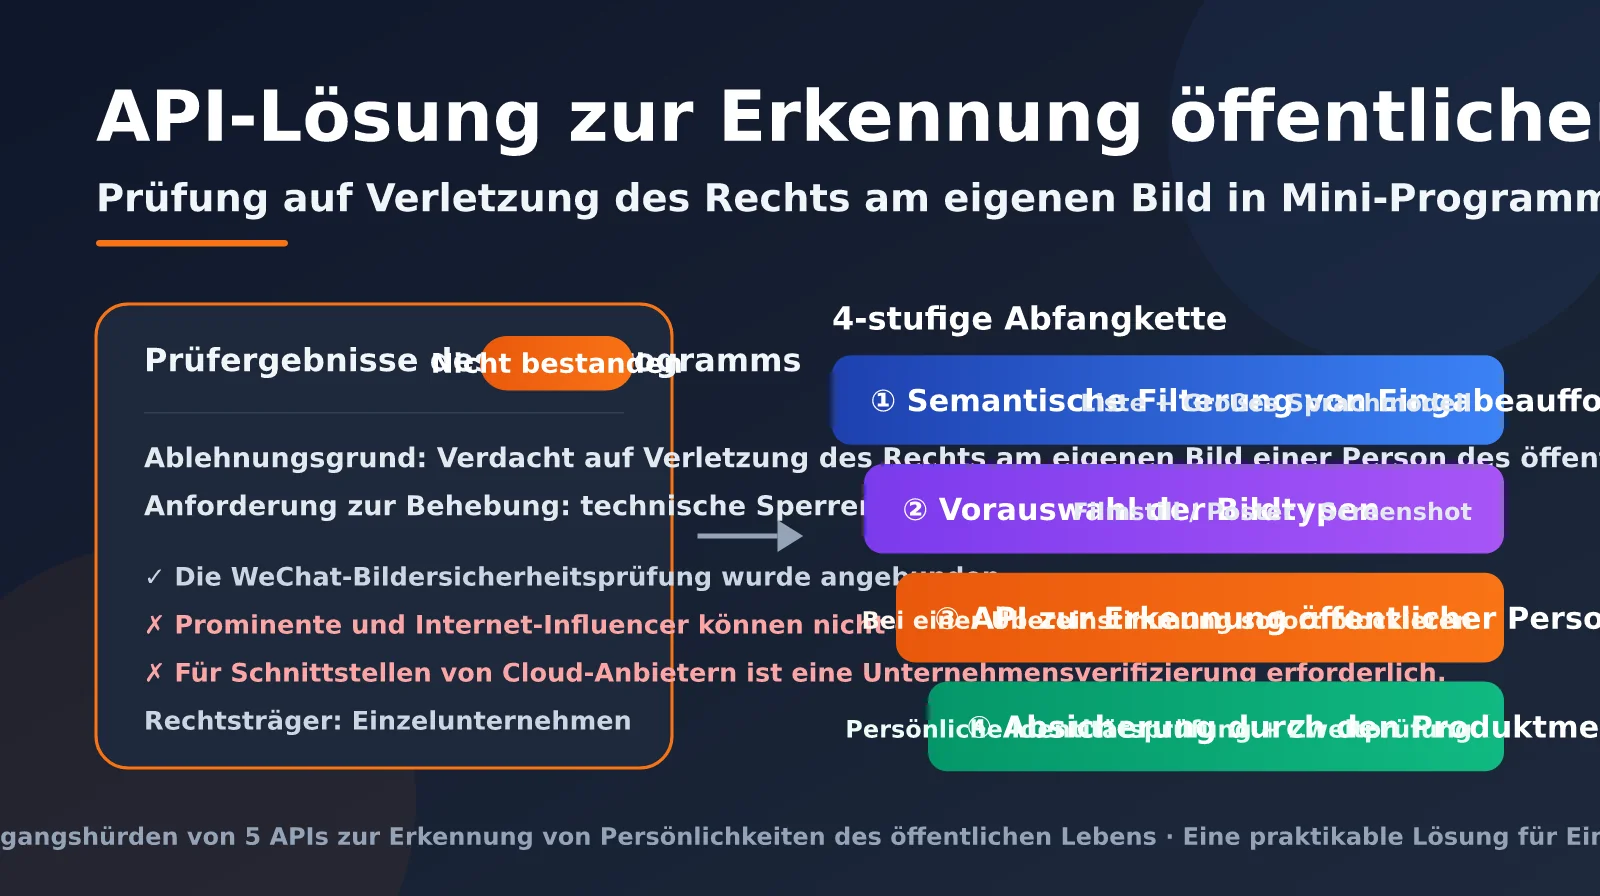
最近 bat ein Entwickler, der ein KI-Bild-Mini-Programm entwickelt, in einer Gruppe um Hilfe: Die Prüfung seines Mini-Programms blieb wegen des Problems Verletzung von Persönlichkeitsrechten durch Abbildungen öffentlicher Personen hängen. WeChat verlangte, eine „technische Sperre“ einzubauen. Er hatte bereits die WeChat-Bildsicherheitsprüfung integriert, aber diese Schnittstelle erkennt keine Stars und Influencer. Alibaba Cloud bietet zwar eine fertige Schnittstelle zur Star-Erkennung, verlangt dafür aber eine Unternehmensverifizierung. Der Entwickler ist jedoch Einzelunternehmer.
Solche Probleme sind bei Mini-Programmen für KI-Porträts, Face-Swapping, Avatar-Erstellung und Posterdesign weit verbreitet. Die Prüfer interessiert nicht, „ob du eine Schnittstelle für Inhaltssicherheit eingebunden hast“, sondern, „ob Nutzer mit deinem Produkt das Abbild einer öffentlichen Person erstellen oder verbreiten können“. Fehlt auch nur ein Glied in der Sperrkette, kann es passieren, dass dein Mini-Programm wiederholt abgelehnt wird.
Dieser Artikel dreht sich um APIs zur Erkennung öffentlicher Personen. Zunächst erklären wir, wo die Möglichkeiten der WeChat-Schnittstelle für Inhaltssicherheit enden. Anschließend vergleichen wir die Einstiegshürden von fünf gängigen APIs zur Erkennung öffentlicher Personen. Zum Schluss stellen wir eine technische Sperrlösung mit vier Ebenen vor, die sich auch von Einzelunternehmern umsetzen lässt.
Das nimmst du aus dem Artikel mit: Du erfährst, welche API zur Erkennung öffentlicher Personen für dich geeignet ist, wie du die Sperrkette kombinierst und wie du deine technische Lösung bei der Prüfung verständlich darstellst.
Warum APIs zur Erkennung öffentlicher Personen für Mini-Programme zur entscheidenden Prüfungshürde geworden sind
WeChat prüft Mini-Programme für KI-generierte Inhalte und Bildbearbeitung immer strenger. Dafür gibt es klare regulatorische Grundlagen. Die „Vorschriften zur Verwaltung von Deep Synthesis in Internet-Informationsdiensten“ gelten seit dem 10. Januar 2023. Sie verlangen von Anbietern, die Funktionen zur Bearbeitung biometrischer Daten wie Gesicht oder Stimme bereitstellen, dass sie Nutzer darauf hinweisen, die bearbeitete Person zu informieren und deren gesonderte Zustimmung einzuholen. Die am 1. September 2025 in Kraft getretene „Kennzeichnungsmethode für KI-generierte und synthetisierte Inhalte“ verlangt darüber hinaus, KI-generierte Inhalte sichtbar und unsichtbar zu kennzeichnen.
Vor diesem Hintergrund bereitet Plattformen vor allem der Missbrauch von „Promi-Gesichtern“ Sorgen: Nutzer laden Standbilder aus Filmen mit Schauspielern hoch, um KI-Porträts zu erstellen, tauschen Gesichter mit Fotos von Influencern oder geben den Namen eines Stars ein, um Bilder im „gleichen Stil“ zu generieren. All das kann eine Verletzung des Rechts am eigenen Bild darstellen. Als Dienstanbieter muss das Mini-Programm deshalb seiner Pflicht zur „technischen Sperrung“ nachkommen. Die Forderung aus dem Prüfbericht, eine „technische Sperre hinzuzufügen“, bedeutet im Kern, dass du öffentliche Personen sowohl beim Hochladen durch Nutzer als auch bei der Bilderzeugung erkennen können musst.
Wo die Möglichkeiten der WeChat-Schnittstelle für Inhaltssicherheit enden
Viele Entwickler denken zuerst daran, die offizielle Schnittstelle von WeChat für Inhaltssicherheit einzubinden. Sie löst jedoch ein anderes Problem. Die folgende Tabelle vergleicht, welche Inhalte die WeChat-Schnittstelle abdeckt und welche Funktionen für das Sperren von Bildrechtsverletzungen tatsächlich erforderlich sind.
| Prüfkategorie | WeChat msgSecCheck / mediaCheckAsync | Für das Sperren von Bildrechtsverletzungen erforderlich |
|---|---|---|
| Pornografische und vulgäre Inhalte | ✅ Unterstützt | Erforderlich |
| Politisch sensible Inhalte | ✅ Unterstützt (teilweise politisch exponierte Personen) | Erforderlich |
| Gewalt, Terrorismus, illegale Inhalte und Beleidigungen | ✅ Unterstützt | Erforderlich |
| Erkennung von Stars aus der Unterhaltungsbranche | ❌ Gibt keine Personenidentität zurück | Kernanforderung |
| Erkennung von Influencern und Streamern | ❌ Nicht unterstützt | Kernanforderung |
| Namen von Stars in Eingabeaufforderungen | ⚠️ Prüft nur, ob der Text gegen Richtlinien verstößt, nicht die Bildrechtsabsicht | Kernanforderung |
WeChat msgSecCheck dient der Textprüfung, mediaCheckAsync der asynchronen Prüfung von Bildern und Audiodateien. Beide erkennen vor allem pornografische, politisch sensible, gewalttätige, terroristische und beleidigende Inhalte. Sie sagen dir jedoch nicht, „welcher Star auf diesem Bild zu sehen ist“. Wenn du nur die WeChat-Schnittstelle einbindest, hast du aus Sicht der Prüfer lediglich die „allgemeine Inhaltssicherheit“ abgedeckt, aber nicht das „Sperren von Abbildungen öffentlicher Personen“.
🎯 Technischer Tipp: Die API zur Erkennung öffentlicher Personen ist nur ein Glied in der Sperrkette. Die Prüfung von Texteingaben ist oft wichtiger und günstiger. Wir empfehlen, über die APIYI-Plattform apiyi.com ein Großes Sprachmodell für die semantische Prüfung von Eingabeaufforderungen zu nutzen. Die Plattform ist mit dem OpenAI-API-Format kompatibel und kann auch von Einzelentwicklern direkt genutzt werden. So lässt sich diese Ebene schnell ergänzen.
Vergleich von 5 API-Lösungen zur Erkennung öffentlicher Personen
Um Informationsverfälschungen zu vermeiden, basieren die folgenden Lösungen auf den englischsprachigen offiziellen Dokumentationen der jeweiligen Anbieter. Vorab sei darauf hingewiesen: Die Erkennung öffentlicher Personen zählt zur Gesichtserkennung. Fast alle großen Anbieter setzen dafür Zugangshürden – genau deshalb haben Einzelunternehmen oft das Gefühl, „keinen Ausweg“ zu haben.
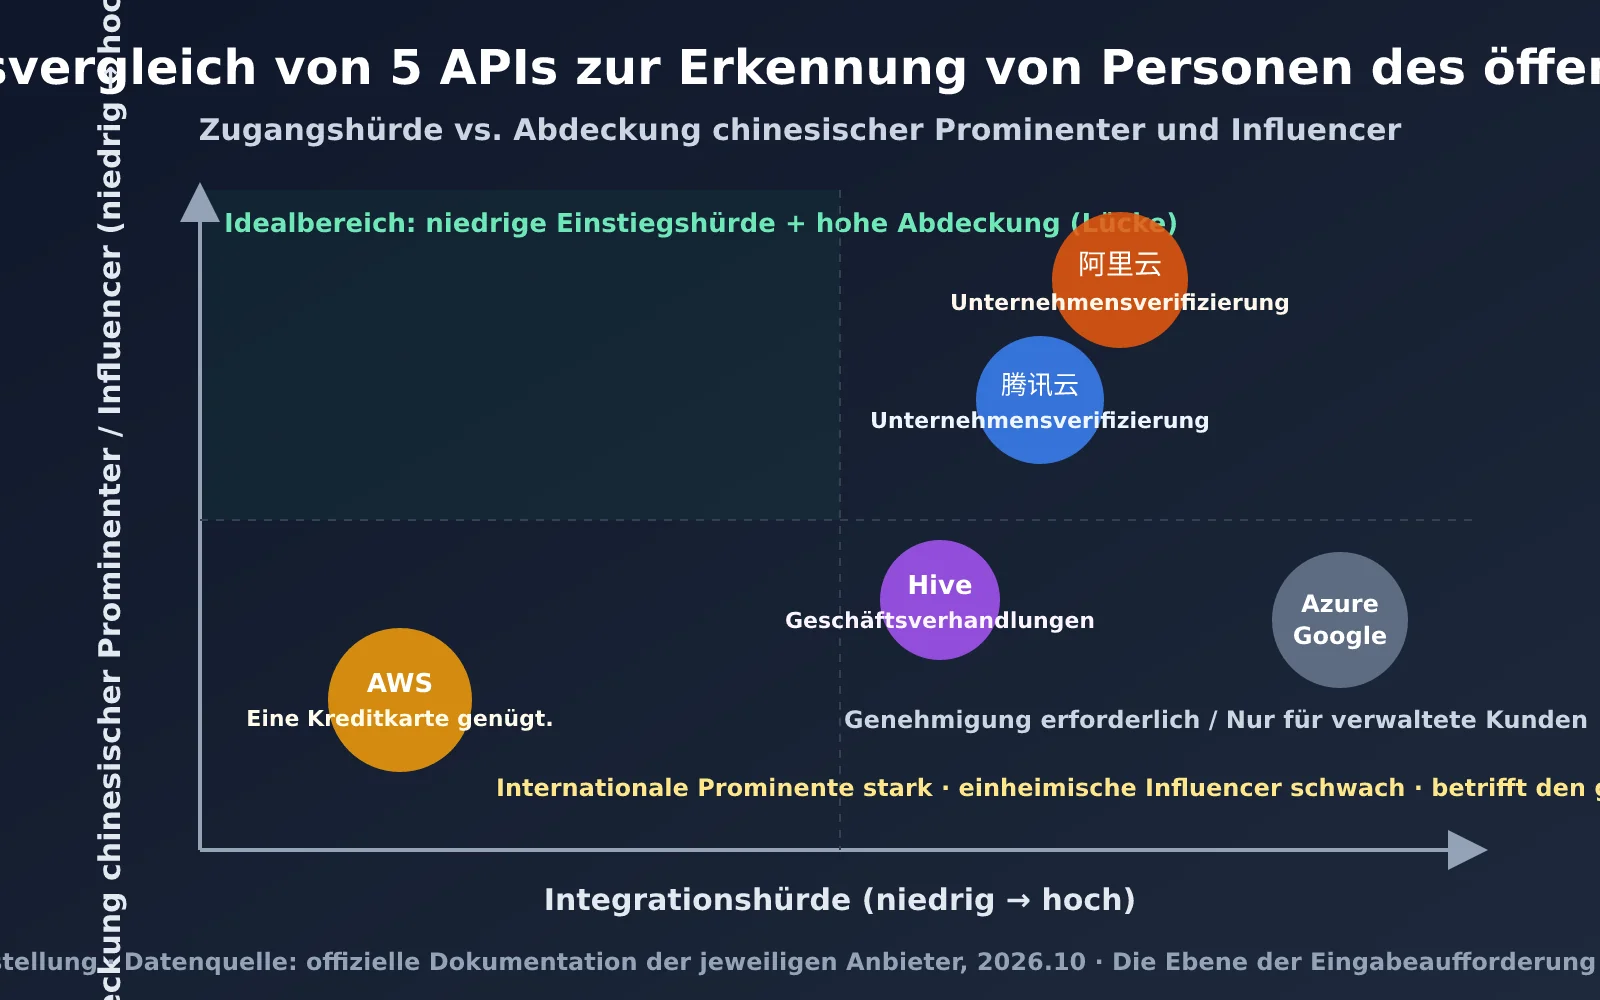
Zugangshürden und Funktionen von APIs zur Erkennung öffentlicher Personen im Überblick
| Lösung | API-Funktionen | Zugangshürden | Abdeckung chinesischer Stars und Influencer | Abrechnungsmodell |
|---|---|---|---|---|
| Alibaba Cloud Visual Intelligence / Content Security | Celebrity-Erkennung mit DetectCelebrity; die erweiterte Bildmoderation kann über infoType=publicFigure Namen und Positionen öffentlicher Personen zurückgeben |
Laut Rückmeldungen von Entwicklern ist eine Unternehmensverifizierung erforderlich | Hoch | Abrechnung nach Anzahl der Aufrufe |
| Tencent Cloud Image Moderation Service (IMS) | Gibt Verstöße als Labels und Unterlabels zurück; in bestimmten Szenarien auch Namen von Personen | Unternehmensverifizierung (Einzelunternehmen können es mit einer Verifizierung anhand der Gewerbelizenz versuchen) | Mittel bis hoch | Abrechnung nach Anzahl der Aufrufe |
| AWS Rekognition | RecognizeCelebrities erkennt bis zu 64 Prominente pro Bild und gibt Namen, IDs, Konfidenzwerte und Referenzlinks zurück |
Für ein Auslandskonto genügt eine hinterlegte Kreditkarte; keine Genehmigung erforderlich | Stark bei internationalen Prominenten, schwach bei chinesischen Influencern | Die ersten 1 Million Bilder kosten jeweils $0.001 |
| Hive Celebrity Recognition | Erfasst mehr als 50.000 Politiker, Sportler, religiöse Führungspersönlichkeiten und Prominente | API-Schlüssel muss beantragt werden; Angebot richtet sich eher an Unternehmen | Mittel | Auf der Website nicht veröffentlicht |
| Azure / Google Cloud Vision | Prominentenerkennung | Azure ist seit Juni 2022 nur noch für betreute Kunden verfügbar; Google beschränkt den Zugang auf Medien- und Unterhaltungskunden, die eine manuelle Prüfung bestanden haben | Mittel | Genehmigung erforderlich |
Wie die Tabelle zeigt, hat AWS Rekognition die niedrigsten Zugangshürden. Die Prominentendatenbank konzentriert sich jedoch vor allem auf internationale Film- und Fernsehstars, Sportler sowie Persönlichkeiten aus Politik und Wirtschaft. Chinesische Influencer und Livestreamer sind nur begrenzt abgedeckt. Außerdem zählen Gesichtsdaten nach dem chinesischen Gesetz zum Schutz personenbezogener Informationen zu den sensiblen personenbezogenen Informationen. Werden von Nutzern hochgeladene Fotos an einen ausländischen Dienst übermittelt, können zusätzlich Compliance-Anforderungen für den grenzüberschreitenden Datentransfer gelten. Das sollte auch bei der Zusammenstellung der Prüfungsunterlagen berücksichtigt werden.
Realistische Optionen für Einzelunternehmen
Zunächst ein häufig missverstandener Punkt: Im Verifizierungssystem großer chinesischer Cloud-Anbieter können Einzelunternehmen mit einer Gewerbelizenz in der Regel den Weg der „Unternehmensverifizierung“ nutzen. Bei einigen besonders sensiblen APIs kommt allerdings eine zusätzliche Prüfung der Qualifikationen hinzu. Die Aussage „Einzelunternehmen sind keine Unternehmen“ trifft also nicht uneingeschränkt zu. Am besten fragst du zunächst beim Kundenservice von Alibaba Cloud oder Tencent Cloud nach den konkreten Freischaltungsbedingungen für die jeweilige API.
Sollte sich herausstellen, dass der Zugang nicht möglich ist, braucht es einen anderen Ansatz: Nicht den gesamten Schutz davon abhängig machen, „zu erkennen, wer die Person ist“, sondern mit mehreren Schutzebenen verhindern, dass Abbildungen öffentlicher Personen überhaupt in die Generierung gelangen. Bei der Prüfung zählen vor allem die Wirksamkeit der Schutzmaßnahmen und die Vollständigkeit des Verfahrens – nicht, von welchem Anbieter die API zur Erkennung öffentlicher Personen stammt.
Technische Schutzarchitektur mit vier Ebenen zur Erkennung öffentlicher Personen
Das Prinzip dieser Architektur lautet: „früh abfangen und die Prüfung schrittweise verschärfen“. Je weiter vorne eine Ebene liegt, desto günstiger und schneller ist sie. Spätere Ebenen sind präziser, aber auch teurer. Die meisten riskanten Anfragen lassen sich bereits auf den ersten beiden Ebenen abfangen.
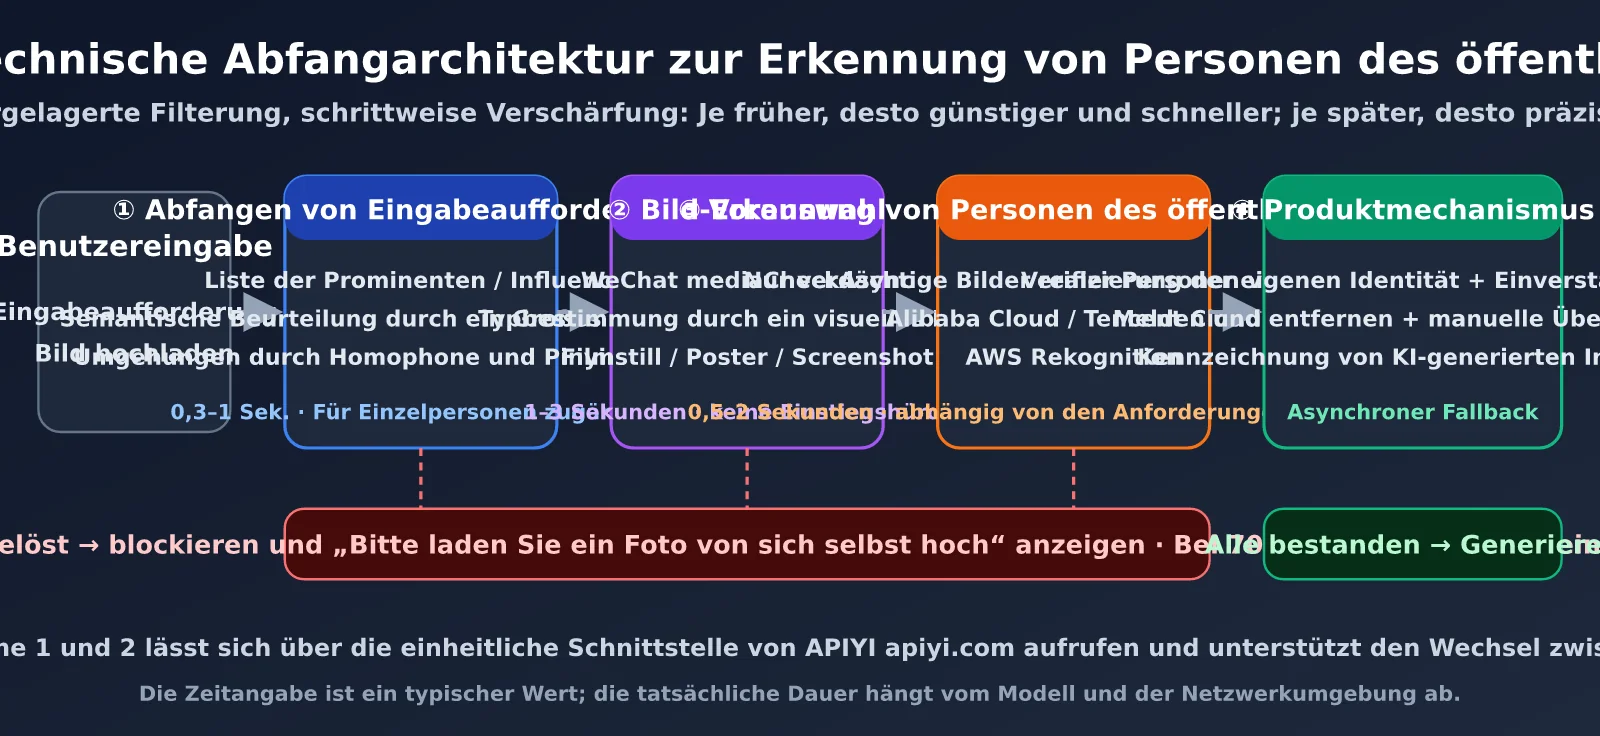
Aufgaben der vier Prüfebenen
| Ebene | Was wird abgefangen? | Umsetzung | Typische Dauer | Zugangshürden |
|---|---|---|---|---|
| Ebene 1: Prüfung der Eingabeaufforderung | „Erstelle ein Porträtfoto von einem bestimmten Star“, „Tausche das Gesicht gegen das eines bestimmten Influencers aus“ | Schlüsselwortliste + semantische Prüfung durch ein Großes Sprachmodell | 0,3–1 Sekunde | Keine, auch für Einzelpersonen zugänglich |
| Ebene 2: Erste Bildprüfung | Filmszenen, Poster, Magazincover, Screenshots von Livestreams | mediaCheckAsync von WeChat + Bildtypenprüfung durch ein multimodales Großes Sprachmodell |
1–3 Sekunden | Keine |
| Ebene 3: API zur Erkennung öffentlicher Personen | Echte Fotos bekannter öffentlicher Personen | Alibaba Cloud / Tencent Cloud / AWS Rekognition | 0,5–2 Sekunden | Je nach Anbieter |
| Ebene 4: Produktmechanismen | Durchgerutschte und strittige Inhalte | Einwilligungserklärung, Melde- und Löschverfahren, manuelle Prüfung, KI-Kennzeichnung | Asynchron | Keine |
Ebene 1 bietet das beste Verhältnis von Aufwand zu Wirkung. Bei KI-Generierungsanwendungen beruhen viele Anfragen mit Urheberrechtsrisiken auf der Eingabeaufforderung – etwa wenn direkt der Name eines Stars oder eine Formulierung wie „ein Gesicht wie das von …“ eingegeben wird. Eine Schlüsselwortliste allein lässt sich leicht durch Homophone, Pinyin oder Abkürzungen umgehen. Eine semantische Prüfung durch ein Großes Sprachmodell kann die Trefferquote deutlich verbessern.
Ebene 2 verfolgt den Ansatz: „Nicht erkennen, wer es ist, sondern was es ist.“ Multimodale Große Sprachmodelle weigern sich in der Regel, die Identität einer realen Person auf einem Foto zu nennen. OpenAI schränkt die Fähigkeit von GPT-4o, reale Personen zu identifizieren, ebenfalls ausdrücklich ein. Zu beurteilen, ob ein Bild eine „Filmszene, ein Poster mit einem Star, ein Magazincover oder einen Livestream-Screenshot mit Senderlogo“ zeigt, liegt jedoch durchaus in ihren Möglichkeiten. Solche Bilder sind bereits für sich genommen ein starkes Risikosignal und können direkt abgefangen oder an Ebene 3 weitergeleitet werden.
Ebene 1: Beispielcode für die semantische Prüfung von Eingabeaufforderungen
Das folgende Minimalbeispiel lässt ein Großes Sprachmodell beurteilen, ob eine Eingabeaufforderung eine reale öffentliche Person betrifft. Das Modell gibt strukturiertes JSON zurück, anhand dessen das Backend entscheidet, ob die Anfrage freigegeben oder blockiert wird.
import json
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")  # APIYI 统一接口

def check_prompt(prompt: str) -> dict:
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        response_format={"type": "json_object"},
        messages=[
            {"role": "system", "content": "判断用户提示词是否要求生成、模仿或替换真实公众人物(明星、网红、主播、政治人物、运动员)的肖像。"
             "只输出 JSON:{\"risk\": true/false, \"names\": [], \"reason\": \"\"}"},
            {"role": "user", "content": prompt},
        ],
    )
    return json.loads(resp.choices[0].message.content)

print(check_prompt("帮我生成一张和那个唱《青花瓷》的歌手同款的写真"))
In diesem Beispiel wird kein Name direkt genannt. Eine Schlüsselwortliste würde die Anfrage daher nicht erkennen. Das Große Sprachmodell kann jedoch aus der Bedeutung ableiten, auf welchen Sänger sich die Eingabeaufforderung bezieht, und sie als risikoreich einstufen.
📦 Vollständige Version anzeigen: zweistufige Prüfung von Eingabeaufforderungen und Bildern
import base64, json
import boto3
from openai import OpenAI

llm = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")  # APIYI 统一接口
rek = boto3.client("rekognition", region_name="ap-southeast-1")

BLOCK_NAMES = {"示例明星A", "示例网红B"}  # 本地名单,命中直接拦截

def llm_json(messages):
    resp = llm.chat.completions.create(
        model="gpt-4o-mini",
        response_format={"type": "json_object"},
        messages=messages,
    )
    return json.loads(resp.choices[0].message.content)

def layer1_prompt(prompt: str) -> bool:
    if any(n in prompt for n in BLOCK_NAMES):
        return True
    r = llm_json([
        {"role": "system", "content": "判断提示词是否涉及真实公众人物肖像,只输出 JSON:{\"risk\": bool}"},
        {"role": "user", "content": prompt},
    ])
    return r.get("risk", False)

def layer2_image(img_bytes: bytes) -> str:
    """不识别身份,只判断图片类型,返回 block / suspect / pass"""
    b64 = base64.b64encode(img_bytes).decode()
    r = llm_json([
        {"role": "system", "content": "不要识别人物身份。只判断图片类型,输出 JSON:"
         "{\"type\": \"selfie|film_still|poster|magazine|live_screenshot|non_human|other\", \"real_person\": bool}"},
        {"role": "user", "content": [
            {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{b64}"}},
        ]},
    ])
    if r.get("type") in {"film_still", "poster", "magazine", "live_screenshot"}:
        return "block"
    return "suspect" if r.get("real_person") else "pass"

def layer3_celebrity(img_bytes: bytes, threshold: float = 90.0) -> bool:
    res = rek.recognize_celebrities(Image={"Bytes": img_bytes})
    return any(c["MatchConfidence"] >= threshold for c in res["CelebrityFaces"])

def moderate(prompt: str, img_bytes: bytes | None) -> str:
    if layer1_prompt(prompt):
        return "blocked: prompt"
    if img_bytes:
        verdict = layer2_image(img_bytes)
        if verdict == "block":
            return "blocked: image_type"
        if verdict == "suspect" and layer3_celebrity(img_bytes):
            return "blocked: public_figure"
    return "pass"
In der vollständigen Version wird Ebene 3 nur für Bilder aufgerufen, die Ebene 2 als „Foto einer realen Person“ eingestuft hat. Das spart Kosten für die API zur Erkennung öffentlicher Personen und reduziert zugleich die Menge der extern übermittelten Gesichtsdaten. Wenn du bereits die API von Alibaba Cloud oder Tencent Cloud freigeschaltet hast, kannst du layer3_celebrity einfach durch den entsprechenden SDK-Aufruf ersetzen.
🚀 Schnellstart: Ebene 1 und Ebene 2 nutzen beide Große Sprachmodelle. Für erste Tests empfiehlt sich APIYI apiyi.com: Verwende das Testguthaben, um 100 echte Nutzereingaben und Bilder zu prüfen, und ermittle vor dem Start die Erkennungs- und Fehlalarmquote. Derselbe Code lässt sich mit verschiedenen Modellen wie GPT, Gemini und Claude verwenden, um die Ergebnisse zu vergleichen.
Schwellenwerte und Maßnahmen bei der Erkennung von Personen des öffentlichen Lebens
Das Erkennungsergebnis ist kein einfaches „Ja“ oder „Nein“: Der Konfidenzschwellenwert bestimmt direkt die Rate falsch positiver und falsch negativer Ergebnisse. Die offizielle Hive-Dokumentation empfiehlt als Richtwerte einen Schwellenwert von 0,85 für echte Fotos und 0,9 für KI-generierte Inhalte. AWS Rekognition gibt MatchConfidence auf einer Skala von 0 bis 100 zurück. Der Schwellenwert lässt sich nach demselben Prinzip festlegen.
| Konfidenzbereich | Maßnahme | Hinweis für Nutzer | Erläuterung |
|---|---|---|---|
| ≥ 90 | Direkt blockieren | „Das Bild enthält möglicherweise das Porträt einer Person des öffentlichen Lebens. Bitte laden Sie ein Foto von sich selbst hoch.“ | Hohe Konfidenz, daher geringes Risiko für falsch positive Ergebnisse |
| 70–90 | Blockieren und zur manuellen Prüfung weiterleiten | „Das Bild wird geprüft. Bitte warten Sie einen Moment.“ | Ähnlichkeit mit einer anderen Person oder Verdeckung durch den Aufnahmewinkel sind häufige Gründe für Werte in diesem Bereich |
| Gesicht erkannt, aber keine Übereinstimmung | Freigeben und protokollieren | Keine | Normale Fotos von Nutzern |
| Kein Gesicht erkannt | Freigeben | Keine | Landschaften, Haustiere, Gegenstände usw. |
Bei KI-Porträtprodukten ist es sicherer, zusätzlich eine „Identitätsprüfung“ einzuführen: Nutzer müssen zunächst ein Selfie als Referenz hochladen. Weitere hochgeladene Fotos dürfen nur dann für die Generierung verwendet werden, wenn die Ähnlichkeit mit dem Referenzgesicht den festgelegten Schwellenwert erreicht. Selbst wenn die API zur Erkennung von Personen des öffentlichen Lebens eine weniger bekannte Influencerin oder einen weniger bekannten Influencer nicht abdeckt, lässt sich so grundsätzlich verhindern, dass Nutzer das Gesicht einer anderen Person verwenden.
💡 Empfehlung: Wenn vor allem chinesische Influencer und Streamer ein Risiko darstellen, reicht die Abdeckung jeder API zur Erkennung von Personen des öffentlichen Lebens aus dem Ausland nicht aus. Konzentrieren Sie sich daher auf die Sperrung von Eingabeaufforderungen in Ebene 1 und auf die „Identitätsprüfung“. Den Modellaufruf des großen Sprachmodells in Ebene 1 können Sie über APIYI apiyi.com integrieren. Die Kosten betragen in der Regel nur einen Bruchteil der Kosten für die Bilderkennung.
So beschreiben Sie die Sperrung von Personen des öffentlichen Lebens bei der Einreichung zur Prüfung
Die technische Umsetzung allein reicht nicht – auch die Prüfenden müssen sie nachvollziehen können. Beschreiben Sie die Maßnahmen in den Prüfhinweisen oder ergänzenden Unterlagen am besten nach folgender Struktur:
- Prüfkette: Erläutern Sie, welche Erkennungsfunktionen bei Eingabeaufforderungen, beim Hochladen von Bildern und bei den generierten Ergebnissen eingesetzt werden.
- Erkennung von Personen des öffentlichen Lebens: Nennen Sie die verwendete API oder die alternative Lösung und beschreiben Sie, was bei einem Treffer geschieht.
- Produktmechanismen: Führen Sie die Klausel zur Einwilligung in die Nutzung des Porträts in den Nutzungsbedingungen, das Bestätigungsfenster „Nur Fotos von mir selbst“ vor dem Hochladen, die Meldemöglichkeit und die Frist für die Entfernung von Inhalten auf.
- Kennzeichnung von KI-Inhalten: Versehen Sie generierte Bilder mit einem sichtbaren Hinweis „KI-generiert“ und hinterlegen Sie zusätzlich eine unsichtbare Kennzeichnung in den Dateimetadaten.
- Testnachweise: Fügen Sie Screenshots oder eine Bildschirmaufzeichnung bei, die zeigen, dass Tests mit Fotos von Prominenten und Eingabeaufforderungen mit deren Namen blockiert wurden.
Punkt 5 ist besonders überzeugend. Prüfende testen die Anwendung häufig direkt mit Fotos von Prominenten. Wenn Ihre Aufzeichnung zeigt, dass sowohl „Foto einer Prominenten hochladen → blockiert“ als auch „Namen einer Prominenten eingeben → blockiert“ funktioniert, steigen die Erfolgsaussichten deutlich.
Häufige Fragen zu APIs zur Erkennung von Personen des öffentlichen Lebens
F1: Kann ein großes Sprachmodell eine API zur Erkennung von Personen des öffentlichen Lebens vollständig ersetzen?
Nein. Führende visuelle große Sprachmodelle verweigern aus Datenschutzgründen normalerweise die Identifizierung realer Personen auf Fotos. Und selbst wenn die Identifizierung gelingt, ist das Ergebnis nicht zuverlässig genug für eine eindeutige Identitätsprüfung. Große Sprachmodelle eignen sich am besten zum Erkennen und Blockieren semantisch problematischer Eingabeaufforderungen sowie zur Einordnung von Bildern. Für die Identifizierung von Personen empfiehlt sich weiterhin eine spezialisierte API zur Erkennung von Personen des öffentlichen Lebens. Über APIYI apiyi.com können Sie verschiedene Modelle mit denselben Testbeispielen vergleichen und anschließend entscheiden, welches Modell welche Aufgabe übernimmt.
F2: Kann AWS Rekognition chinesische Prominente erkennen?
Es erkennt einige bekannte chinesischsprachige Film- und Fernsehstars sowie Sportler. Die Abdeckung chinesischer Influencer, Streamer und Kurzvideokünstler ist jedoch deutlich geringer. Außerdem handelt es sich um einen ausländischen Dienst. Bei der Verarbeitung sensibler personenbezogener Daten wie Gesichtern müssen Sie die Vorschriften zur grenzüberschreitenden Datenübermittlung prüfen. Rufen Sie den Dienst am besten nur für verdächtige Bilder auf, die bereits Ebene 2 durchlaufen haben, und informieren Sie in Ihrer Datenschutzerklärung transparent darüber.
F3: Können Einzelunternehmer grundsätzlich keinen Zugang zur Prominentenerkennung von Alibaba Cloud erhalten?
Nicht unbedingt. Einzelunternehmer können sich mit einer Gewerbelizenz in der Regel als Unternehmen beim Cloud-Anbieter verifizieren lassen. Für bestimmte Schnittstellen ist jedoch eine zusätzliche Berechtigungsprüfung erforderlich. Fragen Sie am besten direkt über ein Support-Ticket nach den Voraussetzungen für die konkrete Schnittstelle und halten Sie Tencent Cloud als Alternative bereit.
F4: Ist der Modellaufruf zur Prüfung von Eingabeaufforderungen teuer?
Nein, die Kosten sind sehr gering. Eine Prüfung verbraucht normalerweise nur einige hundert Token. Bei einem leichtgewichtigen Modell liegen die Kosten pro Aufruf weit unter denen einer Bilderkennung. Über APIYI apiyi.com können Sie außerdem nutzungsabhängig abrechnen. Das eignet sich besonders für Mini-Programme mit stark schwankendem Prüfaufkommen.
F5: Was kann ich tun, wenn die Anwendung trotz der Sperrmaßnahmen abgelehnt wird?
Prüfen Sie zunächst, ob die Ablehnung noch mit bereits vorhandenen Inhalten zusammenhängt. Verwenden beispielsweise Beispielbilder oder Vorlagen innerhalb des Mini-Programms Fotos von Prominenten? Viele Entwickler setzen die technischen Sperren korrekt um, werden aber erneut abgelehnt, weil auf der Startseite ein Beispielbild mit einer prominenten Person zu sehen ist. Ersetzen Sie solche Bilder vollständig durch eigenes lizenziertes Material oder durch KI-generierte virtuelle Porträts.
Zusammenfassung
Wird ein Mini-Programm wegen der Verletzung von Persönlichkeitsrechten durch die Verwendung von Bildern prominenter Personen aufgefordert, „technische Sperren einzubauen“, geht es nicht darum, eine universelle API zur Erkennung prominenter Personen zu finden. Entscheidend ist eine durchgängige Schutzkette. Die WeChat-Schnittstelle zur Inhaltssicherheit deckt nur allgemeine Verstöße ab und erkennt keine Stars oder Influencer. Die Erkennungsfunktionen für prominente Personen von Alibaba Cloud und Tencent Cloud passen am besten zum chinesischen Markt, setzen aber eine Unternehmensverifizierung voraus. AWS Rekognition ist am einfachsten zugänglich, erkennt jedoch nur wenige chinesische Influencer und bringt zudem eine Übermittlung von Daten ins Ausland mit sich. Azure und Google stehen normalen Entwicklern dagegen kaum zur Verfügung.
Für Einzelunternehmer ist folgender Weg am praktikabelsten: zunächst klären, ob sich die Unternehmensverifizierung beim Cloud-Anbieter mit einer Gewerbelizenz abschließen lässt. Gleichzeitig sollten eine semantische Filterung der Eingabeaufforderungen und eine erste Klassifizierung von Bildern eingerichtet werden. Ergänzend kommen eine Identitätsprüfung, eine Erklärung zur Rechtefreigabe und eine manuelle Nachkontrolle hinzu. Abschließend lässt sich den Prüfern anhand einer Testaufzeichnung nachweisen, dass die Sperren wirksam sind.
Für den schnellen Aufbau der ersten beiden Ebenen mit Prüfungsfunktionen auf Basis großer Sprachmodelle empfiehlt sich APIYI unter apiyi.com. Testen Sie die Erkennungsrate anhand realer Beispiele, bevor Sie den Antrag zur Prüfung einreichen.
Autor: APIYI Team. Wir konzentrieren uns auf die praktische Umsetzung von Anwendungen mit KI-Sprachmodellen. Weitere technische Lösungen und Testkontingente finden Sie unter APIYI apiyi.com.