Anmerkung des Autors: MiniMax hat die Modellgewichte von H3 und H3-Image veröffentlicht. Wo Entwicklung und kommerzielle Nutzung enden, bestimmen jedoch die Systemkomponenten, die Cloud-Dienste und die Community-Lizenzen. Dieser Artikel geht Modul für Modul und Lizenz für Lizenz durch.
Am 10. November 2026 hat MiniMax die Modellgewichte von H3-Image veröffentlicht. Schon am 3. August 2026 war das omnimodale Videogenerierungsmodell MiniMax H3 als Open Source erschienen. Zwischen beiden Veröffentlichungen liegen gut drei Monate. Man wirft sie oft in einen Topf, aber es sind zwei Modelle mit zwei Lizenzen.
Das hier ist kein Artikel, der „Fake-Open-Source“ anprangert. Die offizielle Ankündigung, die Hugging-Face-Modellkarte und der Lizenztext sagen es klar: MiniMax gibt Gewichte und Inferenzmaterial rund um das zentrale Generierungsmodell frei, nicht das gesamte Cloud-System. Dieser Artikel ordnet deshalb Punkt für Punkt, was geöffnet wurde, was nicht und wie Sie es nutzen können.
Das nehmen Sie mit: Sie können den Öffnungsstatus der drei H3-Module auseinanderhalten und sehen, welche H3-Image-Komponenten sich lokal betreiben lassen. Außerdem kennen Sie die konkreten Unterschiede der beiden Community Licenses bei der Umsatzschwelle und beim gehosteten Betrieb.
MiniMax H3 Open Source: die Kerninfos im Überblick
Zuerst Zeitlinie und Eckdaten in einer Tabelle. Alle Aussagen unten stützen sich auf die offiziellen Ankündigungen, die Model Cards und den Originaltext der Lizenzen. Der Prüfstand ist der 11. November 2026.
| Info | MiniMax H3 (Video) | MiniMax H3-Image (Bild) |
|---|---|---|
| Open-Source-Datum | 3. August 2026 | 10. November 2026 |
| Modellpositionierung | Omnimodale Videoerzeugung, Ausgabe von Videos mit nativem Stereo-Audio | Hochauflösende Bilderzeugung und Bildbearbeitung, abgeleitet von H3 |
| Kernumfang | 33B Parameter | 33,1B-Parameter-DiT |
| Offene Inhalte | H3-Base-Gewichte und Inferenzmaterialien (zwei Checkpoints: FL2VA und Ref2VA) | DiT, Image-VAE, Tokenizer/Processor, PE-Modell u. a. |
| Weiterhin Cloud-abhängig | Context-IR, Regenerate-2K | H3-Image-Context-IR |
| Lizenz | H3 Community License | H3-Image Community License |
6 Begriffe rund um MiniMax H3, die Sie vorab kennen sollten
- Offene Gewichte: Sie dürfen die trainierten Modellparameter herunterladen. Wofür Sie sie nutzen dürfen, regelt aber die Lizenz. Trainingsdaten und der vollständige Trainingsprozess sind damit nicht automatisch öffentlich.
- Community License: Eine vom Modellanbieter selbst formulierte Nutzungslizenz, keine allgemeine Open-Source-Lizenz wie MIT oder Apache 2.0.
- Checkpoint: Die Parameterdatei, mit der ein Modell geladen wird. Für unterschiedliche Aufgaben kann ein Modell mehrere Checkpoints anbieten.
- Context-IR: Ein offizieller Dienst, der multimodale Eingaben versteht, Anweisungen auswertet und den Kontext aufbereitet. Er steht derzeit nur als API zur Verfügung.
- Gehosteter Dienst: Modellfunktionen werden über das Netzwerk für Dritte bereitgestellt, etwa über eine öffentliche API. Genau dieses Szenario steht im Fokus der Lizenzbeschränkungen.
- Sparse Attention: Eine Technik, die nur einen Teil der Attention-Beziehungen berechnet, um den Rechenaufwand bei langen Sequenzen zu senken.
MiniMax H3 Videomodell: Nur 1 von 3 Modulen ist offen
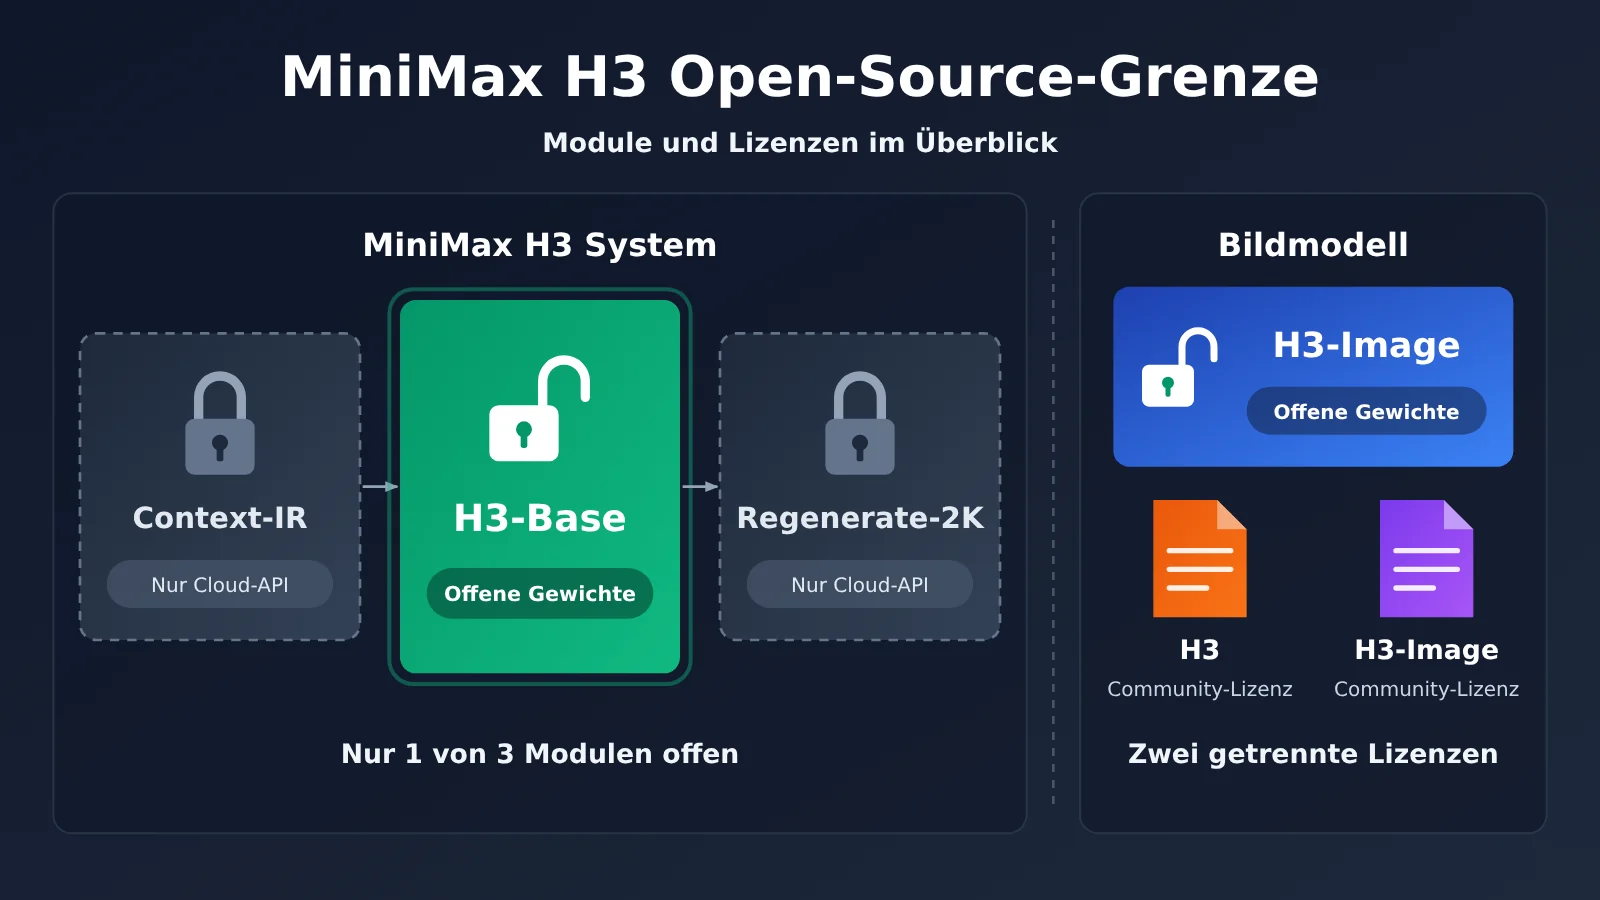
In der offiziellen Ankündigung wird das vollständige MiniMax-H3-System in drei Module unterteilt. Wer diese Aufteilung versteht, versteht auch, warum H3 „Open Source, aber nicht ganz“ ist.
| Modul | Aufgabe | Verfügbarkeit | Lokal nutzbar |
|---|---|---|---|
| H3-Context-IR | Multimodales Verstehen der Eingaben, Auswertung von Anweisungen, Strukturierung des Kontexts | Nicht quelloffen, offizielle API verfügbar | Nein |
| H3-Base | Kernmodell für die Video- und Audioerzeugung | Gewichte und zugehörige Inferenzmaterialien veröffentlicht | Ja |
| H3-Regenerate-2K | Erzeugt Ergebnisse mit niedriger Auflösung unter Einbeziehung des ursprünglichen Kontexts neu in 2K | Nicht quelloffen, offizielle API verfügbar | Nein |
Die zwei Checkpoints von MiniMax H3-Base
H3-Base ist keine einzelne Gewichtsdatei, sondern kommt in zwei aufgabenspezifischen Checkpoints. FL2VA deckt Text-zu-Video, Erstbild-zu-Video, Endbild-zu-Video sowie Erst-und-Endbild-zu-Video ab. Ref2VA kann Bilder, Videos und Audio gleichzeitig als Referenz nutzen und eignet sich für anspruchsvollere Erzeugungs- und Bearbeitungsaufgaben. Ein Beispiel: Aussehen der Figuren und Szene des Originalvideos bleiben erhalten, nur Bewegungen, Lippenbewegungen und Dialoge werden geändert.
Beide Checkpoints enthalten Komponenten wie Processor, Tokenizer, Text-Encoder, Transformer, Visual-VAE und Audio-VAE. Mit anderen Worten: Veröffentlicht wurde ein Modell-Repository, mit dem sich Inferenz tatsächlich ausführen lässt, und keine nackten Gewichte, bei denen man die nötigen Begleitkomponenten selbst zusammensuchen muss. Das ist deutlich vollständiger als bei vielen Releases, die nur Gewichte bereitstellen.
Lokal in 768p vs. vollständiger 2K-Workflow
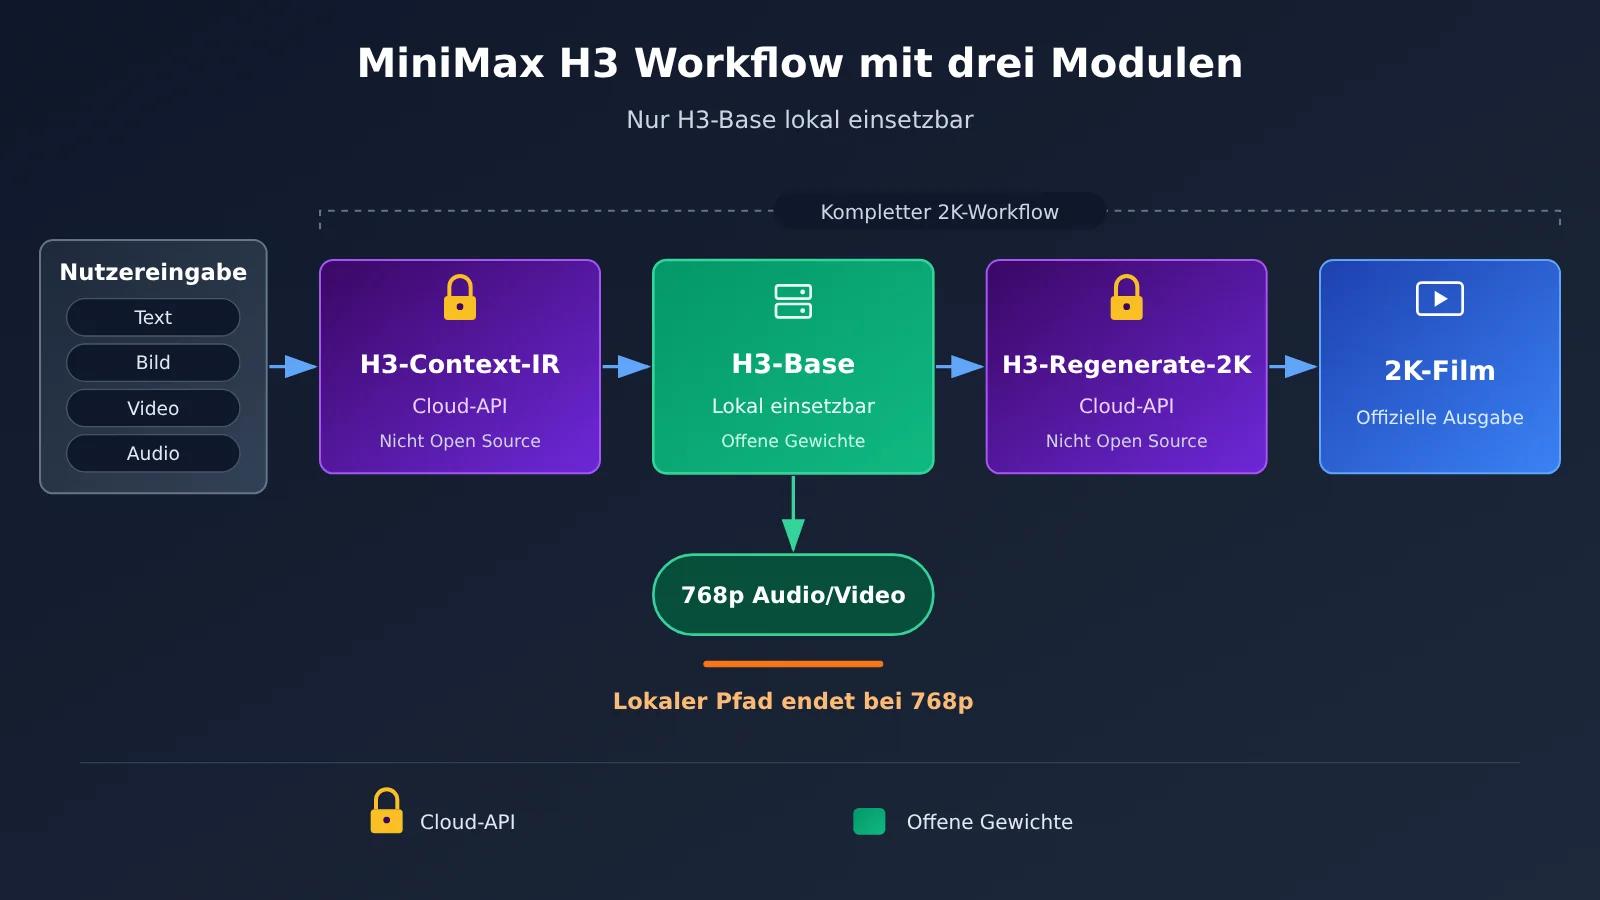
Laut offizieller Spezifikation gibt H3 standardmäßig Videos mit 768 px auf der kurzen Seite aus. Die Videolänge beträgt 4–15 Sekunden, die Bildrate 24 FPS, das Audio ist 32-kHz-Stereo. Wer nur das quelloffene H3-Base einsetzt, kann lokal Audio und Video in 768p erzeugen. Um die offizielle 2K-Ausgabe zu reproduzieren, müssen zusätzlich die beiden APIs Context-IR und Regenerate-2K aufgerufen werden.
Präziser formuliert: H3-Base läuft eigenständig, das vollständige H3-System lässt sich aber nicht völlig von den Diensten von MiniMax lösen. Bei einer lokalen Lösung müssen Entwickler das Verstehen der Eingaben und das Aufbereiten der Anweisungen selbst gestalten. Man sollte nicht davon ausgehen, dass es für Context-IR eine lokale Version gibt.
Sparse Attention: leicht zu übersehen
Beim ersten Open-Source-Release stellt MiniMax klar: Das H3-Modell selbst unterstützt Sparse-Attention-Training und -Inferenz nativ, um die Rechenkosten bei langen multimodalen Sequenzen zu senken. Der erstmals veröffentlichte Inferenzcode enthält jedoch nur Full Attention. Die Implementierung von Sparse Attention soll in einem späteren Update separat folgen.
Offene Gewichte bedeuten also nicht, dass auch alle internen Optimierungen der Inferenz offen sind. Wer mit dem aktuell veröffentlichten Code lange Videos erzeugt, muss unter Umständen mit höherem Rechenaufwand rechnen, als ihn die offizielle Cloud-Variante in der Praxis hat. Diese Variable sollte man bei der Leistungsbewertung berücksichtigen.
Welche Komponenten hat MiniMax H3-Image geöffnet?
H3-Image wird ähnlich geöffnet wie H3: Das Kernmodell lässt sich herunterladen, bei der Kontextverarbeitung bleibt aber eine Abhängigkeit von der Cloud bestehen. Die folgende Tabelle basiert auf dem Modell-Repository bei Hugging Face.
| Komponente | Offen? | Beschreibung |
|---|---|---|
| 33,1B-DiT-Modell zur Bilderzeugung | Ja | Single-Stream-Diffusion-Transformer, ca. 68,65 GB |
| Image VAE | Ja | Kodierung und Dekodierung der latenten Bilddarstellung |
| Tokenizer / Processor | Ja | Vorverarbeitung der Eingaben |
| PDD-Ausgabekopf und Sampling-Konfiguration | Ja | Grundlage für 6-Schritt-Sampling ohne CFG |
| Qwen3-VL-Textencoder | Ja, Gewichte aus dem H3-Repository wiederverwendet | Nutzt die Hidden States der 50. Schicht, ca. 66,7 GB |
| H3-Image-PE (Modell zur Verbesserung von Eingabeaufforderungen) | Ja, separater Download | Ca. 17,9 GB, lokal lauffähig |
| H3-Image-Context-IR | Nein | Wird als offizielle API angeboten |
Warum der Textencoder aus dem H3-Repository geladen wird
H3-Image übernimmt den Qwen3-VL-Textencoder von H3. Die Gewichte liegen im H3-Repository und werden im H3-Image-Repository nicht noch einmal abgelegt. Für die Bereitstellung von H3-Image müssen Sie deshalb die Inhalte beider Repositories herunterladen: Hauptmodell plus Textencoder benötigen zusammen rund 135,35 GB Speicherplatz. Das ist allerdings nur die Dateigröße und nicht gleichbedeutend mit dem Bedarf an GPU-Speicher.
Als Deployment-Frameworks empfiehlt der Hersteller unter anderem SGLang, vLLM-Omni, Diffusers und ComfyUI. Als unterstützte Hardware werden NVIDIA H200, RTX PRO 6000 Blackwell, AMD Instinct MI350X und weitere genannt; zudem gibt es Lösungen für Multi-GPU-Parallelisierung. Für die meisten einzelnen Entwickler ist diese Hardware-Hürde nicht gerade niedrig.
Context-IR und PE sind nicht dasselbe
H3-Image-Context-IR ist ein offizieller Cloud-Dienst, der kurze Anweisungen zu vollständigen Beschreibungen für die Bilderzeugung ausbaut und passende Bildgrößen festlegt. H3-Image-PE dagegen ist ein Modell zur Verbesserung von Eingabeaufforderungen, das sich separat herunterladen und lokal betreiben lässt. Es ist die vom Hersteller vorgesehene lokale Alternative.
Dass PE offen ist, heißt nicht, dass auch der mehrstufige, gehostete Workflow von Context-IR offen ist. Wer nur das Bildmodell und PE herunterlädt, erhält zwar einen nutzbaren lokalen Ablauf, aber nicht automatisch die Ergebnisse der offiziellen Cloud-Lösung.
Herstellerangaben und Framework-Tests getrennt betrachten
„4K-Bilder in unter 10 Sekunden“ und „bis zu 16 Referenzbilder“ stammen aus der offiziellen Modellkarte und der Ankündigung und sind damit Herstellerangaben. In der Deployment-Anleitung von vLLM ist das Limit für Referenzbilder dagegen mit maximal 9 angegeben – die Angaben unterscheiden sich also. Wie viele Referenzbilder tatsächlich nutzbar sind, hängt vom eingesetzten Inferenz-Framework und der Konfiguration ab. Verlassen Sie sich bei der Bewertung am besten auf Ihre eigenen Messungen.
Was beschränken die beiden MiniMax-H3-Lizenzen tatsächlich?
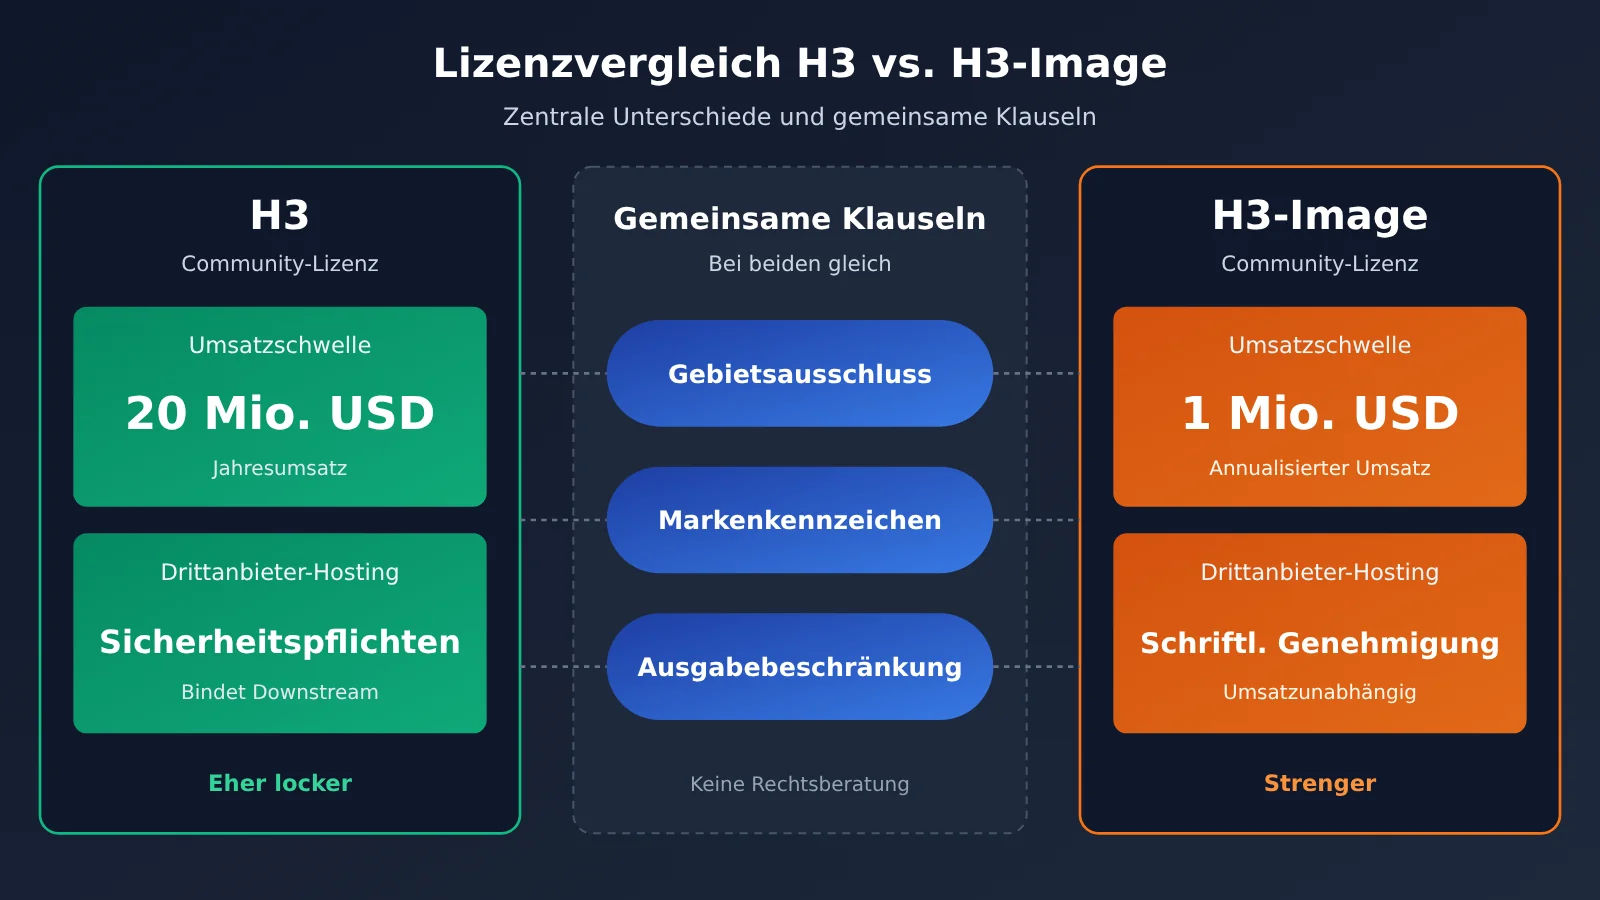
Dieser Teil wird bei den beiden Veröffentlichungen am leichtesten falsch verstanden. H3 und H3-Image stehen unter zwei verschiedenen Community Licenses. Die Bedingungen für die kommerzielle Nutzung unterscheiden sich deutlich, deshalb lässt sich ein Ergebnis nicht einfach auf das andere Modell übertragen.
| Bedingung | H3 Community License | H3-Image Community License |
|---|---|---|
| Geltungsbereich | USA, EU, Großbritannien und Südkorea ausgeschlossen | Identisch |
| Umsatzschwelle für die Genehmigung | Bei einem Jahresumsatz von mehr als 20 Mio. US-Dollar mit kommerziellen Produkten und Diensten ist vorab eine schriftliche Genehmigung nötig | Bei einem annualisierten Umsatz von mehr als 1 Mio. US-Dollar (bei Ihnen und/oder verbundenen Unternehmen) ist vorab eine schriftliche Genehmigung nötig |
| Hosting-Dienste für Dritte | Angemessene Sicherheitsmaßnahmen sind erforderlich, und nachgelagerte Nutzer müssen auf die Nutzungsbeschränkungen verpflichtet werden | Für Hosting-Dienste an beliebige Dritte ist vorab eine schriftliche Genehmigung nötig |
| Kennzeichnung kommerzieller Produkte | MiniMax H3 muss in der Oberfläche deutlich sichtbar angezeigt werden | MiniMax-H3-Image muss in der Oberfläche deutlich sichtbar angezeigt werden |
| Outputs zur Verbesserung anderer KI-Modelle | Nicht erlaubt | Nicht erlaubt |
📌 Hinweis: Die obige Übersicht fasst die Lizenzbedingungen zusammen und ist keine Rechtsberatung. Details zu den regionalen Einschränkungen und weiteren Pflichten entnehmen Sie bitte den Original-LICENSE-Dateien. Wenn Sie zunächst nur die Qualität von Generierungs- und Dialogmodellen vergleichen möchten, können Sie über die einheitliche Schnittstelle von APIYI (apiyi.com) gängige Modelle aufrufen und Ihre Varianten gegeneinander testen. Danach entscheiden Sie, ob sich lokales Deployment und ein Genehmigungsantrag lohnen.
Die Grenzen bei H3: Kommerzielle Nutzung erlaubt, aber mit Pflichten
Innerhalb des Geltungsbereichs bietet H3 eine lizenzgebührenfreie, eingeschränkte Lizenz, die auch kommerzielle Nutzung erlaubt. Es gibt zwei echte Hürden: Bei einem Jahresumsatz von mehr als 20 Mio. US-Dollar brauchen Sie eine schriftliche Genehmigung. Und wenn Sie das Modell als Dienst für Dritte bereitstellen, müssen Sie Sicherheitsvorkehrungen treffen und die Nutzungsbeschränkungen an Ihre nachgelagerten Nutzer weitergeben.
Die Grenzen bei H3-Image: Hosting-Dienste sind eine harte Hürde
Die Bedingungen von H3-Image sind deutlich strenger. Die Schwelle für den annualisierten Umsatz liegt nur noch bei 1 Mio. US-Dollar. Außerdem brauchen Sie sobald Sie einem Dritten einen Hosting-Dienst anbieten, unabhängig von der Umsatzhöhe, vorab eine schriftliche Genehmigung. Die Lizenz nennt zugleich einen Kontaktweg zu MiniMax, über den sich eine gesonderte Lizenz beantragen lässt.
Für API-Plattformen, Modell-Hosting-Plattformen und SaaS-Entwickler heißt das: Aus „Die Gewichte lassen sich herunterladen“ folgt nicht „Ich darf das Modell deployen und eine öffentliche API anbieten“. Wie locker oder streng diese Grenze gezogen ist, unterscheidet sich bei H3 und H3-Image erheblich.
Auswirkungen der MiniMax-H3-Open-Source-Veröffentlichung auf Entwickler
Wer Offenheitsgrad der Module und Lizenz zusammen betrachtet, merkt schnell: Je nach Szenario unterscheidet sich der Spielraum für Entwickler erheblich.
| Einsatzszenario | Was möglich ist | Wichtigste Grenzen |
|---|---|---|
| Private Forschung und lokale Experimente | Gewichte herunterladen, lokale Inferenz, Architektur untersuchen, Weiterentwicklung | Klausel zum Ausschluss bestimmter Regionen; Ausgaben dürfen nicht zur Verbesserung anderer Modelle genutzt werden; hohe Hardware-Anforderungen |
| Kommerzielle Nutzung im Unternehmen | Lokale Bereitstellung, erzeugte Inhalte für das eigene Geschäft | Bei H3 gilt die Schwelle von 20 Mio. US-Dollar; bei H3-Image die Schwelle von 1 Mio. US-Dollar |
| Kommerzielle Produkte für Endnutzer | Integration in eigene Anwendungen | Der Name des jeweiligen Modells muss in der Oberfläche deutlich sichtbar angezeigt werden |
| API-Hosting für Dritte | H3 darf nach Erfüllung der Sicherheitspflichten angeboten werden | H3-Image erfordert vorab eine schriftliche Genehmigung |
| Vollständige Reproduktion des offiziellen Ergebnisses | Lokales 768p-Video, lokale Bilderzeugung plus PE | 2K-Video und Context-IR erfordern weiterhin die offizielle API |
Die tatsächliche Freiheit durch die Öffnung
Die Freiheit, die offene Gewichte bieten, ist handfest. Entwickler können offline bereitstellen, ihre Daten im internen Netz halten, die Struktur eines omnimodalen Modells mit 33B Parametern erforschen und die Vor- und Nachverarbeitung in lokalen Pipelines ersetzen oder anpassen. Beide Modelle werden mit vollständigen Inferenzkomponenten geliefert, was die Hürde für die Reproduktion durch die Community senkt.
Drei Ebenen von Grenzen, die bleiben
Die erste Ebene ist die Systemgrenze: Context-IR und Regenerate-2K gehören nicht zum offenen Umfang. Die zweite Ebene ist die Implementierungsgrenze: Der Sparse-Attention-Code von H3 war bei der Erstveröffentlichung nicht enthalten. Die dritte Ebene ist die Lizenzgrenze: Regionen, Umsatz, Hosting-Dienste und Kennzeichnungspflichten bestimmen gemeinsam, ob eine kommerzielle Nutzung möglich ist.
Offene Gewichte und Cloud-API existieren deshalb nebeneinander. GPU-Beschaffung, Inferenzoptimierung, Scheduling bei hoher Parallelität, Verbesserung der Eingabeaufforderung und Compliance-Prüfung – diese Kosten verschwinden nicht, nur weil die Gewichte offen sind. Für viele Teams ist es der solidere Weg, den Geschäftsbedarf zunächst über eine Aggregationsplattform wie APIYI (apiyi.com) zu validieren und erst danach zu prüfen, ob sich ein Eigenbetrieb lohnt.
Beispiel für den vorgelagerten Schritt im lokalen MiniMax-H3-Workflow
Da Context-IR nicht offen zugänglich ist, müssen Sie den Schritt zur Aufbereitung der Eingabe beim lokalen Betrieb von H3-Base selbst ergänzen. Üblich ist es, mit einem allgemeinen Großen Sprachmodell zunächst eine kurze Idee zu einer strukturierten Beschreibung auszubauen und diese dann an das lokale Modell zu übergeben. Beachten Sie: Das ist nur ein technischer Ersatzansatz, die Ergebnisse sind nicht mit dem offiziellen Context-IR gleichzusetzen.
Minimalbeispiel
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "system", "content": "把简短视频创意扩写为详细镜头描述,包含主体、动作、镜头、光线和声音。"},
        {"role": "user", "content": "雨夜街头,一只猫跳上霓虹灯招牌"}
    ]
)
print(resp.choices[0].message.content)
Vollständigen Code anzeigen
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = """你是视频生成提示词工程师。
请把用户的简短创意扩写为 JSON,字段包括:
- prompt: 详细的画面与动作描述
- camera: 镜头运动
- audio: 环境声与音乐描述
- duration: 视频时长(秒,取值 4 到 15)
只输出 JSON。"""

def build_context(idea: str, model: str = "gpt-4o-mini") -> dict:
    """Bereitet die Eingabe mit einem allgemeinen Großen Sprachmodell auf, als vorgelagerter Schritt für das lokale H3-Base"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": idea},
        ],
        response_format={"type": "json_object"},
    )
    ctx = json.loads(resp.choices[0].message.content)
    # Dauer gemäß offizieller H3-Spezifikation auf 4–15 Sekunden begrenzen
    ctx["duration"] = max(4, min(15, int(ctx.get("duration", 5))))
    return ctx

if __name__ == "__main__":
    ctx = build_context("雨夜街头,一只猫跳上霓虹灯招牌")
    print(json.dumps(ctx, ensure_ascii=False, indent=2))
    # Nächster Schritt: ctx an Ihren lokalen H3-Base-Inferenzablauf übergeben
    # (siehe das FL2VA-Inferenzbeispiel im offiziellen GitHub-Repository)
🚀 Schnellstart: Reicht Ihr lokaler Grafikspeicher nicht aus, können Sie sich über APIYI (apiyi.com) ein kostenloses Testkontingent holen und damit den Schritt zur Aufbereitung der Eingabeaufforderung durchspielen. Die Plattform bietet eine OpenAI-kompatible Schnittstelle: Mit einem einzigen API-Schlüssel wechseln Sie zwischen verschiedenen Modellen und können so bequem vergleichen, welches sich am besten für die vorgelagerte Erweiterung eignet.
MiniMax H3 Open Source: Häufige Fragen (FAQ)
Q1: Ist MiniMax H3 wirklich Open Source?
Treffender ist die Bezeichnung „Modell mit offenen Gewichten“. Die Gewichte und das Inferenzmaterial von H3-Base sind offen, Context-IR und Regenerate-2K dagegen nicht. Außerdem gilt eine restriktive Community License statt MIT oder Apache 2.0.
Q2: Haben MiniMax H3 und H3-Image dieselbe Lizenz?
Nein. Der regionale Ausschluss ist bei beiden gleich, aber die Umsatzschwelle unterscheidet sich: Bei H3 liegt sie bei einem Jahresumsatz von über 20 Millionen US-Dollar, bei H3-Image bei einem hochgerechneten Jahresumsatz von über 1 Million US-Dollar. Wer H3-Image als gehosteten Dienst für Dritte anbieten will, braucht vorab eine schriftliche Genehmigung. Bei H3 müssen stattdessen Schutzmaßnahmen und Auflagen für nachgelagerte Nutzer umgesetzt werden.
Q3: Bekomme ich 2K-Videos, wenn ich nur H3-Base deploye?
Nein. Das lokale H3-Base gibt standardmäßig Videos mit 768 px an der kurzen Seite aus. Für 2K-Ausgaben braucht man die offiziellen APIs Context-IR und Regenerate-2K.
Q4: Kann H3-Image-PE Context-IR ersetzen?
PE ist die offizielle lokale Lösung zur Verbesserung von Eingabeaufforderungen. Man kann sie separat herunterladen und betreiben, aber sie entspricht nicht dem gesamten mehrstufigen, gehosteten Workflow von Context-IR. Wer nah an die offizielle Qualität herankommen will, muss selbst testen und feinjustieren.
Q5: Die Hürden für das lokale Deployment sind hoch – gibt es Alternativen?
Allein das Hauptmodell von H3-Image samt Text-Encoder belegt rund 135,35 GB Speicher. Offiziell unterstützte Hardware sind vor allem Rechenzentrums-GPUs wie H200 oder MI350X. Wenn Sie vorerst nur ein Konzept validieren wollen, können Sie über APIYI (apiyi.com) bereits verfügbare gängige Modelle mit einer einheitlichen Schnittstelle aufrufen und die Ergebnisse schnell vergleichen. Danach lässt sich besser beurteilen, ob sich ein eigenes Setup lohnt.
Q6: Darf ich die Ausgaben von H3 nutzen, um eigene Modelle zu trainieren?
Nein. Beide Lizenzen verbieten es, das Modell oder seine Ausgaben zu nutzen, um andere KI-Modelle zu verbessern. Bevor Sie Daten synthetisieren oder destillieren, sollten Sie unbedingt den Originaltext der Lizenz prüfen.
MiniMax H3 Open Source: Die wichtigsten Punkte (Key Takeaways)
- Nur eines von drei Modulen ist offen: H3-Base ist freigegeben, Context-IR und Regenerate-2K bleiben weiterhin die offizielle API.
- Checkpoints vollständig: FL2VA und Ref2VA enthalten jeweils Tokenizer, VAE und weitere Inferenzkomponenten.
- Lokal ist bei 768p Schluss: Der vollständige 2K-Video-Workflow hängt vom offiziellen Cloud-Dienst ab.
- Sparse Attention folgt noch: Der erstmals veröffentlichte Inferenzcode enthält nur Full Attention.
- Zwei Lizenzen mit unterschiedlichen Schwellen: Bei H3 liegt die Schwelle bei 20 Millionen US-Dollar, bei H3-Image bei 1 Million US-Dollar.
- Gehostete Dienste sind die rote Linie: Wer H3-Image als gehosteten Dienst für Dritte anbieten will, braucht vorab eine schriftliche Genehmigung.
- Erst prüfen, dann selbst hosten: Über die einheitliche Schnittstelle von APIYI (apiyi.com) lässt sich der Bedarf im Unternehmen kostengünstig validieren.
Fazit
Die wichtigsten Punkte zur Open-Source-Freigabe von MiniMax H3:
- Freigegeben ist das zentrale Generierungsmodell: H3-Base und das Hauptmodell H3-Image lassen sich herunterladen und selbst betreiben, die Inferenzkomponenten sind vollständig dabei.
- Der Cloud-Dienst bleibt Teil des Systems: Context-IR und Regenerate-2K bestimmen, wie gut das Gesamtergebnis am Ende wird.
- Die Lizenz legt die Grenzen der kommerziellen Nutzung fest: Die beiden Community Licenses haben unterschiedliche Bedingungen, und H3-Image stellt deutlich strengere Anforderungen an gehostete Dienste.
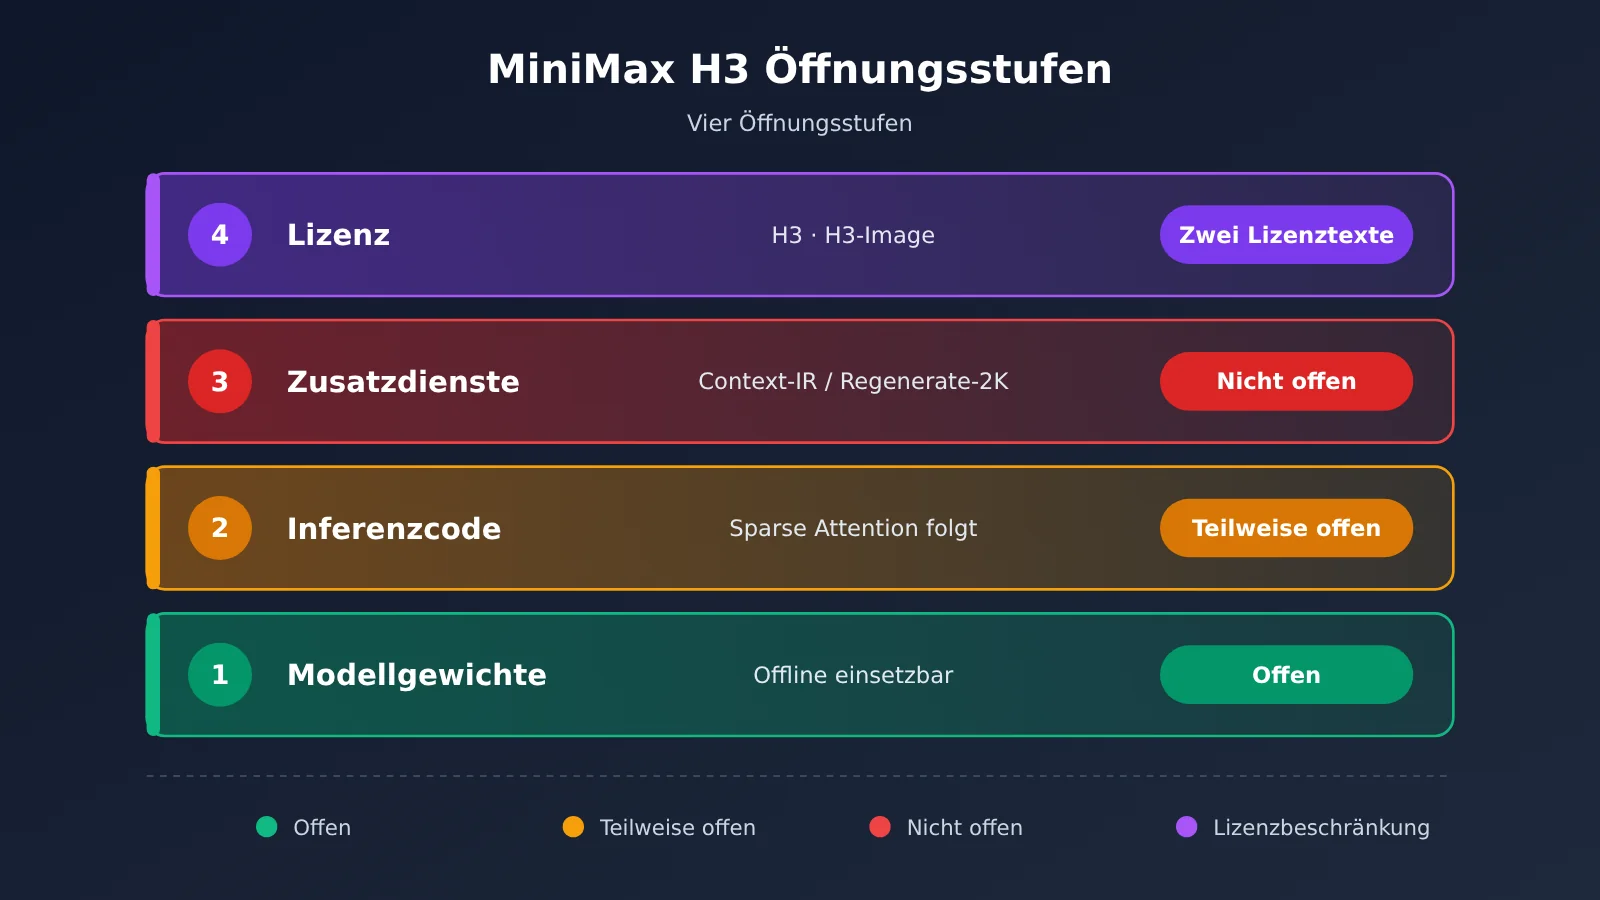
Wie offen ein Modell wirklich ist, zeigt sich nicht allein daran, ob man die Gewichte herunterladen kann. Ihr solltet vier Dimensionen prüfen: Komponenten, Inferenzcode, begleitende Dienste und Lizenz. MiniMax zeigt sich hier durchaus großzügig. Bevor ihr aber deployt oder kommerziell einsetzt, solltet ihr diese vier Ebenen Punkt für Punkt abklopfen.
Wenn ihr gerade generative Lösungen evaluiert, empfehlen wir, zuerst über APIYI (apiyi.com) mit dem kostenlosen Kontingent die Geschäftskette schnell zu validieren. Erst danach lohnt sich die Entscheidung für ein lokales Deployment und einen Lizenzantrag.
📚 Referenzen
- Offizielle Open-Source-Ankündigung von MiniMax H3: Aufteilung in drei Module und Erläuterung zu Sparse Attention
- Link:
minimax.io/news/minimax-h3-open-source -
Beschreibung: Die Primärquelle, um Systemaufbau und Umfang der Freigabe von H3 zu verstehen
-
Hugging Face – MiniMax-H3-Modell-Repository: FL2VA- und Ref2VA-Checkpoints sowie Komponenten
- Link:
huggingface.co/MiniMaxAI/MiniMax-H3 -
Beschreibung: Enthält die gemeinsam genutzten Gewichte des Qwen3-VL-Text-Encoders
-
Originaltext der MiniMax H3 Community License
- Link:
huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/LICENSE -
Beschreibung: Maßgeblich für Umsatzschwelle, geografischen Geltungsbereich und Pflichten für nachgelagerte Nutzung
-
Hugging Face – MiniMax-H3-Image-Modell-Repository: Komponentenliste und Hinweise zum Deployment
- Link:
huggingface.co/MiniMaxAI/MiniMax-H3-Image -
Beschreibung: Die offizielle Model Card, inklusive Herstellerangaben wie dem Limit für Referenzbilder
-
Originaltext der MiniMax H3-Image Community License
- Link:
huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE -
Beschreibung: Lizenzierung für gehostete Dienste und die Klausel zur Schwelle von 1 Million US-Dollar
-
vLLM-Deployment-Rezept – MiniMax-H3-Image
- Link:
recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image -
Beschreibung: Testkonfiguration auf Framework-Seite; das Limit für Referenzbilder ist dort anders angegeben als in der Model Card
-
GitHub – MiniMax-H3-Quellcode und Deployment-Material
- Link:
github.com/MiniMax-AI/MiniMax-H3 - Beschreibung: Beispiele für lokale Inferenz und Deployment-Skripte
Autor: APIYI-Technikteam
Austausch: Schreiben Sie uns gerne über die Startseite von APIYI. Weitere Informationen zur Anbindung finden Sie im Dokumentationscenter unter docs.apiyi.com