Anmerkung des Autors: Dieser Artikel basiert auf einem öffentlichen Vortrag im Rahmen der YC Paper Club Harness Night und fasst eine praxistaugliche Methode zur Modell-Evaluierung zusammen. Sie hilft Teams dabei, zu unterscheiden, ob ein Score-Unterschied vom Modell oder vom Harness stammt.
Derselbe Claude Opus erreicht auf einem privaten Holdout-Set einen Bestwert von 30 %; in Prime Agent sind es laut dem öffentlichen Vortrag 95,5 %. Wer nur auf Ranglisten schaut, könnte annehmen, das Modell habe sich fundamental verändert. Doch diese Zahlen erinnern uns zuerst an etwas anderes: Bei der Modell-Evaluierung vergleicht man oft das gesamte System und nicht nur das Modell.
Dies ist kein Artikel, der Ihnen davon abrät, Ranglisten zu nutzen, und auch keine Behauptung, Harness könne jedes Modell beliebig nach oben treiben. Für diesen Artikel wurden keine unabhängigen Nachmessungen durchgeführt; die zitierten Ergebnisse stammen aus den von InfoQ aufbereiteten Vortragsinhalten. Im Mittelpunkt steht, die dortigen Erfahrungen in einen ausführbaren Evaluierungsprozess zu übersetzen.
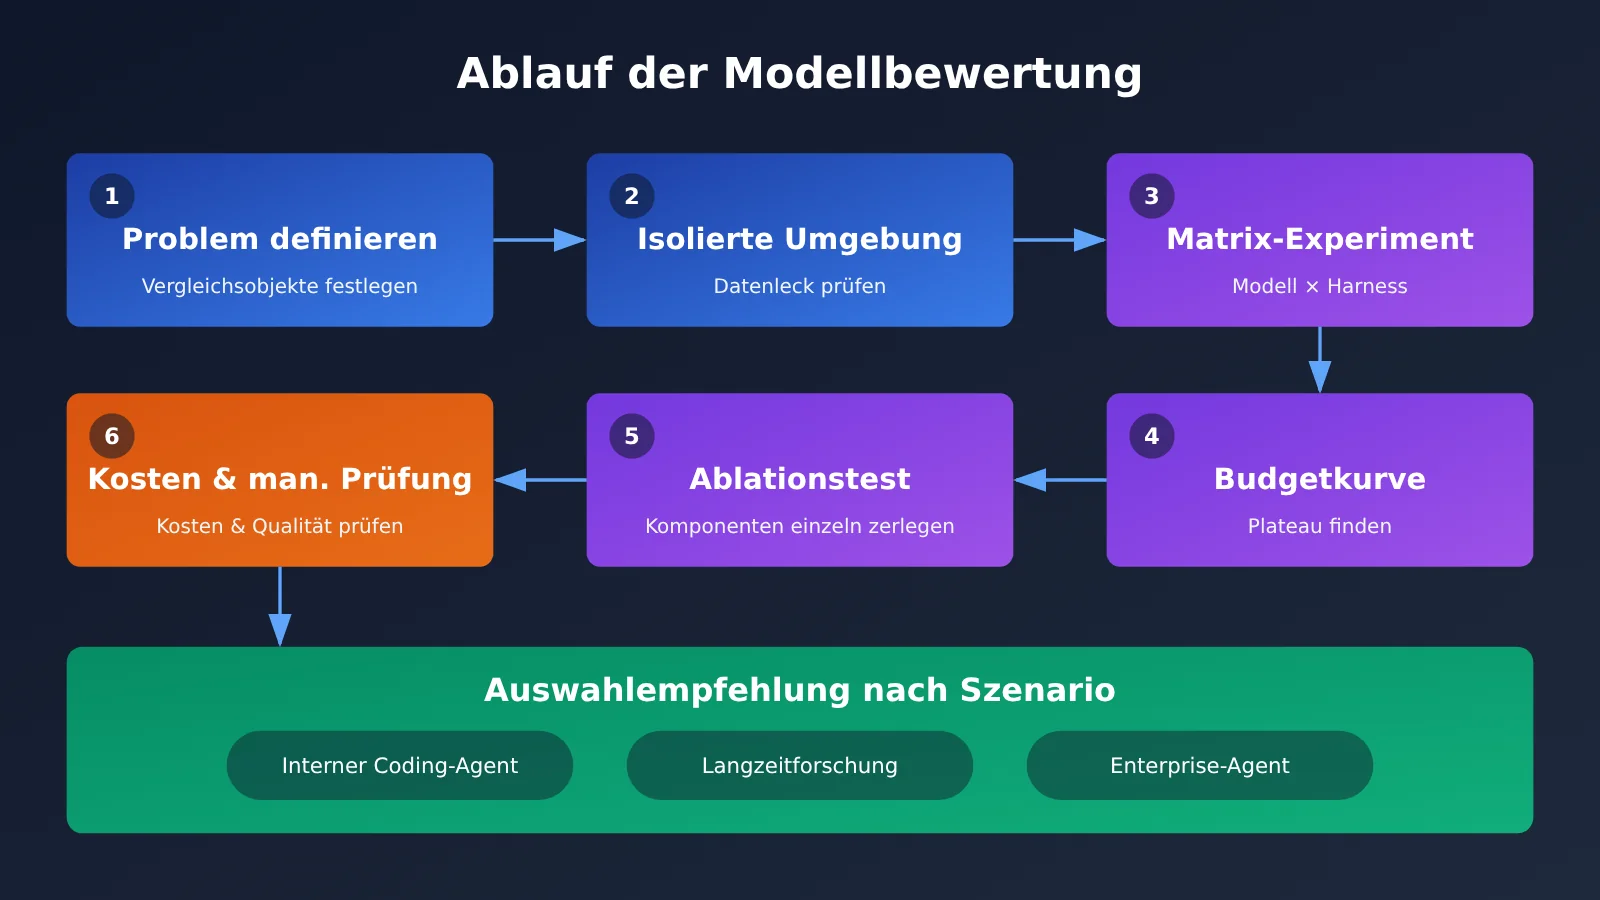
Der Kernnutzen: Nach der Lektüre wissen Sie, wie Sie in sechs Schritten ein kontrolliertes Experiment mit Modell und Harness entwerfen, die Ursache von Score-Unterschieden bestimmen und zu einer verlässlicheren Auswahlentscheidung gelangen.
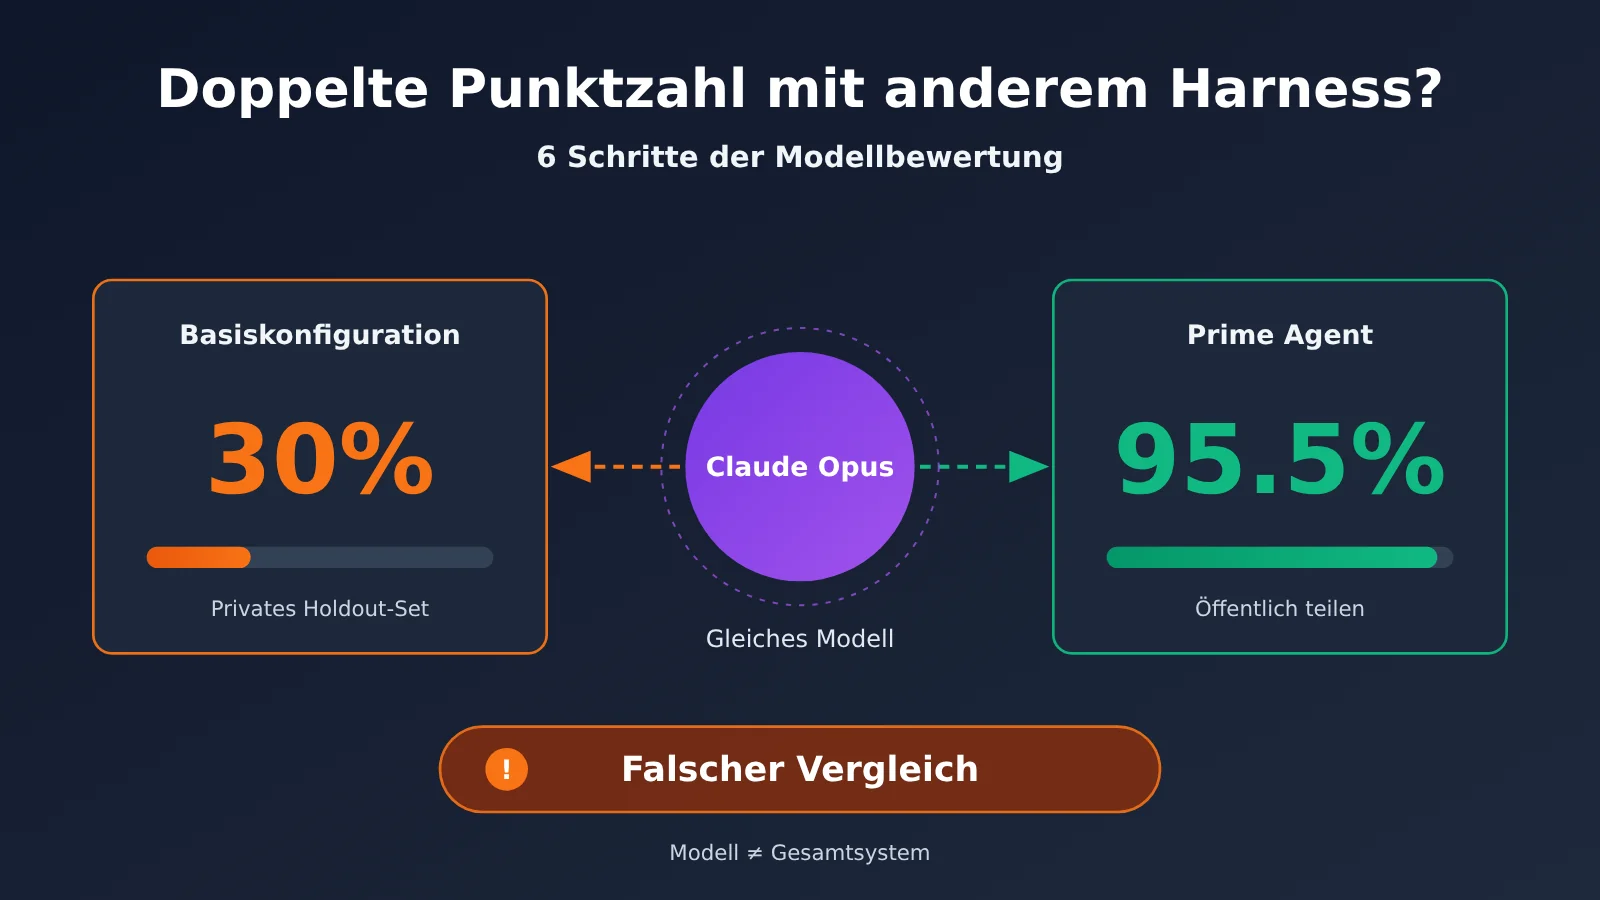
Harness wechseln, Punktzahl verdoppeln: Die Kernpunkte der Modellbewertung
Ein Harness ist eine Systemschicht zwischen dem LLM und der Außenwelt. Er stellt persistente Zustände, Tools und Rechenkapazität bereit. Seth Karten hat dafür einen Vergleich gefunden: Ein nacktes LLM gleicht einer Turing-Maschine, ein Harness dagegen einem Von-Neumann-Rechner, der externen Speicher lesen und beschreiben kann. Bei der Bewertung eines Agents wirken die Schlussfähigkeit des Modells und die Ausdrucksstärke dieser Schicht gleichzeitig auf das Ergebnis ein.
Die folgende Tabelle listet einige der im Vortrag genannten öffentlichen Daten zu ARC-AGI auf. Diese Ergebnisse stammen von unterschiedlichen Modellen, Harnesses oder Evaluationskonfigurationen und lassen sich nicht direkt als Modell-Ranking lesen.
| Konfiguration | Veröffentlichtes Ergebnis | Worauf man beim Lesen achten sollte |
|---|---|---|
| Claude Opus, Validierung auf privatem Holdout-Set | Bestwert 30% | Das ist die Baseline aus dem Vortrag und gilt nicht für alle Ausführungsbedingungen |
| Prime Agent + Opus | 95,5% | Die Unterlagen legen nicht Punkt für Punkt alle Unterschiede zur Baseline offen; es wäre unangemessen, das Ergebnis nur einer einzigen Variable zuzuschreiben |
| Prime Agent + GPT-5.6 Sol | 78% | Dieses Ergebnis wurde nach abgeschlossener Sandbox-Isolierung erzielt |
| Prime Agent + GPT-5.6 Terra | 25,7% | Unter demselben Harness bleibt der Abstand zwischen den Modellen deutlich |
| Nvidia AVO | 100% | Der Vortrag nennt nur das Ergebnis; vor einem Vergleich muss die konkrete Konfiguration geprüft werden |
Das Verhältnis von Harness und Modellbewertung
Prime Agent teilt den Kontext in drei Ebenen: L1 sind die Modellgewichte, L2 ist der aktive Kontext plus REPL, L3 sind Scheduling-Zustände wie das Dateisystem. Der Harness übernimmt zwischen den Ebenen Kompression, CRUD-Operationen und Refinement – seine Wirkung ähnelt einem Cache plus Garbage Collection. Das heißt: Wechselt dasselbe Modell auf einen anderen Harness, können sich die nutzbaren Gedächtnis- und Rechenkapazitäten verändern.
Das bedeutet aber nicht, dass das Modell unwichtig wäre. Prime Agent schneidet bei ARC-AGI herausragend ab, bei langzyklischen Evaluierungen wie Oolong und Emulator Bench ist es dagegen überwiegend gleichauf oder nur etwas besser, und bei GPU-Kernel-Aufgaben liegt es ebenfalls ungefähr gleichauf. Der Aufgabentyp entscheidet darüber, wie stark ein Harness Unterschiede vergrößern kann, deshalb lässt sich ein einzelnes Ergebnis nicht auf alle Szenarien übertragen.
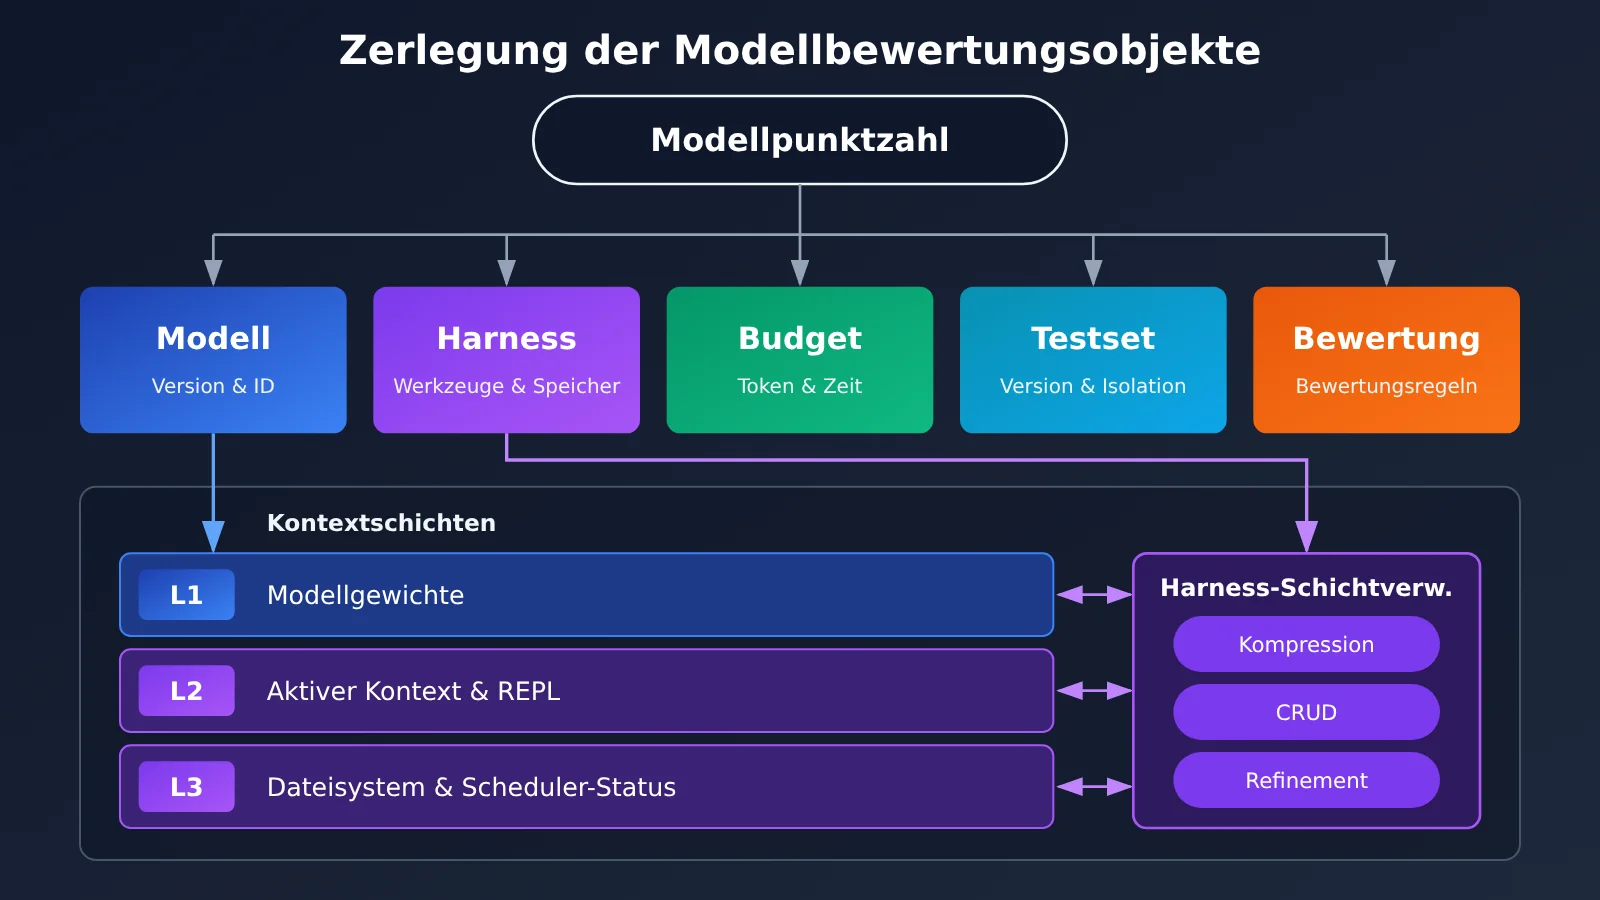
Die 5 Variablen, bei denen Modellvergleiche am häufigsten schiefgehen
| Variable | Häufiger Fehlvergleich | Was dokumentiert werden sollte |
|---|---|---|
| Modell | Nur der Serienname, nicht die konkrete Version | Modell-ID, tatsächliche Aufrufprotokolle, Fälle von Fallback oder Wechsel |
| Harness | Die Standardkonfiguration als Modellfähigkeit behandeln | Tools, System-Eingabeaufforderung, Sub-Agenten, Gedächtnis- und Kompressionsmechanismen |
| Budget | A läuft bis zum Plateau, B stoppt vorzeitig | Token, tatsächliche Zeit, Kosten, Abbruchbedingungen |
| Evaluationsset | Ergebnisse auf einem öffentlichen Set mit Ergebnissen auf einem privaten Set vergleichen | Datensatzversion, Isolationsmethode, mögliche Informationslecks |
| Bewertungsmethode | Nur das LLM beurteilen lassen, ob Fix oder Antwort erfolgreich war | Bewertungsregeln, Anteil manueller Stichproben, strittige Beispiele |
Praxistipp: Wenn Sie mehrere Modelle in derselben Evaluationspipeline vergleichen möchten, können Sie die hier behandelten Modelle über APIYI apiyi.com aufrufen und so Unterschiede bei der Anbindung reduzieren. APIYI ist mit den Schnittstellenformaten von OpenAI und Anthropic kompatibel; die konkreten Modellnamen und Anbindungswege entnehmen Sie bitte der Dokumentation unter docs.apiyi.com.
Harness-Modellbewertung schnell einsteigen: 6 Schritte
Der folgende Ablauf eignet sich für Modellauswahl, Agent-Upgrades und interne Benchmark-Tests. Du musst nicht von Anfang an eine riesige Evaluierungsplattform aufbauen – erfasse zuerst alle Variablen vollständig und erweitere dann schrittweise Aufgaben und Modelle.
Schritt 1: Den Vergleichsgegenstand der Modellbewertung klar definieren
Definiere die Experimentfrage zunächst in einem Satz, zum Beispiel „Unter demselben Harness und Budget die Fähigkeit zweier Modelle vergleichen, interne Coding-Aufgaben zu erledigen“. Wenn die Frage lautet „Welcher Agent ist besser“, dann ist der Vergleichsgegenstand die Kombination aus Modell und Harness, und das Ergebnis darf auch nicht als „Welches Modell ist stärker“ formuliert werden.
Die Evaluierungsspezifikation muss mindestens model, die System-Eingabeaufforderung, die Werkzeugliste, max_tokens, die maximale Rundenzahl und das Gesamtbudget fixieren. Wenn der Harness dem Agent erlaubt, die Laufzeitumgebung selbstständig zu wählen, muss außerdem dokumentiert werden, welches Modell in jedem Schritt tatsächlich verwendet wurde. Das Design von QM erlaubt es dem Agent beispielsweise, bei einer Ablehnung auf ein anderes Modell zu wechseln – in diesem Fall gehört die endgültige Punktzahl nicht mehr zu einem einzelnen Modell.
Schritt 2: Evaluationsumgebung und Daten des Harness isolieren
Seth hatte einmal die System-Eingabeaufforderung der Community-Rangliste in Prime Agent eingesetzt und beim ersten Lauf 99,9 % erzielt. Als er die Logs prüfte, stellte er fest, dass er sich damit selbst betrog, und verbrachte anschließend einen Tag mit Sandbox-Isolierung – danach lag GPT-5.6 Sol bei 78 %. Ein hohes Ergebnis ist nicht zwangsläufig falsch, aber bei ungewöhnlich hohen Werten muss man zuerst die Logs prüfen.
Bei der Prüfung sind drei Punkte entscheidend: Kann der Agent die Antworten oder frühere Ergebnisse lesen, enthält die Eingabeaufforderung Informationen, die ausschließlich zum Evaluationsset gehören, und gehen die Tool-Aufrufe über die vorgesehenen Berechtigungen hinaus. Bei Aufgaben außerhalb öffentlicher Benchmarks sollte man zusätzlich eine Holdout-Stichprobe zurückhalten, die nicht ins Tuning einfließt, damit Eingabeaufforderung und Harness nicht überangepasst werden.
Schritt 3: Mit der Matrix „Modell × Harness“ vergleichen
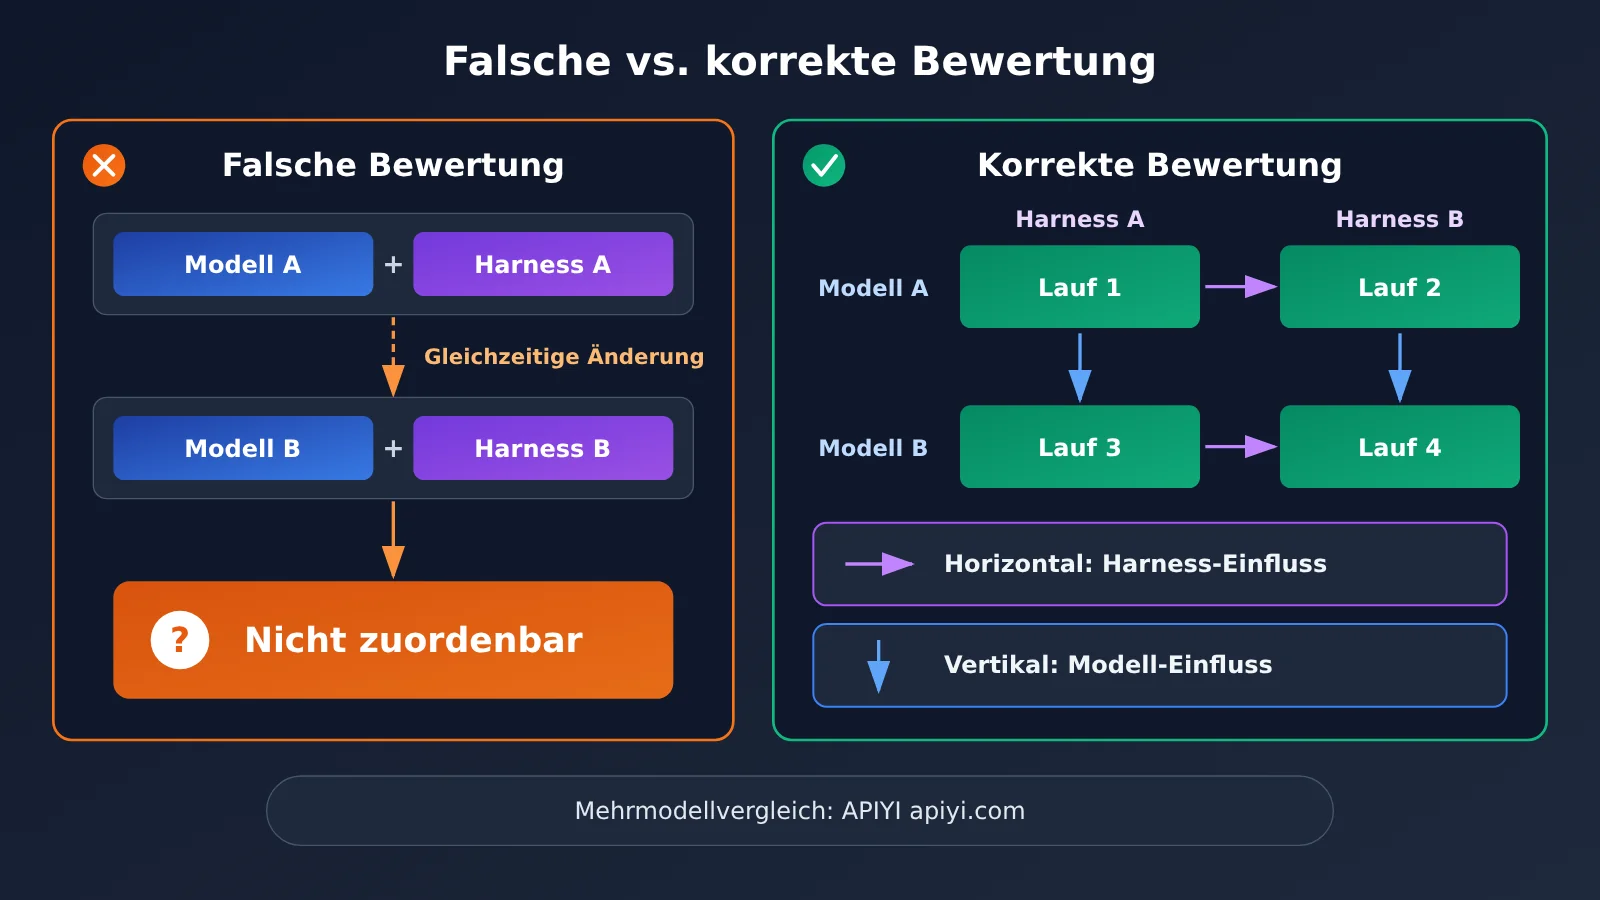
Lass nicht einfach nur „Modell A + Harness A“ und „Modell B + Harness B“ laufen, denn wenn sich zwei Variablen gleichzeitig ändern, lässt sich das Ergebnis nicht mehr zuordnen. Der minimale Ansatz ist eine 2 × 2-Matrix: zwei Modelle laufen jeweils in zwei Harness-Varianten, bei identischem Aufgabenset und identischem Budget.
| Matrixergebnis | Wahrscheinlichere Erklärung | Nächster Schritt |
|---|---|---|
| Modellwechsel bringt deutliche Veränderung, Harness-Wechsel wenig | Die aktuelle Aufgabe hängt stärker von den Modellfähigkeiten ab | Zuerst die Modellauswahl angehen |
| Harness-Wechsel bringt deutliche Veränderung, Modellwechsel wenig | Die Systemfähigkeit ist der Hauptengpass | Zuerst Tools und Kontextmanagement verbessern |
| Beide beeinflussen sich deutlich gegenseitig | Zwischen Modell und Harness gibt es eine Passungsbeziehung | Nach Kombination auswählen, kein einzelnes Ranking schreiben |
| Bei beiden keine deutliche Veränderung | Aufgabe zu einfach, zu schwer oder die Bewertung zu unempfindlich | Evaluationsset und Metriken neu designen |
Hinweis zu Kontrollexperimenten: Für Matrixexperimente muss man häufig das Modell wechseln. Über APIYI apiyi.com kannst du verschiedene Modelle mit einem einheitlichen Account und einer einheitlichen Schnittstellenkonfiguration aufrufen und dabei die Modell-ID im Versuchsprotokoll festhalten, damit sich später alles nachvollziehen lässt.
Schritt 4: Budgets angleichen und Leistungsplateaus des Modells beobachten
Seth weist in seinem Beitrag darauf hin: Wenn ein Modell nicht lange genug läuft oder nach dem Aufbrauchen des Budgets stoppt, während ein anderes Modell weiterarbeitet, dann vergleichst du nicht bei gleichen Kosten und verdeckst zugleich die tatsächliche Leistung. Sinnvoller ist es, mehrere Budgetpunkte festzulegen und die Kurve zu beobachten, wie der Score mit Token oder Zeit steigt.
Die Erfahrung des QM-Teams zeigt ebenfalls, wie wichtig das Budget ist. Ihnen fiel auf, dass Agenten oft zu früh aufgeben. Deshalb versuchten sie, die Werkzeuge zu schärfen: Für das Ziel wurde ein Budget festgelegt, und ein Abbruch war erst erlaubt, wenn die tatsächliche Zeit oder der Tokenverbrauch erreicht war. Dadurch wurden die Forschungsergebnisse besser. Die Evaluationsspezifikation sollte daher nicht nur eine Obergrenze für das Budget nennen, sondern auch klar angeben, ob es eine Mindestaufwandsanforderung gibt.
Schritt 5: Den Harness einem Ablationstest unterziehen
Nachdem du gesehen hast, dass der Harness eine Verbesserung bringt, besteht der nächste Schritt darin, herauszufinden, welche Fähigkeit die Verbesserung bewirkt. Prime Agent legt Wert auf Ausdrucksstärke und ist der Auffassung, dass Kompression, Python-REPL, programmatische Sub-Agenten, Zustandszugriff und Feedback-Mechanismen nicht vorschnell entfernt werden sollten. Bei deiner Aufgabe musst du jedoch den tatsächlichen Beitrag jeder Fähigkeit testen.
Die Vorgehensweise: Schalte jeweils nur eine Fähigkeit ab, zum Beispiel die REPL, die Sub-Agenten oder das Langzeitgedächtnis, und lasse die übrige Konfiguration unverändert. Bleibt der Score danach im Wesentlichen gleich, während die Kosten deutlich sinken, ist es möglicherweise nicht sinnvoll, diese Fähigkeit vorerst beizubehalten. Bei Aufgaben mit hoher Varianz wie der automatisierten Forschung musst du mehrere Läufe wiederholen, denn auch Seth erwähnt, dass sich solche Aufgaben nur schwer direkt auf den Harness oder das Modell zurückführen lassen.
Schritt 6: Kosten kalkulieren und manuelle Prüfung ergänzen
Seth erwähnte außerdem, dass er bei der Auswertung mit Hermes Agent schnell 5.000 US-Dollar ausgegeben habe, ohne eine erkennbare Verbesserung zu sehen, und abbrechen musste. Das sagt nichts über die Leistungsobergrenze von Hermes Agent aus, zeigt aber deutlich, dass das Kosten-Leistungs-Verhältnis in die Bewertungsergebnisse einfließen sollte. Der Abschlussbericht sollte daher Erfolgsquote, Bearbeitungszeit, Token-Verbrauch und Kosten pro erfolgreichem Lauf gemeinsam ausweisen.
Schreiben Sie die Preise bei der Kostenberechnung nicht fest in die Dokumentation des Evaluierungsskripts. Für Eingabe- und Ausgabepreise, Cache-Preise und Abrechnungslogik des Modells sollten die tatsächlichen Daten der APIYI-Preisseite https://docs.apiyi.com/models maßgeblich sein; geben Sie im Bericht außerdem das Abfragedatum an.
Auch bei der Bewertung sollte eine manuelle Stichprobenprüfung beibehalten werden. Das QM-Team hat festgestellt, dass LLMs bei der Bewertung von Korrekturen unter dem „Protagonisten-Syndrom“ leiden: Sie sehen nur einen Teil des Elefanten und nicht das gesamte System. Bei Geschäftsprozessen müssen außerdem Berechtigungsgrenzen getestet werden, denn Agenten verstehen soziale Situationen schlechter, und privilegierte Informationen könnten in Kontexte gelangen, in denen sie nicht auftauchen dürfen.
Wie man die Modellbewertungsmatrix mit APIs umsetzt
Für die praktische Umsetzung empfiehlt es sich, die Evaluierung in drei Teile zu zerlegen: Aufgaben-Set, Laufkonfiguration und Ergebnisprotokoll. Wenn Sie das Modell oder den Harness wechseln, müssen Sie dann nur einen Konfigurationspunkt ändern, statt den gesamten Ablauf neu zu schreiben.
| Konfigurationspunkt | Empfohlene Angaben | Beschreibung |
|---|---|---|
| Schnittstellenformat | OpenAI-kompatibel oder Anthropic-Format | Bei unterschiedlichen Formaten können sich Tool-Aufrufe und Nachrichtenstruktur unterscheiden; separat validieren |
| Zugriffsadresse und Schlüssel | base_url, Name der Umgebungsvariable |
Adresse gemäß docs.apiyi.com; Schlüssel nicht in den Bewertungsbericht schreiben |
| Laufparameter | model, max_tokens, maximale Runden, Wiederholungen |
Sicherstellen, dass jedes Experiment reproduzierbar ist |
| Kostenbasis | Eingabe, Ausgabe, Cache und Abfragedatum | Maßgeblich sind die tatsächlichen Daten der APIYI-Preisseite docs.apiyi.com/models |
| Laufergebnisse | Punktzahl, Fehlerursache, Token, Dauer, Aufrufprotokoll | Dient zur Analyse von Plateauphasen und des Kosten-Leistungs-Verhältnisses |
Wenn Ihr Harness beide Schnittstellen unterstützt, sollten Sie zunächst mit demselben Modell einen Formatvergleich durchführen. So lässt sich prüfen, ob Nachrichtenkonvertierung, Tool-Definitionen und Streaming-Rückgaben die Ergebnisse beeinflussen, und vermeiden, dass Integrationsprobleme fälschlich als Unterschiede in der Modellleistung interpretiert werden.
Integrationshinweis: APIYI bietet API-Aufrufe für die in diesem Artikel behandelten Modelle und ist mit den Schnittstellenformaten von OpenAI und Anthropic kompatibel. Prüfen Sie vor Beginn des Experiments auf docs.apiyi.com, welche Modelle aktuell verfügbar sind und wie sie aufgerufen werden, und tragen Sie anschließend die Modell-ID in die Evaluierungsspezifikation ein.
Häufig gestellte Fragen (FAQ)
F1: Was ist ein Harness in der Modellbewertung?
Ein Harness ist die Systemschicht, die das Modell mit der Außenwelt verbindet. Sie umfasst in der Regel Schleifensteuerung, Kontextverwaltung, Tools, Sub-Agenten, Gedächtnis und Zustandszugriff. Der Harness bestimmt, was das Modell sehen kann, was es aufrufen kann und wie lange es laufen darf.
F2: Bedeutet ein höherer Harness-Score, dass das Modell leistungsfähiger geworden ist?
Nein. Bei unveränderten Gewichten deutet ein höherer Score eher darauf hin, dass das System mehr Fähigkeiten freisetzt oder die Konfiguration besser zu dieser Aufgabe passt. Wenn sich Harness, Budget und Modell gleichzeitig ändern, lässt sich die Ursache nicht isoliert zuordnen – es könnte auch ein Leck in der Evaluierungsumgebung vorliegen.
F3: Wann sollte eine Modellbewertung neu durchgeführt werden?
Immer wenn sich die Modellversion, die System-Eingabeaufforderung, die Tool-Berechtigungen, die Komprimierungsstrategie oder die Geschäftsaufgabe ändern, sollte neu bewertet werden. Der Harness-Bereich entwickelt sich schnell; die Daten in diesem Artikel stammen aus einer Zusammenstellung, die InfoQ im November 2026 veröffentlicht hat, und die Ergebnisse können sich später ändern.
F4: Für welche Szenarien eignet sich diese Methode der Modellbewertung?
Sie eignet sich vor allem für folgende Szenarien:
– **Auswahl interner Coding-Agenten**: Vergleich der Aufgabenabschlussrate von Modell- und Harness-Kombinationen.
– **Langfristige Forschungsaufgaben**: Beobachtung der Plateauphase und der Ergebnisvarianz nach einer Budgeterhöhung.
– **Validierung vor dem Produktivstart von Unternehmens-Agenten**: gleichzeitige Prüfung von Qualität, Kosten und Berechtigungsgrenzen.
F5: Wie binde ich schnell mehrere Modelle für einen Harness-Vergleich ein?
Zunächst legen Sie die Bewertungsaufgaben und die Liste der Modelle fest und binden sie dann über APIYI apiyi.com ein. Die Plattform bietet API-Aufrufe für die in diesem Artikel behandelten Modelle und ist mit den Schnittstellenformaten von OpenAI und Anthropic kompatibel. Die konkreten Modell-IDs und Konfigurationsmethoden finden Sie in der Dokumentation unter docs.apiyi.com; halten Sie während des Experiments die übrigen Variablen konstant.
F6: Wie sollten Modellpreise in einem Bewertungsbericht angegeben werden?
Es empfiehlt sich, nur verifizierte Preisdaten zu zitieren und das Abrufdatum anzugeben. Die Einzelpreise für Eingabe und Ausgabe, die Cache-Preise und die Abrechnungsgrundlage der Modelle sollten den tatsächlichen Daten auf der APIYI-Preisseite https://docs.apiyi.com/models entsprechen; verwenden Sie keine veralteten Tabellen oder Schätzwerte.
F7: Welche Einschränkungen hat diese Harness-Bewertungsmethode?
Matrix-Experimente, wiederholte Läufe und manuelle Überprüfungen erhöhen Zeit- und Kostenaufwand. Auch die Varianz bei langfristigen Aufgaben kann hoch sein; selbst bei Kontrolle der wichtigsten Variablen ist eine präzise Zuordnung schwierig. Deshalb eignet sich die Methode eher zur Entscheidungsunterstützung – ein einzelnes Ergebnis sollte nicht als absolute Rangliste betrachtet werden.
Harness-Modellbewertung: die wichtigsten Erkenntnisse (Key Takeaways)
- Zuerst das Vergleichsobjekt definieren: Klar trennen, ob Modelle verglichen werden – oder die Kombination aus Modell und Harness.
- Bei ungewöhnlich hohen Scores zuerst die Logs prüfen: In 99,9 % der Fälle zeigt sich, dass eine isolierte Umgebung die Voraussetzung für die Bewertung ist.
- Variablen mit einer Matrix trennen: Mehrere Modelle über APIYI anbinden und dann Modell × Harness gegenüberstellen.
- Budget muss vergleichbar sein: Die Kurve an mehreren Budgetpunkten beobachten, um das tatsächliche Plateau zu finden.
- Beitrag per Ablation lokalisieren: Jeweils eine Fähigkeit abschalten und prüfen, woher die Verbesserung wirklich kommt.
- Kostendaten überprüfen: Preise und Abrechnungslogik gelten gemäß der Preisseite von APIYI.
- Menschliches Urteil beibehalten: LLM-Bewertungen können einseitig sein, und Berechtigungsrisiken müssen separat getestet werden.
Fazit
Die Aussage „Harness wechseln und die Scores verdoppeln sich“ ist ernst zu nehmen, sollte aber nicht einfach als „das Modell ist egal“ verstanden werden. Die in dem Beitrag geteilten Daten zeigen sowohl die Verstärkerwirkung des Harness als auch, dass zwischen verschiedenen Modellen und Aufgaben weiterhin deutliche Unterschiede bestehen. Verlässliche Schlussfolgerungen müssen auf kontrollierten Experimenten beruhen.
Für die Umsetzung sollte man sich vor allem drei Punkte merken:
- Bewertungsobjekt klar dokumentieren: Modell, Harness, Budget, Evaluationsset und Bewertungsmethode festhalten.
- Versuchsdesign muss Rückschlüsse erlauben: Variablen mit Matrixexperimenten und Ablationstests trennen und die Evaluationsumgebung isolieren.
- Schlussfolgerungen am Anwendungsfall ausrichten: Plateau, Kosten-Leistungs-Verhältnis, Ergebnisse der manuellen Prüfung und Berechtigungsrisiken gemeinsam betrachten.
Wenn du deine eigene Modellkombination überprüfen möchtest, kannst du die in diesem Artikel behandelten Modelle über APIYI apiyi.com anbinden und die Konfiguration gemäß der Dokumentation unter docs.apiyi.com abschließen. Wenn es um Kostenkalkulationen geht, schaue unter https://docs.apiyi.com/models nach den aktuellen Preisdaten.
📚 Referenzen
- InfoQ: Dasselbe Modell von 30 auf 95 Punkte bringen: Was den Unterschied macht, ist nicht das Modell, sondern das Harness
- Link:
infoq.cn/article/C1C1DThg8z1Dy0rZAmLB -
Beschreibung: Die in diesem Artikel zitierten Ergebnisse, Fallbeispiele und Designansichten stammen aus diesem aufbereiteten Artikel.
-
Vortragsvideo vom YC Paper Club Harness Night
- Link:
youtube.com/watch?v=n9xKblqyQ28 -
Beschreibung: Hier finden Sie den vollständigen Kontext der drei Vorträge von Prime Agent, OpenJarvis und QM.
-
APIYI-Dokumentationszentrum
- Link:
docs.apiyi.com -
Beschreibung: Zum Überprüfen verfügbarer Modelle, Schnittstellenformate und Integrationskonfigurationen.
-
APIYI-Modellpreisseite
- Link:
docs.apiyi.com/models - Beschreibung: Die tatsächlichen Daten auf dieser Seite sind maßgeblich für Modellpreise pro Einheit, Cache-Preise und die Abrechnungslogik.
Autor: APIYI Technikteam
Fachlicher Austausch: Wenn Sie mehr über die Modellintegration erfahren möchten, besuchen Sie die offizielle APIYI-Website apiyi.com. Weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com.