Das Team von Alibaba Tongyi hat am Morgen des 2026-11-16 Qwen4-Max veröffentlicht. Die Hauptparameter liegen bei 2.4T, das Kontextfenster bei 1M – dazu gab es eine Vergleichsgrafik mit 16 Benchmark-Wertungen.
Zuerst das Fazit: Qwen4-Max liegt wirklich vorn bei Token-Effizienz und bei Aufgaben mit langem Horizont – aber nicht in jeder Kategorie auf Platz eins. In den 16 offiziell selbst gemeldeten Benchmarks belegt es 4 Mal Platz eins und 4 Mal Platz zwei; bei Terminal-Bedienung, Programmaufbau, Diagrammverständnis und Videoverständnis liegt es weiterhin deutlich hinter den Spitzenkonkurrenten derselben Grafik zurück.
Dieser Artikel stützt sich auf genau drei Arten von Quellen: die offiziellen Veröffentlichungsmaterialien vom 2026-11-16, einen Snapshot der finalen Rangliste des öffentlichen arena.ai Code Arena WebDev Leaderboards (2026-11-14) sowie die beiden gelisteten Preise von QwenCloud und der Qianwen-KI-Plattform. Nicht veröffentlichte Parameterdetails und Ergebnisse unabhängiger Reproduktionen sind nicht Gegenstand dieses Artikels. Wenn Sie derzeit Qwen3.8-Max oder ein anderes Flaggschiffmodell laufen lassen, können Sie nach dem Lesen für jede der drei Aufgabengruppen separat entscheiden, ob ein Wechsel sinnvoll ist – und mit Eingabepreis, Ausgabepreis und Cache-Preis selbst eine Rechnung aufmachen.
Qwen4-Max: Veröffentlichung auf einen Blick
| Information | Details |
|---|---|
| Veröffentlicht am | 2026-11-16 10:01 (UTC+8) |
| Veröffentlicht von | Alibaba Tongyi-Qianwen-Team (Qwen) |
| Parametergröße | 2.4T Backbone-Parameter; pro Token werden 71B aktiviert; zusätzlich 328B N-gram-Embedding-Parameter |
| Kontext | 1M, native Vision |
| Offizielle Kanäle | QwenCloud API, Qwen Studio, QwenWork, Qoder, Qwen-App |
| Open-Source-Plan | Laut offiziellen Angaben werden kleinere Qwen4-Varianten ihre Gewichte als Open Source veröffentlichen; für Max selbst wird kein Open Source erwähnt. |
Am Rhythmus der Veröffentlichungen lässt sich ablesen, dass es diesmal nicht nur um die Aktualisierung eines API-Modells geht. Qwen4-Max ist zugleich in die beiden hauseigenen Produkte QwenWork (Büro) und Qoder (Programmierung) integriert; die offiziellen Unterlagen setzen den Fokus auf lang laufende Agent-Aufgaben und die Bereitstellung für Branchen. Reine Frage-und-Antwort-Fähigkeiten werden nicht als Hauptargument präsentiert.
Drei Architekturänderungen bei Qwen4-Max
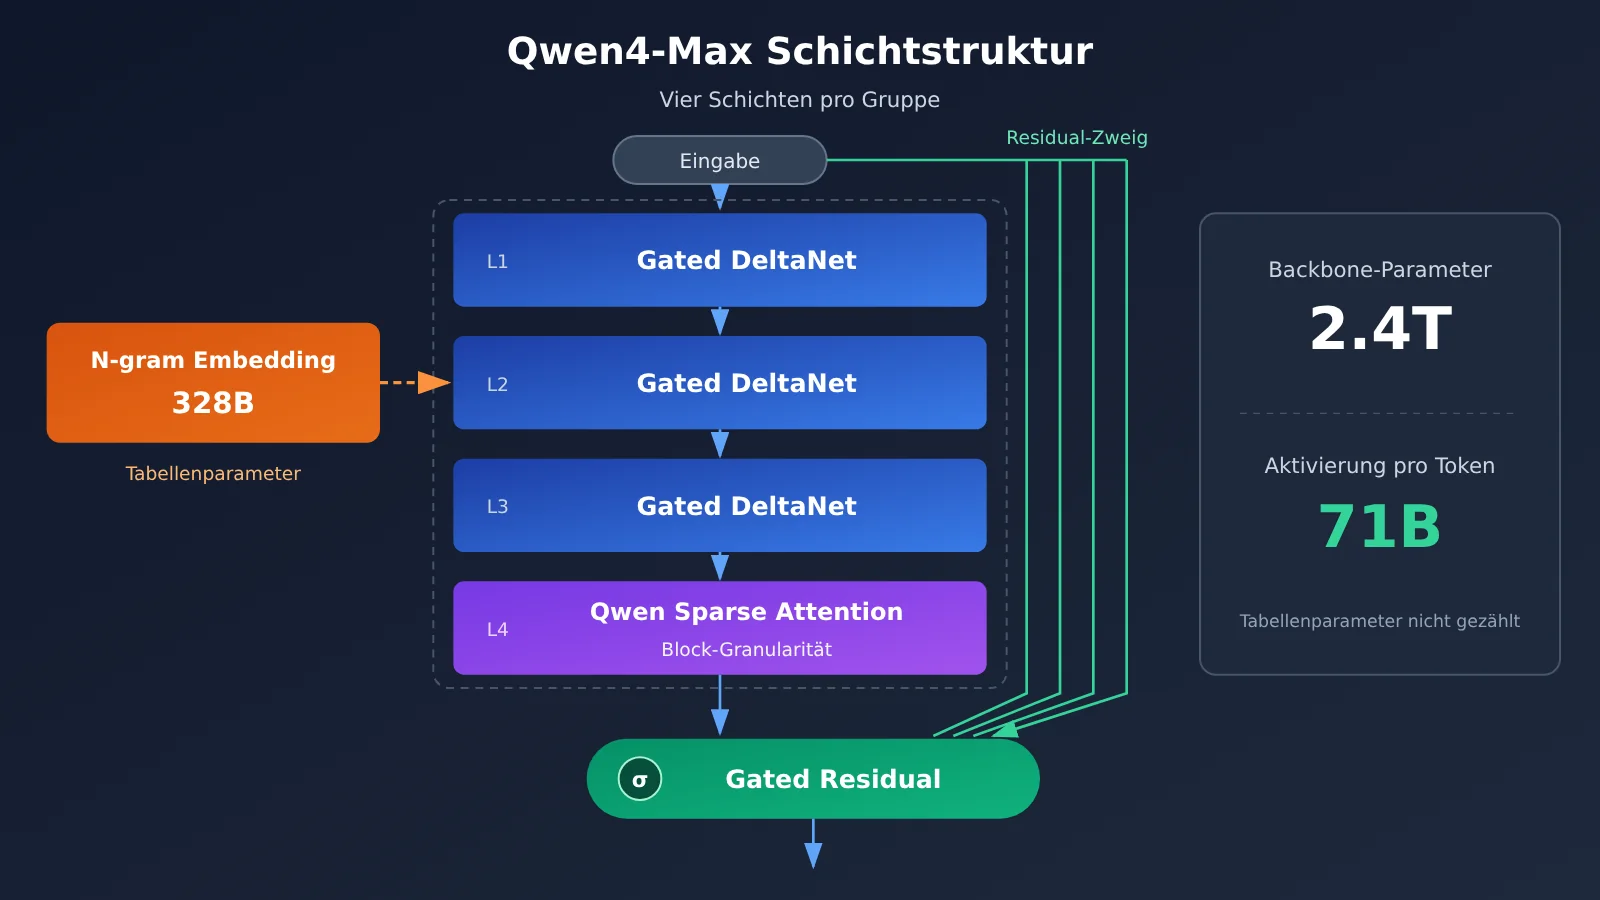
Der offizielle Blog nennt drei strukturelle Änderungen. Im Folgenden wird erläutert, welches Problem jede davon löst:
- Hybride Attention aus GDN + QSA: Von jeweils vier Schichten nutzen drei Gated DeltaNet, die vierte Qwen Sparse Attention; dabei wird der Kontext auf Block-Ebene ausgewählt. Hauptziel ist es, den Rechenaufwand bei langem Kontext von 1M zu senken.
- Gated Residual: Der Residual-Pfad wird in vier parallele Zweige aufgeteilt und anschließend über Gating zusammengeführt, um die Ausdrucksfähigkeit tiefer Netzwerke zu erhöhen.
- N-gram Embedding: In der zweiten Schicht wird per Lookup-Tabelle nachgeschlagen, um lokale Token-Muster zu ergänzen. Die zusätzlichen 328B Parameter stammen von hier; sie zählen zu den Lookup-Parametern und fließen nicht in die Aktivierungsberechnung pro Token ein.
Zu beachten ist: 2.4T ist die Gesamtzahl der Backbone-Parameter; pro Token werden tatsächlich 71B aktiviert. Wenn man sie mit anderen Modellen hinsichtlich der „Parametergröße“ vergleicht, sollte man zuerst sicherstellen, dass beide Seiten dieselbe Zählweise zugrunde legen.
Spezifikationen und Protokolle von Qwen4-Max
| Spezifikation | Qwen4-Max |
|---|---|
| Kontextfenster | 1M |
| Maximale Eingabe | 991K (983K im Thinking-Modus) |
| Maximale Ausgabe | 393K |
| Maximale Chain-of-Thought | 262K |
| TPM | 5 Millionen |
| Kompatible Protokolle | OpenAI Chat Completions, Responses, Anthropic Messages, DashScope |
Standard-reasoning_effort |
high (bei Qwen3.8-Max standardmäßig xhigh) |
Die letzte Zeile wird leicht übersehen. Die standardmäßige Reasoning-Stufe von Qwen4-Max ist high und liegt damit eine Stufe unter dem standardmäßigen xhigh der Vorgängergeneration. Wenn man die alte und die neue Generation direkt mit den Standardparametern vergleicht, stammt ein Teil der beobachteten Token-Einsparung aus dem Unterschied bei der Stufe und nicht ausschließlich aus dem Modell selbst. Bei A/B-Tests sollte reasoning_effort explizit auf denselben Wert gesetzt werden.
Qwen4-Max: 16 offizielle Benchmark-Ergebnisse – wo es vorne liegt und wo nicht
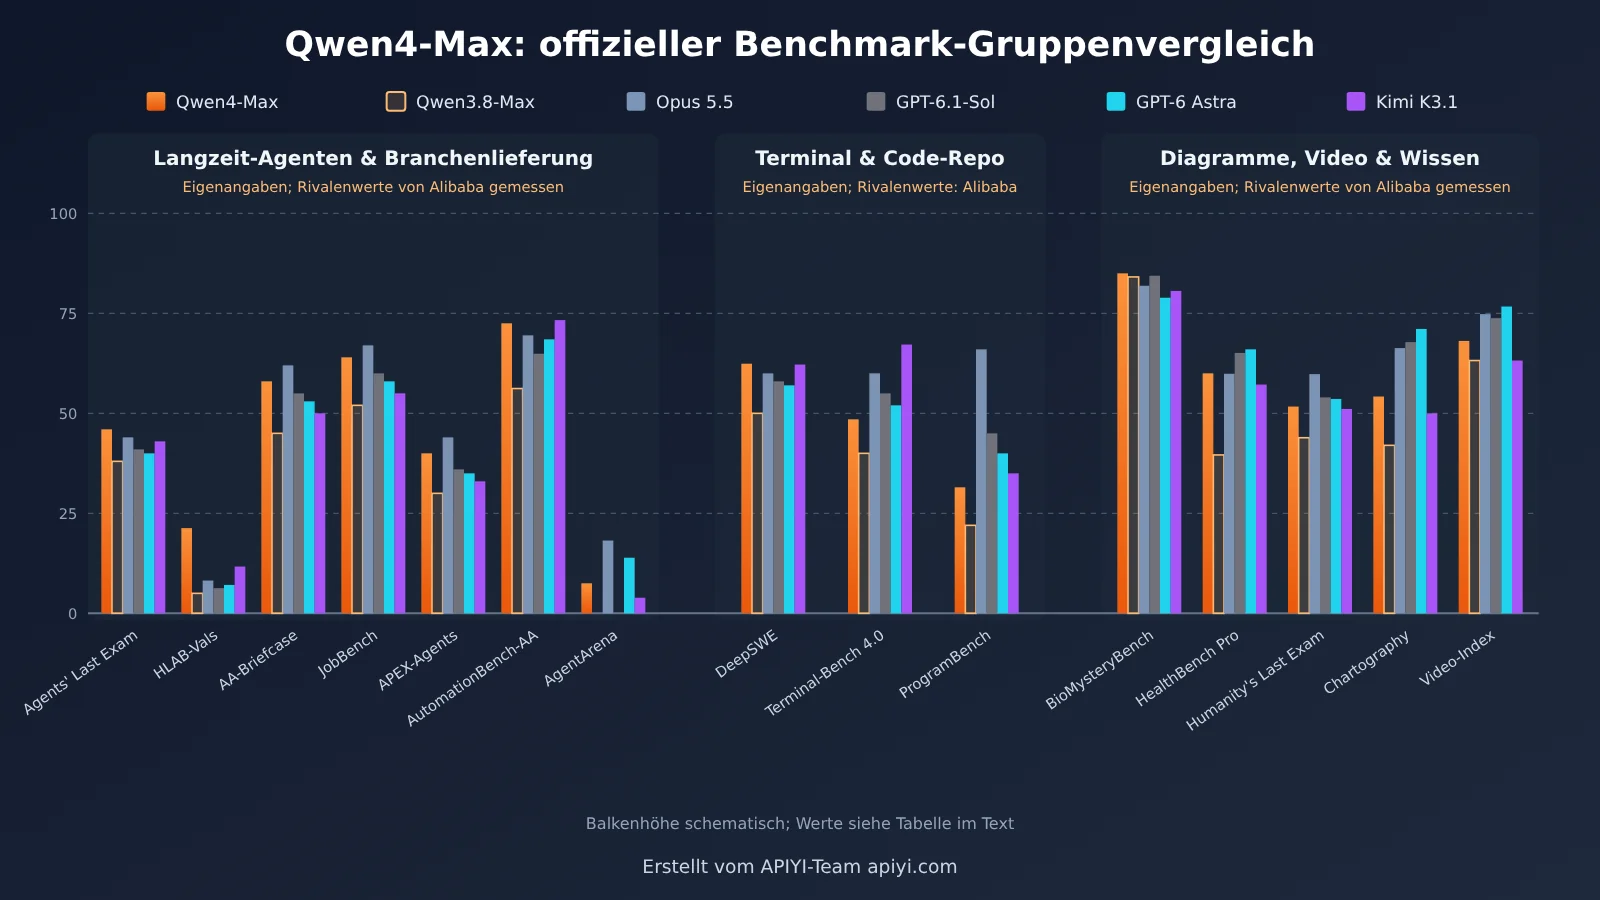
Alle Werte in der folgenden Tabelle stammen aus derselben offiziell veröffentlichten Grafik und sind vom Anbieter selbst berichtet. Auch die Werte der Konkurrenten in dieser Grafik hat Alibaba selbst ermittelt; sie sind nicht als offizielle Ergebnisse von Anthropic, OpenAI oder Moonshot AI zu werten. CodeArena und AgentArena sind aus LM Arena übernommen, AA-Briefcase und AutomationBench-AA aus Artificial Analysis, APEX-Agents aus der Mercor-Rangliste; JobBench hat Alibaba mit einem aktualisierten Datensatz und angepasstem Evaluierungscode selbst getestet.
| Benchmark | Qwen4-Max | Qwen3.8-Max-0902 | Opus 5.5 | GPT-6.1-Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 |
| CodeArena WebDev (Elo) | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 |
| ProgramBench | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 |
| AA-Briefcase v1.1 (Elo) | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 |
| Agents‘ Last Exam v1.1 | 46.7 | 27.9 | 43.4 | 42.6 | 43.4 | nicht angegeben |
| JobBench | 68.5 | 65.3 | 75.4 | 66.2 | 66.1 | 61.2 |
| APEX-Agents v1.1 | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 |
| HLAB-Vals-1.1 | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 |
| AutomationBench-AA | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 |
| AgentArena (Net Improvement) | 7.5 | — | 18.2 | — | 13.9 | 3.9 |
| BioMysteryBench | 85.0 | 84.1 | 81.9 | 84.4 | 78.9 | 80.6 |
| HealthBench Professional | 60.0 | 39.6 | 59.9 | 65.1 | 66.0 | 57.2 |
| Humanity’s Last Exam | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 |
| Chartography | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 |
| Video-Index | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 |
Benchmarks, in denen Qwen4-Max führt
Qwen4-Max liegt in vier Benchmarks auf Platz eins: DeepSWE, Agents‘ Last Exam, HLAB-Vals und BioMysteryBench. Am größten ist der Abstand bei HLAB-Vals: 21,3 Punkte entsprechen etwa dem Doppelten des Zweitplatzierten Kimi K3.1. Bei DeepSWE liegt Qwen4-Max nur 0,2 Punkte vor Kimi – dieser Unterschied ist praktisch als Gleichstand zu werten.
In vier weiteren Benchmarks reicht es für Platz zwei: AA-Briefcase, JobBench, APEX-Agents und AutomationBench-AA. Die ersten drei gewinnt Opus 5.5, die letzte Kimi K3.1. Alle diese Benchmarks sind auf lang laufende Agenten und Arbeitsergebnisse im White-Collar-Umfeld ausgerichtet – genau der Schwerpunkt, den das offizielle Material diesmal bewirbt.
Benchmarks, in denen Qwen4-Max zurückliegt
Terminal- und Programmbuild-Aufgaben sind diesmal die deutlichsten Schwachstellen. Mit 48,5 Punkten in Terminal-Bench 4.0 belegt Qwen4-Max Platz fünf unter sechs Modellen und liegt 18,7 Punkte hinter Spitzenreiter Kimi. Die 31,5 Punkte in ProgramBench erreichen nicht einmal die Hälfte von Opus 5.5. Wenn Ihr Agent Builds, Debugging und Deployment überwiegend in der Shell erledigt, sind diese beiden Benchmarks aussagekräftiger als DeepSWE.
Auch bei Diagramm- und Videoverständnis liegt Qwen4-Max zurück. Chartography und Video-Index belegen jeweils Platz vier, mit 16,9 bzw. 8,6 Punkten Rückstand auf GPT-6 Astra an der Spitze. Auch Humanity’s Last Exam ist nur Platz vier. „Native Vision“ bedeutet also, dass die Fähigkeit vorhanden ist – nicht, dass Qwen4-Max in diesem Bereich führt.
Qwen4-Max in der öffentlichen Rangliste der Code Arena
Der Snapshot der finalen öffentlichen Rangliste (14.11.2026) von arena.ai Code Arena WebDev umfasst 1.007.405 Stimmen und 159 Modelle. Qwen4-Max (xHigh) liegt mit 1750 Punkten auf Platz 6, ist als Preliminary markiert und hat nur 1.814 Stimmen; die auf der Seite angezeigten P50-Kosten pro Aufgabe betragen $4.18. Vor ihm liegen der Reihe nach Claude Fable 5.2, Claude Opus 5.5, Claude Sonnet 5.5, Gemini 4 Carbon (Preliminary) und GPT-6 Astra.
Die vorherige Generation Qwen3.8-Max (0902) steht in derselben Rangliste bei 1676 Punkten auf Platz 16. Diese Generation verbessert sich damit um 74 Punkte und 10 Plätze. Allerdings hat Qwen4-Max noch verhältnismäßig wenige Stimmen, die Platzierung kann sich also noch ändern.
Token-Effizienz von Qwen4-Max und woher die „60 % Kostensenkung“ stammt
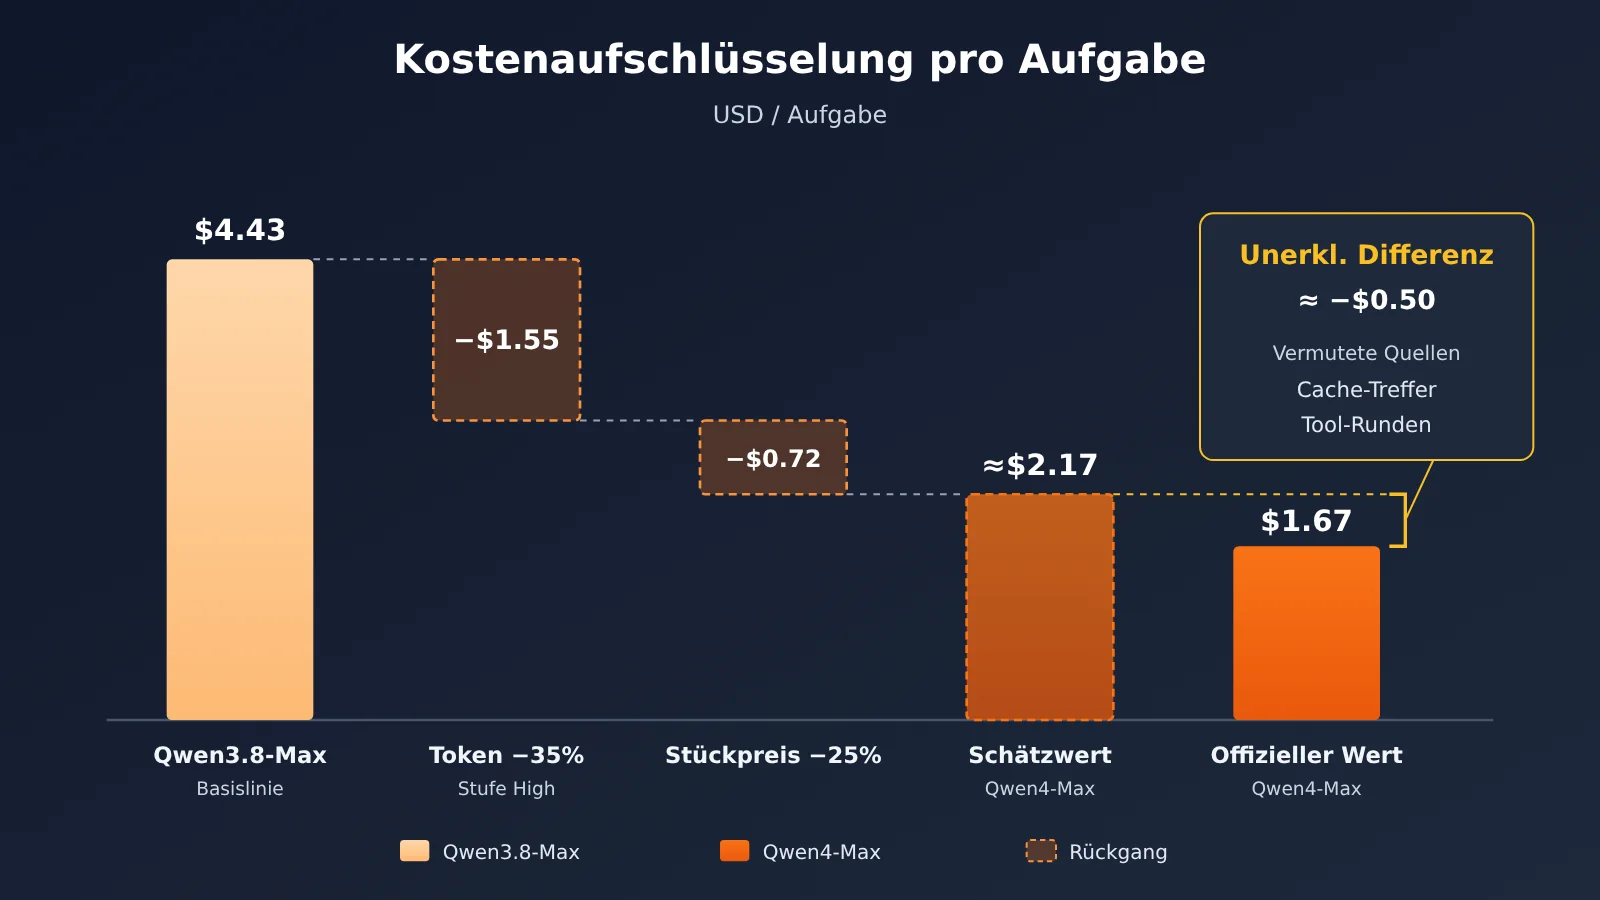
Die offiziellen Effizienzzahlen stammen aus dem eigenen Work360-Szenariobenchmark. Dieser Benchmark umfasst 26 Bereiche der ersten Ebene, 182 der zweiten Ebene und 721 der dritten Ebene. Qwen4-Max erzielt 52,69 Punkte, Qwen3.8-Max 47,74. Beim Token-Verbrauch liegt Work360 in der Xhigh-Stufe um etwa 24 % und in der High-Stufe um etwa 35 % niedriger; bei Terminal-Bench 4.0 sind es in den beiden Stufen etwa 48 % bzw. 49 % weniger.
Bei den durchschnittlichen Kosten pro Aufgabe nennt das Unternehmen offiziell einen Rückgang von $4.43 auf $1.67; die chinesische Blog-Angabe lautet ¥26.58 auf ¥11.16, ein Rückgang um 58 %. Auf Basis der Dollar-Zahlen beträgt der Rückgang etwa 62 %. Rechnet man jedoch nur mit „35 % weniger Token × 25 % niedrigerem Token-Preis“, kommt man auf etwa 0,65 × 0,75 ≈ 0,49, also rund 51 % Rückgang. Die verbleibende Differenz erklärt das Unternehmen nicht. Plausible Ursachen sind eine höhere Cache-Trefferquote und weniger Tool-Aufrufrunden, aber das ist nur eine Vermutung und kein bestätigter Grund.
Im Hinblick auf Sicherheit stieg die „doppelte Bestehensquote für Funktionalität und Schwachstellenfreiheit“ auf Funktionsebene im Last Secure Code Bench von 22,0 % auf 31,8 %. Der Anteil, bei dem auf allen drei Granularitätsstufen – Funktion, Datei und Repository – sicherer Code erzeugt wird, stieg von 8 % auf 14,7 %. Die absoluten Werte bleiben niedrig; der generierte Code muss weiterhin manuell geprüft werden.
Wie berechnet sich der Preis von Qwen4-Max?
Im Folgenden sind die offiziellen Preise von Qwen4-Max sowie die offiziellen Preise der Vorgängergeneration und die aktuellen Preise bei APIYI aufgeführt. Alle Angaben in USD / 1 Mio. Tokens, Stand: 2026-11-16.
| Abrechnungsposten | Qwen4-Max (offiziell bei QwenCloud) | Qwen3.8-Max (offiziell) | qwen3.8-max (aktueller Preis bei APIYI apiyi.com) |
|---|---|---|---|
| Eingabe | $1.5 | $2 | $1.65 |
| Ausgabe | $4.5 | $6 | $4.95 |
| Cache-Lesen / Treffer | $0.075 | $0.25 | $0.20625 |
| Explizite Cache-Erstellung (5 Minuten) | $1.875 | — | — |
| Explizite Cache-Erstellung (1 Stunde) | $3 | — | — |
Für die Renminbi-Preise ist die Qwen AI-Plattform maßgeblich; Einheit: Renminbi / 1 Mio. Tokens, Stand: 2026-11-16:
- Eingabe ¥10, Ausgabe ¥30, Cache-Treffer ¥0.5
- Explizite Cache-Erstellung (5 Minuten): ¥12.5; explizite Cache-Erstellung (1 Stunde): ¥20
Verglichen mit den offiziellen Preisen der Vorgängergeneration sind die Eingabe- und Ausgabepreise von Qwen4-Max jeweils um 25 % niedriger, der Cache-Lesepreis ist um 70 % niedriger. Der stärkste Rückgang betrifft den Cache-Lesepreis, was sich deutlich auf Long-Running-Agenten auswirkt, denn bei Multi-Turn-Aufgaben werden zahlreiche wiederholte System-Eingabeaufforderungen und Verlaufskontexte zum Cache-Preis abgerechnet.
Für eine eigene Kostenschätzung können Sie die Kosten mit dieser Formel aufschlüsseln: nicht gecachte Eingabe × Eingabepreis + Cache-Treffer × Cache-Preis + Umfang der expliziten Cache-Erstellung × Erstellungspreis + Ausgabe (inkl. Chain-of-Thought) × Ausgabepreis. Ein hypothetisches Beispiel: Eine Aufgabe hat 1 Mio. Eingabe-Tokens, davon 600.000 Cache-Treffer, und 100.000 Ausgabe-Tokens. Mit den offiziellen Preisen von Qwen4-Max ergibt sich ungefähr $0.6 + $0.045 + $0.45 ≈ $1.10; bei gleicher Tokenmenge mit den offiziellen Preisen von Qwen3.8-Max ungefähr $1.55. Der tatsächliche Unterschied wird zusätzlich durch Änderungen beim Tokenverbrauch beeinflusst. Am zuverlässigsten ist es daher, die Berechnung mit den eigenen realen Logs erneut durchzuführen.
💰 Hinweis zur Kostenrechnung: APIYI hat qwen4-max derzeit noch nicht im Angebot. Wir werden das Modell so schnell wie möglich aufnehmen. Der genaue Modellname und die Preise richten sich nach der Modellliste auf apiyi.com. Bis zur Aufnahme können Sie mit
qwen3.8-maxauf der Plattform eine Kostenbasis schaffen und die beiden Abrechnungen direkt vergleichen, sobald das neue Modell verfügbar ist.
Wie man je nach Szenario entscheidet, ob ein Wechsel auf Qwen4-Max sinnvoll ist
| Szenario | Leistung von Qwen4-Max (laut offiziellen Angaben) | Empfehlung |
|---|---|---|
| Langlaufende Agenten und branchenspezifische Lieferergebnisse (Büroautomatisierung, Recherche, Abgabedokumente) | HLAB-Vals und Agents‘ Last Exam Platz 1; APEX, JobBench, AA-Briefcase Platz 2; deutlich weniger Tokens | Vorrangig prüfen – der Nutzen eines Upgrades von Qwen3.8-Max ist hier am klarsten |
| Terminal und Code-Repositories (Shell-Agent, Builds, Änderungen über mehrere Repos hinweg) | DeepSWE Platz 1, aber mit sehr kleinem Vorsprung; Terminal-Bench Platz 5, ProgramBench Platz 4 | Bei Aufgaben, die vor allem aus Terminal-Arbeit bestehen, erst mit Kimi K3.1 und Opus 5.5 vergleichen und dann entscheiden |
| Frontend-WebDev | Code Arena öffentliches Ranking Platz 6, 1750 Punkte (Preliminary) | Als Preis-Leistungs-Option geeignet, aber nicht an der Spitze |
| Diagramm- und Videoverständnis, multimodale lange Dokumente | Chartography und Video-Index jeweils Platz 4 | Bei Prozessen mit viel Bild- und Videoauswertung derzeit nicht empfehlenswert, sich nur darauf zu verlassen |
| Fragen zu Biologie und Medizin | BioMysteryBench Platz 1; HealthBench Professional Platz 3 | Kann in Tests aufgenommen werden, sollte aber von Fachexperten geprüft werden |
Ein ziemlich solides Vorgehen ist die Aufteilung: Aufgaben wie langlaufende Agenten und Dokumentabgabe übernimmt Qwen4-Max, terminalintensive Aufgaben sowie Diagramm- und Videoaufgaben bleiben weiter bei den Modellen, die dort aktuell besser abschneiden. So muss man nicht den gesamten Traffic auf einmal migrieren und bekommt trotzdem schon die Token-Einsparungen mit.
🎯 Empfehlung zur Modellauswahl: Voraussetzung für diese Aufteilung ist, dass man mit derselben Codebasis das Modell wechseln kann. APIYI apiyi.com bietet eine OpenAI-kompatible Schnittstelle: Mit einem einzigen API-Schlüssel lassen sich die Flaggschiff-Modelle mehrerer Anbieter aufrufen – man tauscht einfach das Feld
modelaus und kann so einen A/B-Test durchführen.
Qwen4-Max – Schnellstart
Der offizielle Weg führt über die QwenCloud API. Sie unterstützt vier Protokolle: OpenAI Chat Completions, Responses, Anthropic Messages und DashScope. Bestehende OpenAI- oder Anthropic-SDKs lassen sich also direkt anbinden. Bei der Integration sollten Sie auf folgende Punkte achten:
- Modellbezeichnung prüfen: Die offizielle Modell-ID lautet
qwen4-max; maßgeblich ist die Modellseite. Der Standardwert fürreasoning_effortisthigh. Legen Sie bei Vergleichstests explizit dieselbe Stufe fest, zum Beispielxhigh. - Ausgaberaum einplanen: Die maximale Ausgabe beträgt 393K, die maximale Gedankenkette 262K. Bei langen Aufgaben sollten Sie
max_tokensbzw. das entsprechende Parameter groß genug wählen – sonst füllt die Gedankenkette das gesamte Ausgabekontingent aus. - Caching aktivieren: Der Preis für einen impliziten Cache-Treffer liegt bei $0.075. Wenn der System-Prompt lang ist und wiederholt verwendet wird, lohnt es sich zu prüfen, ob ein expliziter Cache mit 5 Minuten oder 1 Stunde sinnvoll ist. Das Anlegen eines Caches ist separat kostenpflichtig – bei zu wenigen Wiederverwendungen rechnet sich das nicht.
- Vergleichsgruppe vorbereiten: Registrieren Sie sich bei APIYI und holen Sie sich einen API-Schlüssel. Setzen Sie
base_urlaufhttps://api.apiyi.com/v1und tragen Sie beimodelqwen3.8-maxein. Lassen Sie dieselbe Aufgabenreihe mit dem alten Modell laufen, um Token-Verbrauch und Punktzahl als Basislinie zu ermitteln. - Nach Verfügbarkeit des neuen Modells umstellen: Sobald qwen4-max bei APIYI verfügbar ist, müssen Sie nur das Feld
modeländern. Der restliche Code bleibt unverändert – und Sie erhalten direkt Vergleichsdaten zwischen alter und neuer Generation.
🚀 Schnellstart: Neue Nutzer erhalten bei der Registrierung auf APIYI apiyi.com ein kostenloses Testkontingent. Das reicht aus, um zunächst die Basislinie für
qwen3.8-maxzu ermitteln. Beim späteren Modellwechsel ist keine erneute Integration nötig.
Häufig gestellte Fragen zu Qwen4-Max
Q1: Was ist Qwen4-Max?
Qwen4-Max ist das Flaggschiffmodell von Qwen, das am 2026-11-16 veröffentlicht wurde. Es verwendet 2.4T Parameter im Backbone, aktiviert pro Token 71B, unterstützt native visuelle Eingaben, hat ein Kontextfenster von 1M und richtet sich vor allem an langfristig laufende Agenten und branchenspezifische Lieferaufgaben.
Q2: Worin unterscheidet sich Qwen4-Max von Qwen3.8-Max?
In den 16 offiziell selbst gemeldeten Benchmarks liegt Qwen4-Max bei jedem einzelnen Wert über Qwen3.8-Max-0902. In der öffentlichen Code-Arena-Rangliste liegt es 74 Punkte vorn. Bei den offiziellen Preisen sind Eingabe und Ausgabe jeweils 25 % günstiger, das Lesen aus dem Cache ist 70 % günstiger. Außerdem unterscheiden sich die standardmäßigen Reasoning-Stufen: `high` gegenüber `xhigh`.
Q3: Sind die 16 Benchmarks vertrauenswürdig?
Diese Werte sind alle offiziell selbst gemeldet, auch die Werte der Konkurrenten wurden von Alibaba selbst gemessen. Derzeit gibt es keine unabhängige Reproduktion durch Dritte. Ein externes Signal, das man heranziehen kann, ist die öffentliche Code-Arena-WebDev-Rangliste: Im Final-Snapshot vom 2026-11-14 belegt Qwen4-Max Platz 6, steht aber noch im Status „Preliminary“ und hat nur wenige Stimmen.
Q4: Lassen sich die „60 % geringeren Kosten“ direkt auf mein Geschäft übertragen?
Nein, nicht direkt. Die Zahl stammt aus dem offiziellen Work360-Szenario. Der Rückgang ist höher als das, was sich allein aus Token und Stückpreis berechnen lässt; die Differenz dazwischen erklärt das Unternehmen nicht. Ihr tatsächlicher Rückgang hängt von der Cache-Trefferquote, der Anzahl der Tool-Aufrufe und der Reasoning-Stufe ab. Sie müssen ihn anhand Ihrer eigenen Aufgabenprotokolle messen.
Q5: Kann man Qwen4-Max über APIYI aufrufen?
Stand 2026-11-16, 11:00, ist qwen4-max noch nicht in der Modellliste von APIYI enthalten. Wir werden es so schnell wie möglich zur Verfügung stellen. Das derzeit erhältliche Qwen-Flaggschiff ist `qwen3.8-max`; der Preis liegt bei Eingabe $1.65, Ausgabe $4.95 und Cache-Lesen $0.20625 (Einheit: 1M Tokens). Verfügbarkeit und Preise richten sich nach der Modellliste auf apiyi.com.
Q6: Wo liegen die Schwächen von Qwen4-Max?
Bei Terminal-Bedienung (Fünfter bei Terminal-Bench), Programmaufbau (Vierter bei ProgramBench), Diagramm- und Videoverständnis (jeweils Vierter) sowie HLE (Vierter) liegt es hinter den führenden Konkurrenten im selben Chart. Die doppelte Bestehensquote bei sicherem Code ist zwar gestiegen, liegt aber nur bei 31.8 %. Außerdem gibt es derzeit keine Pläne, die Gewichte der Max-Variante als Open Source zu veröffentlichen.
Fazit: Lohnt sich der Wechsel zu Qwen4-Max?
- Positionierung: Ein Flaggschiffmodell mit 2,4T-Backbone, 71B aktivierten Parametern pro Token und 1M-Kontextfenster, ausgerichtet auf Long-Range-Agenten und Branchen-Lieferprojekte.
- Führende Bereiche: Bei 16 offiziell selbst gemeldeten Benchmarks 4 erste und 4 zweite Plätze – vor allem bei Agenten- und White-Collar-Delivery-Benchmarks.
- Schwächere Bereiche: Terminal-Bedienung, Programm-Builds, Diagramme, Video und HLE landen alle auf Platz vier oder fünf; ein einziges Modell kann nicht alle Aufgaben abdecken.
- Position in öffentlichen Ranglisten: Snapshot der finalen Code-Arena-WebDev-Rangliste (2026-11-14): Platz 6, 1750 Punkte, weiterhin Preliminary.
- Kosten: Der offizielle Stückpreis sinkt um 25 %, Cache-Reads um 70 %, auch der Token-Verbrauch geht deutlich zurück; die „Senkung um 60 %“ muss man mit eigenen Daten verifizieren.
Wenn Ihre Hauptlast Long-Range-Agenten und Dokumenten-Delivery sind, lohnt es sich, Qwen4-Max prioritär zu evaluieren; bei terminalintensiven Aufgaben oder Diagramm- und Videoverständnis sollten Sie weiterhin auf die derzeit stärkeren Modelle ausweichen. Bevor qwen4-max verfügbar ist, können Sie über die OpenAI-kompatible Schnittstelle von APIYI apiyi.com mit qwen3.8-max eine Kosten- und Leistungsbasislinie aufbauen; nach dem Launch des neuen Modells reicht eine Feldänderung, um den Vergleich durchzuführen.
📚 Quellen
- Offizieller X-Post von Qwen: Ankündigung zu Qwen4-Max
- Link:
x.com/Alibaba_Qwen/status/2122148127520289151 -
Hinweis: Veröffentlichungszeitpunkt und offizielle Verfügbarkeitskanäle
-
Offizieller Qwen-Blog (Chinesisch): Architektur, Spezifikationen, 16 Benchmarks und Effizienzkennzahlen
- Link:
qwen.ai/blog?id=qwen4-max -
Hinweis: Die Architektur-, Spezifikations- und Benchmark-Daten in diesem Artikel stammen aus diesem Beitrag
-
QwenCloud-Modellseite: USD-Listenpreis
- Link:
qwencloud.com/models/qwen4-max -
Hinweis: Preise in USD pro 1 Mio. Tokens für Eingabe, Ausgabe und Caching
-
QianwenAI-Plattform – Modellseite: RMB-Listenpreis
- Link:
qianwenai.com/models/qwen4-max -
Hinweis: Preise in RMB pro 1 Mio. Tokens
-
arena.ai Code Arena WebDev: öffentliche Rangliste
- Link:
arena.ai - Hinweis: Dieser Artikel zitiert den Snapshot der finalen Rangliste vom 14.11.2026
Autor: APIYI-Technikteam
Technischer Austausch: Wenn Sie den Fortschritt bei der Modellbereitstellung und die Integrationsmöglichkeiten erfahren möchten, kontaktieren Sie uns über die Startseite von APIYI. Die Dokumentation finden Sie unter docs.apiyi.com