作者注:Grok 4.8 尚未发布。本文梳理马斯克的三次表态,区分已确认与未确认的信息,再用 Grok 4.7 的实测数据判断这个 2.5T 模型的分量。
先说结论:截至 10 月 30 日,Grok 4.8 尚未发布,也未进入 API。马斯克当天只说它「不会让人失望」「不针对跑分优化」。目前能核实的,是三个时间点,以及 Grok 4.7 已经打下的底子。
“I know it’s taken longer than expected, but Grok 4.8 will not be a disappointment. We’re not optimizing for benchmarks and I really don’t care how Grok does on those, but it will be incredibly useful.”
—— Elon Musk,2026-10-30 05:17 UTC(北京时间 13:17)
原帖:
x.com/elonmusk/status/2116036703538606301
这条帖子回复的是 @techdevnotes 前一天的吐槽:「除了语音,SpaceXSI 几乎没有 SOTA 模型」。需要说明,马斯克并没有说 Grok 4.8「跑分很差」,他说的是没有针对跑分做优化,也不在乎跑分。网上已经有人把这句话解读成「4.8 跑分不行」,这属于第三方推断,不是原话。
这不是一篇发布解读,因为目前还没有可以解读的发布。本文做三件事:把马斯克的口述和官方规格分开;用 Grok 4.7 的第三方数据估计 4.8 的起点;告诉国内团队现在该怎么接入、以后怎么切换。
为了避免把口述当成规格,本文所有信息按三个等级标注:
- 【官方自报】:xAI(现名 SpaceXSI)官方公告、文档和自家 benchmark,可以作为参考,但不等于独立验证。
- 【第三方实测】:Artificial Analysis、Bloomberg 等外部机构的测试或报道。
- 【马斯克口述】:马斯克本人在 X 上的发言,包括 2.5T 参数、C++ 栈、RL 进度,官方没有 model card 背书。
🚀 快速开始:在 Grok 4.8 开放 API 之前,国内开发者可以先通过 API易 apiyi.com 调用已上架的
grok-4.7,使用 OpenAI 兼容接口,一个 Key 就能和 Claude、Gemini 等模型放在一起对比。
Grok 4.8 核心信息:3 个时间点速览
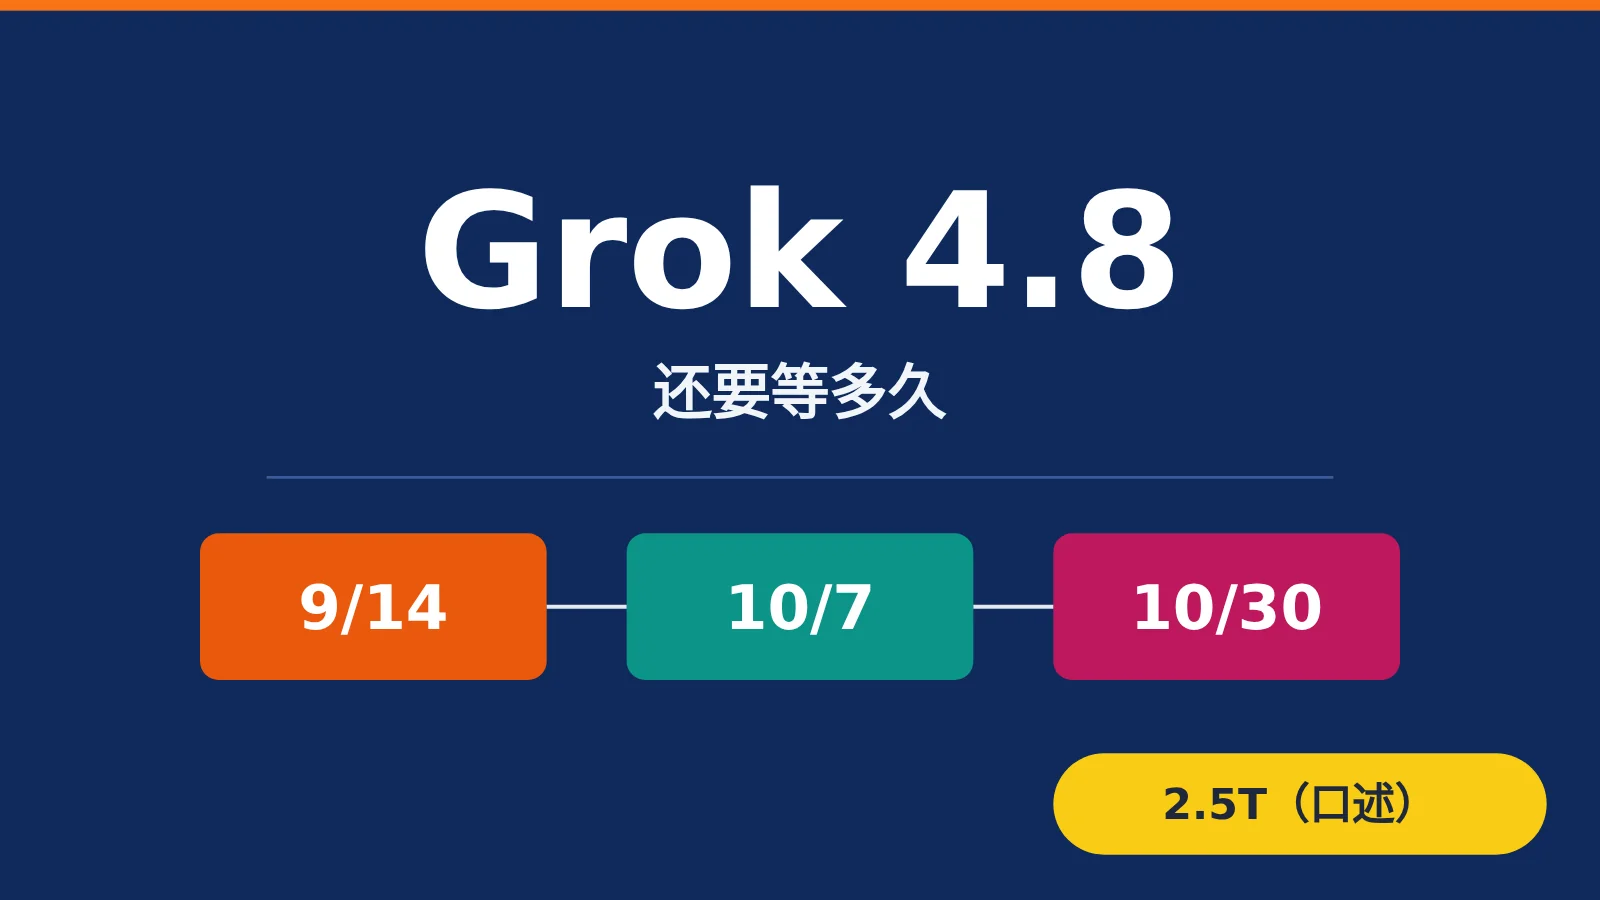
Grok 4.8 的全部公开信息都来自马斯克的 X 帖子。截至 10 月 27 日的核查,xAI 官方文档里没有任何关于 Grok 4.8 的记录。下表是三个关键时间点的汇总。
| 时间(UTC) | 马斯克原话要点 | 透露的信息 | 事实等级 |
|---|---|---|---|
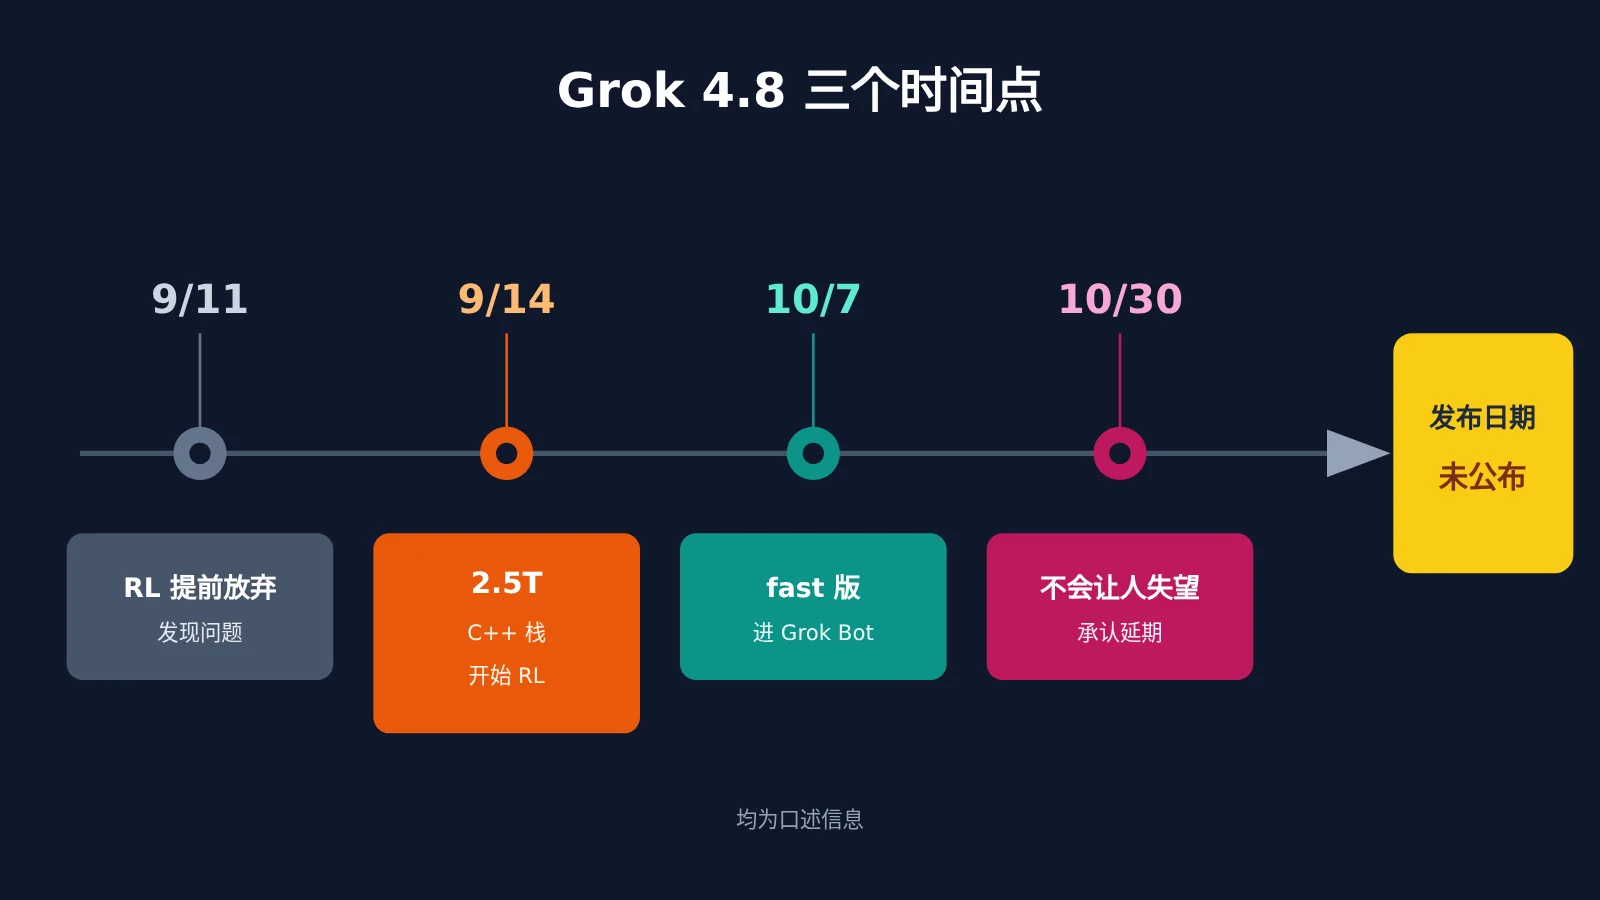
| 2026-09-14 | 「a 2.5T model trained with our new C++ software stack, will finish training this week and start RL」 | 2.5 万亿参数,新的 C++ 预训练栈,当周完成训练并开始 RL | 【马斯克口述】 |
| 2026-10-07 | 「a lightning-fast version of Grok 4.8」处理 Grok Bot 的大多数请求 | 会有一个快速版,承接 Grok Bot 的日常简单请求 | 【马斯克口述】 |
| 2026-10-30 | 「will not be a disappointment」「not optimizing for benchmarks」 | 承认比预期慢,强调实用性而不是跑分 | 【马斯克口述】 |
Grok 4.8 时间点一(9/14):2.5T 模型与新 C++ 栈
9 月 14 日这条是信息量最大的一次表态。马斯克说 Grok 4.8 是一个 2.5T 模型,用新的 C++ 软件栈训练,当周完成训练并开始 RL(强化学习)。同一天他还补充了两条:预训练软件已经换成自研的 C/C++ 栈,主要由 Starlink 软件团队编写;RL 栈则还是「somewhat of a legacy pile」,也就是一堆遗留代码。
这里要分清两件事。「当周完成训练」说的是预训练,之后还要经过 RL 和后训练,所以不能写成「Grok 4.8 已经训练完成」。另外,预训练栈是新的,RL 栈却是旧的,这本身就可以解释为什么 10 月 30 日他会说「比预期花了更久」。RL 阶段很可能才是真正的瓶颈。
同一天他还给出了一张路线图:Grok 4.7 大致与 Opus 5.0 持平(不是 5.1),Grok 4.8 会是「noticeable improvement」,Grok 4.9「probably Astra/Fable class」,Grok 5「maybe better than anything」。这些都是【马斯克口述】,只能作为方向参考。
Grok 4.8 时间点二(10/7):lightning-fast 版本进入 Grok Bot
10 月 7 日,马斯克谈到 Grok Bot 怎么选模型。他说大多数 Bot 请求都很简单,等 Grok 4.8 出来以后,这些请求会交给「a lightning-fast version of Grok 4.8」处理。由此可以推断,Grok 4.8 不会只有一个版本,至少会有一个面向高并发、低延迟的快速版本。
对开发者来说,这条信息比参数量更实用。可以参考 Grok 4.7 Fast 的先例:它的价格是标准版的 2 倍,而且只在 Cursor 与 Grok Build 中提供【官方自报】。所以 4.8 的 fast 版本会不会开放 API、怎么定价,目前都是未知数。
Grok 4.8 时间点三(10/30):「不会让人失望」
10 月 30 日的帖子没有提供新的技术信息,只做了两件事:承认延期,并且把评价标准从「跑分」换成「有用」。考虑到 Grok 4.7 在多项 benchmark 上已经很有竞争力,这个说法更像是在管理预期:4.8 不一定在所有榜单上登顶,但会强调真实任务中的可用性。
Grok 4.8 已确认 / 未确认清单
写 Grok 4.8 相关内容时,最容易出错的就是把口述当成规格。下面这张清单可以直接拿来做内部同步。
| 项目 | 状态 | 说明 |
|---|---|---|
| 是否已发布 | ❌ 未发布 | 10 月 27 日核查:xAI models 页没有 grok-4.8,Grok 4.8 新闻页 404,release notes 最新的文本模型仍是 9/21 的 Grok 4.7 |
| 发布日期 | ❌ 未确认 | 官方没有给出任何日期 |
| 价格 | ❌ 未确认 | 没有输入、输出、缓存读中的任何一项 |
| 上下文长度 | ❌ 未确认 | Grok 4.7 是 500k,4.8 没有公布 |
| API 型号名 | ❌ 未确认 | 官方文档里搜不到 grok-4.8 |
| 2.5T 参数 | ⚠️ 仅口述 | 来自马斯克 9/14 的帖子,没有 model card |
| 新 C++ 预训练栈 | ⚠️ 仅口述 | 9/14 的帖子,没有技术报告 |
| 已开始 RL | ⚠️ 仅口述 | 只能说「马斯克称当周完成预训练并开始 RL」 |
| fast 版本 | ⚠️ 仅口述 | 10/7 的帖子,用于 Grok Bot |
| benchmark 成绩 | ❌ 未确认 | 没有任何官方或第三方数据 |
10 月 30 日查询 API易 的实时定价接口,Grok 系列共 12 个型号,其中也没有 grok-4.8。原因很简单:官方还没有发布,任何平台都不可能提前上架。如果你看到有渠道声称「已接入 Grok 4.8」,建议先核实对方返回的真实模型。
Grok 4.8 影响分析:从 Grok 4.7 看 2.5T 模型的潜力
既然 4.8 没有数据,判断它的分量只能看两点:xAI 的迭代速度,以及 Grok 4.7 这个起点有多高。
Grok 4.8 之前的节奏:十周三次迭代
| 版本 | 发布日期 | 主要变化【官方自报】 |
|---|---|---|
| Grok 4.5 | 2026-07-08 | 首个专门为 coding/agents 训练的版本,与 Cursor 一起训练,使用数万张 NVIDIA GB300 |
| Grok 4.6 | 2026-08-12 | 更长的 supplemental training,用 4.5 重新生成 SFT 数据,agentic RL 覆盖 kernel 优化、web dev、CAD |
| Grok 4.7 | 2026-09-21 | 更大的 base model,更长的 RL(偏向多小时任务),更强的自检;500k 上下文,知识截止 2026-05 |
从 7 月 8 日到 9 月 21 日,大约十周内发了三版,而且价格没有变:输入 $2、输出 $6(每百万 tokens);4.7 的官方定价表里单独列出了缓存读 $0.5,4.5、4.6 的公告没有单列缓存读价。这样的迭代频率在头部实验室里不多见。按这个节奏,4.8 已经明显晚于预期,这也和马斯克「taken longer than expected」的说法对得上。
第三方实测:Grok 4.7 已进入前四实验室
Artificial Analysis 在 9 月 21 日给出的数据【第三方实测】如下:
- Intelligence Index 46 分:比 Grok 4.6 高 2 分,SpaceXAI 因此进入前四实验室。
- Coding Agent Index 56 分:Grok 4.7 xhigh 配合 Grok Build,比 4.6 高 9 分,在原生 harness 中排第 4,前面只有 Claude Fable 5.1、GPT-6 Astra、Claude Opus 5。
- AA-Briefcase 1657 Elo:比 4.6 高 111,与 Claude Opus 5、Fable 5.1 处在同一梯队。
- GDPval-AA 1695 Elo:比 4.6 高 90。
- 分项提升:DeepSWE 从 65% 到 73%,Terminal-Bench 4.0 从 18% 到 33%,SWE-Atlas-QnA 从 58% 到 63%。
语音方面更明显。10 月 14 日发布的 Grok Voice 3.0 在 Artificial Analysis Speech-to-Speech Index 上拿到 86.9 分,全球第一,高于 GPT-Live-1(Astra, medium)的 83.2 和 Gemini 3.8 Live Extended Thinking 的 82.6【第三方实测】。这说明 xAI 在单个方向上做到第一的能力是有的。
Grok 4.7 与 GPT-5.6 Sol、Fable 5.1 对比
下表是 xAI 在 Grok 4.7 公告里给出的对比数据,属于【官方自报】,不能当作第三方实测。
| 基准 | Grok 4.7 xHigh | GPT-5.6 Sol Max | Fable 5.1 Max | 可用平台 |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 41.7% | 51.8% | Grok 4.7:API易 apiyi.com、xAI 官方 |
| Terminal-Bench 4.0 | 37.6% | 37.3% | 57.9% | — |
| DeepSWE v1.1 | 71.0%(high) | 72.7% | 70.0% | — |
| EEBench | 64.0% | 39.4% | 56.4% | — |
| AA Briefcase v1.1 | 1,657 | 1,487 | 1,678 | — |
| Harvey Legal | 19.6% | 2.5% | 6.7% | — |
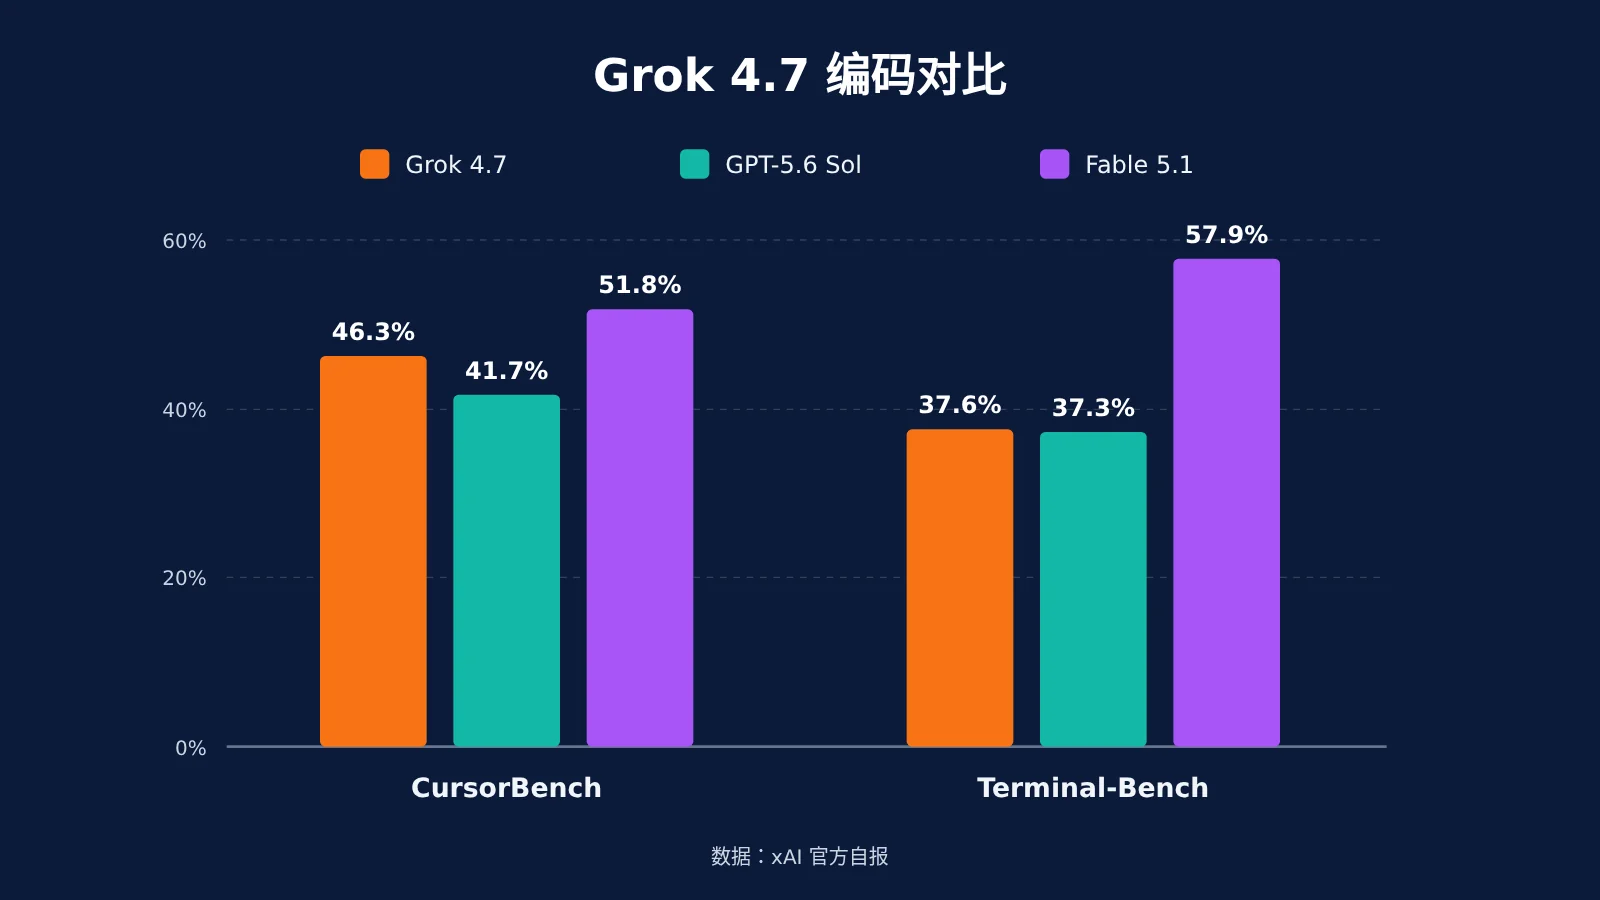
从这张表可以看出,Grok 4.7 在 CursorBench 上介于 GPT-5.6 Sol 和 Fable 5.1 之间,在 EEBench(电气工程)和 Harvey Legal(法律)上领先。它不是全面最强,但在「coding 价格性能、电气工程、法律、语音」这几个方向上优势很明确。
💡 对比说明:上表是厂商自报数据,不同 harness 下差距会比较大。建议用自己的真实任务复测,可以通过 API易 apiyi.com 用同一套接口分别调用 Grok、Claude、GPT 系列,换个
model参数就能做 A/B 对比。
生态与算力:Grok 4.8 的分发底座
模型能不能用起来,很大程度取决于分发渠道和算力。这方面 xAI 的家底不错:
- 用户规模:截至 2026-03-31,Grok 月活 1.17 亿(SpaceX S-1/A 文件),2025 年底是 8,900 万,约占 X 平台 5.5 亿月活的 21%。
- Grok Bot 增长:8 月 11 日开启 beta,到 9 月 14 日约 41.8 万周活,周环比 24%【第三方实测,Bloomberg 报道】。马斯克在 9 月 26 日的采访中称 Grok Bot 月增约 100%【马斯克口述,wccftech 转述】。
- Cursor 收购:8 月 14 日 SpaceX 完成 600 亿美元收购 Cursor。Cursor 官方表示会使用 SpaceX 最大的 GPU 集群,帮助改进 Grok Build、Grok Bot、Grok API 和 Cursor,Grok 4.6 是合作后的第一个成果。
- 企业渠道:10 月 7 日,Grok 4.7 上线 Microsoft Foundry。
这意味着 4.8 一发布,马上就有 Cursor、Grok Build、Grok Bot、X 几条渠道可以分发。fast 版本承接 Grok Bot 的日常请求,正是为这条分发链路准备的。
Grok 4.8 要补的短板
只谈长板会失真,Grok 4.7 的问题同样清楚:
- 终端类 agent 任务落后:Terminal-Bench 4.0 只有 37.6%,比 Fable 5.1 的 57.9% 低了 20 多个百分点【官方自报】。
- token 消耗大:在 Intelligence Index 测试中,平均每题输出 81k tokens,是 Grok 4.6 xhigh(38k)的两倍多【第三方实测】。单价虽然低,长推理任务的实际账单会被放大。
- 马斯克自己也承认差距:9 月 26 日他说 Grok 4.7 是「solid workhorse」,但不如 Anthropic 新的 Opus,追上前沿可能要到「明年某个时候」【马斯克口述】。
- RL 遗留问题:9 月 11 日他解释 4.7 延期时提到,RL 可能对回答长度惩罚过头,导致模型遇到难题时提前放弃、检查不够严谨【马斯克口述】。
期待 Grok 4.8 的 3 个观察点
结合上面的信息,Grok 4.8 发布后建议重点看三件事:
- 2.5T base model 能否兑现:参数量本身不代表能力。要看官方会不会给出 model card,以及 Artificial Analysis 等第三方的 Intelligence Index、Coding Agent Index 是否有实质提升,而不只是 1–2 分的增量。
- RL 是否解决「遇到难题提前放弃」:这是马斯克 9/11 亲口说的问题,RL 栈又是旧的。看长链路 agent 任务(Terminal-Bench、多小时编码)能不能明显缩小和 Fable 5.1 的差距,同时每题 token 消耗能否降下来。
- fast 版本能否撑住 Grok Bot 的日常请求:快速版要在低延迟和质量之间取得平衡。另外要关注它会不会像 4.7 Fast 一样只给 Cursor 与 Grok Build,开发者能否通过 API 调用。
Grok 4.8 发布前怎么用:官方价格与 API易 接入
xAI 官方 Grok 4.7 价格
以下是 xAI 官方定价【官方自报】,单位为美元 / 百万 tokens:
| 计费档位 | 输入 | 输出 | 缓存读 |
|---|---|---|---|
| 标准(prompt < 200k) | $2 | $6 | $0.5 |
| 长上下文(prompt ≥ 200k) | $4 | $12 | $1 |
官方另有几条规则:Batch API 打 8 折,美国区域端点按 1.1 倍计费,Grok 4.7 Fast 是标准价的 2 倍且只在 Cursor 与 Grok Build 中提供。Grok 4.7 支持文本和图像输入、文本输出,reasoning 档位有 low、medium、high(默认)、xhigh。
API易 当前 Grok 型号价格
以下是 API易 型号列表中的数据(2026-10-27 14:50 更新,单位为美元 / 百万 tokens,充值按 1:7),和官方价格分开列出:
| 型号 | 输入 | 输出 | 缓存读 | 接口 / 分组 |
|---|---|---|---|---|
grok-4.7 |
$2 | $6 | $0.5 | chat、CodexResponses;Default、SVIP |
grok-4.6 |
$2 | $6 | $0.5 | chat、CodexResponses;Default、SVIP |
grok-4.5 |
$2 | $6 | $0.5 | chat、responses |
grok-4.3 |
$1.25 | $2.5 | $0.2 | chat、responses |
grok-build-0.1 |
$1 | $2 | $0.2 | chat |
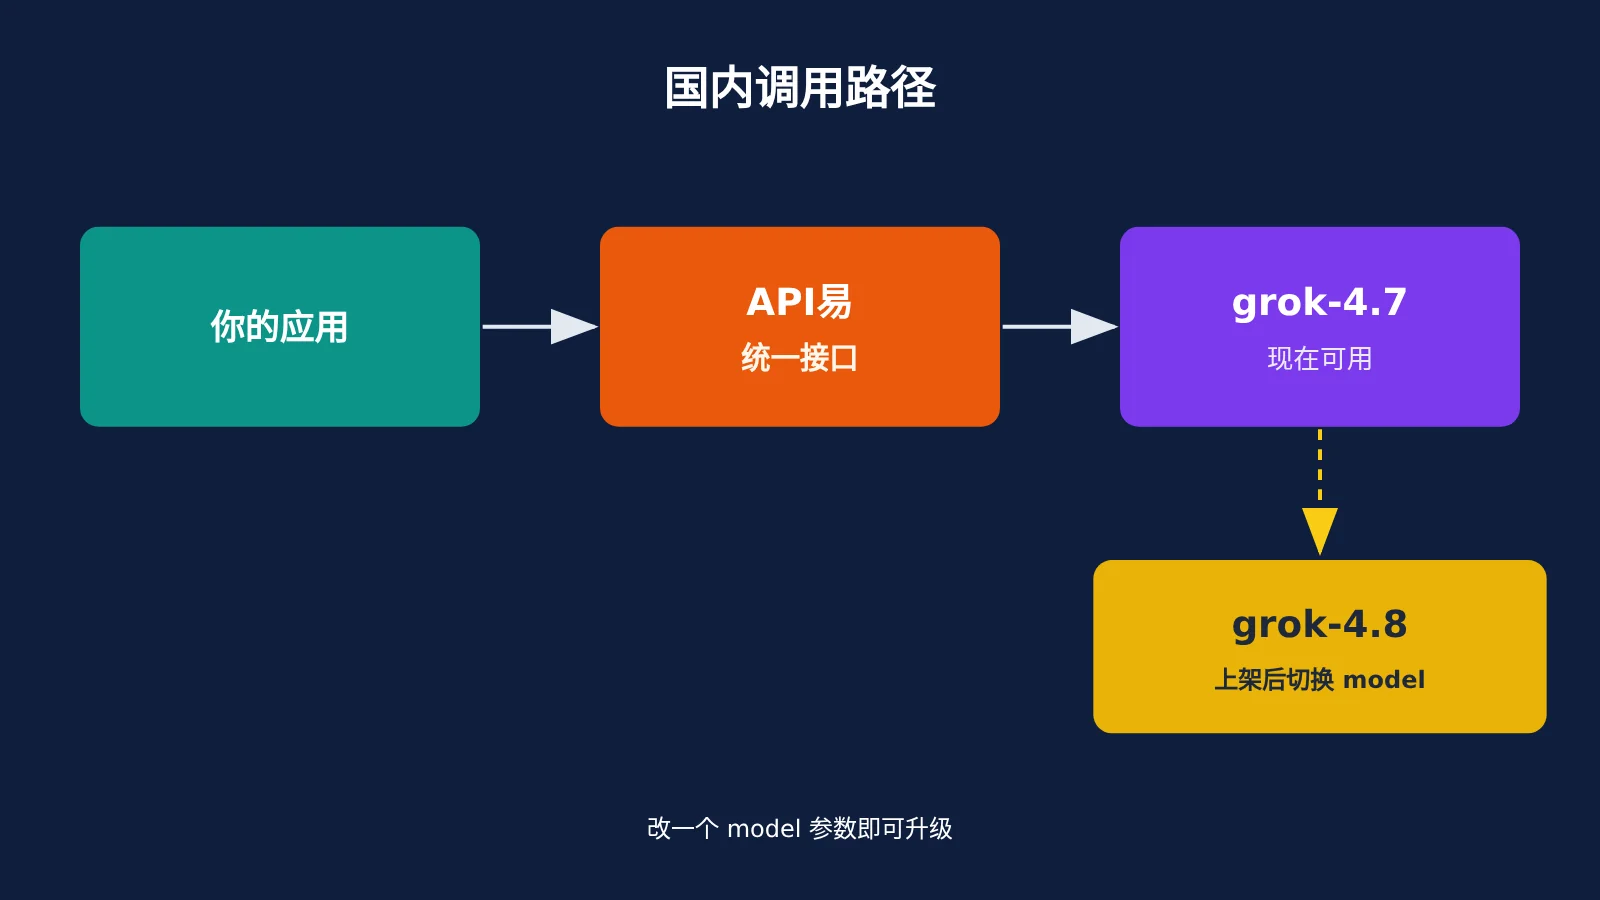
grok-4.7 已经在 API易 上架,可以直接调用。Grok 4.8 尚未发布、未进入 API,所以目前任何平台的型号列表里都没有它。
国内调用 grok-4.7 的接入步骤
本文不放代码块,接入只需要改几个参数:
base_url:设为https://api.apiyi.com/v1,使用 OpenAI 兼容 SDK 即可api_key:在 API易 控制台创建的 Keymodel:现阶段用grok-4.7;需要更低成本时可以换成grok-4.3- 接口:chat 走
/v1/chat/completions;在 Codex 一类工具里可以用 CodexResponses 方式接入 - 切换策略:把
model写进配置文件而不是硬编码,等 Grok 4.8 上架后,按型号列表改一个值就能升级
🎯 技术建议:Grok 4.8 正式开放 API 后,API易 会第一时间上架。现有的
grok-4.7调用不受影响,不会断档。建议先在 API易 apiyi.com 用grok-4.7把业务跑通,留好评测集,4.8 上架后直接用同一套用例对比新旧版本。
对国内开发者的影响
- 不必等:Grok 4.8 没有日期,业务不应该卡在一个未发布的模型上。4.7 已经进入第三方前四梯队,用来做 coding agent、法律和工程类文档处理完全够用。
- 算总账:4.7 的单价低,但 token 消耗高。评估时用「单任务总成本」,不要只比单价,缓存读 $0.5 在长上下文复用场景里能省下不少。
- 预留切换:参考 4.5 到 4.7 一直同价,4.8 也有可能沿用相近的定价,但这只是推测,没有官方信息,预算上要留出余量。
Grok 4.8 常见问题 FAQ
Q1:Grok 4.8 什么时候发布?
目前没有任何官方日期。马斯克 9 月 14 日说当周完成预训练并开始 RL,10 月 30 日承认「比预期花了更久」,但两次都没有给出时间。凡是写了具体发布日期的消息,目前都无法核实。
Q2:Grok 4.8 现在能用吗?
不能。Grok 4.8 尚未发布、未进入 API,xAI 官方文档里也没有 `grok-4.8` 这个型号。现阶段能用的最新版本是 `grok-4.7`,可以通过 API易 apiyi.com 用 OpenAI 兼容接口直接调用,价格为输入 $2、输出 $6、缓存读 $0.5(每百万 tokens)。
Q3:2.5T 意味着什么?
2.5T 指 2.5 万亿参数,来源只有马斯克 9 月 14 日的帖子,官方没有 model card,也不清楚是稠密模型还是 MoE 的总参数。它说明 xAI 在 4.7 的「更大 base model」之后继续放大预训练规模,但最终能力还要看 RL 阶段,而马斯克自己说 RL 栈仍是遗留代码。参数量只能当作潜力信号,不能当作能力结论。
Q4:API易 什么时候上架 Grok 4.8?
xAI 正式开放 Grok 4.8 的 API 之后,API易 会第一时间上架,具体时间取决于官方发布节奏,目前无法给出日期。在此之前可以先用 `grok-4.7`,4.8 上架后到 API易 apiyi.com 的型号列表查看新型号名,改一个 `model` 参数即可切换,现有调用不会中断。
Grok 4.8 核心要点 Key Takeaways
- 尚未发布:Grok 4.8 没有日期、价格、上下文长度和 API 型号名。
- 三个时间点:9/14 披露 2.5T 与 C++ 栈,10/7 提到 fast 版,10/30 称不会让人失望。
- 口述不等于规格:2.5T、C++ 栈、开始 RL 都是马斯克口述,没有 model card。
- 起点不低:Grok 4.7 的 AA 智能指数为 46,Coding Agent 指数排第 4,Voice 3.0 全球第一。
- 短板明确:Terminal-Bench 落后 Fable 5.1 约 20 个百分点,每题 token 消耗是 4.6 的两倍多。
- 三个观察点:base model 能否兑现、RL 能否解决提前放弃、fast 版能否撑住 Grok Bot。
- 现在就能用:API易 已上架
grok-4.7,4.8 上架后改型号名即可升级。
总结
关于 Grok 4.8 还要等多久,目前的答案是:没人知道,包括马斯克给出的公开信息也不足以推出日期。能确定的是三点:
- 规模在放大:按马斯克的说法,4.8 是 2.5T 模型,并换上了新的 C++ 预训练栈。
- 瓶颈在 RL:旧的 RL 栈和「遇到难题提前放弃」的问题,是延期最合理的解释,也是发布后最该验证的地方。
- 底子已经有了:十周三次迭代、价格不变、第三方前四梯队,再加上 Cursor 带来的算力和分发,4.8 值得期待,但还没到可以下结论的时候。
对技术团队来说,比较稳妥的做法是不等、不赌:先用 4.7 跑通业务,把评测集准备好,等 4.8 上架再用数据决定是否升级。
国内开发者现在就可以在 API易 用 grok-4.7,等 4.8 上架再升级:https://api.apiyi.com。型号与价格以平台型号列表为准。
📚 参考资料
- 马斯克 10 月 30 日帖子:「不会让人失望」原文
- 链接:
x.com/elonmusk/status/2116036703538606301 -
说明:本文开头引用的原话
-
马斯克 9 月 14 日帖子:2.5T 模型、新 C++ 栈、开始 RL
- 链接:
x.com/elonmusk/status/2099308197802631191 -
说明:Grok 4.8 规模信息的唯一来源
-
马斯克 10 月 7 日帖子:lightning-fast 版本进 Grok Bot
- 链接:
x.com/elonmusk/status/2107894231922876510 -
说明:fast 版本的出处
-
xAI Grok 4.7 公告与定价:官方 benchmark 和价格
- 链接:
x.ai/news/grok-4-7、docs.x.ai/developers/pricing -
说明:官方自报数据与 ≥200k 阈值定价
-
Artificial Analysis Grok 4.7 评测:第三方实测
- 链接:
artificialanalysis.ai/articles/benchmarking-grok-4-7 -
说明:Intelligence Index、Coding Agent Index、token 消耗数据
-
Cursor 加入 SpaceX:算力与分发合作
- 链接:
cursor.com/blog/joining-spacex - 说明:收购后的 GPU 集群与产品协同
作者:APIYI 技术团队
技术交流:欢迎在 API易 网站首页联系我们,更多 Grok 系列接入资料可访问 docs.apiyi.com 文档中心