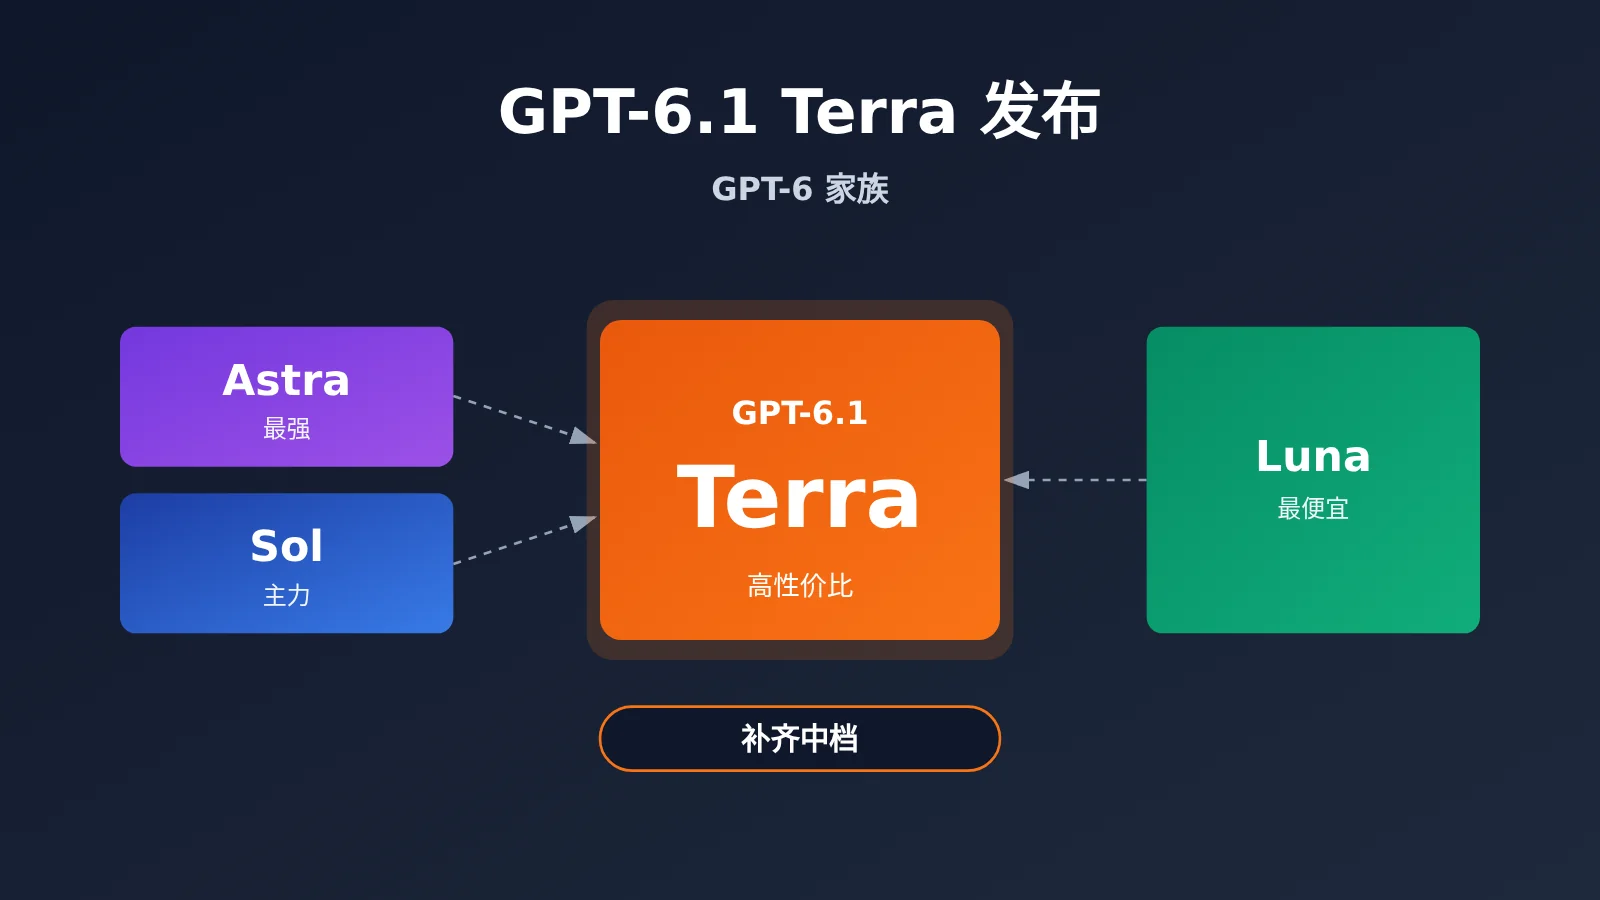
2026 年 10 月 26 日,OpenAI 正式发布 GPT-6.1 Terra,Token 单价只有 Sol 的一半、Astra 的十分之一,部分视觉与电脑操作测试却接近旗舰水平。这款模型因此受到不少关注。很多开发者的第一反应是:已经有最强的 Astra、综合主力 Sol 和最便宜的 Luna,OpenAI 为什么还要再推出一个 Terra?
这不是小道消息。OpenAI 官方公告、API 模型页和定价页已经同步上线,Artificial Analysis、Plotly、DualEntry 等第三方机构也在发布当天公开了实测数据。本文会把这些信息放在一起,讲清楚 GPT-6.1 Terra 在 GPT 家族里的位置。
核心价值:用几分钟了解 GPT-6.1 Terra 的核心参数、价格、实测表现,以及它和 Astra、Sol、Luna 各自适合做什么。
GPT-6.1 Terra 核心信息速览
先看基本事实。下表汇总了 OpenAI 官方公告和 API 文档中确认的关键信息:
| 信息项 | 详情 |
|---|---|
| 发布时间 | 2026 年 10 月 26 日(国内报道集中在 27 日) |
| 发布方 | OpenAI |
| API 模型 ID | gpt-6.1-terra |
| 官方定位 | 快速、高效,重点提升视觉推理、精确电脑操作和自然语言写作 |
| 上下文窗口 | 1,050,000 Token,最大输出 128,000 Token |
| 知识截止 | 2026 年 6 月 1 日 |
| 输入 / 输出模态 | 输入文本、图像;原生输出文本;不支持音频和原生视频输入 |
| 推理强度 | none / low / medium / high / xhigh / max 六档,默认 medium |
| 可用范围 | ChatGPT Work、Codex(Plus、Pro、Enterprise、Edu),以及 OpenAI API |
有一个版本号细节需要说明。此前 Terra 停留在 GPT-5.6 版本,这次是从 5.6 Terra 直接升级到 6.1 Terra,并不存在正式发布过的 GPT-6.0 Terra。从时间线看,9 月 3 日发布旗舰 GPT-6 Astra,9 月 22 日发布 Sol 和 Luna,9 月 29 日 Sol 升级到 6.1,到 10 月 26 日 Terra 补上,GPT-6 系列的四档阵容才算凑齐。
GPT-6.1 Terra 的能力边界
Terra 支持流式输出、结构化输出和函数调用。工具调用需要通过 Responses API 实现,可接入网页搜索、文件搜索、Computer Use、Shell、Code Interpreter、MCP 等工具。
需要注意的是,“能借助软件剪辑视频”不等于模型原生支持视频生成,“能看懂截图”也不等于接入 API 后就能自动操作用户电脑。具体能做什么,取决于你给它配置的工具和运行环境。另外,105 万 Token 的上下文窗口与 Sol、Astra 属于同一级别,不是 Terra 独有的优势。
GPT-6.1 Terra 在 GPT 家族中的定位
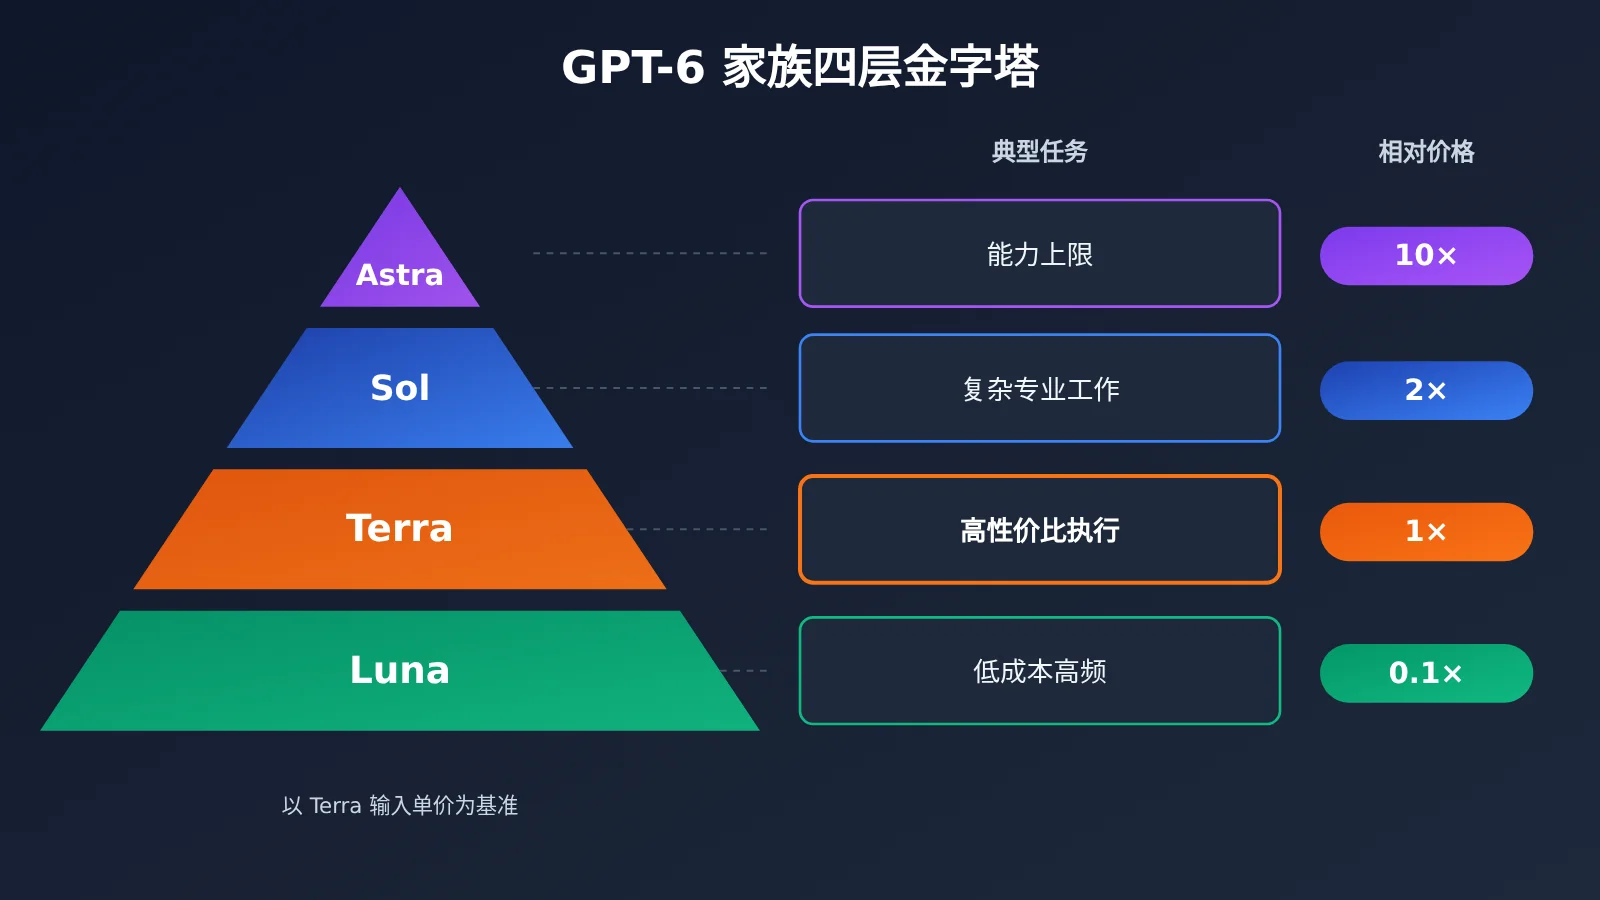
理解 Terra,关键在于看清整个家族的分工。OpenAI 官方选型指南把当前主力模型分为四个层级,各自对应不同的任务难度和预算。
| 模型 | 定位关键词 | 典型任务 | 一句话总结 |
|---|---|---|---|
| GPT-6 Astra | 最高智能、复杂推理 | 困难编程、科研、长流程专业项目 | 追求能力上限 |
| GPT-6.1 Sol | 接近旗舰、成本均衡 | 复杂代码开发、深度调查、多步骤项目 | 承担复杂专业工作 |
| GPT-6.1 Terra | 视觉理解、电脑操作、快速执行 | 发票录入、图纸理解、跨软件表单操作、文档起草 | 高性价比执行现实工作流 |
| GPT-6 Luna | 轻量、极低价、高并发 | 分类、格式转换、简单提取 | 最低成本完成重复任务 |
GPT-6.1 Terra 不是缩水版 Sol
Terra 位于 Sol 和 Luna 之间,但它不是把 Sol 的能力平均削减一截。官方强调的是从“看懂信息”到“执行操作”的完整链路,比如识别一张截图、判断该点击哪个按钮、再跨软件填报数据并输出结果。这类任务对视觉理解和操作精度要求高,但不一定需要旗舰级的综合推理。
这说明 OpenAI 的思路已经变了:不再让所有用户都去用同一个最强模型,而是按任务难度、执行速度和成本来分层。Terra 补上的正是“Luna 做不好、交给 Sol 又不划算”的中间区域。
🎯 技术建议:如果你想在同一套代码里对比 Astra、Sol、Terra、Luna 的实际效果,可以通过 API易 apiyi.com 使用 OpenAI 兼容接口统一调用,切换模型只需要改
model参数。
GPT-6.1 Terra 价格对比与真实成本
价格是 Terra 最直观的卖点。以下是 OpenAI 官方 Standard API 价格,单位为美元 / 每百万 Token,适用于普通短上下文区间:
| 模型 | 输入 | 缓存输入 | 输出 | 可用平台 |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $1.00 | $50.00 | OpenAI API、API易 apiyi.com |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 | OpenAI API、API易 |
| GPT-6.1 Terra | $1.00 | $0.05 | $5.00 | OpenAI API、API易 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | OpenAI API、API易 |
| 上代 GPT-5.6 Terra | $2.00 | $0.20 | $12.00 | — |
按单价算,Terra 是 Sol 的 50%、Astra 的 10%、Luna 的 10 倍。和上代 5.6 Terra 相比,输入降价 50%,输出降价约 58.3%,缓存读取降价 75%。假设一次任务消耗 10 万输入 Token 和 1 万输出 Token,Astra 约 $1.50,Sol 约 $0.30,Terra 约 $0.15,Luna 约 $0.015。
GPT-6.1 Terra 计费的几个坑
单价便宜不代表总成本一定低。下面几条计费规则需要提前了解:
- 长上下文溢价:单次请求输入超过 272K Token 时,整次请求的输入和缓存价格按 2 倍计,输出按 1.5 倍计。
- 服务档位:Batch / Flex 模式约为 Standard 价格的一半,Fast 模式是 Standard 的 2 倍。
- 缓存写入:30 分钟缓存写入为 $1.25 / 百万 Token,12 小时缓存写入为 $2.50 / 百万 Token。
- 推理强度:档位越高,消耗的推理 Token 越多,工具调用也可能另外收费。
更值得注意的是官方 OSWorld 图表中的一组数据:Terra max 每任务成本约 $1.19,Sol max 约 $1.15。也就是说,在推理量和操作步骤增加之后,单价减半的 Terra 不一定是最终最省钱的选项。
GPT-6.1 Terra 性能实测数据
官方基准:特定能力逼近旗舰
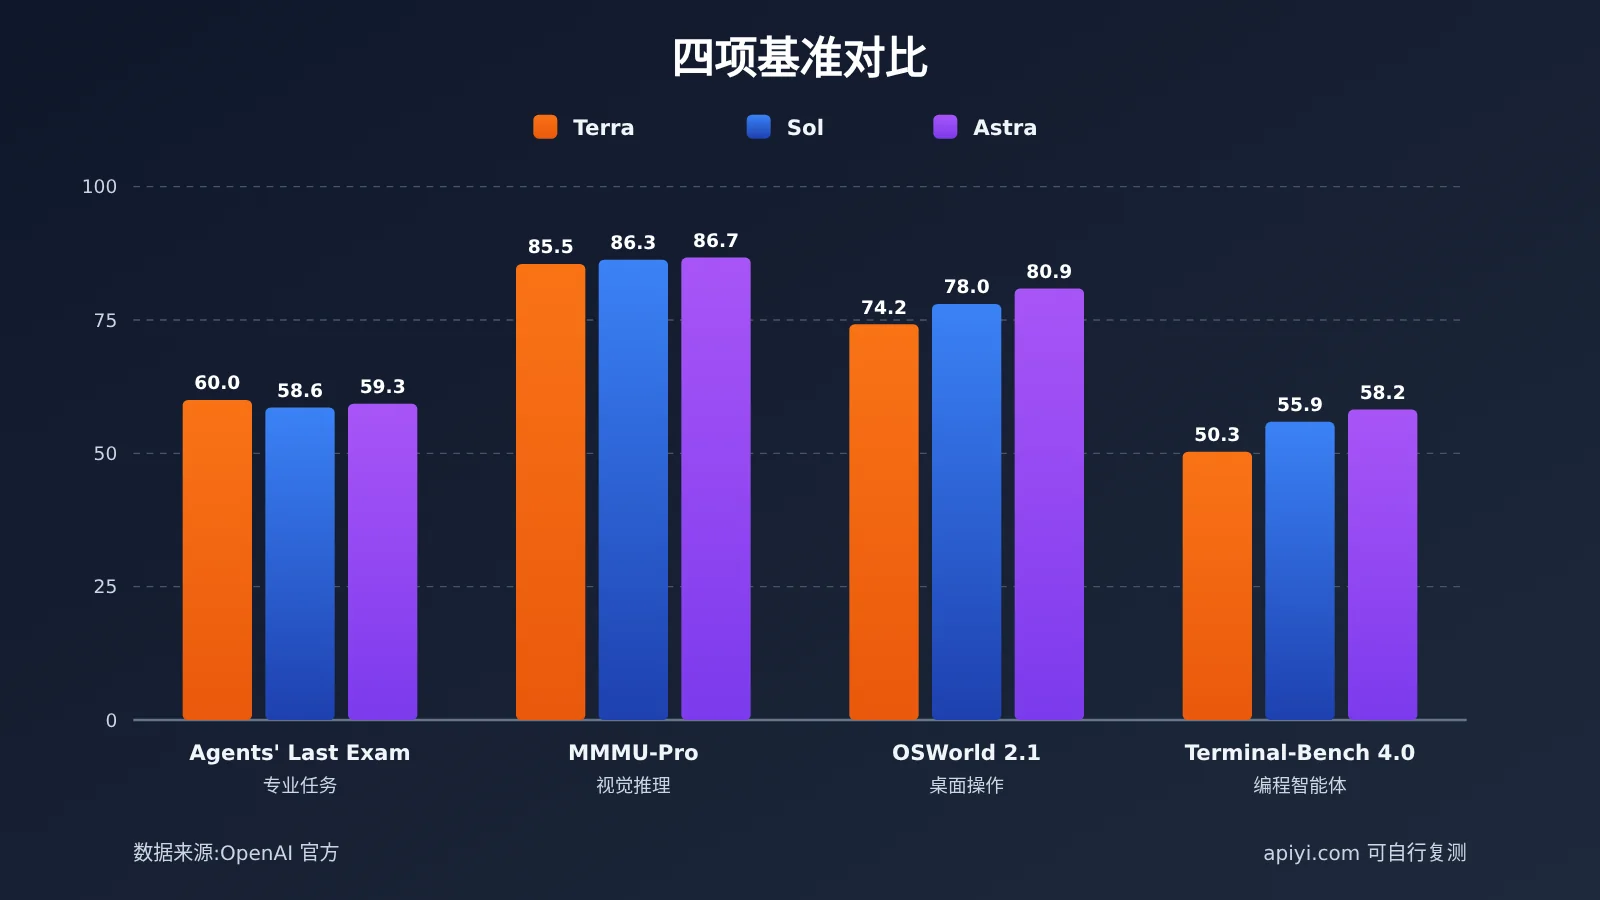
OpenAI 公布了多项测试结果,其中部分完整数值由 Kingy.ai 从官方交互图表中转录,属于厂商测试数据。下表挑出了最能说明定位的几项:
| 测试项目(max 推理档) | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Agents’ Last Exam(专业任务) | — | 60.0% | 58.6% | 59.3% |
| MMMU-Pro(视觉推理) | 81.7% | 85.5% | 86.3% | 86.7% |
| OSWorld 2.1(桌面操作) | 57.1% | 74.2% | 78.0% | 80.9% |
| Terminal-Bench 4.0(编程智能体) | 21.5% | 50.3% | 55.9% | 58.2% |
| Terminal-Bench-Science 0.1 | — | 58.3% | 57.0% | 68.1% |
这组数据有几个看点。在 Agents’ Last Exam 中,Terra medium 得到 57.6%,比上代 medium 的 42.6% 高出 15 个百分点,估算每任务成本从 $0.84 降到 $0.29,并且和 Astra medium 打平。视觉推理方面,Terra max 和 Astra max 只差 1.2 个百分点,这是 Terra 最有说服力的优势之一。
短板同样明显。复杂编程上,Terra 虽然比上代提升了 28.8 个百分点,但仍落后 Sol 和 Astra。官方图表还显示,Sol medium 在 Terminal-Bench 4.0 上得到 52.7%,已经高于 Terra max 的 50.3%,而且任务成本约 $1.02,低于 Terra max 的约 $1.84。在 Agents’ Last Exam 中,Claude Opus 5.5 max 以 63.2% 仍然领先 Terra。
事实错误率的改进也值得一提。官方内部测试中,低推理强度下 Terra 的事实错误率从上代的 53.6% 降到 16.7%,最高推理强度下为 4.3%。不过这些数据来自专门设计的困难事实题,不能理解为日常聊天的幻觉率只有 4.3%。
第三方实测:效率高,稳定性待验证
只看厂商数据不够全面,第三方测评提供了更多参照:
| 测评来源 | GPT-6 Luna | GPT-6.1 Terra | GPT-6.1 Sol | 关键发现 |
|---|---|---|---|---|
| Artificial Analysis 智能指数(max) | 约 38 | 48 | 52 | Terra max 成本约为 Sol max 的 56% |
| Plotly 数据分析(43 题) | 38 题 / $0.13 | 40 题 / $1.31 | 43 题 / $2.61 | Terra 费用约为 Sol 一半 |
| DualEntry 会计任务准确率 | 66.3% | 78.2% | 81.2% | Terra 三次全通过率仅 65.3% |
Artificial Analysis 特别指出,Terra 的 low 和 medium 档位处在智能与成本的帕累托前沿,medium 档智能指数为 41,每任务成本约 $0.10。换句话说,并不是所有推理档位都同样划算。该机构的 AA-Omniscience 测试还显示,面对不知道答案的问题,Terra 的“硬猜”比例从上代约 88% 降到约 38%。
Plotly 的观察比较有意思。Terra 每题平均生成约 1460 个 Token、调用约 4.5 次,实际输出速率约每秒 64 Token。它更快的部分原因是输出更简洁、步骤更少。这也带来一个疑问:精简的背后,有没有漏掉必要的工作?DualEntry 的结果也指向这一点:Terra 平均每任务 16.1 秒、约 $0.042,速度和成本都明显占优,但在应付账款、月末结账等任务上准确率只有五六成,稳定性还不足以替代人工审核。
GPT-6.1 Terra 快速调用示例
Terra 已在 OpenAI API 中开放。下面用 OpenAI 兼容接口演示基础调用,reasoning_effort 用来控制推理档位:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 统一接口
)

resp = client.chat.completions.create(
    model="gpt-6.1-terra",
    reasoning_effort="medium",  # none/low/medium/high/xhigh/max
    messages=[{"role": "user", "content": "把这段发票信息整理成 JSON:..."}]
)
print(resp.choices[0].message.content)
查看任务分层调用的完整示例
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

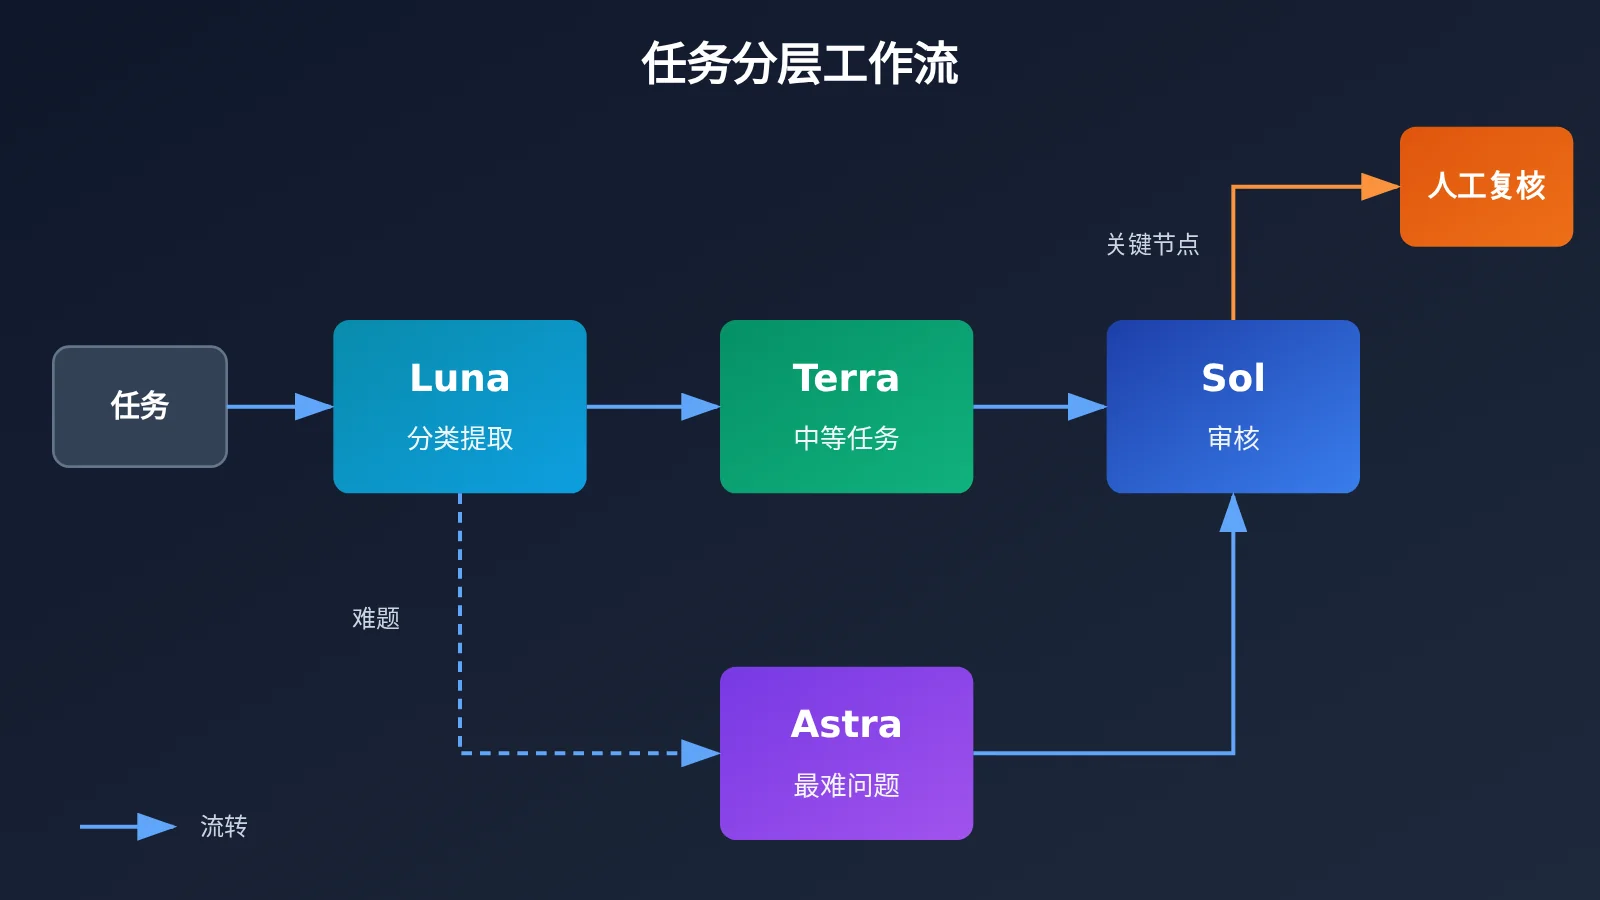
# 按任务难度分层选择模型(策略示例,非官方规定)
TIER = {
    "simple":  ("gpt-6-luna",    "low"),     # 分类、提取
    "medium":  ("gpt-6.1-terra", "medium"),  # 中等复杂度执行
    "complex": ("gpt-6.1-sol",   "high"),    # 复杂判断与审核
}

def run(task: str, level: str = "medium") -> str:
    model, effort = TIER[level]
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort=effort,
        messages=[
            {"role": "system", "content": "你是严谨的业务助理,完成全部要求后再结束。"},
            {"role": "user", "content": task},
        ],
    )
    return resp.choices[0].message.content

# Terra 执行,Sol 复核
draft = run("根据以下报表数据生成月度摘要:...", "medium")
review = run(f"检查下面的摘要是否遗漏要点或存在错误:\n{draft}", "complex")
print(review)
需要说明的是,Computer Use、Shell 等工具调用必须走 Responses API,上面的 Chat Completions 示例只适合文本和图像理解类任务。具体可用模型 ID 以平台模型列表为准。
🚀 快速开始:新用户可以在 API易 apiyi.com 领取免费测试额度,用自己的真实业务数据同时跑一遍 Terra 和 Sol。比起看榜单,这样更能判断哪个模型在你的场景里总成本更低。
影响分析:GPT-6.1 Terra 意味着什么
对开发者的影响
- 多智能体分工更现实:r/codex 社区有开发者尝试让 Astra 或 Sol 负责规划与审查,Terra 负责执行大量边界清楚的子任务。这种组合能明显降低中间环节的成本。
- 中等复杂度自动化门槛下降:发票录入、商品图比对、图纸理解这类任务,过去用旗舰太贵、用 Luna 不够稳,现在有了更合适的选项。
- 必须设计复核机制:社区里也有用户抱怨 Terra 会“过早宣布完成”,被指出遗漏后补做时仍可能只做最低限度。这些是发布不到两天的个案反馈,不能视为共识,但提醒开发者在关键流程中保留检查环节。
对行业的影响
- 竞争焦点从智能上限转向任务分层:模型厂商比拼的不只是“谁最强”,还有“每一美元能完成多少工作”。
- 对 Claude 中高端模型形成价格压力:OpenAI 宣称在 Agents’ Last Exam 中 Terra max 每任务成本约为 Opus 5.5 的九分之一,但 Opus 5.5 和 Sonnet 5.5 在部分测试中得分仍更高,Terra 还不能算全面替代品。
- 安全关注点前移:官方系统卡将 Terra 的网络安全能力归入 Critical 阈值、生化能力归入 High 阈值。这是风险能力等级,不是安全评分。对执行型 AI 来说,授权边界和提示注入防护更加重要。
常见问题 FAQ
Q1:GPT-6.1 Terra 是什么?
GPT-6.1 Terra 是 OpenAI 于 2026 年 10 月 26 日发布的中档模型,API ID 为 `gpt-6.1-terra`。它重点优化视觉推理、电脑操作和自然写作,定位是以较低成本完成大量真实工作流程。
Q2:GPT-6.1 Terra 和 Sol 有什么区别?
Terra 的 Token 单价是 Sol 的一半,视觉与部分操作任务表现接近 Sol。但在综合智能指数、复杂编程和稳定性上,Sol 仍然领先。复杂编程任务中,Sol medium 甚至可能比 Terra max 更强、更省钱。
Q3:普通 ChatGPT 用户能用上 GPT-6.1 Terra 吗?
Terra 主要面向 ChatGPT Work、Codex 以及 API 开发者,Plus、Pro、Enterprise、Edu 用户已可使用,Business 版本正在逐步开放。它并不是普通 Chat 对话菜单里的通用选项。
Q4:如何快速通过 API 测试 GPT-6.1 Terra?
可以在 API易 apiyi.com 注册并获取 API Key,把 base_url 设为 `https://api.apiyi.com/v1`,用本文代码即可调用。同一个 Key 还能调用 Sol、Luna 以及 Claude、Gemini 等模型,方便横向对比。
Q5:GPT-6.1 Terra 有哪些已知局限?
复杂编程和综合推理仍不如 Sol、Astra。会计等企业流程中稳定性一般,部分用户反馈存在提前结束任务的问题。高推理档位的总成本也不一定比 Sol 低,建议通过 API易 apiyi.com 用真实任务实测后再上线。
GPT-6.1 Terra 核心要点 Key Takeaways
- 定位清晰:Terra 是 GPT-6 家族的中档执行模型,夹在 Sol 和 Luna 之间
- 价格优势:单价为 Sol 的一半、Astra 的十分之一,比上代降价超过五成
- 强项突出:视觉推理逼近旗舰,专业任务测试中 medium 档与 Astra medium 持平
- 短板明确:复杂编程、综合智能和多次运行稳定性仍落后 Sol 与 Astra
- 成本看总账:高推理档位下总成本可能追平 Sol,low 和 medium 档更划算
- 上手方式:可通过 API易 apiyi.com 统一接口对比四款模型的真实成本
总结
GPT-6.1 Terra 的发布,说明 GPT 家族正在从比拼智能上限转向更精细的任务分层。可以把四款模型的分工这样理解:
- Astra 守上限:最难的科研、编程和专业决策交给它。
- Sol 扛复杂:长期高水平工作和结果审核的主力。
- Terra 管执行:视觉理解、电脑操作和中等复杂度批量任务的性价比之选。
- Luna 跑量:规则明确的分类与提取,用它最省钱。
Terra 不是缩水版 Sol,也不是加强版 Luna,更不是旗舰的全面替代。它的价值体现在特定工作流中速度、能力与成本的平衡。真正该问的不是“谁的 Token 最便宜”,而是“谁能用最低总成本把你的任务做对”。
推荐通过 API易 apiyi.com 用自己的业务数据实际跑一轮对比,再决定 Terra 在你的系统中承担哪一层工作。
📚 参考资料
- OpenAI 官方发布公告:GPT-6.1 Terra 定位、官方测试与可用性
- 链接:
openai.com/index/introducing-gpt-6-1-terra -
说明: 最重要的一手资料
-
OpenAI API 模型页与定价页:规格、推理档位与计费规则
- 链接:
developers.openai.com/api/docs/models/gpt-6.1-terra -
说明: 上下文、工具支持和价格细节
-
Artificial Analysis 独立测评:智能指数、成本效率与幻觉测试
- 链接:
artificialanalysis.ai/models/releases/gpt-6-1-terra -
说明: 各推理档位的第三方对比
-
Plotly DataAnalyticsBench 实测:43 道数据分析题的正确率与费用
- 链接:
plotly.com/blog/gpt-6-1-terra-plotly-data-analytics-bench -
说明: 揭示 Terra 速度优势的来源
-
DualEntry 会计任务实测:101 项会计任务的准确率与稳定性
- 链接:
dualentry.com/blog/gpt-6-1-terra-accounting-benchmark -
说明: 企业流程稳定性的重要参考
-
GPT-6.1 Terra 官方系统卡:风险分级与防护措施
- 链接:
deploymentsafety.openai.com/gpt-6-1-terra - 说明: 部署安全相关信息
作者:APIYI 技术团队
技术交流:欢迎访问 API易 apiyi.com 联系我们,更多接入资料可查阅 docs.apiyi.com 文档中心