作者注:Claude 提示词缓存命中率突然掉到 0,或者账单一直降不下来,可以用 diagnostics 三步找到前缀分叉的位置,再结合 usage 判断缓存是否真正命中。本文也会说明走 API易 中转时怎么自查。(如果你有这个问题,可以在看完这篇文章后把这篇文章发给你的 Agent,让他去排查)
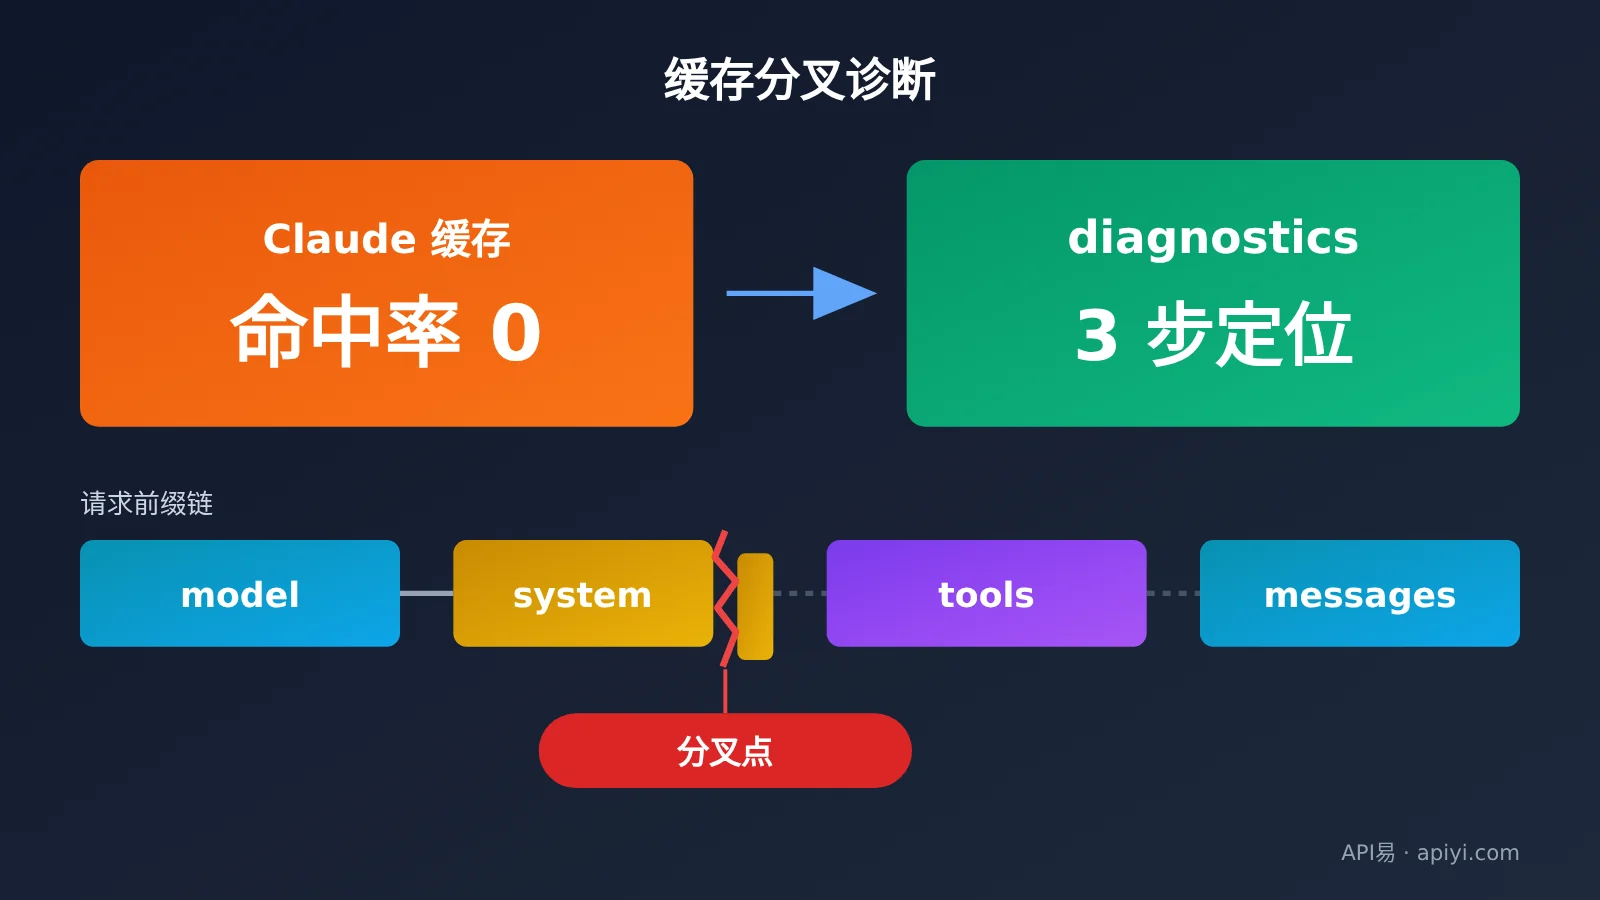
缓存没命中不是玄学,API 会告诉你前缀从哪一段开始分叉。你只需要把上一轮响应的 id 传回去,就能看到第一个不一致的地方落在 model、system、tools 还是 messages。
这不是一篇功能发布解读。本文写给已经在用 Claude 提示词缓存、但命中率突然归零或账单居高不下的开发者,所有排查步骤都会写清楚每一步会看到什么。
核心价值:读完本文,你能在三轮请求之内定位缓存失效的原因。你也能分清 diagnostics 和 usage 各自说明什么,并知道走中转时用哪两个字段互相比对。
Claude 缓存诊断 diagnostics 核心要点
先用一句话说清它是什么:把上一轮响应的 id 传进来,API 会对比两次请求,指出第一个分叉点落在 model、system、tools 还是 messages。以前缓存悄悄失效时,你只能看到 usage.cache_read_input_tokens 变成 0,却不知道是哪一段变了。
| 要点 | 说明 | 对你的价值 |
|---|---|---|
| 开关 | 请求体顶层带 diagnostics 对象才会存指纹 |
不用改业务逻辑,加一个字段即可 |
| 对比方式 | previous_message_id 传上一轮响应 id |
直接定位第一个分叉段 |
| 结论字段 | cache_miss_reason 给出六种类型之一 |
每种类型都有明确的修复位置 |
| 配合指标 | 需要和 usage.cache_read_input_tokens 一起看 |
避免把「没分歧」误判成「没生效」 |
| 可用范围 | 只有官方 Claude API 提供 | 走其他通道需要换用 usage 自检 |
Claude 缓存诊断的时间线
这个功能在 2026 年 5 月以 beta 形式上线,当时需要带 anthropic-beta: cache-diagnosis-2026-04-07 这个 header。9 月期间规则收紧过一次:只有显式带了 diagnostics 对象的请求才会存指纹,只带 header 的请求不会被记录。
9 月 23 日它转为正式版,不再需要 cache-diagnosis-2026-04-07,带着旧 header 的请求也照常能用。现在 POST /v1/messages 的响应里总会出现 diagnostics 字段,没有开启时值为 null。所以看到这个字段是 null,并不代表接口出了问题。
指纹里只保存哈希和 token 数估计,不保存原始提示词内容。它按 response id 索引,作用域限定在本组织和本 workspace,保留时间较短。
3 步用 diagnostics 排查 Claude 缓存命中率
下面三步按官方字段说明来写。如果你通过 API易 调用,Messages 原生接口的 base_url 填 https://api.apiyi.com/v1,请求路径是 /v1/messages。不过要注意,后文实测部分会说明中转场景下 diagnostics 的实际回传情况。
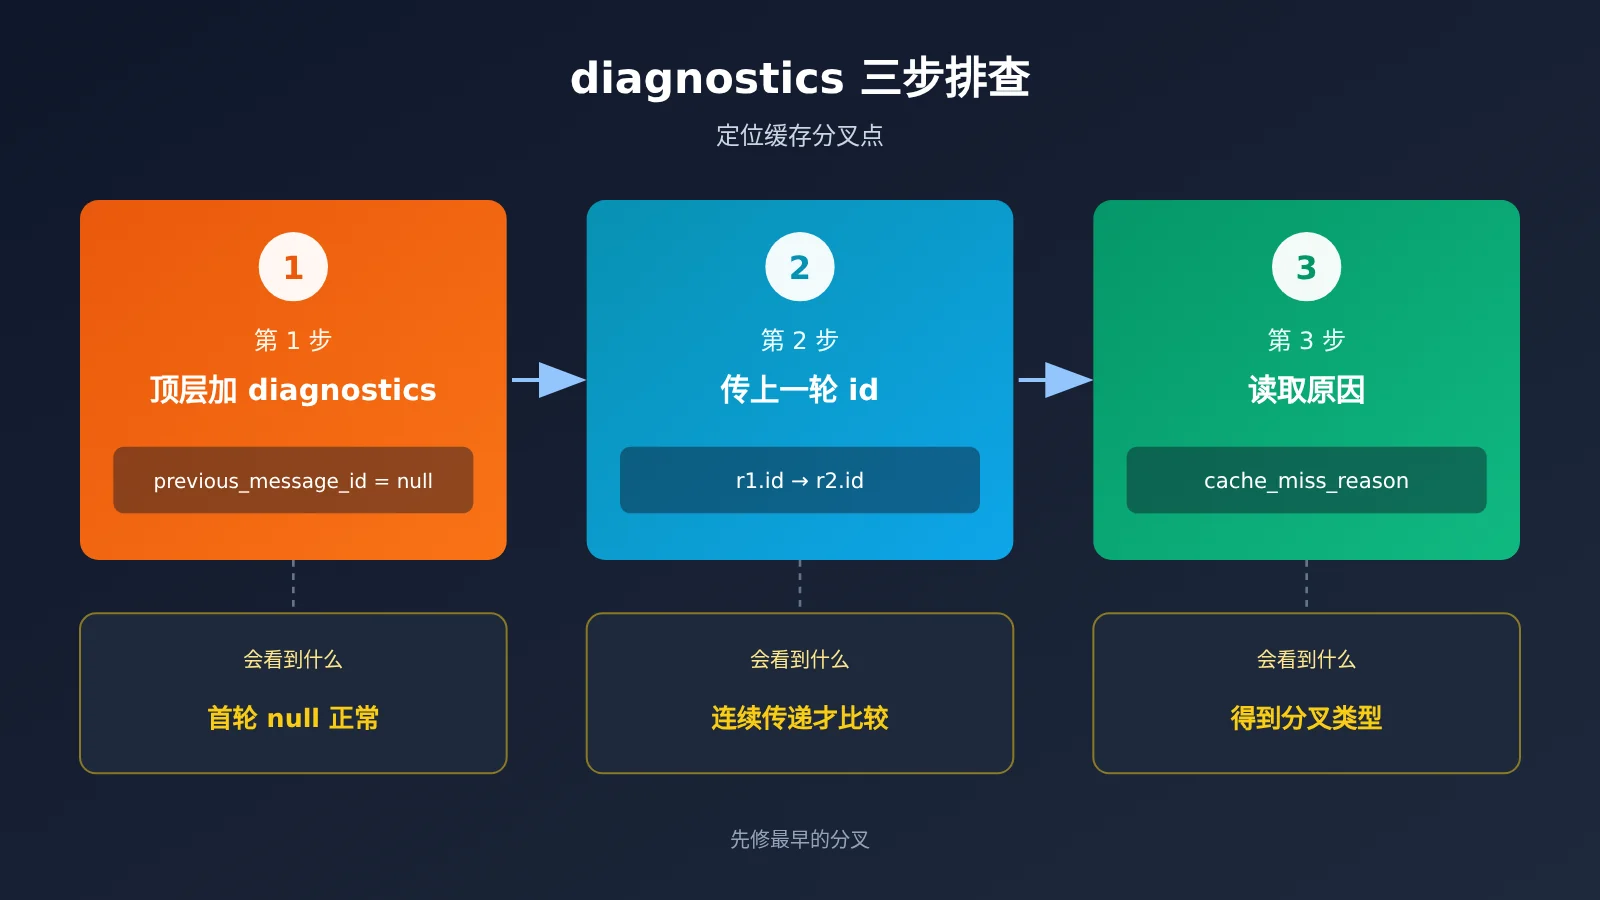
第 1 步:在请求顶层加 diagnostics 对象
diagnostics 是唯一的开关,没带它的请求不会存指纹,后面也就无从比较。第一轮没有可以对比的对象,所以 previous_message_id 传 null,意思是「从这一轮开始记录」。
- 请求头保留常规版本号:
anthropic-version: 2023-06-01 - 正式版之后不需要再带:
anthropic-beta: cache-diagnosis-2026-04-07 - 在请求体顶层加上:
"diagnostics": {"previous_message_id": null} - 需要缓存的 system 块照常打断点:
"cache_control": {"type": "ephemeral"} - 会看到什么:响应里
diagnostics为null,cache_read_input_tokens通常为 0,cache_creation_input_tokens大于 0
第一轮看到 null 不代表失败。这一轮是在写缓存,本来就没有可比的上一轮,不需要排错。
第 2 步:之后每一轮都传上一轮响应的 id
从第二轮开始,把上一轮响应的 id 填进 previous_message_id。最常见的错误是只在第一轮带 diagnostics,之后漏掉。下一轮指向的那次请求没有被记录,结果会返回 previous_message_not_found。
- 第二轮请求体:
"diagnostics": {"previous_message_id": "<第一轮响应的 id>"} - 第三轮请求体:
"diagnostics": {"previous_message_id": "<第二轮响应的 id>"} - 多轮循环的规律:第一轮传
null,第二轮传r1.id,第三轮传r2.id,以此类推 - 流式调用时,结果出现在
message_start事件里,id 同样一轮轮往后传 - 会看到什么:相邻两轮间隔够短、且在同一 workspace 内时,响应里开始出现比较结果
第 3 步:读 cache_miss_reason 并对号修复
diagnostics 有三种取值,读之前先分清楚:
null:请求没带diagnostics;或者previous_message_id为null;或者比较已经完成且没有发现分歧{"cache_miss_reason": null}:比较还在进行中,因为响应开始得太快,这一轮先不下结论,看下一轮cache_miss_reason是一个对象:已经有结论,里面带着分叉类型和细节- 会看到什么:拿到类型后按下一节的对照表修改,先修最早的那个分叉,因为它只报第一个分歧点,后面的问题可能被它挡住了
🚀 快速开始:如果想先确认自己的缓存前缀能不能写入和命中,可以在 API易 apiyi.com 用同一个 Key 切换 Claude 各型号做两轮对照,重点看 usage 里缓存写入和读取两个数字是否对得上。
cache_miss_reason 六种类型与修复位置
拿到 cache_miss_reason 之后,按下表对应到要改的地方:
| 类型 | 含义 | 改哪里 |
|---|---|---|
model_changed |
模型和上一轮不同,比如路由、A/B 测试或 fallback 换了模型。缓存按模型隔离 | 同一段缓存对话里固定模型 |
system_changed |
system 变了,最常见的是插入了时间戳、请求 ID 等每次都不同的值 | system 改成逐字节稳定的常量,动态数据挪到断点之后的第一条 user 消息 |
tools_changed |
工具被增删、调换顺序,或 input_schema 序列化结果不稳定 |
每轮发送同一份工具列表,顺序固定,序列化按键排序 |
messages_changed |
更早的消息被改动、重排或删除,而不是在末尾追加 | 历史只追加,assistant 内容和工具结果原样回传 |
previous_message_not_found |
找不到对应指纹,不等于请求变了 | 每轮都带 diagnostics,不跨 workspace,间隔不要太长 |
unavailable |
这一轮拿不到诊断结果,比如 tool_choice、thinking、context_management、output_config、output_format 或 beta header 集合不一致,也可能是对话太长 |
一条缓存对话的整个生命周期里,这些参数保持不变 |
四个 *_changed 类型还会附带 cache_missed_input_tokens,表示分叉点之后大约丢掉了多少可缓存的输入 token。这个数是按字节长度换算的,只能用来判断数量级,不是账单数字,偶尔还会比 usage.input_tokens 还大。
单看 diagnostics 会误判:结合 usage 判断 Claude 缓存命中
diagnostics 回答的是「我的请求变了吗」,usage.cache_read_input_tokens 回答的是「缓存命中了吗」。两个问题不一样,只看其中一个就容易得出错误结论。
| diagnostics 结果 | 缓存读 token | 结论 | 怎么做 |
|---|---|---|---|
null |
高 | 前缀稳定,缓存命中 | 不用处理 |
null |
低或为 0 | 请求没变,但缓存已经过期 | 缩短请求间隔,或改用 1 小时 TTL |
*_changed |
低 | 请求变了,导致没有命中 | 按上一节的对照表修复 |
*_changed |
高 | 变化发生在靠后的位置,前面的断点仍然命中 | 值得修,但影响较小 |
需要再强调一次:null 不等于没生效,它可能正是最好的结果。还有几种情况不适用这张表:第一轮,cache_miss_reason 为 null(比较还在进行),以及 previous_message_not_found 和 unavailable。这几种情况下根本没有产生有效比较。
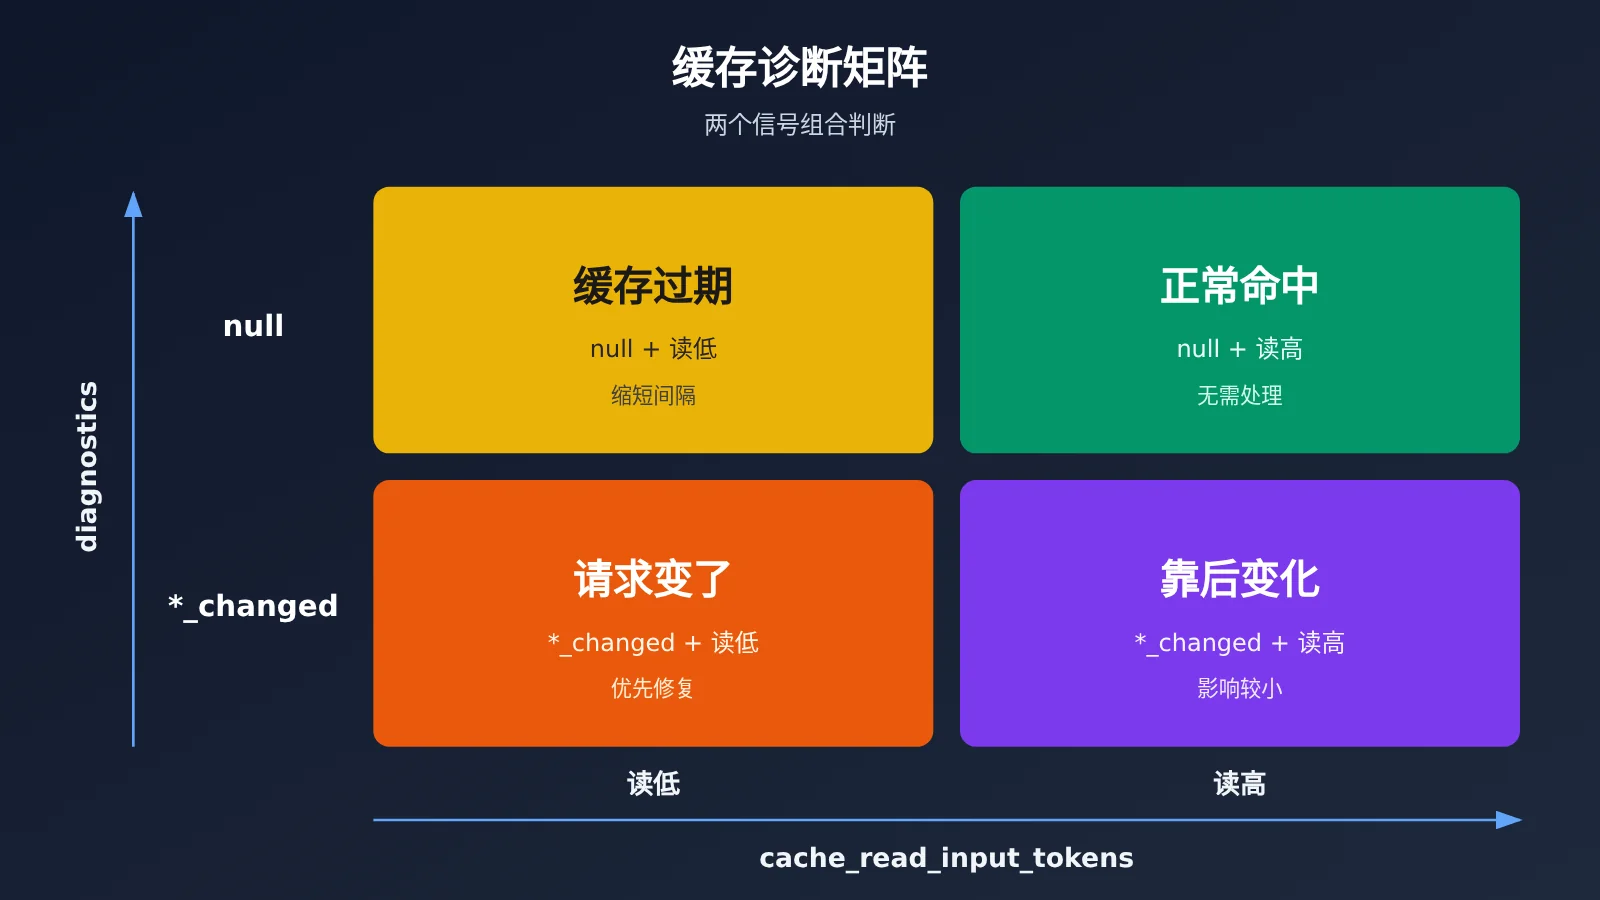
如果你还没确定哪一轮属于哪个格子,可以在 API易 apiyi.com 上把同一份请求连发两轮,记录每轮的缓存读写数字,再对照上面的矩阵逐项排除。
Claude 缓存命中率低的常见原因:三个硬条件
很多时候命中率低,并不是请求变了,而是缓存从一开始就没写进去。下面三个条件缺一个,缓存就不会生效:
- 必须显式打
cache_control:可以放在具体内容块上做显式断点,也可以在请求顶层放一个cache_control,由系统自动把断点打在最后一个可缓存块上。如果 content 是纯字符串,没有可以挂标记的内容块,就永远不会缓存。 - 长度达到最小可缓存长度:在 Claude API 上,Sonnet 5.5 和 Opus 5.5 都是 512 tokens。前缀不够长时,缓存会被静默忽略,也不会报错。
- 前缀逐字节相同:历史只追加,system 和 tools 保持稳定。空格、JSON 字段顺序、时间戳任何一处变了,都会被当成新的前缀。
API易 的缓存文档还写了两个硬限制:单次请求最多 4 个 cache_control 断点,每个断点只向前回溯最近 20 个 content block。长的多轮对话只在最后一条打标记,是覆盖不到全部历史的。
TTL 也经常被忽略。默认是 5 分钟,每次命中都会续期,但计时从写入或读取那次请求开始算,而不是从响应结束时算。如果一次流式响应输出了 4 分钟,下一次请求大约要在 1 分钟内发出。需要更长的窗口时,可以在 cache_control 里写 "ttl": "1h"。
Claude 缓存命中率掉到 0 的成本账
下面先列出价格,单位是美元/百万 tokens,数据时间为 2026-10-25,以控制台实时价格为准:
| 型号 | 输入 | 输出 | 缓存读 | 5 分钟写 | 1 小时写 |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | $2 | $10 | $0.10 | $2.50 | $4 |
| Claude Opus 5.5 | $4 | $20 | $0.20 | $5 | $8 |
| Claude Haiku 5.5(10 万 tokens 以内) | $0.1 | $0.5 | $0.01 | $0.125 | $0.20 |
| Claude Haiku 5.5(超过 10 万 tokens) | $0.50 | $2.50 | $0.05 | $0.625 | $1 |
倍率需要分开看。API易 缓存指南给的通用口径是:命中 0.1×,5 分钟写入 1.25×,1 小时写入 2×。Sonnet 5.5 在 10 月 7 日随官方调整,缓存读从 $0.20 降到 $0.10,变成基础输入价的 0.05×,写入价没有变。
这次调整不是全线降价,Sonnet 5 的缓存读仍然是 $0.20。所以不要拿 0.1× 去算 Sonnet 5.5,具体型号与价格以平台型号列表为准。
回本点按平台的通用 0.1× 口径计算:5 分钟 TTL 复用两次就能回本(1.25 + 0.1 = 1.35,低于不缓存的 2.0);1 小时 TTL 需要复用三次(2 + 0.2 = 2.2,低于 3.0)。
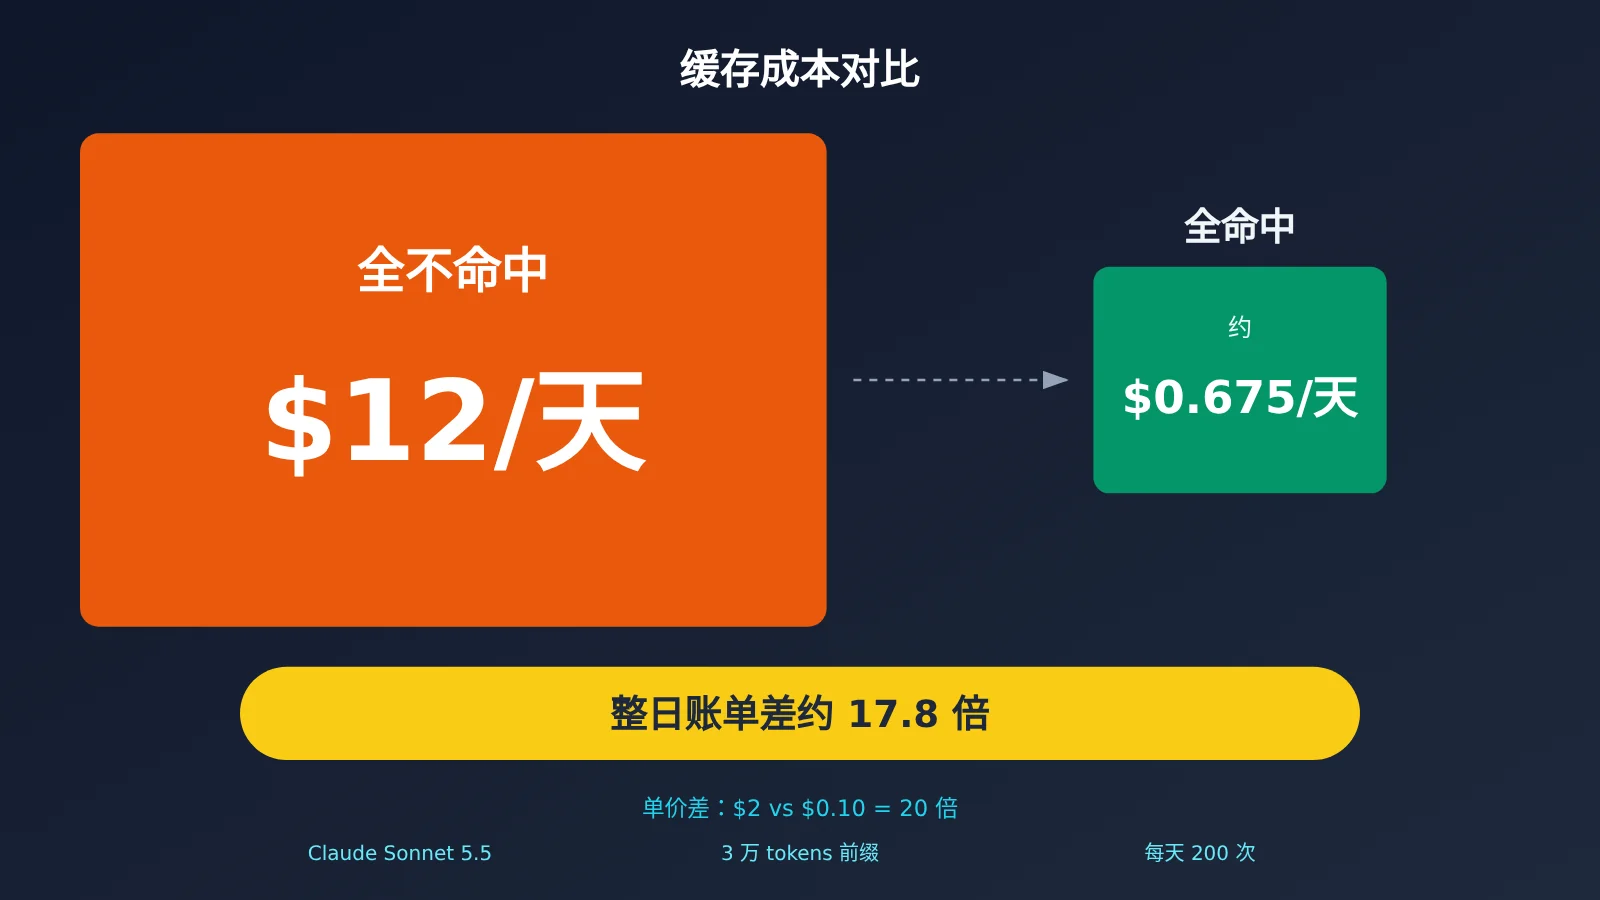
再看一个算例。Sonnet 5.5,固定前缀 3 万 tokens,一天发 200 次,全部在 5 分钟 TTL 内:
- 全部命中:200 × 3 万 × $0.10/百万 = $0.60,加上一次写入 $0.075,合计约 $0.675/天
- 全部不命中:200 × 3 万 × $2/百万 = $12/天
两者的整日账单差约 17.8 倍,这不是单价差。单价是 $2 对 $0.10,相差 20 倍。如果改用 1 小时 TTL,一次写入是 $0.12,命中价不变。请求间隔经常超过 5 分钟时,可以对比一下:多付的这部分写入费用,和反复重建前缀的费用相比哪个更低。
走 API易 时如何排查 Claude 缓存命中率
先说实测结果。2026-10-26 我们在 API易 上实测,用 Claude Sonnet 5.5 跑了两轮:第一轮缓存写 2523、读 0;第二轮原样回传后,缓存读 2523、写 0,token 数完全对得上。Claude Opus 5.5 用长前缀同样能写入,也能命中。
但响应里没有 diagnostics 字段。非流式调用没有,流式调用的 message_start 里也没有。我们又带上 beta header 重发了一次,还故意修改 system 制造了一次真实的不命中(读 0、写 2526),响应里仍然没有这个字段。所有请求都返回 200,没有报错。中转层的上游通道不一定是官方那条 Claude API,因此在中转场景下,主要靠 usage 里的两个字段互相比对。
| 自检现象 | 说明 |
|---|---|
本轮 cache_read_input_tokens 精确等于上一轮 cache_creation_input_tokens |
前缀完整命中 |
| 本轮读明显小于上一轮写 | 只命中了更靠前的一段,中间有内容变了 |
| 写入一直为 0 | 没打标记、长度不够,或者用了 OpenAI 兼容格式 |
| 第二轮又在写入,而读为 0 | 前缀变了,检查时间戳、UUID、序列化顺序 |
另外要特别注意:缓存只在原生 /v1/messages 下生效。用 OpenAI 兼容格式 /v1/chat/completions 调用 Claude,无论怎么传参都拿不到缓存计费。
💡 排查建议:API易 apiyi.com 会把
cache_control原样转发给上游,响应里的两个缓存字段也原样返回,代码不需要为中转层额外适配。把「本轮读 = 上一轮写」做成日志告警,就能取代大部分人工排查。
Claude 缓存诊断 diagnostics 的限制
diagnostics 不能解决所有问题,使用前先了解它的边界:
- 只有官方 Claude API 提供,Amazon Bedrock 和 Google Cloud 托管的 Claude 都没有
- 指纹只短期保留,需要连续几轮、间隔较短地发送请求
- 两次请求必须属于同一组织和同一 workspace,可以用响应头
anthropic-workspace-id核对 - 长对话里,如果变化藏在消息列表很深的位置,可能只会返回
unavailable - 它是 best-effort 机制,拿不到结果也不会阻塞请求,也不会让请求失败
常见问题 FAQ
Q1:为什么 diagnostics 一直是 null?
分三种情况:没带 `diagnostics` 对象;当前是第一轮,`previous_message_id` 为 `null`;比较完成且没有分歧。要结合缓存读数来判断:读数高就说明一切正常,读数为 0 多半是缓存过期了。如果是走中转,字段可能根本不会回传,这时改用 usage 自检。
Q2:previous_message_not_found 是不是说明请求变了?
不是。它只表示找不到对应的指纹。常见原因有三个:上一轮没带 `diagnostics`,上一轮来自别的 workspace,或者间隔太久。每轮都带上 `diagnostics` 并缩短间隔即可。
Q3:诊断会不会额外收费?
官方文档没有把「诊断费用」单独列为一项,它随普通 Messages 请求一起计费。文档也没有明确写不加价,所以计费请以账单和控制台为准。
Q4:走中转还能用这套诊断吗?
我们在 API易 的实测中没有拿到 `diagnostics` 字段,但缓存的写入和命中都正常。可以用「本轮读是否精确等于上一轮写」来判断,接入方式见 API易 apiyi.com 的缓存计费文档。
Q5:写了 cache_control 为什么一次都没写进缓存?
先检查三点:content 是不是纯字符串;前缀是否达到 512 tokens(Sonnet 5.5 和 Opus 5.5);是否走的是 OpenAI 兼容格式。三者中有任何一个不满足,缓存都会被静默跳过。
Q6:同时出现多个问题,应该先修哪个?
先修 `cache_miss_reason` 报出来的那一个。它只报最早的分叉点,修好之后再跑一轮,后面被挡住的问题才会显现出来。在 API易 apiyi.com 上用同一份请求反复回放,可以比较快地逐个排除。
Claude 缓存诊断核心要点 Key Takeaways
- diagnostics 是什么:传入上一轮响应 id,定位前缀第一个分叉段
- 怎么开启:顶层带
diagnostics,第一轮传null,之后每轮都要传 - null 的含义:第一轮或没有分歧时也是
null,不能单独当作故障信号 - 怎么判断:diagnostics 配合
cache_read_input_tokens一起看才能下结论 - 硬条件:显式打标记、达到 512 tokens、前缀逐字节相同
- 成本差距:3 万前缀每天 200 次,整日账单相差约 17.8 倍
- 中转自检:在 API易 apiyi.com 上看「本轮读是否等于上一轮写」
总结
Claude 缓存命中率排查可以归纳为三件事:
- 定位分叉:每轮带上
diagnostics,读cache_miss_reason,先修最早报出的那一处 - 交叉判断:diagnostics 和 usage 两边一起看,
null不代表没生效 - 守住硬条件:打好标记,长度达标,历史只追加,system 和 tools 保持稳定
如果你的调用链路拿不到 diagnostics,就用 usage 里的两个字段建立自检。推荐先在 API易 apiyi.com 用两轮请求验证缓存读写数字,再上线到生产环境。
📚 参考资料
- Claude 官方文档:Cache diagnostics:诊断字段、六种类型与判断矩阵
- 链接:
platform.claude.com -
说明: 本文 diagnostics 的字段、时间线和限制均以该文档为准
-
Claude 官方文档:Prompt caching:缓存规则、TTL、最小长度与价格
- 链接:
platform.claude.com -
说明: 最小可缓存长度和官方价格表的来源
-
API易 型号列表:Claude 各型号的输入、输出与缓存读价格
- 链接:
docs.apiyi.com/models -
说明: 价格数据更新于 2026-10-25
-
API易 Claude Prompt Caching 缓存计费指南:倍率、回本点与自检判据
- 链接:
docs.apiyi.com/api-capabilities/claude-prompt-caching - 说明: 中转场景下的排查依据
作者:APIYI 技术团队
技术交流:欢迎在 API易 网站首页联系我们,更多资料可访问 docs.apiyi.com 文档中心