作者注:MiniMax M3.1 Flash 的权重计划在 10 月 23 日放出。本文说明本地部署大概需要什么级别的硬件,并从 4 个维度比较“自己部署”和“直接调 API”哪个更划算。
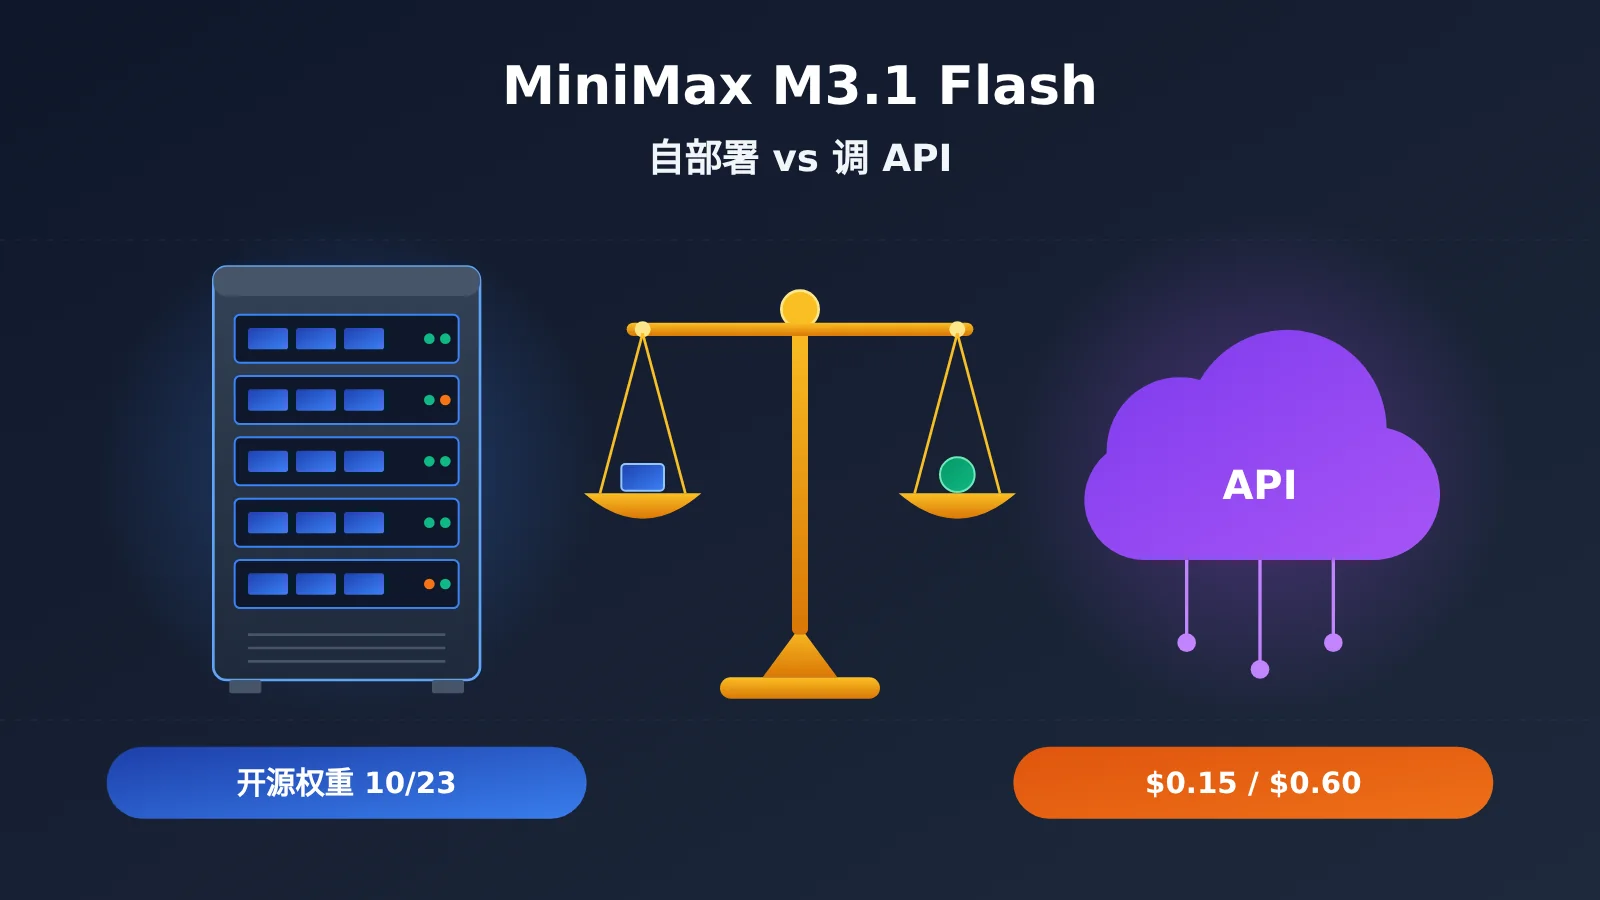
先说结论:对绝大多数个人开发者和小团队,直接调用 每百万 tokens 输入 $0.15、输出 $0.60 的 API,比自己部署省钱也省事得多。 只有三种情况值得考虑自部署:数据按规定不能出内网,调用量大到能让一整台多卡服务器长期满载,或者你需要修改、微调模型本身。
这篇不是劝退开源。 开源权重对行业有价值,但“能下载”和“值得自己跑”是两件事。M3.1 Flash 的发布新闻本站已经单独写过,本文不再复述,只回答两个问题:本地部署要什么配置,以及自部署和调 API 哪个划算。
核心价值:读完本文,你能判断自己该不该等这份权重,以及等到之后要先确认哪些信息。
MiniMax M3.1 Flash 开源权重现状:哪些已确定,哪些还没公布
先解释一个词。开源权重指模型训练好的参数文件公开发布,你可以下载到自己的服务器上运行。它和“开源代码”不同,也不等于随便商用,能怎么用要看许可证。
截至发稿(2026 年 10 月 22 日),M3.1 Flash 的权重还没有正式放出。MiniMax 官方 X 帖写的是“Model weights will arrive on Oct 23”,也就是计划 10 月 23 日发布。官方博客只说“稍后发布”。另据上海纽约大学 RITS 的报道,10 月 20 日 MiniMax 的 Hugging Face 组织下还没有 M3.1 Flash 的仓库。
为了区分信息的可靠程度,本文把事实分成三档:官方自报(MiniMax 自己公布)、第三方测评(如 Vals AI)、未知/未公布。
| 信息项 | 现状 | 信息档位 |
|---|---|---|
| 权重发布时间 | 官方 X 帖称 10 月 23 日;官方博客只写“稍后” | 官方自报(计划,尚未完成) |
| 模型规模 | MoE 架构,总参数 428B,激活约 23B,与 M3 相同 | 官方信息,经媒体报道 |
| 许可证 | M3.1 Flash 的许可证尚未公布 | 未知/未公布 |
| 部署硬件要求 | 官方部署指南还没有 M3.1 Flash | 未知/未公布 |
| 技术报告 | 尚未发布说明 Flash 相比 M3 改了什么 | 未知/未公布 |
| 参考对象 M3 | 权重 6 月起已在 Hugging Face 上,采用社区许可证 | 官方信息 |
⚠️ 提醒:权重放出后,许可证条款、文件大小、推荐硬件都以 Hugging Face 上的 MiniMax 官方模型页为准。社区转载的量化版本不在官方验证范围内,不要把它们当作官方配置。
MiniMax M3.1 Flash 本地部署要什么配置
官方还没公布 M3.1 Flash 的硬件要求,所以这里不推测显存和 GPU 数量。能参考的是同规模的上一代 M3。两者的总参数(428B)和激活参数(约 23B)相同,可以拿 M3 来估计大致量级。
先理解 MiniMax M3.1 Flash 的“428B 总参数、23B 激活”
MoE(混合专家)是一种模型结构:模型由很多“专家”子网络组成,每次推理只调用其中一部分。“激活约 23B”说的是每生成一个 token 实际参与计算的参数量,所以速度可以比较快。
但有一点容易误解:激活参数少,不代表显存需求小。 全部 428B 参数都要装进显存(GPU 上的专用内存),推理时才能随时调用任意专家。这也是 MoE 大模型本地部署门槛高的主要原因。
MiniMax 官方给出的 M3 参考部署(仅作量级参考)
几个术语先解释一下。MXFP8 是一种 8 位精度的存储格式,可以缩小模型文件和显存占用。SGLang 是开源推理框架,能把模型跑成一个兼容 OpenAI 格式的 API 服务。TP(张量并行)是把一个模型拆到多张显卡上协同运行的方式。
| 模型 | 官方参考配置 | 权重体积 | 状态 |
|---|---|---|---|
| MiniMax-M3 | 8 × B200,MXFP8 精度,SGLang 的 OpenAI 兼容接口 | MXFP8 版本约 440 GB | Experimental(实验性) |
| MiniMax-M2.7 | 4 张大显存 NVIDIA GPU,TP 4 | 未公布统一最低显存 | Preview |
| MiniMax-M3.1 Flash | 官方部署指南暂未覆盖 | 未公布 | 未知/未公布 |
再强调一次:上表中 M3 的数据不是 M3.1 Flash 的官方要求。 它说明的是,同规模模型的官方参考方案需要 8 张数据中心级 GPU,单是 MXFP8 权重就有约 440 GB。这个级别远超消费级显卡和普通工作站,个人在家用一两张游戏显卡跑起完整版是不现实的。
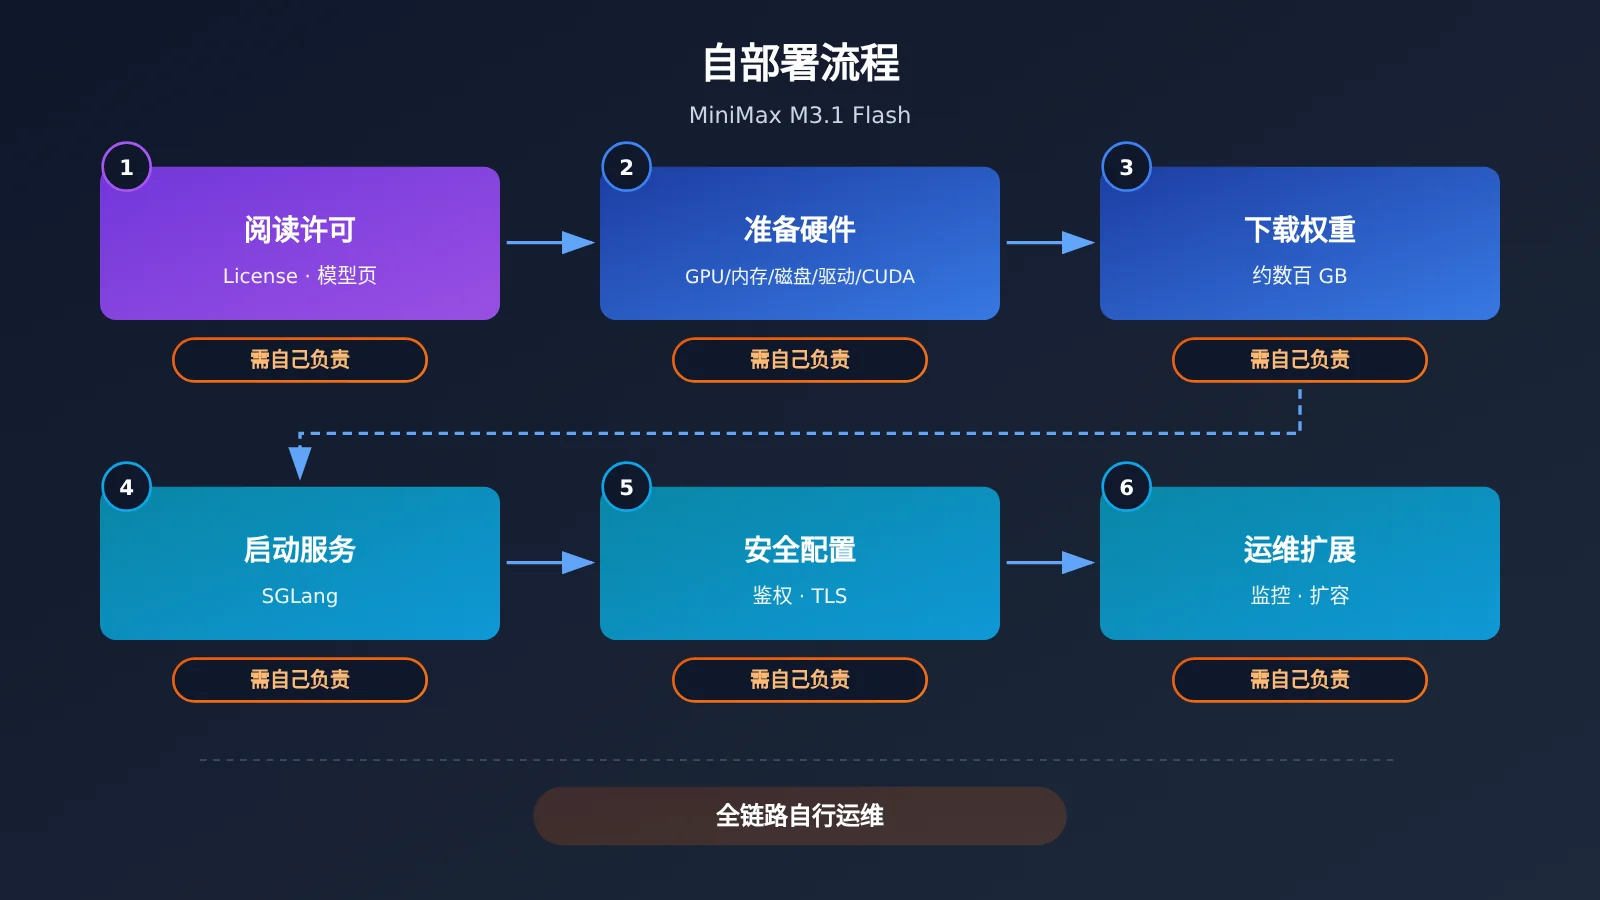
MiniMax 官方部署文档还给了几条部署前的建议,适用于所有开源模型:
- 先读许可和能力范围,确认你的用途被允许;
- 按模型页准备硬件,包括 GPU、内存、磁盘、驱动和 CUDA 版本;
- 固定版本,模型版本和推理框架版本都锁定,不要跟着 main/latest 分支变动;
- 国内镜像只用模型页列出的官方源,避免下载到被篡改的文件。
MiniMax M3.1 Flash 自己部署还是调 API 划算
这是本文的核心问题。下面用 4 个维度做判断,对照自己的情况看即可。
| 判断维度 | 倾向直接调 API | 倾向自己部署 |
|---|---|---|
| 数据合规要求 | 数据可以发给云端服务商处理 | 法规或合同要求数据不能出内网 |
| 调用量 | 中小规模、波峰波谷明显 | 长期大规模,能让多卡服务器持续满载 |
| 团队运维能力 | 没有专职的 GPU 运维人员 | 有人负责集群、监控、值班 |
| 是否需要改模型 | 直接用通用能力就够 | 需要微调、改结构或深度定制 |
只要前三项里有两项落在左列,选 API 基本不会错。
MiniMax M3.1 Flash API 成本怎么算
官方价格是固定价:输入 $0.15、输出 $0.60、缓存读取 $0.015,单位都是每百万 tokens,没有长上下文加价。token 是模型计费的文本单位,官方给的换算是约 750 个英文单词 ≈ 1000 tokens。缓存读取指重复发送的相同前缀内容按更低价格计费。
举个按官方单价算的例子(不是实测):每月输入 1 亿 tokens、输出 2000 万 tokens,费用是 100 × $0.15 + 20 × $0.60 = $27。这已经是不小的个人或小团队用量,一个月几十美元。
自部署的账要换个算法。如果参考 M3 的 8 × B200 方案,这类机器不论采购还是租用,都是一笔持续的固定支出,而且没人调用时也在花钱。要摊薄这笔成本,调用量通常需要大到让机器长期高负载,大多数个人和小团队达不到。
有一点需要留意:M3.1 Flash 的思考过程无法关闭,effort(思考深度)不传时默认 max 档。思考内容也算输出 token。实际账单里输出部分可能比你预想的多,想省钱可以把 effort 调到 low 或 medium。
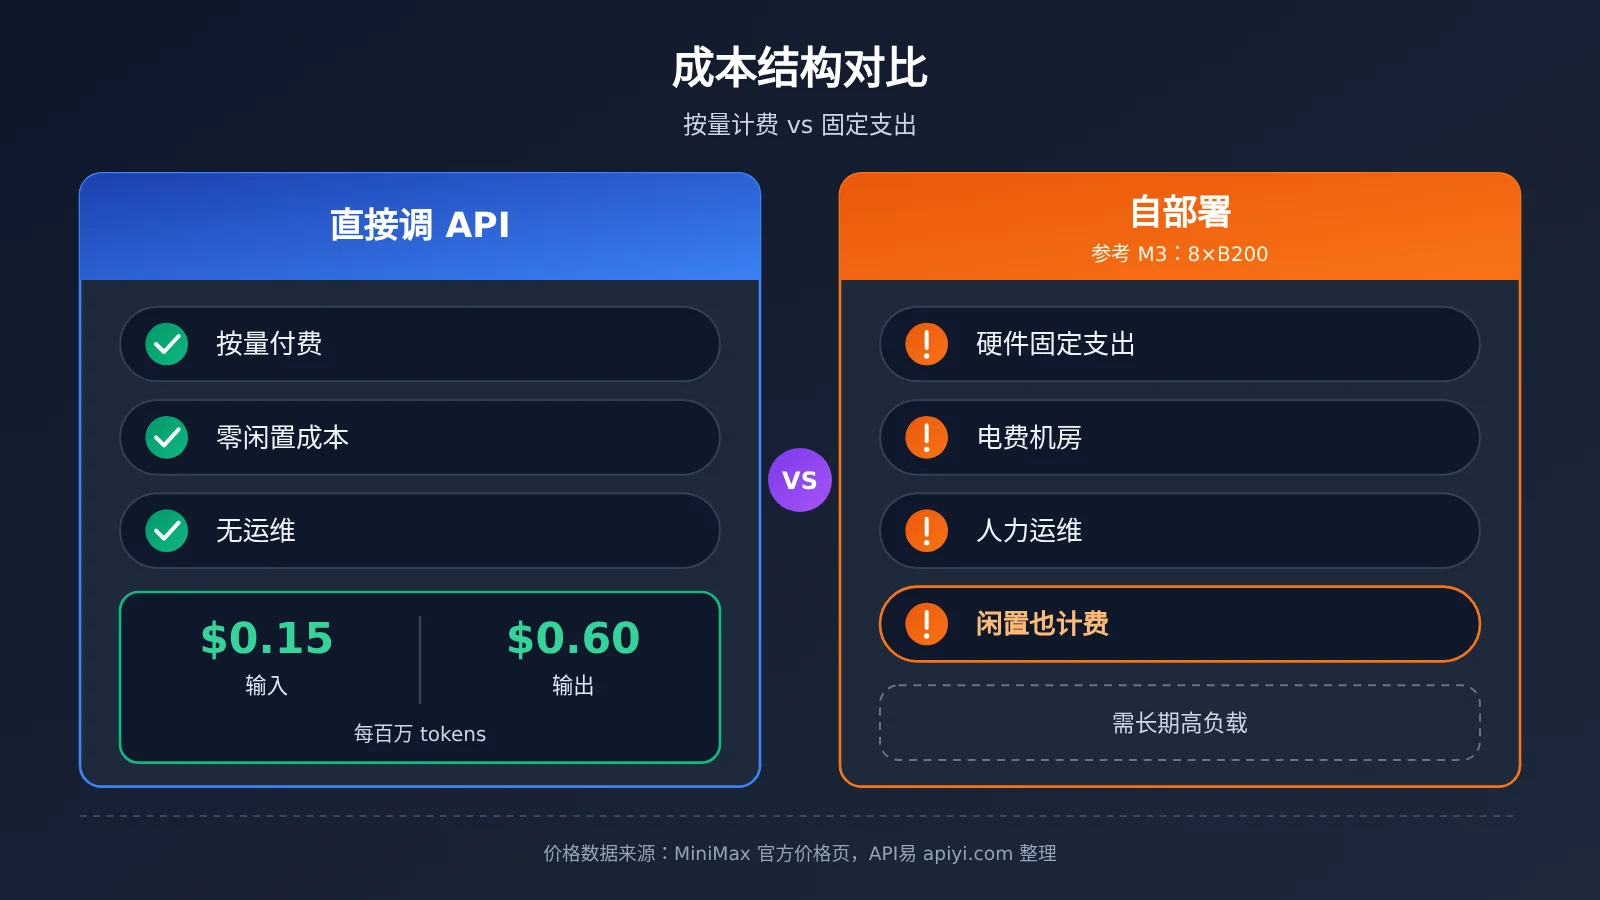
上图的价格来自 MiniMax 官方价格页,由 API易 apiyi.com 技术团队整理。下表列出几个常被拿来比较的模型的官方单价:
| 模型 | 输入价(每百万 tokens) | 输出价(每百万 tokens) | 可用平台 |
|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 | $0.60 | MiniMax 官方 API、M Plan;API易 能否调用以价格页为准 |
| MiniMax-M3(≤512K 输入) | $0.30 | $1.20 | MiniMax 官方 API、API易 apiyi.com |
| claude-opus-5-5 | $4 | $20 | Anthropic 官方、API易 apiyi.com |
| claude-opus-5 | $5 | $25 | Anthropic 官方、API易 apiyi.com |
💰 成本建议:如果你现在就想试 MiniMax 系列的效果,可以先通过 API易 apiyi.com 调用已上架的 MiniMax-M3 跑通流程。M3.1 Flash 能否在 API易 调用,以价格页为准,我们也会尽快上架。
MiniMax M3.1 Flash 自部署后要自己负责的事
MiniMax 官方文档写得很清楚:开源权重不包含平台上的缓存、内容安全等功能,服务默认只监听本机。决定自部署之前,确认下面这些事都有人负责:
- 鉴权:给接口加访问密钥,防止被别人随意调用;
- TLS 加密:对外开放时用 HTTPS 加密传输,防止数据被窃听;
- 网络隔离:限制哪些机器、哪些网段能访问推理服务;
- 监控告警:GPU 利用率、显存、延迟、错误率要有人盯;
- 容量规划与扩容:高峰期请求排队时,扩容方案要提前准备好;
- 故障恢复与升级:机器宕机怎么恢复,新版本如何灰度切换;
- 内容安全:输入输出的内容审核需要自己补上;
- 许可证合规:部署、再分发、商用前读完完整 License 和使用政策。
这张清单里任何一项缺人负责,自部署省下的 token 费都可能被运维成本抵掉。
MiniMax M3.1 Flash 能力怎么看:官方自报 vs 第三方测评
决定要不要自部署之前,先看清模型的实际水平。下表按信息档位整理:
| 指标 | 数据 | 信息档位 |
|---|---|---|
| Automation-Bench v1.0.6 | 62.2,Claude Opus 5 为 50.3 | 官方自报 |
| BankerToolBench | 76.2,与 Claude Opus 5 持平 | 官方自报 |
| Terminal Bench 4.0 | 38.1,Claude Opus 5 为 51.8 | 官方自报 |
| SWE Refactor Bench | 23.0,Claude Opus 5 为 31.0 | 官方自报 |
| 推理速度 | 博客称日常 200+ TPS、P50 170+;产品页写约 150 tokens/秒 | 官方自报(口径不一) |
| Vals Index | 53.78%,22 个模型中第 15,开源权重模型中第 5 | 第三方测评 |
| Vals Terminal-Bench 4.0 | 25.25%,51 个模型中第 22 | 第三方测评 |
| “成本为 M3 的 1/3” | 按任务计算,具体算法未公开 | 未知/未公布 |
TPS 是每秒生成的 token 数,数值越高,回答出来得越快。
和 Claude 的比较需要说清楚:MiniMax 官方表格里的对照对象是 Claude Opus 5,不是 Opus 5.5。 Claude Opus 5.5 仍是 Anthropic 当前最强的旗舰模型,官方没有拿它和 M3.1 Flash 逐项对比,所以不能得出“追上或超过 Opus 5.5”的结论。
即使只对比 Opus 5,M3.1 Flash 在 Terminal Bench、SWE Refactor 这类长链路编程和重构任务上也有明显差距。Vals 的第三方结果同样显示,它在长链路 Agent 任务上偏弱。
什么时候不该用 MiniMax M3.1 Flash,也不该急着自部署
以下几种情况,建议先别动:
- 复杂规划和大型重构:官方自报和第三方测评都显示它在长链路任务上偏弱。这类任务交给 Claude Opus 5.5 这类旗舰模型更稳妥。
- 对延迟极其敏感、又不需要深度推理:思考无法关闭,即使调到 low 档也会有思考开销。
- 已有基于 M3
<think>标签解析的集成:M3.1 Flash 的思考内容改为单独字段返回,旧解析逻辑要先改好再切换。 - 许可证还没看清:权重放出前许可证未公布,商用项目不要提前排期依赖自部署。
- 没人值班:上一节的运维清单没人负责,就别把业务压在自建服务上。
- 想在消费级显卡上跑完整版:参考 M3 的量级,这不现实。等官方硬件说明,也不要轻信来源不明的量化版。
在 API易 上搭配 MiniMax 与 Claude Opus 5.5
对多数开发者来说,比“自部署还是调 API”更实际的问题是:不同难度的任务怎么分给不同模型。
API易 支持一个 Key 同时调用 Claude、GPT、Gemini 等海外模型,以及 DeepSeek、MiniMax 等国内模型。目前 API易 上可以直接用的包括 MiniMax-M3(同时支持 OpenAI 和 Anthropic 两种接口格式,ClaudeCode 分组也可用)、MiniMax-M2.7 系列,以及 claude-opus-5-5、claude-opus-5。截至发稿,API易 价格页还没有 MiniMax-M3.1-Flash,能否调用以价格页为准。
推荐的分工如下:
- 便宜的批量活交给 MiniMax:数据清洗、批量摘要、格式转换、简单代码补全等,量大、单次难度低,单价越低越划算;
- 难的规划和重构交给 Claude Opus 5.5:跨文件重构、架构设计、复杂 Agent 任务规划,按次付费更贵,但出错返工的成本更高;
- 同一个 Key 切换模型:只改模型名,不用维护多套账号和多个接口地址。
🎯 技术建议:在 API易 apiyi.com 用同一个 Key 分别跑一遍 MiniMax-M3 和 claude-opus-5-5,用你自己的真实任务对比效果和账单,比看任何跑分都更可靠。
常见问题
Q1:MiniMax M3.1 Flash 的权重什么时候能下载?
官方 X 帖写的计划日期是 10 月 23 日,官方博客只说“稍后”。截至发稿还没有放出,请以 Hugging Face 上的 MiniMax 官方模型页为准。
Q2:一张消费级显卡能跑 MiniMax M3.1 Flash 吗?
官方没有公布 M3.1 Flash 的硬件要求。同规模的 M3 官方参考方案是 8 × B200,MXFP8 权重约 440 GB,完整版在单张消费级显卡上基本不现实。
Q3:MiniMax M3.1 Flash 开源后可以商用吗?
许可证尚未公布。官方提醒,开源权重不代表所有模型使用同一个许可证,部署、再分发或商用前都要读完完整 License。
Q4:现在怎么低成本体验 MiniMax 系列模型?
最省事的方式是直接调 API。M3.1 Flash 可以走 MiniMax 官方 API 或 M Plan 订阅(月费以官网为准)。如果想用一个 Key 同时管理多个模型,可以先在 API易 apiyi.com 调用已上架的 MiniMax-M3。M3.1 Flash 能否调用,以 API易 价格页为准。
Q5:MiniMax M3.1 Flash 能替代 Claude Opus 5.5 吗?
不建议这样理解。官方只和 Claude Opus 5 做了对比,并且在长链路编程任务上落后。更合理的做法是分工:批量任务用 MiniMax,难的规划和重构用 Opus 5.5。在 API易 上一个 Key 就能完成这种组合。
MiniMax M3.1 Flash 开源权重核心要点 Key Takeaways
- 权重尚未放出:计划 10 月 23 日发布,以 Hugging Face 官方模型页为准
- 许可证和硬件要求未公布:不要提前按猜测的配置采购或排期
- 量级参考 M3:8 × B200 加约 440 GB 的 MXFP8 权重,属于数据中心级别
- API 更划算:$0.15/$0.60 的单价,对多数个人和小团队远比自建省事
- 自部署适用面窄:主要是强合规、超大调用量、需要改模型这三类场景
- 对比对象是 Opus 5:Opus 5.5 仍是 Anthropic 最强旗舰,官方没有逐项对比
- 组合使用:在 API易 apiyi.com 用一个 Key 搭配 MiniMax 和 Claude Opus 5.5
总结
MiniMax M3.1 Flash 开源权重的要点:
- 现状:权重计划 10 月 23 日放出,许可证和部署硬件要求都还没公布,一切以官方模型页为准;
- 配置:参考同规模的 M3,官方方案是 8 张 B200 级 GPU,不是个人设备能承担的;
- 决策:按合规、调用量、运维能力、改模型需求 4 个维度判断,多数情况下直接调 API 更划算。
权重放出后,建议先读许可证和官方硬件说明,再决定是否自建。业务上更实际的做法是让不同难度的任务用不同模型。可以通过 API易 apiyi.com 用一个 Key 测试 MiniMax 系列和 claude-opus-5-5 的组合效果。
📚 参考资料
- MiniMax 官方发布博客:M3.1 Flash 发布说明与官方自报数据
- 链接:
minimax.io/blog/minimax-m31f -
说明:价格、速度和权重“稍后发布”的官方表述
-
MiniMax 官方价格页:各模型按量计费单价
- 链接:
platform.minimax.io/docs/guides/pricing -
说明:M3.1 Flash 与 M3 的价格对照
-
MiniMax 官方自部署指南:开源模型部署参考配置
- 链接:
platform.minimax.io/docs/guides/local-deploy -
说明:M3 的 8 × B200 参考方案与自部署注意事项
-
Vals AI 测评页:M3.1 Flash 第三方评测结果
- 链接:
vals.ai/models/minimax_MiniMax-M3.1-flash -
说明:Vals Index 排名与各子项得分
-
Hugging Face – MiniMax-M3:M3 权重与社区许可证
- 链接:
huggingface.co/MiniMaxAI/MiniMax-M3 -
说明:M3.1 Flash 权重放出后可在同一组织下查看
-
SGLang 文档 – MiniMax-M3:推理框架部署说明
- 链接:
docs.sglang.io/cookbook/autoregressive/MiniMax/MiniMax-M3 - 说明:M3 的 MXFP8 版本体积与运行方式
作者:APIYI 技术团队
技术交流:欢迎在 API易 官网首页联系我们,更多资料可访问 docs.apiyi.com 文档中心