本文用 GPT-6.1 Sol 与 GPT-6.2 Sol 的迁移、客服和代码案例,说明如何先固定业务验收条件,再选出能稳定达标的推理档位,并核算每个达标任务的成本。
先说结论:调档时应比较的是“每个达标任务花多少钱、多少时间”,单次调用的标价只是其中一项。在已公开的小样本实测里,GPT-6.2 Sol 的 low 在客服政策题和一组代码题上都达到了与 medium 相同的通过数,而且耗时更短。代码题中,low 的标价折算成本约为 medium 的七成。这个结论成立需要两个条件:你的任务与测试任务足够相似,并且验收门槛不只看通过率,还检查虚构链接、金额字段和返工。跨资料冲突、工具依赖复杂或容易漏约束的任务,仍应单独验证 medium 及以上档位。
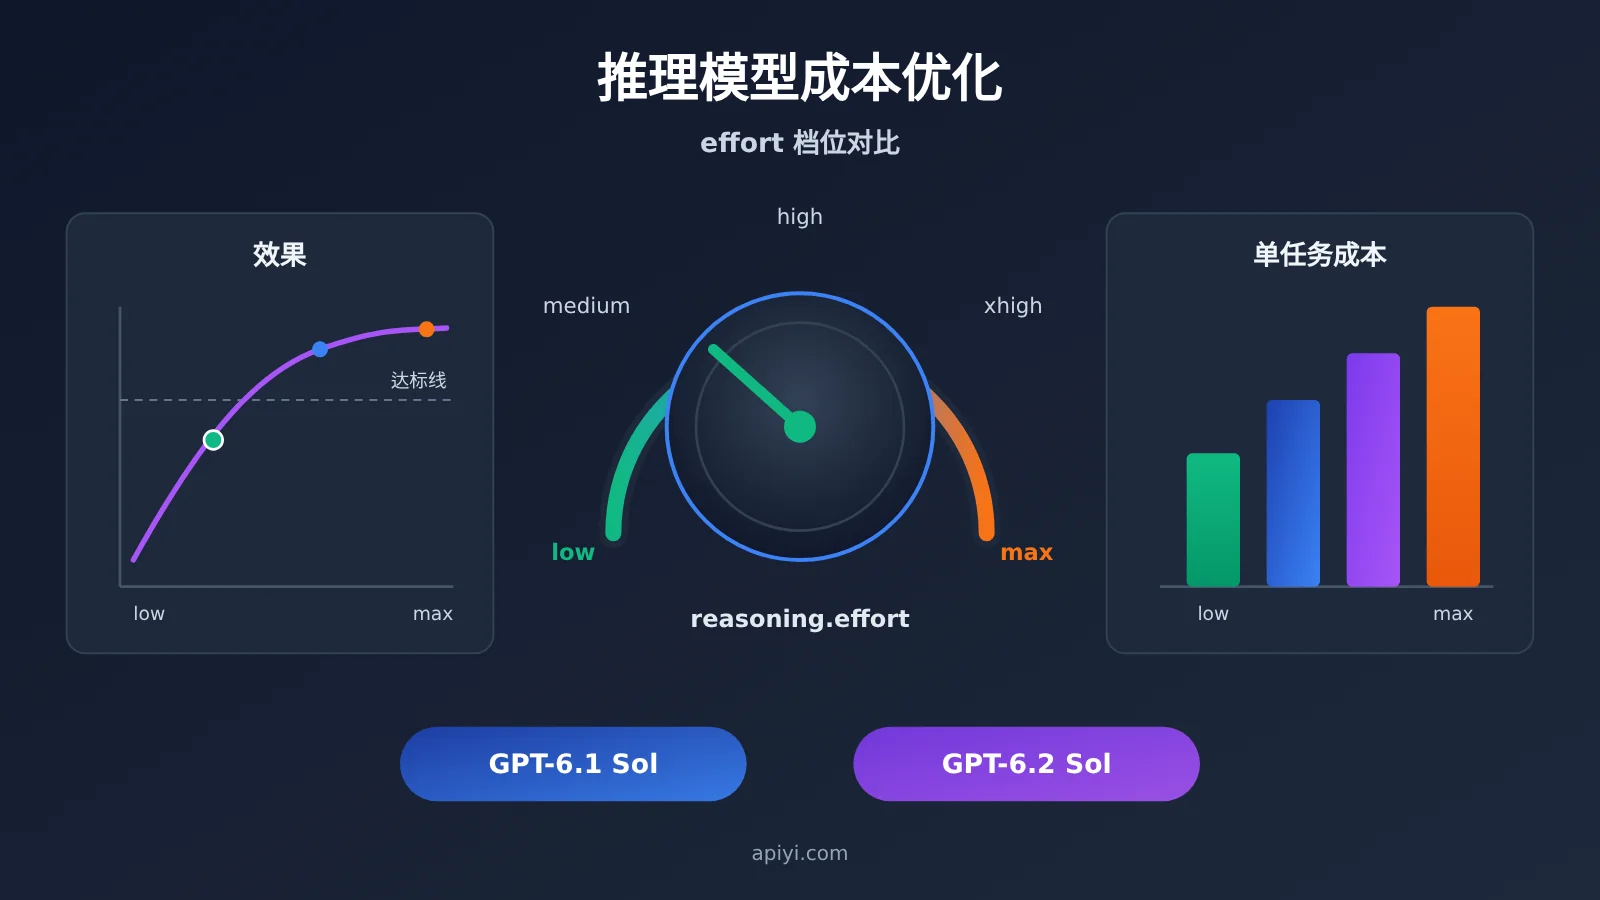
推理模型 effort 档位对比速览
下表汇总本文会用到的几组证据,每一行都注明了来源和口径。不同来源的数字不能直接相加或混排。
| 对比维度 | GPT-6.1 Sol | GPT-6.2 Sol | 差异意味着什么 |
|---|---|---|---|
| 可选档位(OpenAI 文档) | low、medium、high、xhigh、max | 同五档,拒绝 none |
从可设 none/minimal 的型号迁移时,需要改起步档位 |
| API易 短上下文标价(2026-11-20 总表,美元/百万 Token) | 输入 $2、缓存读 $0.10、输出 $10 | 同左 | 短上下文下两代价格一致,成本差异主要来自用量 |
| 超过 272,000 输入 Token 的输入价 | API易 与 OpenAI Standard 均列 $4 | API易 列 $3,OpenAI Standard 列 $4 | 长输入场景下,渠道之间会出现价差 |
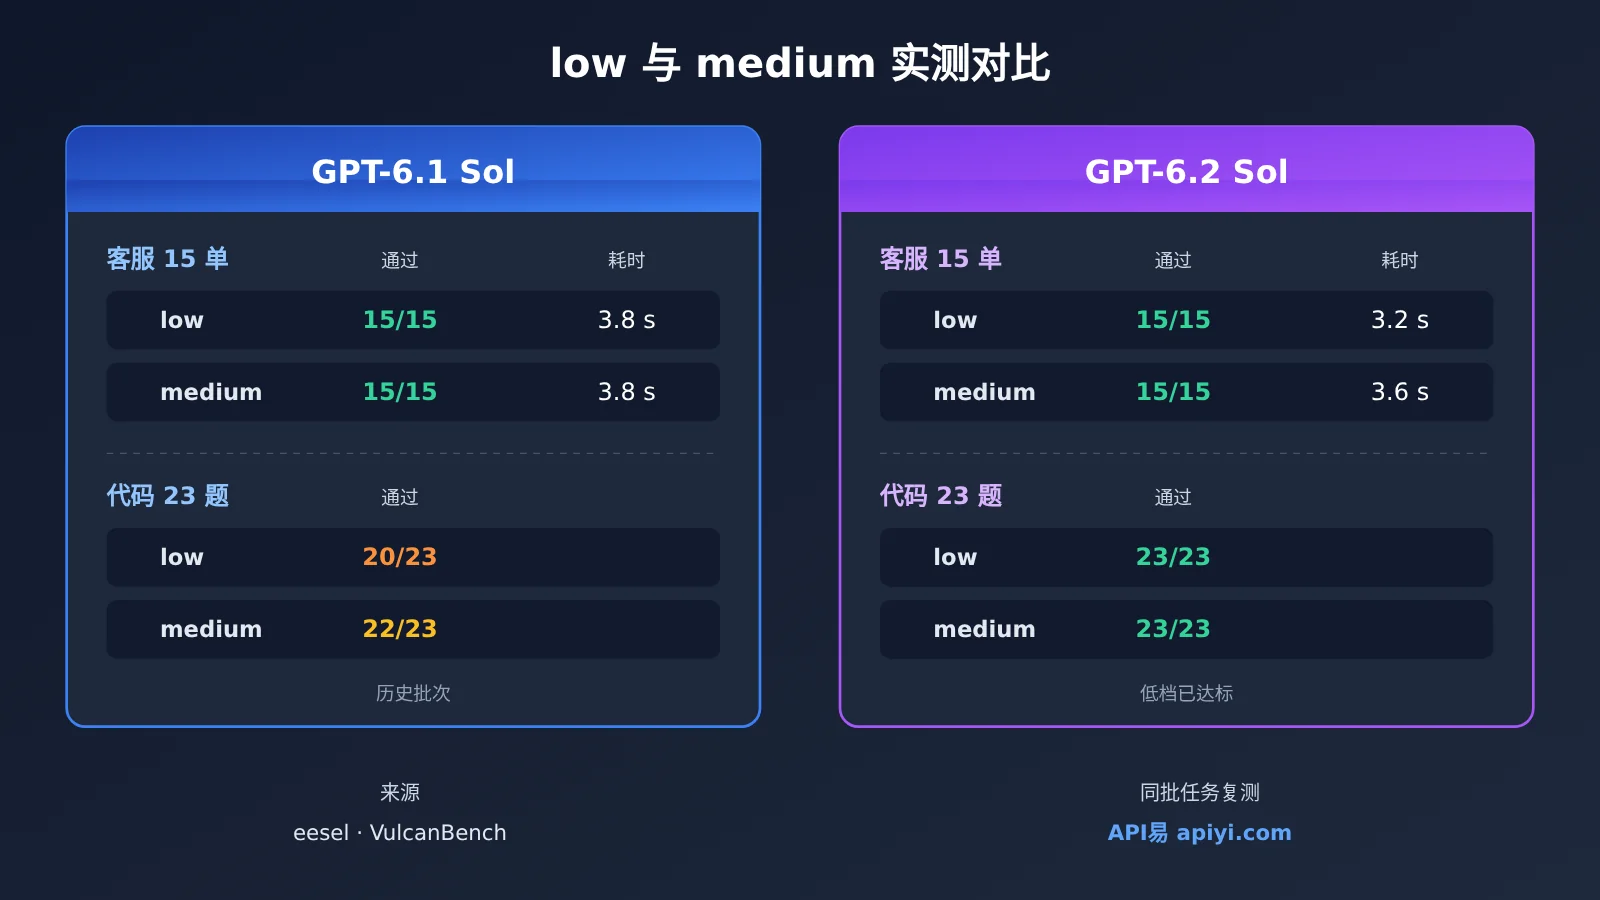
| eesel 客服 15 工单(low / medium) | 15/15、3.8 秒;15/15、3.8 秒 | 15/15、3.2 秒;15/15、3.6 秒 | 通过率相同,档位之间成本差异很小 |
| VulcanBench 23 道代码题(low / medium) | 20/23;22/23(历史批次) | 23/23;23/23 | 6.2 Sol 低档已达标,跨版本的数字来自不同批次 |
| Artificial Analysis Index(OrcaRouter 转引,low / medium) | 35;46 | 41;53 | 第三方综合指数,档位标签由该评测自行映射 |
正文按以下顺序展开:第 1 节确认能否接入、怎么计价,第 2 节看同任务的实测结果,第 3 节给出迁移和验收步骤,第 4 节处理多轮会话中途调档的问题。如果你已经确认过模型路由和价格,可以直接从第 2 节读起。
推理 effort 档位相关术语 To Know
| 术语 | 解释 |
|---|---|
reasoning.effort |
Responses API 中用来设定模型思考强度的字段 |
| 推理 Token | 模型为得出答案而消耗的推理用量。它包含在计费的 output_tokens 里,需要与用户可见的输出区分开 |
low / medium |
两个推理档位。同一档位换到新版本后,仍需重新验收 |
| 缓存读取单价 | 只适用于命中可复用前缀的那部分输入,无法用总 Token 数直接推算 |
| 请求前缀 | 当前消息之前已经存在的上下文。修改早期历史会影响缓存和推理项的复用 |
configuration_update |
在支持该功能的 Responses 会话里,用于调整后续配置的输入项 |
| 验收门槛 | 对政策正确性、功能通过或返工水平设定的最低可接受标准 |
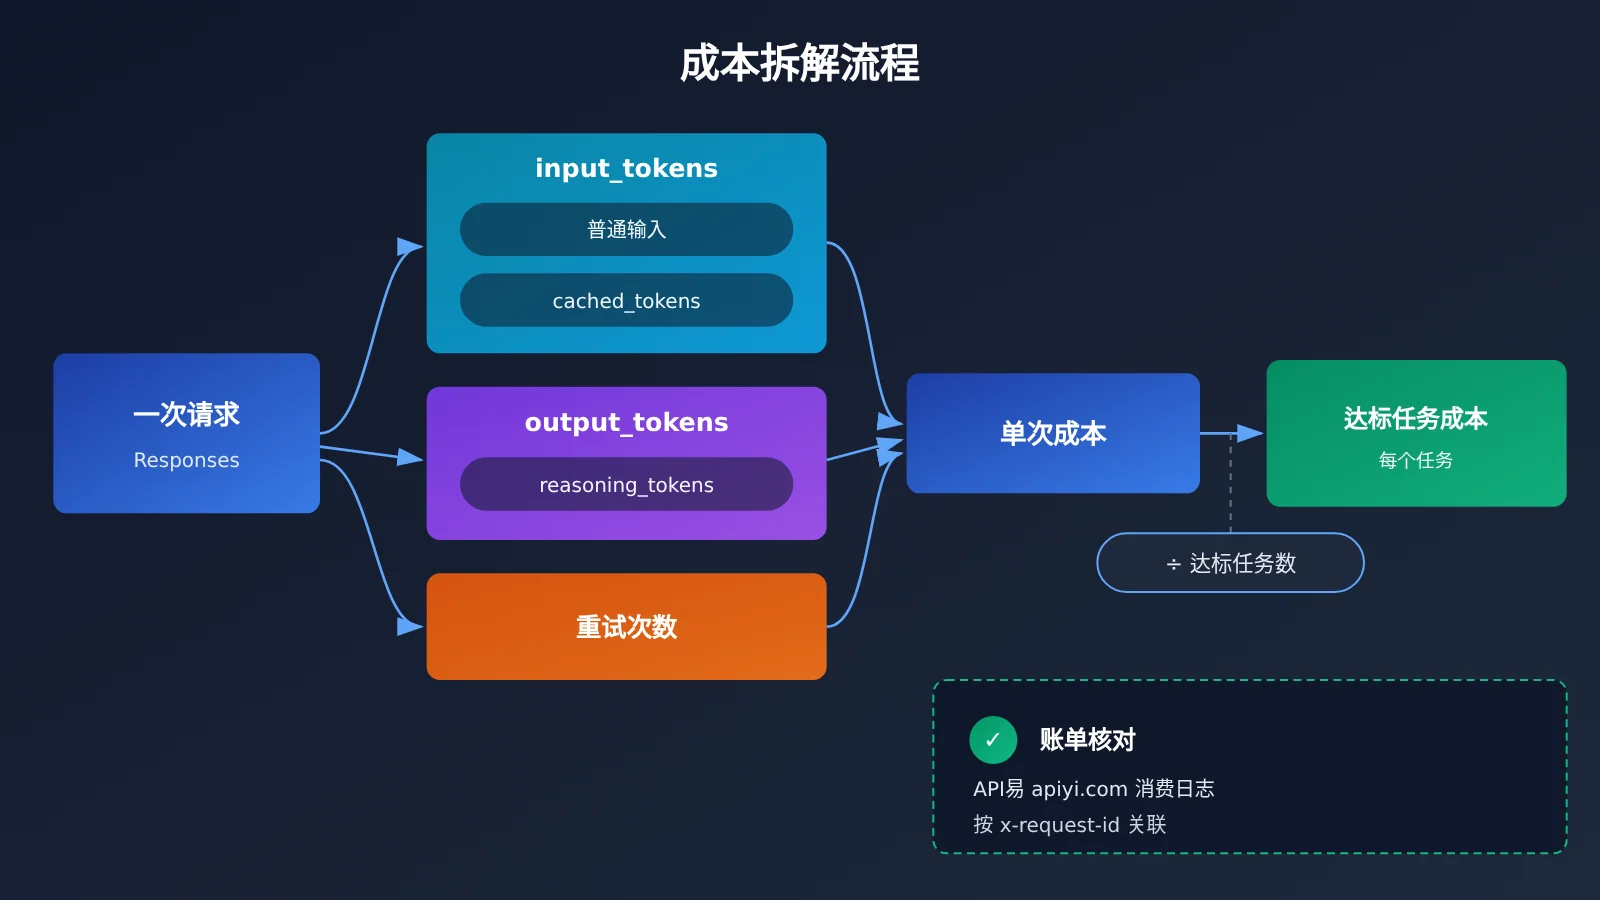
| 每个达标任务成本 | 整个试验的调用、重试、工具和人工返工成本,除以达标任务数 |
1. 推理模型成本优化前:何时值得调 effort 档位
1.1 两代 Sol 在 API易 的接入情况
根据 API易 平台动态,GPT-6.1 Sol 于 2026-09-30 上线,GPT-6.2 Astra 与 Sol 于 2026-11-18 公告上线。2026-11-20 的价格总表显示,两款 Sol 都同时提供 responses 和 chat 两种路由,涉及的分组有 CodexResponses、Codex_Reverse、Default、SVIP。账户实际能调用哪些能力,以令牌所在分组为准。
按 OpenAI 文档,两代 Sol 都支持 Chat Completions 和 Responses,但工具调用必须走 Responses,档位通过 reasoning.effort 设置。所以只要业务里有订单查询、代码执行这类工具环节,评测和上线都应统一使用 Responses 路由,避免两条路由的行为差异混进对比结果。
1.2 两套价格口径:API易 标价与上游标准价
| 模型 ID(API易 总表,2026-11-20) | 普通输入 | 缓存读 | 输出 | 可用平台 |
|---|---|---|---|---|
gpt-6.2-sol |
$2 | $0.10 | $10 | API易 apiyi.com、OpenAI 官方 |
gpt-6.1-sol |
$2 | $0.10 | $10 | API易 apiyi.com、OpenAI 官方 |
gpt-6-sol |
$2 | $0.20 | $10 | API易 |
gpt-6.2-astra |
$8 | $0.40 | $40 | API易 |
上表是短上下文的默认标价,单位为美元/百万 Token。OrcaRouter 整理的上游价目卡对两代 Sol 列出相同的输入、缓存读和输出价格,并另外列出缓存写入 $2.50。长上下文需要单独核对:gpt-6.2-sol 输入超过 272,000 Token 时,API易 当前列 $3,OpenAI 官方 Standard 列 $4;gpt-6.1-sol 两边均为 $4。长档的缓存价和输出价,请以各渠道的实时计费规则为准。
1.3 成本要从真实响应和账单里读
标价只能用来估算。下面用一组假设算例说明成本如何拆分。假设每轮输入 12,000 Token,没有缓存写入和工具费:
- 保留前缀:缓存读取 9,000、总输出 1,000,估算约 $0.0169。
- 修改了前缀:缓存读取降到 3,000、总输出升到 1,600,估算约 $0.0343。
两者的差额中,约 $0.0114 来自 6,000 个输入 Token 从缓存价变回普通价,约 $0.0060 来自额外的 600 个输出 Token。这是假设数据,实际差额以 usage 为准。如果存在单列的缓存写入,应把普通输入、缓存读、缓存写作为三个互斥类别分别计算。
实际扣费的核对方法:用响应头里的 x-request-id 关联 API易 消费日志中 type=2 的记录,用 quota ÷ 500,000 换算出实际扣费的美元值,同时记录模型、令牌分组、调用时间窗口、输入输出用量和重试次数。
下面是一个最简调用示例,同时读出诊断所需的用量字段:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "low"},
    input=[{"role": "user", "content": "根据退款政策判断工单 #1024 是否可退"}],
)

u = resp.usage
print(resp.output_text)
print("输入:", u.input_tokens, "缓存命中:", u.input_tokens_details.cached_tokens)
print("总输出:", u.output_tokens, "其中推理:", u.output_tokens_details.reasoning_tokens)
🚀 快速开始:建议先在 API易 apiyi.com 用新用户免费额度跑通上面的示例,确认目标分组能正常返回
cached_tokens和reasoning_tokens,再开始批量评测。
2. 同任务对比:low 与 medium 档位的实测结果
2.1 客服工单:低档带来的收益很小
eesel 的测试者在 2026-11-18 通过 Responses API 对两代 Sol 各测了 low 和 medium 两档,共 60 次调用。每种配置都覆盖同样的 15 个工单,内容包括退款、物流查询和订单工具失败,由人工按一份虚构的 SaaS 政策打分。
| 配置(eesel,15 工单) | 通过 | 平均耗时 | 标价折算/千件 |
|---|---|---|---|
| GPT-6.1 Sol low | 15/15 | 3.8 秒 | $1.32 |
| GPT-6.1 Sol medium | 15/15 | 3.8 秒 | $1.35 |
| GPT-6.2 Sol low | 15/15 | 3.2 秒 | $1.41 |
| GPT-6.2 Sol medium | 15/15 | 3.6 秒 | $1.42 |
在这组数据里,low 和 medium 每千件只差几美分,选择档位的依据更多是延迟,而不是费用。另外,按实测用量折算,GPT-6.2 Sol 在这组客服题上反而比 6.1 Sol 略贵。更重要的一点是,尽管四种配置的通过率都是满分,作者仍发现 6.2 Sol 会输出工具响应里并不存在的物流链接。这说明客服验收如果只看“答对政策”,就会漏掉这类问题,链接和字段的来源必须单独检查。这些证据仅适用于这套工单、这套评分标准和 OpenAI 测试环境。
2.2 代码任务:低档的单题成本值得实测
VulcanBench 在 2026-11-19 用 Codex 对 GPT-6.2 Sol 在同一套 23 题测试集上逐档运行,共 115 次。下表中的金额是根据运行收据按 API 标价折算的,不是 API易 账户的实际结算。
| 配置(VulcanBench,23 题) | 通过 | 平均耗时 | 标价折算/题 | 综合分 |
|---|---|---|---|---|
| GPT-6.2 Sol low | 23/23 | 2.8 分钟 | $0.23 | 88.44 |
| GPT-6.2 Sol medium | 23/23 | 4.4 分钟 | $0.33 | 88.94 |
| GPT-6.2 Sol max | — | 11.3 分钟 | $0.55 | 88.74 |
| GPT-6.1 Sol low(历史批次) | 20/23 | 6.9 分钟 | $0.31 | — |
| GPT-6.1 Sol medium(历史批次) | 22/23 | 10.6 分钟 | $0.40 | — |
只看 GPT-6.2 Sol 这一组:low 和 medium 的通过数相同,单题成本约低三成,耗时也更短;max 的综合分并没有超过 medium。跨版本对比需要谨慎:6.1 Sol 的数据来自同一题集的历史评测,属于不同的测试批次。综合分是代码质量评分,和测试通过率是两个指标,不能互相替代。
OrcaRouter 转引的 Artificial Analysis Index v5.0.1(2026-11-20 读取)给出了另一个视角:low 档下 6.2 Sol 为 41 分、每任务 $0.18,6.1 Sol 为 35 分、$0.16;medium 档下分别为 53 分、$0.41 和 46 分、$0.36。这份综合榜单的档位标签是评测方自己的映射方式,你使用的框架不一定采用同样的映射。
💡 选择建议:以上两项实测说明,通过线、重试率和人工返工都可能改变“最划算的档位”,但它们都不是你自己业务的账单。建议在 API易 apiyi.com 上,用同一个分组、同一批样本复测,再做决定。
3. 推理模型成本优化的迁移顺序与验收门槛
3.1 先保留基线,再调整档位
按 OpenAI《Using GPT-6.2》的建议,迁移时一次只改一个变量:
- 现用 6.1 Sol
low:先换成 6.2 Sollow做对照,再单独测试medium。 - 现用 6.1 Sol
medium:先换模型但保留medium,验收通过后,再用同一批任务对比low。 - 新接入:从
medium起步。 - 从可设
none或minimal的型号迁移:GPT-6.2 Sol 从low开始测试。
对于约束清晰的简单任务,可以从 low 开始验证;对于复合任务,根据结果逐级升档。评测期间要固定提示词、工具定义、分组和测试样本。同时按官方说明清理不再适用的参数,例如 Responses 请求里去掉 temperature、top_p、top_logprobs。
3.2 按场景定义验收门槛
| 场景 | 验收门槛 | 何时考虑升档 |
|---|---|---|
| 常规客服 | 政策一致性、金额字段正确、升级人工的触发条件;链接和单号必须来自工具返回 | 涉及跨政策冲突或多工具串联时 |
| 代码修改 | 测试通过、关键功能完整、代码审查返工量 | 低档通过率下降或返工明显增加时 |
| 短内容 | 约束遵守、事实字段、人工修改时长 | 出现漏约束或事实错误时 |
每个达标任务成本的计算方式是:把调用、重试、工具和人工返工的费用加总,再除以达标任务数。只要 low 达到约定门槛就可以选 low;如果 low 需要多次重试或人工补救,账面上的便宜可能被抵消。
💰 成本优化:做档位对照时,可以在 API易 apiyi.com 为评测单独创建令牌,日志就能按令牌和模型直接筛出,方便核算整批试验的真实花费。
4. 多轮会话中途调整 effort 档位
4.1 用 configuration_update 调档并保留前缀
在支持该功能的 OpenAI HTTP Responses 单代理会话中,请求级的 reasoning.effort 保持初始值不变,把下面这一项放在下一条用户消息之前:
{"type": "configuration_update", "reasoning": {"effort": "medium"}}
这个设置会一直生效,直到下一次更新。这样做的好处是不需要改写早期历史,请求前缀保持不变。按 OpenAI 文档,从 GPT-6.2 开始,编辑早期历史可能触发 prefix_mismatch,导致已有的推理项被移除;切换模型家族或降到较低能力的型号,也可能移除推理项。改写前缀的代价有两部分:缓存读取可能减少,丢失可用推理项后还可能产生新的推理输出。按官方说明,删除完整的项目并保持其余项目不变,或在推理项之后追加新项目,不会触发这一移除,但缓存命中量仍可能变化。另外,GPT-6.2 的顶层 instructions 追加在 input 之后,按未缓存输入计费。
4.2 上下文压缩与 API易 路由的注意事项
使用服务端 context_management 时,更新后的配置可以延续。如果把含有旧 configuration_update 的历史直接交给独立的 /responses/compact 端点,请求会被拒绝;正确做法是按官方说明先把配置项分离出来,压缩完成后再追加一条最新配置。
在 API易 上,目前稳妥的做法是自己管理 input 历史,不依赖 previous_response_id。原因是 API易 原生调用指南对这一点的记载前后不一致:正文说链式续接不生效,FAQ 又记录 2026-09-02 曾实测可用。API易 文档目前也没有列出 configuration_update 在各分组的验证结果。因此,这类特有配置、加密推理项回传和缓存诊断字段,都应先在目标渠道用短会话单独验证,确认可用后再接入正式工作流。
🎯 技术建议:可以先在 API易 apiyi.com 的 Responses 路由上跑一组两轮短会话,对比“仅追加”和“改写前缀”两种样本的
cached_tokens、reasoning_tokens和耗时,确认行为后再决定中途调档的实现方式。
最后一句话:选择档位的依据,应该是在固定验收门槛下的每个达标任务成本。在 API易 apiyi.com 上用自己的样本和账单跑一轮对照,比任何榜单都更能说明问题。
参考资料
- OpenAI《Using GPT-6.2》:迁移与起步档位建议
- 链接:
developers.openai.com/api/docs/guides/latest-model
- 链接:
- OpenAI《Reasoning models》:
configuration_update与推理项复用- 链接:
developers.openai.com/api/docs/guides/reasoning
- 链接:
- OpenAI《Compaction》:上下文压缩规则
- 链接:
developers.openai.com/api/docs/guides/compaction
- 链接:
- OpenAI《Keep the prefix unchanged》:前缀与缓存诊断
- 链接:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- 链接:
- eesel AI《GPT-6.2 Sol: what’s new, pricing, benchmarks》:客服工单实测,2026-11-18
- 链接:
eesel.ai/blog/gpt-6-2-sol
- 链接:
- VulcanBench《GPT-6.2 Sol across effort levels》:代码题逐档评测,2026-11-19
- 链接:
vulcanbench.com/benchmarks/swe-v4-gpt62-sol-v331.html
- 链接:
- OrcaRouter《GPT-6.2 vs GPT-6.1 Sol》:价目卡与综合指数转引,2026-11-20
- 链接:
orcarouter.ai/blog/gpt-6-2-vs-gpt-6-1-sol
- 链接:
- API易《模型价格总表》:数据更新于 2026-11-20
- 链接:
docs.apiyi.com/models
- 链接:
作者: APIYI 技术团队
技术交流: 欢迎在 API易 apiyi.com 首页联系我们,更多接入说明可查阅 docs.apiyi.com 文档中心