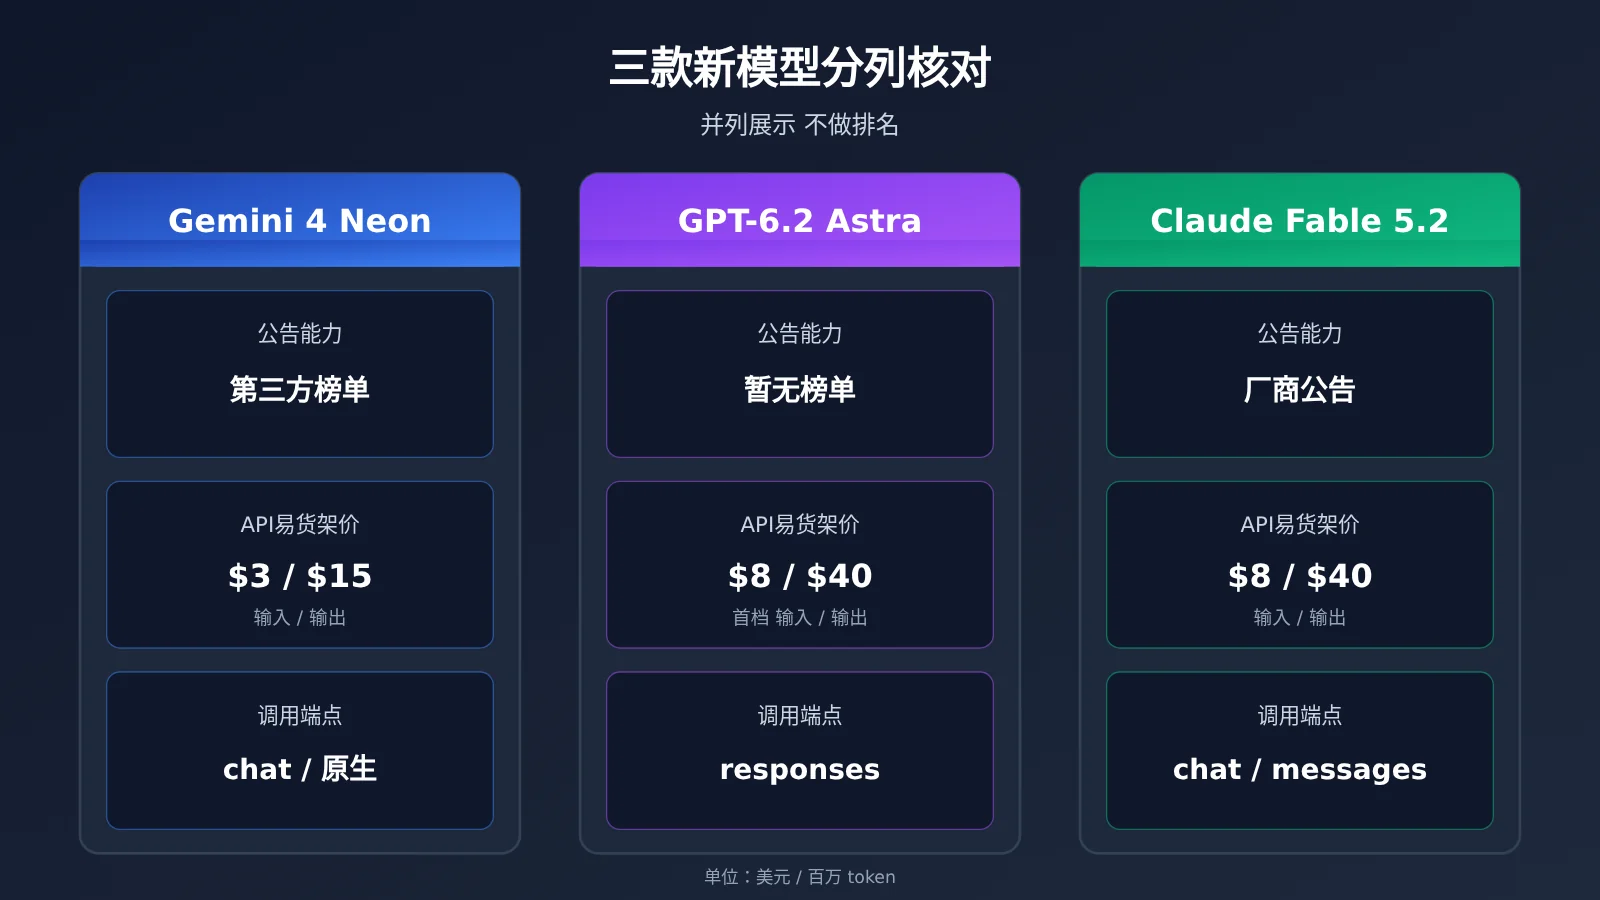
作者注:把 Gemini 4 Neon、GPT-6.2 Astra、Claude Fable 5.2 的公告能力、API易货架价和调用端点拆成三列分开核对,帮你按推理深度、编码代理或长上下文单价做选型。
2026 年 11 月,三家厂商在十天内相继发布新模型:Anthropic 在 11 月 9 日发布 Claude Fable 5.2,Google 在 11 月 18 日公告 Gemini 4 Neon,GPT-6.2 Astra 也已出现在 API易的价格总表里。选型时最容易犯的错,是把 三家的榜单、三家的价格、三条不同的接口 混成一个“谁最划算”的结论。
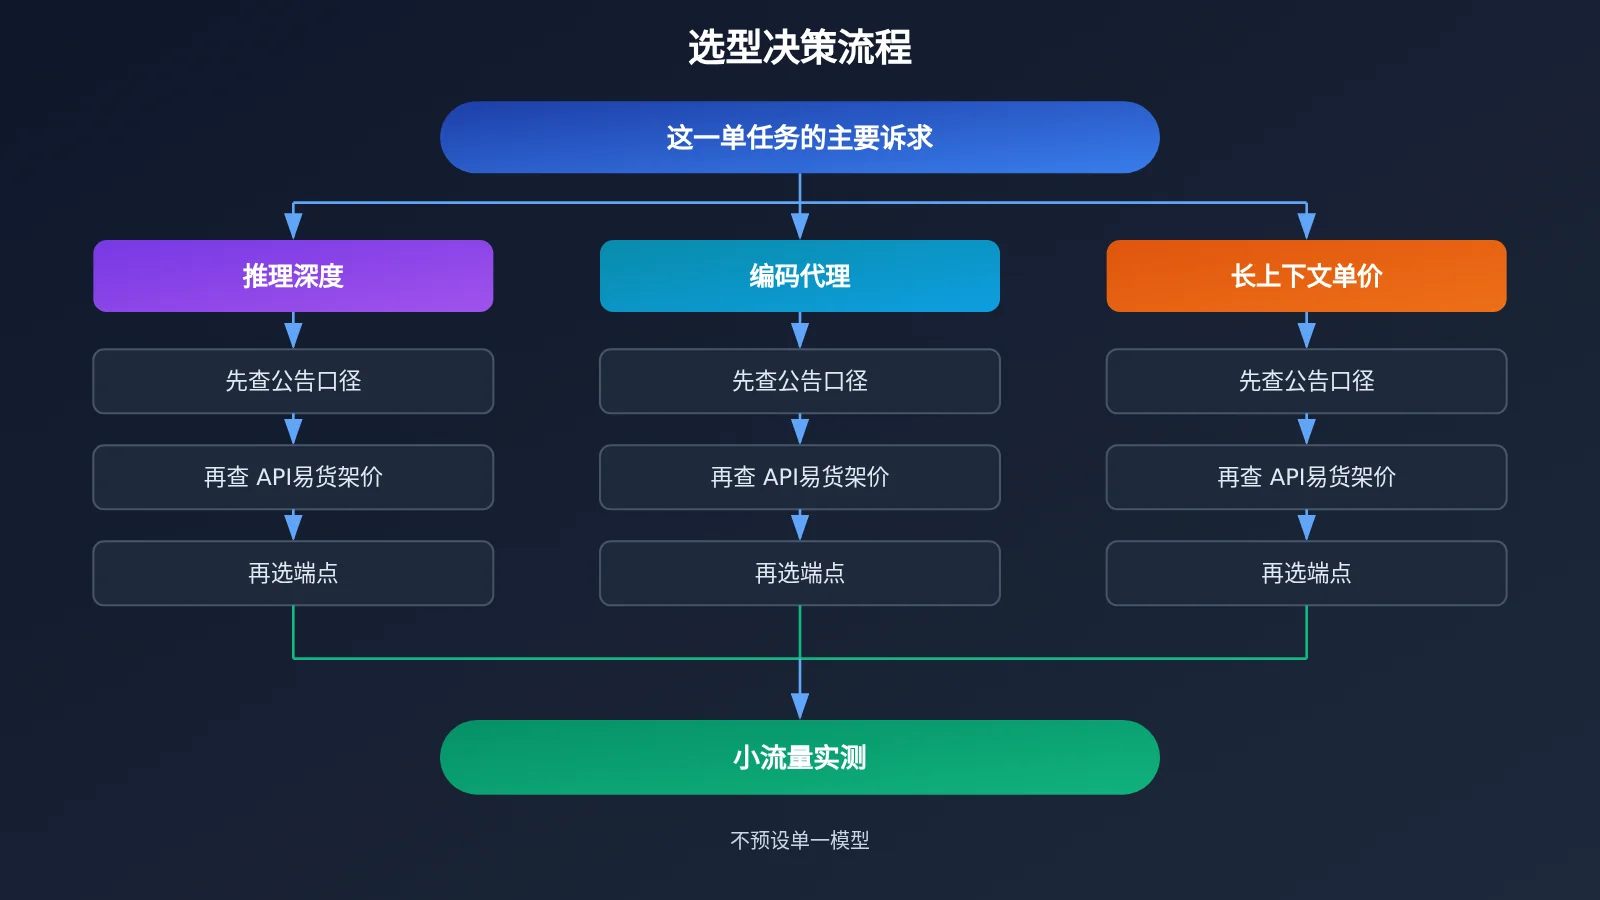
这不是一篇排座次的文章。榜单来源不同,计价档位不同,端点格式也不同,硬把它们折算成一个分数只会误导决策。本文把三款模型拆成三列分别核对:官方或公告引用的能力数据、API易 apiyi.com 货架价(2026-11-20 核对)、以及每款模型应该走的端点。
核心价值:读完本文,你能根据这一单任务更看重推理深度、编码代理,还是长上下文单价,自己判断该先测哪一款,并知道每款该用什么接口去调。
Gemini 4 Neon、GPT-6.2 Astra、Claude Fable 5.2 核心要点
先给一张速读表。三行信息来自三类不同的来源,表格只做并列展示,不做横向加总。
| 维度 | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| 能力数据来源 | Google 公告引用的第三方榜单(Artificial Analysis、Vals) | 参考资料未覆盖公告榜单数据 | API易更新日志转述的 Anthropic 公告(FrontierCode 2.0 等) |
| API易货架价(美元/百万 token) | 输入 3、缓存读 0.15、输出 15 |
首档输入 8、缓存读 0.4、输出 40,长上下文另有档位 |
输入 8、缓存读 0.2、输出 40 |
| 推荐端点 | chat 或 Gemini 原生格式 | responses(推荐),也支持 chat | chat 或 messages |
| 上下文 | 100 万 token | 以 272000 token 为计价分档线 | 1M 上下文、最多 128K 输出 |
三款模型核对重点详解
能力这一列,三款模型的口径并不对齐。Gemini 4 Neon 的数据是 Google 在公告中引用的第三方排行榜,Claude Fable 5.2 的数据是 Anthropic 发布内容经 API易更新日志转述,GPT-6.2 Astra 在本次参考资料中没有对应的榜单数字。榜单不同、测试集不同,不能把 Neon 的 Vals Index 百分比和 Fable 的 FrontierCode 百分比放在同一个数轴上比较。
价格这一列看起来最直观,但同样不能只比数字大小。三款模型的缓存读价格、长上下文分档、思考模式计费都不一样,一单任务的实际花费取决于输入输出比例、缓存命中率和是否越过分档线。端点这一列则直接决定代码怎么写,选错端点会导致参数不兼容或功能缺失。
Gemini 4 Neon、GPT-6.2 Astra、Claude Fable 5.2 性能差异(公告引用)
这一节只整理厂商公告或公告转述中出现的能力信息。以下数据均不是 API易实测,引用时请保留来源标注。
| 模型 | 数据项 | 数值 | 来源性质 |
|---|---|---|---|
| Gemini 4 Neon | Artificial Analysis Intelligence Index(xhigh) | 61,总排名第 3 | Google 公告引用的第三方榜 |
| Gemini 4 Neon | Vals Index | 第 2,70.9% | Google 公告引用的第三方榜 |
| Claude Fable 5.2 | FrontierCode 2.0 | 从 32.4% 提升到 49.1% | 公告转述(API易更新日志) |
| Claude Fable 5.2 | 生成速度 | 最多快 30% | 公告转述(API易更新日志) |
| GPT-6.2 Astra | 公开榜单 | 参考资料未提供 | — |
Gemini 4 Neon 的推理榜单怎么读
Google 在 2026-11-18 的公告里,引用 Artificial Analysis Intelligence Index 在 xhigh 档位下的 61 分、总排名第 3,以及 Vals Index 第 2、得分 70.9%。这两个都是综合性指数,侧重衡量通用推理与知识任务。需要注意的是,xhigh 是高推理强度档位,日常低档位调用的表现不一定与这个分数一致。
Claude Fable 5.2 的编码数据怎么读
Claude Fable 5.2 的核心数据是 FrontierCode 2.0 从上一代的 32.4% 提升到 49.1%,这是一个面向编码任务的评测。同时公告提到生成最多快 30%,配合 1M 上下文和 128K 最大输出,更贴近需要长代码库输入、长补丁输出的编码代理场景。FrontierCode 与 Vals 测的是不同能力,两组数字之间不存在换算关系。
GPT-6.2 Astra 的能力该怎么核对
本次参考资料没有提供 GPT-6.2 Astra 的公告榜单数据,因此这一格留空,不做推测。如果你的任务对 Astra 的能力有明确要求,更稳妥的做法是直接用自己的业务样本做小流量对比,而不是借用其他模型的榜单来类推。
Gemini 4 Neon、GPT-6.2 Astra、Claude Fable 5.2 价格核对(API易货架价)
本节价格于 2026-11-20 在 API易 apiyi.com 核对,来源有两处:模型总表(2026-11-19 10:59 UTC+8 更新版)和定价接口(版本 shell-api-modelmak-v1)。单位均为美元/百万 token。
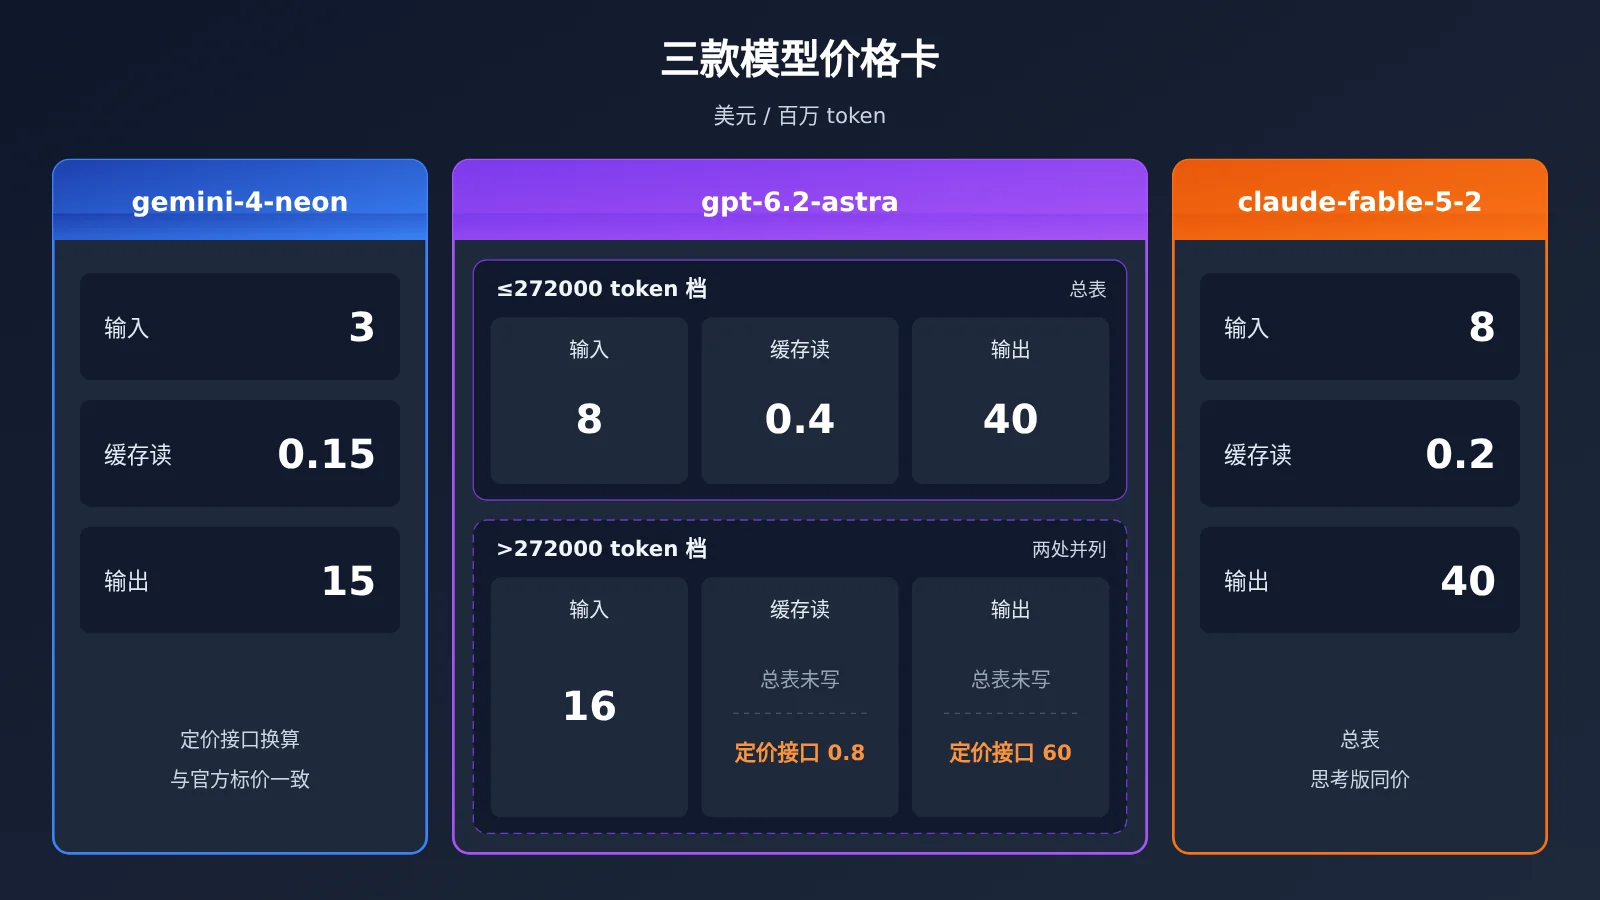
| 模型 ID | 输入 | 缓存读 | 输出 | 数据来源 |
|---|---|---|---|---|
gemini-4-neon |
3 |
0.15 |
15 |
定价接口换算,与 Google 公告标价一致 |
gpt-6.2-astra(首档) |
8 |
0.4 |
40 |
总表 |
gpt-6.2-astra(>272000 token) |
16 |
总表未写 / 定价接口 0.8 |
总表未写 / 定价接口 60 |
总表与定价接口并列 |
claude-fable-5-2 |
8 |
0.2 |
40 |
总表 |
claude-fable-5-2-thinking |
8 |
0.2 |
40 |
总表 |
定价接口的倍率怎么换算成美元
API易定价接口用倍率表示价格,约定 model_ratio 为 1 时等于输入 2 美元/百万 token。以 gemini-4-neon 为例:model_ratio 为 1.5,输入即 1.5 × 2 = 3;completion_ratio 为 5,输出即 3 × 5 = 15;cache_ratio 为 0.05,缓存读即 3 × 0.05 = 0.15。换算结果与 Google 在 2026-11-18 公告的标价完全一致,核对时可以直接用这个公式自查。
GPT-6.2 Astra 的长上下文档位为什么分两处写
GPT-6.2 Astra 以 272000 token 为分档线。总表写明了首档价格,以及超过 272000 token 后输入为 16,但没有写这一档的输出价;定价接口则给出了超过 272000 token 时输出按 60、缓存读按 0.8 计。两处信息并列保留,本文不把它们合成为一个数,如果你的请求经常越过 272000 token,建议以调用时定价接口返回的结果为准。
Claude Fable 5.2 的降价信息
根据 API易 2026-11-10 的更新日志,Anthropic 公告 Claude Fable 5.2 的输入、输出价格为 8 和 40,比 5.1 低 20%,缓存读为 0.2。claude-fable-5-2 与 claude-fable-5-2-thinking 在总表中价格相同,选择思考版时不需要单独换算单价,但思考过程产生的输出 token 会体现在用量上。
同系列 Gemini 4 的价格参照
如果你在 Gemini 4 系列内部做取舍,下面几款的货架价可以一起参考。其中 gemini-4-carbon 的价格对应 Google 截至 2026-11-30 的介绍价,Google 公布 12 月 1 日起标准价为输入 4、输出 20,届时货架价是否调整请以当天总表为准。
| 模型 ID | 输入 | 缓存读 | 输出 | 备注 |
|---|---|---|---|---|
gemini-4-carbon |
2 |
0.1 |
10 |
对应 Google 介绍价(至 2026-11-30) |
gemini-4-hydrogen |
1.5 |
0.075 |
7.5 |
— |
gemini-4-argon |
2 |
0.1 |
10 |
总表价格 |
Gemini 4 Neon、GPT-6.2 Astra、Claude Fable 5.2 接口端点
三款模型推荐的端点各不相同,不存在一段代码能通吃三家的写法。统一的部分只有 base_url:在 API易调用时都填 https://api.apiyi.com/v1,再按模型选择对应路径和请求格式。
| 模型 | 推荐端点 | 备选端点 | 写法要点 |
|---|---|---|---|
| Gemini 4 Neon | chat(OpenAI 兼容 /chat/completions) |
Gemini 原生格式 | 已有 OpenAI SDK 的项目走 chat;需要 Gemini 原生参数时走原生格式 |
| GPT-6.2 Astra | responses(/responses) |
chat(/chat/completions) |
推荐 responses,请求体用 input 字段;chat 用 messages 字段 |
| Claude Fable 5.2 | chat(/chat/completions) |
messages(Anthropic Messages 格式) | 需要 Anthropic 原生能力时走 messages;思考版用 claude-fable-5-2-thinking |
为什么 GPT-6.2 Astra 推荐 responses
responses 是 OpenAI 新一代接口格式,对多轮状态、工具调用等能力的承载更完整,因此 Astra 推荐优先走这个端点。chat 端点依然可用,适合已有大量 chat 格式代码、暂时不想重构的项目。两种端点的请求体字段不同,迁移时不要只改模型名。
为什么 Neon 和 Fable 各有两个入口
Gemini 4 Neon 和 Claude Fable 5.2 都同时支持 OpenAI 兼容的 chat 端点和各自厂商的原生格式。chat 端点的好处是代码可以与其他模型共用一套 SDK;原生格式的好处是可以使用厂商特有的参数。如果你的业务只是常规对话与生成,chat 端点通常已经够用。
Gemini 4 Neon、GPT-6.2 Astra、Claude Fable 5.2 快速上手
按照本文要求,这里不给一段通用代码,而是按模型分别列出关键参数。三款模型共用的配置是:api_key 填在 API易后台获取的 Key,base_url 填 https://api.apiyi.com/v1。
- 调用 Gemini 4 Neon:OpenAI SDK 指向上述 base_url,调用
chat.completions.create,model填gemini-4-neon,messages传入对话数组;如需原生参数,改用 Gemini 原生格式请求。 - 调用 GPT-6.2 Astra:同一个 SDK 客户端调用
responses.create,model填gpt-6.2-astra,用input传入提示内容;若沿用旧代码,也可以走chat.completions.create。 - 调用 Claude Fable 5.2:常规场景调用
chat.completions.create,model填claude-fable-5-2;需要深度思考时换成claude-fable-5-2-thinking;需要 Anthropic 原生参数时改走 messages 格式。 - 记录用量:每次调用后记下返回的输入、输出、缓存 token 数,后面算单任务成本时要用。
🚀 快速开始:建议先在 API易 apiyi.com 领取新用户免费测试额度,用同一批业务样本分别跑三款模型。一个 API Key 即可切换三家模型,按量计费,便于在真实负载下对比效果和花费。
场景推荐:按这一单的诉求分开看
选型的起点不是“哪个模型最好”,而是这一单任务最在意什么。下面按三种常见诉求,列出应该优先查看的那一列信息。
更看重推理深度的场景
- 复杂分析与多步推理:优先查看 Gemini 4 Neon 公告引用的 Artificial Analysis 与 Vals Index 数据,注意 61 分是 xhigh 档位下的结果。
- 需要高推理档位的任务:Claude Fable 5.2 有独立的
claude-fable-5-2-thinking模型 ID,可以和非思考版用同样单价对照测试。 - 对 GPT-6.2 Astra 有需求:参考资料没有其榜单数据,建议直接用业务样本验证。
更看重编码代理的场景
- 长代码库输入、长补丁输出:Claude Fable 5.2 公告转述的 FrontierCode 2.0 提升和 128K 输出上限是可以参考的信息。
- 工具调用与多轮状态较重:GPT-6.2 Astra 推荐的 responses 端点更适合承载这类交互,接入方式本身是一个考量点。
- 已有 OpenAI 兼容代码:三款都能走 chat 端点,迁移成本相对可控。
更看重长上下文单价的场景
- 常驻超长输入:先确认请求是否越过 GPT-6.2 Astra 的 272000 token 分档线,越线后单价按另一档计。
- 高缓存命中率:三款模型的缓存读单价差别较大,缓存命中率高的业务要把缓存读单价单独算进去。
- 1M 级上下文:Gemini 4 Neon 与 Claude Fable 5.2 都标注了 100 万 token 级别上下文,但输入输出单价不同,需要按自己的输入输出比例计算。
决策建议:三列分开核对再小流量验证
把三列信息分开核对,是避免选型误判最简单的方法。能力列只说明“在某个榜单、某个档位下的表现”,价格列只说明“每百万 token 的单价”,端点列只说明“代码该怎么写”,任何一列都不能单独推出“这一单该用谁”。
更实用的做法是先算单任务成本:用业务里的典型请求估算输入、输出、缓存 token 数,分别乘以三款模型的对应单价,GPT-6.2 Astra 还要判断是否越过 272000 token。然后再用同一批样本测质量,把成本和质量放在一起看,而不是只看榜单或只看单价。
💡 选择建议:选择哪款模型取决于你的任务结构和质量要求。建议通过 API易 apiyi.com 用统一的 Key 对三款模型做小流量对比,按真实用量核算成本,再决定主力模型和备用模型。
常见问题 FAQ
Q1:Gemini 4 Neon、GPT-6.2 Astra、Claude Fable 5.2 分别是什么?
三款都是 2026 年 11 月前后出现的新一代大模型:Gemini 4 Neon 由 Google 在 2026-11-18 公告,Claude Fable 5.2 由 Anthropic 在 11 月 9 日发布,GPT-6.2 Astra 已列入 API易价格总表。三款的能力口径、计价方式和端点格式各不相同。
Q2:三款模型的榜单分数能直接比较吗?
不能。Gemini 4 Neon 的数据来自 Google 公告引用的 Artificial Analysis 与 Vals Index,Claude Fable 5.2 的数据是公告转述的 FrontierCode 2.0,两者测的是不同能力;GPT-6.2 Astra 在本次资料中没有榜单数据。不同榜单之间不存在换算关系。
Q3:三款模型是什么时候发布的?
根据 API易 2026-11-10 的更新日志,Anthropic 在 11 月 9 日发布 Claude Fable 5.2;Google 在 2026-11-18 发布 Gemini 4 Neon 公告。本文价格于 2026-11-20 核对,参考的总表版本更新于 2026-11-19 10:59(UTC+8)。
Q4:GPT-6.2 Astra 超过 272000 token 后输出价到底是多少?
两处来源的写法不同:API易总表写了超过 272000 token 后输入为 `16`,但没有写输出价;定价接口写明超过 272000 token 时输出按 `60`、缓存读按 `0.8`。本文两处并列保留,实际计费建议以调用时定价接口为准。
Q5:如何通过 API 快速调用这三款模型?
推荐使用多模型聚合平台统一接入:
1. 访问 API易 apiyi.com 注册账号,获取 API Key 和免费测试额度
2. base_url 统一填 `https://api.apiyi.com/v1`
3. 按模型选端点:Neon 走 chat 或 Gemini 原生格式,Astra 走 responses(也可走 chat),Fable 走 chat 或 messages
一个 Key 即可切换三家模型,方便在同一批样本上对比。
Q6:怎样自己核对 API易的货架价?
可以同时看 API易 apiyi.com 的模型总表和定价接口。定价接口用倍率表示,`model_ratio` 为 1 等于输入 2 美元/百万 token,输出等于输入乘以 `completion_ratio`,缓存读等于输入乘以 `cache_ratio`。例如 `gemini-4-neon` 按此换算为输入 3、输出 15、缓存读 0.15。
Q7:Claude Fable 5.2 的思考版要额外付费吗?
`claude-fable-5-2` 与 `claude-fable-5-2-thinking` 在总表中的单价相同,都是输入 8、缓存读 0.2、输出 40。单价不变,但思考过程会产生额外输出 token,实际花费会随用量变化。
Q8:这三款模型有哪些需要注意的限制?
– **能力数据**:Neon 与 Fable 的数据都是公告引用或转述,不是独立实测;Astra 缺少公开榜单数据。
– **计价分档**:Astra 有 272000 token 分档线,两处来源写法不一。
– **价格时效**:同系列的 `gemini-4-carbon` 对应 Google 截至 11 月 30 日的介绍价,12 月起 Google 标准价为输入 4、输出 20。
– **端点差异**:三款推荐端点不同,迁移时不能只改模型名。
Gemini 4 Neon、GPT-6.2 Astra、Claude Fable 5.2 核心要点 Key Takeaways
- 三列分开看:公告能力、API易货架价、调用端点各自独立,不合成一个分数。
- 榜单口径不同:Neon 引用 Artificial Analysis 与 Vals,Fable 引用 FrontierCode,不可横比。
- Neon 价格可自查:定价接口倍率换算为输入 3、缓存读 0.15、输出 15。
- Astra 注意分档:超过 272000 token 输入为 16,输出价总表未写、定价接口写 60。
- Fable 单价统一:普通版与思考版同为输入 8、缓存读 0.2、输出 40。
- 端点各不相同:Neon 走 chat 或原生,Astra 推荐 responses,Fable 走 chat 或 messages。
- 上手方式:通过 API易 apiyi.com 一个 Key 接入三款模型,用同批样本小流量对比。
总结
Gemini 4 Neon、GPT-6.2 Astra、Claude Fable 5.2 的对比,关键在于不把三类信息混在一起:
- 能力列:只看公告引用的榜单和档位,Neon 与 Fable 的数据口径不同,Astra 需自行验证。
- 价格列:以 API易货架价为准,留意缓存读单价、Astra 的 272000 token 分档和两处来源的差异。
- 端点列:三款推荐端点各不相同,base_url 统一为
https://api.apiyi.com/v1,路径和请求体按模型分别写。
先明确这一单更看重推理深度、编码代理还是长上下文单价,再按对应那一列核对,最后用真实样本做小流量验证。推荐通过 API易 apiyi.com 领取免费额度,在同一个 Key 下完成三款模型的对比测试。
📚 参考资料
-
API易模型总表:模型 ID 与货架价(本文核对版本更新于 2026-11-19 10:59 UTC+8)
- 链接:
docs.apiyi.com/models.md - 说明: 查询
gpt-6.2-astra、claude-fable-5-2等模型的分档单价
- 链接:
-
API易定价接口:倍率形式的实时定价(版本
shell-api-modelmak-v1)- 链接:
api.apiyi.com/api/pricing - 说明: 用
model_ratio、completion_ratio、cache_ratio换算美元单价
- 链接:
-
Google Gemini 4 Neon 公告:2026-11-18 发布
- 说明: 含标价、100 万上下文,以及引用的 Artificial Analysis 与 Vals Index 数据
-
API易更新日志(2026-11-10):转述 Anthropic Claude Fable 5.2 发布信息
- 说明: 含价格调整、FrontierCode 2.0 数据、1M 上下文与 128K 输出
作者: APIYI 技术团队
技术交流: 欢迎在 API易官网首页联系我们,获取更多模型接入与定价核对资料