直接回答: GPT-6.2 Astra 在 Responses API 中可以并行委派子任务(Multi-agent),可以借助截图操作浏览器或桌面界面(Computer Use),也可以连接远程 MCP 服务调用团队的业务工具。不过,这三项能力的执行方各不相同:委派由 API 托管,界面操作的运行环境由你的应用提供,MCP 调用的对象是你配置的远端服务。
核心结论: 工程上的难点主要在编排,而不在模型能力本身。真正能落地的业务智能体,需要事先说清三件事:每个工具由谁执行,数据授权到哪一步为止,最终结果由谁来校验。
您读完此文能了解到什么?
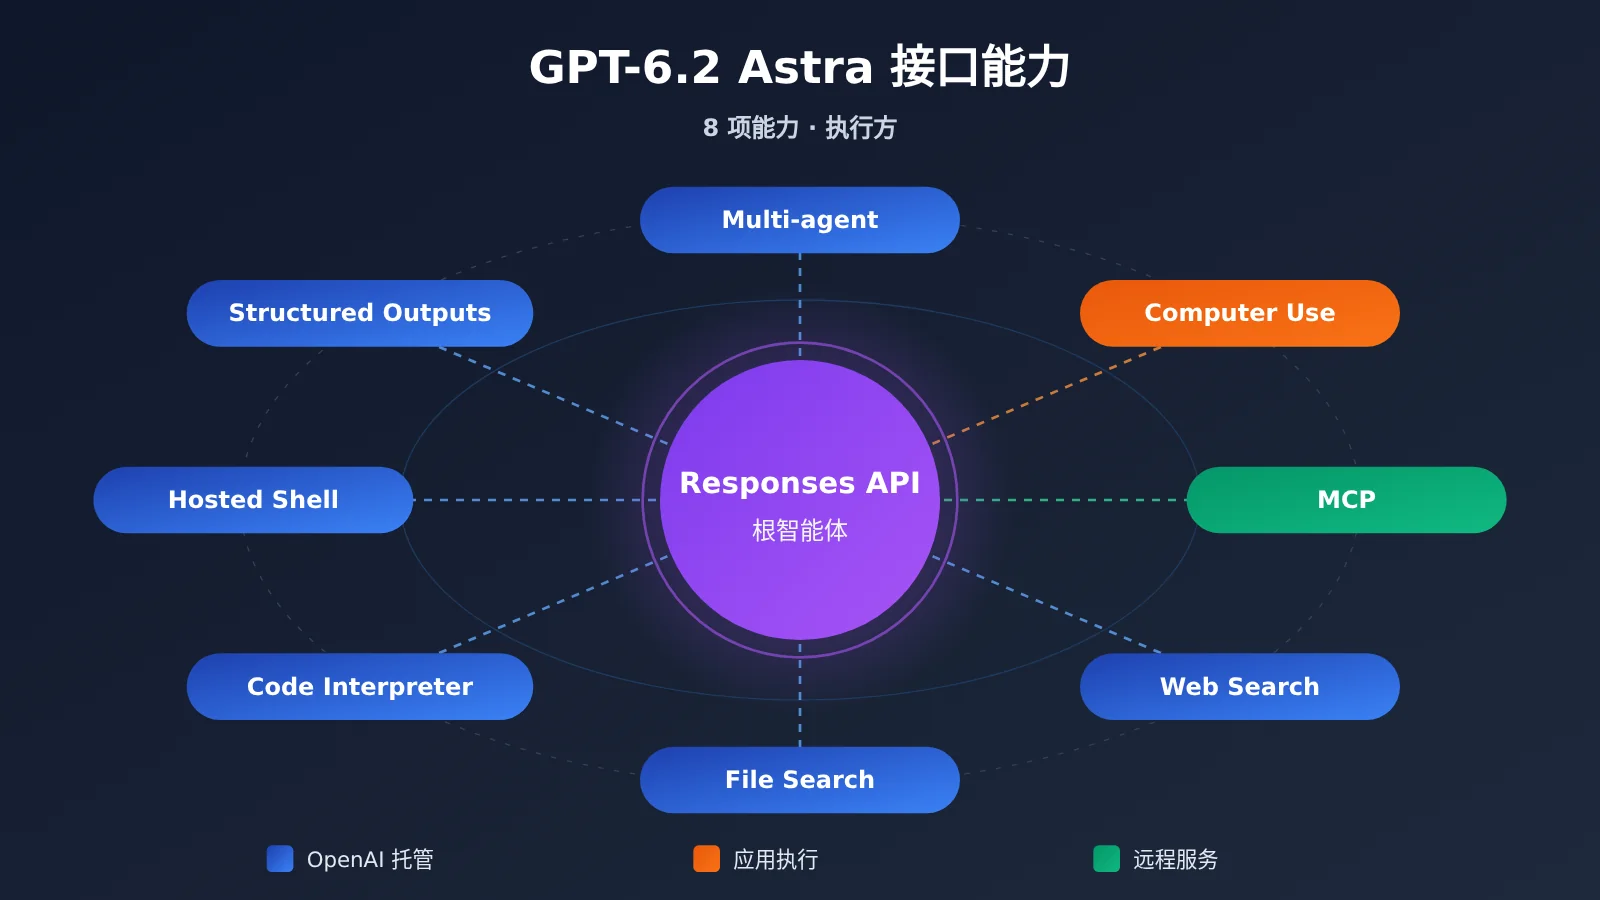
- GPT-6.2 Astra 在 Responses API 中支持的 6 类内置工具和 Structured Outputs,以及每一项的执行方和使用前提;
- Multi-agent beta 的启用方式、默认并发数,以及哪些任务适合并行、哪些必须顺序执行;
- Computer Use 与远程 MCP 两条执行路径的区别,包括审批、权限范围和责任划分;
- 如何把检索、计算和结构化输出串起来,交付一份可以校验的采购核验结果。
索引: 正文先汇总 OpenAI 在 11 月 17 日公布的模型身份、规格与价格。随后用一张表对比 8 项能力的执行方,再沿“只读采购核验”这个设计示例,依次讲解 Multi-agent 的并行边界、Computer Use 与 MCP 的执行路径,以及从检索到结构化输出的交接方式。文章最后的分析部分会回答:开发者和产品负责人现在应该先做什么。
GPT-6.2 Astra To Know:概念解释
| 概念 | 简要解释 |
|---|---|
| Responses API | OpenAI 用于模型响应和工具调用的接口,本文讨论的内置工具和 Multi-agent 都以它为准 |
| Multi-agent | 在一次受支持的 Responses 请求中启用多个协作智能体的 beta 功能 |
| 子智能体 | 在独立上下文中处理委派任务,完成后向根智能体回报的工作单元 |
| Computer Use | 模型根据截图定位界面元素,请求执行浏览器或桌面操作的能力 |
| MCP | 规范模型客户端如何发现、调用外部服务工具的协议 |
| Web Search | 在公开互联网检索资料,可在响应中返回来源标注的工具 |
| File Search | 在指定向量存储中检索已上传文件的工具 |
| Code Interpreter | 运行 Python 分析数据、生成文件的托管沙箱 |
| Hosted Shell | 由 OpenAI 托管、可以执行终端命令的隔离环境 |
| Structured Outputs | 通过 JSON Schema 约束响应格式的输出能力 |
| 工具调用 ID | 把某次调用请求和它的执行结果对应起来的标识,如 call_id |
GPT-6.2 Astra 影响速览
- 业务智能体工程师:一次请求里可以组合委派、检索、远程工具和结构化输出,编排代码会变少。但函数结果回传、Computer Use 运行环境、MCP 审批这些环节,仍然要由应用侧实现。
- 产品负责人:“智能体能自己操作系统”这件事有了官方接口支撑。权限范围、写入确认和人工复核的责任,需要在产品设计阶段就写进流程。
- 成本敏感的团队:官方单价较前代有所下调。但 Multi-agent 并行可能增加 token 用量,预算需要按任务结构重新估算。
GPT-6.2 Astra 客观事实:发布、规格与工具清单
GPT-6.2 Astra 的发布与模型身份
OpenAI 于 2026 年 11 月 17 日同时发布 GPT-6.2 Astra 和 GPT-6.2 Sol。官方将 Astra 定位为面向复杂推理、编码和专业工作的模型,API 模型 ID 为 gpt-6.2-astra,前代为 GPT-6 Astra(gpt-6-astra)。API 更新日志在同一天记录了模型发布和后台完成窗口相关条目。
模型卡列出的规格是:上下文 1,050,000 token,最大输入 922,000 token,最大输出 128,000 token。模型接受文本和图像输入,输出文本,同时支持 Responses API 和 Chat Completions API。需要特别注意,模型卡说明 reasoning.effort 设为 none 的请求会被拒绝,迁移旧代码时要检查这个参数。
价格方面,OpenAI 公示的标准短上下文纯文本单价按每百万 token 计:普通输入 $8,缓存命中输入 $0.40,输出 $40。与前代相比,官方公布普通输入和输出单价降低 20%,缓存命中输入单价降低 60%。这组数字只适用于官方直连 API 的估算,第三方评测中的按题费用采用的是另一套价格口径,不能直接对比。
🚀 快速开始:如果想先验证 GPT-6.2 Astra 在自己业务数据上的表现,可以通过 API易 apiyi.com 用一个 API Key 发起 OpenAI 兼容调用。新用户有免费测试额度,适合正式接入前做小规模验证。beta 工具的可用范围以平台实际支持为准。
GPT-6.2 Astra 接口能力总表
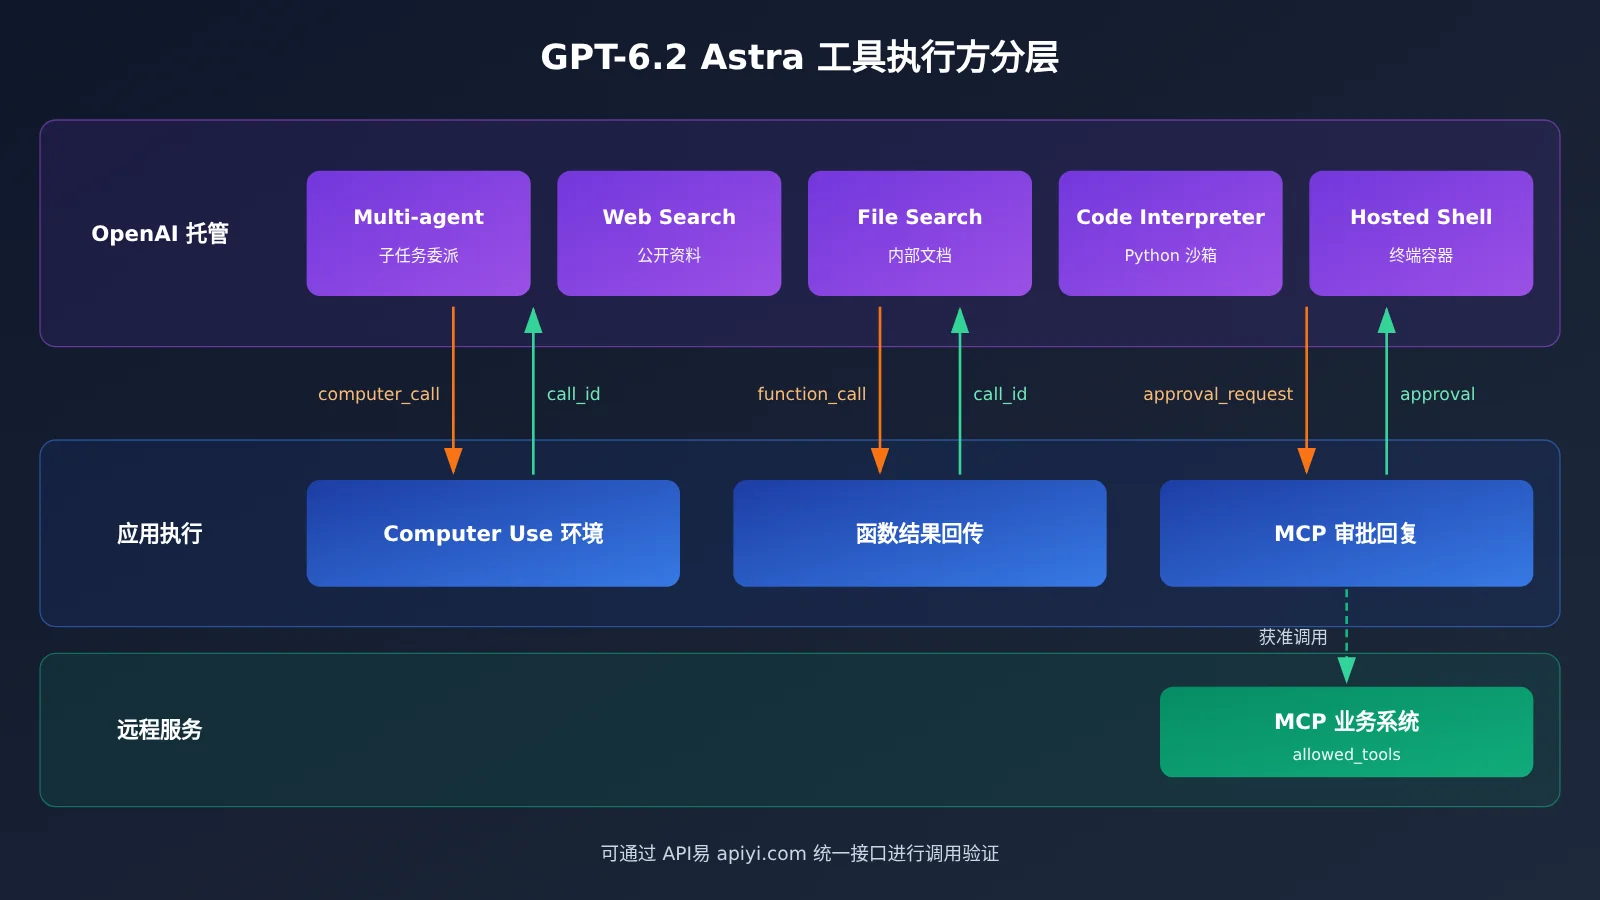
模型卡将 Web Search、File Search、Code Interpreter、Hosted Shell、Computer Use 和 MCP 列为 Astra 在 Responses API 中支持的工具,Structured Outputs 列为输出能力,Multi-agent 则是 Responses 的 beta 功能。开发者在请求中声明可用工具,模型根据任务决定是否发起调用。响应里可能出现工具请求、审批请求、执行结果或最终文本,客户端需要处理哪些输出项,取决于每个工具的执行方。
| 能力 | 执行方 | 前提 / 配置 | 适合的动作 |
|---|---|---|---|
| Multi-agent | Responses 托管委派 | 显式启用 beta | 并行处理独立子任务并汇总 |
| Computer Use | 应用提供的浏览器或桌面 | 应用负责环境与登录态 | 查看或操作需要交互的界面 |
| MCP | OpenAI 调用你配置的远程服务 | 服务地址、认证、allowed_tools | 查询业务系统或请求写入 |
| Web Search | OpenAI 托管 | 声明工具即可 | 查公开且变化较快的资料 |
| File Search | OpenAI 托管 | 预先上传并索引到向量存储 | 按语义和关键词查内部文档 |
| Code Interpreter | OpenAI 管理的 Python 容器 | 管理文件的输入与取回 | 对账、统计、生成图表 |
| Hosted Shell | OpenAI 管理的终端容器 | 可用 container_auto 配置 | 多步骤命令行与多文件处理 |
| Structured Outputs | 响应格式约束 | 在 text.format 中声明 JSON Schema | 产出可校验的业务数据 |
GPT-6.2 Astra Multi-agent 的启用方式与共享范围
启用 Multi-agent 时,需要在 Responses 请求中设置 multi_agent.enabled。如果使用原始 HTTP 或 WebSocket,还要带上请求头 OpenAI-Beta: responses_multi_agent=v1;使用 SDK 时则调用对应的 beta 接口。根智能体可以创建子智能体、与它们沟通、等待它们完成,并负责最终汇总。
每个子智能体有自己的上下文,但共享该请求的模型和可用工具。max_concurrent_subagents 默认值为 3,限制的是整棵智能体树中同时处于活动状态的子智能体回合数。委派动作 multi_agent_call 由 API 托管。如果子智能体调用了开发者自定义的函数,应用需要按对应的调用 ID 返回执行结果。官方同时提醒,并行适合相互独立的调查任务,token 用量可能因此上升;依赖前序结果的步骤和共享写入,需要自行安排执行顺序。
GPT-6.2 Astra Computer Use 与 MCP 的执行边界
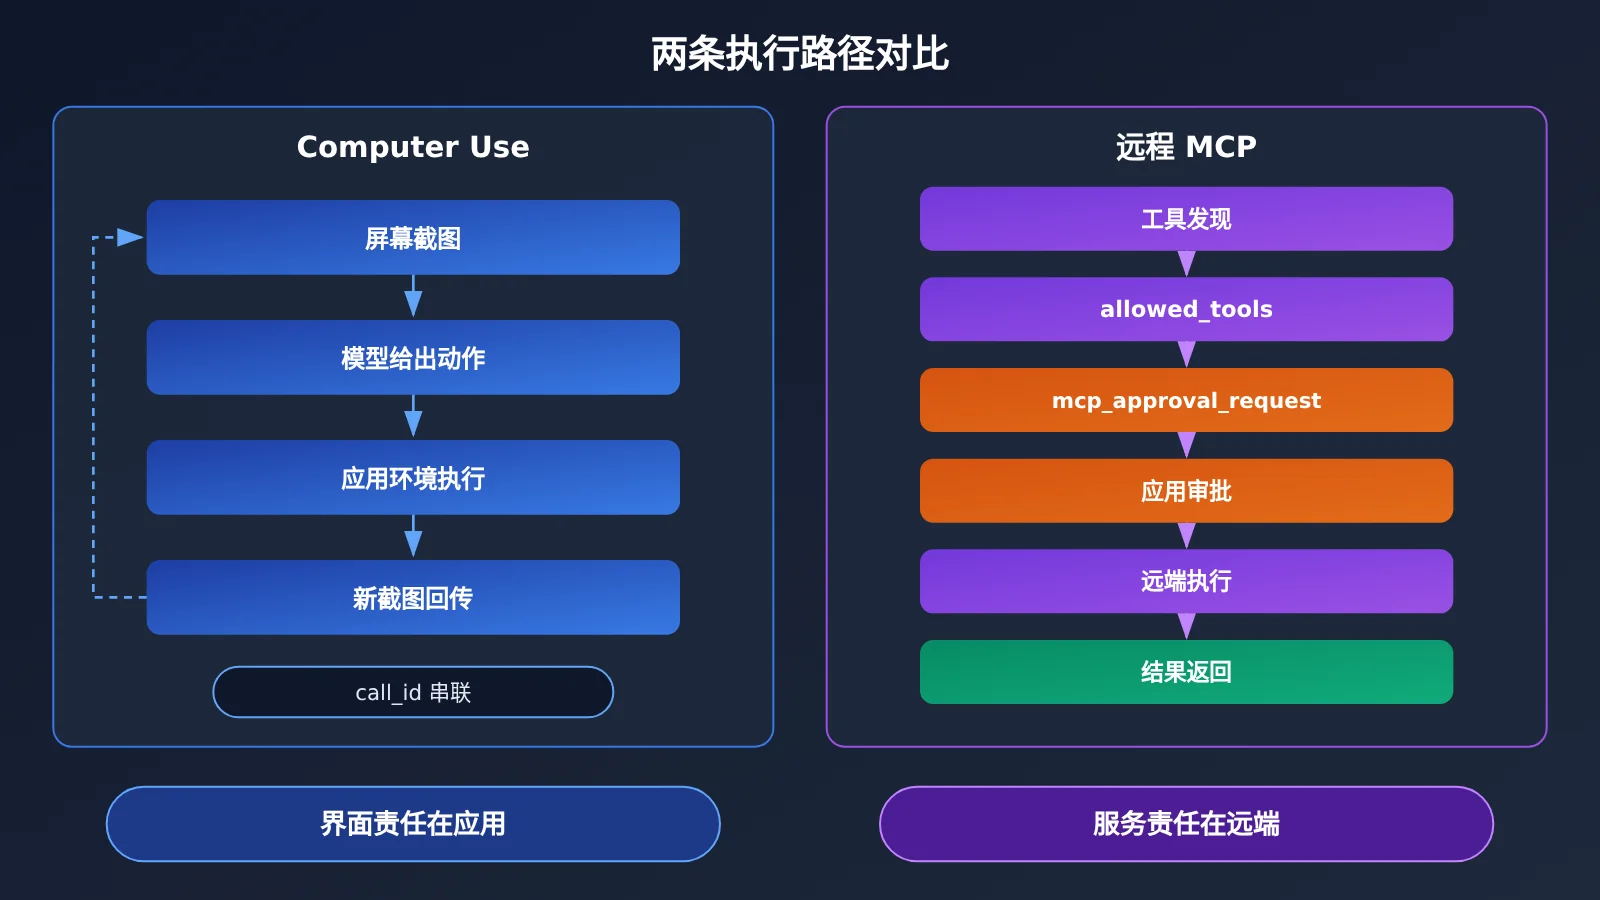
Computer Use 的运行环境由应用提供。使用原生 computer 工具时,模型发出 computer_call,由你的运行环境执行其中的点击、输入等动作,再把新的屏幕截图通过 computer_call_output 和对应的 call_id 交回模型,如此循环直到任务结束。官方指南也给出了另一种接法:让模型生成脚本,由应用在隔离环境中执行。无论采用哪种方式,环境本身、登录态、可访问的页面以及关键写入前的确认,都由应用负责。
远程 MCP 的执行方式不同。API 会连接你指定的服务地址,导入服务端暴露的工具,并执行获准的调用。远端认证按服务要求配置,allowed_tools 可以限制导入哪些工具。默认情况下,向连接器或远程服务发送数据之前会先申请审批:应用可以读取 mcp_approval_request 中的工具名和参数,再逐次回传 mcp_approval_response。
GPT-6.2 Astra 检索、计算与结构化输出的规则
Web Search 面向公开互联网,应用可以利用 url_citation 把结论和来源关联起来。File Search 在指定向量存储中检索已上传的文件,适合已经归档的内部资料。Code Interpreter 提供 Python 沙箱,并能产出文件。Hosted Shell 可以通过 container_auto 配置云端终端;Shell 指南还介绍了由应用自行托管运行时的方式。两种计算环境里的文件,都需要在使用时主动管理和取回。
Structured Outputs 通过 text.format 声明 JSON Schema,约束的是完成且未拒绝的响应。官方明确说明,接收方仍需处理拒绝、未完成、API 错误,以及 schema 无法表达的业务规则。
GPT-6.2 Astra 分析判断:用一次采购核验串起全部能力
以下流程是一个设计示例,由参考资料中的能力组合推演而来,并非官方案例。每次请求需要按实际情况配置工具,最终能启用哪些组合,取决于你的账户、工具配置和运行环境。
GPT-6.2 Astra Multi-agent 何时适合并行
任务目标是:核对某份合同的约定、采购系统中的订单记录、供应商官网的公开信息三者是否一致,全程只读。这三项查询之间没有依赖关系,正好对应默认并发数 3:合同组用 File Search 查条款,采购组通过只读 MCP 查订单,网页组用 Web Search 查公开信息。根智能体等三组都回报之后再做归并。
判断能否并行,可以看一个标准:子任务的输入里是否需要另一个子任务的输出。比如“先拿到订单号,再用订单号查发票”就必须顺序执行,硬拆成并行只会让子智能体各自猜测,结果更难核对。还要注意,委派动作虽然由 API 托管,但如果子智能体调用了你定义的函数,函数结果仍需应用按调用 ID 回传。这个环节漏掉,整棵智能体树就会停在等待状态。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

# 示意代码:参数结构请以 OpenAI 最新指南为准
resp = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "medium"},  # 设为 none 会被拒绝
    input="只读核验:合同 C-102 条款、订单 PO-881 记录、供应商官网公示信息是否一致",
    tools=[
        {"type": "file_search", "vector_store_ids": ["vs_contracts"]},
        {"type": "web_search"},
        {
            "type": "mcp",
            "server_label": "procurement",
            "server_url": "https://mcp.example.com/procurement",
            "allowed_tools": ["get_purchase_order"],  # 只开放一个只读工具
            "require_approval": "always",
        },
    ],
    extra_headers={"OpenAI-Beta": "responses_multi_agent=v1"},
    extra_body={"multi_agent": {"enabled": True, "max_concurrent_subagents": 3}},
)
💡 选择建议:并行委派会增加 token 消耗,建议先用小样本测出单次核验的实际用量,再决定并发数。通过 API易 apiyi.com 按量计费调用,可以在不同并发配置之间快速对比成本。
GPT-6.2 Astra Computer Use 与 MCP 的分工判断
假设供应商官网的资质有效期只有在点开某个“资质证书”弹窗后才会显示,Web Search 抓不到这个字段,这时就需要 Computer Use。流程分三步:应用在隔离浏览器中打开页面并截图;模型返回点击坐标或操作指令;应用执行后把新截图连同 call_id 交回模型。由于登录态和可访问范围都掌握在应用手里,只读任务最好从环境层面就禁止表单提交,不要只依赖提示词约束。
订单查询则走 MCP。工具发现阶段,通过 allowed_tools 只导入 get_purchase_order 这一个只读工具;认证使用权限最小的只读凭证。每次调用前,应用读取 mcp_approval_request 里的参数,确认订单号在本次核验范围内,再回传批准。两条路径的责任可以这样划分:界面上发生了什么由应用负责,远端系统返回了什么由服务方负责,模型只负责提出请求。
| 维度 | Computer Use | 远程 MCP |
|---|---|---|
| 执行环境 | 应用提供的浏览器 / 桌面 | 你配置的远端服务 |
| 串联标识 | computer_call 与 call_id | mcp_approval_request / response |
| 权限控制点 | 环境隔离、登录态、页面白名单 | 服务认证、allowed_tools、逐次审批 |
| 适合字段 | 需要交互才显示的公开信息 | 业务系统中的结构化记录 |
| 主要风险 | 误点击、页面改版 | 越权调用、参数越界 |
GPT-6.2 Astra 从搜集资料走到可用输出
检索工具按文档所在位置选择:公开且经常变化的信息用 Web Search,并保留 url_citation;已归档的合同用 File Search。计算环境按任务形态选择:金额对账、汇总统计这类工作,Code Interpreter 的 Python 沙箱就够用;需要批量解压、转换多个文件或串联命令行工具时,再考虑 Hosted Shell。别忘了在流程中写好文件取回这一步。
根智能体完成归并后,建议在应用发起的后续 Responses 请求里单独生成结构化结果,不要和检索混在同一次请求里。这样 schema 更简单,失败时也更容易重试。
查看审批回传与结构化输出的示意代码
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

ALLOWED_PO = {"PO-881"}

def handle_approvals(resp):
    """逐条审批 MCP 调用:只放行本次核验范围内的订单号"""
    replies = []
    for item in resp.output:
        if item.type == "mcp_approval_request":
            ok = item.name == "get_purchase_order" and \
                 item.arguments and any(po in item.arguments for po in ALLOWED_PO)
            replies.append({
                "type": "mcp_approval_response",
                "approval_request_id": item.id,
                "approve": bool(ok),
            })
    return replies

schema = {
    "type": "object",
    "properties": {
        "records": {
            "type": "array",
            "items": {
                "type": "object",
                "properties": {
                    "record_id": {"type": "string"},
                    "evidence": {"type": "array", "items": {"type": "string"}},
                    "status": {"type": "string",
                               "enum": ["match", "mismatch", "needs_review"]},
                },
                "required": ["record_id", "evidence", "status"],
                "additionalProperties": False,
            },
        }
    },
    "required": ["records"],
    "additionalProperties": False,
}

def to_structured(prev_id):
    final = client.responses.create(
        model="gpt-6.2-astra",
        previous_response_id=prev_id,
        input="把核验结论整理为结构化记录,evidence 只写可追溯来源",
        text={"format": {"type": "json_schema", "name": "procurement_check",
                         "schema": schema, "strict": True}},
    )
    if final.status != "completed":
        raise RuntimeError(f"未完成:{final.status}")  # 拒绝、未完成需单独处理
    return final.output_text
格式约束只是第一道防线,字段逻辑还需要程序和人来把关。下面是一份输出样例,以及每个字段的校验责任:
| 字段 | 示例值 | 格式保证 | 仍需检查的内容 | 责任方 |
|---|---|---|---|---|
| record_id | PO-881 | schema 约束为字符串 | 是否真实存在于采购系统 | 程序回查 |
| evidence | 合同第 5.2 条;官网资质页 | 必须是数组 | 来源能否打开、引用是否对应 | 程序 + 抽检 |
| status | mismatch | 只能取枚举值 | 判定是否符合业务口径 | 人工复核 |
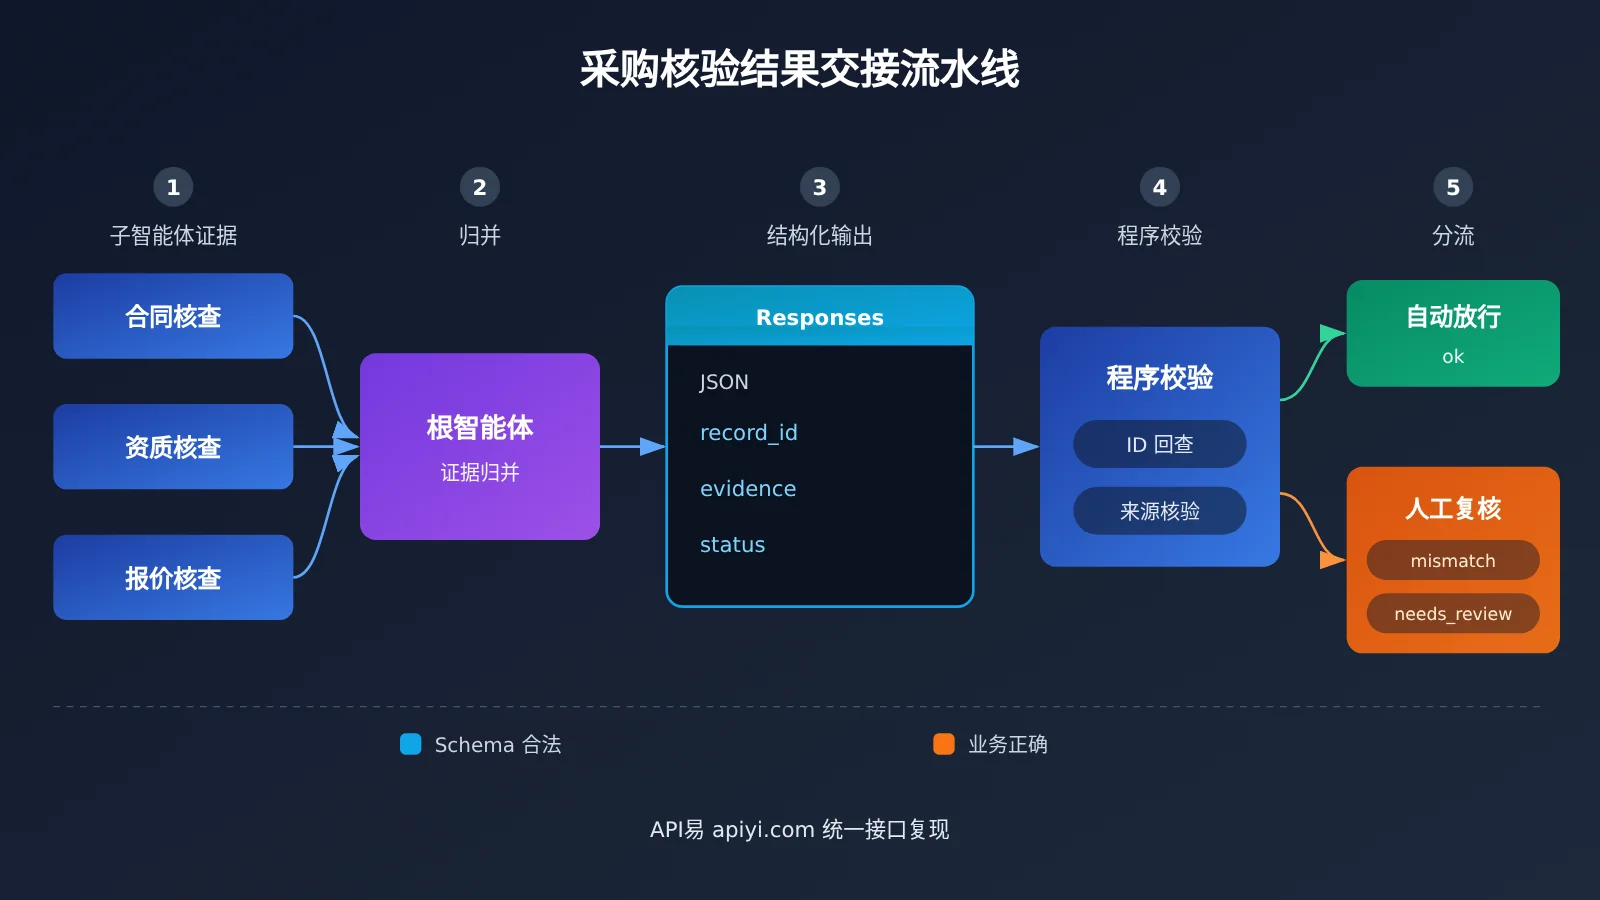
🎯 技术建议:建议把“schema 合法”和“业务正确”拆成两个独立检查步骤,
status为mismatch或needs_review的记录一律进入人工队列。上线前可以在 API易 apiyi.com 上用历史采购单回放整条流程,统计误判率,再决定哪些状态可以自动放行。
GPT-6.2 Astra 落地顺序的判断
基于以上事实,我们对接入顺序的判断是:先打通 Structured Outputs 和 File Search,再接只读 MCP,最后引入 Multi-agent 和 Computer Use。前两项由 OpenAI 托管,出错概率最低;MCP 的审批回传是一套需要单独测试的状态机;Multi-agent 目前仍是 beta,Computer Use 的稳定性又依赖你自建环境的质量,这两项适合在主流程稳定之后再叠加。
这个判断成立的前提是:beta 接口在近期不会出现破坏性变更,你的账户也能开通相应工具。两者都需要持续关注 OpenAI 的 API 更新日志。另外,“只读”在示例中是一个设计约束。一旦业务需要写入,审批策略、写入顺序和回滚方案都必须重新设计,不能直接沿用本文的配置。
💰 成本优化:长合同反复检索时,缓存命中输入的单价远低于普通输入,把固定的系统指令和 schema 放在请求前部,有助于提高缓存命中率。中小团队也可以通过 API易 apiyi.com 按量调用,逐步扩大核验规模。
工具清单越来越长,但真正决定智能体能否投入生产的,还是那几条朴素的边界:谁执行、谁授权、谁复核。正如陆游在《冬夜读书示子聿》中所写:
纸上得来终觉浅,绝知此事要躬行。
作者:APIYI 技术团队
技术交流:欢迎在 API易 apiyi.com 网站首页联系我们,获取 GPT-6.2 Astra 接入的更多实践资料。