gemini-4-argon 於 2026 年 10 月 13 日發佈,不少開發者接入後第一時間遇到了 429:併發剛上來就報錯,有時單請求也失敗。很多人的第一反應是“AI Studio 的併發上限太低”,但這個判斷多半是錯的。本文會拆解 gemini-4-argon 在 AI Studio 上的真實限流機制,並給出一套可落地的 429 解決方案。
這不是又一篇“加個重試就行”的泛泛教程。我們先澄清一個關鍵事實:Google 目前沒有公開發布 gemini-4-argon 的統一固定併發數,所以網上流傳的“併發 10”“併發 50”都缺乏依據。
核心價值:讀完本文,你將學會區分 RPM、TPM、消費速率與上游容量四類 429 成因,掌握指數退避與限速的工程做法,並瞭解如何通過 API易 apiyi.com 的大併發通道繞開 AI Studio 單項目配額的瓶頸。
gemini-4-argon 核心要點
先用一張表概括全文結論,後面的章節會逐項展開。
| 要點 | 說明 | 價值 |
|---|---|---|
| 沒有公開的固定併發數 | Google 未發佈 gemini-4-argon 統一併發上限,限流以 RPM、TPM、RPD 等指標爲準 | 避免按錯誤數字做容量規劃 |
| RPM 不等於併發 | 在途請求數取決於請求平均耗時,而不只是每分鐘請求數 | 能正確估算自己的併發需求 |
| 限制按項目計算 | 同一項目下創建多個 Key 不會獲得多倍配額 | 不再浪費時間輪換 Key |
| 10 分鐘消費限額 | Tier 1 爲 $10、Tier 2 爲 $50、Tier 3 爲 $200 | 解釋“RPM 沒超卻 429”的現象 |
| 429 需分層處理 | 先看原始響應,再限速、退避、切換渠道、升級配額 | 按優先級逐步解決 |
| API易大併發通道 | API易 apiyi.com 支持 gemini-4-argon 大併發,RPM 500 以下無需操心限流 | 中小規模業務可直接使用 |
爲什麼 429 不一定是併發超限
很多開發者把 429 等同於“併發太高”,但 Google 的限流體系裏併發並不是一個獨立指標。真正觸發 429 RESOURCE_EXHAUSTED 的,可能是每分鐘請求數、每分鐘輸入 Token 數、每日請求數、10 分鐘滾動消費金額,甚至是新模型上線初期上游容量不足。
gemini-4-argon 發佈還不到一週,上游資源尚在爬坡階段,即使你的配額完全夠用,也可能因爲容量緊張被臨時拒絕。所以排查 429 的第一步,永遠是看清楚它到底是哪一類,而不是盲目降低併發。
gemini-4-argon 在 AI Studio 的併發是多少?
直接回答:沒有統一的公開固定值。 在 AI Studio 上,每個項目針對 gemini-4-argon 有各自生效的 RPM、TPM、RPD 配額,具體數字隨 Tier 等級和項目狀態而變,需要在後臺查看。
AI Studio 的五類限制指標
Google 官方採用的限制機制可以歸納爲下表,它們任何一個觸頂都可能返回 429。
| 限制指標 | 含義 | 是否會造成 429 |
|---|---|---|
| RPM | 每分鐘請求數 | 會 |
| TPM | 每分鐘輸入 Token 數 | 會 |
| RPD | 每日請求數 | 會 |
| 消費速率 | 10 分鐘滾動窗口內的 API 消費金額 | 會 |
| 實際服務容量 | Google 上游可用資源 | 可能 |
注意最後一行:容量不足屬於“你無法通過調參解決”的情形,只能靠降低流量、延後重試或切換渠道來緩解。
RPM 與併發的換算關係
RPM 是“一分鐘內的總請求數”,併發是“同一時刻在途的請求數”,兩者靠請求耗時聯繫起來。以一個限制爲 60 RPM 的項目爲例(僅爲計算示例,不代表 Argon 的實際配額):
- 請求平均耗時 5 秒,理論平均在途請求約 5 個。
- 請求平均耗時 30 秒,理論平均在途請求約 30 個。
- 瞬間發出 60 個請求,即便一分鐘總數沒有超額,也可能遭遇短時限流或容量限制。
第三種情況最容易被忽視。很多人的壓測腳本是“一次性併發打出去”,這種尖峯流量比勻速流量更容易觸發限流,哪怕總量完全合規。
如何在後臺查看 gemini-4-argon 的真實配額
打開 Google AI Studio 的 Rate Limits 頁面(路徑爲 aistudio.google.com/usage,切換到 rate-limit 標籤),也可以從官方速率限制文檔 ai.google.dev/gemini-api/docs/rate-limits 進入。選擇對應項目和 gemini-4-argon,就能看到有效的 RPM、TPM、RPD 以及當前 Tier 等級。
Google 明確說明,限制按項目計算,而不是按 API Key 計算。這意味着在同一個項目下創建再多的 Key,也不會獲得多倍配額,靠“多 Key 輪換”來擴容的思路在 AI Studio 上行不通。
gemini-4-argon 429 頻現的 5 類原因
理解了限制指標,再來看實際踩坑的場景。下面五類原因覆蓋了絕大多數 gemini-4-argon 429 報告。
- 瞬時請求速率過高:批量任務或壓測腳本一次性打出大量請求,形成尖峯,超過 RPM 的瞬時承載。
- TPM 觸頂:長上下文、大文檔輸入導致 Token 消耗快,請求數不多卻先撞上 TPM。
- 10 分鐘消費限額觸頂:這是最容易被忽略的一項,下面單獨說明。
- 每日 RPD 用盡:運行一段時間後纔開始 429,往往是日配額耗盡的信號。
- 上游容量不足:新模型上線初期資源緊張,即使配額夠用也可能被拒絕。
容易忽略的原因:10 分鐘消費限額
根據 Google 2026 年 10 月 15 日更新的官方文檔,每個賬戶層級都有 10 分鐘滾動窗口內的消費上限。
| 賬戶層級 | 每 10 分鐘消費限額 |
|---|---|
| Tier 1 | $10 |
| Tier 2 | $50 |
| Tier 3 | $200 |
舉個例子:一個 Tier 1 賬號在 10 分鐘內累計消耗達到 $10,即使 RPM 和 TPM 都沒超,也可能返回 429 RESOURCE_EXHAUSTED。gemini-4-argon 作爲新一代模型,單次調用成本可能高於舊模型,長上下文請求更容易讓消費曲線陡升,這正是“請求量不大卻被限流”的常見原因。
另外需要提醒,Google 文檔中列出的 Argon Batch API 配額,是批處理隊列的 Token 配額,不能當成實時 API 的併發配額來用。
如何判斷 gemini-4-argon 的 429 出在哪裏?
不同現象對應不同的根因,對症排查比盲目調參高效得多。
| 現象 | 優先排查方向 | 處理思路 |
|---|---|---|
| 併發一上來就頻繁 429 | 瞬時請求速率、RPM、上游容量 | 做均勻發請求的階梯壓測,固定併發不代表固定 RPM |
| 運行一段時間後開始 429 | 10 分鐘消費限額、RPD、TPM 累積 | 查看消費曲線和日配額使用量 |
| 單請求或極低併發也出現 429 | 上游容量不足、賬戶或項目被限 | 查看原始響應,考慮切換渠道 |
| 多個 Key 同時出現 429 | 多個 Key 屬於同一項目,共享配額 | 降低項目總流量,或使用獨立配額的渠道 |
排查時有兩份信息最關鍵:一是你的 AI Studio 賬號處於 Tier 1、2 還是 3;二是 429 的原始錯誤內容,尤其是 error.message、error.details 和響應頭裏的 Retry-After。這兩項信息基本就能區分出是賬戶配額太低、請求流量過大,還是 Google Argon 新模型本身供給不足,三種情況的解法完全不同。
解決 gemini-4-argon 429 的 6 步方案
下面按實際處理優先級給出措施,P0 是必須先做的,P2 屬於長期規劃。
| 優先級 | 解決措施 | 作用 |
|---|---|---|
| P0 | 查看 429 原始響應和 Retry-After |
判斷具體限流原因 |
| P0 | 按項目配置 RPM、TPM 和消費速率限流 | 避免持續觸發配額 |
| P0 | 429 指數退避重試,增加隨機抖動 | 緩解突發限流 |
| P1 | 429 時自動切換獨立配額的健康渠道 | 提高成功率 |
| P1 | 升級 Tier 或向 Google 申請提額 | 增加長期容量 |
| P2 | 評估 Vertex AI 或其他正式授權渠道 | 擴大資源供給 |
第一步:讀懂 429 的原始響應
不要只看到狀態碼就重試。先打印完整的錯誤體和響應頭,重點看 error.message、error.details 與 Retry-After。如果上游已經告訴你需要等待多久,就應該優先遵循這個時間,而不是自己拍腦袋設一個間隔。
第二步:在客戶端主動限速
把 RPM 控制在後臺可見限額的 70% 到 80%,TPM 單獨管理,並額外監控 10 分鐘消費金額。留出餘量的目的,是給尖峯流量和上游波動一個緩衝帶。很多團隊的限流只管請求數,忽略了 Token 和金額,結果總在“明明沒超 RPM”的情況下被拒。
第三步:指數退避加隨機抖動
Google 官方建議對 429 使用指數退避,例如等待 1、2、4、8 秒,並加入隨機抖動,避免大量請求在同一時刻集體重試,造成二次擁堵。最多重試 2 到 3 次,且優先遵循上游返回的重試時間。
第四步:持續 429 時切換渠道
如果同一個項目持續返回 429,就不要繼續向它重試,這隻會加劇限流。正確的做法是降低流量,或者切換到配額獨立的健康渠道。聚合服務的價值正在於此:通過 API易 apiyi.com 調用,請求可以分散到多個獨立配額的渠道上,不必讓單個 AI Studio 項目承擔全部壓力。
第五步:升級 Tier 或申請提額
長期來看,容量不足最終要靠升級賬戶層級或向 Google 申請提額解決。Tier 提升後,不僅 RPM、TPM 會放寬,10 分鐘消費限額也會從 $10 提升到 $50 乃至 $200。不過提額需要時間和消費記錄,通常趕不上業務上線的節奏。
第六步:評估其他正式授權渠道
如果業務規模持續增長,可以評估 Vertex AI 或其他正式授權渠道,擴大資源供給。多渠道並行也是降低單點風險的穩妥做法。
新渠道接入的壓測建議
對於新接入 Argon 的渠道,建議先把併發設置爲 5 到 10 做壓測。請注意,這只是起步測試參數,不是官方併發上限。之後按階梯逐級加量,每一級都均勻發送請求,同時按供應商、Google 項目、模型分別統計 429 率、實際 RPM、TPM、10 分鐘消耗和請求耗時,確認穩定後再進入下一級。
gemini-4-argon 快速上手:通過 API易 調用
理論說完,來看代碼。API易 提供 OpenAI 兼容接口,只需替換 base_url 即可調用 gemini-4-argon。
極簡示例
以下 10 餘行代碼即可跑通一次調用:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 API易 統一接口
)

response = client.chat.completions.create(
    model="gemini-4-argon",
    messages=[{"role": "user", "content": "用一句話解釋什麼是 429 限流"}]
)
print(response.choices[0].message.content)
查看完整代碼:帶指數退避、隨機抖動與 Retry-After 的併發調用
import random
import time
from concurrent.futures import ThreadPoolExecutor

import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 API易 統一接口
)

MAX_RETRIES = 3       # 最多重試 2-3 次
BASE_DELAY = 1.0      # 指數退避起點:1、2、4、8 秒


def call_argon(prompt: str) -> str:
    """調用 gemini-4-argon,429 時指數退避並優先遵循 Retry-After"""
    for attempt in range(MAX_RETRIES + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-argon",
                messages=[{"role": "user", "content": prompt}],
                max_tokens=512,
            )
            return resp.choices[0].message.content
        except openai.RateLimitError as e:
            if attempt == MAX_RETRIES:
                return f"Error after retries: {e}"
            # 優先使用上游返回的 Retry-After
            retry_after = None
            try:
                retry_after = float(e.response.headers.get("Retry-After"))
            except (AttributeError, TypeError, ValueError):
                pass
            delay = retry_after if retry_after else BASE_DELAY * (2 ** attempt)
            delay += random.uniform(0, 0.5)  # 隨機抖動,避免集體重試
            print(f"429,第 {attempt + 1} 次重試,等待 {delay:.1f}s")
            time.sleep(delay)
        except Exception as e:
            return f"Error: {e}"


if __name__ == "__main__":
    prompts = [f"請用一句話介紹第 {i} 種限流策略" for i in range(10)]
    # 併發度從 5 起步壓測,不是官方上限
    with ThreadPoolExecutor(max_workers=5) as pool:
        for result in pool.map(call_argon, prompts):
            print(result)
快速開始:推薦通過 API易 apiyi.com 註冊並獲取 API Key,用上面的代碼直接驗證 gemini-4-argon 的調用效果。平臺提供統一的 OpenAI 兼容接口,無需自己申請和維護多個 Google 項目。
客戶端限速的簡單實現
除了重試,更重要的是“少撞牆”。下面是一個基於令牌桶思路的最小限速器,可以把請求節奏壓平,避免尖峯:
import threading
import time


class RateLimiter:
    """按目標 RPM 勻速放行請求,避免瞬時尖峯"""

    def __init__(self, rpm: int):
        self.interval = 60.0 / rpm
        self.lock = threading.Lock()
        self.next_time = time.monotonic()

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
            self.next_time = max(now, self.next_time) + self.interval


limiter = RateLimiter(rpm=300)  # 按後臺限額的 70%-80% 設置

# 在每次調用前執行:
# limiter.wait()
把限速器放在調用函數入口,再配合前面的退避重試,就形成了“主動限速加被動退避”的雙層保護。
API易 的 gemini-4-argon 大併發通道
直連 AI Studio 的瓶頸,在於單個項目的配額是固定的,Tier 1 賬號還要面對 $10 的 10 分鐘消費上限。而聚合服務可以把流量分散到多個獨立配額的渠道,並在某個渠道出現持續 429 時自動切換到健康渠道。
API易 apiyi.com 目前支持大併發的 gemini-4-argon,RPM 500 以下可以無視限流問題,歡迎直接使用。 對於絕大多數中小規模的應用、內部工具、自動化工作流和測試壓測來說,這個區間已經足夠覆蓋日常需求,你不必再爲 Tier 等級、項目配額和 10 分鐘消費窗口分心。
| 對比維度 | 直連 AI Studio | 通過 API易 調用 |
|---|---|---|
| 配額歸屬 | 單個項目,多 Key 共享 | 多渠道獨立配額,由平臺調度 |
| 429 處理 | 自行實現退避、切換 | 平臺側優先切換健康渠道,客戶端保留基礎重試即可 |
| 消費限額約束 | 受 Tier 的 10 分鐘消費上限限制 | 無需自行管理 Google 賬戶層級 |
| 接入方式 | 需申請項目、配置 Tier | 統一 OpenAI 兼容接口,替換 base_url |
| 適用規模 | 低流量或已升級高 Tier | RPM 500 以下無需操心限流 |
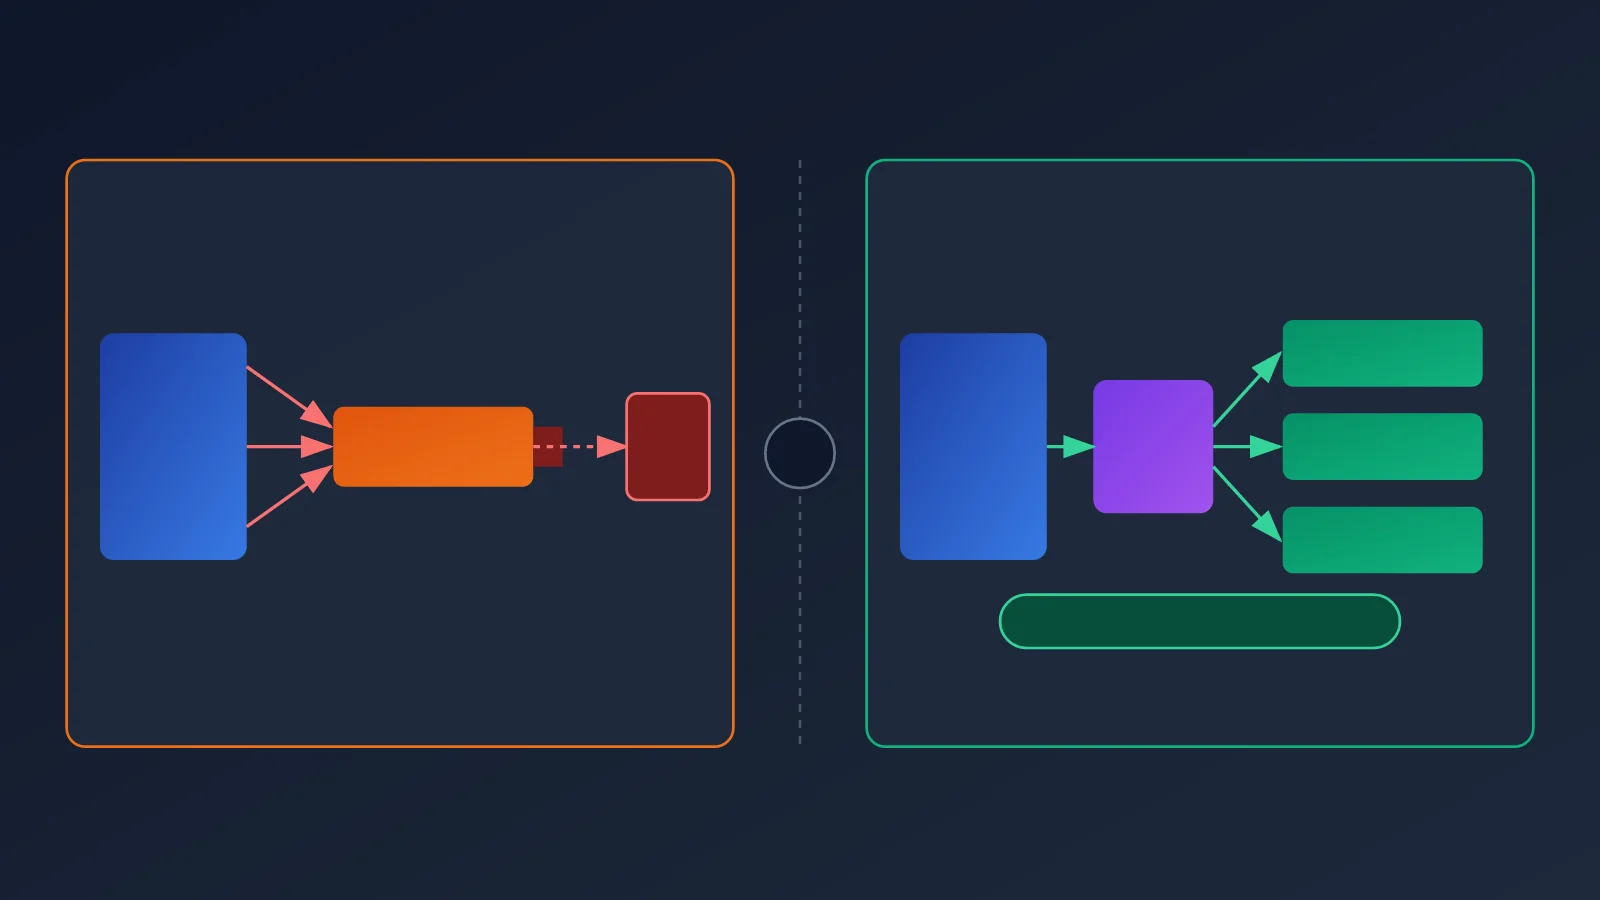
🎯 技術建議:如果你的業務峯值在 RPM 500 以內,可以直接通過 API易 apiyi.com 調用 gemini-4-argon,把精力放在業務邏輯上。若預期流量超出這個區間,建議先按階梯壓測,並提前與平臺溝通容量安排。
即使使用大併發通道,保留客戶端的指數退避和合理的超時設置依然是好習慣。網絡抖動、上游短暫波動都可能出現,良好的重試邏輯能讓你的服務在極端情況下依然平穩。
常見問題 FAQ
Q1: gemini-4-argon 在 AI Studio 上的併發到底是多少?
Google 沒有公開統一的固定併發數。實際限制由項目的 RPM、TPM、RPD 以及 10 分鐘消費限額共同決定,需要在 AI Studio 的 Rate Limits 頁面選擇對應項目和模型查看。網上流傳的具體併發數字沒有官方依據,不建議作爲容量規劃的參考。
Q2: 多創建幾個 API Key 能提高 gemini-4-argon 的配額嗎?
不能。Google 明確說明限制按項目計算,不是按 API Key 計算,同一項目下的多個 Key 共享同一份配額。想要真正的獨立配額,需要不同的 Google 項目,或者使用像 API易 apiyi.com 這樣的多渠道聚合服務。
Q3: 爲什麼 RPM 和 TPM 都沒超,還是返回 429?
最常見的原因是觸及了 10 分鐘消費限額:Tier 1 爲 $10,Tier 2 爲 $50,Tier 3 爲 $200。另外,新模型上線初期上游容量不足,也會導致配額內的請求被拒絕。建議同時查看原始錯誤體裏的 `error.details` 來確認。
Q4: 429 時應該怎麼重試才合理?
採用指數退避,例如 1、2、4、8 秒,並加入隨機抖動,最多重試 2 到 3 次,同時優先遵循響應頭中的 `Retry-After`。如果同一項目持續 429,應降低流量或切換到獨立配額的渠道,而不是繼續重試。
Q5: 如何通過 API易 快速調用 gemini-4-argon?
1. 訪問 API易 apiyi.com 註冊賬號並獲取 API Key。
2. 將代碼中的 `base_url` 設置爲 `https://api.apiyi.com/v1`。
3. 把模型名設爲 `gemini-4-argon`,即可運行本文的示例代碼。
API易 支持 gemini-4-argon 大併發調用,RPM 500 以下無需操心限流,適合快速驗證和中小規模上線。
Q6: 使用 API易 之後還會遇到 429 嗎?
在 RPM 500 以下的正常使用範圍內,限流問題基本無需關心。但任何上游服務都可能出現短暫波動,所以仍建議保留基礎的指數退避重試。如果你的業務流量會超過這個區間,建議先做階梯壓測,並通過 API易 apiyi.com 與平臺確認容量。
Q7: Batch API 的配額能當作實時併發配額參考嗎?
不能。Google 文檔列出的 Argon Batch API 配額是批處理隊列的 Token 配額,用於離線批量任務,和實時 API 的併發、RPM 限制是兩套體系,不能互相套用。
gemini-4-argon 429 核心要點 Key Takeaways
- 沒有固定併發數:Google 未公佈 gemini-4-argon 統一併發上限,以後臺實際配額爲準。
- RPM 不等於併發:併發取決於請求耗時,尖峯流量比勻速流量更易觸發限流。
- 限制按項目計算:多 Key 不能擴容,配額由同一項目共享。
- 警惕 10 分鐘消費限額:Tier 1 到 Tier 3 分別爲 $10、$50、$200,RPM 沒超也可能 429。
- 退避加限速加切換:指數退避配合隨機抖動,持續 429 時切換獨立配額渠道。
- 大併發更省心:API易 apiyi.com 支持 gemini-4-argon 大併發,RPM 500 以下無需操心限流。
總結
gemini-4-argon 在 AI Studio 上頻繁出現 429,核心原因並不是“併發太低”,而是 RPM、TPM、RPD、10 分鐘消費速率和新模型上游容量幾類限制疊加的結果。解決思路也應該分層:先讀懂原始響應,再主動限速,配合指數退避與隨機抖動,持續 429 時切換渠道,長期則通過升級 Tier 或拓展授權渠道來擴容。
對於希望少折騰配額的開發者,更務實的選擇是藉助聚合通道。推薦通過 API易 apiyi.com 快速驗證效果,平臺支持 gemini-4-argon 大併發調用,RPM 500 以下可以放心使用,歡迎上手測試。
參考資料
- Google AI Studio 用量與速率限制頁面: 查看項目級 RPM、TPM、RPD 與 Tier 等級
- 鏈接:
aistudio.google.com/usage -
說明: 選擇項目和 gemini-4-argon 即可查看真實配額
-
Gemini API 速率限制文檔: 官方限流機制與 429 處理建議
- 鏈接:
ai.google.dev/gemini-api/docs/rate-limits - 說明: 包含 10 分鐘消費限額與指數退避建議
作者: APIYI Team
技術交流: 歡迎在評論區討論 gemini-4-argon 的 429 排查經驗,更多接入資料可訪問 API易 docs.apiyi.com 文檔中心