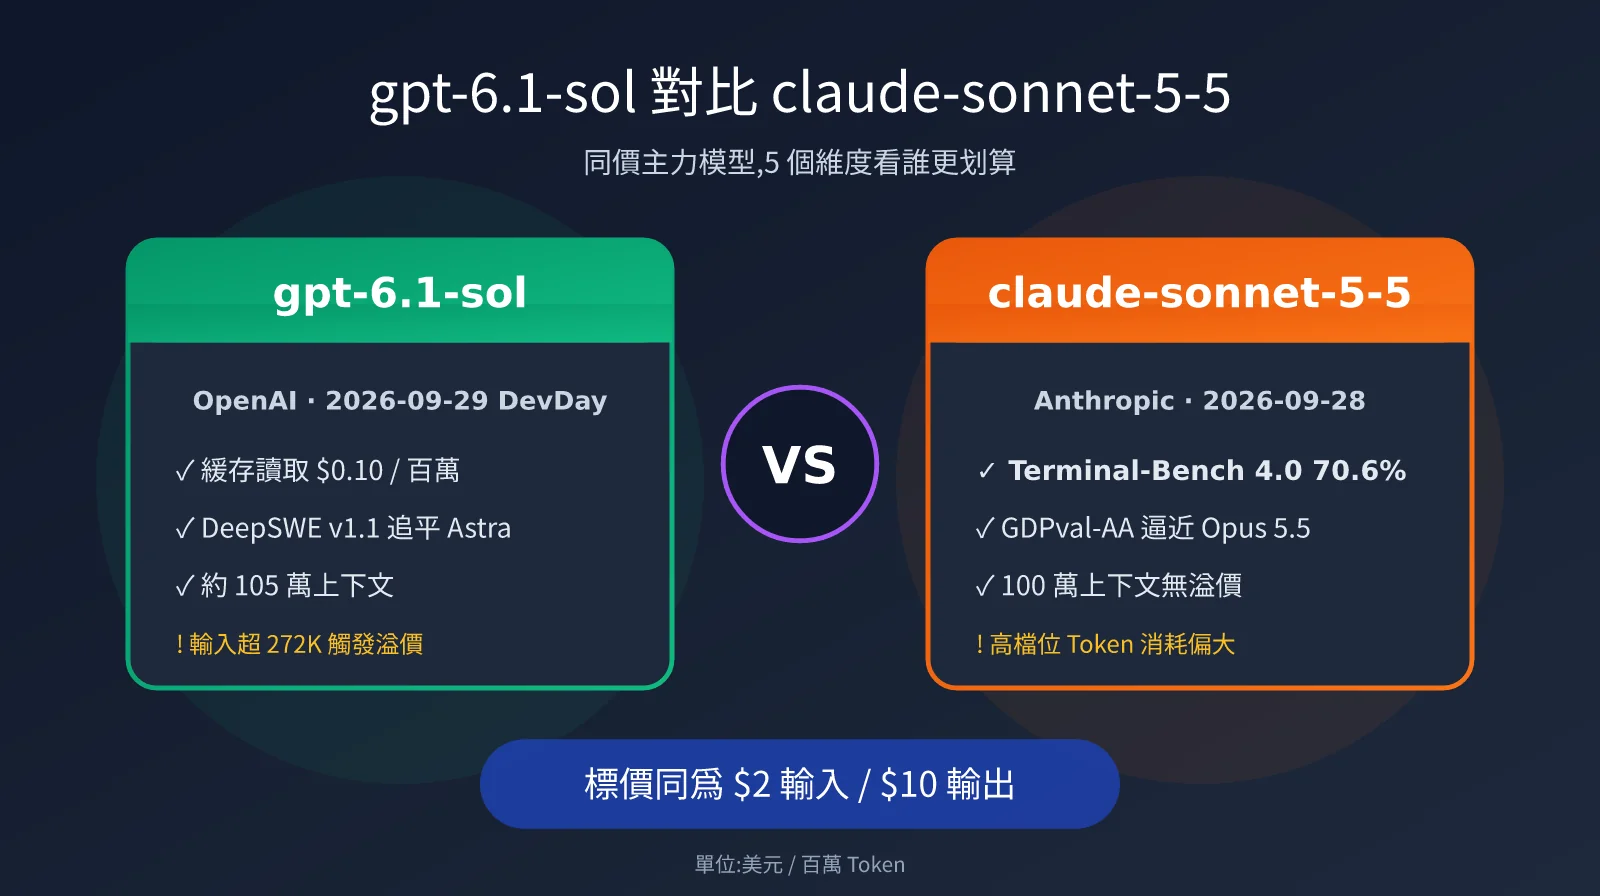
9 月 28 日 Anthropic 發佈 claude-sonnet-5-5,第二天 OpenAI 在 DevDay 上推出 gpt-6.1-sol。兩家的新一代主力模型前後腳上線,而且標價一模一樣:輸入 $2、輸出 $10(每百萬 Token)。很多開發者的第一反應是“都便宜了,隨便選一個”,但真正上生產之後,兩者在單任務成本、長上下文計費和智能體表現上的差距,遠比標價表顯示的要大。本文將從 5 個維度拆解 gpt-6.1-sol 對比 claude-sonnet-5-5 的真實差異,幫你擺脫品牌偏好和賬號可達性的干擾,按場景做出理性選擇。
核心價值: 看完本文,你將清楚在編程智能體、辦公文檔、長上下文檢索和高併發批處理等場景下,gpt-6.1-sol 和 claude-sonnet-5-5 分別該怎麼選、怎麼配。
gpt-6.1-sol 與 claude-sonnet-5-5 核心參數速覽
先澄清一個常見誤解:嚴格來說,這兩款模型的標價都沒有下調。claude-sonnet-5-5 延續了 Sonnet 5 的 $2/$10 定價,gpt-6.1-sol 也與上一代 gpt-6-sol 標價相同。所謂“降價”,體現在兩個層面:一是旗艦級能力被下放到了主力價位,gpt-6.1-sol 只有 gpt-6-astra 五分之一的價格,claude-sonnet-5-5 只有 Opus 5.5 一半的價格;二是隱性成本在下降,gpt-6.1-sol 的緩存輸入從 $0.20 砍半到 $0.10,claude-sonnet-5-5 則通過減少工具調用次數,讓單任務成本最多下降約 30%。
| 參數 | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|
| 發佈時間 | 2026-09-29(DevDay) | 2026-09-28 |
| 模型 ID | gpt-6.1-sol |
claude-sonnet-5-5 |
| 上下文窗口 | 約 105 萬 Token | 100 萬 Token |
| 最大輸出 | 128K | 128K(Batch 測試版可達 300K) |
| 推理檔位 | low / medium(默認)/ high / xhigh / max | low / medium / high(API 默認)/ xhigh / max |
| 思考模式 | 可按檔位調節 | 自適應思考,無法關閉 |
| 同門旗艦 | gpt-6-astra($10/$50) | Claude Opus 5.5($4/$20) |
| 可用平臺 | API易 apiyi.com、OpenAI 官方 API | API易 apiyi.com、Anthropic 官方 API |
從參數表能看出一個關鍵差異:兩者的默認推理檔位不同。gpt-6.1-sol 默認 medium,claude-sonnet-5-5 的 API 默認是 high。如果你直接用默認參數做對比,等於讓 Sonnet 多“想”了一檔,Token 消耗和延遲自然不在同一起跑線上。公平對比時,建議兩邊都顯式指定 reasoning_effort。
🎯 測試建議: 對比兩款模型時,務必固定相同的推理檔位和提示詞。我們建議通過 API易 apiyi.com 用同一個 API Key 同時調用 gpt-6.1-sol 和 claude-sonnet-5-5,只改
model參數即可完成 A/B 測試,避免因爲賬號、網絡差異引入干擾變量。
gpt-6.1-sol 對比 claude-sonnet-5-5 的 5 大核心差異
差異一:編程智能體,claude-sonnet-5-5 領先終端類任務
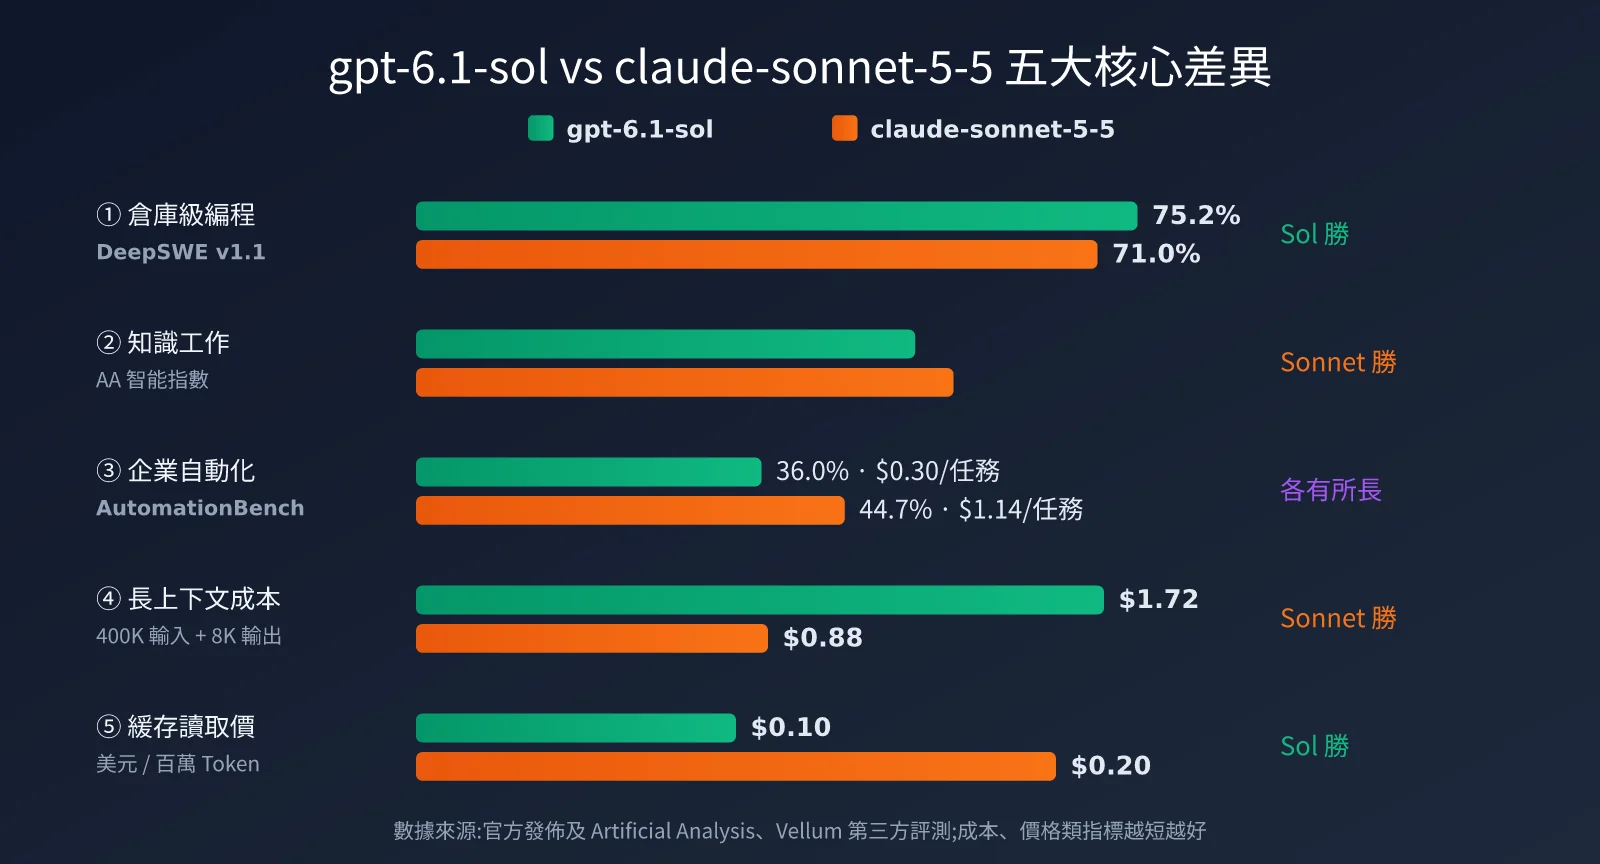
編程是兩款模型競爭最激烈的領域,但各家公佈的基準不完全重疊,需要分開看。claude-sonnet-5-5 在 Terminal-Bench 4.0 上官方成績爲 70.6%,比 Sonnet 5 的 10.3% 提升巨大,甚至超過了 Opus 5.5 的 66.4%;Artificial Analysis 的獨立複測給出 64%,同樣高於 Opus 5.5 和 gpt-6-astra 的 60%。它在 SWE-Bench Pro 上拿到 81.3%,CursorBench 4.0 爲 55.5%,僅次於 Opus 5.5。
gpt-6.1-sol 這邊,OpenAI 主打的是 DeepSWE v1.1:gpt-6.1-sol 得分 75.2%,略高於 gpt-6-astra 的 74.8%,而每個任務成本只有約 $1.50,不到 Astra 的五分之一。第三方彙總中 claude-sonnet-5-5 在該基準上爲 71.0%。換句話說,在終端驅動的智能體編程上 claude-sonnet-5-5 證據更強,在倉庫級軟件工程任務上 gpt-6.1-sol 性價比更突出。
差異二:知識工作,claude-sonnet-5-5 逼近 Opus
在辦公類知識工作上,claude-sonnet-5-5 的表現非常亮眼。GDPval-AA v2.1 得分 1844,與 Opus 5.5 的 1846 幾乎打平;AA-Briefcase 爲 1811,同樣緊貼 Opus。Artificial Analysis 智能指數中,claude-sonnet-5-5 以 56 分排名第二,僅比 Opus 5.5 低 2 分,gpt-6.1-sol(max)爲 52 分。
gpt-6.1-sol 則在文檔分析上有自己的優勢。在 GDP.pdf 基準上它得到 32.0%,幾乎追平 gpt-6-astra 的 32.2%,並超過 Opus 5.5 的 28.8%,單任務成本約 $0.38。在企業流程自動化 AutomationBench 上,claude-sonnet-5-5 以 44.7% 領先 gpt-6.1-sol 的 36.0%,但前者單任務成本約 $1.14,後者只要 $0.30。
差異三:電腦操作,兩者都進入實用區間
電腦操作(Computer Use)方面,gpt-6.1-sol 在 OSWorld 2.0 上拿到 71.4%,距 gpt-6-astra 的 73.5% 只差 2.1 個點,單任務約 $1.30。claude-sonnet-5-5 在 OSWorld 2.1 上爲 80.1%,接近 Opus 5.5 的 81.8%。需要注意的是兩個版本的 OSWorld 測試集不同,分數不能直接橫比,但可以確定兩者都已經具備穩定操作桌面應用的能力。
差異四:長上下文計費,gpt-6.1-sol 有隱藏門檻
這是最容易被忽略、也最影響賬單的一點。gpt-6.1-sol 雖然支持約 105 萬 Token 上下文,但單次請求輸入超過 272K Token 後,整個請求的輸入和緩存按 2 倍計費、輸出按 1.5 倍計費。claude-sonnet-5-5 的 100 萬上下文則沒有長上下文溢價,全程按標準價格收費。如果你的業務經常把整本手冊、整個代碼倉庫塞進上下文,這一條差異足以改變選型結論。
差異五:Token 效率與緩存,gpt-6.1-sol 更省
gpt-6.1-sol 的緩存讀取價格爲 $0.10,是 claude-sonnet-5-5($0.20)的一半,在智能體循環這類前綴高度重複的場景中優勢明顯。另一方面,claude-sonnet-5-5 在高推理檔位下 Token 消耗偏大:Artificial Analysis 測得其 max 檔位每個任務約輸出 19.3 萬 Token,是目前測到的最高值;獨立測試也發現,API 默認的 high 檔位比 medium 多消耗近一倍輸出 Token,質量卻沒有明顯提升。
| 基準 / 指標 | gpt-6.1-sol | claude-sonnet-5-5 | 勝出 |
|---|---|---|---|
| Terminal-Bench 4.0(官方) | 未公佈 | 70.6% | claude-sonnet-5-5 |
| DeepSWE v1.1 | 75.2% | 71.0% | gpt-6.1-sol |
| GDPval-AA v2.1 | 未公佈(上代 gpt-6-sol 爲 1487) | 1844 | claude-sonnet-5-5 |
| GDP.pdf 文檔分析 | 32.0% | 未公佈 | gpt-6.1-sol |
| AutomationBench | 36.0%(約 $0.30/任務) | 44.7%(約 $1.14/任務) | 質量看 Sonnet,成本看 Sol |
| AA 智能指數 | 52 | 56 | claude-sonnet-5-5 |
| 緩存讀取價格 | $0.10 / 百萬 | $0.20 / 百萬 | gpt-6.1-sol |
💡 數據說明: 以上基準來自 OpenAI、Anthropic 官方公佈以及 Artificial Analysis、Vellum 等第三方評測,不同機構的測試版本和推理檔位不同。我們建議以自己的真實業務樣本跑一輪對照測試,比任何榜單都更有參考價值。
gpt-6.1-sol 與 claude-sonnet-5-5 的真實成本對比
標價相同不代表賬單相同。下面用三種典型負載估算單次請求成本(不含緩存寫入,按官方標價計算),可以直觀看到差異來自哪裏。
| 負載場景 | 請求構成 | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|---|
| 智能體循環(高緩存) | 100K 輸入(90% 命中緩存)+ 5K 輸出 | 約 $0.079 | 約 $0.088 |
| 常規對話 | 5K 輸入 + 1K 輸出 | 約 $0.020 | 約 $0.020 |
| 超長上下文檢索 | 400K 輸入(無緩存)+ 8K 輸出 | 約 $1.72(觸發溢價) | 約 $0.88 |
| 批處理(Batch) | 標價 5 折 | $1 / $5 | $1 / $5 |
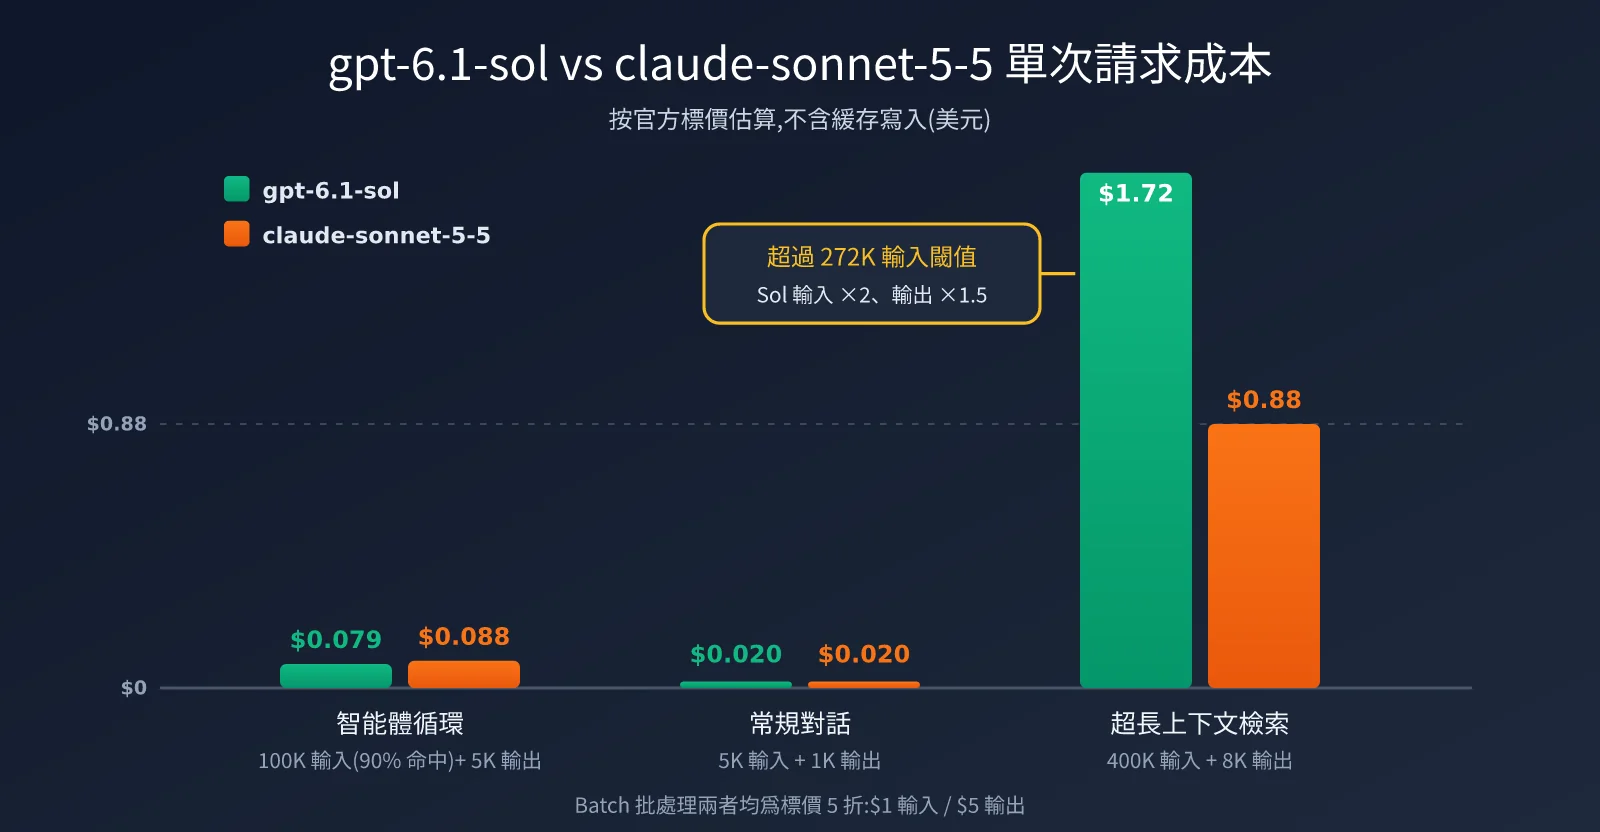
結論很清晰:在前綴重複度高的智能體循環裏,gpt-6.1-sol 靠更便宜的緩存讀取勝出約 10%;在常規對話中兩者幾乎一樣;一旦單次輸入超過 272K,claude-sonnet-5-5 的成本只有 gpt-6.1-sol 的一半左右。另外還要疊加 Token 效率因素,如果 claude-sonnet-5-5 跑在 high 或 max 檔位,實際輸出 Token 可能翻倍,抵消掉它在長上下文上的優勢,所以控制推理檔位是用好 Sonnet 的關鍵。
用同一套代碼快速對比兩款模型
通過 OpenAI 兼容接口,只需切換 model 參數就能在兩款模型之間橫向測試。下面是極簡示例:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口,兩款模型共用一個 Key
)

for model in ["gpt-6.1-sol", "claude-sonnet-5-5"]:
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort="medium",  # 固定相同檔位,保證公平對比
        messages=[{"role": "user", "content": "爲這個函數補充單元測試:def add(a, b): return a + b"}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content[:200])
展開查看:帶耗時與成本統計的完整對比腳本
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口
)

# 每百萬 Token 價格:輸入、緩存讀取、輸出
PRICES = {
    "gpt-6.1-sol": (2.0, 0.10, 10.0),
    "claude-sonnet-5-5": (2.0, 0.20, 10.0),
}

def run(model: str, prompt: str, effort: str = "medium"):
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}],
    )
    elapsed = time.time() - start
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p_in, p_cache, p_out = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p_in + cached * p_cache
            + u.completion_tokens * p_out) / 1_000_000
    return elapsed, u.prompt_tokens, u.completion_tokens, cost

tasks = [
    "用 Python 實現一個帶過期時間的 LRU 緩存,並寫出測試",
    "閱讀以下需求,輸出數據庫表結構設計與索引建議:訂單、用戶、優惠券",
]

for task in tasks:
    for model in PRICES:
        t, i, o, c = run(model, task)
        print(f"{model:<20} {t:>6.1f}s  in={i:<6} out={o:<6} ${c:.4f}")
🚀 快速上手: 如果你還沒有 Anthropic 賬號,或者被海外支付、手機號驗證卡住,可以直接在 API易 apiyi.com 註冊獲取測試額度,一個 Key 即可調用 gpt-6.1-sol 與 claude-sonnet-5-5,省去分別開通兩家官方賬號的麻煩。
gpt-6.1-sol 和 claude-sonnet-5-5 的場景推薦
不同業務對質量、成本、延遲的權重不同,下面按常見場景給出推薦。
| 業務場景 | 推薦模型 | 核心理由 |
|---|---|---|
| 終端驅動的編程智能體(Claude Code 類) | claude-sonnet-5-5 | Terminal-Bench 4.0 領先,工具調用次數更少 |
| 倉庫級代碼修復、Codex 工作流 | gpt-6.1-sol | DeepSWE 追平 Astra,單任務成本約 $1.50 |
| 超長文檔 / 整倉代碼分析(>272K) | claude-sonnet-5-5 | 無長上下文溢價,成本約爲 Sol 的一半 |
| 高併發客服、RAG 問答(高緩存) | gpt-6.1-sol | 緩存讀取 $0.10,前綴複用越多越省 |
| 報告撰寫、表格與辦公知識工作 | claude-sonnet-5-5 | GDPval-AA 與 Opus 5.5 幾乎打平 |
| PDF 文檔解析、信息抽取 | gpt-6.1-sol | GDP.pdf 追平 Astra,單任務約 $0.38 |
| 安全研究、滲透測試輔助 | gpt-6.1-sol | Sonnet 5.5 內置網絡安全防護,拒答率上升 |
選擇 gpt-6.1-sol 的典型場景
gpt-6.1-sol 最適合對成本敏感、請求量大、前綴重複度高的業務。例如智能客服、知識庫問答、批量數據清洗等,系統提示詞和檢索上下文高度複用,$0.10 的緩存讀取價格能持續放大優勢。它的幻覺率也有明顯改善,低推理檔位下事實錯誤率從上一代的 11.4% 降到 7.7%,適合用 low 或 medium 檔位跑大批量的輕任務。此外,OpenAI 即將爲 gpt-6.1-sol 推出 Ultrafast 檔位,生成速度最高約 300 Token/秒,價格爲標準檔的 6 倍,對實時交互類產品是一個可選項。
選擇 claude-sonnet-5-5 的典型場景
claude-sonnet-5-5 更適合任務複雜、上下文超長、對一次成功率要求高的業務。它在智能體任務中通常只需約 3 次工具調用就能完成 Sonnet 5 需要 12-13 次的工作,輸出速度也比上一代快 30% 以上。對於需要把大量材料一次性放進上下文的法務審閱、代碼庫遷移、長報告寫作,它的無溢價 100 萬上下文非常友好。
需要提醒的是,claude-sonnet-5-5 相對 Sonnet 5 有幾處接口破壞性變更:思考模式無法關閉,強制指定工具的 tool_choice: "tool" 已被移除。如果你的舊代碼依賴這些行爲,遷移前務必迴歸測試。
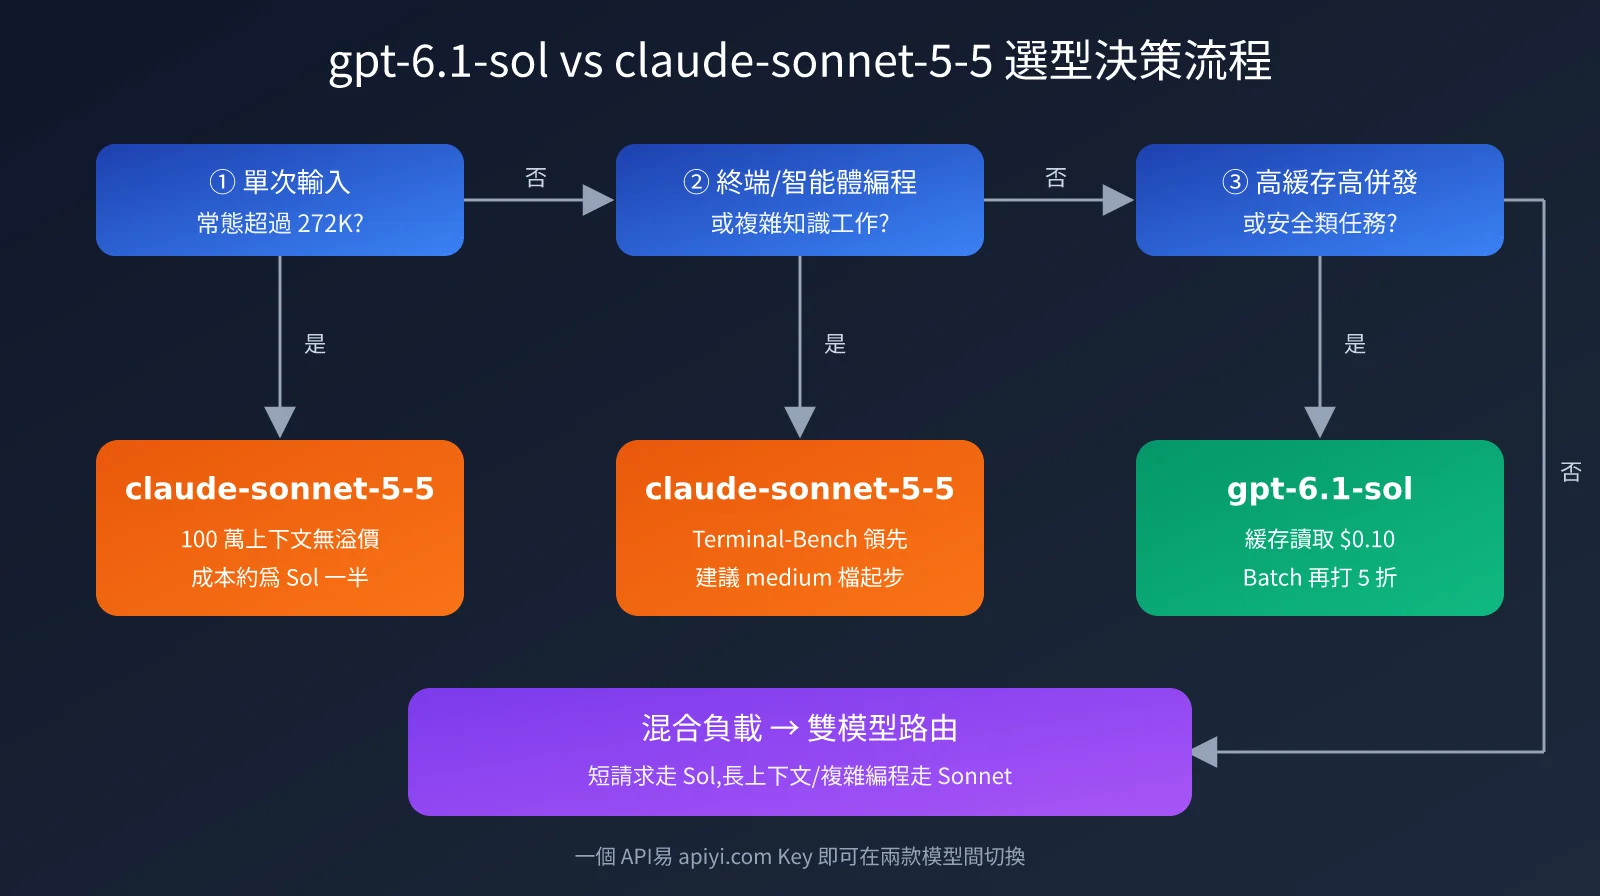
🎯 架構建議: 兩款模型並非只能二選一。我們建議通過 API易 apiyi.com 搭建簡單的模型路由,短請求和高緩存流量走 gpt-6.1-sol,超長上下文和複雜編程任務走 claude-sonnet-5-5,在同一套 OpenAI 兼容接口下即可按需切換。
gpt-6.1-sol 對比 claude-sonnet-5-5 的決策建議
把前面的分析濃縮成一套可執行的決策步驟:
- 先看輸入長度:如果常態請求超過 272K Token,優先 claude-sonnet-5-5,否則進入下一步。
- 再看任務類型:終端/智能體編程、複雜知識工作偏向 claude-sonnet-5-5;倉庫級代碼修復、PDF 解析偏向 gpt-6.1-sol。
- 然後看流量結構:緩存命中率高、併發大的業務,gpt-6.1-sol 的成本優勢會隨規模放大。
- 最後壓推理檔位:無論選哪個,都從 medium 起步測試。claude-sonnet-5-5 尤其要避免直接使用 API 默認的 high,否則 Token 消耗可能翻倍。
| 你的優先級 | 首選 | 備選策略 |
|---|---|---|
| 質量優先,預算充足 | claude-sonnet-5-5(medium/high) | 疑難任務再升級到 Opus 5.5 |
| 成本優先,流量巨大 | gpt-6.1-sol(low/medium) | 非實時任務走 Batch 5 折 |
| 速度優先,實時交互 | gpt-6.1-sol(Ultrafast 上線後) | claude-sonnet-5-5 low 檔 |
| 穩定優先,避免單點 | 雙模型路由 | 一方限流時自動切換另一方 |
至於品牌偏好和可達性,它們不應該成爲技術選型的決定因素。Claude 的官方賬號對地區、支付方式要求更嚴格,這確實提高了使用門檻,但這是接入層的問題,而不是模型能力的問題。把接入層交給統一的 API 平臺處理後,你就可以完全按照任務表現和成本來選型。
常見問題
Q1:gpt-6.1-sol 和 claude-sonnet-5-5 真的都降價了嗎?
標價層面都沒有變化,兩者都維持 $2/$10。真正的“降價”在於:gpt-6.1-sol 用五分之一的價格提供了接近 gpt-6-astra 的能力,緩存讀取也從 $0.20 降到 $0.10;claude-sonnet-5-5 用 Opus 一半的價格提供了接近 Opus 5.5 的能力,並通過更少的工具調用把單任務成本最多降低約 30%。因此比較兩者時,應該看單任務總成本而不是單價。
Q2:沒有 Anthropic 賬號,怎麼調用 claude-sonnet-5-5?
Anthropic 官方賬號對註冊地區、手機號和支付方式都有要求,個人開發者和國內團隊經常卡在這一步。一個簡單的做法是通過 API易 apiyi.com 調用,平臺提供 OpenAI 兼容接口,把 base_url 改爲 https://api.apiyi.com/v1、model 設爲 claude-sonnet-5-5 即可,無需改動其他業務代碼。
Q3:gpt-6.1-sol 的 105 萬上下文可以放心用滿嗎?
可以用,但要注意計費。單次輸入超過 272K Token 時,整個請求的輸入和緩存價格翻倍,輸出價格爲 1.5 倍。如果業務確實需要超長上下文,建議先做檢索壓縮,或者把這部分請求路由到沒有長上下文溢價的 claude-sonnet-5-5。
Q4:claude-sonnet-5-5 爲什麼有時比預期更貴?
主要原因是推理檔位。它的 API 默認檔位是 high,思考模式又無法關閉,在簡單任務上容易產生大量不必要的思考 Token。獨立測試顯示 medium 檔位的 Token 消耗與 Sonnet 5 持平但效果更好,因此日常任務建議顯式設置爲 medium。
Q5:編程場景到底選哪個?
如果你主要用終端類智能體(如 Claude Code)做多步驟開發,claude-sonnet-5-5 的 Terminal-Bench 成績更有說服力;如果主要做倉庫級缺陷修復、在 Codex 工作流中使用,gpt-6.1-sol 以更低的單任務成本追平了 gpt-6-astra。團隊條件允許的話,兩者都接入並按任務類型分流是最穩妥的方案。
總結
gpt-6.1-sol 對比 claude-sonnet-5-5,並沒有絕對的贏家。claude-sonnet-5-5 在智能體編程、知識工作和智能指數上更強,且 100 萬上下文無溢價;gpt-6.1-sol 則在緩存價格、倉庫級代碼修復、文檔解析和單任務成本上更有優勢,適合大規模、高複用的生產流量。兩者標價相同,真正拉開賬單差距的是輸入長度、緩存命中率和推理檔位這三個變量。
實操上可以分三步走:先用本文的決策流程確定主力模型;再用對比腳本在真實任務上跑一輪 A/B 測試,固定相同的推理檔位;最後按任務類型搭建雙模型路由,讓每一類請求都落在性價比最高的模型上。
如果你希望跳過 Anthropic 與 OpenAI 兩套官方賬號的開通流程,推薦通過 API易 apiyi.com 統一調用 gpt-6.1-sol 與 claude-sonnet-5-5。該平臺接口與 OpenAI 官方格式兼容,一個 Key 即可在兩款模型間自由切換,非常適合做選型測試和生產環境的多模型路由。
參考資料:
– OpenAI 官方發佈:GPT-6.1 Sol 介紹 openai.com/index/introducing-gpt-6-1-sol
– Anthropic 官方發佈:Claude Sonnet 5.5 介紹 anthropic.com/claude-sonnet-5-5
– Artificial Analysis 智能指數評測: artificialanalysis.ai
– Vellum GPT-6.1 Sol 基準解讀: vellum.ai/blog
– The Decoder 關於 Claude Sonnet 5.5 的報道: the-decoder.com
作者簡介:APIYI 技術團隊,專注 AI 大模型 API 接入與工程化實踐。歡迎通過 API易 apiyi.com 交流 gpt-6.1-sol 與 claude-sonnet-5-5 的選型與成本優化經驗。