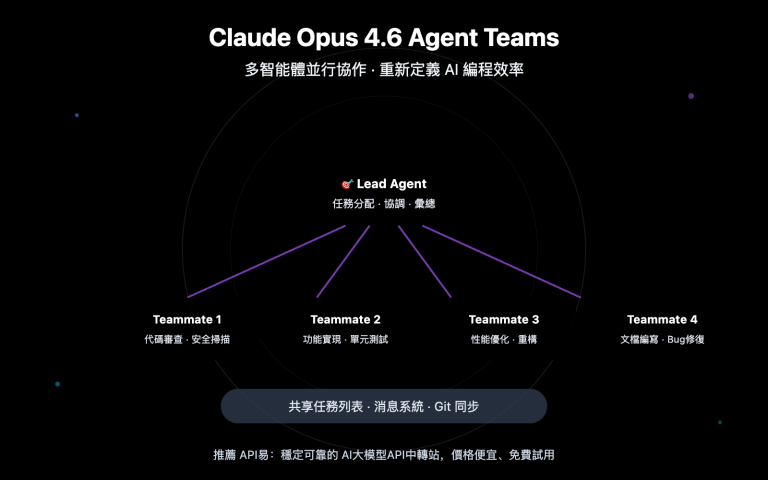
2026 年 11 月 9 日,Anthropic 發佈 Claude Fable 5.2,並披露了一項內部實驗。實驗從一個空文件夾開始,Fable 5.2 協調超過 1000 個子 Agent,連續工作 8 天,最終做出一個能在筆記本電腦上啓動的操作系統原型。
核心價值:本文不復述宣傳,而是結合 Anthropic 公開的多 Agent 工程資料,講清楚 Orchestrator、Subagent、Advisor、Workflow 各自的角色,說明任務該怎麼拆、成本爲什麼會漲、可靠性怎麼設計。最後給出一份開發者能直接落地的實踐清單。
Claude Fable 5.2 操作系統實驗覈心信息速覽
先把已經確認的事實和尚未披露的部分分開,這是理解多 Agent 協作門檻的前提。
| 信息項 | 詳情 |
|---|---|
| 發佈時間 | 2026 年 11 月 9 日,隨 Claude Fable 5.2 一同披露 |
| 發佈方 | Anthropic |
| 實驗起點 | 空文件夾,任務是設計並實現一個原型操作系統 |
| 執行規模 | 超過 1000 個子 Agent,連續 8 天,全天候編寫、測試、審查、修改代碼 |
| 最終產物 | 包含內核、磁盤/鍵盤/網絡驅動、永久文件存儲、窗口系統、登錄界面、安裝程序和內置 Claude 功能的原型系統,可在真實筆記本電腦上啓動 |
| 未披露信息 | Agent 分工結構、Harness、通信協議、代碼量、編程語言、總 Token 消耗、實驗成本、第三方安全審計 |
官方的說法是 working prototype operating system,也就是“能工作的操作系統原型”,並不是成熟的商業操作系統。另外需要注意,Anthropic 同期還有其他實驗,例如費馬大定理相關實驗披露過“1 名 Lead + 999 名 Helper”的結構,但那是獨立實驗,不能直接套用到操作系統項目上。
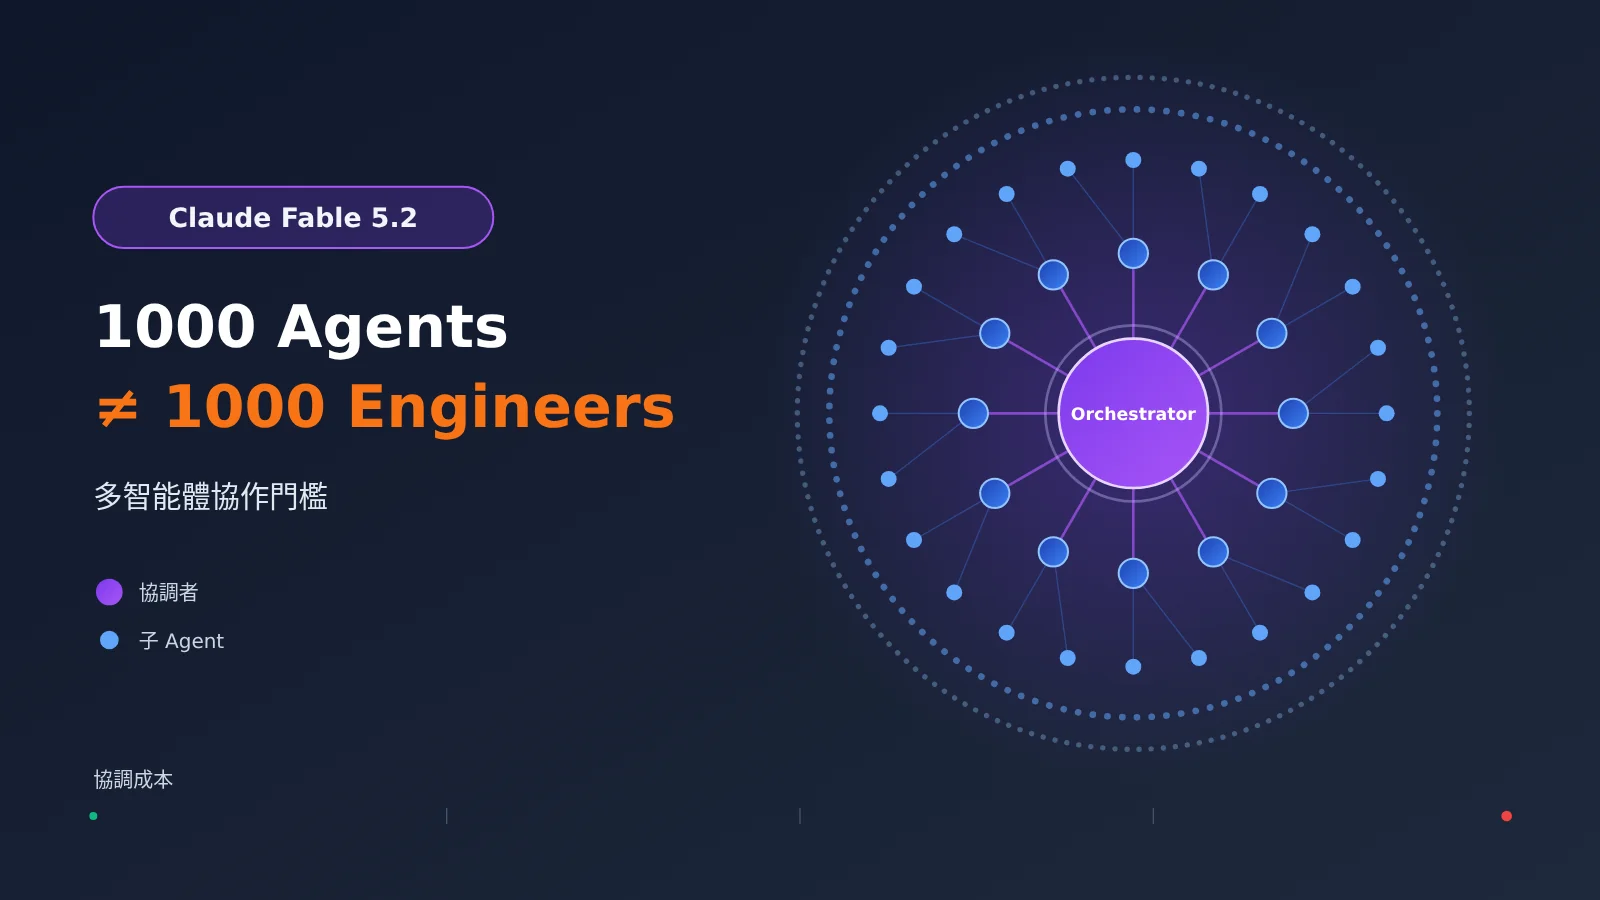
這項實驗真正值得關注的地方,不在於代碼寫了多少,而在於模型能在 8 天裏組織一個長期軟件工程項目:拆分任務、並行推進、彙總成果、發現錯誤、安排修復。這就引出了本文的核心問題:1000 個 Agent 背後,真正難的是組織。
多 Agent 協作如何工作:Claude Fable 5.2 背後的角色分工
在討論“要不要多 Agent”之前,需要先把幾個容易混淆的概念講清楚。下面這張表按照 Anthropic Managed Agents 文檔的思路做了歸納。
| 概念 | 職責 | 典型例子 |
|---|---|---|
| Agent | 能執行任務、調用工具的智能體 | 一個能讀代碼、跑測試的編程助手 |
| Orchestrator | 負責任務分配和結果整合的協調者 | 把“做一個博客系統”拆成多個模塊並彙總 |
| Subagent | 接受委派、完成子任務的智能體,擁有獨立上下文 | 專門實現評論模塊並寫好測試 |
| Advisor | 不親自幹活,只在關鍵節點提供專項建議 | 主 Agent 卡住時請更強的模型給方案 |
| Workflow | 組織任務順序、併發和結果交接的執行流程 | “調研→實現→審查→不通過則重做”的多階段程序 |
| Harness | 調用模型、工具並管理執行的外層系統 | 你自己寫的調度代碼或託管 Agent 平臺 |
多 Agent 的三種協作模式
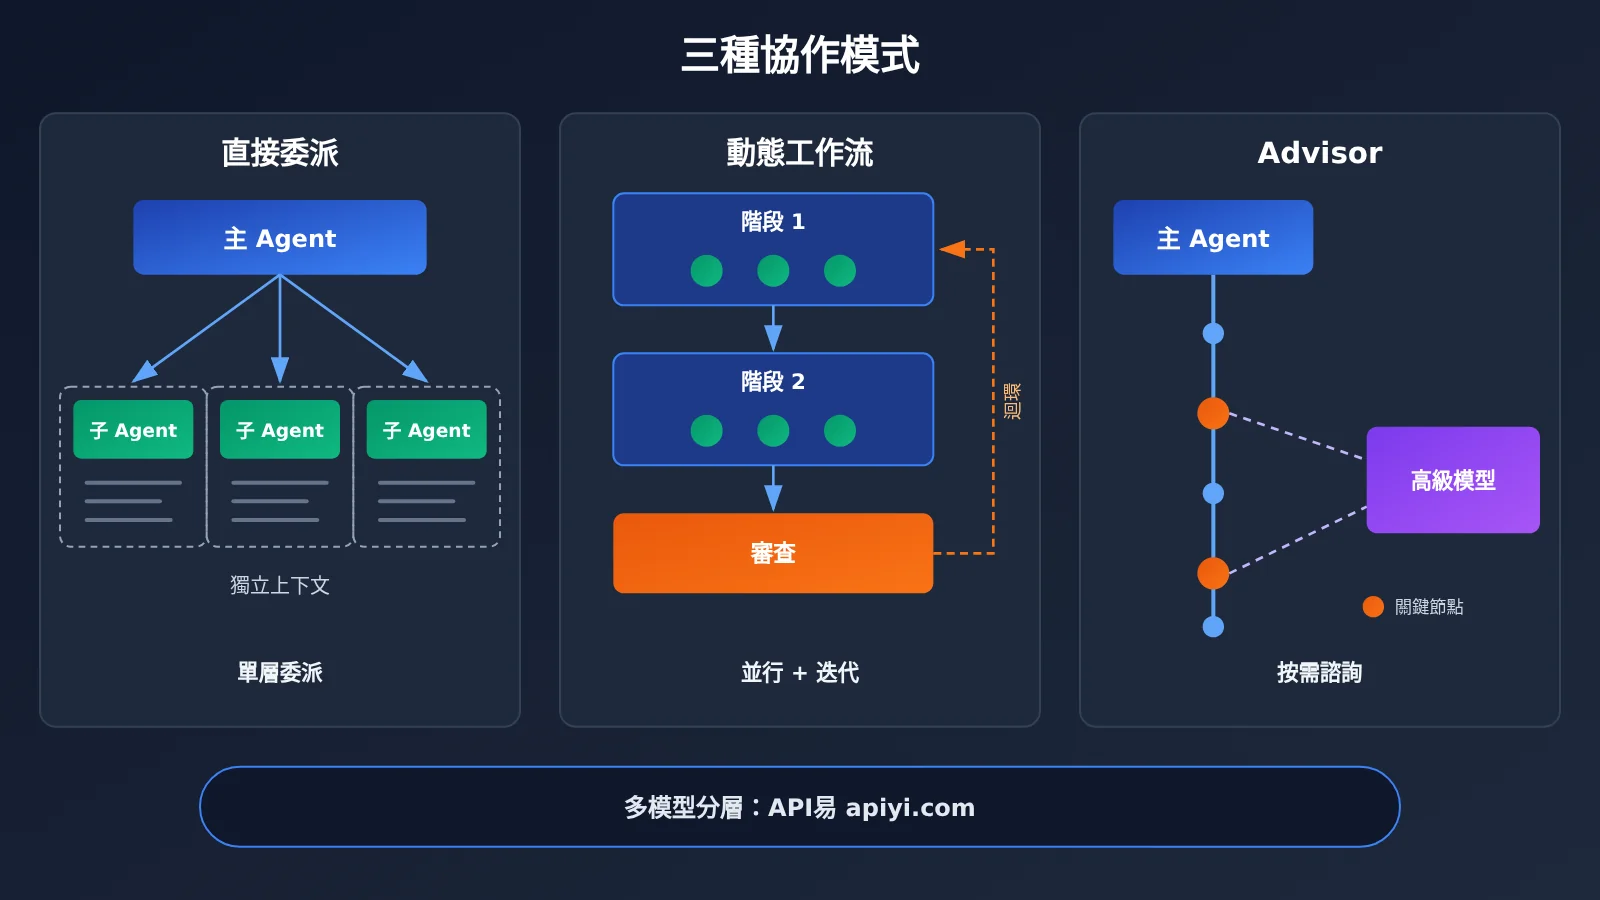
Anthropic 的 Managed Agents 文檔把多 Agent 協作分成三種模式,適用場景各不相同。
- Subagents 直接委派:主 Agent 自己決定創建哪些子 Agent、派什麼任務、何時讀取結果、是否追問。每個子 Agent 有獨立的 Session Thread,但委派只有一層,單 Session 最多 25 個直接子線程。適合需要持續跟進的少量專業任務。
- Dynamic Workflows 動態工作流:主 Agent 不再逐個管理子 Agent,而是生成一段工作流程序。程序可以劃分階段、併發運行多個 Agent、傳遞結果、根據結果選擇下一階段,並在審查不通過時重複執行直到達到輪次上限。適合大規模文件審查、多模塊代碼遷移這類任務。
- Advisor 顧問模式:主 Agent 仍然親自執行,只在困難或關鍵節點諮詢能力更強的模型。它的好處是不需要把任務拆散,協調開銷最小。
可以用一個具體例子理解三者的區別。假設要把一個電商後臺從 Python 遷移到 Go:只遷移支付和庫存兩個模塊,用直接委派就夠了;要遷移 200 個獨立接口並逐個審查,適合動態工作流;如果只是一個工程師級 Agent 在做,偶爾需要請高級模型審一下數據庫事務設計,用 Advisor 最划算。
何時增加 Agent:多 Agent 任務拆分的正確方法
Anthropic 在 2026 年 1 月 23 日的文章《Building multi-agent systems: When and how to use them》中提到一個真實現象:有團隊花幾個月搭建複雜的多 Agent 系統,最後發現改進單 Agent 的 Prompt 就能達到相近效果。所以第一個問題永遠是“該不該拆”,而不是“拆成多少個”。
多 Agent 真正有價值的三種場景
根據這篇文章,多 Agent 能穩定創造價值的場景主要有三類:
- 上下文隔離:例如客服 Agent 先讀了大量訂單歷史,再去診斷技術問題,訂單數據會擠佔上下文、干擾判斷。把訂單查詢交給獨立 Agent,只傳回必要摘要,主 Agent 就能保持清醒。
- 並行處理:分別調研不同地區市場、並行審查不同文件、同時檢查不同代碼模塊。Anthropic 特別指出,這類架構的主要價值往往是提高任務覆蓋度和完整性,而不是保證總耗時更短。
- 專業化分工:不同 Agent 配置不同的 System Prompt、工具、MCP Server、Skills 和模型,避免單一 Agent 同時揹負太多職責。
按上下文邊界拆分,而不是按角色拆分
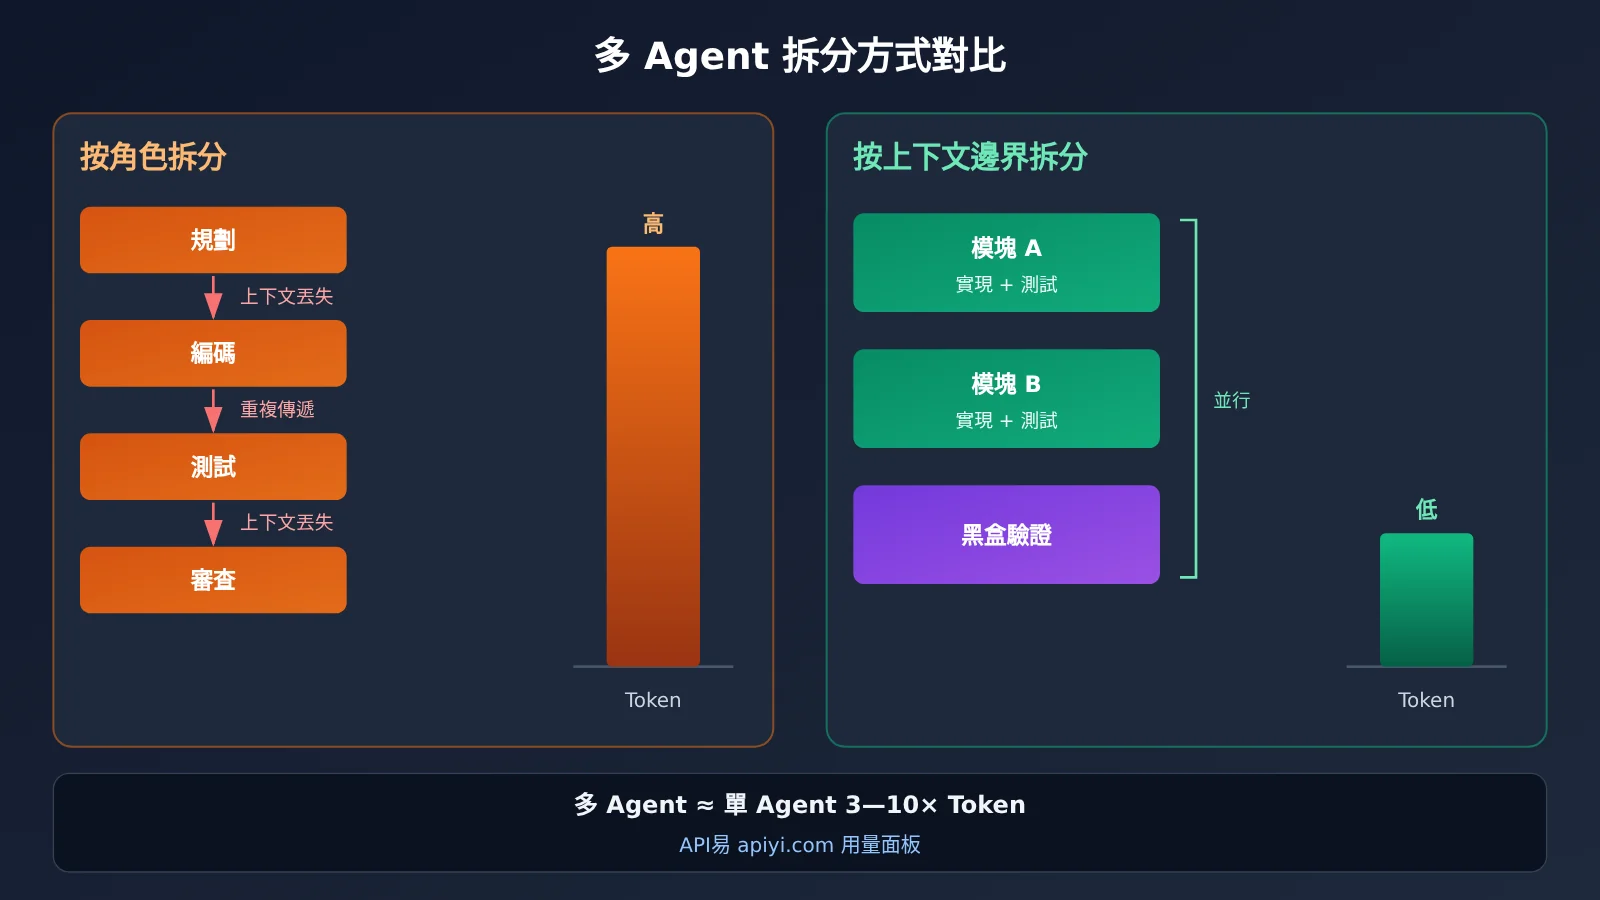
Anthropic 提出的設計原則是 Context-centric decomposition,即按上下文邊界拆分,而不是按問題環節機械拆分。很多團隊的第一反應是“規劃 Agent + 編碼 Agent + 測試 Agent + 審查 Agent”,看起來像一個分工明確的研發團隊,實際上問題很大。
測試 Agent 不知道代碼爲什麼這樣設計,審查 Agent 不瞭解前面的探索過程,信息在 Agent 之間反覆傳遞,容易出現類似“電話傳話”的失真。更合理的做法是:讓一個 Agent 負責某個完整功能模塊,包括實現和對應測試;另一個 Agent 負責一個有獨立接口的模塊;第三個 Agent 只做黑盒驗證,拿到的是待驗證成果、明確的驗收標準和測試工具。
| 任務類型 | 多 Agent 適用性 | 原因 |
|---|---|---|
| 多地區獨立市場調查 | 高 | 子任務之間幾乎不共享信息 |
| 大量文檔並行審查 | 高 | 每份文檔可獨立處理,最後彙總 |
| 不同模塊獨立開發 | 高 | 接口清晰時上下文邊界天然存在 |
| 獨立測試和驗證 | 高 | 黑盒驗證只需成果和標準 |
| 緊密耦合的代碼修改 | 較低 | 改一處牽動多處,交接成本高 |
| 需要共享大量實時狀態的任務 | 較低 | 狀態同步開銷可能超過並行收益 |
| 簡單事實查詢 | 通常不需要 | 單 Agent 一次調用即可完成 |
回到操作系統實驗,內核、驅動、文件系統、窗口系統之間確實存在相對清晰的模塊邊界,這也是它比“一個複雜業務系統的大規模重構”更適合大規模並行的原因之一。當然,Anthropic 沒有公開具體分工方式,這一點只能作爲合理推測,不能當作事實。
多 Agent 成本爲什麼更高:Claude Fable 5.2 時代的 Token 賬本
很多人直覺上認爲,任務分給更多 Agent 並行處理,成本會被攤薄。實際情況往往相反。Anthropic 2026 年 1 月的文章明確指出:對於相同任務,多 Agent 架構通常使用單 Agent 的 3—10 倍 Token。
額外的 Token 主要來自五個地方:每個 Agent 都要建立自己的上下文;Agent 之間要交換任務描述和結果;主 Agent 要閱讀並彙總多個子 Agent 的輸出;任務拆解本身會產生額外調用;多個 Agent 之間還可能重複做同一部分工作。
兩組成本數據,基準完全不同
討論多 Agent 成本時,經常有人把不同來源的數據混在一起。下面這張表把它們分開:
| 數據來源 | 指標 | 對照基準 |
|---|---|---|
| 2026 年 1 月《Building multi-agent systems》 | 多 Agent Token 消耗爲單 Agent 的 3—10 倍 | 相同任務下的單 Agent |
| 2025 年 6 月 Anthropic Research 系統 | Token 消耗約爲普通聊天的 15 倍 | 普通聊天 |
| 2025 年 6 月 Anthropic Research 系統 | 內部 Research Eval 比單 Agent Opus 4 高 90.2% | 單 Agent Opus 4,特定內部評測 |
| 2025 年 6 月 Anthropic Research 系統 | 複雜查詢研究時間最多縮短約 90%,早期典型並行 3—5 個 Subagent | 同系統單線程研究 |
需要強調的是,90.2% 和 15 倍這兩個數字都來自 2025 年的 Research 系統,前者只是特定內部評測的相對錶現,不代表所有任務準確率都提升 90.2%。它們和 2026 年的操作系統實驗沒有關係,也不能和 3—10 倍直接比較。
總計算量、執行時間和覆蓋度是三件事
理解多 Agent 成本,需要區分三個指標。總計算量通常會上升,因爲上下文被複制、結果被反覆閱讀;執行時間可能縮短,前提是子任務真正互相獨立;任務覆蓋度往往會提升,因爲多個 Agent 能同時探索更多方向。
以官方 API 標價估算,Fable 5.2 普通模式輸入 8 美元/百萬 Token、輸出 40 美元/百萬 Token,Batch API 可享 50% 折扣,緩存讀取爲 0.20 美元/MTok。如果一個單 Agent 任務本身就要消耗可觀的 Token,放大到 3—10 倍後差距會非常明顯。Anthropic 沒有公佈操作系統實驗的實際賬單,所以任何“8 天花了多少錢”的說法都沒有依據。
如何設計可靠的多 Agent 系統:從 Claude Fable 5.2 學到的工程方法
模型分層:不是每個 Agent 都需要最強模型
Managed Agents 支持兩種 Agent 定義方式。Predefined Agent 是提前配置好的,可以擁有獨立的模型、System Prompt、工具、MCP Server 和 Skills;Inline Agent 在執行時動態定義,默認沿用主 Agent 的模型和工具配置。
這意味着可以做成本與能力分層:協調者和複雜審覈用 Fable 5.2 這類強模型,普通資料檢索用 Sonnet 級模型,簡單分類用 Haiku 級模型。這只是一種設計示例,並不是 Anthropic 規定的固定架構,需要按實際任務測試調整。
驗證:審查 Agent 不等於真實驗證
Anthropic 在 Fable 5.2 的 Prompting 文檔中提到一個新變化:在 xhigh、max 等較高 Effort 設置下,Fable 5.2 會主動調用 Subagent 檢查自己的工作,而 Fable 5.1 在相同測試任務中沒有這種行爲。這是編排能力上的進步,但不能把它當作質量保證。
審查 Agent 本質上還是模型判斷。真正可靠的驗證需要三樣東西:寫清楚的驗收標準、能執行的黑盒測試、對代碼和外部系統修改的真實檢查(例如真正運行測試、真正啓動服務)。操作系統實驗最有說服力的一點,恰恰是“能在真實筆記本電腦上啓動”這個硬性結果,而不是某個 Agent 說“看起來沒問題”。
防止過度委派與規則堆積
Agent 是否委派任務,不只取決於模型能力,也受 Harness 和工具說明影響。Anthropic 測試發現,當 Subagent 工具說明寫明“每個子 Agent 的額外成本、哪些任務值得委派、哪些不值得、如何描述任務”時,模型在短任務中的委派頻率比只強調委派理由的版本降低約三分之一,而任務成功率保持不變。
另一個容易被忽視的問題是規則堆積。Fable 5.2 對上下文中累積的限制性指令遵循得比較嚴格,如果歷史文件、Reviewer 意見和 System Prompt 不斷疊加禁止事項,模型可能在日常工作中不敢執行本來允許的操作。所以需要定期清理 Agent 的記憶、規則和審批要求。
運行時限制:公開產品裏的真實天花板
“1000 個 Agent”在公開產品裏同樣有明確邊界。下面是 Managed Agents 文檔列出的限制,它們屬於公開產品,不代表內部操作系統實驗使用了相同的調度器:
| 指標 | 限制 |
|---|---|
| 直接 Subagent 子線程 | 最多 25 個 |
| Dynamic Workflow 同時工作線程 | 64 個 |
| 單個 Workflow 生命週期內啓動的 Agent | 1000 個 |
| 默認 Workflow 生命週期 | 24 小時 |
| 單 Session 默認同時開放的 Workflow | 10 個 |
此外,Workflow 內的 Agent 不能再創建嵌套 Workflow;達到預算後,運行中的 Workflow 會暫停;某個 Agent 失敗後系統通常會重試一次,再次失敗則由工作流決定如何處理。換句話說,1000 個 Agent 是“生命週期內累計啓動”,同一時刻真正在跑的遠沒有那麼多。
長時間運行還有一個體驗問題:Fable 5.2 在長時間工具調用期間可能很少輸出面向用戶的文本,用戶會誤以爲任務卡住。官方建議開啓 thinking.display: "updates",或讓 Harness 在連續多次工具調用後提醒模型彙報進度。官方測試中,加入進度提醒後最長連續無反饋時間大約縮短了一半。
多 Agent 快速上手:用 Claude Fable 5.2 搭一個最小編排器
下面不依賴任何託管平臺,用 OpenAI 兼容接口演示最基礎的一步:讓協調模型按上下文邊界拆分任務。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",  # 以平臺模型列表中的實際名稱爲準
    messages=[{"role": "user", "content": "把“爲博客增加評論功能”按上下文邊界拆成子任務,每個子任務包含實現和測試,輸出 JSON"}]
)
print(resp.choices[0].message.content)
完整版本加入了模型分層、併發執行、Token 預算、失敗重試一次和黑盒驗收,結構上對應前文講的工程方法:
查看完整多 Agent 編排示例代碼
import json
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 一個 Key 調用多家模型
)

ORCHESTRATOR_MODEL = "claude-fable-5-2"   # 協調與審覈用強模型
WORKER_MODEL = "your-fast-model"          # 子任務用更快更便宜的模型,按需替換
TOKEN_BUDGET = 200_000                     # 整個任務的 Token 預算
used_tokens = 0


def call(model, system, user):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出預算,暫停工作流")
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": system},
                  {"role": "user", "content": user}],
    )
    used_tokens += r.usage.total_tokens
    return r.choices[0].message.content


def plan(goal):
    text = call(ORCHESTRATOR_MODEL,
                "你是協調者。按上下文邊界拆分任務,簡單任務不要拆。"
                "只輸出 JSON 數組,每項含 name、spec、acceptance 字段。",
                goal)
    return json.loads(text)


def run_subagent(task):
    # 每個子 Agent 只拿到自己需要的上下文,失敗重試一次
    for _ in range(2):
        try:
            return call(WORKER_MODEL,
                        "你負責一個完整模塊,同時給出實現和測試。",
                        f"任務:{task['spec']}\n驗收標準:{task['acceptance']}")
        except Exception:
            continue
    return "FAILED"


def review(task, output):
    # 黑盒驗收:只給成果和標準,不給探索過程
    return call(ORCHESTRATOR_MODEL,
                "你是審覈者,只依據驗收標準判斷,輸出 PASS 或 FAIL 及理由。",
                f"驗收標準:{task['acceptance']}\n成果:{output}")


if __name__ == "__main__":
    tasks = plan("爲博客系統增加評論功能,含後端接口與前端組件")
    with ThreadPoolExecutor(max_workers=4) as pool:  # 控制併發
        outputs = list(pool.map(run_subagent, tasks))
    for t, o in zip(tasks, outputs):
        print(t["name"], "->", review(t, o)[:80])
    print("累計 Token:", used_tokens)
這段代碼只是演示結構,審覈環節仍然是模型判斷。在生產環境裏,review 應該替換成或補充真實的測試執行,例如運行單元測試、啓動服務做接口探測。
🚀 快速上手建議:多 Agent 的關鍵是讓不同角色用不同模型,並能隨時對比消耗。建議通過 API易 apiyi.com 用一個 API Key 同時接入 Claude、OpenAI、Gemini 等模型,先用新用戶免費測試額度跑通單 Agent 基線,再逐步加入協作層。
多 Agent 協作對開發者的影響分析
對開發者的影響
- 從單 Agent 開始:先用單 Agent 加好的 Prompt 建立基線,只有在出現上下文被污染、子任務可獨立並行、需要專業化配置這三類瓶頸時,才增加協作層。
- 把基礎設施當成一等公民:模型 API、工具 API、預算上限、併發控制和調用日誌,決定了多 Agent 系統能否穩定運行。沒有日誌,就無法定位哪個子 Agent 在重複勞動。
- 多模型分工成爲常態:協調者、執行者、審覈者使用不同模型,是控制 3—10 倍成本放大的主要手段之一。
對行業的影響
- AI 能力邊界在擴展:從“完成一個編程任務”走向“組織一個長期軟件工程項目”。Vercel、Shopify、Datadog 等早期測試夥伴的反饋也指向這一點,例如 Datadog 工程師把它形容爲能向更快模型派發任務的“事故指揮官”。需要注意,這些是發佈時公佈的合作伙伴反饋,不是獨立盲測。
- 編排能力比 Agent 數量更重要:任務可並行程度、協調開銷、共享狀態、代碼衝突、測試覆蓋率和調用成本,共同決定多 Agent 的真實效率。
常見問題 FAQ
Q1: Claude Fable 5.2 的 1000 Agent 實驗到底做出了什麼?
Anthropic 披露,Fable 5.2 從空文件夾開始,協調超過 1000 個子 Agent 連續工作 8 天,做出一個能在真實筆記本電腦上啓動的操作系統原型,包含內核、驅動、文件存儲、窗口系統、登錄界面和安裝程序。官方定位是“能工作的原型”,源碼、代碼量、總 Token 和成本均未公開,也沒有第三方審計。
Q2: 多 Agent 一定比單 Agent 好嗎?
不一定。Anthropic 明確表示多 Agent 並不總是優於單 Agent,有團隊花數月搭多 Agent 系統,最後發現優化單 Agent Prompt 就有相近效果。對於相同任務,多 Agent 通常消耗單 Agent 3—10 倍的 Token,只有上下文隔離、並行處理、專業化分工這三類場景收益比較穩定。
Q3: 90.2% 提升和 15 倍 Token 能用來評估 Fable 5.2 嗎?
不能。這兩個數字來自 2025 年 6 月發佈的 Anthropic Research 系統:90.2% 是特定內部 Research Eval 相對單 Agent Opus 4 的表現,15 倍的對照基準是普通聊天。它們與 2026 年 Fable 5.2 的操作系統實驗無關,也不能和“相同任務 3—10 倍”的數據混用。
Q4: 如何通過 API 快速搭建自己的多 Agent 原型?
推薦按以下步驟:
1. 在 API易 apiyi.com 註冊並獲取 API Key 和免費測試額度
2. 把本文代碼中的 base_url 設爲 `https://api.apiyi.com/v1`
3. 先跑單 Agent 基線,記錄 Token 和成功率
4. 再給協調者和子 Agent 分配不同模型,對比成本與質量變化
Q5: 怎樣控制多 Agent 的成本?
核心有四點:按上下文邊界拆分,減少信息交接;子任務使用更快更便宜的模型,只在規劃和關鍵審覈時用強模型;在工具說明裏寫清委派成本和不值得委派的任務,避免過度委派;設置全局 Token 預算和併發上限。批量離線任務可以考慮 Batch API 折扣,日常調用也可以藉助 API易 apiyi.com 的按量計費和用量統計做精細覈算。
Q6: 多 Agent 系統目前有哪些已知限制?
一是成本,相同任務 Token 通常放大 3—10 倍。二是調度上限,公開的 Managed Agents 中直接子線程最多 25 個,Workflow 同時工作線程 64 個,生命週期內累計啓動上限 1000 個。三是驗證,審查 Agent 不等於真實測試。四是規則堆積和長時間無反饋等體驗問題,需要定期清理規則並開啓進度更新。
Claude Fable 5.2 多 Agent 協作核心要點 Key Takeaways
- 數量不等於效率:1000 個 Agent 的價值在於組織能力,不在於數量本身
- 角色要分清:Orchestrator 協調、Subagent 執行、Advisor 建議、Workflow 管流程
- 按上下文邊界拆分:一個 Agent 負責完整模塊加測試,避免按角色傳話失真
- 成本要算清:相同任務多 Agent 通常是單 Agent 的 3—10 倍 Token
- 驗證要落地:審查 Agent 之外,必須有驗收標準和真實測試
- 從單 Agent 起步:遇到真實瓶頸再加協作層,可通過 API易 apiyi.com 多模型接入做分層測試
總結
Claude Fable 5.2 的操作系統實驗帶來的啓示:
- 編排能力是新的門檻:Fable 5.2 的進步在於更能勝任協調者角色,包括在高 Effort 下主動調用子 Agent 審查自己的工作
- 多 Agent 有明確的適用邊界:上下文隔離、並行處理、專業化分工值得拆,緊密耦合任務和簡單查詢不值得拆
- 成本、併發和驗證是三條硬約束:Token 放大、調度上限和真實測試,決定了系統能不能長期跑下去
對於大多數開發者,正確的路徑是先用單 Agent 建立基線,再根據實際瓶頸引入 Subagent、Workflow 或 Advisor,同時把模型 API、預算、併發和日誌做紮實。API 基礎設施纔是多 Agent 應用真正的底座。
推薦通過 API易 apiyi.com 快速驗證你的多 Agent 方案,平臺提供 OpenAI 兼容的統一接口和新用戶免費測試額度,便於在不同模型之間做分工對比。
📚 參考資料
- Anthropic 官方發佈公告:Claude Fable 5.2 and Mythos 5.2(2026-11-09)
- 鏈接:
anthropic.com/claude-fable-and-mythos-5-2 -
說明: 操作系統實驗、編程評測和價格的一手來源
-
Building multi-agent systems: When and how to use them:多 Agent 適用場景與成本(2026-01-23)
- 鏈接:
claude.com/resources/articles/building-multi-agent-systems-when-and-how-to-use-them -
說明: 3—10 倍 Token 數據、按上下文邊界拆分的原則
-
How we built our multi-agent research system:Anthropic Research 系統(2025-06-13)
- 鏈接:
anthropic.com/research/multi-agent-research-system -
說明: Orchestrator-Worker 架構、90.2% 內部評測與 15 倍 Token 數據
-
Managed Agents 多 Agent 編排與 Workflow 文檔:協作模式與運行限制
- 鏈接:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
說明: Subagents、Dynamic Workflows、Advisor 的定義與併發上限
-
Prompting Claude Fable 5.2:官方提示工程指南
- 鏈接:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
說明: 自我審查行爲、過度委派實驗、進度反饋建議
-
Fable 5.2 模型規格文檔:上下文、輸出上限與計費
- 鏈接:
platform.claude.com/docs/en/models/fable-5-2/overview - 說明: 1M 上下文、128K 最大輸出及 API Model ID
作者: APIYI 技術團隊
技術交流: 歡迎訪問 API易 apiyi.com 首頁聯繫我們,交流多 Agent 架構與多模型接入實踐