作者注:新模型發佈日撞額度、限流和超時是可預期的。本文給出模型分層、備用映射、優先級隊列、錯峯調度、監控與預算 5 個設計要點,以及一份發佈日容量檢查清單。
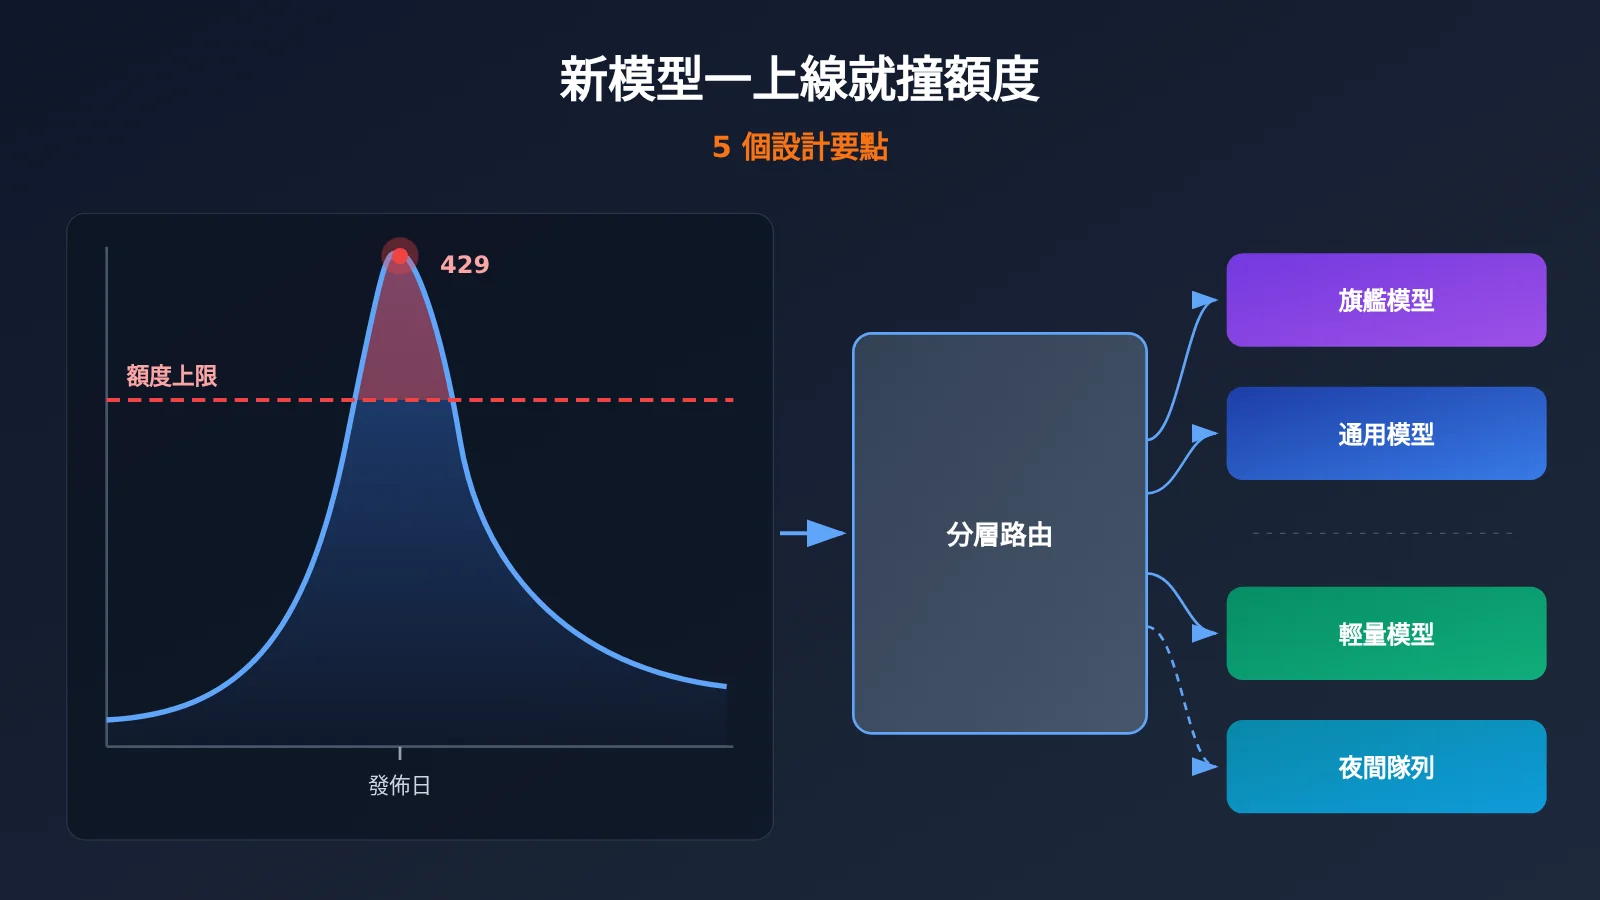
先說結論:新模型一上線就撞額度,不是意外,而是產品節奏的一部分。免費額度會吸引大量試用,發佈日的流量又高度集中,上游擴容需要時間,這幾件事疊在一起,容量緊張幾乎是必然結果。應用側真正該做的,是在發佈前就設計好 多模型切換與錯峯調度,而不是等 429 出現後再一遍遍重試。
這不是一篇教你“多加幾次重試”的文章。重試只能消化短暫抖動,解決不了額度耗盡和上游過載。發佈日拼的不是重試次數,而是提前做好的分層和排隊。讀完本文,你將拿到一套可落地的發佈日容量設計方法:模型分層、備用映射、優先級隊列、錯峯調度、監控與預算,並知道什麼時候切換、什麼時候排隊、什麼時候停手。
新模型發佈日爲什麼容易撞額度
結論:發佈日撞額度是需求側集中爆發與供給側擴容滯後共同造成的,應用側要把它當作可預期事件來設計。
最近一個典型例子是騰訊 Hy4。根據騰訊方面的公開說法,Hy4 於 11 月 4 日在 WorkBuddy 首發,首日大量用戶觸及額度,隨後推理集羣擴容十倍,並提高了免費額度。騰訊給出的建議是:觸限時切換到 Hy3,或者把非緊急任務放到晚間處理,同時將 Hy3 的限免延長到 11 月 15 日 23:59。
需要特別說明的是,這次額度事件發生在 WorkBuddy 產品層面,是面向終端用戶的使用額度,不能直接等同於 API 限流。產品額度通常按賬號或會員等級計算,API 限流則按 Key、組織或模型維度計算速率和併發,兩者的觸發條件和處理方式都不同。不過它揭示的規律是通用的:新模型一上線,需求會在極短時間內集中湧入。
需求規模本身也在快速放大。同樣在 11 月 4 日,DeepSeek 方面披露 Harness 日活約 154 萬、日消耗約 92 萬億 token。這類數字屬於廠商自報,不是第三方審計數據,只適合用來感受量級,不宜作爲容量規劃的精確依據。但它足以說明,Agent 類應用的 token 消耗已經遠超普通聊天場景。
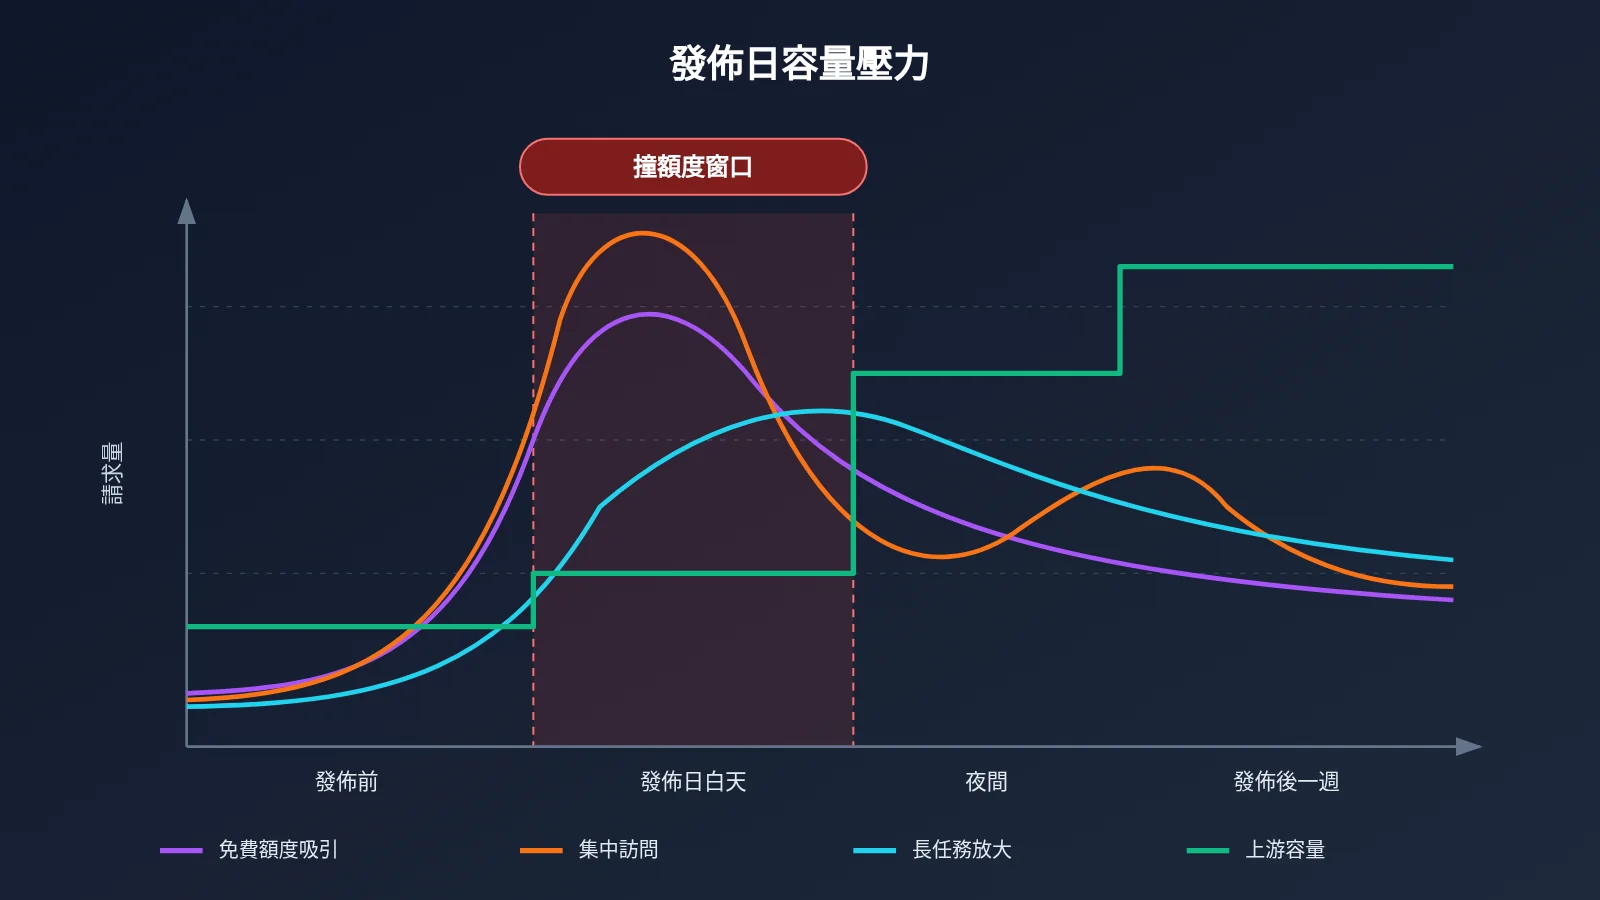
新模型撞額度的四個成因
| 成因 | 具體表現 | 對應用側的影響 |
|---|---|---|
| 免費或試用額度 | 新模型常配試用額度,吸引大量用戶同時試用 | 額度很快用完,出現 402 或 429 |
| 集中訪問 | 發佈日、活動期、工作日白天流量疊加 | 峯值可能達到日常的 3-10 倍 |
| 長任務佔用 | Agent 多輪、工具調用、長上下文 | 單請求 token 大,佔用推理資源時間長 |
| 上游擴容滯後 | 推理集羣擴容需要時間 | 5xx、排隊、超時,甚至輸出質量波動 |
這四個成因裏,應用側能直接控制的只有自己的請求形態和調度方式。所以與其寄希望於上游“扛住”,不如在自己這一側準備好分流和緩衝。
新模型撞額度的五類容量問題
結論:撞額度不是一種錯誤,而是五類性質不同的容量問題,處理方式必須按類區分。
很多團隊把所有失敗都塞進同一個重試邏輯,這恰恰是發佈日事故擴大的原因。額度耗盡時重試只會繼續失敗,上游過載時密集重試還會加劇擁塞。下面這張表把五類問題拆開,方便你對照設計處理分支。
| 問題 | 典型狀態碼 | 原因 | 處理 |
|---|---|---|---|
| 額度耗盡 | 402、429 |
免費額度、試用額度或賬戶餘額用完 | 停止重試,切換備用模型或提示補充額度 |
| 速率或併發限制 | 429,常帶 Retry-After |
單 Key 或單模型的 RPM、TPM、併發超限 | 按 Retry-After 等待;等待超閾值則切換或入隊 |
| 上游容量不足 | 500、502、503、529 |
推理集羣過載或局部故障 | 指數退避少量重試,連續失敗後切換備用模型 |
| 長任務佔用 | 超時、連接中斷 | Agent 多輪、工具調用、長上下文導致單請求過重 | 拆分任務、限制上下文、給長任務獨立併發池 |
| 高峯集中 | 混合出現 429 與 5xx |
白天、發佈日、活動期流量疊加 | 優先級隊列加錯峯調度,非緊急任務後移 |
表裏有兩個細節值得強調。第一,429 本身有歧義,既可能是速率超限,也可能是額度耗盡,需要結合響應體裏的錯誤信息和 Retry-After 判斷。第二,529 這類過載碼錶示上游暫時無法服務,此時降低請求密度比加快重試更有效。
把錯誤碼分清楚之後,後面的五個設計點纔有落腳點:哪些情況切換,哪些情況排隊,哪些情況直接停手。
多模型切換與錯峯調度的 5 個設計要點
結論:五個設計點分別解決“用哪個模型、換成哪個模型、誰先用、什麼時候用、花了多少”這五個問題,缺一個都會在發佈日暴露。
設計要點 1:模型分層
怎麼做:把模型按能力和成本分成旗艦、通用、輕量三層,再把業務任務按優先級和難度映射到層級上。複雜推理、關鍵代碼生成用旗艦層;日常問答、摘要、改寫用通用層;分類、抽取、意圖識別這類簡單任務用輕量層。新模型上線時,通常只把它放進旗艦層的一部分流量裏,而不是全量替換。
什麼時候觸發:分層是常態配置,不是故障時才啓用。它在平時就決定了每類任務的默認去向,發佈日只是在此基礎上調整比例。
怎麼驗證:對每一層抽取固定的評測題集,記錄通過率、P95 延遲和單任務 token 成本,確認輕量層承接簡單任務時質量沒有明顯下降。
在實現上,分層最大的阻力往往是“每接一家廠商就多一套 SDK 和 Key”。通過 API易 apiyi.com 這類聚合平臺,一個 Key 就可以調用 OpenAI、Claude、Gemini 等多家模型,接口兼容 OpenAI 格式,分層時只需要改模型名,不必爲每一層維護獨立的鑑權和客戶端。
設計要點 2:備用模型映射
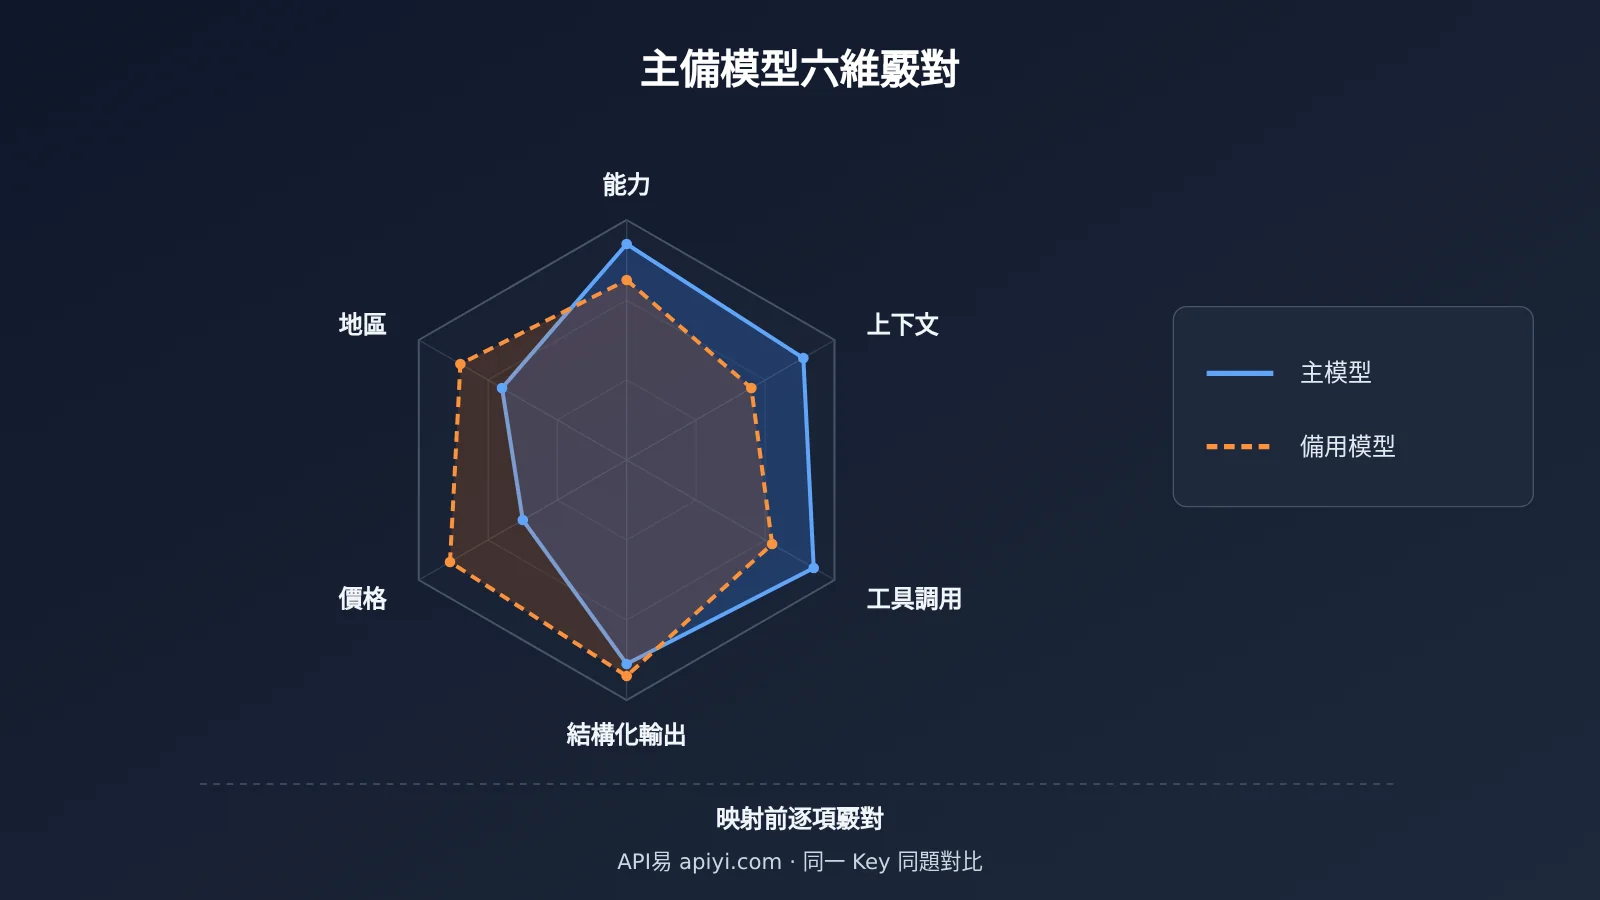
怎麼做:爲每個主模型指定至少一個備用模型,映射時逐項覈對六個維度:能力水平、上下文長度、工具調用支持、結構化輸出能力、價格、可用地區。最容易被忽略的是工具調用和結構化輸出,備用模型如果不支持同樣的函數調用格式,切過去之後 Agent 會直接中斷。
什麼時候觸發:切換條件要寫成具體規則,例如連續 2 次 5xx、429 的 Retry-After 超過任務可接受的等待時間、P95 延遲持續超過基線兩倍,或者明確返回額度耗盡。不要設置“任何失敗都切換”,那會讓偶發抖動也觸發大量切換。
怎麼驗證:用同一批題目分別跑主模型和備用模型,比較通過率、結構化輸出的校驗通過率和工具調用成功率,差距超出業務容忍範圍的映射要重新選擇。
| 層級 | 適用任務 | 主模型 | 備用模型 | 切換條件 |
|---|---|---|---|---|
| 旗艦層 | 複雜推理、關鍵代碼、Agent 規劃 | 新發布的旗艦模型 | 上一代旗艦或同級別其他廠商模型 | 連續 2 次 5xx;429 的 Retry-After 超過 30 秒 |
| 通用層 | 問答、摘要、改寫、報告生成 | 主力通用模型 | 同級別其他廠商通用模型 | P95 延遲超過基線 2 倍並持續 5 分鐘 |
| 輕量層 | 分類、抽取、路由、意圖識別 | 輕量模型 | 另一家輕量模型 | 5xx 率超過 5%;額度耗盡 |
| 批處理層 | 離線分析、數據標註、評測 | 任意可用的低價模型 | 不切換,直接延後 | 不即時切換,進入夜間隊列 |
| 可用平臺 | 以上各層統一接入 | API易 apiyi.com、各廠商官方 API | 同左 | 以控制檯和文檔爲準 |
表中的閾值是示例,需要根據你自己的業務基線調整。
💡 降級建議:如果不想在應用裏自己維護全部切換邏輯,可以結合平臺側能力。API易 apiyi.com 官方描述其採用多節點部署、智能路由、自動降級與負載均衡,可以在上游局部故障時分擔一部分壓力。具體的觸發條件和切換規則以官方文檔爲準,應用側仍建議保留自己的備用映射作爲兜底。
設計要點 3:優先級隊列
怎麼做:把請求按優先級分成三檔:付費或緊急任務、內部任務、批處理任務。緊急任務直接走主模型;內部任務在主模型繁忙時降到備用模型;批處理任務進入隊列等待。每個隊列都要設置最大併發、最大排隊時間和超時降級策略,避免一個長任務把整個併發池佔滿。
什麼時候觸發:當主模型的 429 率或排隊長度超過閾值時,隊列開始生效,低優先級請求停止搶佔主模型併發。
怎麼驗證:隊列必須可觀測,至少要看到排隊長度、平均等待時間和放棄率。壓測時人爲製造主模型限流,確認緊急任務的延遲保持穩定,低優先級任務在排隊而不是失敗。
這裏有一條硬性原則:非冪等請求不能自動重試。像下單、發消息、寫數據庫、調用外部付費工具這類操作,失敗後必須先查詢狀態,確認上一次是否已經生效,再決定是否重發。可以爲這類請求生成冪等鍵,服務端據此去重。對所有錯誤一律自動重試,是發佈日產生重複扣費和重複寫入的常見原因。
設計要點 4:錯峯調度
怎麼做:識別出延遲容忍的任務,比如離線報告、批量摘要、數據標註、迴歸評測,把它們放到夜間或低峯時段執行。騰訊在 Hy4 觸限時給用戶的建議之一,就是把非緊急任務放到晚間,這個思路同樣適用於 API 調用場景。
什麼時候觸發:兩種觸發方式可以並用。一種是時間窗口觸發,固定在夜間低峯執行批量任務;另一種是負載觸發,當白天的 429 率或 P95 延遲超標時,自動把批處理隊列的執行時間推遲。
怎麼驗證:檢查錯峯後白天高峯的請求量是否下降,夜間任務的完成率和失敗重試率是否在可接受範圍內。錯峯任務失敗後可以重試,但同樣要遵守冪等原則。
設計要點 5:監控與預算
怎麼做:按 Key、模型、任務類型三個維度拆分統計用量,不要只看總量。總量平穩時,可能某一個 Agent 任務的 token 已經翻倍,只有拆分維度才能看出來。同時爲發佈日設置臨時預算和告警,可以適當放寬告警閾值,但預算上限必須保留。
什麼時候觸發:告警規則建議覆蓋四類信號:429 率突增、5xx 率突增、單任務 token 超出基線、日預算消耗超過一定比例。
怎麼驗證:發佈前用小流量跑一遍,確認看板能正確拆分維度,告警能在預期時間內送達。
| 指標 | 關注維度 | 說明 |
|---|---|---|
429 率 |
Key、模型 | 區分速率超限與額度耗盡 |
5xx 率 |
模型 | 判斷上游是否過載,觸發切換 |
| P95 延遲 | 模型、任務類型 | 長任務單獨統計,避免拉高整體基線 |
| 排隊長度與等待時間 | 優先級隊列 | 觀察低優先級任務是否積壓 |
| token/任務、成本/任務 | 任務類型 | Agent 多輪與工具調用會顯著放大 |
| 切換次數與回退成功率 | 主備映射 | 判斷備用模型是否真的接住了流量 |
成本側的統計可以藉助平臺能力完成。API易 apiyi.com 的控制檯提供模型列表、用量、賬單和日誌查詢,適合在發佈日按 Key 和模型覈對實際消耗,再配合自己的任務維度埋點,就能把“花了多少”和“花在哪裏”對應起來。
關於容量估算,可以按日活、請求量和平均 token 估算峯值 QPS,再乘上 Agent 多輪和工具調用的放大係數。發佈日峯值可能是日常的 3-10 倍,建議預留 30%-50% 的備用容量,或者準備好可以隨時切過去的備用模型。只按聊天場景估算,會嚴重低估長上下文和工具調用帶來的消耗。
多模型切換快速上手:回退驗證怎麼做
結論:備用路徑沒有演練過,就等於沒有備用路徑,回退驗證要在發佈前完成。
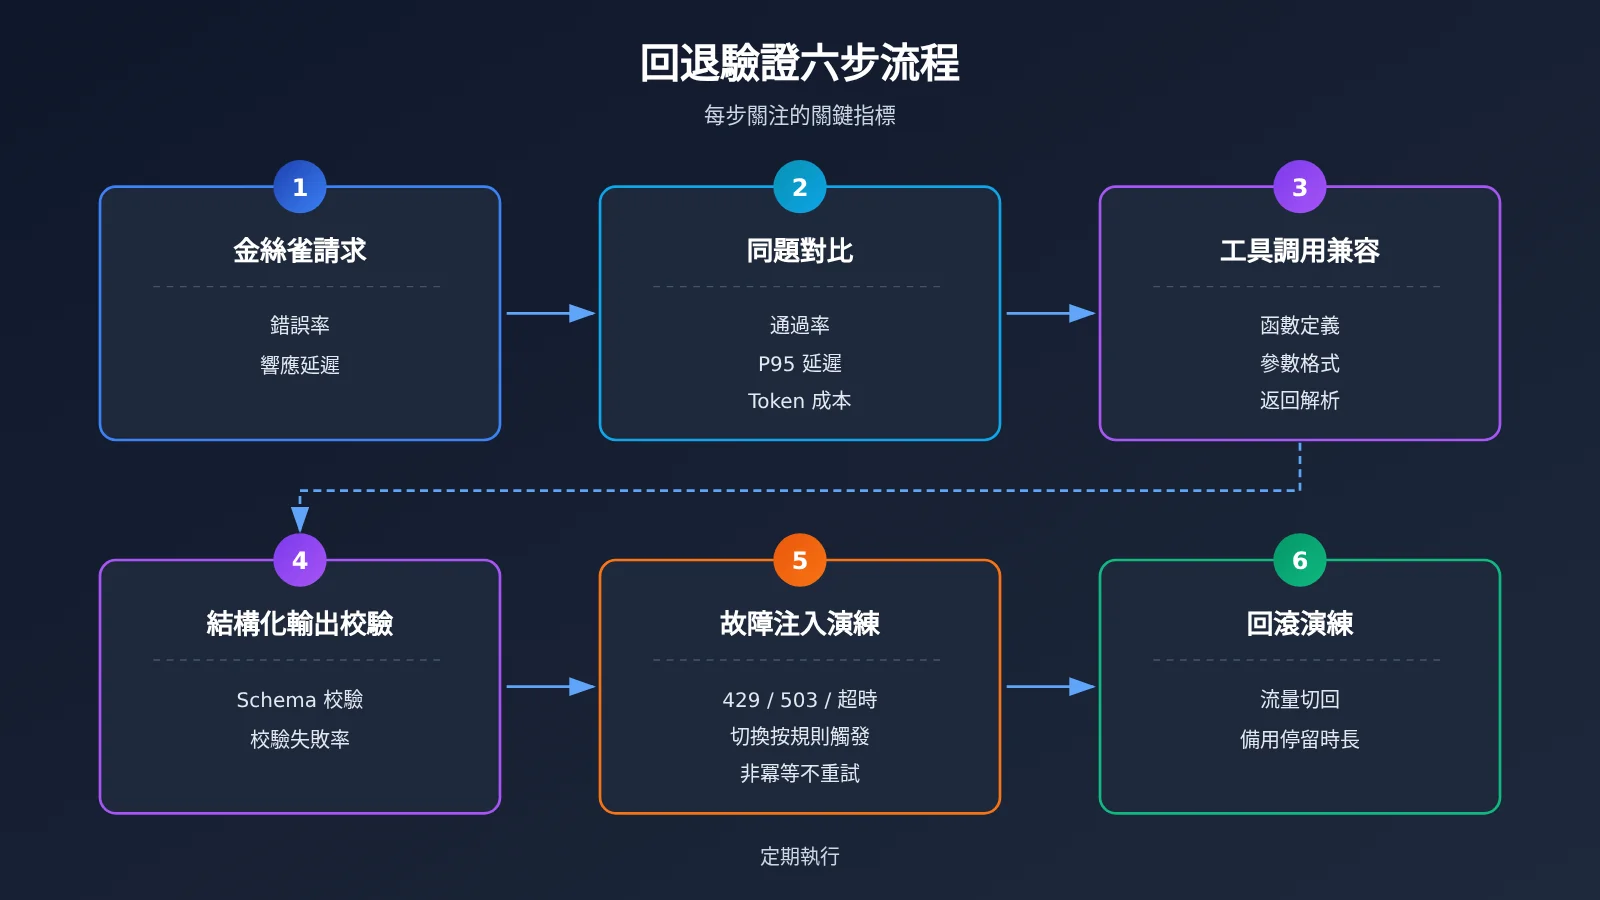
接入層面的改動並不複雜。如果你已經在使用 OpenAI 兼容的 SDK,只需把 base_url 設置爲 https://api.apiyi.com/v1,再把 api_key 換成平臺提供的 Key,主模型和備用模型就可以通過修改 model 參數切換,無需引入新的客戶端。真正需要投入時間的是驗證環節,建議按下面的順序進行:
- 金絲雀請求:先用少量真實流量打到備用模型,觀察錯誤率和延遲。
- 同題對比:用固定評測集分別跑主模型和備用模型,比較通過率、P95 延遲和 token 成本。
- 工具調用兼容性:逐個檢查函數定義、參數格式和返回解析在備用模型上是否正常。
- 結構化輸出校驗:對 JSON 輸出做 schema 校驗,記錄校驗失敗率。
- 故障注入演練:人爲模擬
429、503和超時,確認切換按規則觸發,非冪等請求沒有被自動重試。 - 回滾演練:主模型恢復後,確認流量能按預期切回,不會長時間停留在備用模型上。
回退演練最好定期執行,而不是隻在發佈前做一次。上游模型會更新版本,你的提示詞和工具定義也在變,三個月前驗證過的映射今天未必還成立。
🚀 快速開始:建議先在 API易 apiyi.com 註冊並領取免費測試額度,用同一個 Key 把主模型和備用模型都跑一遍同題對比,再決定發佈日的映射關係。價格與模型可用性以控制檯和文檔爲準。
常見問題 FAQ
結論:發佈日的大多數疑問,都可以歸結爲“先判斷錯誤性質,再決定切換、排隊還是停手”。
Q1:新模型發佈日要不要在應用側提前限流?
建議要。提前在應用側設置最大併發和優先級隊列,比被上游 `429` 被動限流更可控。你可以決定哪些用戶和任務優先,而上游限流不會區分你的業務優先級。限流閾值可以參考平時峯值再乘以預估放大係數來設定。
Q2:遇到 429 要不要馬上換模型?
不一定。先看 `Retry-After`,如果等待時間在任務可接受範圍內,等待後重試即可;如果超過閾值,或者響應明確表示額度耗盡,再切換備用模型。通過 API易 apiyi.com 一個 Key 調用多家模型時,切換隻需改模型名,因此可以把閾值設得更細,不必一遇到 `429` 就整體切走。
Q3:非緊急任務應該怎麼排隊?
給非緊急任務單獨的隊列和併發池,設置最大排隊時間。超時後不是丟棄,而是推遲到夜間或低峯時段執行。隊列要監控排隊長度、等待時間和放棄率,失敗任務可以重試,但非冪等任務必須先查狀態。
Q4:自動降級會不會降低輸出質量?
有可能,所以降級前必須做同題對比,把質量差距控制在業務可接受範圍內。API易 apiyi.com 官方描述支持自動降級與負載均衡,但切換規則以官方文檔爲準,切換後的效果差異需要你用自己的評測集驗證。對質量敏感的任務,寧可排隊等主模型,也不要直接降級。
Q5:怎麼判斷是產品額度用完還是 API 限流?
看來源和維度。產品額度出現在面向終端用戶的應用裏,比如 Hy4 在 WorkBuddy 中的額度,按賬號計算,通常表現爲界面提示。API 限流出現在接口響應中,表現爲 `429` 並可能攜帶 `Retry-After`,按 Key、組織或模型計算。前者靠切換產品內模型或等待額度恢復,後者靠退避、排隊和備用映射。
多模型切換與錯峯調度 Key Takeaways
結論:發佈日的穩定性,取決於提前做好的分層、隊列和預算。
- 容量緊張可預期:新模型發佈日撞額度是產品節奏的一部分,要提前設計。
- 錯誤必須分類:
402、429、5xx、超時各有處理分支,不能統一重試。 - 分層先於切換:旗艦、通用、輕量三層映射任務,新模型先承接部分流量。
- 備用映射要覈對:能力、上下文、工具調用、結構化輸出、價格、地區逐項確認。
- 非冪等請求停手:失敗後先查狀態,再決定是否重發。
- 錯峯釋放高峯:延遲容忍任務放到夜間,白天把併發留給緊急任務。
- 監控按維度拆分:通過 API易 apiyi.com 的用量日誌覈對 Key 與模型維度的實際消耗。
總結與發佈日容量檢查清單
結論:發佈日拼的不是重試次數,而是提前做好的分層和排隊。
新模型一上線就撞額度,背後是免費額度、集中訪問、長任務和上游擴容滯後的疊加。應用側能做的,是用模型分層決定默認去向,用備用映射準備退路,用優先級隊列保護關鍵任務,用錯峯調度削平高峯,再用監控與預算把風險和成本控制在可見範圍內。下面這張清單分爲發佈前和發佈日兩組動作,可以直接用於上線評審。
| 階段 | 檢查項 | 完成標準 |
|---|---|---|
| 發佈前 | 主備都驗證 | 主模型與備用模型均通過同題對比、工具調用和結構化輸出校驗 |
| 發佈前 | 區分錯誤碼 | 402、429、500、503、529 與超時各有獨立處理分支 |
| 發佈前 | 非冪等停手 | 寫操作與付費工具調用禁止自動重試,失敗後先查狀態 |
| 發佈前 | 優先級隊列 | 三檔優先級,配置最大併發、最大排隊時間和超時降級 |
| 發佈前 | 錯峯任務清單 | 列出可延後到夜間的批處理任務,並配置負載觸發規則 |
| 發佈前 | 演練 | 完成故障注入、切換與回滾演練,並記錄結果 |
| 發佈日 | 監控 | 按 Key、模型、任務查看 429 率、5xx 率、P95 延遲、排隊長度 |
| 發佈日 | 預算 | 設置臨時預算與告警,放寬閾值但保留上限 |
| 發佈日 | 切換觀察 | 關注切換次數與回退成功率,主模型恢復後按計劃切回 |
| 發佈日 | 業務通知 | 提前告知業務方可能出現的延遲和降級範圍 |
如果你正在爲下一次模型發佈做準備,推薦通過 API易 apiyi.com 用一個 Key 把主備模型都跑通,再結合控制檯的用量日誌設定預算,把這張清單逐項落實。
📚 參考資料
結論:以下資料用於覈對模型接入方式與平臺能力,具體參數以官方最新文檔爲準。
- API易 文檔中心:模型列表、接口說明、用量與賬單查詢
- 鏈接:
docs.apiyi.com -
說明: 查看可用模型、OpenAI 兼容接口用法以及自動降級相關說明
-
OpenAI API 錯誤碼說明:
429等限流錯誤的含義與處理建議 - 鏈接:
platform.openai.com/docs/guides/error-codes -
說明: 理解速率限制與額度耗盡的區別
-
Anthropic API 錯誤說明:包括過載類錯誤的處理方式
- 鏈接:
docs.anthropic.com/en/api/errors - 說明: 瞭解
529過載錯誤的含義
作者: APIYI 技術團隊
技術交流: 歡迎在 API易 網站首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心