作者注:解讀 Menlo Ventures 2026 企業 AI 報告,說明 Agent 如何把模型消費從“人類提問”變成“機器持續執行任務”,以及這對 API 調用、併發和採購結構的影響。
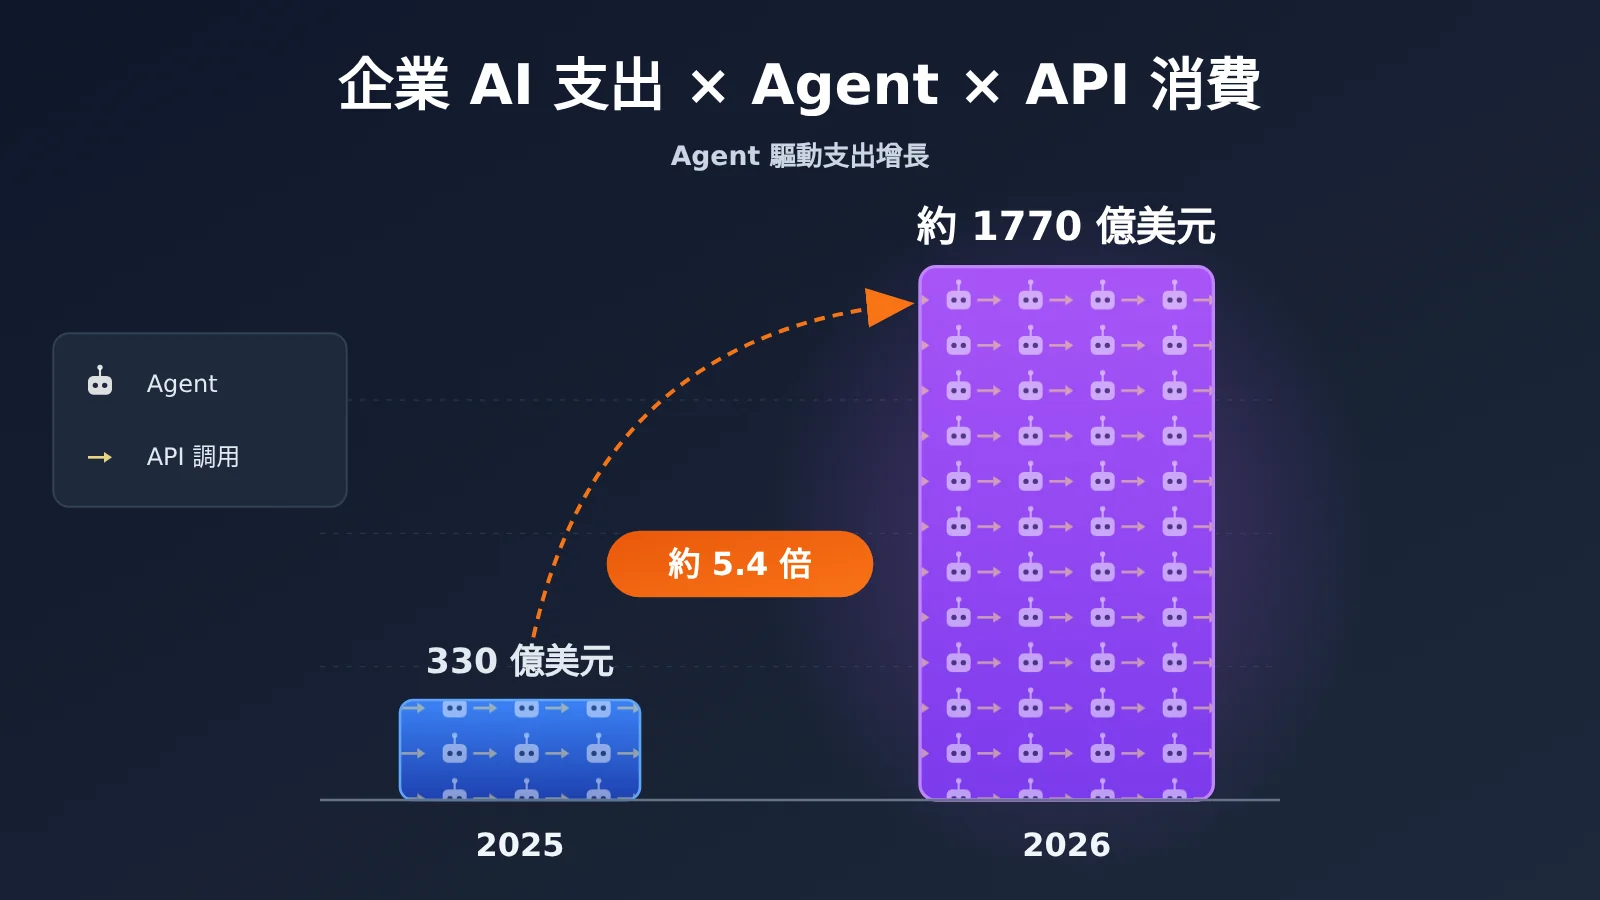
Menlo Ventures 在 2026 年 11 月 3 日發佈了《The State of Enterprise AI》報告。報告估算,2026 年企業使用 AI 的支出約 1770 億美元(報告原值爲 1768 億美元),約爲 2025 年 330 億美元的 5.4 倍。更值得注意的是,企業實際花掉的錢平均是原計劃的 2.5 倍左右。
這不是又一輪“AI 市場很大”的泛泛之談。 報告基於近 400 名美國企業決策者的調查,並引用 OpenRouter 的 Token 數據,結論指向同一個變化:支出增長的主要來源已經不是“更多人在問 AI”,而是“Agent 在替人持續幹活”。
核心價值:本文梳理企業 AI 支出和 Agent 的關鍵數據,解釋 Agent 爲什麼會改變 Token 消耗與 API 調用方式,並分析 API 開發者和採購者需要提前準備的事項。
2026 企業 AI 支出核心信息速覽
先看數據。下表數字全部來自 Menlo Ventures 的市場估算,不是經審計的企業付款總額,也不是某一家模型廠商的收入。
| 信息項 | 詳情 |
|---|---|
| 發佈方 / 時間 | Menlo Ventures,2026 年 11 月 3 日 |
| 2026 企業 AI 支出 | 約 1768 億美元(2025 年爲 330 億美元,約 5.4 倍) |
| 支出構成 | AI 基礎設施約 995 億美元,AI 應用約 773 億美元 |
| 使用 vs 構建 | 使用 AI 支出約爲構建模型支出(1025 億美元)的 1.7 倍 |
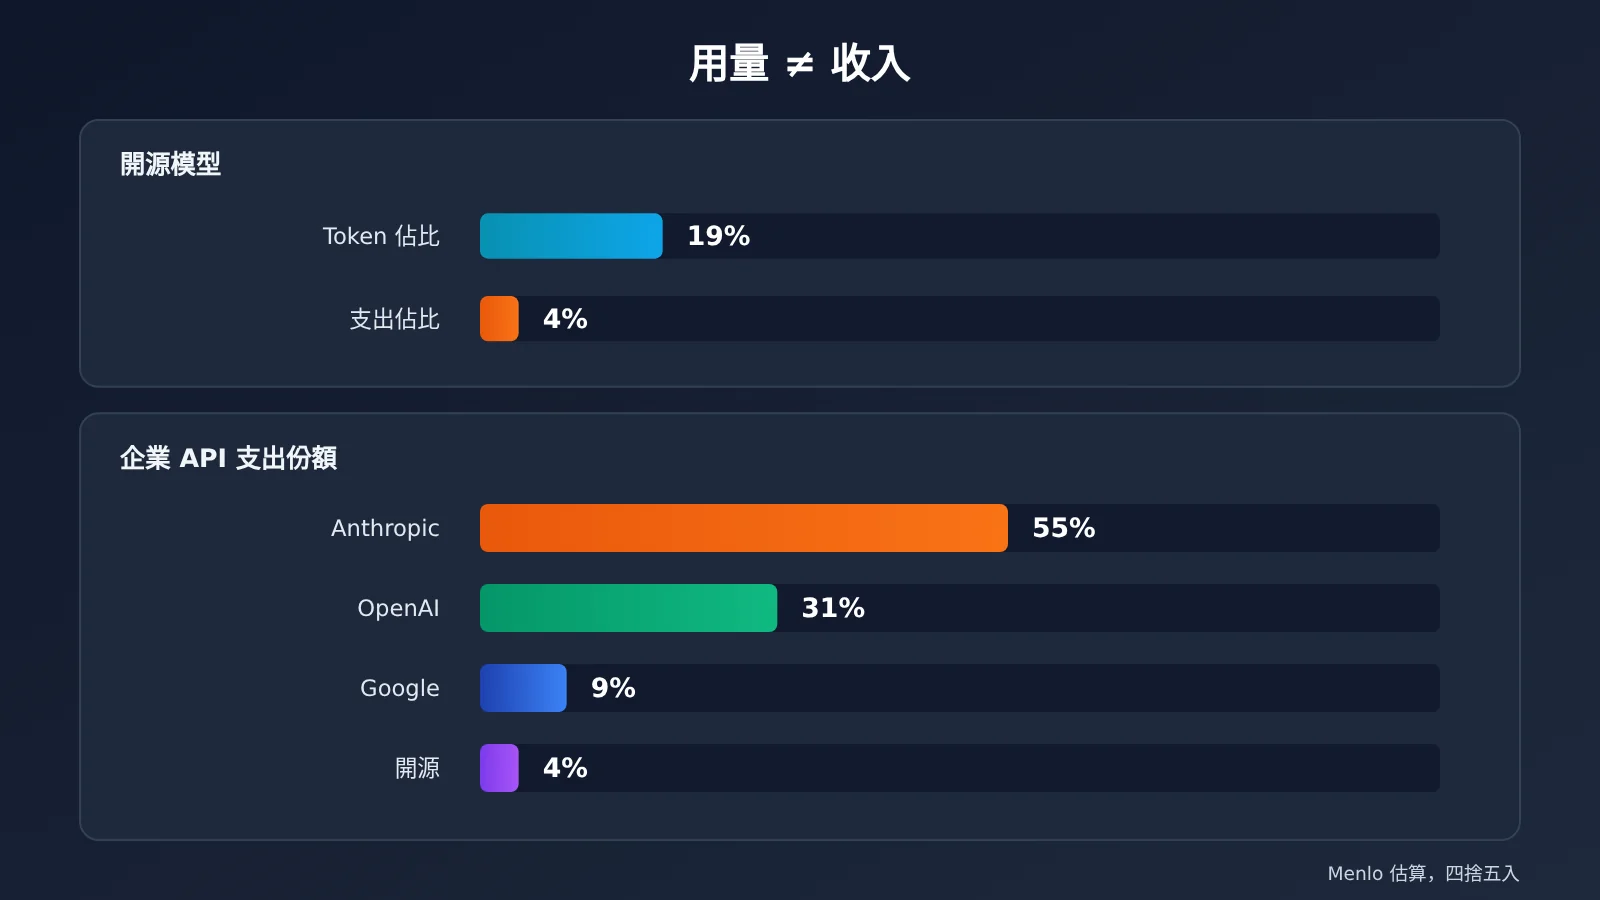
| 企業 API 支出份額 | Anthropic 55%、OpenAI 31%、Google 9%、開源模型 4% |
| Agent Token 佔比 | 在 OpenRouter 上約佔總 Token 消耗的 80% |
| 調研方法 | 近 400 名美國企業決策者,調查時間爲 2026 年 9 月 8—26 日 |
“使用 AI 的支出超過構建模型的支出”是一個轉折信號。過去討論 AI 產業鏈,重點在訓練和算力。現在企業爲了讓模型完成工作而支付的服務費用已經成爲更大的一塊。還要注意,這裏的“使用支出”包括基礎設施、應用訂閱和 API 等多種形式,不能直接當作 API 市場收入。
同一時期,OpenAI 總裁 Greg Brockman 在 11 月 4 日的 WSJ 科技大會上表示,OpenAI 已有超過一半的收入來自企業業務。這個數字說的是 OpenAI 自身的收入結構,和 Menlo 統計的“OpenAI 佔企業 API 支出 31%”是兩個不同口徑,不能混在一起比較。
企業 AI 支出爲何遠超預算:使用深度比用戶數更關鍵
企業 AI 支出的預算偏差
報告裏最反直覺的數據是預算偏差。企業年初普遍低估了 AI 的消耗速度:
| 指標 | 原計劃(相對上年) | 實際(相對上年) |
|---|---|---|
| 平均 AI 支出 | 1.9 倍 | 4.7 倍 |
| 中位數 AI 支出 | 1.8 倍 | 2.2 倍 |
| 企業 AI 採用率 | — | 55% → 65% |
平均值比中位數高出一倍多,說明少數高強度使用 AI 的企業拉高了整體支出。採用率只上升了 10 個百分點,單個企業的平均支出卻接近原來的 5 倍。所以增長的主要原因不是更多公司開始用 AI,而是已經在用的公司用得越來越深。
企業 AI 支出正在形成新預算
從資金來源看,Menlo 估算新增 AI 支出中約 55% 來自新增預算,約 22% 來自原有軟件預算。也就是說,AI 不只是在替換傳統 SaaS,還在創造過去沒有的採購科目。對採購負責人來說,AI 已經從“IT 工具費”中分離出來,成爲一筆需要單獨管理的運營成本。
Agent 如何改變 API 消費:從提問到執行
聊天機器人與 Agent 的調用機制差異
預算失控的直接原因,是調用模式發生了變化。普通聊天機器人基本是“一問一答”:用戶發一條消息,模型返回一次結果,Token 消耗和人的提問次數大致成正比。Agent 的工作方式是“給目標、拆任務、調工具、檢查結果、再迭代”,一次任務背後可能有幾十次模型調用。
| 維度 | 聊天機器人 | AI Agent |
|---|---|---|
| 觸發方式 | 人主動提問 | 目標驅動,可定時或事件觸發 |
| 單任務調用次數 | 通常 1 次 | 多輪規劃、執行、校驗 |
| 併發特徵 | 跟隨在線人數 | 多個子任務、多個 Agent 並行 |
| 上下文 | 對話歷史 | 文檔、代碼庫、工具返回結果 |
| 運行時長 | 人離開即停止 | 可在後臺持續執行 |
| 消耗決定因素 | 用戶數 × 提問頻率 | 任務量 × 並行度 × 持續時間 |
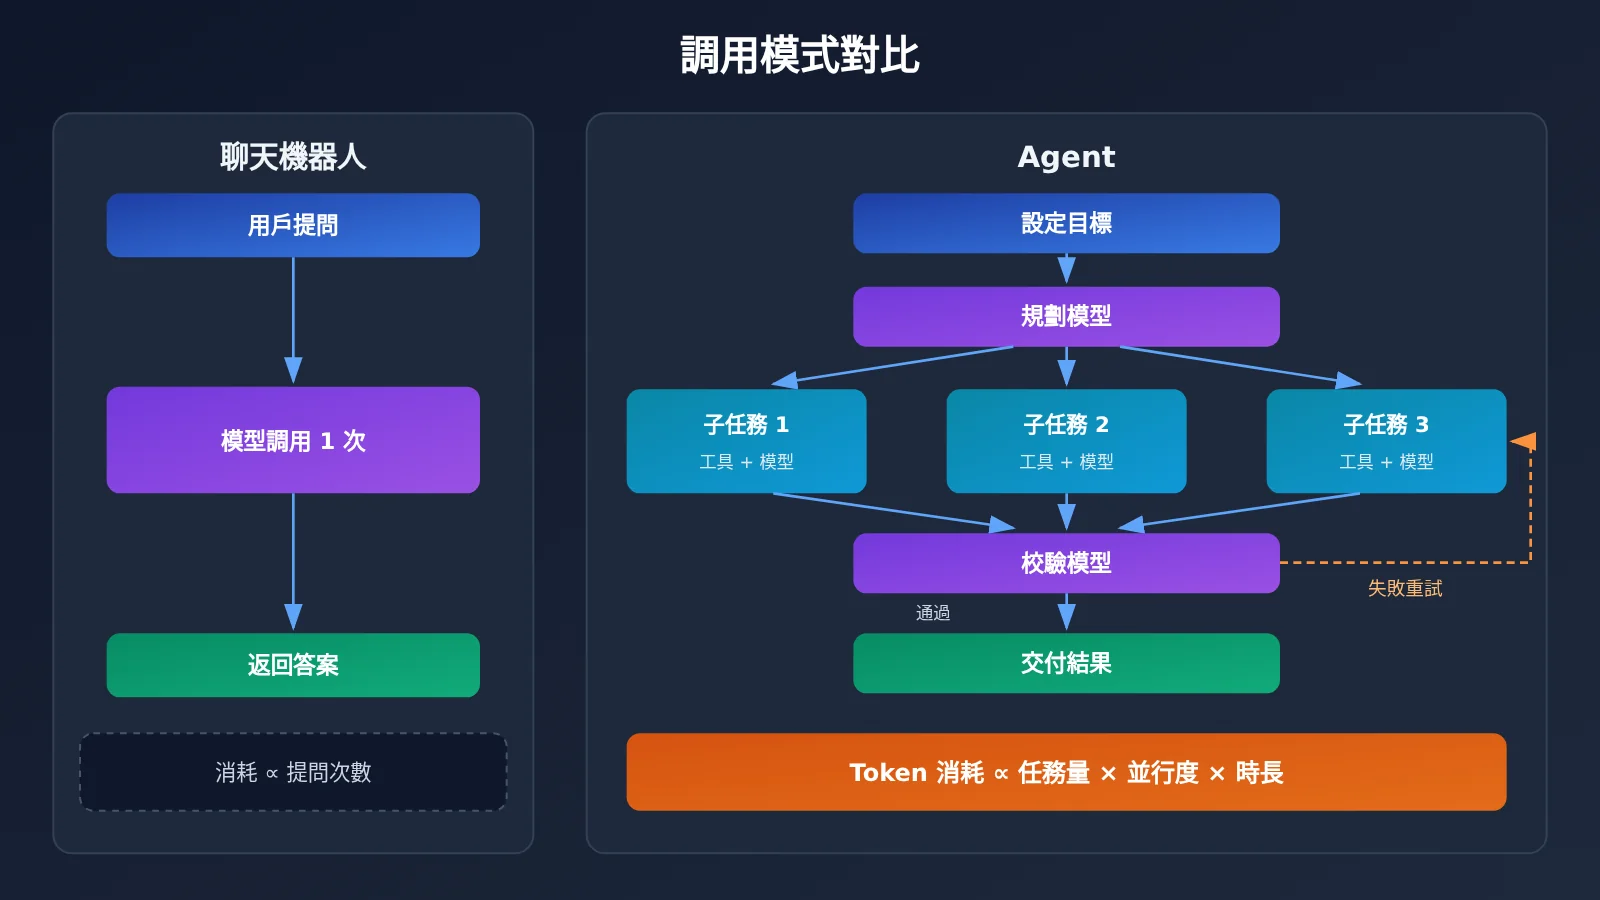
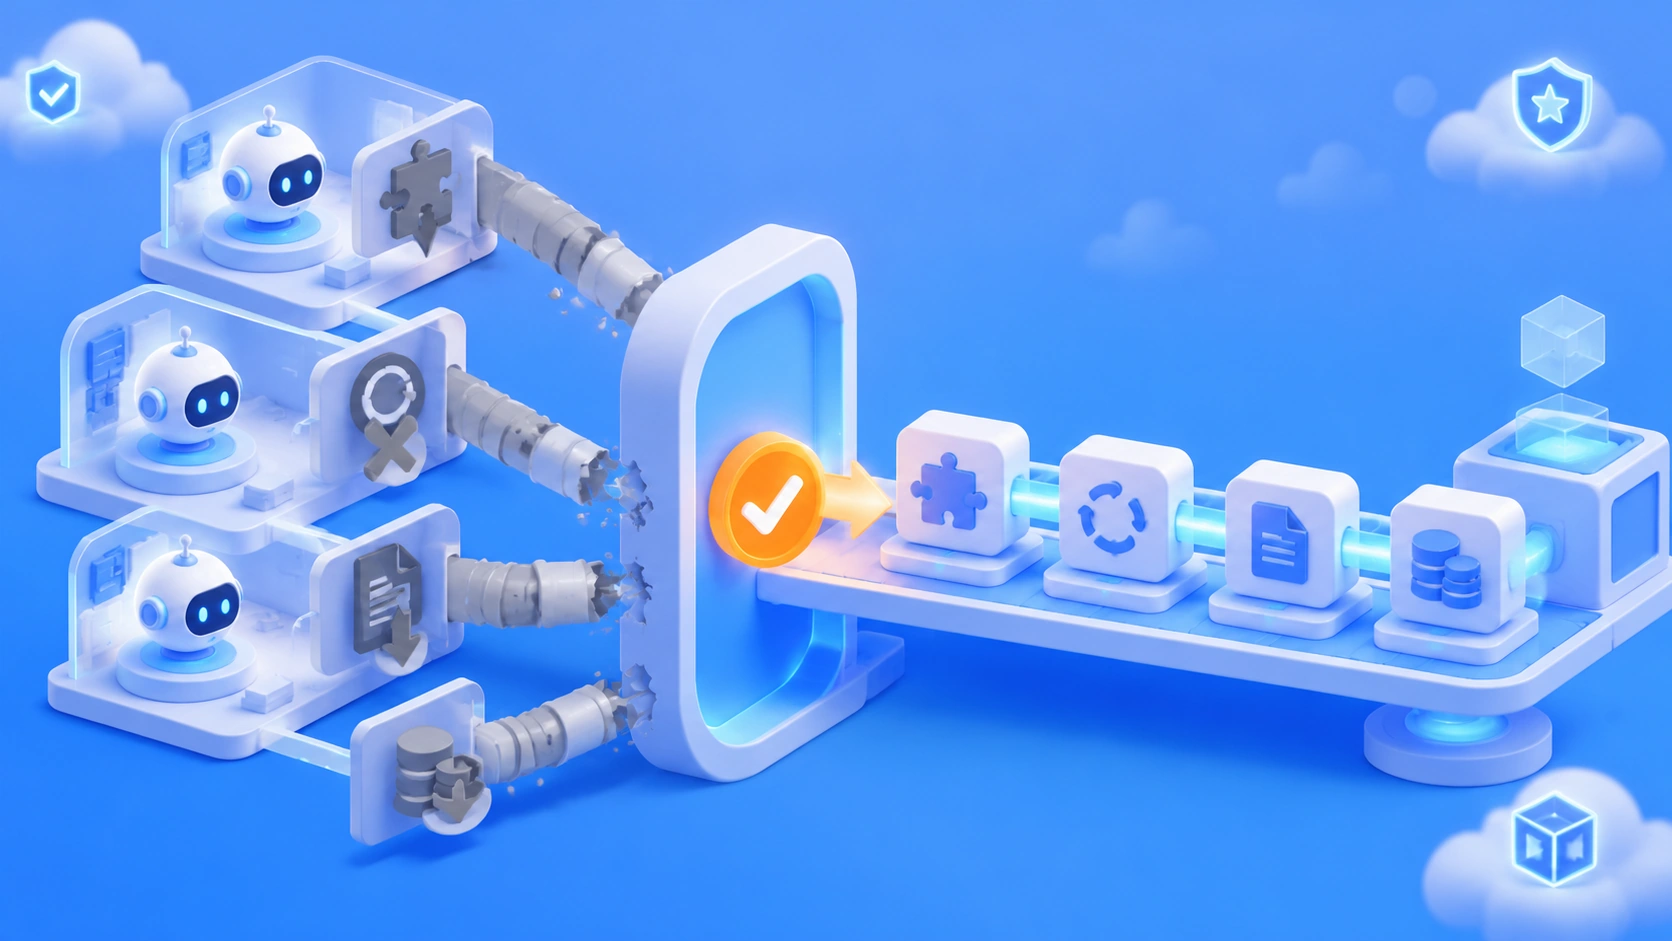
📊 圖示說明:右側的多模型 Agent 流程,在規劃、執行、校驗三個環節可以分別使用不同模型。如果想自己驗證這種調用結構,可以通過 API易 apiyi.com 用一個 Key 切換多家模型做對比。
Token 消耗與任務執行量掛鉤
Menlo 用 OpenRouter 數據觀察到:Agent 已佔該平臺總 Token 消耗的約 80%,每週約 130.9 萬億 Token。2026 年 2 月 Agent 流量超過人工驅動流量之後,Agent 流量增長約 37 倍,同期人工驅動流量只增長約 5 倍。
OpenRouter 的用戶以開發者和創業公司爲主,這組數據不能代表整個行業,但方向和其他信號一致。OpenAI 2025 年企業報告顯示,企業 API 每個組織的平均推理 Token 消耗同比增長約 320 倍。Axios 對 Codex 的報道也提到,超過 60% 的用戶會在一天中的某個時段同時運行多個任務。這些數據說明,Token 消耗正在從“跟着人走”變成“跟着任務走”。
企業 AI 支出流向:編程和企業聊天機器人爲何領先
AI 應用市場的資金分佈
在約 773 億美元的 AI 應用市場中,資金高度集中:
| 應用類別 | 2026 年估算規模 | 同比變化 |
|---|---|---|
| AI 編程應用 | 340 億美元 | 約 7.7 倍 |
| 企業 AI 聊天機器人 | 250 億美元 | 約 3 倍 |
| 醫療 AI 應用 | 37 億美元 | — |
| 編程 + 聊天合計佔比 | 約 76% | — |
編程領域集中度更高。Menlo 估算,Claude Code 和 Codex 合計約佔編程應用市場 240 億美元,接近七成。編程之所以最先跑通 Agent 模式,和下面三個條件直接相關。
Agent 成功落地的三個條件
- 有可執行操作的環境:Agent 需要接入 GitHub、郵件、日曆、Slack、企業文檔和數據庫。只有推理能力、沒有工具,無法完成真實工作。
- 有完整的任務上下文:除了用戶的問題,還需要企業規範、業務流程、項目歷史、操作約束和成功標準。
- 結果可以被驗證:編譯器能判斷代碼能否構建,測試能判斷功能是否正常。這是編程 Agent 領先的關鍵原因。相比之下,研究、檢索類任務的結果更難客觀校驗。
第三點也解釋了 Agent 的成本風險。在結果難以驗證的領域,Agent 可能消耗大量 Token 卻產出錯誤結論。Axios 報道過斯坦福教授 Andrew Hall 用 Claude Code 更新舊論文的案例,事後人工審查發現數據收集和代碼處理都有錯誤。
Agent 對 API 消費市場的影響分析
對 API 開發者的影響
- 成本模型要重算:按“用戶數 × 單價”估算 API 預算已經不準確,應改爲按“任務數 × 平均調用輪次 × 上下文長度”估算。
- 需要預算護欄:後臺持續運行的 Agent 必須設置單任務 Token 上限、最大迭代次數和失敗熔斷,否則就會出現類似企業預算 1.9 倍變 4.7 倍的情況。
- 多模型組合成爲常態:規劃用強模型,批量執行用低價模型,校驗用另一家模型做交叉檢查,這樣能明顯降低單位任務成本。
對 API 服務商的影響
Agent 帶來的需求變化可以歸納爲五類,每一類都對應服務商需要具備的能力:
| 需求變化 | 產生原因 | 服務商需要的能力 |
|---|---|---|
| 調用頻率增加 | 單任務需要多輪調用 | 低延遲、失敗重試 |
| 並行調用增加 | 多個 Agent 同時處理子任務 | 併發能力、限流策略 |
| 上下文消耗增加 | 攜帶文檔與工具返回結果 | 長上下文支持、緩存計費 |
| 持續運行增加 | 用戶離開後繼續執行 | 調用穩定性、用量監控 |
| 模型組合增加 | 規劃、執行、檢查分工 | 多模型統一接入與切換 |
💡 選擇建議:如果你的 Agent 工作流需要組合多家模型,可以先在 API易 apiyi.com 上用 OpenAI 兼容接口跑通原型,按量計費,方便統計每個環節的真實成本。
冷靜看待:企業 AI 支出不等於 API 收入
“Agent 越多,API 服務商收入就一定越高”這個推論並不成立,原因有三點:
- 1768 億美元中有很大一部分是基礎設施和應用訂閱,不是 API 調用費。
- 價格在持續下行。開源模型的 Token 使用佔比已升至 19%,支出佔比卻只有約 4%,說明 Token 量上漲不一定帶來同等的收入增長。
- 緩存、批處理和模型路由會壓低單位成本,競爭最終比拼的是穩定性和任務成功率,而不只是 Token 銷量。
如何用 API 搭建多模型 Agent 工作流
極簡示例
下面這段代碼演示 Agent 最基本的“規劃 → 執行”兩次調用,模型名請替換爲平臺控制檯中可用的模型:
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

plan = client.chat.completions.create(
    model="YOUR_PLANNER_MODEL",
    messages=[{"role": "user", "content": "把“整理本週銷售週報”拆成 3 個步驟"}]
).choices[0].message.content

result = client.chat.completions.create(
    model="YOUR_EXECUTOR_MODEL",
    messages=[{"role": "user", "content": f"按以下步驟執行並輸出結果:\n{plan}"}]
)
print(result.choices[0].message.content, result.usage.total_tokens)
查看完整實現代碼(含校驗、重試和 Token 預算)
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
)

MODELS = {
    "planner": "YOUR_PLANNER_MODEL",    # 強推理模型,負責拆解任務
    "executor": "YOUR_EXECUTOR_MODEL",  # 低價模型,負責批量執行
    "checker": "YOUR_CHECKER_MODEL",    # 另一家模型,交叉校驗
}
TOKEN_BUDGET = 50_000   # 單任務 Token 上限
MAX_ROUNDS = 3          # 最大迭代輪次

used_tokens = 0

def call(role: str, prompt: str, retries: int = 3) -> str:
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出單任務 Token 預算,熔斷")
    for i in range(retries):
        try:
            resp = client.chat.completions.create(
                model=MODELS[role],
                messages=[{"role": "user", "content": prompt}],
            )
            used_tokens += resp.usage.total_tokens
            return resp.choices[0].message.content
        except Exception as e:
            time.sleep(2 ** i)  # 指數退避
            last_err = e
    raise last_err

def run_agent(goal: str) -> str:
    plan = call("planner", f"將目標拆成可執行步驟:{goal}")
    output = call("executor", f"按步驟執行:\n{plan}")
    for _ in range(MAX_ROUNDS):
        verdict = call("checker", f"檢查結果是否滿足目標“{goal}”,"
                                  f"合格只回復 PASS,否則指出問題:\n{output}")
        if verdict.strip().startswith("PASS"):
            break
        output = call("executor", f"根據反饋修正:\n{verdict}\n原結果:\n{output}")
    print(f"本任務共消耗 Token:{used_tokens}")
    return output

print(run_agent("整理本週銷售數據並寫一份 300 字摘要"))
這段代碼體現了前文的幾個要點:一個任務至少 3 次調用,三個角色使用不同模型,並通過 Token 預算和迭代上限避免成本失控。
🚀 快速開始:建議先在 API易 apiyi.com 領取免費測試額度,分別爲三個角色試用不同模型,記錄
usage數據後再決定生產環境的模型組合。
常見問題 FAQ
Q1:2026 年企業 AI 支出 1770 億美元是什麼口徑?
這是 Menlo Ventures 自下而上估算的 2026 年企業使用 AI 的支出(原值 1768 億美元),包括基礎設施約 995 億美元和應用約 773 億美元。它是市場估算,不是審計後的付款總額,也不是 API 市場收入。
Q2:企業 AI 使用支出和模型開發支出有什麼區別?
模型開發支出指構建和訓練模型的投入,Menlo 估算約 1025 億美元。使用支出指企業爲完成工作而購買 AI 服務的花費。前者約爲後者的六成,說明商業化重心正在轉向“使用”。
Q3:爲什麼 Agent 會讓企業 AI 支出超出預算?
Agent 的消耗由任務量、並行度和運行時長決定。一個任務包含多輪調用,多個 Agent 並行運行,還能在後臺持續執行。企業沿用“按人數估算”的思路,自然會低估實際消耗。
Q4:OpenRouter 的 Agent 佔比 80% 能代表整個行業嗎?
不能。OpenRouter 的用戶以開發者和創業公司爲主,數據只能反映趨勢方向。企業內部私有部署、雲平臺直採等場景的結構可能有明顯差異,引用時需要說明樣本來源。
Q5:開發者如何低成本驗證多模型 Agent 方案?
建議用統一接口的聚合平臺做原型:
1. 訪問 API易 apiyi.com 註冊並獲取 API Key 和免費測試額度
2. 將上文示例的 base_url 和模型名替換爲控制檯中的配置
3. 分別記錄規劃、執行、校驗三個環節的 Token 用量,再優化模型組合
Q6:Agent 目前有哪些已知限制?
主要有三點。第一,結果難以驗證的任務容易出錯,仍需專業人員審查。第二,多個 Agent 並行運行會增加監督壓力,部分用戶反映會產生精神疲勞。第三,後臺運行的成本不容易預測。實踐中可以先在 API易 apiyi.com 用小額度跑通流程,並配置預算上限後再擴量。
企業 AI 支出與 Agent 核心要點 Key Takeaways
- 規模:Menlo 估算 2026 年企業 AI 使用支出約 1768 億美元,約爲上年的 5.4 倍。
- 預算偏差:企業平均實際支出爲上年的 4.7 倍,原計劃只有 1.9 倍。
- 增長來源:主要來自已採用企業的使用深度加深,而不是採用率上升。
- 調用機制:Agent 讓 Token 消耗與任務量、並行度、運行時長掛鉤。
- 落地條件:需要執行環境、完整上下文和可驗證的結果,編程領域因此領先。
- 理性判斷:企業 AI 支出不等於 API 收入,Token 增長也不等於收入同比增長。
- 上手方式:可通過 API易 apiyi.com 用一個 Key 組合多家模型,測算真實任務成本。
總結
2026 年企業 AI 支出的核心變化有三點:
- 從人驅動到任務驅動:模型消費的主體正在從“人類提問”轉向“Agent 持續執行”。
- 從工具費到獨立預算:過半新增支出來自新增預算,AI 正在成爲單獨管理的運營成本。
- 從賣 Token 到賣可靠性:API 服務的競爭重點會轉向穩定性、併發、多模型切換和用量監控。
對開發者和採購者來說,現在最值得做的是用真實任務測算“單任務成本”,而不是按人數估算預算。推薦通過 API易 apiyi.com 快速搭建多模型 Agent 原型,用實際 usage 數據爲下一年的 AI 預算提供依據。
📚 參考資料
- Menlo Ventures – 2026 The State of Enterprise AI:本文主要數據來源
- 鏈接:
menlovc.com/perspective/2026-the-state-of-enterprise-ai -
說明:包含企業 AI 支出、API 份額、OpenRouter Agent 數據及調研方法
-
Reuters – Brockman 談 OpenAI 企業收入:OpenAI 企業收入佔比過半
- 鏈接:
reuters.com/legal/transactional -
說明:2026 年 11 月 5 日報道,注意與 Menlo 的 API 份額屬於不同口徑
-
OpenAI – The State of Enterprise AI 2025:企業使用基線數據
- 鏈接:
openai.com/business/guides-and-resources/the-state-of-enterprise-ai-2025-report -
說明:包含每組織推理 Token 消耗同比約 320 倍等歷史數據
-
Axios – Office workers drive OpenAI’s Codex growth:Agent 多任務並行與監督問題
- 鏈接:
axios.com/2026/06/02/openai-codex-knowledge-workers - 說明:2026 年 6 月數據,適合瞭解知識工作者使用 Agent 的情況
作者:API易 技術團隊
技術交流:關於 Agent 工作流與多模型調用的實踐問題,歡迎在 API易 apiyi.com 首頁聯繫我們交流