作者注:以 OpenCode 上無人認領的免費隱身模型 Iceman 爲例,拆解官方聲明、目錄參數與未證實線索三層信息,給出接入前的 5 項覈查清單,並說明如何合併多個 id 解讀用量榜單。
免費、不限請求次數、上下文窗口很大,但沒人知道是誰做的。這類免費隱身模型最近在編程工具裏很常見,很多開發者第一反應是“先接進項目試試”。本文以 OpenCode 上的 Iceman 爲案例,回答一個具體問題:在把代碼或業務數據發給一個來源不明的免費模型之前,你需要確認什麼。
這不是一篇勸你別用的文章,免費隱身模型完全可以用於原型驗證和公開代碼實驗。關鍵在於分清哪些信息可以作爲使用依據,哪些只是傳聞,以及訓練與保留條款會對你的數據產生什麼實際影響。
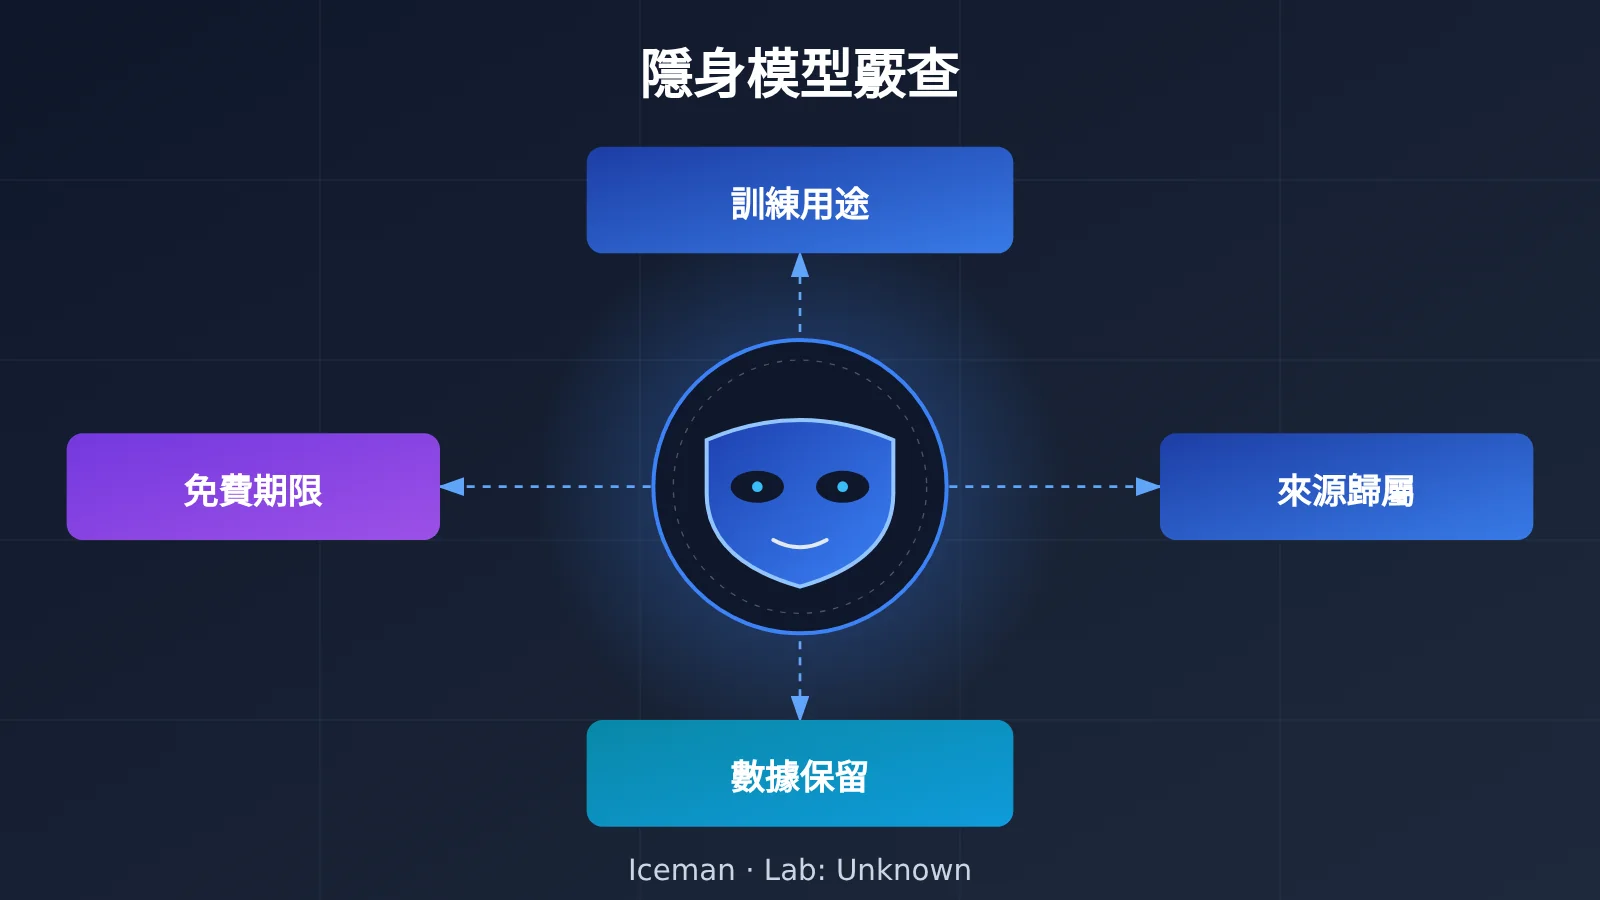
核心價值:讀完本文,你會得到一份可複用的隱身模型覈查清單,覆蓋數據訓練、零數據保留、免費期限和來源歸屬四個維度。你還能學會識別“換 id 造成的虛假增長”這類榜單誤讀。
免費隱身模型 Iceman 核心要點
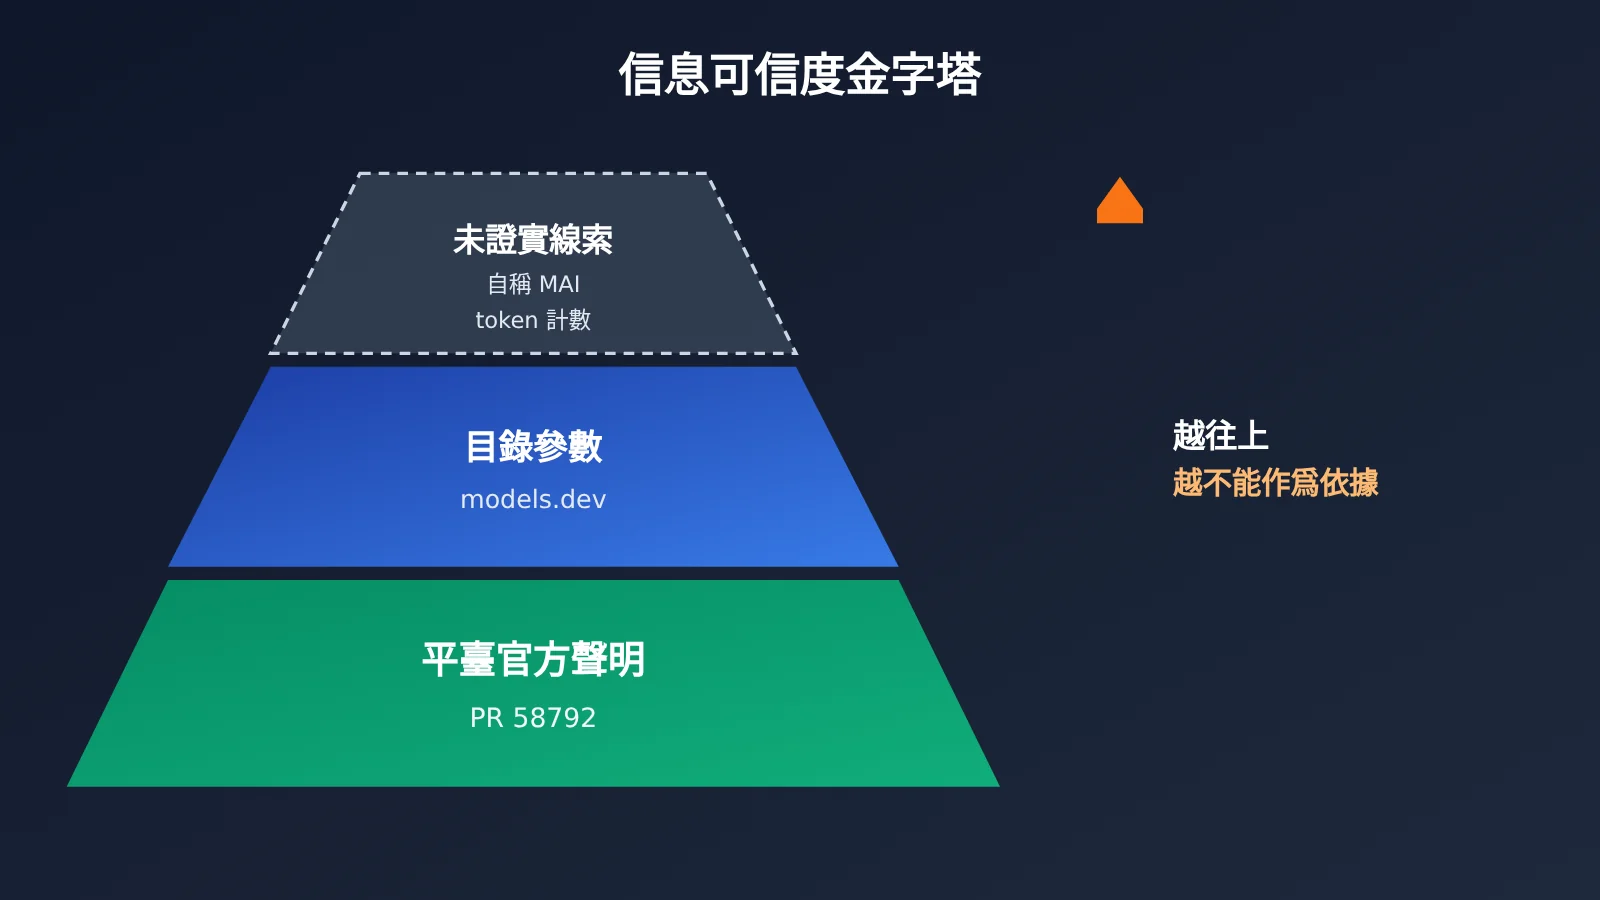
截至 2026-11-04 18:31 UTC,Iceman 仍未被任何 AI 實驗室認領。根據 OpenCode 用量數據,它從 10 月 23 日起在兩個 id 下累計運行了約 3.37 萬億 tokens。下表先把關於它的信息按可信度分成三層,這是後面所有判斷的基礎。
| 信息層次 | 具體內容 | 可否作爲使用依據 |
|---|---|---|
| 平臺官方聲明 | OpenCode 合併的 PR 58792:限時免費、無請求限制、提示詞用於訓練、非零數據保留 | ✅ 可以,這是條款層面的事實 |
| 目錄參數 | models.dev 目錄:262,144 上下文、最多 131,072 輸出 tokens、支持推理與工具調用、文本進文本出 | ✅ 可以,用於技術選型 |
| 未證實線索 | 第三方追蹤稱它自稱 Microsoft MAI,token 計數與 MAI Thinking 1 一致 | ❌ 不可以,只能當傳聞 |
隱身模型 Iceman 的官方條款詳解
OpenCode 在 10 月 24 日把 Iceman 加入每月 10 美元的 Go 套餐,對應倉庫中的 pull request 58792,於 20:24 UTC 合併。模型名稱爲 Iceman Contributor Free,條款寫明“限時免費、無請求限制”。同一處變更同時標註了兩件事:發給它的提示詞會被用於訓練,數據保留策略不是零數據保留。
這兩條纔是開發者最該關注的內容,它們比上下文窗口和輸出長度更直接地決定了能發什麼數據。此外,該 PR 把這個 id 加入了 OpenCode 的隱身模型列表,所以用量頁面上的實驗室一欄顯示爲 Unknown。換句話說,平臺本身也明確告訴你:來源未知。
隱身模型命名中 Contributor 的真實含義
很多人會把 iceman-contributor 裏的 Contributor 理解成某個實驗室或貢獻者的名字。實際上它指的是 OpenCode 的一種交換模式:用訓練數據換免費訪問。Meta 的 Muse Spark 1.3 與 1.2 也有 Contributor 版本,說明這是平臺層面的通用標籤,而不是模型來源的線索。
所以看到 Contributor 字樣時,正確的解讀是“這個通道的數據會進入訓練”,而不是“這是某家實驗室的貢獻版本”。這一點在後面的核查清單中會作爲第一項檢查。
免費隱身模型的訓練條款對代碼與隱私數據的影響
“提示詞用於訓練”聽起來抽象,落到項目裏就是一個很具體的問題:你發出去的每一段上下文,都可能成爲別人模型的訓練樣本。在編程工具場景下,上下文往往不只是你輸入的那句問題,還包括被自動帶上的文件內容、報錯日誌、配置文件甚至環境變量。
非零數據保留意味着請求內容會在服務端留存一段時間,具體多久、存在哪裏、由誰處理,在模型來源未知的情況下都無法確認。對於企業項目,這通常直接觸碰合同中的保密條款或數據合規要求。下表按數據類型列出實際風險。
| 數據類型 | 典型來源 | 訓練 + 非零保留下的風險 | 建議 |
|---|---|---|---|
| 開源或公開代碼 | 公開倉庫、示例項目 | 低,內容本已公開 | 可以使用 |
| 公司私有業務代碼 | 內部倉庫、核心算法 | 高,可能泄露實現細節與架構 | 不建議發送 |
| 密鑰與配置 | .env、配置文件、CI 腳本 |
極高,憑證可能留存並被訓練 | 必須排除 |
| 用戶隱私數據 | 日誌、數據庫樣本、工單 | 極高,涉及個人信息合規 | 禁止發送 |
| 合成或脫敏數據 | 測試夾具、Mock 數據 | 低到中,取決於脫敏質量 | 脫敏後可用 |
這裏要特別提醒編程類工具的“隱式上下文”問題。很多 Agent 會自動讀取工作區文件,你以爲只問了一個函數怎麼寫,實際上整個目錄結構和相鄰文件都可能被打包進請求。使用訓練類通道時,最穩妥的方式是在一個只包含公開或合成數據的獨立工作區裏操作。
如何覈查免費隱身模型:5 項接入前清單
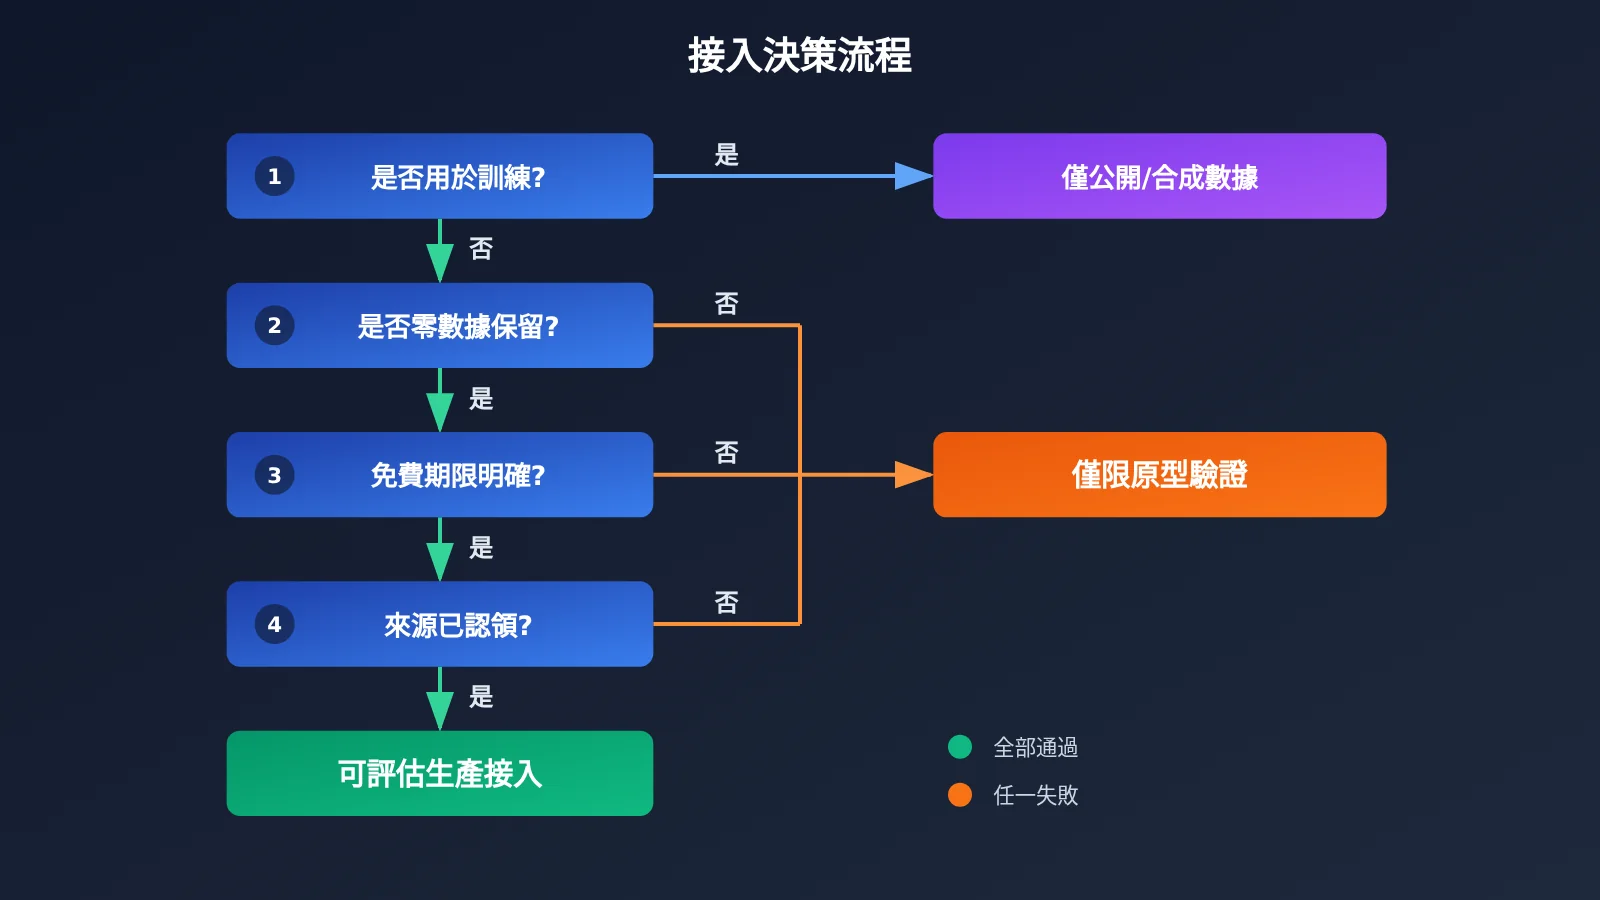
下面這份清單不針對 Iceman 一個模型,它適用於任何免費、來源未認領的模型。前四項來自條款與歸屬,第五項來自數據解讀,建議在團隊內部做成固定的評審流程。
| 序號 | 覈查項 | 去哪裏確認 | Iceman 當前狀態 |
|---|---|---|---|
| 1 | 提示詞是否用於訓練 | 平臺條款、模型配置變更記錄 | 是,用於訓練 |
| 2 | 是否零數據保留 | 平臺條款、隱私說明 | 否,非零數據保留 |
| 3 | 免費期限多長 | 平臺公告、套餐說明 | 僅寫“限時”,期限未知 |
| 4 | 來源歸屬是否確認 | 實驗室官方聲明 | 未確認,實驗室顯示 Unknown |
| 5 | 用量數據是否被 id 拆分 | 用量榜單的全部相關 id | 是,分爲 iceman 與 iceman-contributor |
隱身模型來源歸屬:爲什麼線索不等於確認
關於 Iceman 的來源,追蹤網站 stealthmodels.com 報道稱,X 賬號 @aitrackerbot 發現 Iceman 自我介紹爲 Microsoft 的 MAI,並且 prompt token 計數方式與 MAI Thinking 1 完全一致。但該網站自己的測試發現,它與 MAI Thinking 1 一致,與 OpenAI 的 GPT-6 系列也同樣一致。這意味着 token 計數無法區分這幾個模型。
模型“自稱是誰”同樣不可靠,模型會複述訓練數據中的身份信息,也可能被系統提示詞刻意設定。截至目前,Microsoft 沒有發表任何聲明。所以這條信息的正確定位是“一條線索”,而不能寫進你的技術選型文檔當作事實。
隱身模型認領的歷史先例
從 OpenCode 過往的隱身模型來看,認領通常發生在發佈時或幾周內。ox-alpha 由 Z.ai 認領爲 GLM-5.3 Flash,cat-jam 由 Reflection AI 認領爲 Beam,Space Bunny 則在首次出現 26 天后由 MiniMax 認領爲 M3.1 Flash。截至 11 月 4 日,Iceman 已上線 11 天,仍無人認領。
先例的價值在於提供預期,而不是預測。它告訴你認領可能要等幾周,在此期間模型的規模、來源和免費時長都是未知數,你的方案不能依賴這些未知數。
免費隱身模型快速上手:合併多 id 解讀用量榜單
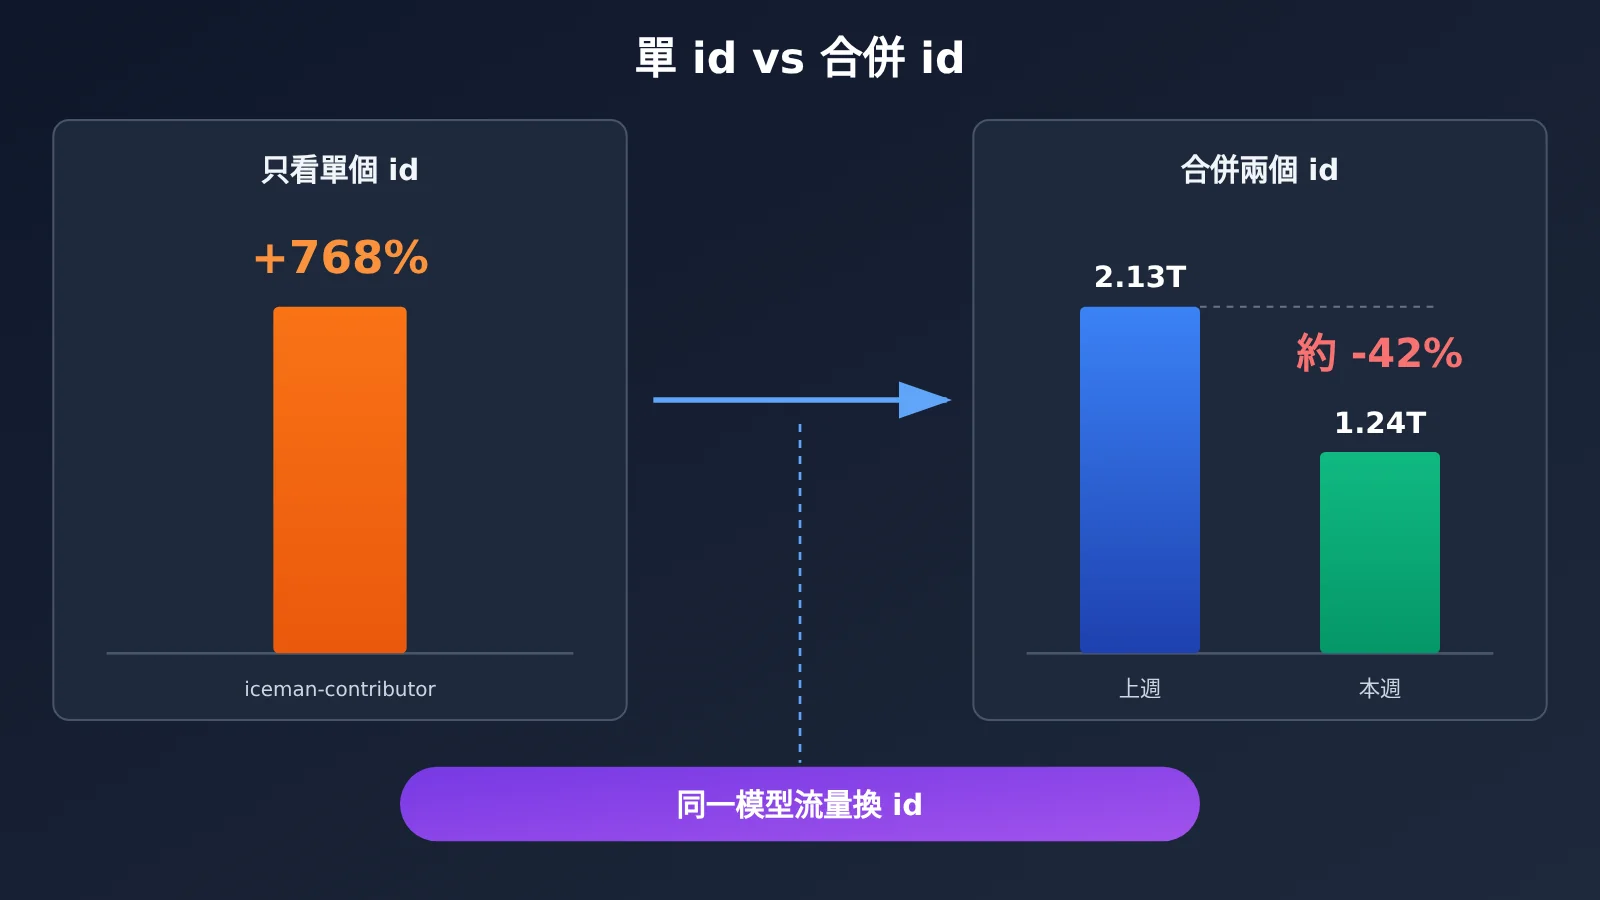
Iceman 在 OpenCode 周榜上的表現,是一個非常典型的榜單誤讀案例。如果只看單個 id,你會得出“爆發式增長”的結論;把兩個 id 合在一起看,結論正好相反。
| id | 周榜排名 | 本週 tokens | 環比變化 |
|---|---|---|---|
| iceman-contributor | #12 | 670B | +768% |
| iceman | #16 | 567B | -72% |
| 合計 | — | 約 1.24T | 約 -42%(上週約 2.13T) |
+768% 並不是增長,而是同一個模型的流量從一個 id 轉移到了另一個 id。兩個 id 合計過去 7 天運行約 1.24 萬億 tokens,比前一週的約 2.13 萬億下降了約 42%。日用量在 10 月 28 日達到峯值約 6,530 億 tokens,10 月 29 日至 11 月 3 日每天在 1,620 億到 2,510 億之間。
極簡示例:合併 id 計算真實環比
下面這段 Python 代碼演示了合併邏輯,數據取自上文的公開數字。上週各 id 的數值由本週數值和環比反推,因此是近似值。
# 同一模型的多個 id,本週 tokens(單位:十億)與環比變化
ids = {
    "iceman-contributor": {"this_week": 670, "change": 7.68},   # +768%
    "iceman":             {"this_week": 567, "change": -0.72},  # -72%
}

this_total = sum(v["this_week"] for v in ids.values())
# 由環比反推上週數值:last = this / (1 + change)
last_total = sum(v["this_week"] / (1 + v["change"]) for v in ids.values())

print(f"本週合計:{this_total}B")
print(f"上週合計(反推):{last_total:.0f}B")
print(f"合併後環比:{(this_total / last_total - 1):.1%}")
運行後可以得到本週約 1,237B、上週約 2,100B 量級、合併環比約 -41% 到 -42%,與報道給出的合計數據基本吻合。反推存在舍入誤差,實際分析中應直接讀取每個 id 的原始週數據。
查看完整實現:接入前的模型策略閘門
下面的代碼把覈查清單落成一個簡單的“策略閘門”。它不調用任何具體平臺的接口,只根據你手工覈查後填寫的元數據,決定某類數據能否發往某個模型。你可以把它放在自己的請求路由層前面。
from dataclasses import dataclass
from typing import Optional

@dataclass
class ModelPolicy:
    model_id: str
    used_for_training: bool          # 覈查項 1
    zero_data_retention: bool        # 覈查項 2
    free_until: Optional[str]        # 覈查項 3,None 表示期限未知
    lab_confirmed: bool              # 覈查項 4
    related_ids: tuple = ()          # 覈查項 5,用於合併統計

# 數據敏感等級:0 公開,1 脫敏/合成,2 私有代碼,3 密鑰或隱私
SENSITIVITY = {"public": 0, "synthetic": 1, "private_code": 2, "secret_or_pii": 3}

def max_allowed_level(p: ModelPolicy) -> int:
    """根據模型條款返回允許發送的最高敏感等級"""
    if p.used_for_training or not p.zero_data_retention:
        return 1          # 訓練或非零保留:只允許公開與合成數據
    if not p.lab_confirmed:
        return 1          # 來源未認領:同樣只限低敏數據
    return 2              # 條款與歸屬都確認後,才考慮私有代碼

def can_send(p: ModelPolicy, data_kind: str) -> bool:
    level = SENSITIVITY[data_kind]
    if level >= 3:
        return False      # 密鑰與隱私數據永遠不發往外部免費通道
    return level <= max_allowed_level(p)

def production_ready(p: ModelPolicy) -> list:
    """返回阻止生產接入的問題列表,空列表表示可進入評估"""
    issues = []
    if p.used_for_training:
        issues.append("提示詞用於訓練")
    if not p.zero_data_retention:
        issues.append("非零數據保留")
    if p.free_until is None:
        issues.append("免費期限未知,存在突然收費或下線風險")
    if not p.lab_confirmed:
        issues.append("來源未認領,無法評估模型規模與長期可用性")
    return issues

iceman = ModelPolicy(
    model_id="iceman-contributor",
    used_for_training=True,
    zero_data_retention=False,
    free_until=None,
    lab_confirmed=False,
    related_ids=("iceman", "iceman-contributor"),
)

for kind in SENSITIVITY:
    print(f"{kind:15s} -> {'允許' if can_send(iceman, kind) else '拒絕'}")

print("生產接入阻礙:", production_ready(iceman))
實踐建議:把上面的元數據當作團隊共享配置維護,每次平臺條款或模型認領狀態變化時更新一次。這樣新同事接入任何免費模型時,都能直接複用同一套判斷標準,而不是憑感覺決定。
常見問題 FAQ
Q1: 什麼是免費隱身模型?
隱身模型(stealth model)是指在平臺上以代號上線、實驗室身份暫不公開的模型。平臺的用量頁面通常把它的來源顯示爲 Unknown。Iceman 就是 OpenCode 隱身模型列表中的一員,截至 2026-11-04 尚未被認領。
Q2: Iceman 和 iceman-contributor 有什麼區別?
從公開數據看,它們是 OpenCode 用量榜單追蹤同一模型時使用的兩個 id,周榜上表現爲一個暴漲、一個暴跌,實際是流量在兩個 id 間轉移。Contributor 一詞指的是“用訓練數據換免費訪問”的平臺交換模式,而不是某個實驗室的名稱。
Q3: Iceman 的免費期會持續多久?
目前沒有公開答案。OpenCode 的變更只寫明“限時免費、無請求限制”,沒有給出截止日期。模型規模、開發方和免費時長都屬於目前未知的信息,因此不建議在生產方案中依賴它的免費狀態。
Q4: 免費隱身模型最適合哪些場景?
在條款明確“用於訓練、非零保留”的前提下,比較合適的場景包括:
– **開源項目實驗**:處理本就公開的代碼,例如給開源庫寫示例或測試。
– **能力摸底評估**:用合成題目測試它的推理與工具調用表現,瞭解大上下文下的行爲。
– **個人學習原型**:搭建不含真實數據的 Demo,驗證交互流程是否可行。
Q5: 如何在團隊裏落地這份隱身模型覈查清單?
建議分三步:先把 5 項覈查寫入模型准入文檔,再像上文的策略閘門那樣在路由層按數據敏感等級攔截,最後爲編程工具配置獨立的工作區,避免 Agent 自動帶上私有文件。條款變化時同步更新元數據即可。
Q6: 模型自稱是某家公司的產品,可以相信嗎?
不能直接相信。模型的自我介紹可能來自訓練語料或系統提示詞,而 token 計數方式也可能在多個模型間完全一致。以 Iceman 爲例,第三方測試發現其計數與 MAI Thinking 1 和 GPT-6 系列同樣吻合,無法據此區分。歸屬只能以實驗室的官方認領爲準。
Q7: 隱身模型被認領後,之前發送的數據會怎樣?
認領只改變來源歸屬的信息,不會改變你發送數據時適用的條款。如果當時條款寫明用於訓練且非零保留,那麼這些數據的處理方式就已經確定。這也是爲什麼覈查必須在發送之前完成,而不是等認領之後再補。
免費隱身模型核心要點 Key Takeaways
- 先看條款再看參數:訓練用途與數據保留決定能發什麼,上下文長度只決定能發多少。
- Contributor 是交換模式:它代表用訓練數據換免費訪問,不代表模型來源。
- 線索不等於確認:模型自稱身份和 token 計數都無法證明歸屬。
- 免費期限按未知處理:“限時”沒有截止日期,方案中不要依賴它。
- 榜單要合併 id 看:Iceman 的 +768% 合併後實爲約 -42%。
- 敏感數據一律隔離:密鑰、隱私數據和私有核心代碼不發往訓練類通道。
總結
免費隱身模型能不能接進項目,答案取決於你要發什麼數據,而不取決於它免不免費。以 Iceman 爲例,可以作爲依據的是平臺條款和目錄參數:用於訓練、非零數據保留、限時免費、262,144 上下文、支持推理與工具調用。不能作爲依據的是關於開發方的各種線索,它們在官方認領之前都只是傳聞。
可複用的方法論可以歸納爲三點:
- 分層看信息:把平臺聲明、目錄參數、未證實線索分開,只用前兩層做決策。
- 按數據分級用:訓練類通道只處理公開或合成數據,私有代碼和隱私數據另行處理。
- 合併口徑讀榜單:同一模型的多個 id 必須合計後再計算增長率,避免被換 id 造成的虛假增長誤導。
無論之後 Iceman 由誰認領,這套覈查方法都可以長期沿用到下一個出現的隱身模型上。
📚 參考資料
- ArtificialWatch – Iceman 用量與歸屬分析:本文核心事實來源
- 鏈接:
artificialwatch.com/wire/iceman-opencode-stealth-model-3-trillion-tokens-unclaimed -
說明: 彙總了 Iceman 的雙 id 用量、條款變更與歸屬線索,發佈於 2026-11-04
-
OpenCode Data 用量頁面:iceman 與 iceman-contributor 的用量數據
- 鏈接:
opencode.ai/data -
說明: 可直接查看各 id 的周榜排名與 token 用量
-
models.dev 模型目錄:Iceman 的技術參數
- 鏈接:
models.dev -
說明: 提供上下文窗口、最大輸出、推理與工具調用等目錄信息
-
stealthmodels.com 隱身模型追蹤:歸屬線索的報道來源
- 鏈接:
stealthmodels.com - 說明: 記錄了關於 Iceman 自稱身份與 token 計數的測試,僅作線索參考
作者: APIYI 技術團隊
說明: 本文事實截至 2026-11-04,Iceman 的認領狀態與免費期限可能隨時變化,請以平臺最新條款爲準。