作者注:基於官方展示、智東西與 TOKRACE 第三方實測,拆解 LongCat-2.5 在截圖轉網頁、交互頁面和 3D 生成上的真實能力、典型失敗案例與驗收邊界。
美團於 2026-11-02 正式發佈 LongCat-2.5,官方把 Visual Coding(視覺編程) 作爲重點能力之一,並展示了實時流體模擬、三星堆青銅神樹三維展示、照片生成活動邀請頁等案例。很多前端開發者看到後,第一個問題是:把一張設計稿或網頁截圖丟給它,能不能直接拿到一個可交付的網頁?
這不是一篇複述官方宣傳的文章。官方展示是挑選過的成功案例,第三方實測裏則同時出現了完成度很高的作品和尺寸錯 1000 倍的工程。本文把這兩類證據放在一起對照,並說明哪些結論有證據支撐、哪些目前還沒有。
核心價值:讀完本文,你會知道 LongCat-2.5 的視覺編程能做到什麼程度,網頁交付時應該從哪五個維度驗收,以及哪些環節必須由人複覈。
LongCat-2.5 視覺編程核心信息速覽
先把和視覺編程相關的公開事實整理成一張表。下面的信息來自美團官方技術博客、API 文檔和發佈報道,模型權重在發佈時尚未開放下載,所以“官方 API 已開放”不等於“已經開源”。
| 信息項 | 已公開內容 |
|---|---|
| 正式發佈時間 | 2026-11-02(Preview 版於 2026-09-25 上線 API 平臺) |
| 發佈方 | 美團 LongCat 團隊 |
| 模型規模 | 總參數 1.6T,每 Token 激活約 48B,稀疏 MoE 架構 |
| 上下文窗口 | 1,048,576 Tokens(約 1M) |
| 視覺輸入 | 圖片支持 PNG、JPG、JPEG、WebP、GIF;視頻通過 URL 輸入 |
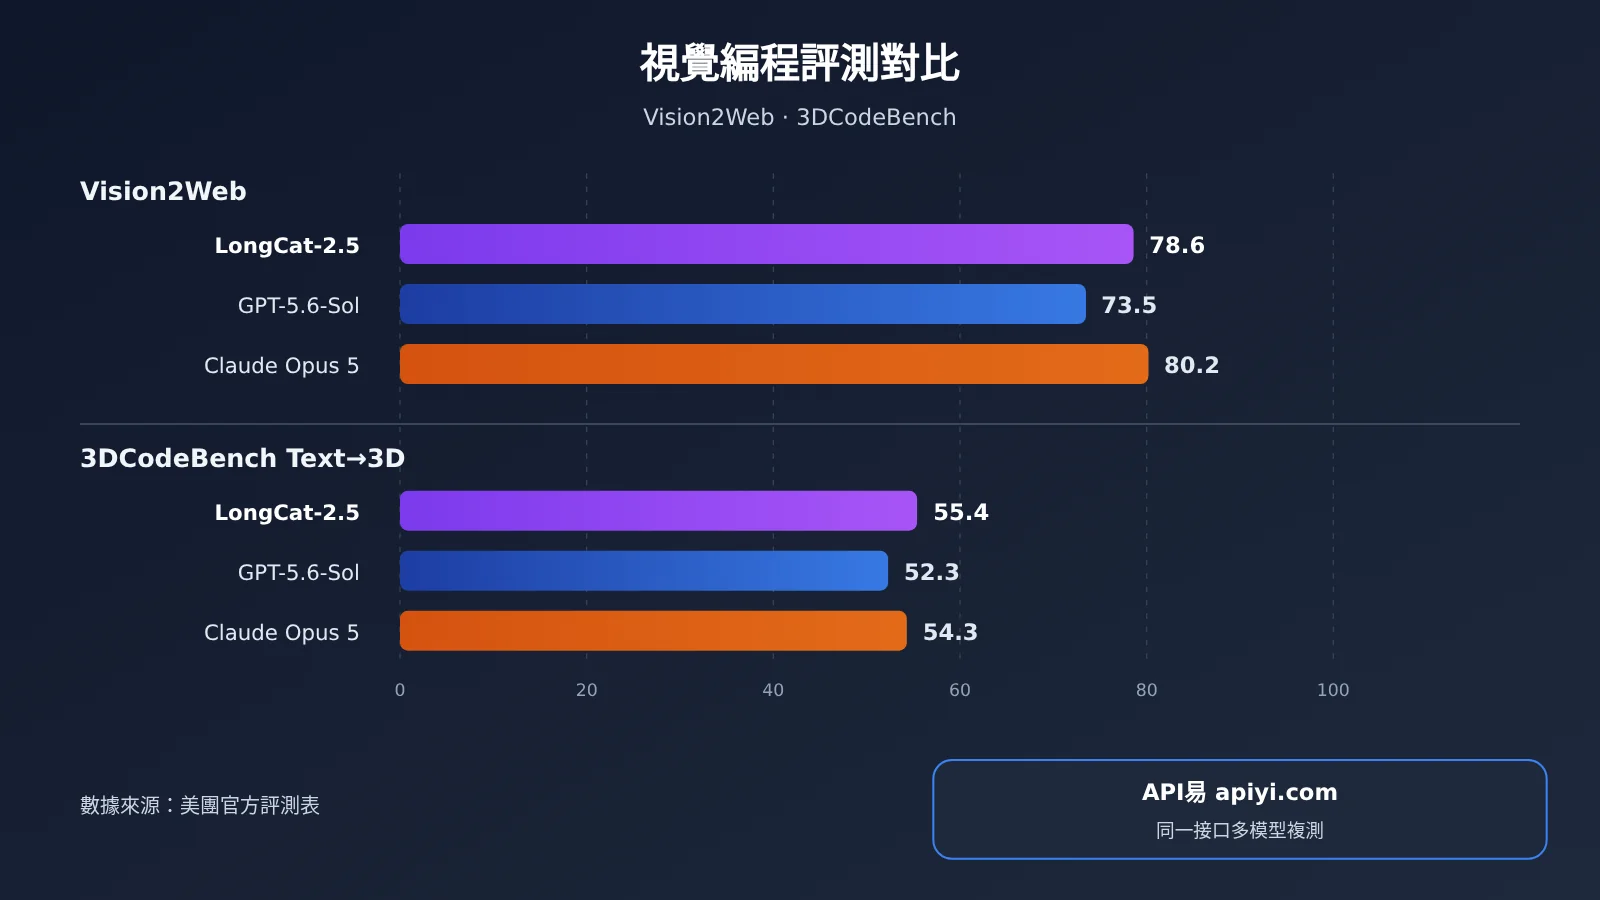
| 視覺編程相關成績 | Vision2Web 78.6、3DCodeBench Text→3D 55.4(官方表格) |
| 接口形式 | OpenAI 兼容與 Anthropic 兼容兩種格式 |
| 開源狀態 | 正式版權重發布時未開放,官方稱後續上線 |
需要特別注意的一點是:官方文檔支持的是圖像和視頻理解,並不代表 LongCat-2.5 提供圖片生成或視頻生成接口。第三方測試中出現的圖片和視頻,都是模型寫代碼後由 Blender、瀏覽器等工具渲染出來的。
截圖復刻與視覺參考生成網頁不是一回事
討論“截圖變網頁”之前,必須先把兩類任務分開。第一類是視覺參考生成:給一張場地照片或氛圍圖,再加一段文字需求,讓模型設計一個風格匹配的網頁。這類任務允許模型自由發揮佈局,只要“看起來對味”就算成功。
第二類是嚴格截圖復刻:給一張現成網頁截圖,要求在佈局、間距、字體、交互和響應式表現上儘量一致。這類任務的驗收標準硬得多,任何偏移都會被看出來。官方的活動邀請頁案例屬於前者,目前沒有足夠的獨立樣本證明 LongCat-2.5 在後者上的通用還原準確率,更不能說它已經能做到像素級復刻。
LongCat-2.5 視覺 Token 機制簡述
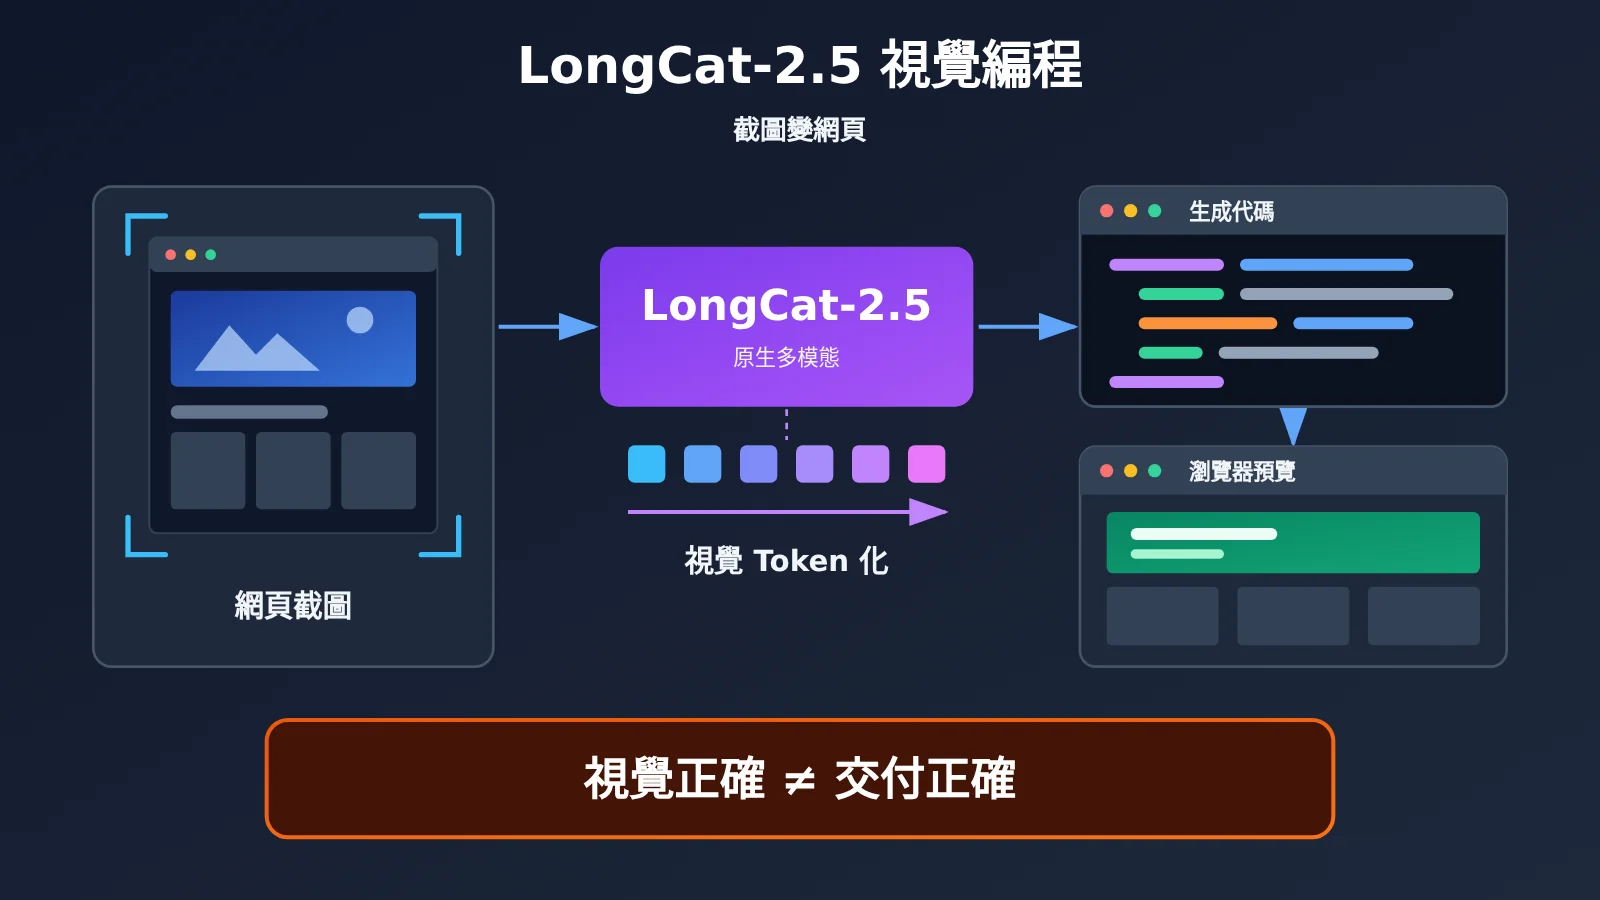
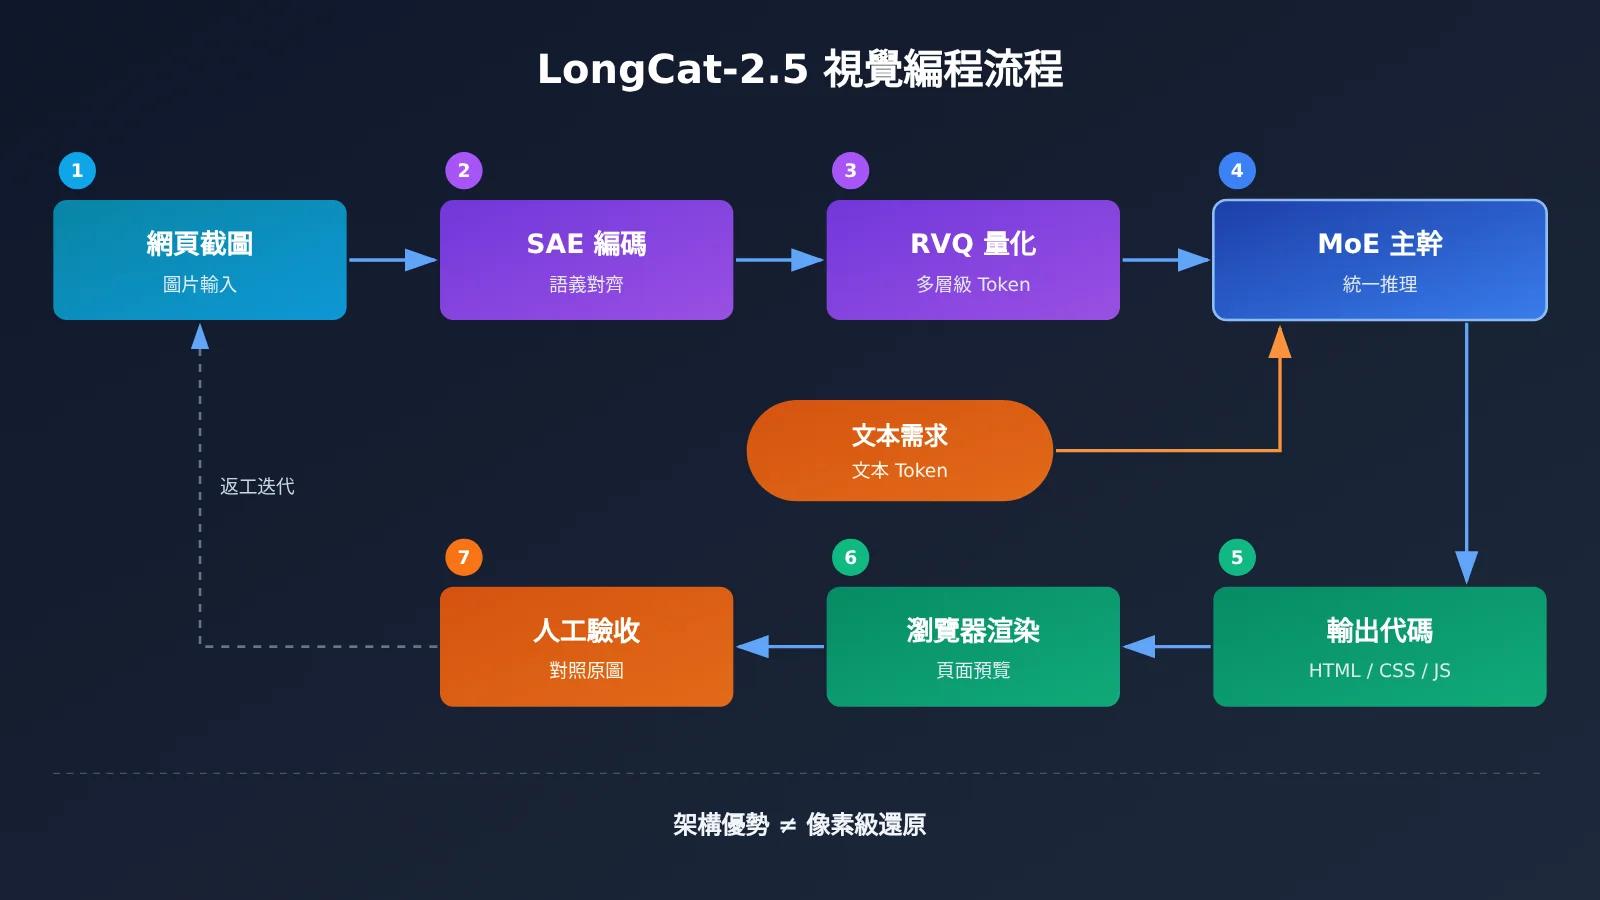
LongCat-2.5 的“原生多模態”來自它處理圖片的方式。官方披露,模型先用 SAE(語義對齊編碼器)提取視覺特徵,再通過 RVQ(殘差向量量化)把特徵編碼成多層級離散 Token,最後與文本 Token 一起進入主幹模型統一處理。
這套設計還包括原生分辨率視覺離散化、視覺 Token 離線預計算,以及視覺碼本 Embedding 與主幹模型聯合學習。對開發者來說,可以把它理解爲:圖片不是被“翻譯成一段文字描述”再交給模型,而是以接近原生的形式參與推理和寫代碼。不過,架構上的優勢只是能力基礎,並不等於每張截圖都能被準確還原。
LongCat-2.5 Vision2Web 成績怎麼看
官方公佈了兩項和視覺編程直接相關的 Benchmark。數據全部來自美團發佈的評測表,比較對象只有表內兩款模型,不覆蓋截至 2026-11-03 的全部最新模型。
| 評測項目 | LongCat-2.5 | GPT-5.6-Sol | Claude Opus 5 | 評測說明 |
|---|---|---|---|---|
| Vision2Web | 78.6 | 73.5 | 80.2 | Claude Code v2.1.7、256K 序列長度、top_k=50 |
| 3DCodeBench Text→3D | 55.4 | 52.3 | 54.3 | 文本生成 3D 代碼 |
| DeepSWE v1.1(參照) | 64.6 | 72.7 | 68.8 | 真實倉庫問題修復,mini-swe-agent |
從數字看,LongCat-2.5 在 Text→3D 上處於官方比較表的領先位置;Vision2Web 比 GPT-5.6-Sol 高 5.1 分,但比 Claude Opus 5 低 1.6 分。把 DeepSWE 放進來作爲參照很有必要:視覺編程最終仍要落到工程代碼上,而 LongCat-2.5 在真實軟件倉庫問題修復上和 GPT-5.6-Sol 還有 8.1 分的差距。
更重要的是,Benchmark 分數不等於像素級還原率,也不等於產品驗收通過率。LongCat-2.5 的默認評測設置是開啓思考、temperature=1.0、top_p=0.95,不同模型的部分成績來自公開報告、部分由美團自測,測試條件並不完全統一。
💡 選擇建議:公開榜單隻能當作參考,真正有意義的是在你自己的截圖和需求上跑一遍。通過 API易 apiyi.com 這樣的 OpenAI 兼容聚合接口,可以用同一份測試腳本對比多個視覺模型的輸出,再決定主力模型。
LongCat-2.5 視覺編程案例對照:成功與失敗
下面把三類來源的案例放在一起。官方展示是經過選取的成功案例,智東西和 TOKRACE 是第三方小樣本測試,三者的證據強度不同,閱讀時請注意區分。
| 來源 | 任務 | 實際要求 | 觀察結果 |
|---|---|---|---|
| 官方展示 | 實時流體模擬 | 交互式流體網頁 | 鼠標點擊、拖動可觸發流體效果 |
| 官方展示 | 活動邀請網頁 | 場地照片 + 自然語言需求 | 風格匹配,含報名表單、名單管理與導出 |
| 智東西 | 鵜鶘騎自行車動畫 | HTML 動畫 | 主體清晰、風格一致,圍巾局部位置偏差 |
| TOKRACE | 中文活動海報 SVG | 保留 6 段指定中文 | 6 段均正確且各出現一次,排版清晰 |
| TOKRACE | 季度數據圖表 SVG | 按數據畫柱狀圖 | 比例與彙總值 84 正確,但編造了財年、美元單位和數據來源 |
| TOKRACE | 行星減速器 3D | 140mm 尺寸及視頻交付 | 齒面破碎,寫成 140m,視頻未交付 |
| TOKRACE | 兩居室空間模型 | 室內佈局建模 | 門窗未開洞、牀與隔牆重疊、次臥方位錯誤 |
官方展示:視覺參考 + 交互邏輯的成功樣本
官方博客共列出八項端到端任務,和網頁直接相關的有流體模擬、三星堆青銅神樹三維展示、城市沙盤、中國風視覺設計和活動邀請網頁。三星堆案例需要同時處理三維結構、材質和旋轉縮放交互,活動邀請頁則需要把照片氛圍轉成頁面風格,並實現報名、名單管理和表格導出。
這些案例能證明 LongCat-2.5 具備把視覺要求轉成可運行前端代碼的能力。但它們不能證明“所有交互式網頁都能一次完成”,也不能說明頁面性能已經達到商業上線標準。
智東西實測:整體完成度高,局部細節仍需修
智東西在 2026-11-02 讓 LongCat-2.5 生成鵜鶘騎自行車的 HTML 動畫。記者觀察到動畫整體完成度較高、主體清晰、風格統一、細節豐富,但圍巾的局部位置略有偏差。
另一項亞馬遜第三季度財報 PPT 任務裏,分析框架完整,有趨勢圖、結構圖和風險提示,記者初步比對未發現明顯數據錯誤。問題集中在呈現層:部分頁面信息密度偏高、字號偏小,個別結論表達過於絕對。這對網頁開發同樣有啓示,內容基本正確不代表可讀性和佈局合格。
TOKRACE 實測:約束越明確,成功率越高
TOKRACE 把 LongCat-2.5 接入 Claude Code,配合 Blender 和瀏覽器完成 15 項創作任務,其中 6 項 3D、4 項知識視頻、4 項靜態 SVG、1 項動畫。成功案例有一個共同特徵:約束清晰、結構簡單。
- 參數化書架:0.8m 三格版和 1.0m 四格版尺寸正確,18mm 板厚符合要求,六張視角圖交付完整,耗時約 36 分鐘、47 次請求、輸出 69,708 Token。
- 中文活動海報:約 3 分鐘、10 次請求完成,六段中文全部正確保留,圖標沒有擠壓正文。
- 4 秒騎行動畫:輪子、腳踏和雙腿同步,測試方抽查 40 個時點,腳端與腳踏最大偏差約 0.19px,但淺色主體對比度偏低。
失敗案例則暴露了視覺編程最容易忽視的問題。行星減速器任務中,三顆行星輪位置基本正確,但 140mm 被寫成 140m,出現 1000 倍單位錯誤,要求的視頻也沒有交付;兩居室模型“看上去像個客廳”,卻存在門窗未開洞、牀與隔牆重疊、部分機位被牆體遮擋等結構錯誤。鐘錶 SVG 的 9:41 指針角度正確,數字卻和粗刻度重疊。
TOKRACE 還做了思考模式對照:開啓思考後部分畫面排版更清晰,但推理和請求成本可能明顯增加;在鵜鶘騎車 SVG 對照中,關閉思考首次請求就成圖,開啓思考到第 5 次請求才成圖。這只是單個任務的觀察,不能推導出開關思考的平均成功率。
LongCat-2.5 視覺編程的五個驗收維度
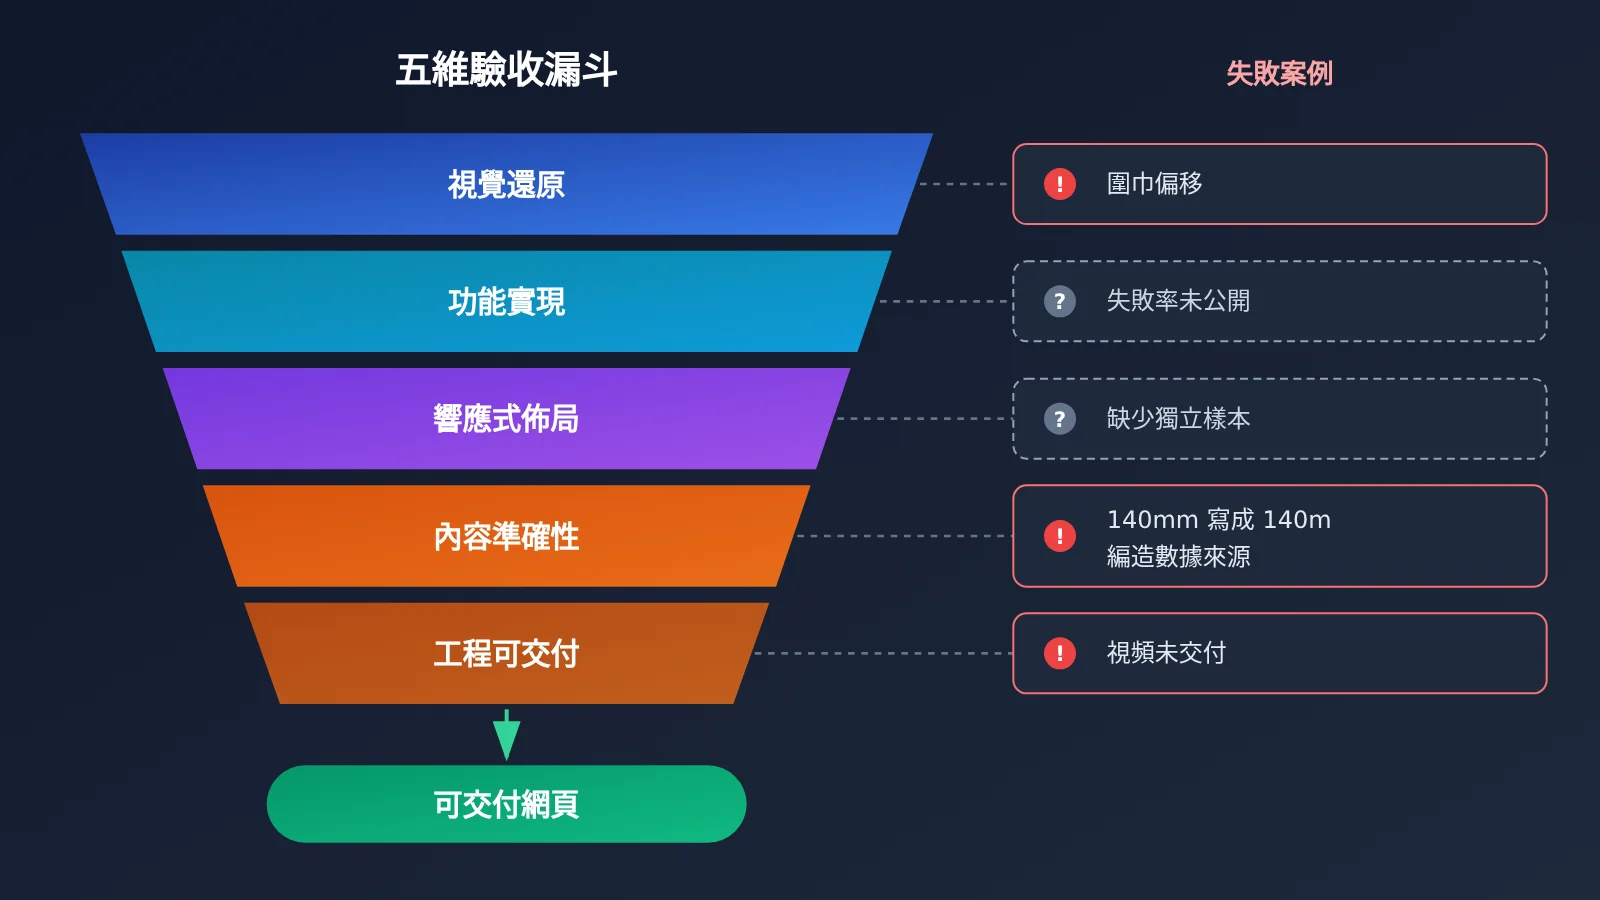
從上面的案例可以看出,“看起來對”和“能交付”之間至少隔着四道關。下面這套驗收框架是根據案例整理的工程檢查方法,不是 LongCat 官方的評測標準。
| 驗收維度 | 檢查內容 | 案例中暴露的風險 | 建議檢查方式 |
|---|---|---|---|
| 視覺還原 | 配色、佈局、字體、間距、圖形 | 圍巾偏移、數字與刻度重疊 | 與原圖疊加對比,逐區域截圖覈對 |
| 功能實現 | 點擊、導航、表單、狀態變化 | 官方展示未公開失敗率 | 手動走一遍主流程,寫簡單 E2E 測試 |
| 響應式佈局 | 不同屏寬下是否溢出、遮擋 | 目前缺少獨立樣本 | 至少檢查手機、平板、桌面三個斷點 |
| 內容準確性 | 數字、單位、文案、來源 | 編造財年和數據來源、140mm 寫成 140m | 逐項覈對所有文字和單位 |
| 工程可交付 | 依賴安裝、運行、打包、文件齊全 | 視頻未交付、長任務超時中斷 | 按交付清單逐項勾選 |
這五個維度裏,最容易被 AI 生成結果“騙過去”的是內容準確性和工程可交付。一個頁面配色漂亮、動畫流暢,很容易讓人忽略裏面多出來的一個虛構數據來源,或者少交的一個文件。截圖轉網頁時,建議把“模型額外添加了什麼”單獨列爲一個檢查項。
如何用 API 測試 LongCat-2.5 截圖轉網頁
如果你想在自己的設計稿上驗證 LongCat-2.5,可以用 OpenAI 兼容格式發送“圖片 + 文字需求”。圖片支持 Base64 和公開 URL,單張最大 10MB,單次請求最多 50 張,原始寬高比超過 200:1 會報錯,長截圖需要先切分。
需要說明的是,截至本文覈查日期(2026-11-03),尚未確認 API易 平臺已上線 LongCat-2.5,模型是否可用請以 API易 模型列表爲準。下面的腳本採用標準 OpenAI 格式,同一份代碼也可以先接入平臺上已有的視覺模型跑通流程,模型上線後只需替換模型名。
極簡示例
import base64, openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
img = base64.b64encode(open("screenshot.png", "rb").read()).decode()

resp = client.chat.completions.create(
    model="LongCat-2.5",  # 以 API易 模型列表中的實際名稱爲準
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "按截圖復刻爲單文件 HTML,只用截圖中出現的文字,不要補充任何數據"},
        {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{img}"}}
    ]}],
)
print(resp.choices[0].message.content)
查看完整實現代碼(含驗收約束與重試)
import base64
import time
import openai
from pathlib import Path

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

SYSTEM_PROMPT = """你是前端工程師。根據截圖生成單文件 HTML(內聯 CSS/JS)。
硬性要求:
1. 只使用截圖中可見的文字,禁止補充數據、單位、來源或年份
2. 無法辨認的文字用 [待確認] 佔位
3. 支持 375px / 768px / 1440px 三個斷點
4. 代碼末尾用註釋列出:你做的假設、未實現的交互"""

def encode_image(path: str) -> str:
    data = Path(path).read_bytes()
    if len(data) > 10 * 1024 * 1024:
        raise ValueError("單張圖片超過 10MB,請壓縮後再試")
    return base64.b64encode(data).decode()

def screenshot_to_html(path: str, model: str = "LongCat-2.5",
                       retries: int = 3) -> str:
    img = encode_image(path)
    messages = [
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": [
            {"type": "text", "text": "請復刻這張網頁截圖。"},
            {"type": "image_url",
             "image_url": {"url": f"data:image/png;base64,{img}"}},
        ]},
    ]
    for i in range(retries):
        try:
            resp = client.chat.completions.create(
                model=model, messages=messages, max_tokens=16000
            )
            return resp.choices[0].message.content
        except openai.RateLimitError:
            time.sleep(2 ** i)  # 429 限流時指數退避
    raise RuntimeError("多次重試失敗")

if __name__ == "__main__":
    html = screenshot_to_html("screenshot.png")
    Path("output.html").write_text(html, encoding="utf-8")
    print("已生成 output.html,請按五維清單驗收")
代碼裏有兩處設計值得說明。一是在系統提示詞中明確禁止補充數據、單位和來源,這是針對 TOKRACE 圖表案例中“編造財年和數據來源”問題的直接防護;二是要求模型在代碼末尾列出自己的假設,便於人工複覈時快速定位“猜”出來的部分。思考模式的具體請求結構,請以 LongCat 官方參數文檔爲準,不要直接套用其他模型的 reasoning 參數。
🚀 快速上手:建議先通過 API易 apiyi.com 領取新用戶免費測試額度,用 3-5 張不同複雜度的截圖(落地頁、表單頁、數據看板)跑一遍完整流程,按五維清單打分後再決定是否納入正式工作流。
LongCat-2.5 視覺編程影響分析
對前端開發者的影響
- 原型階段提效明顯:從視覺參考快速生成可交互頁面,適合做方案演示、活動頁初稿和內部工具,官方活動邀請頁和 TOKRACE 海報案例都屬於這一類。
- 驗收工作量不會消失:模型能寫出“看起來對”的頁面,但單位、文案、結構關係的錯誤更隱蔽,開發者的角色會從“寫代碼”部分轉向“定約束和做驗收”。
- 約束寫得越清楚越好:書架案例給出明確尺寸和交付清單後表現良好,模糊需求則更容易出現自由發揮。
對 AI Coding 工作流的影響
LongCat-2.5 官方文檔提供了 Claude Code、Codex、OpenCode、Cline 等工具的接入指南,通常只需改 Base URL、API Key 和模型名。這意味着視覺編程可以被放進已有的 Agent 工作流,而不是單獨開一個聊天窗口。不過兼容 API 格式不代表所有工具功能和參數都完全一致,長任務還可能出現超時或中斷,TOKRACE 的部分視頻任務就因此沒有完成。
成本方面,官方當前標註的限時優惠價爲未命中緩存輸入 ¥2.00、命中緩存輸入 ¥0.04、輸出 ¥8.00(每百萬 Token),實際以官方平臺和賬單爲準。書架這類多輪任務輸出接近 7 萬 Token,在規劃視覺編程批量任務時,請求次數和輸出長度比單價更值得關注。
LongCat-2.5 截圖轉網頁的使用邊界
結合全部證據,可以把使用場景分成三檔:
| 檔位 | 典型場景 | 建議做法 |
|---|---|---|
| 可以直接用 | 活動頁初稿、SVG 海報、簡單交互動畫、內部演示頁 | 生成後做視覺和文案檢查即可 |
| 需要人工複覈 | 截圖復刻上線頁面、數據圖表、響應式落地頁、多步驟表單 | 按五維清單逐項驗收,重點核對數據與單位 |
| 不建議依賴 | 高精度工程尺寸、空間結構設計、需要像素級還原的品牌頁、無人值守長任務 | 只用於草稿,最終交付由人完成 |
💰 成本建議:視覺編程往往需要多輪迭代,建議先用小批量截圖測算單頁面平均 Token 消耗。API易 apiyi.com 按量計費、提供統一賬單,便於在多個模型之間橫向比較單頁面成本。
常見問題 FAQ
Q1:LongCat-2.5 能把一張截圖直接變成完整網頁嗎?
能生成可運行的網頁,但“完整可交付”需要打折扣。官方展示和第三方測試證明它能把視覺參考轉成帶交互的前端代碼,但目前沒有獨立樣本證明其截圖復刻的通用準確率,也不能宣稱已實現像素級還原。
Q2:LongCat-2.5 的 Vision2Web 成績和 Claude Opus 5 比怎麼樣?
官方表格中 LongCat-2.5 爲 78.6,Claude Opus 5 爲 80.2,GPT-5.6-Sol 爲 73.5。LongCat-2.5 在 Text→3D 上領先,但 Vision2Web 仍略低於 Claude Opus 5。這些都是美團公佈的數據,測試條件不完全統一,建議用自己的任務複測。
Q3:LongCat-2.5 視覺編程最常見的失敗是什麼?
從 TOKRACE 測試看,主要有四類:單位錯誤(140mm 寫成 140m)、空間結構錯誤(牀與隔牆重疊)、編造內容(圖表中添加不存在的數據來源)、交付不完整(要求的視頻未生成)。這些問題在視覺上往往不明顯,必須專門檢查。
Q4:可以通過 API易 調用 LongCat-2.5 嗎?
截至 2026-11-03,尚未確認 API易 平臺已接入 LongCat-2.5,請以 API易 apiyi.com 的實時模型列表爲準。你可以先用本文的 OpenAI 兼容腳本接入平臺已有的視覺模型跑通驗收流程,模型上線後替換模型名即可。
Q5:做截圖轉網頁時開啓思考模式更好嗎?
沒有統一結論。TOKRACE 觀察到開啓思考後部分排版更清晰,但成本可能明顯增加,鵜鶘 SVG 對照中關閉思考反而首次成圖。建議在 API易 apiyi.com 上用同一批截圖分別測試,用實際成功率和 Token 消耗來決定。
Q6:LongCat-2.5 能生成圖片或視頻嗎?
官方 API 支持的是圖片和視頻理解,不是生成。第三方測試中的圖片、視頻和 3D 畫面,都是模型寫代碼後由瀏覽器、Blender 等工具渲染出來的,不能視爲模型原生的圖像生成能力。
LongCat-2.5 視覺編程核心要點 Key Takeaways
- 能力定位:LongCat-2.5 能把視覺參考轉成可運行網頁代碼,但不等於像素級截圖復刻。
- 官方成績:Vision2Web 78.6,略低於 Claude Opus 5;Text→3D 55.4,在官方比較表中領先。
- 成功規律:約束明確、結構簡單的任務完成度高,如海報 SVG 和參數化書架。
- 失敗規律:單位、空間關係、虛構內容和交付完整性是主要風險點。
- 驗收方法:從視覺還原、功能、響應式、內容準確性、工程可交付五個維度逐項檢查。
- 上手方式:可在 API易 apiyi.com 用 OpenAI 兼容腳本搭建測試流程,LongCat-2.5 可用性以模型列表爲準。
總結
LongCat-2.5 截圖轉網頁能力的核心結論:
- 能做原型,不等於能直接交付:官方案例和第三方測試都證明了視覺編程能力,但截圖到上線頁面之間仍有明顯差距。
- 視覺正確只是第一關:交互、響應式、內容準確性和工程完整性需要單獨驗收,其中“模型額外添加了什麼”最容易被忽略。
- 用約束換穩定性:明確尺寸、文案、斷點和交付清單,並在提示詞裏禁止補充數據,能顯著減少自由發揮帶來的錯誤。
如果你打算把視覺編程納入日常開發,建議先用自己的真實截圖做一輪小樣本測試,再按本文的三檔邊界劃定使用範圍。推薦通過 API易 apiyi.com 用統一接口對比多個視覺模型的實際表現,平臺提供新用戶免費額度,方便低成本驗證。
📚 參考資料
- LongCat-2.5 官方技術博客:模型架構、Benchmark 與官方展示案例
- 鏈接:
longcat.ai/blog/longcat-2.5 -
說明:Vision2Web、3DCodeBench 成績及評測條件的原始出處
-
美團技術團隊博客:LongCat-2.5 視覺 Token 技術說明
- 鏈接:
tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html -
說明:SAE、RVQ 等視覺編碼機制介紹
-
LongCat 視覺理解接口文檔:圖片與視頻輸入限制
- 鏈接:
longcat.ai/platform/docs/image-video-understanding -
說明:圖片格式、大小、數量與寬高比限制
-
智東西實測報道:鵜鶘動畫與財報 PPT 測試
- 鏈接:
tech.ifeng.com/c/8xjHpT7wJEN -
說明:媒體視角的正式版使用體驗
-
TOKRACE 正式版測試:15 項創作任務案例記錄
- 鏈接:
www.tokrace.com/zh-CN/guides/longcat-2-5-release - 說明:包含原始圖片、工程與運行記錄,成功與失敗案例均有
作者:APIYI 技術團隊
技術交流:歡迎訪問 API易 apiyi.com 首頁聯繫我們,更多接入資料可查閱 docs.apiyi.com 文檔中心