Примечание автора: разбираем новинку LongCat 2.5. В статье — параметры и архитектура модели, 8 официальных примеров, результаты 25 тестов разработчиков, расчёт стоимости по временным скидочным тарифам и способы подключения к Claude Code и Cline.
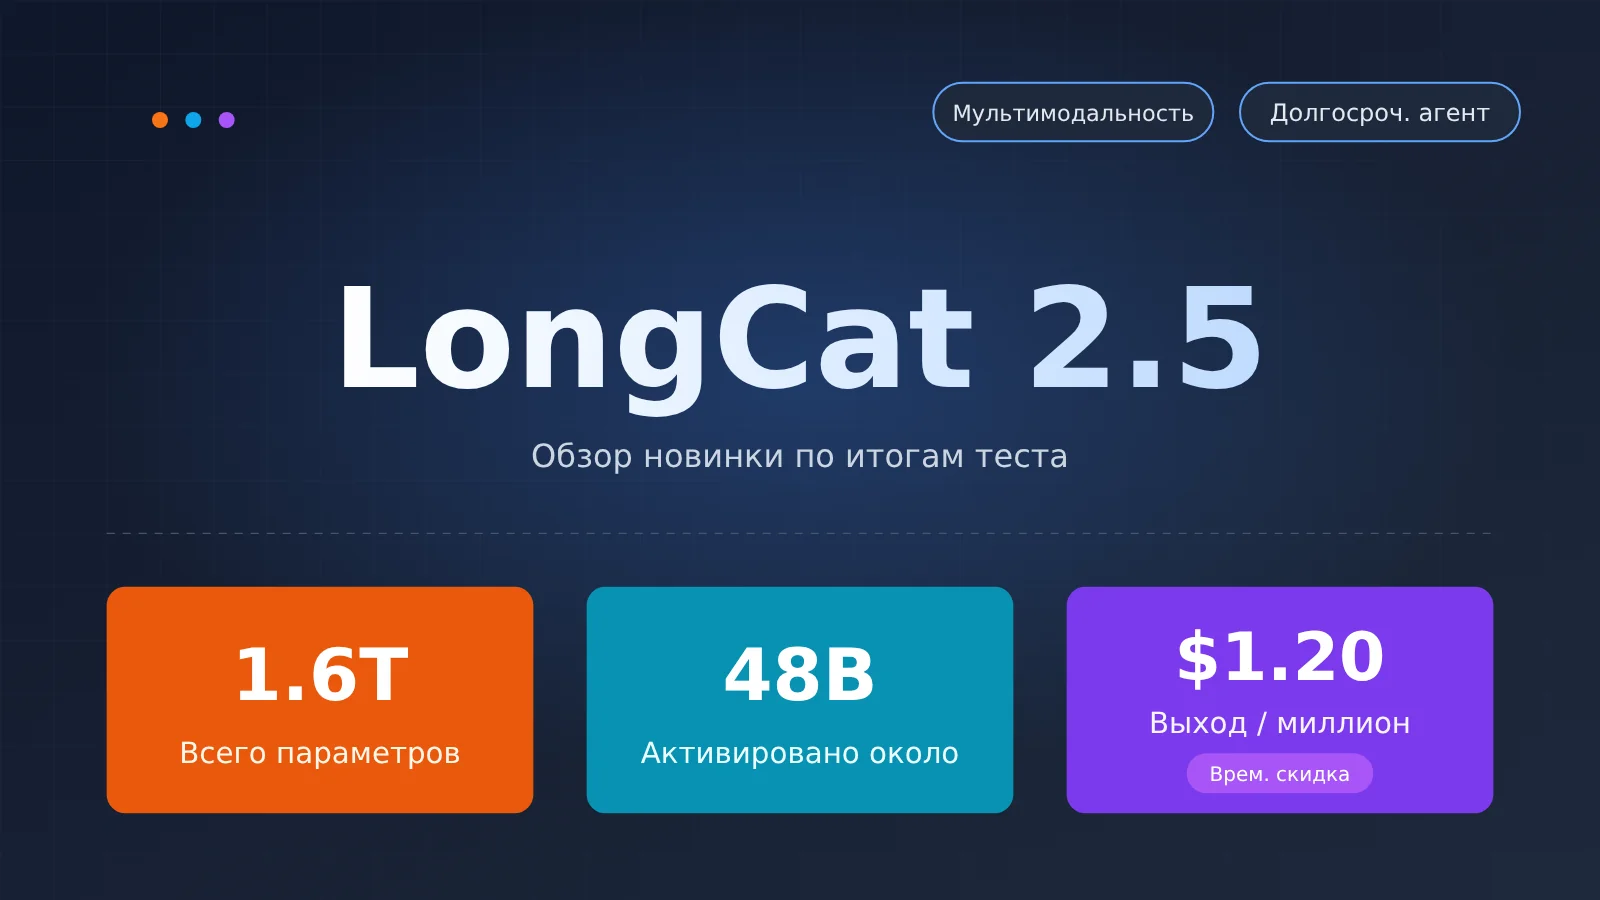
Команда Meituan LongCat (так её обычно называют в сообществе) 1 ноября выпустила LongCat-2.5. У этой нативно мультимодальной модели 1,6 трлн параметров, из которых около 48 млрд активируются для каждого токена. Она создана для длительных агентных задач. По сравнению с версией 2.0 основные улучшения коснулись нативного понимания изображений и агентного программирования. Сейчас действуют временные скидочные тарифы: $1,20 за миллион выходных токенов, $0,30 за миллион входных токенов без попадания в кеш и $0,006 — с попаданием в кеш.
Это не сравнение моделей для выбора победителя. Ниже разберём только три вопроса: что это за модель, с какими задачами она справляется и сколько стоит её использование. Результаты тестов приводятся лишь для сравнения — без выводов о том, какая модель какую заменит.
Что вы получите: карту возможностей модели, понятный расчёт расходов и кратчайший путь к началу работы.
LongCat 2.5: главное
| Параметр | Подробности |
|---|---|
| Дата выпуска | 2026-11-01 (официальный блог) |
| Назначение | Нативная мультимодальная модель для длительных агентных задач |
| Масштаб | Всего 1,6 трлн параметров, для каждого токена активируется около 48 млрд |
| Улучшения по сравнению с 2.0 | Нативное понимание изображений, агентное программирование |
| Контекстное окно / максимальный вывод | 1 млн токенов / 128 тыс. токенов |
| Интерфейс | Два протокола: форматы OpenAI и Anthropic |
| Цена (скидка на ограниченное время) | Вход: $0.30 без попадания в кеш / $0.006 при попадании в кеш; выход: $1.20. Цены указаны за миллион токенов |
| Веса | На GitHub и HuggingFace указано «ожидайте»; веса пока не опубликованы |
С количеством активируемых параметров легко запутаться. В день выпуска в одном из постов сообщества указали 440 млрд, но в официальном блоге сказано, что для каждого токена активируется около 48 млрд параметров. В этой статье мы используем именно цифру 48 млрд.
Что такое LongCat 2.5: параметры, архитектура и нативная мультимодальность
Масштаб LongCat 2.5 и подход к обучению
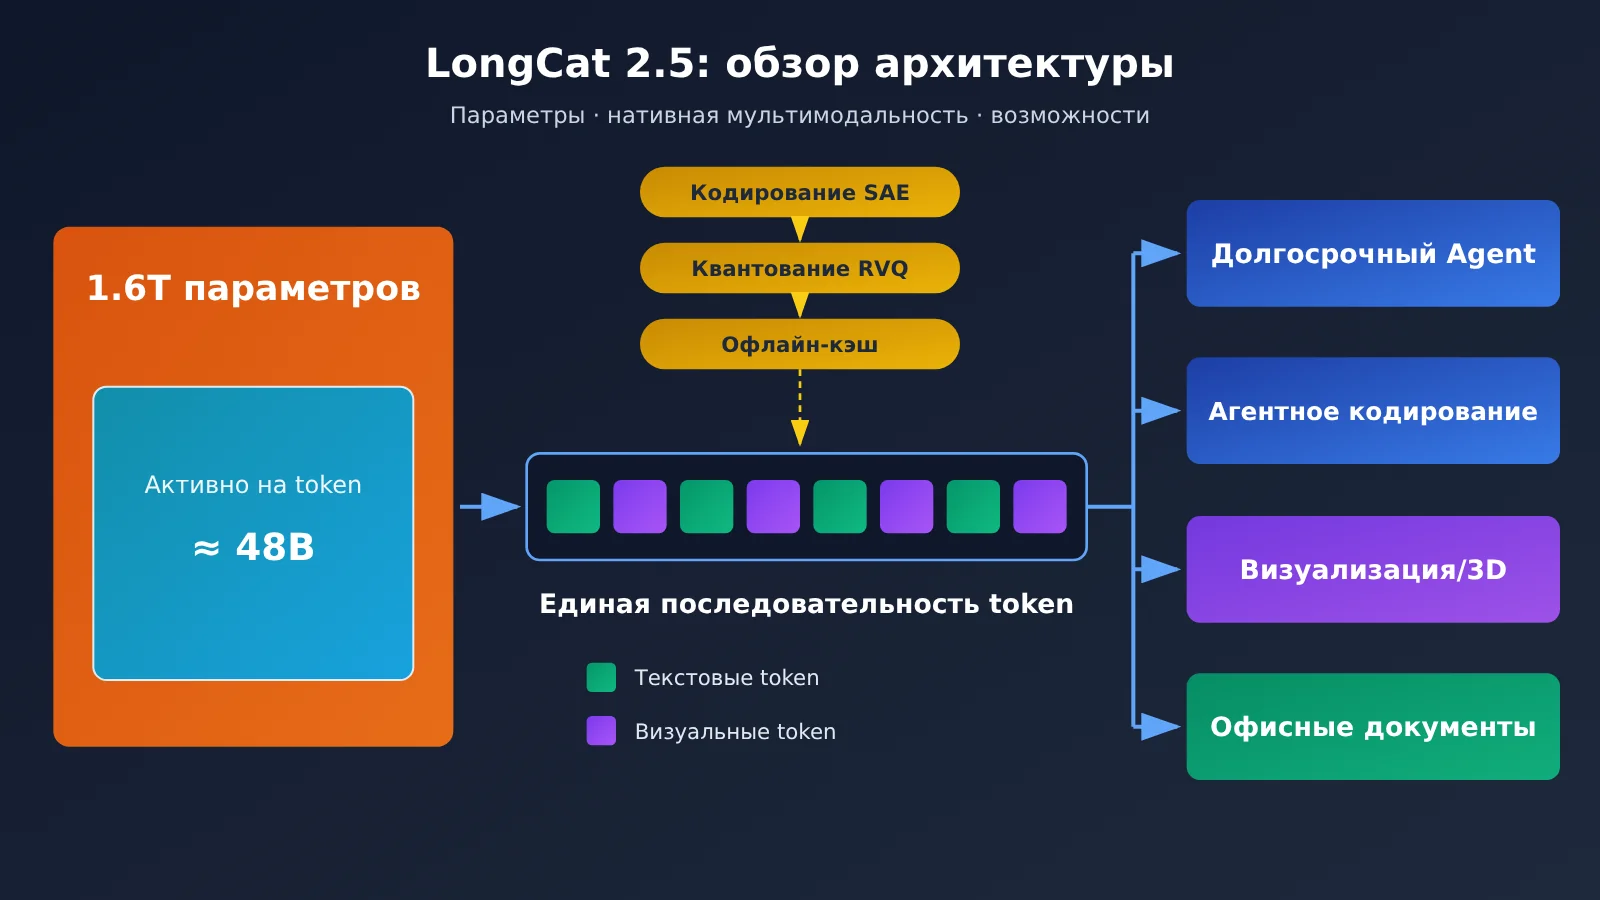
LongCat 2.5 — большая языковая модель с разреженной активацией: из 1,6 трлн параметров при каждом вызове задействуется около 48 млрд. Такая архитектура позволяет найти баланс между объёмом знаний и стоимостью инференса, а также помогает снизить цену использования модели.
В обучении разработчики выделили несколько подходов, напрямую связанных с длительными задачами:
- Больше данных о длительных траекториях: при обучении на длинных последовательностях используют больше длительных траекторий, а затем масштабное обучение с подкреплением на них. Так модель учится выполнять сквозные инженерные задачи, например разрабатывать сложные кодовые базы и создавать проекты целиком.
- Реальные неудачные траектории как учебные задачи: разработчики одновременно расширяют синтез данных, создание сред и смешанное обучение с разными Harness. Это позволяет превращать неудачные траектории реальных агентов в задачи, которые можно воспроизвести и проверить.
- Меньше лишних размышлений и повторных вызовов: модель дополнительно штрафуют за повторение рассуждений и вызовов инструментов. При чрезмерно долгих размышлениях и слишком быстром росте длины ответа положительные вознаграждения перераспределяют.
Последний пункт особенно полезен для агентов. В длительных задачах немало денег уходит на то, что модель снова и снова обращается к одному и тому же инструменту. Если сократить такие повторы на этапе обучения, можно напрямую сэкономить токены.
Как устроена нативная мультимодальность LongCat 2.5
Здесь у «нативной мультимодальности» есть конкретный смысл. Визуальные сигналы представляются в виде многоуровневых дискретных токенов, а основная модель обрабатывает изображения и текст в едином формате токенов. Внешний визуальный энкодер, чьи признаки затем добавляются к входным данным модели, не используется.
Разработчики выделяют три этапа:
- Дискретизация изображений в исходном разрешении: энкодер с семантическим выравниванием (SAE) и остаточное векторное квантование (RVQ) преобразуют изображение в дискретные токены.
- Предварительная офлайн-обработка визуальных токенов: после фиксации токенизатора идентификаторы визуальных токенов можно заранее вычислить и сохранить в кэше.
- Совместное обучение: визуальные эмбеддинги обучаются вместе с основной моделью.
По словам разработчиков, благодаря такой архитектуре модель показывает высокие результаты в Visual Coding и справляется с задачами творческого дизайна, работы с 3D и другими. Тесты 3DCodeBench и Vision2Web в таблице ниже как раз измеряют эти способности.
Почему LongCat 2.5 стоит так недорого
В официальном блоге много внимания уделили эффективности реализации — и это помогает понять, откуда взялась такая цена. Модель обучали на китайском оборудовании, причём объём видеопамяти каждой карты был меньше 80 ГБ. Чтобы снизить потребление памяти, команда использовала FSDP с двойным шардированием, смешанный параллелизм словаря и динамическое копирование экспертов. В задачах SFT с длинными последовательностями такая конфигурация FSDP дала на 86% большую пропускную способность на одну карту по сравнению с базовой конфигурацией DDP.
При инференсе используется W4A4: веса экспертов и активации квантизированы до 4 бит. По данным официального нагрузочного тестирования в продакшене, по сравнению с базовой конфигурацией W8A8 INT8 пропускная способность prefill выросла на 43,3%, decode — на 42,77%, задержка первого токена (TTFT) снизилась на 15,91%, а задержка на токен (TPOT) — на 19,72%. Когда пропускная способность растёт более чем на 40%, стоимость обработки одного токена закономерно снижается.
Чем сильна LongCat 2.5: длительные агентные задачи и 8 официальных примеров
Как LongCat 2.5 продвинулась по сравнению с 2.0
Сначала сравним две версии между собой. Ниже приведены результаты собственных тестов LongCat; показатели, отмеченные звёздочкой, взяты из публичных рейтингов. В этом разделе мы приводим только баллы двух поколений LongCat.
- Terminal Bench v4.0: 2.0 — 3,0, 2.5 — 38,5.
- DeepSWE v1.1: 2.0 — 9,7, 2.5 — 64,6.
- Program Bench Almost Resolved: 2.0 — 2,5, 2.5 — 25,5.
- AutomationBench v1.0.6: 2.0 — 15,8, 2.5 — 51,8.
Все эти тесты связаны с длительными задачами: многошаговыми операциями в терминале, исправлениями на уровне репозитория и автоматизацией рабочих процессов. Версия 2.0 в них почти ничего не показывала, а 2.5 набрала достаточно баллов, чтобы сравнивать её с другими моделями. Это говорит о заметном прогрессе в агентном программировании. Разработчики также уточняют: все результаты LongCat-2.5 получены с включённым режимом thinking, при temperature=1.0 и top_p=0.95.
8 официальных демонстраций LongCat 2.5
Разработчики показали 8 примеров, созданных моделью от начала до конца, и разделили их на две группы. Важно: это официальные демонстрации, мы не повторяли каждый пример самостоятельно.
| Категория | Пример | Какие навыки проверяет |
|---|---|---|
| Разработка ПО | Симуляция жидкости в реальном времени | Физические вычисления и рендеринг во фронтенде в реальном времени |
| Разработка ПО | Интерактивная 3D-экспозиция исторических артефактов | Создание 3D-сцены и логики взаимодействия |
| Разработка ПО | Макет города | Размещение и организация множества объектов |
| Разработка ПО | Ассеты для миниатюрной сцены | Контроль деталей при создании 3D-ассетов |
| Офисные задачи | Анализ деятельности бизнеса | Чтение данных, разбор показателей и оформление выводов |
| Офисные задачи | Отчёт по анализу отзывов клиентов | Классификация и обобщение неструктурированных текстов |
| Офисные задачи | Страница о цветовой эстетике в китайском стиле | Визуальная эстетика и вёрстка веб-страницы |
| Офисные задачи | Генератор приглашений на мероприятие | Работа с формами и дизайн макета |
Три из четырёх примеров в группе разработки напрямую связаны с 3D. Они демонстрируют нативные возможности модели по работе с визуальной информацией и визуальным программированием (Visual Coding). Офисные задачи больше сосредоточены на работе с материалами и создании готового результата — в том же направлении, что и тесты JobBench и GDPVal.
Какое место занимает LongCat 2.5 в бенчмарках
В официальной таблице результатов больше 25 тестов, разделённых на три категории: Code Agent, General Agent и Visual. Ниже — сравнение пяти моделей по девяти тестам.
| Бенчмарк | LongCat-2.5 | Claude Opus 5 | GPT-5.6-Sol | GLM-5.3 | Kimi K3 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 89.1* | 88.8* | 88.2* | 88.3* |
| Terminal Bench v4.0 | 38.5 | 53.9* | 37.3* | 41.8* | 12.6* |
| DeepSWE v1.1 | 64.6 | 68.8* | 72.7* | 66.9* | 67.5* |
| BrowseComp | 91.9 | 90.8* | 90.4* | 81.0 | 91.2* |
| HLE w/tools | 63.1 | 64.7* | 58.0* | 62.5* | 56.0* |
| JobBench | 65.4 | 66.7* | 45.4* | 61.4* | 52.9* |
| MCP Atlas | 83.1 | 85.8* | 81.8* | 84.2* | 84.2* |
| 3DCodeBench Text to 3D | 55.4 | 54.3 | 52.3 | 53.4 | 49.3 |
| Vision2Web | 78.6 | 80.2* | 73.5* | 77.8* | 79.0* |
Звёздочкой (*) отмечены результаты из публичных рейтингов или технических отчётов, на которые ссылаются разработчики. Остальные получены в собственных тестах LongCat и приведены только для сравнения.
Из таблицы можно сделать несколько выводов:
- Поиск информации: в BrowseComp результат LongCat — 91.9, самый высокий среди пяти моделей. Разработчики использовали собственный облегчённый harness, включив только два инструмента — search и browse_with_goal, с ограничением до 1024 шагов.
- Генерация 3D: в 3DCodeBench Text to 3D результат 55.4 — тоже лучший среди пяти моделей. Но ни один из результатов в этой строке не отмечен звёздочкой: все они получены в собственных тестах LongCat.
- Задачи в терминале: в Terminal Bench v2.1 результаты всех пяти моделей лежат в диапазоне от 88.2 до 89.1. В более сложном v4.0 LongCat-2.5 набирает 38.5, а Claude Opus 5 — 53.9: разница составляет 15.4 балла.
- Исправление кода на уровне репозитория: в DeepSWE v1.1 результат LongCat — 64.6, самый низкий среди пяти моделей. GPT-5.6-Sol набирает 72.7.
- Вызов инструментов и офисные задачи: в MCP Atlas LongCat набирает 83.1, в JobBench — 65.4. Отставание от Opus 5 составляет 2.7 и 1.3 балла соответственно.
Стоит обратить внимание и на harness — среду, в которой проводились тесты. Для обеих версий Terminal Bench использовался Claude Code harness с max_seq_length 512K; для DeepSWE — mini-swe-agent с длиной последовательности 1M. Результаты разных тестов, проведённых в разных harness, напрямую сравнивать не стоит.
Сколько стоит LongCat 2.5: сравнение цен и расчёт за 1 миллион токенов
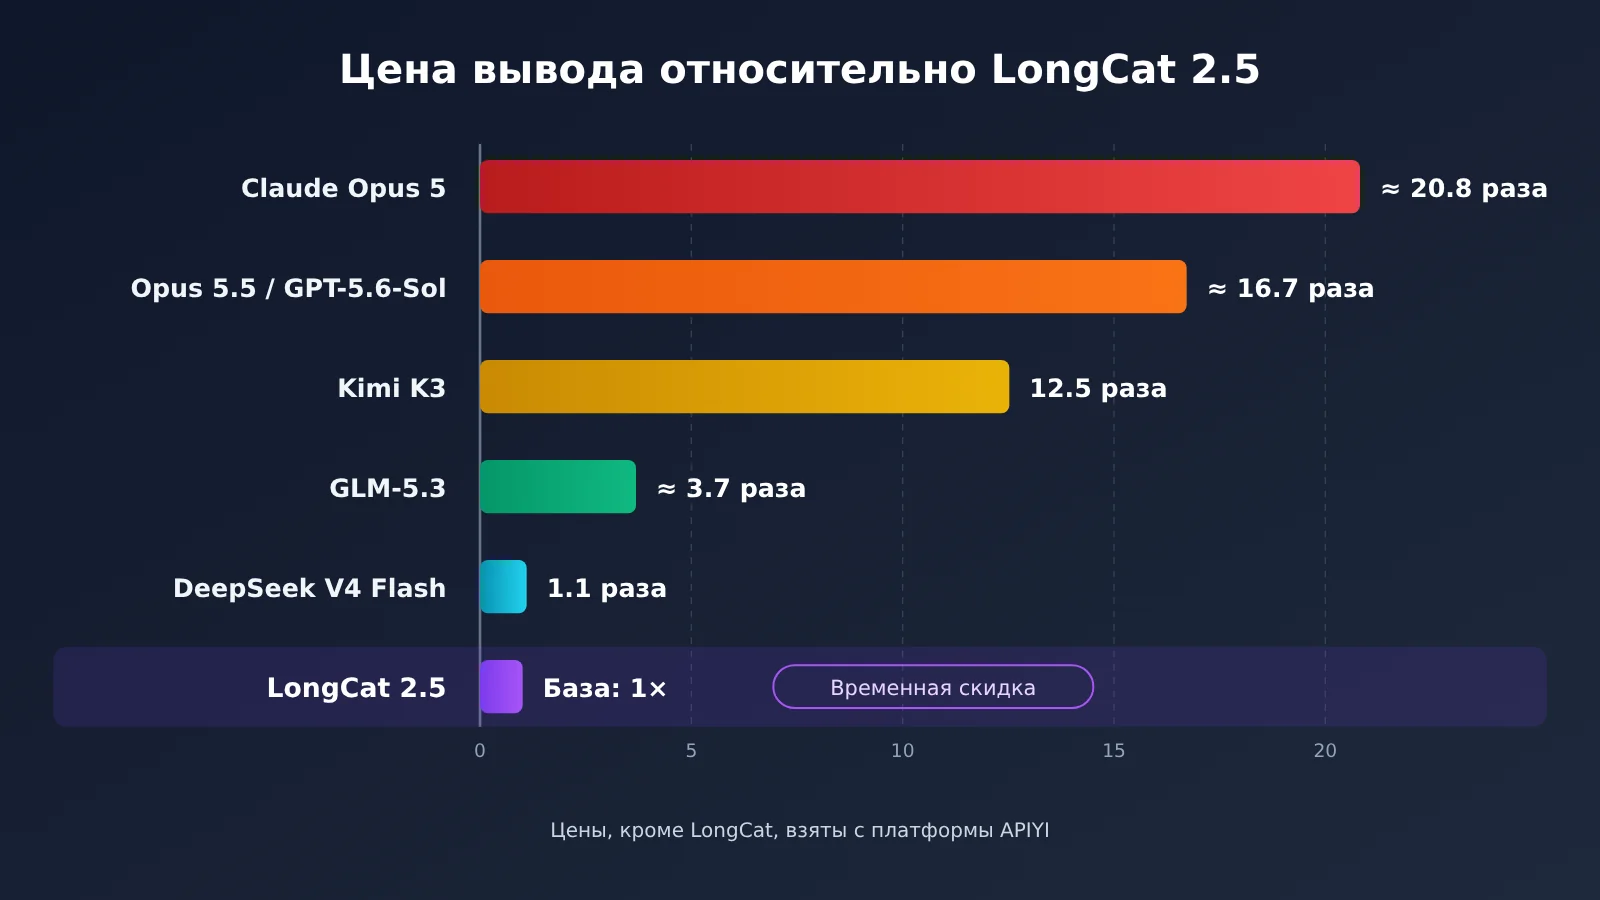
Подпись к диаграмме: для LongCat-2.5 указана цена с временной скидкой на официальной API-платформе, цены остальных моделей взяты из списка моделей на платформе APIYI apiyi.com.
| Модель | Входные токены (за 1 млн) | Выходные токены (за 1 млн) | Во сколько раз цена выходных токенов выше, чем у LongCat |
|---|---|---|---|
| LongCat-2.5 (временная скидка, официальная платформа) | $0.30 ($0.006 при попадании в кэш) | $1.20 | 1 |
| Claude Opus 5 | $5 | $25 | около 20,8 |
| Claude Opus 5.5 | $4 | $20 | около 16,7 |
| GPT-5.6-Sol | $4 | $20 | около 16,7 |
| Kimi K3 | $3 | $15 | 12,5 |
| GLM-5.3 | $1.4 | $4.396 | около 3,7 |
| DeepSeek V4 Flash | $0.44 | $1.32 | около 1,1 |
Цены APIYI apiyi.com проверены 2026-11-02 и соответствуют списку моделей на платформе на эту дату. Цены LongCat-2.5 взяты с платформы LongCat API; на официальной платформе указано, что они могут измениться.
Сколько стоит обработать 1 миллион токенов
Допустим, пакетная задача требует 1 миллион токенов: 800 тысяч входных и 200 тысяч выходных. Кэширование пока не учитываем.
- LongCat-2.5 (временная скидка): 0,8 × $0,30 + 0,2 × $1,20 = $0,48
- DeepSeek V4 Flash: $0,352 + $0,264 = $0,616
- GLM-5.3: $1,12 + $0,879 ≈ $2,00
- Kimi K3: $2,40 + $3,00 = $5,40
- GPT-5.6-Sol или Claude Opus 5.5: $3,20 + $4,00 = $7,20
- Claude Opus 5: $4,00 + $5,00 = $9,00
За одну и ту же задачу Opus 5 обойдётся примерно в 18,75 раза дороже LongCat-2.5. Если часть данных попадёт в кэш, разница будет ещё больше. В официальном примере 1 миллион входных токенов (400 тысяч из кэша и 600 тысяч без попадания в кэш) плюс 500 тысяч выходных обойдутся в $0,18 + $0,0024 + $0,6 = $0,7824. Стоимость миллиона входных токенов из кэша — всего $0,006, то есть в 50 раз меньше, чем без кэширования.
Стоит запомнить ещё две детали: плата списывается, только если запрос вернул HTTP 200; неудачные запросы с кодами 401, 403, 429 и 500 не тарифицируются. Баланс пополняется заранее и не сгорает, а при наличии бонусных средств сначала расходуются они.
Как упростить сравнение нескольких моделей
На практике в проектах с агентами редко используют всего одну модель. Например, вы можете захотеть сравнить ответы LongCat-2.5, Claude, GPT и GLM на один и тот же промпт. С APIYI apiyi.com переключаться между моделями можно с помощью одного аккаунта и одного API-ключа — не придётся отдельно регистрироваться и пополнять баланс у каждого провайдера.
📌 Примечание: актуальный список моделей и цены доступны на платформе APIYI apiyi.com. LongCat-2.5 пока недоступна в APIYI, но её планируют добавить в ближайшее время.
Как начать работу с LongCat 2.5: веб-версия и подключение API
Шаг первый: попробуйте в браузере
Официальная веб-версия доступна по адресу longcat.ai/chat. Согласно публикации в сообществе, в период запуска новые пользователи получают 10 млн токенов, а существующие — 5 млн. Бонус начисляется автоматически, а при попадании в кеш не расходуется. В публикации также упоминается пакет с ограниченным сроком действия за 9,9 юаня, который «скоро появится». Для начала попробуйте задачи на поиск и анализ изображений: в этих категориях модель показала хорошие результаты в тестах.
Шаг второй: подключитесь через API — запомните четыре параметра
- Эндпоинт в формате OpenAI:
https://api.longcat.ai/openai - Эндпоинт в формате Anthropic:
https://api.longcat.ai/anthropic - Поле model:
LongCat-2.5 - Контекст и вывод: контекстное окно — 1 млн токенов, максимальный вывод — 128 тыс. токенов
Что касается ограничений частоты запросов, официально указано лишь, что при их превышении возвращаются HTTP 429, код ошибки rate_limit_exceeded и значение retry_after, равное 60. Также разработчики рекомендуют настроить повторные попытки с экспоненциальной задержкой на стороне клиента. Конкретные значения RPM и TPM не опубликованы.
Если ваш код уже использует OpenAI SDK для вызова других моделей, при переходе достаточно изменить три параметра: base_url, api_key и model. Например, при работе через APIYI base_url имеет значение https://api.apiyi.com/v1. Чтобы перейти на официальный API LongCat, замените его на https://api.longcat.ai/openai, а model — на LongCat-2.5.
Шаг третий: подключите к Claude Code
- Claude Code, раздел env в файле
~/.claude/settings.json: вANTHROPIC_AUTH_TOKENукажите API-ключ LongCat - Раздел env в том же файле: в
ANTHROPIC_BASE_URLукажитеhttps://api.longcat.ai/anthropic - Раздел env в том же файле: в
ANTHROPIC_MODELукажитеLongCat-2.5 - Раздел env в том же файле: в
CLAUDE_CODE_MAX_OUTPUT_TOKENSукажите131072 - Раздел env в том же файле (рекомендуется изменить заодно): для
ANTHROPIC_SMALL_FAST_MODEL,ANTHROPIC_DEFAULT_SONNET_MODELиANTHROPIC_DEFAULT_OPUS_MODELукажитеLongCat-2.5
Если не изменить последние три переменные, внутренние подзадачи Claude Code могут по-прежнему обращаться к моделям по умолчанию. Это может привести к ошибкам или неожиданному списанию средств.
Шаг четвёртый: подключите к Cline
- Cline, панель настроек на боковой панели VS Code: в API Provider выберите вариант, совместимый с OpenAI
- На той же панели: в Base URL укажите
https://api.longcat.ai/openai - На той же панели: в API Key укажите ключ LongCat, а в Model ID —
LongCat-2.5
В официальной документации LongCat есть отдельная страница по подключению Cline. Сверяйте названия полей с ней. Там же есть инструкции по подключению более десятка других инструментов, включая Codex, OpenCode, Kilo Code, Cherry Studio, Chatbox и CC Switch.
🚀 Совет для быстрого старта: сначала используйте бонусные токены от LongCat, чтобы проверить работу на своих задачах, а затем решите, стоит ли подключать сервис на постоянной основе. Если вам также нужно вызывать Claude, GPT и Gemini для сравнения, в APIYI на apiyi.com ими можно управлять через единый OpenAI-совместимый интерфейс. После появления LongCat-2.5 в сервисе на неё тоже можно будет переключиться в рамках одного аккаунта.
Для каких задач подходит LongCat 2.5
| Подходит для LongCat 2.5 | Лучше не спешить |
|---|---|
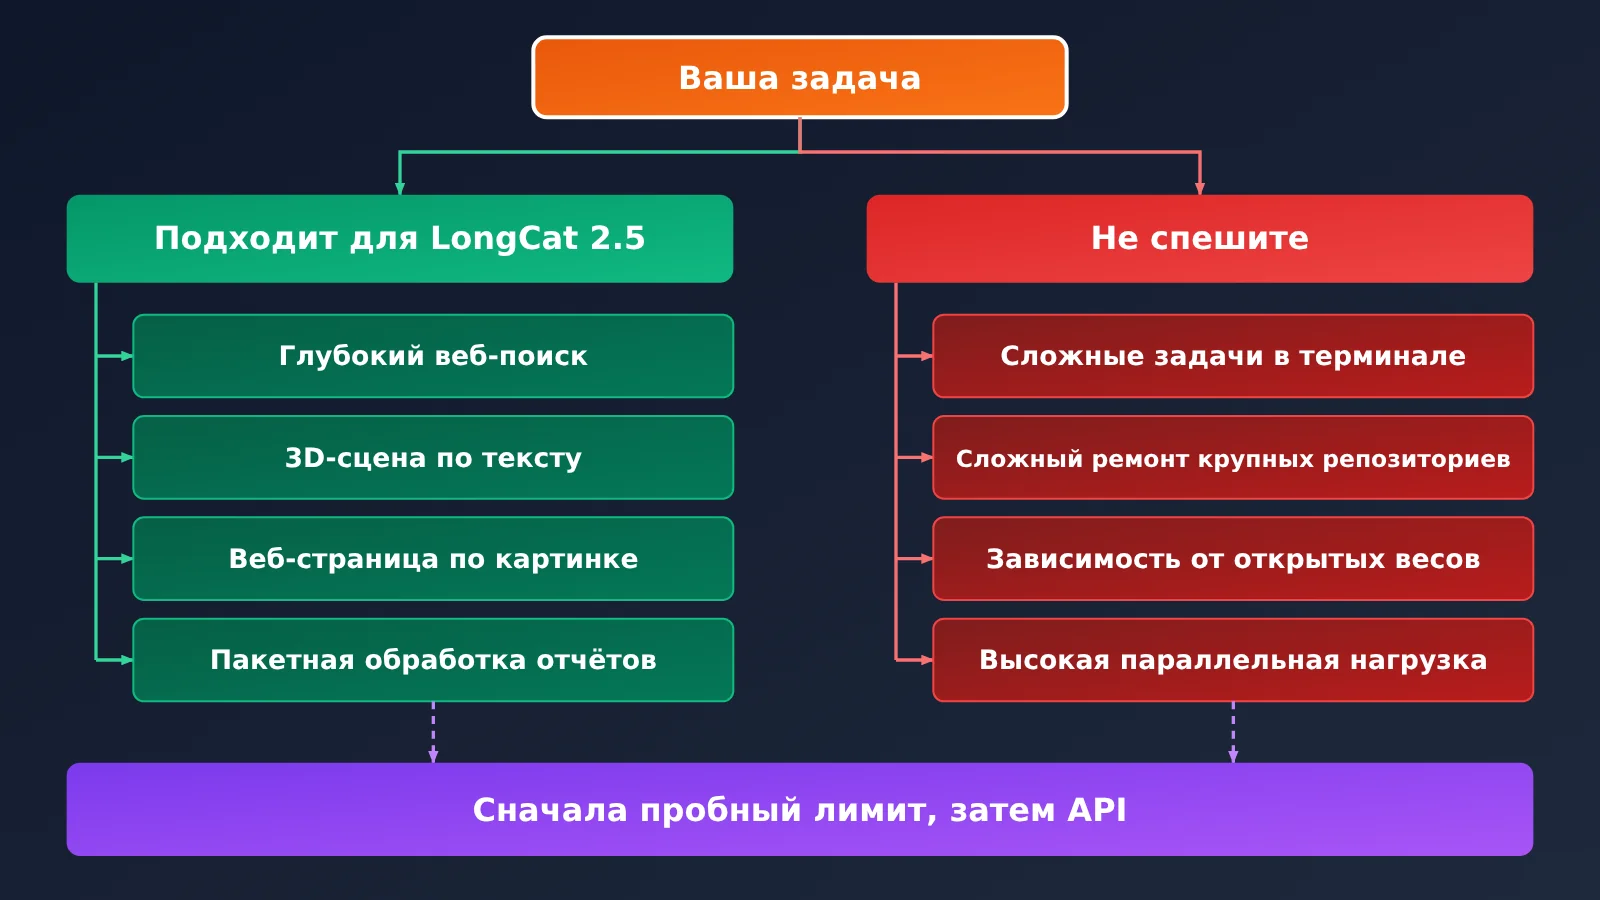
| Многоэтапный поиск в интернете и обобщение материалов (BrowseComp — 91,9) | Сложные многошаговые задачи администрирования в терминале (Terminal Bench v4.0 — 38,5 против 53,9 у Opus 5) |
| Создание 3D-сцен, например на Three.js, по текстовому описанию (3DCodeBench — 55,4) | Исправление сложных багов в крупных репозиториях (DeepSWE v1.1 — 64,6, самый низкий результат среди пяти моделей) |
| Создание веб-страниц по дизайн-макету или скриншоту (Vision2Web — 78,6) | Проекты, которым нужно развёртывание в собственной инфраструктуре и локальный доступ к весам модели (веса пока не опубликованы) |
| Пакетная обработка отзывов клиентов и бизнес-данных с подготовкой текстов (JobBench — 65,4; временная скидка на выходные токены — $1,20 за миллион) | Продакшен-сервисы, которым нужна гарантированная квота на высокую параллельную нагрузку (официальные лимиты RPM/TPM не опубликованы) |
Задачи в левом столбце объединяет одно: они длительные, требуют много токенов и чувствительны к цене. LongCat-2.5 здесь выгодно смотрится как по результатам тестов, так и по стоимости. Правый столбец не означает, что модель не справится с этими задачами: просто в тестах пока видно отставание, а условия развёртывания и квоты ещё неясны. Поэтому лучше сначала провести небольшой тест.
LongCat 2.5: часто задаваемые вопросы
Вопрос 1: Результаты LongCat 2.5 в тестах получены третьей стороной?
Нет. Все результаты самой LongCat-2.5 в таблице получены командой LongCat. Для моделей, отмеченных звёздочкой, данные взяты из открытых отчётов или официальных рейтингов; остальные модели LongCat тоже тестировала самостоятельно. Лучше воспринимать эти результаты как ориентир для сравнения.
Вопрос 2: $1.20 за миллион токенов — это постоянная цена?
Нет. Официально это цена по ограниченной по времени скидке, и она может измениться. Актуальную стоимость можно проверить на платформе LongCat API и в счёте. При долгосрочном планировании бюджета стоит предусмотреть запасную модель: агрегаторы вроде APIYI apiyi.com позволяют сохранить возможность переключения.
Вопрос 3: LongCat 2.5 доступна с открытым исходным кодом?
Пока нет. Кнопки GitHub и HuggingFace в официальном блоге помечены как «скоро». Сейчас доступны только онлайн-версия и API, а сроки открытия исходного кода не объявлены.
Вопрос 4: Можно ли вызвать LongCat 2.5 через APIYI?
Пока нет, но APIYI планирует добавить эту модель в ближайшее время. Сейчас можно использовать официальный API LongCat. Если вы хотите сравнить Claude, GPT и GLM, на APIYI apiyi.com их уже можно протестировать с одним API-ключом. Доступные модели и цены указаны в списке моделей на платформе.
Вопрос 5: Что делать при ошибке 429?
Это значит, что сработало ограничение частоты запросов. В теле ответа будет указан `retry_after` со значением 60. Разработчики рекомендуют настроить на стороне клиента повторные попытки с экспоненциальным увеличением интервала. Запросы с ошибкой 429 не тарифицируются, поэтому дополнительных списаний не будет.
Итог: стоит ли подключать LongCat 2.5
Главное о LongCat 2.5:
- Позиционирование: изначально мультимодальная модель с 1,6 трлн параметров, из которых около 48 млрд активируются на каждый токен. Ориентирована на длительные агентные задачи.
- Улучшения: по сравнению с версией 2.0 результат на Terminal Bench v4.0 вырос с 3,0 до 38,5, на DeepSWE v1.1 — с 9,7 до 64,6.
- Сильные стороны: BrowseComp — 91,9, 3DCodeBench — 55,4. Это лучшие результаты среди пяти моделей, сравниваемых в статье, по официальным данным.
- Отставание: на Terminal Bench v4.0 и DeepSWE v1.1 разница всё ещё заметна.
- Цена: по временной скидке выходные токены стоят $1,20 за миллион; запрос с 800 тысячами входных и 200 тысячами выходных токенов обойдётся примерно в $0,48.
- Подключение: поддерживаются протоколы OpenAI и Anthropic. Для Claude Code достаточно изменить четыре переменные.
Если коротко: сначала попробуйте задачи на поиск и анализ изображений на longcat.ai/chat, используя подарочный лимит 10M, а затем переходите к API. Если планируете регулярно переключаться между моделями, управляйте ими в одном месте через APIYI — apiyi.com.
📚 Источники
- Официальный блог LongCat: статья о выпуске LongCat-2.5 с описанием архитектуры, обучения и таблицами результатов тестирования
- Ссылка:
longcat.ai/blog/longcat-2.5 -
Описание: первоисточник данных о количестве параметров, восьми демонстрационных примерах и методике оценки
-
Документация платформы LongCat API: интерфейсы, тарификация и подключение инструментов
- Ссылка:
longcat.ai/platform/docs -
Описание: эндпоинты для двух протоколов, временные скидки, страницы подключения Claude Code и Cline
-
Список моделей APIYI: цены на модели на разных платформах
- Ссылка:
docs.apiyi.com/models - Описание: источник цен для сравнения в этой статье; актуальные цены смотрите на сайте
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу сайта APIYI. Дополнительные материалы доступны в центре документации docs.apiyi.com