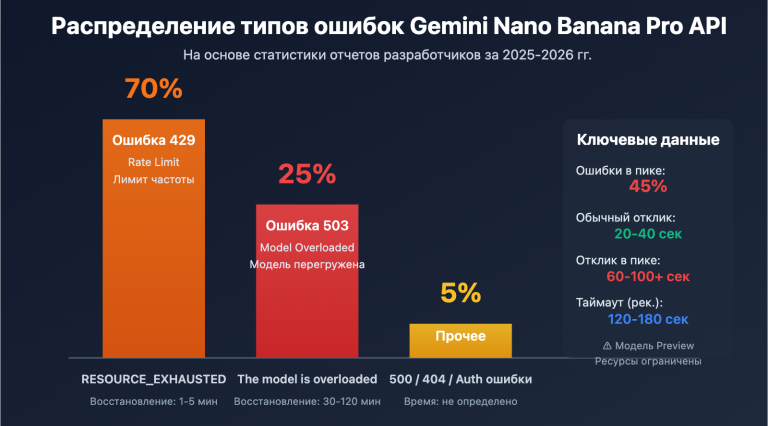
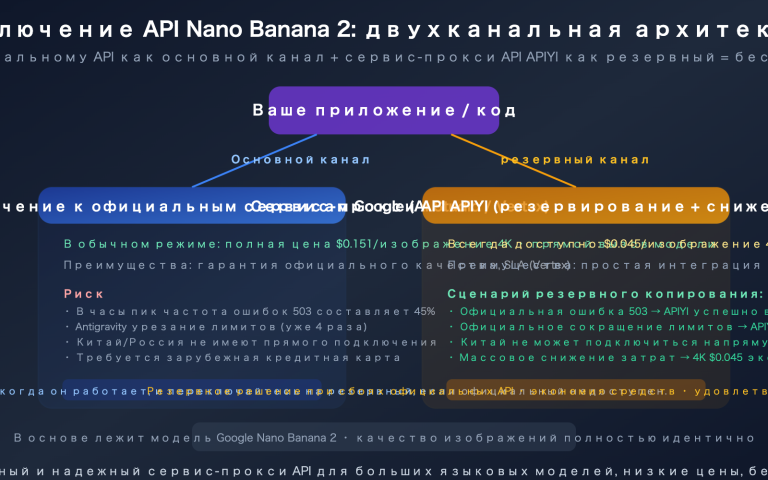
gemini-4-argon вышла 13 октября 2026 года. Многие разработчики, подключив модель, сразу столкнулись с ошибкой 429: стоило увеличить число параллельных запросов — и появлялась ошибка, а иногда не проходил даже одиночный запрос. Первая мысль у многих: «В AI Studio слишком низкий лимит параллельных запросов». Но скорее всего, это неверный вывод. В этой статье разберём как на самом деле работает ограничение запросов gemini-4-argon в AI Studio и предложим практические способы справиться с ошибкой 429.
Это не очередное поверхностное руководство в духе «просто добавьте повторы». Сначала уточним важный факт: Google пока не публиковала единого фиксированного лимита параллельных запросов для gemini-4-argon. Поэтому цифры вроде «10 параллельных запросов» или «50» из интернета ничем не подтверждены.
Что вы узнаете: как различать четыре причины ошибки 429 — превышение RPM, TPM, скорости расходования квоты и ограничений пропускной способности на стороне провайдера; как правильно применять экспоненциальную задержку и ограничение скорости; а также как обойти ограничения квоты отдельного проекта AI Studio с помощью канала APIYI apiyi.com для обработки большого числа параллельных запросов.
Ключевые выводы о gemini-4-argon
Сначала — краткое резюме в таблице. Подробности разберём в следующих разделах.
| Ключевой момент | Пояснение | Практическая польза |
|---|---|---|
| Единого публичного лимита параллельных запросов нет | Google не публиковала общий лимит параллельных запросов для gemini-4-argon. Ограничения задаются по RPM, TPM, RPD и другим показателям | Помогает не планировать ресурсы на основе неверных цифр |
| RPM — это не то же самое, что параллельность | Число запросов в обработке зависит от их средней длительности, а не только от количества запросов в минуту | Позволяет правильно оценить необходимую параллельность |
| Ограничения рассчитываются на уровне проекта | Создание нескольких ключей в одном проекте не умножает квоту | Не придётся тратить время на ротацию ключей |
| Лимит расходов за 10 минут | Для Tier 1 он составляет $10, Tier 2 — $50, Tier 3 — $200 | Объясняет ситуации, когда возникает ошибка 429, хотя лимит RPM не превышен |
| Ошибку 429 нужно разбирать поэтапно | Сначала проверьте исходный ответ, затем ограничьте скорость запросов, настройте повторные попытки с задержкой, переключите канал или запросите увеличение квоты | Помогает последовательно решить проблему |
| Канал APIYI для высокой параллельности | APIYI apiyi.com поддерживает высокую параллельность для gemini-4-argon. При нагрузке ниже 500 RPM о лимитах можно не беспокоиться | Подходит для проектов малого и среднего масштаба |
Почему ошибка 429 не всегда означает превышение лимита параллельных запросов
Многие разработчики считают, что ошибка 429 означает «слишком много параллельных запросов». Но в системе ограничений Google параллельность не выделена в отдельный показатель. Причиной 429 RESOURCE_EXHAUSTED могут быть превышение количества запросов в минуту, числа входных токенов в минуту, дневного лимита запросов или лимита расходов за скользящий 10-минутный период. Кроме того, на раннем этапе после запуска новой модели может не хватать ресурсов на стороне сервиса.
С момента выпуска gemini-4-argon прошла меньше недели, и ресурсы на стороне провайдера ещё наращиваются. Поэтому временный отказ возможен даже при достаточной квоте. При разборе ошибки 429 всегда сначала выясняйте, что именно её вызвало, а не снижайте параллельность наугад.
Какова параллельность gemini-4-argon в AI Studio?
Короткий ответ: единого публичного значения нет. Для gemini-4-argon каждому проекту в AI Studio выделяются собственные лимиты RPM, TPM и RPD. Точные значения зависят от уровня Tier и состояния проекта — их нужно смотреть в панели управления.
Пять типов ограничений в AI Studio
Ограничения Google можно свести к показателям в таблице ниже. Превышение любого из них может привести к ошибке 429.
| Показатель | Значение | Может ли вызвать ошибку 429 |
|---|---|---|
| RPM | Количество запросов в минуту | Да |
| TPM | Количество входных токенов в минуту | Да |
| RPD | Количество запросов в день | Да |
| Скорость расходов | Сумма расходов на API за скользящий 10-минутный период | Да |
| Фактическая пропускная способность сервиса | Доступные ресурсы Google на стороне провайдера | Возможно |
Обратите внимание на последнюю строку: нехватку ресурсов нельзя устранить настройками с вашей стороны. В таком случае остаётся снизить нагрузку, повторить запрос позже или переключить канал.
Как связаны RPM и параллельность
RPM — это общее количество запросов за минуту, а параллельность — число запросов, обрабатываемых одновременно. Их связывает длительность обработки запросов. Возьмём для примера проект с лимитом 60 RPM — это только пример для расчёта, а не фактический лимит Argon:
- При средней длительности запроса 5 секунд в обработке будет в среднем около 5 запросов.
- При средней длительности 30 секунд — около 30 запросов.
- Если отправить 60 запросов одновременно, можно столкнуться с кратковременным ограничением или нехваткой ресурсов, даже если общий лимит за минуту не превышен.
Последний случай часто упускают из виду. Многие тестовые скрипты отправляют запросы одновременно, создавая резкий скачок нагрузки. Такой всплеск чаще приводит к ограничению запросов, чем равномерный поток, даже если общее количество запросов укладывается в лимит.
Как посмотреть фактические квоты gemini-4-argon в панели управления
Откройте страницу Rate Limits в Google AI Studio: aistudio.google.com/usage, а затем перейдите на вкладку rate-limit. Также можно открыть официальную документацию по ограничениям скорости: ai.google.dev/gemini-api/docs/rate-limits. Выберите нужный проект и gemini-4-argon, чтобы посмотреть действующие лимиты RPM, TPM и RPD, а также текущий уровень Tier.
Google отдельно уточняет, что ограничения рассчитываются на уровне проекта, а не API-ключа. Поэтому создание любого количества ключей в одном проекте не увеличит квоту. Расширить её за счёт ротации нескольких ключей в AI Studio не получится.
5 причин, почему gemini-4-argon часто возвращает 429
Теперь, когда мы разобрались с лимитами, посмотрим на типичные проблемы на практике. Эти пять причин объясняют подавляющее большинство случаев с ошибкой 429 у gemini-4-argon.
- Слишком высокая мгновенная частота запросов: пакетные задачи или скрипты нагрузочного тестирования отправляют много запросов одновременно, создавая всплеск, который превышает мгновенную пропускную способность RPM.
- Достигнут лимит TPM: длинный контекст и большие документы быстро расходуют токены. Запросов может быть немного, но лимит TPM будет исчерпан первым.
- Достигнут лимит расходов за 10 минут: этот лимит чаще всего упускают из виду, поэтому разберём его отдельно ниже.
- Исчерпан дневной лимит RPD: если 429 начинают появляться только спустя какое-то время, часто это сигнал, что закончилась дневная квота.
- Не хватает ресурсов на стороне провайдера: сразу после запуска новой модели ресурсов может быть мало, и запросы могут отклоняться даже при неиспользованной квоте.
Причина, которую легко упустить: лимит расходов за 10 минут
Согласно официальной документации Google, обновлённой 15 октября 2026 года, для каждого уровня аккаунта установлен лимит расходов в скользящем окне за 10 минут.
| Уровень аккаунта | Лимит расходов за 10 минут |
|---|---|
| Tier 1 | $10 |
| Tier 2 | $50 |
| Tier 3 | $200 |
Например, если аккаунт Tier 1 потратит $10 за 10 минут, он может получить 429 RESOURCE_EXHAUSTED, даже если лимиты RPM и TPM не превышены. gemini-4-argon — модель нового поколения, и стоимость одного вызова может быть выше, чем у предыдущих моделей. Запросы с длинным контекстом также быстрее увеличивают расходы. Поэтому нередко лимит срабатывает даже при небольшом количестве запросов.
Также обратите внимание: указанные в документации Google квоты Argon Batch API — это лимит токенов для очереди пакетной обработки. Их нельзя использовать как лимит параллельных запросов к API в реальном времени.
Как определить, на каком этапе возникает ошибка 429 у gemini-4-argon?
Разные симптомы указывают на разные причины. Разобраться в них обычно эффективнее, чем без разбора менять параметры.
| Симптом | Что проверить в первую очередь | Что делать |
|---|---|---|
| 429 часто появляются сразу после увеличения параллелизма | Мгновенную частоту запросов, RPM и доступность ресурсов на стороне провайдера | Проведите ступенчатый нагрузочный тест с равномерной отправкой запросов: фиксированный параллелизм не означает фиксированный RPM |
| 429 появляются спустя какое-то время после запуска | Лимит расходов за 10 минут, RPD и накопленный расход TPM | Проверьте график расходов и использование дневной квоты |
| 429 появляются даже при одном запросе или очень низком параллелизме | Доступность ресурсов на стороне провайдера, ограничения аккаунта или проекта | Посмотрите исходный ответ и подумайте о переключении на другой канал |
| 429 появляются одновременно на нескольких ключах | Возможно, несколько ключей привязаны к одному проекту и используют общую квоту | Снизьте общий трафик проекта или воспользуйтесь каналом с отдельной квотой |
При диагностике важнее всего проверить две вещи: во-первых, к какому уровню относится ваш аккаунт AI Studio — Tier 1, 2 или 3; во-вторых, посмотреть исходный текст ошибки 429, особенно поля error.message, error.details и заголовок ответа Retry-After. Этих данных обычно хватает, чтобы понять, в чём причина: слишком низкая квота аккаунта, чрезмерный поток запросов или нехватка ресурсов у новой модели Google Argon. Для каждого случая решение будет своим.
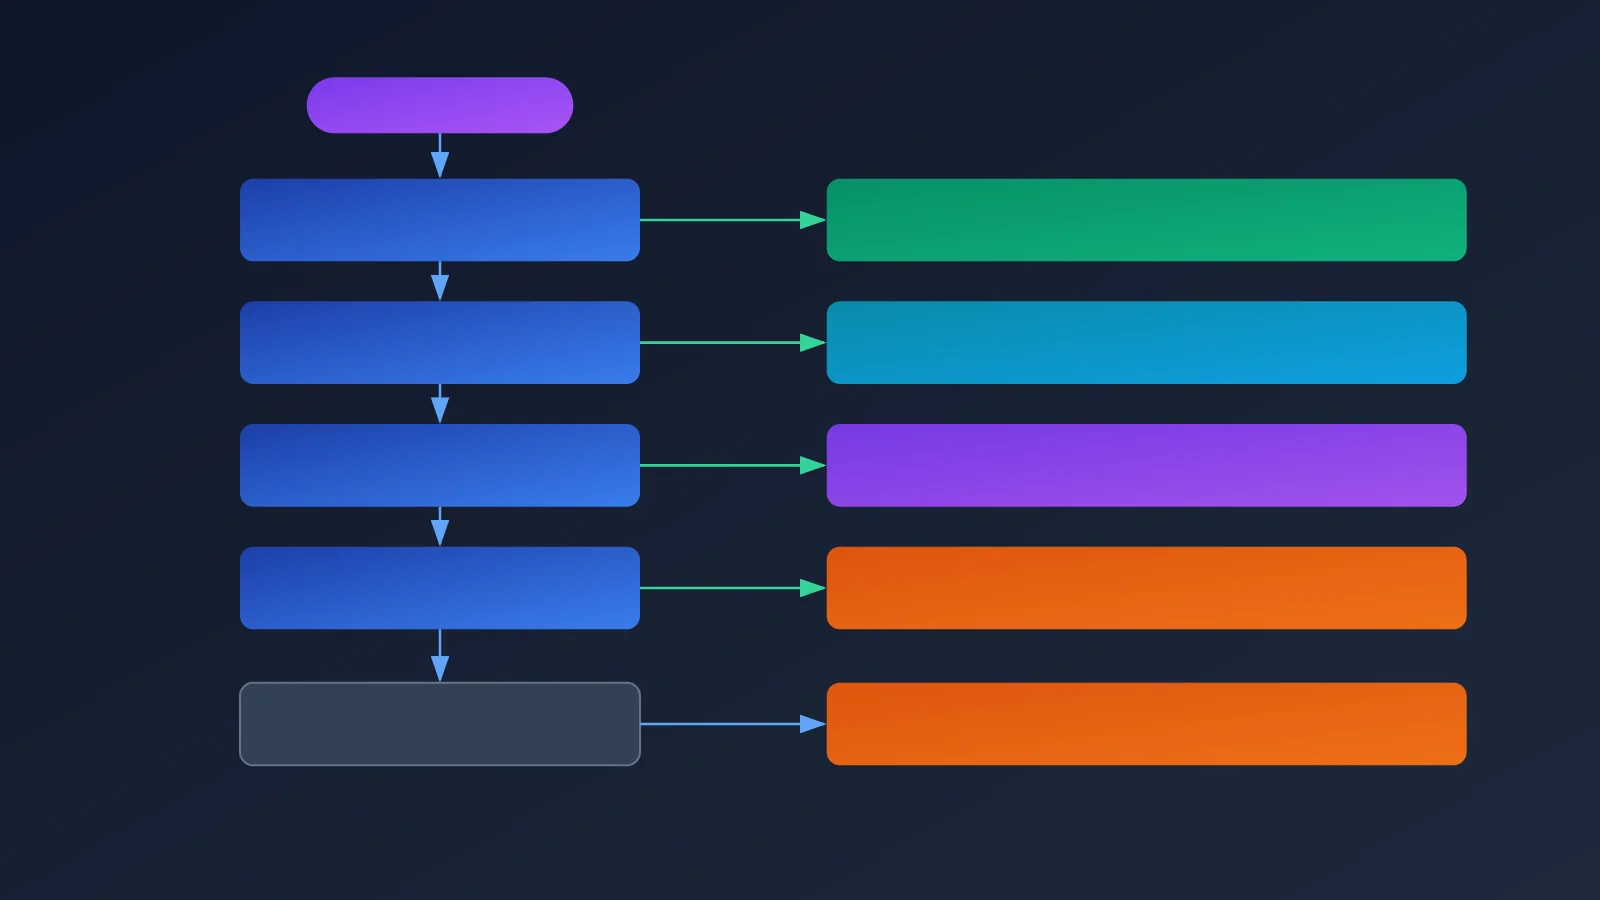
6 шагов для решения проблемы 429 в gemini-4-argon
Ниже меры перечислены в порядке практического приоритета: P0 — то, что нужно сделать в первую очередь, P2 — долгосрочные шаги.
| Приоритет | Решение | Зачем |
|---|---|---|
| P0 | Проверить исходный ответ с ошибкой 429 и заголовок Retry-After |
Понять конкретную причину ограничения |
| P0 | Настроить ограничения RPM, TPM и скорости расхода для проекта | Не допустить постоянного превышения квот |
| P0 | Повторять запросы с ошибкой 429 с экспоненциальной задержкой и случайным разбросом | Смягчить последствия резкого ограничения |
| P1 | При ошибке 429 автоматически переключаться на работоспособный канал с отдельной квотой | Повысить вероятность успешного вызова |
| P1 | Перейти на более высокий Tier или запросить у Google повышение лимитов | Увеличить доступную емкость в долгосрочной перспективе |
| P2 | Рассмотреть Vertex AI или другие официально авторизованные каналы | Расширить доступные ресурсы |
Шаг 1. Разберитесь в исходном ответе с ошибкой 429
Не стоит просто увидеть код ошибки и сразу повторять запрос. Сначала выведите полный текст ошибки и заголовки ответа, уделив особое внимание error.message, error.details и Retry-After. Если вышестоящий сервис уже указал, сколько нужно подождать, в первую очередь следуйте этому значению, а не устанавливайте интервал наугад.
Шаг 2. Ограничьте скорость запросов на клиенте
Установите RPM на уровне 70–80% от видимого в консоли лимита, отдельно контролируйте TPM и дополнительно отслеживайте расходы за 10 минут. Запас нужен, чтобы сглаживать пиковую нагрузку и колебания на стороне сервиса. Многие команды ограничивают только количество запросов, забывая о токенах и расходах. В результате они получают отказ, хотя лимит RPM, казалось бы, не превышен.
Шаг 3. Используйте экспоненциальную задержку со случайным разбросом
Google рекомендует при ошибке 429 применять экспоненциальную задержку, например ждать 1, 2, 4 и 8 секунд, добавляя случайный разброс. Это помогает избежать ситуации, когда множество запросов повторяются одновременно и создают новую волну перегрузки. Ограничьте число повторов двумя-тремя попытками и в первую очередь учитывайте время ожидания, указанное в ответе сервиса.
Шаг 4. Переключайте канал, если ошибки 429 продолжаются
Если один и тот же проект постоянно возвращает ошибку 429, не продолжайте отправлять ему повторы — это только усилит ограничение. Правильнее снизить нагрузку или переключиться на работоспособный канал с независимой квотой. В этом и состоит преимущество агрегирующего сервиса: при вызове через APIYI apiyi.com запросы можно распределить между каналами с отдельными квотами, не возлагая всю нагрузку на один проект AI Studio.
Шаг 5. Перейдите на более высокий Tier или запросите повышение лимитов
В долгосрочной перспективе нехватку ресурсов можно устранить, только повысив уровень аккаунта или запросив у Google увеличение лимитов. При повышении Tier становятся выше не только лимиты RPM и TPM, но и лимит расходов за 10 минут: с $10 до $50 или даже $200. Однако рассмотрение запроса требует времени и истории расходов, поэтому обычно с ним не успеть к запуску продукта.
Шаг 6. Рассмотрите другие официально авторизованные каналы
Если бизнес продолжает расти, можно рассмотреть Vertex AI или другие официально авторизованные каналы, чтобы расширить доступные ресурсы. Параллельная работа через несколько каналов — также надежный способ снизить риск отказа единственной точки доступа.
Рекомендации по нагрузочному тестированию нового канала
Для недавно подключенного канала Argon рекомендуем начать нагрузочное тестирование с 5–10 параллельных запросов. Обратите внимание: это стартовые параметры тестирования, а не официальный лимит параллелизма. Затем постепенно увеличивайте нагрузку ступенями, равномерно отправляя запросы на каждом этапе. Отдельно отслеживайте долю ошибок 429, фактические RPM и TPM, расходы за 10 минут и время выполнения запросов — по поставщику, проекту Google и модели. Переходите к следующему этапу, только убедившись в стабильной работе.
Быстрый старт с gemini-4-argon: вызовы через APIYI
С теорией разобрались — перейдем к коду. APIYI предоставляет интерфейс, совместимый с OpenAI: чтобы вызывать gemini-4-argon, достаточно заменить base_url.
Минимальный пример
Для одного вызова хватит чуть больше 10 строк кода:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

response = client.chat.completions.create(
    model="gemini-4-argon",
    messages=[{"role": "user", "content": "用一句话解释什么是 429 限流"}]
)
print(response.choices[0].message.content)
Полный код: параллельные вызовы с экспоненциальной задержкой, случайным разбросом и Retry-After
import random
import time
from concurrent.futures import ThreadPoolExecutor

import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

MAX_RETRIES = 3       # 最多重试 2-3 次
BASE_DELAY = 1.0      # 指数退避起点:1、2、4、8 秒


def call_argon(prompt: str) -> str:
    """调用 gemini-4-argon,429 时指数退避并优先遵循 Retry-After"""
    for attempt in range(MAX_RETRIES + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-argon",
                messages=[{"role": "user", "content": prompt}],
                max_tokens=512,
            )
            return resp.choices[0].message.content
        except openai.RateLimitError as e:
            if attempt == MAX_RETRIES:
                return f"Error after retries: {e}"
            # 优先使用上游返回的 Retry-After
            retry_after = None
            try:
                retry_after = float(e.response.headers.get("Retry-After"))
            except (AttributeError, TypeError, ValueError):
                pass
            delay = retry_after if retry_after else BASE_DELAY * (2 ** attempt)
            delay += random.uniform(0, 0.5)  # 随机抖动,避免集体重试
            print(f"429,第 {attempt + 1} 次重试,等待 {delay:.1f}s")
            time.sleep(delay)
        except Exception as e:
            return f"Error: {e}"


if __name__ == "__main__":
    prompts = [f"请用一句话介绍第 {i} 种限流策略" for i in range(10)]
    # 并发度从 5 起步压测,不是官方上限
    with ThreadPoolExecutor(max_workers=5) as pool:
        for result in pool.map(call_argon, prompts):
            print(result)
Быстрый старт: зарегистрируйтесь на APIYI apiyi.com и получите API-ключ, чтобы сразу проверить работу gemini-4-argon с помощью кода выше. Платформа предоставляет единый интерфейс, совместимый с OpenAI, — не нужно самостоятельно регистрировать и обслуживать несколько проектов Google.
Простой вариант ограничения скорости запросов на клиенте
Помимо повторных попыток, важно в первую очередь не «биться о стену». Ниже — минимальный ограничитель на основе идеи токен-бакета. Он сглаживает поток запросов и помогает избежать резких пиков:
import threading
import time


class RateLimiter:
    """按目标 RPM 匀速放行请求,避免瞬时尖峰"""

    def __init__(self, rpm: int):
        self.interval = 60.0 / rpm
        self.lock = threading.Lock()
        self.next_time = time.monotonic()

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
            self.next_time = max(now, self.next_time) + self.interval


limiter = RateLimiter(rpm=300)  # 按后台限额的 70%-80% 设置

# 在每次调用前执行:
# limiter.wait()
Добавьте ограничитель в начало функции вызова и сочетайте его с описанным выше механизмом повторов с задержкой. Так вы получите двойную защиту: предварительное ограничение скорости и обработку ошибок с помощью задержки.
Канал высокой параллельной нагрузки gemini-4-argon от APIYI
Главное ограничение при прямом подключении к AI Studio — фиксированная квота на один проект. Аккаунты Tier 1 также ограничены расходами в $10 за 10 минут. Агрегатор может распределять трафик между каналами с независимыми квотами и автоматически переключаться на исправный канал, если один из них начинает постоянно отвечать ошибкой 429.
APIYI apiyi.com поддерживает gemini-4-argon с высокой параллельной нагрузкой: при RPM ниже 500 можно не беспокоиться об ограничениях. Попробуйте сами. Для большинства небольших и средних приложений, внутренних инструментов, автоматизированных сценариев и нагрузочного тестирования этого достаточно для повседневных задач. Не придётся отвлекаться на уровень Tier, квоты проекта и ограничения по расходам за 10 минут.
| Критерий | Прямое подключение к AI Studio | Вызов через APIYI |
|---|---|---|
| Как распределяются квоты | Один проект, общая квота для нескольких ключей | Независимые квоты каналов, распределением занимается платформа |
| Обработка ошибок 429 | Нужно самостоятельно настраивать задержки и переключение | Платформа в первую очередь переключает запросы на исправный канал; на клиенте достаточно базовых повторных попыток |
| Ограничение расходов | Действует лимит расходов Tier за 10 минут | Не нужно самостоятельно управлять уровнем аккаунта Google |
| Подключение | Нужно создать проект и настроить Tier | Единый интерфейс, совместимый с OpenAI: достаточно заменить base_url |
| Подходящий масштаб | Низкий трафик или повышенный уровень Tier | При RPM ниже 500 можно не беспокоиться об ограничениях |
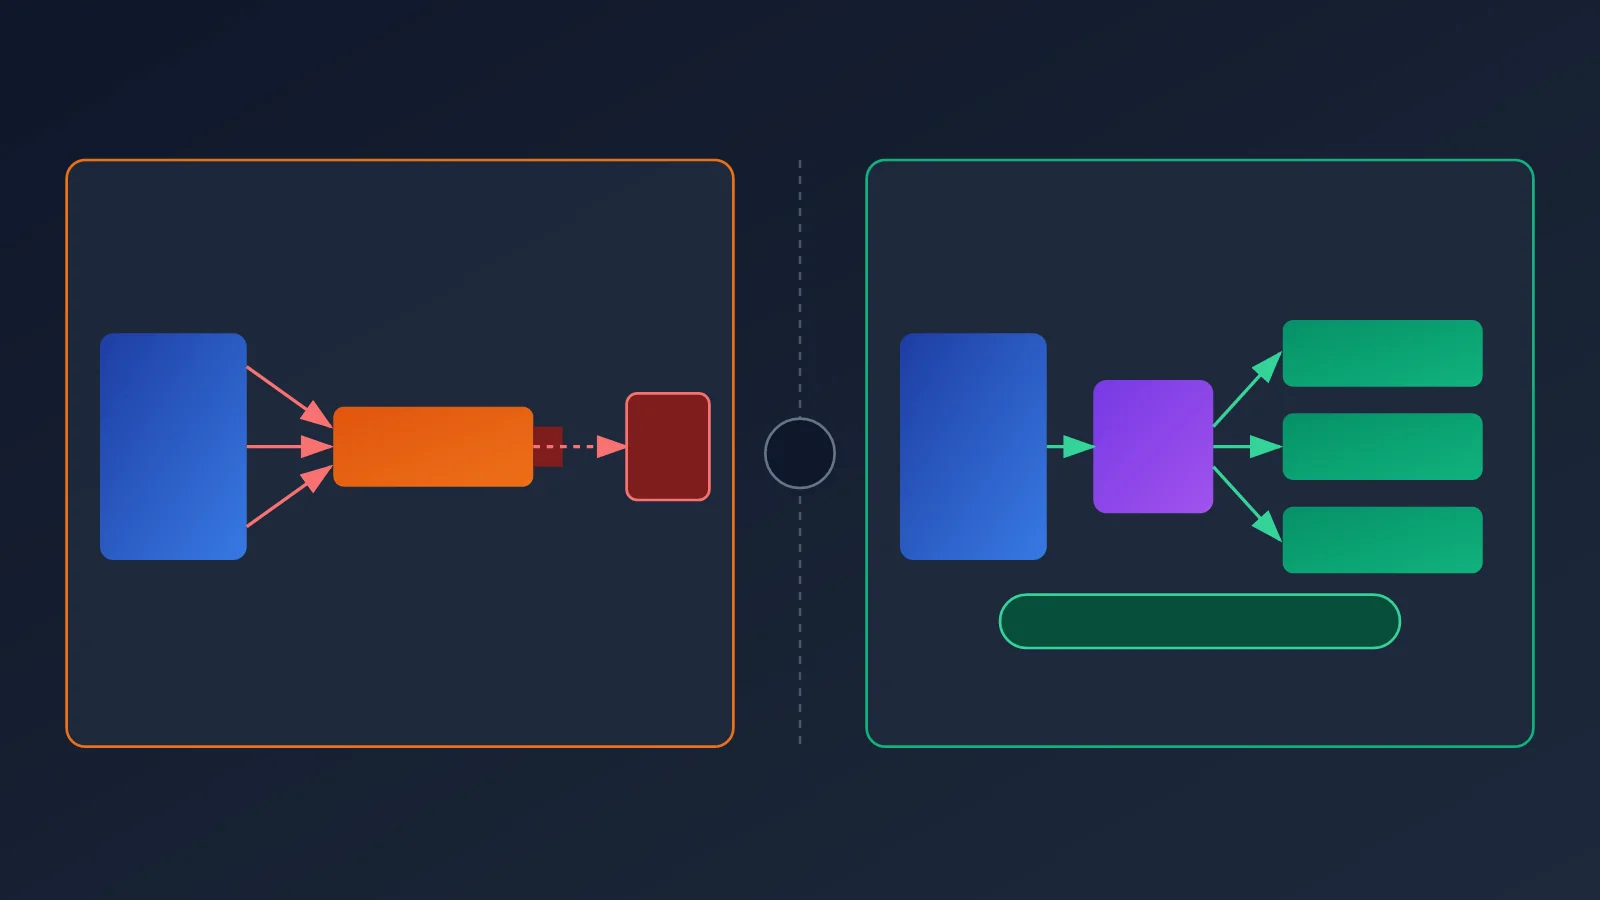
🎯 Технический совет: если пиковая нагрузка в вашем сервисе не превышает 500 RPM, вызывайте gemini-4-argon напрямую через APIYI apiyi.com и сосредоточьтесь на бизнес-логике. Если ожидается более высокий трафик, сначала проведите нагрузочные тесты с постепенным увеличением нагрузки и заранее обсудите с платформой доступную ёмкость.
Даже при использовании канала высокой параллельной нагрузки стоит оставить на клиенте экспоненциальную задержку между повторными запросами и настроить разумные тайм-ауты. Возможны сетевые сбои и кратковременные перебои на стороне вышестоящих сервисов, поэтому хорошая логика повторных запросов поможет сохранить стабильность даже в сложных ситуациях.
Часто задаваемые вопросы
Вопрос 1. Какова фактическая параллельность gemini-4-argon в AI Studio?
Google не публикует единого фиксированного значения. Фактические ограничения зависят от RPM, TPM, RPD и лимита расходов за 10 минут. Проверить их можно на странице Rate Limits в AI Studio, выбрав нужные проект и модель. Конкретные цифры, которые встречаются в интернете, не подтверждены официально — не стоит опираться на них при планировании нагрузки.
Вопрос 2. Увеличится ли квота gemini-4-argon, если создать несколько API-ключей?
Нет. Google прямо указывает, что ограничения рассчитываются для проекта, а не для API-ключа. Несколько ключей в одном проекте используют общую квоту. Чтобы получить независимые квоты, нужны разные проекты Google или сервис-агрегатор с несколькими каналами, например APIYI apiyi.com.
Вопрос 3. Почему приходит ошибка 429, если лимиты RPM и TPM не превышены?
Чаще всего причина — превышен лимит расходов за 10 минут: $10 для Tier 1, $50 для Tier 2 и $200 для Tier 3. Кроме того, вскоре после выпуска новой модели пропускной способности на стороне провайдера может не хватать, поэтому запросы отклоняются, даже если квота ещё не исчерпана. Чтобы выяснить причину, проверьте поле `error.details` в теле исходного ответа об ошибке.
Вопрос 4. Как правильно повторять запросы при ошибке 429?
Используйте экспоненциальную задержку, например 1, 2, 4 и 8 секунд, добавьте случайный разброс и повторяйте запрос не более 2–3 раз. В первую очередь следуйте значению `Retry-After` в заголовках ответа. Если ошибки 429 продолжают возникать в одном проекте, снизьте нагрузку или переключитесь на канал с независимой квотой, а не продолжайте повторы.
Вопрос 5. Как быстро вызывать gemini-4-argon через APIYI?
1. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ.
2. Укажите в коде `base_url`: `https://api.apiyi.com/v1`.
3. Задайте имя модели `gemini-4-argon` — после этого можно запускать примеры кода из статьи.
APIYI поддерживает высокую параллельность запросов к gemini-4-argon. При RPM ниже 500 о лимитах можно не беспокоиться. Это удобно для быстрой проверки и запуска проектов среднего масштаба.
Вопрос 6. Могут ли возникать ошибки 429 при использовании APIYI?
При обычной нагрузке до 500 RPM о проблемах с ограничением запросов можно практически не беспокоиться. Однако любой вышестоящий сервис может иногда работать нестабильно, поэтому рекомендуем предусмотреть базовые повторы с экспоненциальной задержкой. Если нагрузка в вашем проекте может превысить этот уровень, сначала проведите поэтапное нагрузочное тестирование и уточните доступную мощность у APIYI apiyi.com.
Вопрос 7. Можно ли использовать квоты Batch API как ориентир для параллельных запросов в реальном времени?
Нет. Указанные в документации Google квоты Argon Batch API относятся к токенам в очереди пакетной обработки и предназначены для офлайн-задач. Это отдельная система, не связанная с ограничениями на параллельные запросы и RPM для API реального времени. Эти квоты нельзя применять друг вместо друга.
Главное об ошибке 429 в gemini-4-argon
- Фиксированного лимита параллельности нет: Google не публикует единый предел для gemini-4-argon. Ориентируйтесь на фактические квоты в панели управления.
- RPM — не то же самое, что параллельность: она зависит от времени обработки запросов. При резких всплесках нагрузки ограничение срабатывает чаще, чем при равномерном потоке.
- Ограничения рассчитываются для проекта: несколько API-ключей не увеличат квоту — в рамках проекта она общая.
- Учитывайте лимит расходов за 10 минут: для Tier 1–3 он составляет соответственно $10, $50 и $200. Ошибка 429 может возникнуть, даже если лимит RPM не превышен.
- Используйте повторы, ограничение нагрузки и переключение каналов: добавляйте случайный разброс к экспоненциальной задержке, а при постоянных ошибках 429 переключайтесь на канал с независимой квотой.
- Высокая параллельность без лишних хлопот: APIYI apiyi.com поддерживает высокую параллельность запросов к gemini-4-argon. При RPM ниже 500 о лимитах можно не беспокоиться.
Итоги
Частые ошибки 429 при работе с gemini-4-argon в AI Studio возникают не столько из-за «недостаточно высокой параллельности», сколько из-за сочетания нескольких ограничений: RPM, TPM, RPD, скорости расходования квоты за 10 минут и доступной мощности инфраструктуры для новых моделей. Решать проблему тоже стоит поэтапно: сначала разобраться в исходном ответе, затем ограничить скорость запросов и добавить экспоненциальную задержку со случайным разбросом. Если ошибки 429 продолжаются — переключиться на другой канал. В долгосрочной перспективе увеличить квоту можно, повысив Tier или расширив набор авторизованных каналов.
Разработчикам, которые не хотят постоянно разбираться с квотами, проще воспользоваться агрегатором. Для быстрой проверки рекомендуем APIYI apiyi.com: платформа поддерживает вызовы gemini-4-argon с высокой параллельностью, а при RPM ниже 500 можно работать без опасений. Попробуйте сами.
Источники
- Страница квот и ограничений скорости Google AI Studio: здесь можно посмотреть RPM, TPM, RPD и уровень Tier для проекта
- Ссылка:
aistudio.google.com/usage -
Примечание: выберите проект и gemini-4-argon, чтобы увидеть актуальные квоты
-
Документация Gemini API по ограничениям скорости: официальное описание механизма ограничения запросов и рекомендации по обработке ошибок 429
- Ссылка:
ai.google.dev/gemini-api/docs/rate-limits - Примечание: содержит информацию о лимите расходования квоты за 10 минут и рекомендации по экспоненциальной задержке
Автор: APIYI Team
Обсуждение технических вопросов: делитесь в комментариях опытом поиска причин ошибок 429 при работе с gemini-4-argon. Дополнительные материалы по подключению доступны в центре документации APIYI: docs.apiyi.com