Аннотация: Google Decisions API напрямую оценивает фиксированные варианты и не генерирует текст. В этой статье на основе публичных цен рассчитывается его стоимость в задачах классификации, модерации и маршрутизации, а также с привлечением официальных и сторонних данных объясняются границы применимости.
Сначала вывод: Google 11 ноября 2026 года выпустила Gemini Decisions API (ID модели gemini-decision-1). Он позволяет в одном запросе выполнить от 1 до 1 000 независимых суждений по одному и тому же входу. Цена входных данных — 0.10 доллара за миллион токенов, платы за токены генеративного вывода нет. По расчёту на основе публичных цен, при проверке одного документа на 10K токенов по 1 000 правилам стоимость составляет около 1/20 от Gemini 3.5 Flash-Lite, теоретическая экономия — 94.9%. При однократной классификации 1 000 сообщений теоретическая экономия — 73.1%. Официальный тест Google показывает преимущество по стоимости примерно в 4.7 раза. В сторонних измерениях на одном вопросе это преимущество составляет около 1.5 раза. Для задач, где нужны только классификация, модерация или маршрутизация и где ответ можно заранее ограничить фиксированным набором вариантов, он лучше всего подходит для снижения затрат.
Далее сначала объясняется механизм работы этого интерфейса и три типа суждений, затем по воспроизводимой формуле рассчитывается стоимость трёх типовых бизнес-сценариев и объясняется разрыв между официальными «примерно в 5 раз» и сторонними измерениями. После этого сопоставляются опубликованные Google данные о скорости и независимая оценка Artificial Analysis, обсуждается, достаточна ли точность для производственных требований. В конце приводятся минимальный пример вызова, таблица выбора и контрольный список затрат перед запуском.
Для ознакомления: базовые термины
| Термин | Объяснение |
|---|---|
| Decisions API | Интерфейс принятия решений от Google, который напрямую выдаёт результат и вероятность для фиксированного набора вариантов |
| Gemini Decision 1 | Специализированная модель, лежащая в основе этого интерфейса; ID модели — gemini-decision-1 |
| Token | Базовая единица обработки и тарификации в модели: текст, изображения и прочее пересчитываются в токены |
| Shared Input | Входные данные, общие для всех решений в рамках одного запроса |
| Closed-set Decision | Решение с заранее ограниченным набором ответов, например «да/нет» или «выбрать один из A/B/C» |
| noul | Бинарное решение: возвращает вероятность ответа «Yes» |
| choice | Выбор одного варианта из заданных 2–255 опций |
| score | Оценка по заранее определённой упорядоченной шкале; результат — взвешенное ожидаемое значение |
| Confidence | Оценка моделью вероятности того, что выбранный результат верен |
| Single Forward Pass | Модель за один проход вычислений выдаёт оценки по всем вариантам — без посимвольной генерации текста |
| Context Window | Общий объём содержимого, которое вмещает один запрос; для этой модели — 262 144 токена |
| TPM / RPM | Количество токенов / запросов, обрабатываемых за минуту; это верхняя граница пропускной способности |
1 Что выпустила Google: Gemini Decisions API для ответов на вопросы с выбором
1.1 Чем Gemini Decision 1 отличается от традиционных генеративных моделей
Gemini Decisions API стал доступен 11 ноября 2026 года через Gemini Developer API v1beta; REST-эндпоинт: POST https://generativelanguage.googleapis.com/v1beta/decisions. Его основная функция — вероятностная оценка заранее заданных вариантов: API возвращает результат решения, вероятности по каждому варианту, уверенность и расход токенов. На вход принимаются текст, изображения, аудио, видео и PDF.
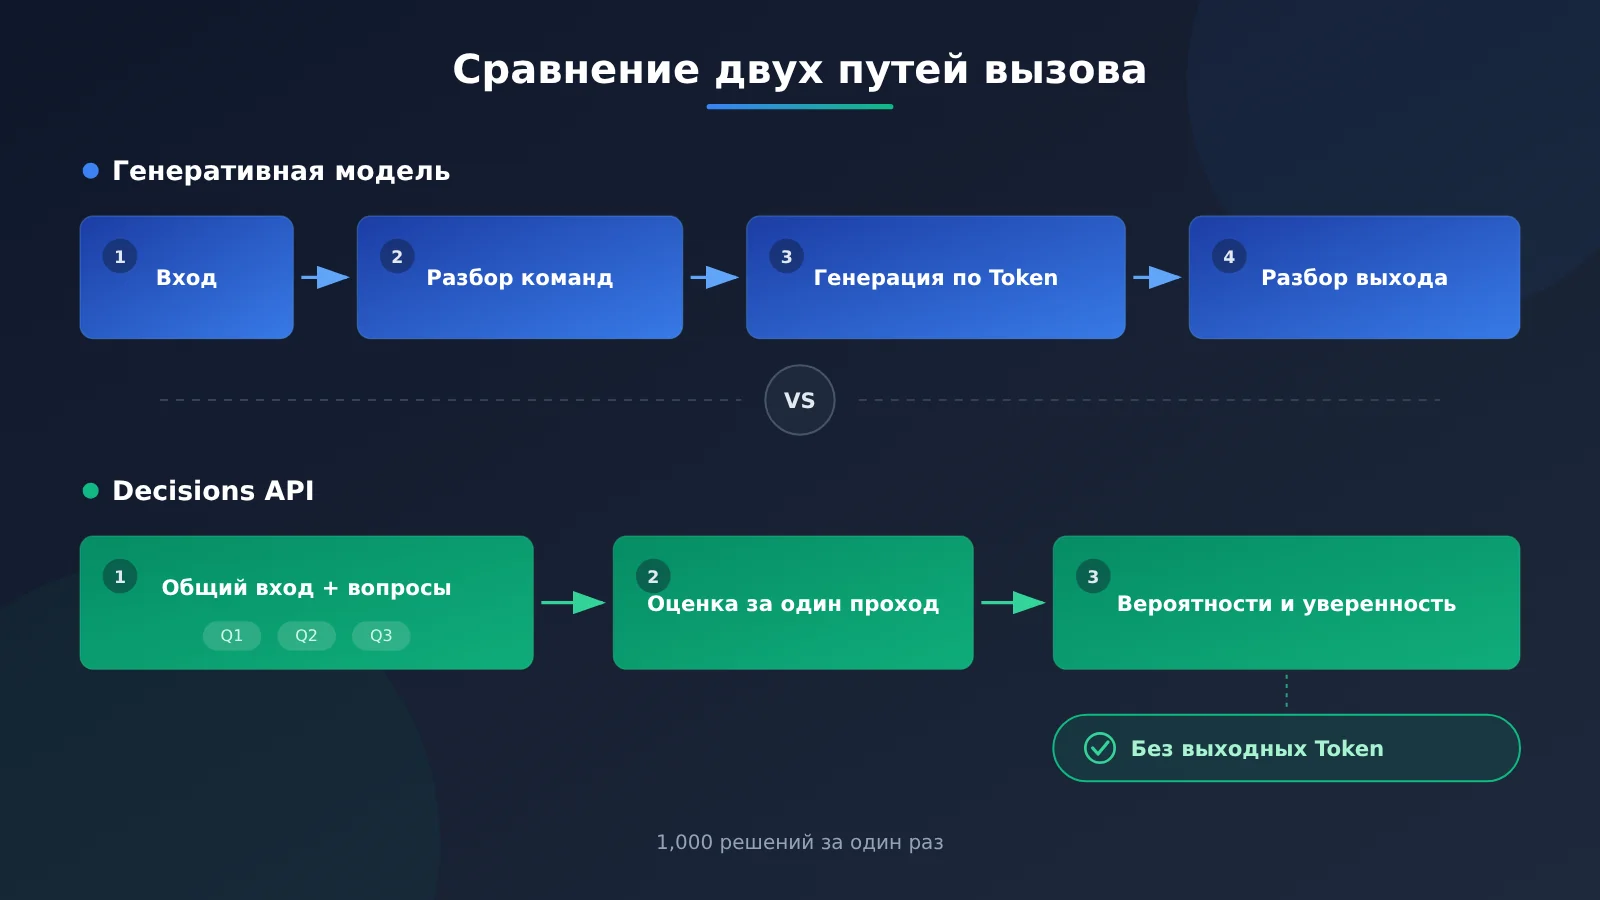
Традиционная генеративная модель решает задачу классификации так: получает содержимое, понимает инструкцию, затем генерирует ответ токен за токеном, а разработчику ещё нужно разобрать этот ответ. Decisions API меняет процесс: сначала загружается общий контент, а затем каждый вопрос напрямую оценивается по заранее заданным вариантам. Для классификации, модерации и маршрутизации достаточно одной метки или ответа «да/нет»; генерация длинного ответа и стоит денег за выходные токены, и замедляет отклик. Отказ от этого шага и есть источник снижения затрат и задержки.
1.2 Какие задачи закрывают три способа оценки в Decisions API
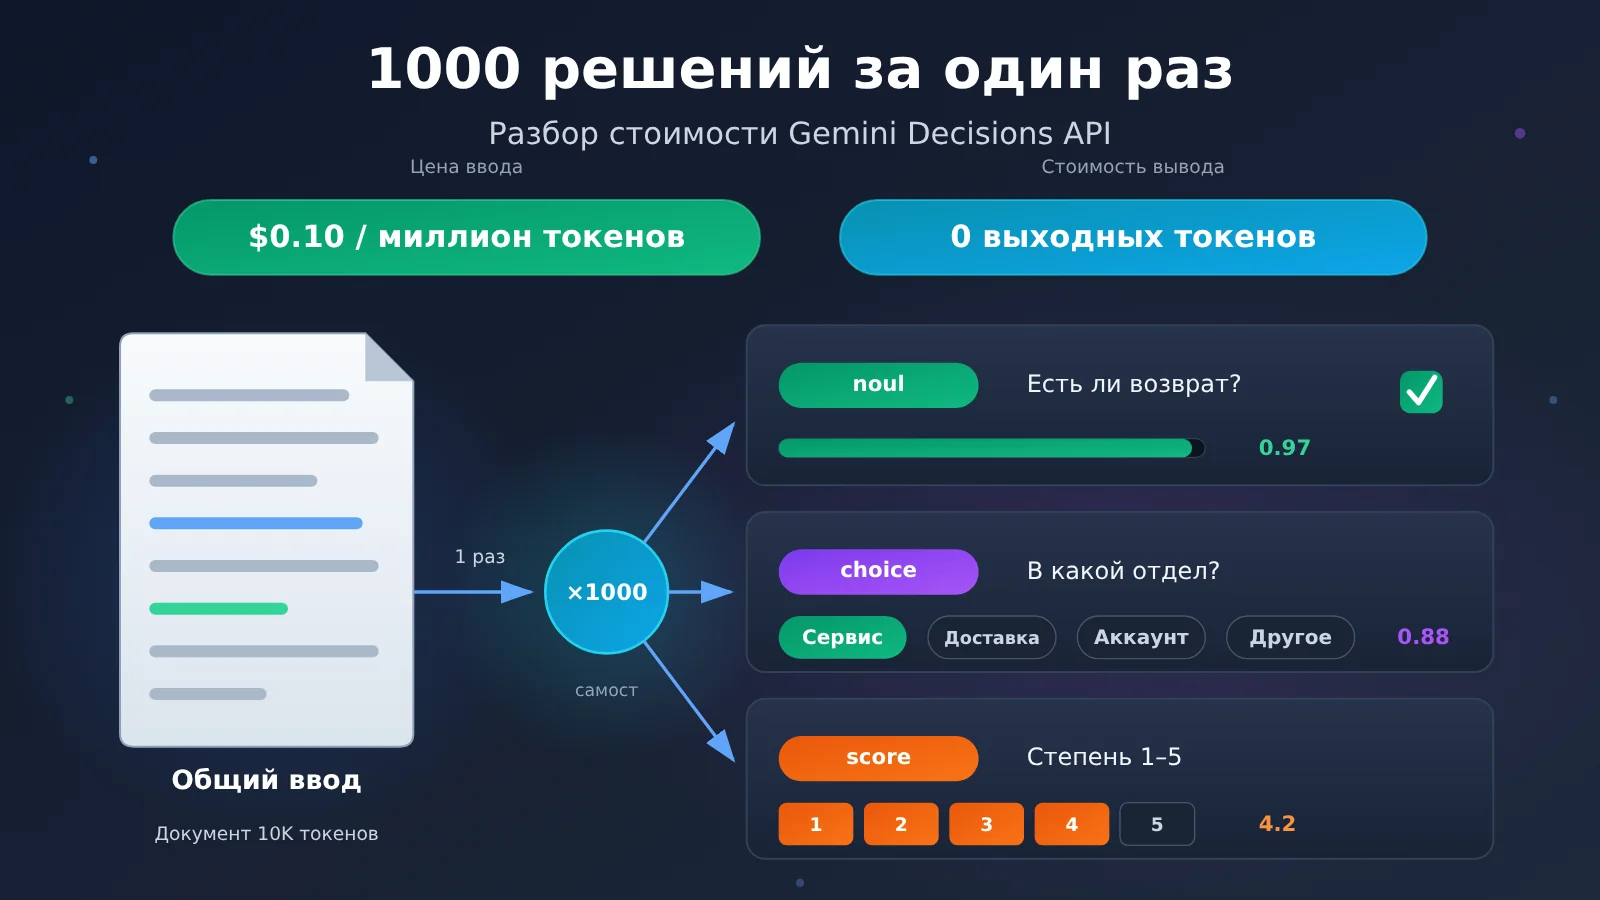
Возьмём пример сообщения в поддержку: «В наушниках, которые я купил на прошлой неделе, левый наушник не работает. Я уже три дня жду возврата денег, никто не отвечает. Если не решите вопрос, я пожалуюсь на платформу». По этому одному сообщению можно в одном запросе задать три независимых вопроса.
| Тип решения | Пример вопроса | Что возвращается | Типичные задачи |
|---|---|---|---|
| noul | Связано ли это сообщение с возвратом денег? | Вероятность «Yes», например 0.97 | Нарушение правил, упоминание цены, необходимость эскалации на проверку |
| choice | В какой отдел передать: послепродажная поддержка / логистика / аккаунт / другое? | Выбирается «послепродажная поддержка» и приводятся вероятности по всем вариантам | Маршрутизация тикетов, классификация статей, выбор инструмента агентом |
| score | Насколько серьёзна жалоба по шкале от 1 до 5? | Взвешенное ожидаемое значение по вероятностям уровней, например 4.2 | Оценка релевантности, серьёзности, приоритета лида |
choice поддерживает от 2 до 255 вариантов, score — от 2 до 255 уровней. score возвращает ожидаемое значение, вычисленное по вероятностям уровней, поэтому его можно напрямую использовать для сортировки или установки порога — не нужно извлекать оценку из текстового пояснения.
2 Google Decisions API: сколько реально можно сэкономить — считаем на трёх бизнес-сценариях
2.1 Почему общий вход снижает расход токенов
У тарификации Decisions API есть три особенности: общий вход в рамках одного запроса оплачивается только один раз; инструкции каждого отдельного вопроса по-прежнему тарифицируются как входные токены; результат проверки не создаёт расходов на генеративный вывод. Для сравнения возьмём официальные стандартные цены Gemini 3.5 Flash-Lite: 0,30 доллара за миллион входных токенов и 2,50 доллара за миллион выходных (официальный прайс-лист от 13 ноября 2026 года).
Пусть S — число токенов в одной порции общего входа, Q — число независимых вопросов по этой порции, Tq — среднее число токенов на один вопрос, To — среднее число выходных токенов на один вопрос у генеративной модели, N — число порций входа. При упрощающем допущении, что «тарифицируемые входные токены у двух интерфейсов одинаковы»:
Стоимость Decisions API  C_D = N × (S + Q×Tq) × 0.10 / 1,000,000
Стоимость Flash-Lite     C_F = N × [ (S + Q×Tq) × 0.30 + Q×To × 2.50 ] / 1,000,000
Доля экономии            = (1 − C_D / C_F) × 100%
Это расчётная модель, помогающая понять механизм; фиксированного процента экономии Google не приводит. У каждого интерфейса свои накладные расходы на кодирование инструкций и форматирование, поэтому фактические затраты определяются по тарифицированным токенам, которые возвращает каждый из них.
2.2 От 1 проверки до 1 000 проверок: как меняются расходы
Таблица ниже — это теоретический пример, рассчитанный по публичным ценам, без реальных нагрузочных тестов. В сценарии ① все 1 000 проверок относятся к одному и тому же документу: это 1 000 независимых вопросов к одному входу, и это принципиально иная нагрузка, чем «1 000 документов, каждый проанализирован по разу».
| Бизнес-сценарий | Основные допущения | Decisions API | Flash-Lite | Теоретическая экономия |
|---|---|---|---|---|
| ① Проверка одного документа по 1 000 правилам | Документ 10 тыс. токенов, каждое правило 20 токенов, Flash-Lite выдаёт 20 токенов на каждое правило; у обоих вариантов все проверки объединены в один запрос | $0.003 | $0.059 | 94.9% |
| ② 1 000 сообщений, каждое классифицируется 1 раз | По 300 токенов на сообщение, инструкция для проверки 50 токенов, Flash-Lite выдаёт 10 токенов | $0.035 | $0.130 | 73.1% |
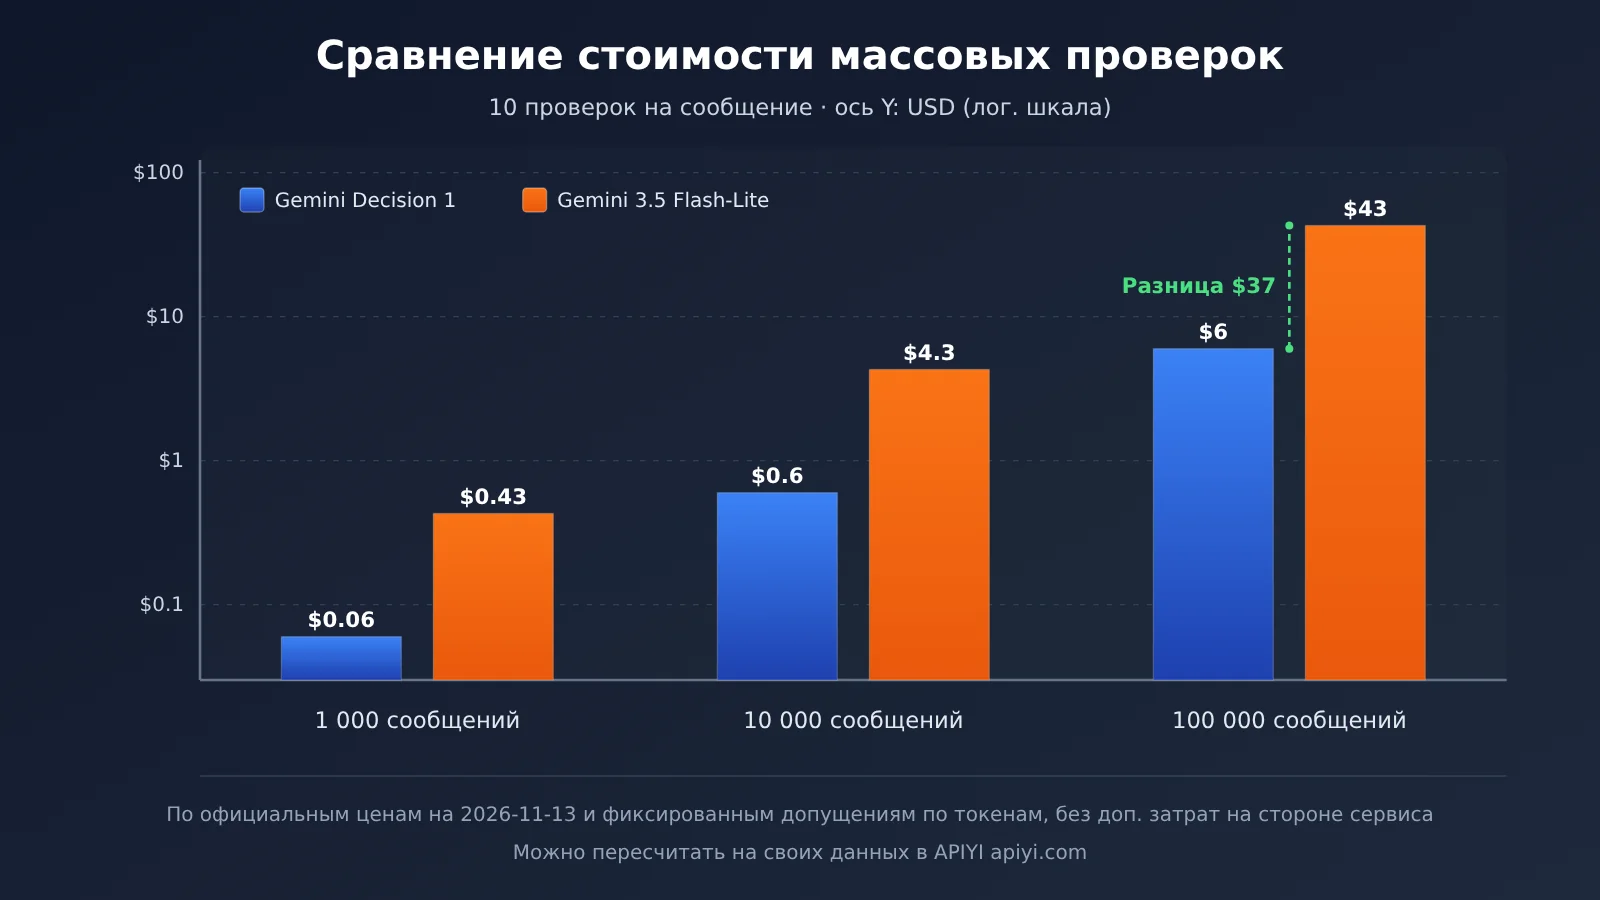
| ③ 1 000 сообщений, по 10 проверок на каждое | По 300 токенов на сообщение, 30 токенов на каждую проверку, Flash-Lite выдаёт 10 токенов на каждую проверку, один запрос на сообщение | $0.060 | $0.430 | 86.0% |
Эти три сценария показывают две вещи. В сценарии ② в каждом запросе всего один вопрос — и всё равно теоретическая экономия составляет 73.1%: цена входных токенов падает втрое, а расходы на выход равны нулю. В сценариях ① и ③ экономия выше, потому что общий вход «размазывается» по множеству вопросов, а Flash-Lite при этом должен генерировать выход для каждого вопроса.
Масштабируем параметры сценария ③: при обработке 100 тыс. сообщений и 1 млн проверок стоимость вызовов модели у Decisions API составит 6 долларов, у Flash-Lite — 43 доллара, разница — 37 долларов. Эта цифра включает только плату за вызовы модели и не учитывает повторы, ручную проверку после ошибочных срабатываний, переход на более мощную модель, передачу и хранение данных, а также затраты на инженерные доработки.
Если хотите пересчитать на своих бизнес-примерах, сначала прогоните ту же выборку данных через генеративную модель, запишите фактические входные и выходные токены, а затем подставьте их в формулу выше. В APIYI apiyi.com один ключ даёт доступ к Gemini, GPT, Claude и другим генеративным моделям — так удобно быстро построить эту базовую линию затрат.
2.3 Почему «примерно в 5 раз» от Google — не универсальный ответ
При выпуске Google сообщила, что в официальных тестах стоимость Decision 1 составляет примерно 1/4,7 от стоимости Gemini 3.5 Flash-Lite. Независимый тестировщик RanThis 12 ноября 2026 года, используя реальные вызовы API, получил другую серию цифр: 100 сообщений на английском и 20 сообщений на вьетнамском, причём каждый запрос содержал лишь одно бинарное суждение.
- Точность: из 100 суждений на английском Decision 1 дал верный ответ в 99 случаях, Flash-Lite — в 98.
- Стоимость: расчётная стоимость тысячи суждений на английском составила $0,0113 и $0,0166 соответственно, то есть Decision 1 примерно на 32% дешевле — разница около 1,5 раза.
- Задержка: медианная задержка одного запроса составила 0,18 секунды и 0,58 секунды соответственно.
- Расход Token: Decision 1 в среднем тарифицирует около 113 входных Token на запрос, Flash-Lite — около 47 входных Token плюс 1 выходной Token.
Причина расхождения очевидна: накладные расходы самого интерфейса Decisions на инструкции и формат более чем удваивают тарифицируемые входные Token, что частично перекрывает преимущество в цене за единицу. Когда вход очень короткий, за раз задаётся лишь один вопрос, а генеративной модели нужно выдать всего один Token, экономия минимальна. Когда RanThis объединил 10 вопросов об одном и том же письме в один запрос Decision 1 и сравнил его с 10 отдельными запросами Flash-Lite, разрыв вырос примерно до 5,4 раза; но в этом сравнении Flash-Lite не выполнял такого же объединения, так что это сравнение разных способов отправки запросов.
Таким образом, переменные, влияющие на реальную экономию, таковы: длина общего входа, количество вопросов на один вход, длина вывода генеративной модели, применяется ли объединение запросов с обеих сторон, а также фиксированные накладные расходы самого интерфейса. Вывод формул, официальные бенчмарки и сторонние измерения получены в разных условиях, и при выборе модели их следует рассматривать по отдельности.
3. 1000 решений за один вызов: для каких задач Decisions API реально подходит?
3.1. Проверка документов: один материал — множество правил
Преимущество общего входа лучше всего раскрывается в формуле «длинный материал + много правил». Контракт, тендерная документация или инструкция к продукту — всё это нужно по пунктам сверять с чек-листом соответствия: есть ли пункт о нарушении обязательств, прописана ли передача данных за рубеж, превышает ли срок оплаты 60 дней, отсутствует ли дата подписания и т. д. Чем длиннее материал и чем больше правил, тем сильнее «размазывается» общий вход, и теоретическая экономия 94,9% из сценария ① — прямое следствие именно такой структуры.
Ещё одно преимущество таких задач — результат сразу можно занести в таблицу. Каждое правило — это отдельное решение noul, возвращающее вероятность и уверенность; программа может по порогу пометить «проходит / не проходит / требует проверки», и проверяющий смотрит только на те пункты, которые нужно перепроверить.
3.2. Маршрутизация агентов и классификация контента
На каждом шаге агент решает, что делать дальше: нужен ли поиск в интернете, запускать ли код, передавать ли задачу другому инструменту. У таких решений фиксированный набор вариантов, они вызываются часто и чувствительны к задержке — идеальный случай, чтобы сделать всё за один вызов с помощью choice. Внутренние случаи использования, раскрытые Google, тоже сосредоточены здесь: Gemini Notebook с его помощью выбирает модель и уровень «размышлений» в зависимости от характера вопроса, снижая задержку обычных запросов до 40%; Google Search применяет его для проверки безопасности MCP-инструментов и выявления состязательного контента; CC быстро выбирает реакцию из более чем 200 кандидатов-эмодзи. Это данные самого Google; реальный эффект у сторонних разработчиков зависит от их собственной нагрузки.
Ещё один смежный сценарий — рабочие процессы создания контента. Когда собрана одна новость об ИИ, системе нужно определить, новое ли это событие, связано ли оно с разработчиками, затрагивает ли цены API, есть ли официальный источник, подходит ли она для статьи-руководства, и оценить ценность контента. Эти шесть условий независимы друг от друга, их можно уложить в один запрос к Decisions и выполнить отбор, а прошедшие отбор темы передать генеративной модели для исследования, написания и редактуры. Это пример схемы, построенной на возможностях API. На этапе генерации во второй половине можно через APIYI apiyi.com по мере необходимости переключать разные модели и сравнивать качество текстов и затраты.
3.3. Три границы 1000 вопросов
- Вопросы должны быть независимы друг от друга. Решения внутри одного запроса не могут читать результаты друг друга. Процессы с последовательной зависимостью вроде «сначала определить, есть ли жалоба, а потом классифицировать её по типу» требуют, чтобы программа комбинировала результаты и при необходимости отправляла следующий запрос.
- 1000 вопросов делят между собой контекстное окно в 262 144 токена. Общий вход и все вопросы вместе занимают это окно: чем длиннее инструкция для каждого вопроса, тем короче материал, который удастся поместить.
- Официальные данные о низкой задержке касаются только малых запросов. В тестах Google задержка оставалась примерно стабильной при 1–100 вопросах на запрос и контексте до 16K токенов. При 1000 вопросах и почти заполненном контексте задержку нужно измерять самостоятельно.
4. Помимо дешевизны: хватит ли Gemini Decisions API точности и скорости для продакшена?
4.1. Скорость и данные внутренних применений, которые опубликовал Google
Google сообщает, что медиана времени вычислений модели — 50–100 мс, сквозная задержка — 150–250 мс. Условия теста: от 1 до 100 вопросов за раз, контекст не больше 16 тыс. токенов. Эти цифры говорят о том, что модель можно встроить в контур реального времени — например, для маршрутизации на каждом шаге агента или мгновенной сортировки сообщений пользователей. Замер RanThis на одном вопросе дал медианную задержку 0,18 секунды — тоже примерно в этом диапазоне.
4.2. Что говорят сторонние бенчмарки
Первые результаты Decision Index v2.1 от Artificial Analysis, где смешаны исходные баллы и реальные задачи. Стоимость в таблице ниже — это смешанная стоимость задач этого бенчмарка; это другой показатель, чем «цена за миллион токенов», счёт ведётся по другой методике.
| Модель для решений | Итоговый балл | Время на задачу | Оценка стоимости за миллион задач | Доля задач AA-Paperclip, где все 15 пунктов верны |
|---|---|---|---|---|
| Drex Max v1.1 | 72,62 | 283 мс | $103 | 63% |
| TypeSafe Jev 1.14 | 66,23 | 92 мс | $156 | 35,5% |
| Gemini Decision 1 | 65,98 | 211 мс | $345 | 33% |
| GPT-6 Luna (Decisions) | 60,25 | 206 мс | $339 | — |
Здесь важны два момента. Во-первых, у Gemini Decision 1 низкая цена за токен, но на этом наборе задач оценка стоимости на миллион задач выше, чем у Drex Max и Jev. То есть способ отправки запросов и структура задач меняют итоговую экономику. Во-вторых, в тесте AA-Paperclip на документах доля документов, где Decision 1 за один проход выполнил все 15 проверок и все сделал правильно, составила 33%. Выполнение нескольких проверок за один проход экономит деньги, но точность каждой проверки всё равно нужно подтверждать отдельно.
4.3. Как использовать уверенность, чтобы ошибки не выполнялись автоматически
Уверенность (confidence) — это оценка моделью вероятности собственного результата. По ней можно решать, какие результаты исполнять автоматически, а какие передавать человеку. При выводе в продакшен рекомендую соблюдать три правила:
- Задайте порог уверенности: например, если уверенность в решении о возврате средств ниже 0,85 — передаём человеку; если выше порога — можно автоматически ставить метку или распределять заявку.
- Добавьте в choice вариант other: когда ни один вариант не подходит, модель всё равно выберет один из них. Вариант «другое / не могу определить» поможет отсечь часть входных данных вне допустимых границ; ещё можно отдельно добавить noul для проверки диапазона.
- Для высокорисковых операций сохраняйте ограничения в коде: суммы возвратов, блокировки аккаунтов, комплаенс-ограничения и другие действия должны опираться не только на решение модели, но и на жёстко прописанные правила и проверку человеком.
5 Как разработчикам использовать и выбирать Gemini Decisions API?
5.1 Как отправить первый запрос
Официально требуется Python SDK google-genai версии 3.2 или новее; также поддерживаются JavaScript SDK и REST. Для подключения нужен API-ключ Google AI Studio. Приведённый ниже пример собран по структуре официального SDK: для одной и той же новости одновременно выполняется бинарное суждение и классификация. В этой статье он не проверялся реальным вызовом — названия полей уточняйте по официальному руководству для разработчиков.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    # input: общий вход для всех вопросов, тарифицируется один раз
    input="Google released a new AI API with official pricing and developer documentation.",
    # questions: независимые суждения, ключ — это ID вопроса
    questions={
        "has_api_pricing": {
            "type": "noul",
            "instructions": "Does this news mention API pricing?",
        },
        "category": {
            "type": "choice",
            "instructions": "Which news category fits best?",
            "criteria": {
                "model": "An AI model launch",
                "api": "An API or developer tool",
                "business": "Business or finance news",
            },
        },
    },
)

print(result.answers)  # результаты по каждому вопросу, вероятности вариантов и уверенность
print(result.usage)    # расход тарифицируемых токенов; на этом основывается расчёт стоимости
Четыре ключевых поля работают так: input — общий контент, questions — независимые вопросы (как задавать уровни для типа score, смотрите в официальном руководстве), answers — результаты суждений и вероятности, usage — тарифицируемые токены. При расчёте стоимости обязательно используйте реальные значения из usage: в разделе 2.3 уже сказано, что фиксированные накладные расходы интерфейса заметно влияют на стоимость одного вопроса.
Чтобы сравнить стоимость, нужна ещё базовая линия на генеративной модели. Ниже через OpenAI-совместимый интерфейс и APIYI вызывается Flash-Lite для той же классификации с записью расхода токенов:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",  # точное название смотрите в списке моделей платформы
    messages=[{
        "role": "user",
        "content": "News: Google released a new AI API with official pricing.\n"
                   "Q1 mentions API pricing? Answer yes/no.\n"
                   "Q2 category: model/api/business. Answer one word each line."
    }],
    max_tokens=10,
)
print(resp.choices[0].message.content)
print(resp.usage)  # входные и выходные токены — подставьте в формулу из раздела 2.1
Посмотреть скрипт массового сравнения: подсчёт стоимости двух интерфейсов на одной и той же выборке
import openai

PRICE_IN, PRICE_OUT = 0.30, 2.50   # Официальная стандартная цена Flash-Lite: USD за миллион токенов
DECISION_IN = 0.10                 # Цена входных токенов Decision 1; выходные не тарифицируются

gen_client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def flash_lite_cost(samples, questions, model="gemini-3.5-flash-lite"):
    """Объединяет все вопросы каждого образца в один генеративный запрос и суммирует фактическую стоимость"""
    total = 0.0
    for text in samples:
        prompt = text + "\n" + "\n".join(
            f"Q{i+1}: {q} Answer briefly." for i, q in enumerate(questions)
        )
        r = gen_client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
            max_tokens=10 * len(questions),
        )
        total += (r.usage.prompt_tokens * PRICE_IN
                  + r.usage.completion_tokens * PRICE_OUT) / 1_000_000
    return total

def decision_cost(usage_input_tokens_list):
    """Принимает входные токены usage, которые Decisions API возвращает при каждом вызове, и вычисляет общую стоимость"""
    return sum(t * DECISION_IN for t in usage_input_tokens_list) / 1_000_000
🚀 Совет для быстрого старта: сначала возьмите 200–500 реальных бизнес-примеров, прогоните генеративную модель, чтобы получить базовую точность и расход токенов, а затем сравните с
usageиз Decisions API. APIYI apiyi.com предоставляет OpenAI-совместимый интерфейс и бесплатный тестовый лимит для новых пользователей — отлично подходит, чтобы быстро выполнить этот базовый тест.
5.2 Когда выбирать Decisions API, а когда оставаться на генеративных моделях
| Тип задачи | Рекомендуемый подход | Причина |
|---|---|---|
| Проверка одного длинного документа на соответствие множеству правил | Decisions API | Общий вход снижает затраты, а проверки не зависят друг от друга |
| Маршрутизация инструментов агента, выбор модели | Decisions API | Фиксированный набор вариантов, низкая задержка |
| Проверка безопасности контента и нарушений | Decisions API | Несколько независимых условий noul, можно распределять по уверенности |
| Классификация обращений в поддержку, теги для возвратов в электронной коммерции | Decisions API | Фиксированный набор тегов |
| Отбор тем, оценка приоритета лидов | Decisions API | Подходит score по заранее заданной шкале |
| Суммаризация, перефразирование, написание текстов | Генеративная модель | Нужен вывод на естественном языке |
| Сложные исследования, аргументация, выдвижение новых идей | Генеративная модель | Требуется открытое рассуждение |
| Процессы, где проверки последовательно зависят друг от друга | Оркестрация программ + несколько запросов, или генеративная модель | Внутри одного запроса вопросы не могут ссылаться друг на друга |
Структурированный вывод генеративных моделей (JSON Schema) тоже позволяет ограничить ответ фиксированным форматом, но модель всё равно генерирует содержимое токен за токеном и тарифицирует по объёму вывода, а вероятности приходится получать с помощью дополнительной обработки. Decisions API сразу возвращает вероятность и уверенность по каждому варианту, вывод не тарифицируется, но ценой этого становится возможность отвечать только на вопросы с заранее заданным набором вариантов.
5.3 Какие ещё затраты нужно учесть перед запуском
Помимо цены за единицу, на «общую стоимость каждого правильного решения» напрямую влияют несколько факторов:
- Фактический расход токенов: ориентируйтесь на
usage; в сценарии с коротким вводом и одним вопросом доля фиксированных затрат наиболее высока. - Лимиты запросов: бесплатный уровень — 200 RPM, 50 000 TPM, 10 000 RPD; платный Tier 1 — 1 500 RPM, 1 млн TPM, 50 000 RPD. Запросы с длинным контекстом обычно первыми упираются в лимит TPM.
- Отсутствие кэширования и пакетной обработки: не поддерживаются Context Caching, Batch API, Flex/Priority inference, поэтому при повторном использовании одного и того же длинного документа скидка за кэширование недоступна.
- Функциональные ограничения: в инструкции вопроса нельзя размещать медиаматериалы, а также нельзя напрямую передавать полную историю диалога, блоки рассуждений или блоки вызова инструментов — многоходовой диалог нужно предварительно привести к текстовому вводу.
- Ошибочные решения и ручная проверка: долю передач на ручную обработку при низкой уверенности и стоимость переработки после ошибок нужно включать в стоимость единицы.
- Условия обработки данных: данные бесплатного уровня могут использоваться для улучшения продуктов Google, а в официальной таблице цен указано, что платные уровни для этого не используются. Перед обработкой клиентских документов стоит уточнить, какой уровень используется.
- Инженерная доработка: переписывание генеративных промптов в вопросы noul / choice / score, настройка порогов и логики откатов — всё это требует вложений в разработку.
Если вы планируете подключаться через стороннюю API-платформу, нужно проверить, поддерживает ли она специализированный эндпоинт /v1beta/decisions: платформы, поддерживающие только Chat Completions, не могут напрямую вызывать Decisions API. Перед использованием на APIYI apiyi.com можно сначала посмотреть список моделей и эндпоинтов в центре документации или связаться с платформой, чтобы уточнить поддержку.
6. Заключение: задачи классификации, модерации и маршрутизации можно передать Gemini Decisions API
Возвращаясь к вопросу из заголовка, можно сделать три вывода:
- Для задач с фиксированным набором вариантов стоит в первую очередь рассмотреть Decisions API. Если отталкиваться от публичных цен, теоретическая экономия на классификации одного вопроса составляет около 73%, а на проверке тысячи правил в одном длинном документе — около 95%; по сторонним замерам на одном вопросе преимущество составляет примерно 32%.
- «Один вход — несколько независимых вопросов» — структура с наибольшим потенциалом экономии. Общий вход оплачивается только один раз: чем больше вопросов, чем длиннее вход и чем длиннее вывод генеративной модели, тем больше разрыв.
- Главный критерий — общая стоимость каждого правильного решения в продакшене. Цена за токен и лимит в 1 000 вопросов — это только отправная точка; реальную выгоду определяют точность, доля ручной обработки после разделения по уровню уверенности, лимиты и инженерные затраты.
Более надёжный путь такой: сначала получить базовые показатели генеративной модели на реальных примерах, затем сравнить usage и точность в Decisions API и проектировать слой принятия решений отдельно от слоя генерации. Выбор модели и сравнение затрат для слоя генерации можно выполнить через APIYI apiyi.com с помощью единого интерфейса.
📚 Справочные материалы
- Руководство для разработчиков и таблица цен Google Gemini Decisions API: возможности интерфейса, ограничения, квоты и официальные цены
- Ссылка:
ai.google.dev -
Описание: идентификаторы моделей, типы задач, контекстное окно, лимиты скорости и использование SDK
-
Публикация в официальном блоге Google: дата выхода, данные о задержках и примеры внутреннего применения
- Ссылка:
blog.google -
Описание: вычисления занимают 50–100 ms, преимущество в стоимости примерно в 4.7 раза, кейсы вроде Gemini Notebook и другие
-
REST-эндпоинт Gemini Decisions API
- Ссылка:
generativelanguage.googleapis.com/v1beta/decisions -
Описание: официальная конечная точка для вызовов через REST
-
Artificial Analysis Decision Index v2.1: оценка моделей принятия решений от третьей стороны
- Ссылка:
artificialanalysis.ai -
Описание: итоговый балл, время выполнения задачи, стоимость за миллион задач и доля полностью правильных ответов AA-Paperclip
-
Независимое тестирование RanThis (2026-11-12): небольшой тест на основе реальных вызовов
- Описание: сравнение стоимости одной задачи, задержки и расхода токенов, а также результаты объединённых запросов по нескольким задачам
Автор: техническая команда APIYI
Связь по техническим вопросам: пишите нам через главную страницу APIYI apiyi.com, больше материалов по интеграции — в центре документации docs.apiyi.com