Примечание автора: оценки в публичных рейтингах могут быть намеренно завышены. В этой статье разберёмся, почему возникает benchmaxing, предложим 5 проверок достоверности и расскажем, как за 4 шага создать приватный набор тестов на основе собственных задач.
Сразу к главному: баллы в рейтингах могут стать отправной точкой для исследования, но не должны напрямую определять выбор модели. Разница между ведущими моделями в общих рейтингах часто составляет всего несколько баллов — и этого достаточно, чтобы сменился лидер. При таком небольшом разрыве оптимизация под тестовые задания легко влияет на позиции. Это явление называют benchmaxing.
При выборе модели действительно важно то, как кандидаты справляются с задачами вашего бизнеса. В этой статье мы не составляем рейтинг моделей и не пытаемся определить, кто «жульничает». Вместо этого разберём три вопроса: как распознать возможное завышение оценок, как создать небольшой приватный набор тестов на основе реальных рабочих задач и какие важные показатели рейтинги могут вовсе не охватывать.
Что такое benchmaxing: 3 причины завышенных результатов в рейтингах
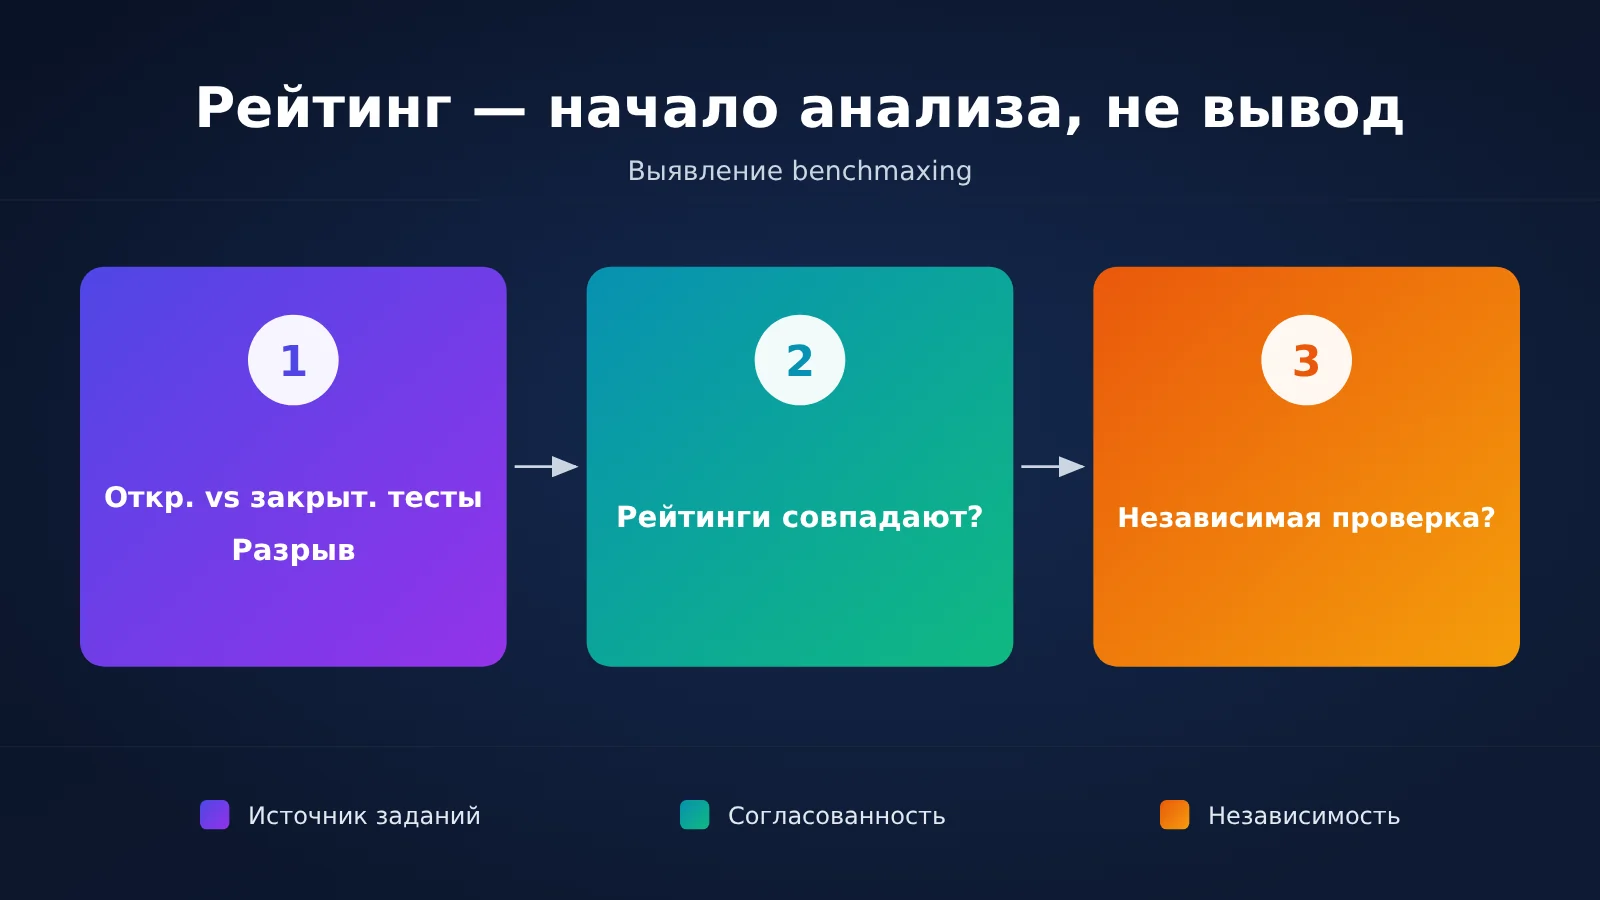
Согласно статье MindStudio от 1 ноября 2026 года, benchmaxing — это обучение или настройка модели с целью получить высокие баллы на известных бенчмарках, а не улучшить её общие способности. Типичная картина: модель впечатляет в рейтинге, но заметно хуже справляется с новыми задачами, которые проверяют тот же навык.
| Причина | Как это происходит | На что обратить внимание |
|---|---|---|
| Задания попали в обучающие данные | Задания бенчмарка или очень похожие на них варианты намеренно или случайно попали в обучающий корпус | На оригинальных заданиях результат высокий, но после их переформулировки он снижается |
| Дообучение под тип задач | Модель специально оптимизируют под форматы и схемы рассуждений, характерные для конкретного бенчмарка | Модель выделяется только в одном рейтинге, а в остальных показывает средние результаты |
| Открытые задания давно распространены | Задания обсуждают на форумах и в блогах, а затем они попадают в данные, собранные с веб-страниц | Чем старше открытый бенчмарк, тем ближе результаты к максимальным |
Benchmaxing не обязательно связан со злым умыслом
В оригинальной статье отдельно отмечается, что ни в одном из этих трёх случаев злой умысел не обязателен. Лаборатория может искренне считать, что улучшает общие способности модели к рассуждению, хотя на деле модель переобучается на нескольких известных типах задач. Чем дольше бенчмарк находится в открытом доступе, тем меньше он похож на инструмент измерения способностей и тем больше — на пробный тест, который модель уже прошла заранее.
Поэтому судить стоит по фактам, а не по предполагаемым мотивам. Важно, сохраняется ли высокий результат на новых задачах, а не то, сделал ли кто-то это намеренно.
Почему возникает benchmaxing: темп релизов и сравнение результатов
Для лабораторий оценки в тестах — самый простой способ показать инвесторам, разработчикам и широкой публике, что работа движется вперёд. При этом открывать доступ к полноценному независимому аудиту не нужно. Цифру вроде «59 баллов в сводном индексе» легко включить в пресс-релиз и сравнить с результатом конкурента. Чем проще показатель, тем сильнее давление, подталкивающее к оптимизации именно под него.
Второй фактор — темп релизов. Согласно той же статье MindStudio, одна из моделей семейства Google Gemini набрала 50 баллов в Artificial Analysis Index, а примерно через месяц следующая модель той же компании получила 59 баллов и возглавила рейтинг. Пока у этих данных только один источник, и для этой статьи они независимо не проверялись. Автор показывает, что новые версии выходят с интервалом в недели, лидеров разделяют считаные баллы, поэтому любой способ оторваться от конкурентов выглядит привлекательно.
Прежде чем читать рейтинги, разделим факты по категориям
Ссылаясь на результаты тестов, сначала стоит понять, к какой категории они относятся. В таблице ниже — примеры из этой статьи:
| Тип факта | Пример из статьи | Как оценивать |
|---|---|---|
| Данные компании / устный прогноз | Илон Маск заявил, что Grok 5 может набрать «почти максимальный балл» в Humanity’s Last Exam, а Grok 4 получил около 52% в текстовой части этого теста | Это прогноз и данные самой компании, а не результаты независимого тестирования |
| Независимое тестирование третьей стороной | Artificial Analysis Index объединяет тесты на рассуждение, программирование, научные знания, математику и другие способности | Можно использовать как ориентир, указав дату обращения к данным |
| Публикация в одном медиа | Результат Grok 4.7 в индексе и Terminal-Bench, а также изменение показателя Gemini с 50 до 59 | Единственный источник — MindStudio; независимой проверки не было |
| Неизвестно | Точное время перехода Artificial Analysis на закрытые задания и его масштаб | Следует ориентироваться на официальные разъяснения; в этой статье предположения не делаются |
По данным MindStudio, Grok 4.7 отстаёт от ведущих моделей и в независимом сводном индексе, и в Terminal-Bench. Автор исходной статьи рассматривает этот «разрыв между публичными ожиданиями и независимыми тестами» как повод присмотреться к результатам, но прямо отмечает: это не означает, что у xAI больше проблем, чем у других компаний. Мы приводим этот пример в том же качестве и не делаем никаких выводов.
5 признаков, по которым можно оценить надёжность результатов в рейтинге
Независимые организации нашли простой способ противодействия: не публиковать задания. Если задания никогда не были в открытом доступе, никто не сможет обучить модель специально под них. По данным MindStudio, такие организации, как Artificial Analysis, уже перешли к закрытым заданиям. Разрыв между результатами на открытых и новых закрытых заданиях в одной категории считается одним из самых надёжных признаков бенчмаксинга — подгонки модели под тесты.
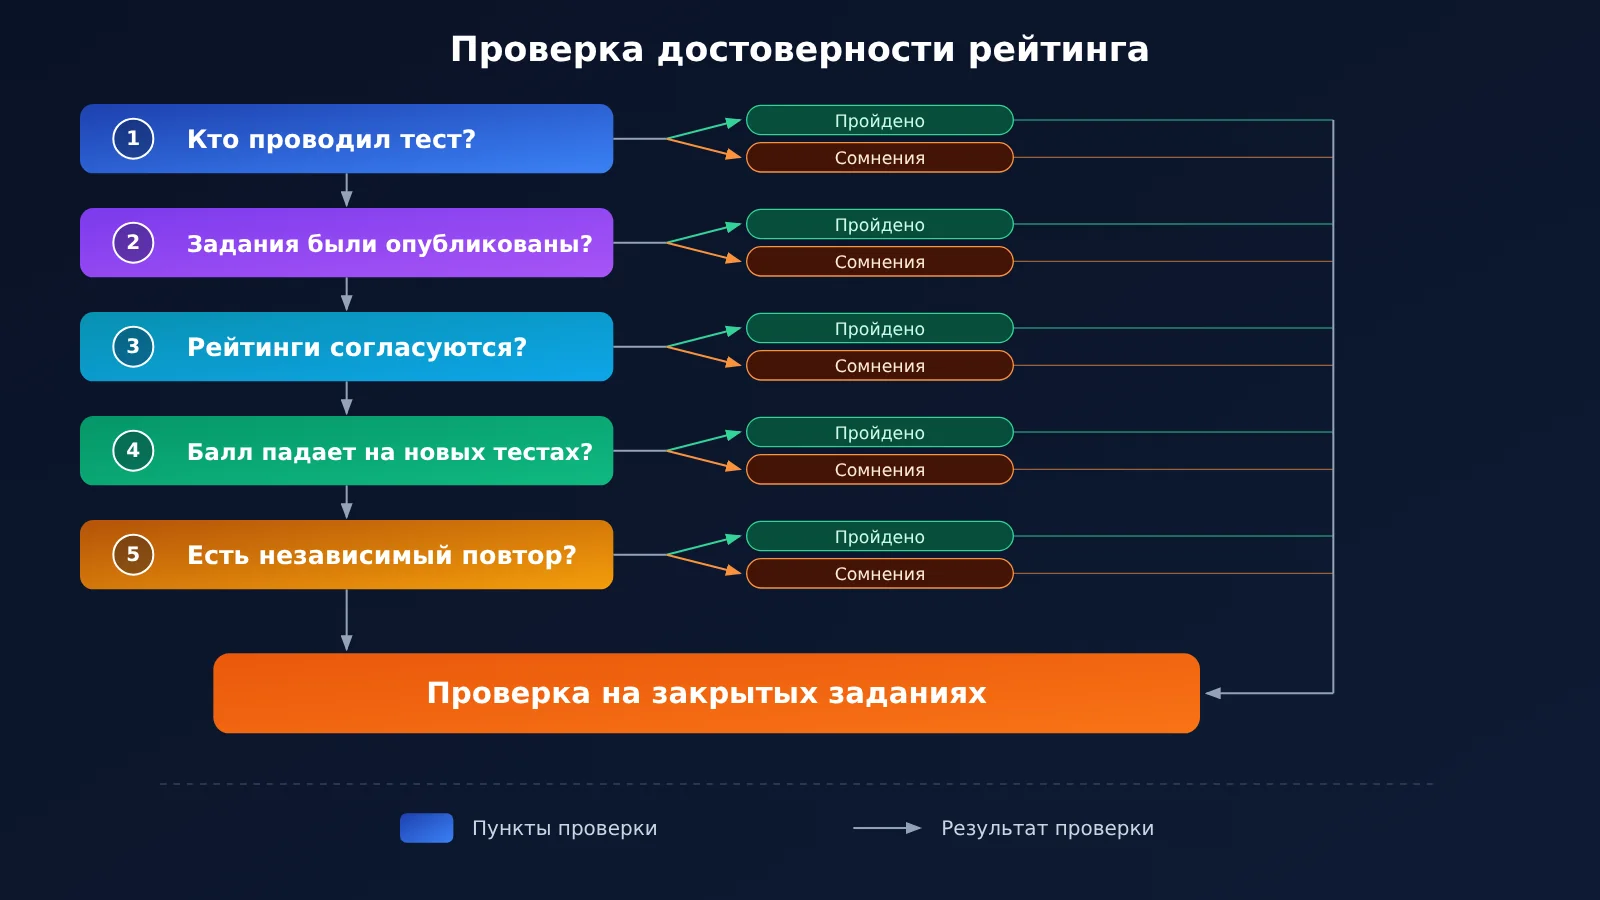
На основе рекомендаций из оригинальной статьи можно составить такой чек-лист из пяти пунктов:
| № | Что проверить | Как проверить | Хороший знак | Повод насторожиться |
|---|---|---|---|---|
| 1 | Кто проводил тест | Посмотрите, откуда взяты результаты: из технического отчёта разработчика или со страницы стороннего тестирования | Независимое тестирование третьей стороной | Только данные от самого разработчика |
| 2 | Публиковались ли задания | Проверьте, вышел ли бенчмарк до даты окончания обучения модели | Закрытые задания или новые задания, появившиеся после обучения | Старые задания, опубликованные много лет назад |
| 3 | Сходятся ли результаты в разных рейтингах | Сравните результаты в нескольких бенчмарках на рассуждение, программирование, математику и другие навыки | Позиции в разных рейтингах примерно совпадают | Модель выделяется только в одном рейтинге |
| 4 | Падают ли результаты при смене заданий на тот же навык | Сравните результаты на открытых и закрытых наборах, оригинальных и переформулированных заданиях | Разница после смены заданий невелика | После смены заданий результат заметно падает |
| 5 | Воспроизвели ли результат независимые эксперты | Найдите отчёты о независимом воспроизведении и проверьте настройки тестирования | Результаты воспроизведены несколькими сторонами, настройки прозрачны | Результат не удаётся воспроизвести или настройки не раскрываются |
Почему комплексный индекс сложнее накрутить
По мнению автора оригинальной статьи, ценность Artificial Analysis Index в том, что он объединяет результаты разных тестов в одну оценку. Переобучить модель под один тест возможно. Но сделать это одновременно для тестов на рассуждение, программирование, естественные науки и математику гораздо сложнее, особенно если часть заданий закрыта. Поэтому пункту 3 — «Сходятся ли результаты в разных рейтингах» — стоит придать больше веса.
Как собрать свой закрытый набор задач для оценки: 4 шага
Каким бы честным ни был рейтинг, модели в нём проверяют на чужих задачах. Для окончательного выбора нужен собственный закрытый набор. Его главное преимущество: ни одна лаборатория не видела этих задач.
| Шаг | Что делать | Как именно | Результат |
|---|---|---|---|
| ① Собрать примеры | Взять задачи из реальной работы | Используйте реальные обращения в поддержку, ошибки из рабочих логов и диалоги с жалобами пользователей. Разделите их по типам задач и начните с 20–50 примеров на каждый тип | Исходный набор задач с метками |
| ② Определить критерии приёмки | Заранее решить, какой результат считать достаточно хорошим | По возможности используйте результаты, которые легко проверить: поля JSON, метки классификации или прохождение модульных тестов. Для открытых ответов составьте критерии оценки и проверяйте вручную фиксированную долю ответов | Скрипт и критерии оценки |
| ③ Протестировать несколько моделей | Сравнить модели в одинаковых условиях | Используйте один и тот же промпт, одинаковые параметры и одного оценщика или единые правила оценки. Записывайте баллы, задержку и расход токенов | Таблица сравнения |
| ④ Регулярно обновлять набор | Не дать набору превратиться в очередной тренировочный тест | Каждый месяц добавляйте новые примеры ошибок и убирайте задачи, на которых все модели набирают максимум баллов. Часть данных оставьте в отложенной выборке, не используемой для настройки параметров | Набор задач с версионированием |
Как отбирать примеры для внутреннего тестового набора и задавать критерии приемки
При отборе примеров неудачные случаи ценнее успешных. Лучше всего различия между моделями видны на диалогах, где пользователь повторно задавал вопрос, оператору пришлось вмешаться или ответ получил плохую оценку. Критерии приемки нужно записать до запуска моделей, иначе появится соблазн подогнать их под полученные результаты.
Определение «достаточно хорошо» должно выражаться в конкретных показателях. Например: «точность извлечения полей достигает заданного порога» или «выборочная проверка ответов поддержки не выявляет фактических ошибок». Долю ответов для ручной проверки выбирайте с учетом рисков: для задач с высоким риском проверяйте больше, для остальных преимущественно используйте автоматическую оценку.
Как контролировать условия при сравнении моделей
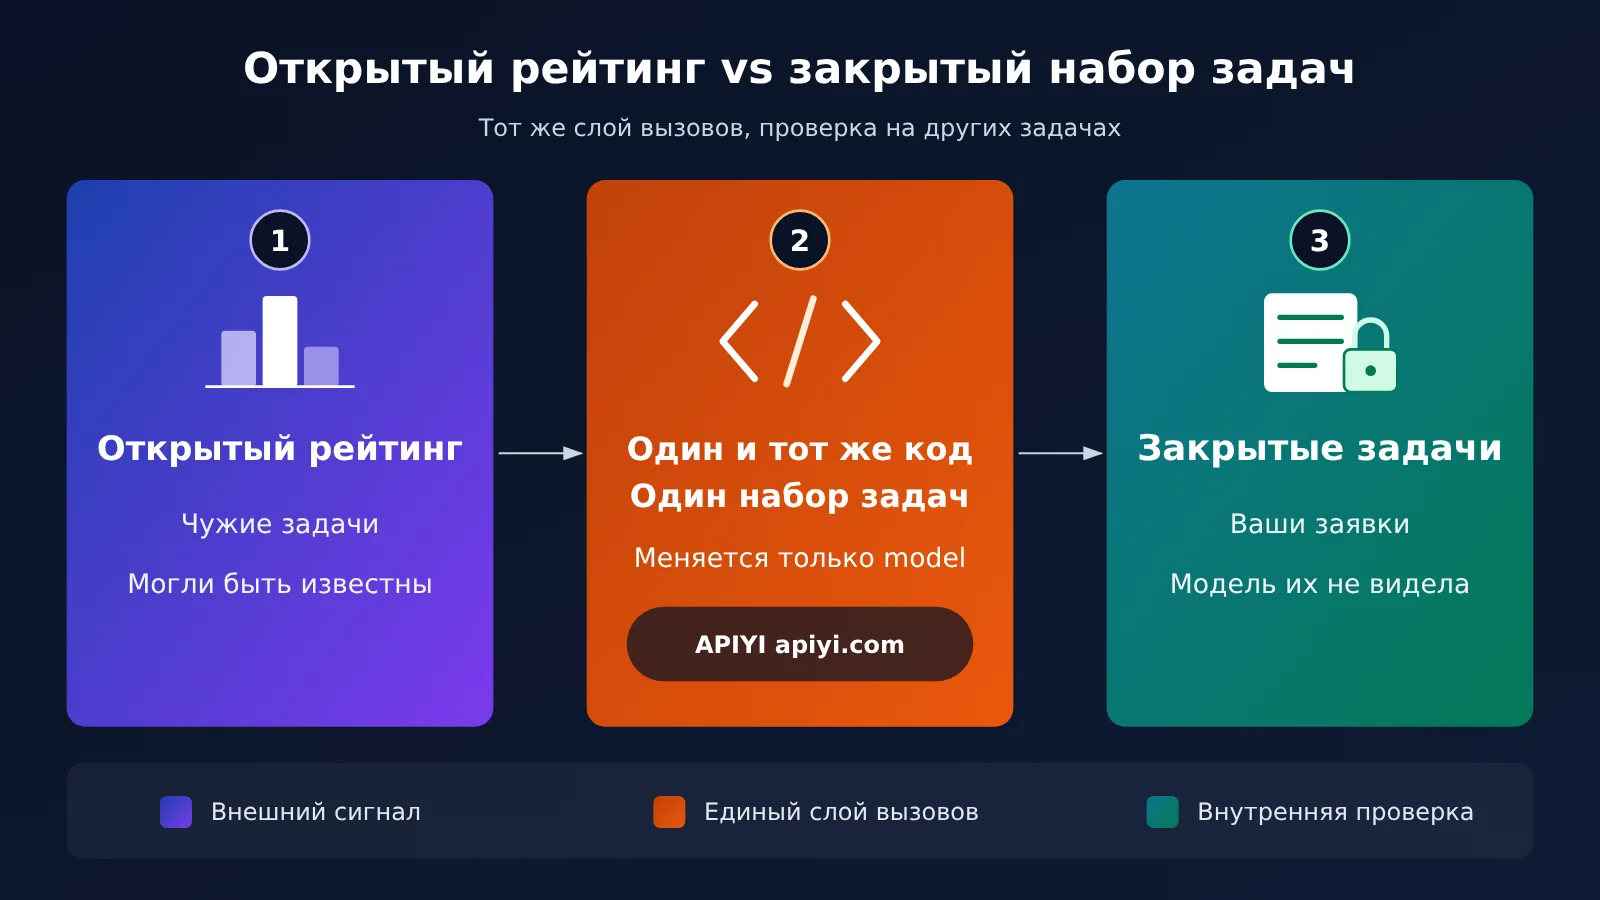
Самая частая проблема при сравнении моделей — разные условия тестирования: для модели A используют тщательно настроенный промпт, а для модели B — стандартный. Правильнее запускать один и тот же код на одном и том же наборе тестовых примеров, меняя только название модели.
Если модели-кандидаты от разных поставщиков, поддерживать несколько SDK неудобно. APIYI совместим с форматом OpenAI: один токен позволяет вызывать модели разных поставщиков, а для переключения достаточно изменить параметр model. Это удобно для запуска одного тестового набора через общий скрипт оценки. Настройка выглядит так:
- Официальный Python SDK от OpenAI: при инициализации клиента задайте
base_urlкакhttps://api.apiyi.com/v1, а вapi_keyукажите токен платформы - Переключение моделей в цикле оценки: меняйте только поле
model, сверяя названия моделей со списком на APIYI apiyi.com - Фиксация параметров сэмплирования: для всех моделей задайте
temperature=0и одинаковое значениеmax_tokens, чтобы уменьшить влияние случайности - Учет использования: считывайте поле
usageиз ответа и суммируйте расход токенов каждой модели на тестовом наборе
🚀 Быстрый старт: сначала выберите 3–4 модели из верхней части рейтингов, которые прошли все 5 проверок выше. Последовательно вызовите их через APIYI apiyi.com с одним токеном — и уже за один день получите первую версию сравнения на 50 реальных обращениях.
Не подгоняйте модель под собственный набор тестов
Вы тоже можете заняться benchmaxing на своём наборе задач. Если снова и снова менять промпт, пока модель не получит высший балл на всех 50 заданиях, это по сути ничем не отличается от подгонки под рейтинги со стороны производителей. Чтобы этого избежать:
- Выделите отложенную выборку: зарезервируйте около трети задач, при настройке используйте только выборку для разработки, а окончательное решение принимайте по результатам на отложенной выборке
- Зафиксируйте промпты: начав официальное сравнение, закрепите версии промптов. После любого изменения заново протестируйте все модели
- Обновляйте задачи: при каждом обновлении набора добавляйте недавние случаи неудач, чтобы тесты отражали изменения в рабочих задачах
Когда не стоит полагаться только на баллы в рейтинге
Даже если баллам в рейтинге можно полностью доверять, они могут не отражать то, что важно именно вам. В следующих случаях рейтинг годится разве что для общего представления:
| Сценарий | Почему рейтинг этого не охватывает | Как дополнить оценку |
|---|---|---|
| Редкие узкоспециализированные задачи | Отраслевая терминология, внутренние форматы и малораспространённые языки редко встречаются в общих бенчмарках | Составить собственный набор задач на основе реальных рабочих данных |
| Вызов инструментов и агенты | Одноходовые вопросы и ответы не показывают стабильность многошаговых вызовов и корректность формата параметров | Измерить долю успешно выполненных задач от начала до конца и частоту ошибок в формате вызовов функций |
| Стоимость и задержка | Рейтинги оценивают способности моделей, но не учитывают стоимость запроса и задержку до первого символа | При тестировании также записывать расход токенов и время ответа |
| Стабильность | Однократный запуск не отражает колебания результатов в реальной работе | Выполнить каждую задачу несколько раз и проверить согласованность результатов |
Практический принцип прост: когда модели достигают нужного уровня качества, сравнивайте их по соотношению цены и качества и по стабильности. Модели с первого и третьего места в рейтинге могут одинаково хорошо справляться с вашими задачами. Тогда зачастую лучше выбрать ту, у которой меньше задержка и проще контролировать расходы. Подключив модели через единый интерфейс APIYI apiyi.com, можно сравнить качество, время ответа и расход токенов в одной таблице.
Часто задаваемые вопросы FAQ
Q1: Означает ли benchmaxing, что модель жульничает?
Не обязательно. Задания могли случайно попасть в обучающие данные при сборе материалов из интернета. А команда, оптимизирующая модель под определённые типы задач, может искренне считать, что улучшает её способность рассуждать. Поэтому стоит смотреть на то, сохраняется ли результат при смене заданий, и не делать выводов о мотивах команды.
Q2: Когда результатам в рейтингах всё ещё можно доверять?
Баллы остаются полезным ориентиром, если задания закрыты или появились после даты окончания сбора обучающих данных, тест проводит независимая третья сторона, выводы нескольких рейтингов совпадают, а результаты удалось воспроизвести. Показатель, объединяющий разные типы тестов, сложнее искусственно завысить, чем результат отдельного бенчмарка.
Q3: Сколько заданий нужно как минимум для собственного закрытого теста?
Единого стандарта нет. На практике можно начать с 20–50 реальных примеров для каждого типа задач — этого достаточно, чтобы заметить существенную разницу. Если разница неочевидна, увеличьте число заданий и оставьте часть примеров для отдельной проверки.
Q4: Как сравнить модели разных разработчиков с помощью одного кода?
Проще всего использовать интерфейс, совместимый с OpenAI API. Получите токен через APIYI apiyi.com, укажите адрес платформы в `base_url` и меняйте в цикле только параметр `model`. Так можно сравнить модели на одном наборе заданий. Доступные модели указаны в списке на платформе.
Q5: Grok 5 набрала почти максимальный балл в Humanity’s Last Exam?
На дату публикации этой статьи это публичный прогноз Маска, а не результат тестирования. Если в будущем модель действительно наберёт такой балл, его всё равно стоит проверить по чек-листу из пяти пунктов. Особенно важно посмотреть, как модель справляется с новыми закрытыми заданиями на тот же навык, а затем проверить её на собственных задачах через APIYI apiyi.com, чтобы понять, подходит ли она для вашего бизнеса.
Benchmaxing и оценка на собственных задачах: главное
- Определение: benchmaxing — это оптимизация под известные тестовые задания, из-за которой результаты в рейтинге оказываются выше реальных возможностей модели
- Причины: задания попадают в обучающие данные, модели дообучают под конкретные типы вопросов, а открытые тесты подолгу остаются в доступе. Для всего этого не нужен злой умысел
- Главный сигнал: снижение результата на новых заданиях, проверяющих тот же навык, — самое явное предупреждение
- 5 проверок: кто проводил тест, были ли задания опубликованы, совпадают ли результаты в разных рейтингах, падает ли результат на новых заданиях, удалось ли третьим сторонам воспроизвести результаты
- 4 шага к собственному набору задач: отобрать примеры, определить критерии приёмки, протестировать несколько моделей и регулярно обновлять набор. Чтобы не переобучиться на собственных задачах, нужно сохранить отложенную выборку
- Единый интерфейс: с совместимым с OpenAI интерфейсом APIYI apiyi.com для переключения модели достаточно изменить параметр
model
Итог: рейтинг — отправная точка для изучения, а не окончательный вывод
Уже сегодня можно сделать три вещи. Во-первых, проверить результаты интересующих моделей в рейтингах по каждому из пяти пунктов, указав тип фактов и дату ссылки на источник. Во-вторых, выбрать из логов за последний месяц 50 случаев, в которых модель не справилась, и записать критерии приёмки до запуска тестов. В-третьих, протестировать 3–4 модели-кандидата с одним и тем же кодом и параметрами, записав результаты, задержку и расход токенов.
Для сравнения нескольких моделей используйте один токен через APIYI apiyi.com, а затем обновляйте набор задач раз в месяц. Выбирать модель стоит по результатам на собственных задачах, а не по чужим тестам.
📚 Источники
- MindStudio: What Is Benchmaxing? Why AI Labs Are Hiding Test Questions (2026-11-01)
- Ссылка:
mindstudio.ai/blog/ai-benchmark-maxing-private-tests -
Описание: определение и причины бенчмакинга, тенденция к использованию закрытых тестовых вопросов, а также единственный источник приведённых в статье данных о Gemini и Grok.
-
Официальный сайт Artificial Analysis: независимые оценки моделей и сводные индексы
- Ссылка:
artificialanalysis.ai - Описание: сроки и масштабы перехода к закрытым тестовым вопросам уточняйте в официальных материалах.
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу сайта APIYI apiyi.com. Дополнительные материалы по подключению доступны в центре документации docs.apiyi.com.