Примечание автора: разберём GPT-6.2 Astra и Claude Fable 5.2 на трёх уровнях — сторонний сводный рейтинг, официально заявленные результаты по отдельным задачам и официальный прайс-лист. Объясним разницу в стоимости чтения кэша и то, какую модель сейчас можно вызвать в APIYI.
2026-11-17 OpenAI выпустила GPT-6.2 Astra и GPT-6.2 Sol. Примерно за неделю до этого, 2026-11-09, в документации Anthropic появилась Claude Fable 5.2. У обеих флагманских моделей заявленная цена за 1 млн токенов на входе при коротком контексте и на выходе одинаковая — 8 и 40 долларов США, так что обсуждение выбора закономерно свелось к GPT-6.2 Astra против Claude Fable 5.2.
Проблема в том, что два типа рейтингов указывают в разные стороны. В сводном индексе сторонней Artificial Analysis выше балл у Fable 5.2. В нескольких специализированных задачах, которые OpenAI приводит в своём анонсе, лидирует Astra, и официально указанная стоимость одной задачи у неё ниже. Если смешать оба набора цифр, получится вывод «кто сильнее», но данные ни одной из сторон его не выдерживают.
Это не статья с объявлением победителя. Здесь цифры разделены на три уровня: сторонний сводный рейтинг, официальные результаты по отдельным задачам и официальный прайс-лист. Каждый уровень рассматриваем отдельно, а в конце объясняем, какую модель сейчас можно вызвать в APIYI.
Главное: после прочтения вы сможете выбрать рейтинг под конкретную задачу, которая вас интересует, увидеть разницу в цене чтения кэша и понять текущий статус подключения обеих моделей.
GPT-6.2 Astra и Claude Fable 5.2: главное — не смешивать три уровня цифр
Когда сравниваешь GPT-6.2 Astra и Claude Fable 5.2, проще всего ошибиться в одном: взять цифры из разных источников и сделать из них один вывод. В таблице ниже сразу разделены три слоя информации — откуда они берутся и что показывают.
| Уровень цифр | Природа источника | Что показывает этот уровень | На что обратить внимание |
|---|---|---|---|
| Сводный рейтинг | Сторонний Artificial Analysis, Intelligence Index v5.0.1 | У Fable 5.2 — 65, у Astra (Max) — 62 | Обязательно указывать уровень рассуждений: на разных уровнях баллы сильно различаются |
| Отдельные задачи | Официальные данные из публикации OpenAI; AA-3D — официально пересказанная сторонняя слепая оценка | На Agents’ Last Exam, Harvey LAB-AA и AA-3D лидирует Astra | В рейтинге ALE у Fable не учитываются девять задач с резервными моделями |
| Цены | Официальные страницы моделей и документация обеих компаний | Вход и выход стоят одинаково, чтение из кэша у Fable дешевле | Срок хранения кэш-записи разный, правила для длинного контекста тоже разные |
Почему GPT-6.2 Astra и Claude Fable 5.2 «каждый в чём-то впереди»
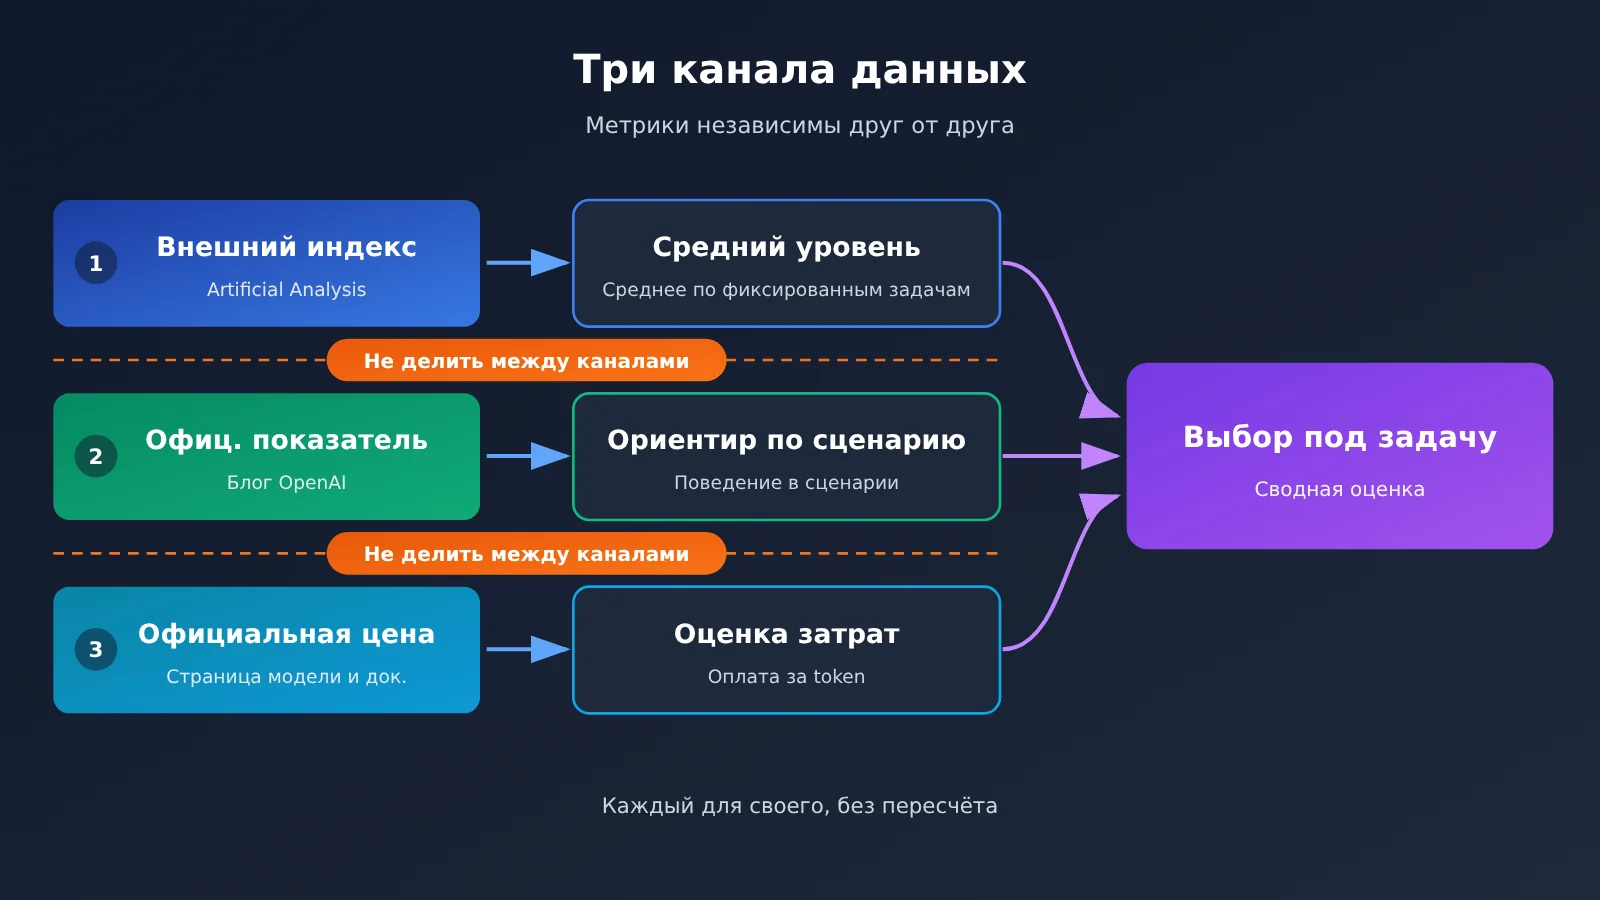
Сводный индекс оценивает средний результат на фиксированном наборе задач, а веса задаёт третья сторона. Публикация OpenAI, наоборот, выхватывает конкретные сценарии — длительные профессиональные рабочие процессы, юриспруденцию, 3D-генерацию — и настройки тестов определяет сама компания. Эти два подхода изначально отвечают на разные вопросы: первый — про средний уровень, второй — про результат в конкретном рабочем процессе. Если выводы расходятся, это вовсе не значит, что у кого-то неверные данные.
С затратами та же история. «Стоимость одной задачи» от Artificial Analysis — это расход на прогон задач из его сводного индекса. А «стоимость ALE примерно 5% от Fable», о которой говорит OpenAI, — это другой набор задач и другая методика подсчёта. Эти два числа нельзя делить друг на друга и нельзя пересчитывать одно в другое.
Ключевые отличия GPT-6.2 Astra от Claude Fable 5.2: сводный рейтинг третьей стороны
Artificial Analysis 17 ноября 2026 года опубликовала статью и обновила страницы моделей. Все приведённые ниже баллы — это Intelligence Index v5.0.1, результат независимой оценки третьей стороны, а не цифры, которые заявляют сами вендоры.
| Модель | Уровень рассуждений | Intelligence Index v5.0.1 | Стоимость одной задачи по сводному индексу (со страницы модели) |
|---|---|---|---|
| Claude Fable 5.2 | Высший уровень рассуждений | 65 (первое место в рейтинге) | 26.54 доллара США |
| GPT-6.2 Astra | Max / Xhigh | 62 | 4.00 доллара США (Max) |
| GPT-6.2 Astra | High / Medium / Low | 60 / 57 / 46 | — |
| GPT-6.2 Sol | Max | 57 | 1.01 доллара США (Max) |
| Gemini 4 Carbon | Высший уровень | 60 | — |
| Claude Opus 5.5 | Высший уровень | 59 | — |
В этом рейтинге третьей стороны сводный балл Fable 5.2 на 3 балла выше, чем у Astra на максимальном уровне. Astra на 5 баллов превосходит предыдущее поколение GPT-6 Astra и обходит высшие уровни Gemini 4 Carbon и Claude Opus 5.5. Отдельно стоит учесть: когда Astra опускается на уровень Low, у неё остаётся всего 46 баллов. Если в вашем продукте вы снижаете интенсивность рассуждений ради экономии, рассчитывать на эффект в 62 балла уже нельзя.
В статье Artificial Analysis есть ещё несколько детализированных результатов — это тоже данные третьей стороны. В исследовательском превью AA-Robotics v0.1 Astra получает 79, а Fable 5.2 — 75. В научных задачах Astra лидирует в Terminal-Bench-Science 0.1, а на сложном подмножестве CritPt v2 уступает только Fable 5.2. В Coding Agent Index (Codex harness, max) Astra идёт наравне с GPT-6 Astra. По уровню галлюцинаций в AA-Omniscience (Max) у Astra 59%.
Ключевые различия GPT-6.2 Astra и Claude Fable 5.2: отдельные показатели по официальным данным
Все цифры ниже взяты из анонса OpenAI и страницы модели — это официально заявленные результаты. Для задач, где в анонсе нет абсолютного балла, в статье указана только относительная разница.
| Отдельная задача | Официально заявленный результат | Официальная оценка стоимости | На какие сноски смотреть |
|---|---|---|---|
| Agents’ Last Exam (длительные профессиональные рабочие процессы) | Astra на 5,5 балла выше Fable 5.2 | Стоимость — около 5% от стоимости Fable | В рейтинге результат Fable 5.2 не включает девять задач, где использовалась резервная модель |
| Harvey LAB-AA v1.1 (юридические задачи) | Доля успешных прохождений у Astra более чем вдвое выше, чем у Fable 5.2 | Стоимость — примерно в шесть раз ниже | В анонсе не указана абсолютная доля прохождения; конфигурация «Astra for Law» для юристов имеет более высокие показатели |
| AA-3D (Elo по слепой экспертной оценке) | Astra — 1318, Fable 5.2 — 1271, Sol — 1259 | Не указана | Слепая оценка третьей стороны, но приведена в пересказе официального анонса |
| Terminal-Bench-Science 0.1 | Astra на 9 процентных пунктов выше GPT-6 Astra | Стоимость — менее трети от предыдущего поколения | У Fable две цифры из разных тестов, см. ниже |
Сноску к Agents’ Last Exam стоит разобрать отдельно. OpenAI указывает: результат Fable 5.2 в рейтинге не включает девять задач, где использовалась резервная модель. Когда читаете про «на 5,5 балла выше», стоит понимать, что наборы задач у сторон совпадают не полностью.
В Terminal-Bench-Science 0.1 у Fable 5.2 есть две цифры из разных источников. Одна — от Artificial Analysis, с использованием mini-swe-agent. Другая — 74,6%, заявленные Anthropic; тестирование проходило в Claude Code с уровнем рассуждений Max. Это не результаты одного и того же теста: их нельзя подменять друг другом и напрямую сравнивать с Astra.
Значения 1318 и 1271 в AA-3D сами по себе — это Elo из независимой слепой экспертной оценки, но в статье они приводятся в пересказе анонса OpenAI. При цитировании лучше писать «независимая слепая оценка в пересказе официального источника»: не стоит выдавать её за чисто официальные данные и не стоит представлять как самостоятельно проверенную автором статьи.
💡 Совет по выбору: отдельный рейтинг по одной задаче имеет смысл смотреть, только если тип задачи близок к вашему бизнесу. Fable 5.2 уже можно вызывать через APIYI apiyi.com — сначала прогоните её на своих реальных примерах, а потом оценивайте с учётом двух таблиц выше.
Сравнение прайс-листов GPT-6.2 Astra и Claude Fable 5.2: чтение кэша отличается
По официальным прайс-листам у обеих моделей стандартная цена на коротком контексте полностью совпадает и по входу, и по выходу — различия сосредоточены в статьях, связанных с кэшем, и в правилах для длинного контекста. Все цены в таблице указаны в долларах за 1 млн токенов.
| Статья | GPT-6.2 Astra (официально у OpenAI) | Claude Fable 5.2 (официально у Anthropic) | Доступность на платформе (сводная таблица APIYI, 2026-11-17 15:54 UTC+8) |
|---|---|---|---|
| Вход | 8 | 8 | Astra пока не добавлена; у Fable — 8 |
| Выход | 40 | 40 | Astra пока не добавлена; у Fable — 40 |
| Чтение кэша | 0.40 | 0.20 | Astra пока не добавлена; у Fable — 0.2 |
| Запись в кэш | 10 (хранение 30 минут), 20 (12 часов) | 10 (5 минут), 16 (1 час) | Смотрите список на платформе |
| Контекст / максимальный выход | 1,050,000 / 128,000 (максимальный вход 922,000) | 1M / 128K | — |
| Batch | 50% от стандартной цены | Вход и выход — со скидкой 50% | — |
Официальная цена GPT-6.2 Astra у OpenAI — 8 долларов за вход, 0.40 доллара за чтение кэша и 40 долларов за выход. Модель пока не добавлена на платформу — мы сделаем это в ближайшее время; актуальные модели и цены смотрите в списке моделей на платформе. Ни в сводной таблице моделей APIYI docs.apiyi.com/models.md, ни в публичном интерфейсе цен по состоянию на 2026-11-17 gpt-6.2-astra не находится. Не пытайтесь оценивать цену 6.2 по уже доступной gpt-6-astra (короткий контекст 10 / 50 / 1) — это две разные модели.
Разница в цене чтения кэша сильно сказывается на агентах и сценариях с длинными диалогами. При чтении 100 млн токенов кэша по прайс-листу Astra выходит 40 долларов, а Fable 5.2 — 20 долларов. Если у вас очень длинный системный промпт или вы снова и снова обращаетесь к одному и тому же набору документов, эта статья напрямую отразится в счёте. Запись в кэш вроде бы везде стоит 10 долларов, но Astra хранит его 30 минут, а Fable — 5 минут, поэтому доля попаданий зависит от интервалов между запросами: сравнивать только цену за единицу здесь нельзя.
Правила для длинного контекста тоже отличаются. На странице модели Astra указано: если вход одного запроса превышает 272K токенов, цена входа и кэша удваивается, выход становится в 1.5 раза дороже цены короткого контекста, и по этой цене считается весь запрос целиком. В выдержке из прайса Fable, на которую опирается эта статья, похожей ступенчатой тарификации нет — перед подключением сверьтесь с документацией Anthropic.
Режимы ускорения у сторон тоже разные. У Astra Fast стоит 2× от стандартной цены, Ultrafast до 2027-02-28 (по тихоокеанскому времени) — 3×, а с 2027-03-01 — 6×. У Fable Fast mode даёт максимум примерно 2.5× скорости по цене 16 долларов за вход и 80 долларов за выход.
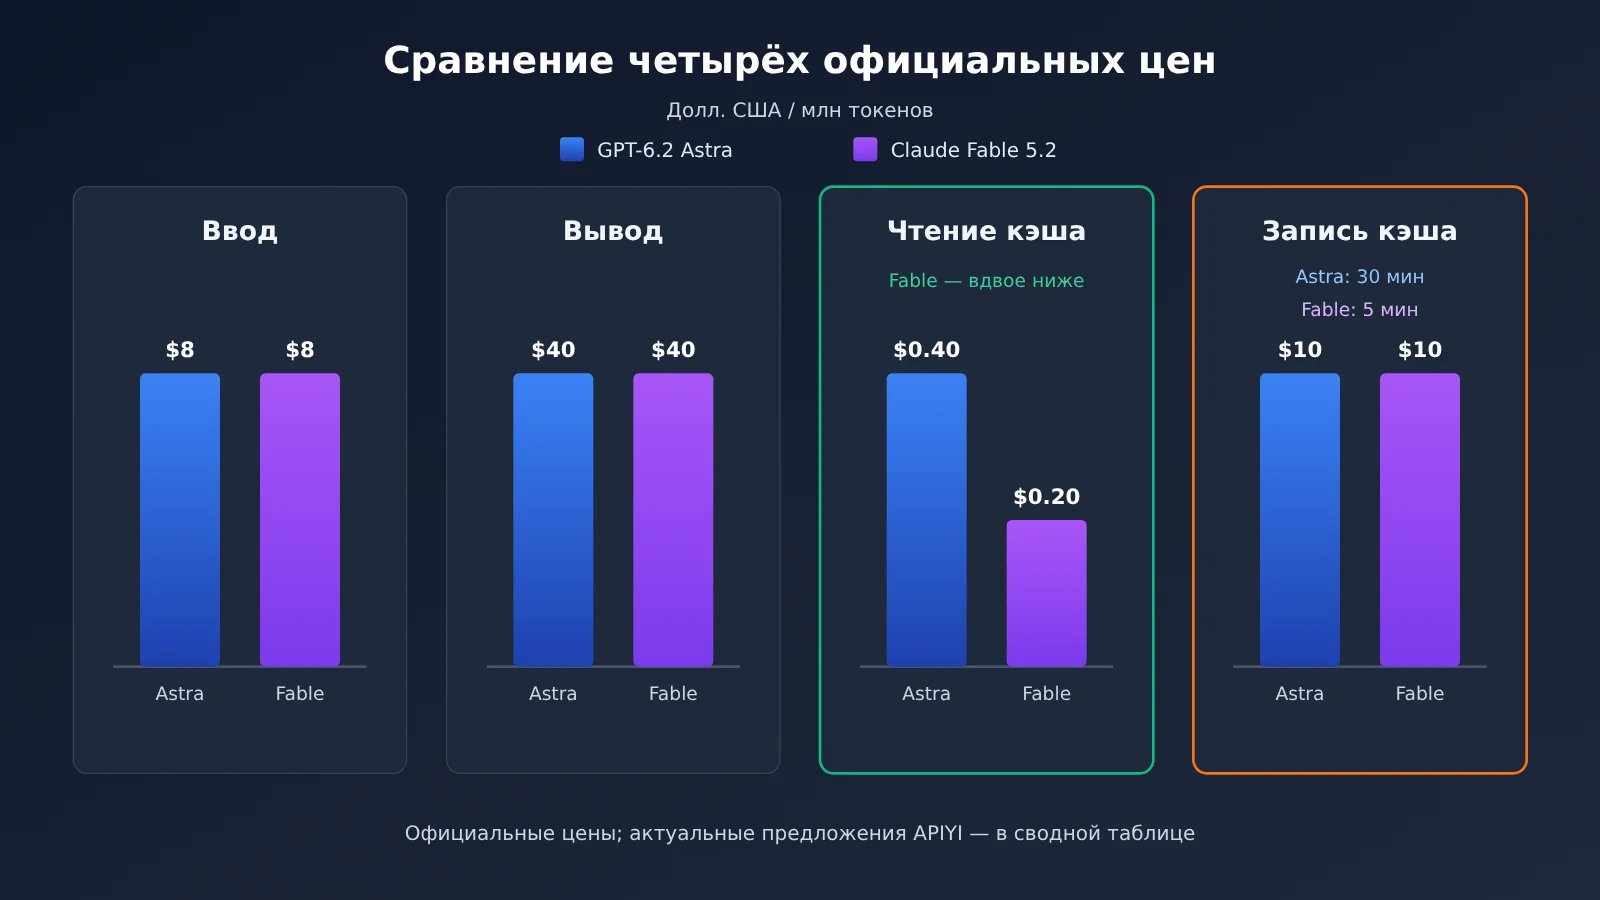
🎯 Пояснение к данным: на диаграмме выше показаны только официальные цены обеих компаний. Реально доступные на платформе модели и цены определяются списком моделей на APIYI apiyi.com — Astra 6.2 сейчас в этом списке отсутствует.
Рекомендации по сценариям для GPT-6.2 Astra и Claude Fable 5.2
Ниже мы идём от вопроса «что именно показывает этот рейтинг» к подходящим сценариям и не делаем выводов о том, кто в целом сильнее.
Сценарии, где в первую очередь стоит присмотреться к GPT-6.2 Astra
- Длинные профессиональные рабочие процессы: по официально заявленным результатам Agents’ Last Exam Astra впереди, но при этом нужно учитывать сноску о том, что у Fable не учитываются девять задач.
- Задачи с юридическими документами: официально заявленная доля прохождений Harvey LAB-AA v1.1 более чем вдвое выше, чем у Fable, — это направление стоит тестировать в первую очередь.
- Сравнительные оценки, связанные с 3D-генерацией: официально приведённые результаты слепого сравнения AA-3D — Elo 1318 против 1271.
- Чувствительность к стоимости одной задачи по комплексному индексу: на странице третьей стороны Astra (Max) стоит 4.00 доллара, но это относится только к набору задач комплексного индекса.
Сценарии, где в первую очередь стоит присмотреться к Claude Fable 5.2
- Универсальные приложения, где нужен запас по общим способностям: комплексный индекс третьей стороны у Fable 5.2 — 65, первое место в рейтинге.
- Приложения с большой долей чтения кэша: официальная цена чтения кэша — 0.20 доллара, вдвое ниже, чем у Astra.
- Нужно подключить прямо сейчас:
claude-fable-5-2иclaude-fable-5-2-thinkingуже есть в сводной таблице APIYI.
| На что смотреть | Какой уровень брать первым | Куда он указывает | Что ещё учесть |
|---|---|---|---|
| Средняя способность | Сводный рейтинг третьей стороны | У Fable 5.2 выше | Учитывайте режим рассуждения |
| Профессиональные процессы / юриспруденция | Отдельные показатели, заявленные официально | Astra впереди | Данные заявлены самой компанией — читайте сноски |
| Стоимость кэша в длинных диалогах | Официальная цена | У Fable чтение кэша дешевле | Сроки хранения при записи кэша различаются |
| Можно ли вызвать прямо сейчас | Сводная таблица APIYI | Доступна только Fable | Astra 6.2 ждёт публикации |
GPT-6.2 Astra и Claude Fable 5.2: быстрый старт, решение за три шага
Шаг 1. Сначала посмотрите на рейтинг именно по вашей задаче
Сначала определите, к какому типу задач относится ваш бизнес. Если это универсальный помощник или смешанные задачи, смотрите на сводный индекс Artificial Analysis и запишите, какой уровень reasoning собираетесь использовать. Если речь о долгосрочных агентных задачах, юридике или 3D, смотрите на отдельный рейтинг, который OpenAI публикует по этой задаче, и внимательно читайте сноски. Не складывайте разрыв в сводном рейтинге и разрыв в отдельном рейтинге в некий «общий балл».
Шаг 2. Затем посмотрите на чтение из кэша
Оцените, какую долю запроса составляет повторяющийся префикс — например, системный промпт, фрагменты базы знаний или история многоходового диалога. Чем выше доля чтения из кэша, тем заметнее разница между 0.20 и 0.40. Если один входной запрос часто превышает 272K, дополнительно учитывайте правило Astra о наценке на весь запрос.
Шаг 3. Теперь посмотрите, что сейчас доступно в APIYI
В текущей сводной таблице APIYI доступна Fable 5.2 с ID модели claude-fable-5-2. Если нужна версия с явным режимом thinking, используйте claude-fable-5-2-thinking. Цены: вход — 8, выход — 40, чтение из кэша — 0.2. Эндпоинт поддерживает chat и messages. Страница с описанием этой модели сейчас возвращает 404, поэтому цену смотрите в сводной таблице.
При подключении через OpenAI-совместимый интерфейс установите в SDK base_url в значение https://api.apiyi.com/v1, в model укажите claude-fable-5-2; остальные параметры — как при обычном вызове Chat Completions. Важно учесть: у Fable 5.2 режим thinking включён всегда, отключить его нельзя, а effort по умолчанию — high. Если позже перейдёте на Astra, API Astra не принимает значение none для reasoning effort.
🚀 Быстрый старт: рекомендую сначала использовать бесплатные тестовые кредиты на APIYI (apiyi.com) и проверить
claude-fable-5-2на своих примерах — зафиксируйте качество вывода и попадания в кэш. Когдаgpt-6.2-astraстанет доступна, прогоните тот же набор примеров ещё раз: так сравнение получится честнее.
Часто задаваемые вопросы (FAQ)
В1: Что такое GPT-6.2 Astra и Claude Fable 5.2?
GPT-6.2 Astra — флагманская модель OpenAI, выпущенная 2026-11-17, ID модели — `gpt-6.2-astra`. Вместе с ней вышла более дешёвая GPT-6.2 Sol. Claude Fable 5.2 — модель Anthropic, документация опубликована 2026-11-09. Обе поддерживают контекстное окно около 1M и максимальный вывод 128K.
В2: Так кто всё-таки сильнее — GPT-6.2 Astra или Claude Fable 5.2?
По имеющимся данным однозначного ответа нет. В стороннем сводном индексе Fable 5.2 с 65 баллами опережает Astra (Max) с 62 баллами. В официально заявленных ALE, Harvey и официально пересказанном слепом тесте AA-3D впереди Astra. Смотреть стоит на тот слой данных, который соответствует вашему типу задач.
В3: Можно ли сопоставить «стоимость 5%» из ALE с ценой одной задачи у Artificial Analysis?
Нет. «Около 5%» — это самоотчёт OpenAI по Agents’ Last Exam. А 4.00 доллара и 26.54 доллара — стоимость задач из того набора, на котором Artificial Analysis прогоняет сводный индекс. И задачи, и методика подсчёта там разные: их нельзя ни делить друг на друга, ни использовать для взаимной проверки.
В4: Данные по GPT-6.2 Sol — сторонние?
Нет. Sol — собственная модель OpenAI, и все цифры о ней в анонсе относятся к официальным самоотчётам. Artificial Analysis отдельно тестировала Sol: в режиме Max — 57 баллов, и вот это уже сторонние данные. Официальные цены Sol: вход 2, чтение из кэша 0.10, выход 10. Пока модель не размещена на платформе; мы добавим её как можно скорее. Актуальные модели и цены — в списке моделей платформы.
В5: Как сейчас вызвать Claude Fable 5.2 через API?
Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ, в OpenAI-совместимом SDK укажите base URL `https://api.apiyi.com/v1` и модель `claude-fable-5-2`. Если используете нативный протокол Anthropic, можно обращаться к эндпоинту messages.
В6: Какие известные ограничения есть у GPT-6.2 Astra?
В официальном описании Astra достигает «серьёзного» уровня кибербезопасности по Preparedness Framework, поэтому защита строже и часть легитимных запросов на исследование уязвимостей будет отклонена. В оценках выравнивания она в двух тестах чаще пропускает мешающие проблемы — например, отсутствующий файл или недоступный поисковый инструмент. Сторонний показатель галлюцинаций AA-Omniscience (Max) — 59%. Кроме того, модель не поддерживает аудио- и видео-ввод, а также Realtime и дообучение.
В7: Изменятся ли цены после декабря?
В справочных материалах этой статьи ни для одной из двух моделей изменение цен в декабре не объявлено. Изменится множитель Ultrafast у Astra: с 2027-03-01 он вырастет с 3x до 6x. Фактическое выставление счетов на платформе — по списку моделей на APIYI apiyi.com.
GPT-6.2 Astra и Claude Fable 5.2: главное
- В сводном рейтинге ориентируйтесь на третьи стороны: в AA Intelligence Index v5.0.1 у Fable 5.2 — 65 баллов, у Astra (Max) — 62.
- В отдельных тестах — на данные самих разработчиков: Astra лидирует в ALE, Harvey и в AA-3D в пересказе вендора, но сноски читать обязательно.
- Две системы цен нельзя просто делить друг на друга: ~5% в ALE и стоимость одной задачи в AA — это разные задачи и разные методики подсчёта.
- Вход и выход стоят одинаково: у обеих моделей с коротким контекстом тариф 8 / 40 долларов, чтение из кэша — 0,40 и 0,20 соответственно.
- У Astra длинный контекст идёт по ступеням: если один входной запрос превышает 272K, вся задача тарифицируется по более высокой ставке.
- Статус подключения разный: Fable 5.2 уже есть в сводной таблице на APIYI apiyi.com, Astra 6.2 пока ждёт публикации.
Итог
Сравнивая GPT-6.2 Astra и Claude Fable 5.2, главное — не смешивать источники цифр:
- Сводные рейтинги третьих сторон: у Fable 5.2 результат выше; при цитировании обязательно указывайте уровень рассуждений.
- Официальные данные по отдельным задачам: Astra лидирует в нескольких специализированных задачах, а официально заявленная стоимость одной задачи у неё ниже — но это данные самой компании.
- Официальный прайс-лист: цены за ввод и вывод одинаковые; чтение из кэша у Fable вдвое дешевле, а правила для длинного контекста тоже различаются.
Ни одна из этих двух моделей не выигрывает по всем параметрам. Надёжнее всего сначала определить свой тип задач, затем проверить стоимость кэша и в конце прогнать тесты на реальных примерах. Сейчас Fable 5.2 уже можно вызывать через APIYI (apiyi.com); после выхода Astra 6.2 в каталоге её можно будет дополнительно проверить на том же наборе примеров. Мы добавим эту модель как можно скорее.
📚 Справочные материалы
-
Публикация OpenAI: описание выпуска GPT-6.2 Astra и Sol и официальные самостоятельно заявленные результаты оценки
- Ссылка:
openai.com/index/introducing-gpt-6-2-astra-sol - Пояснение: данные по отдельным задачам ALE, Harvey, AA-3D и источники в сносках
- Ссылка:
-
Страница модели OpenAI: спецификации и цены GPT-6.2 Astra
- Ссылка:
platform.openai.com/docs/models/gpt-6.2-astra - Пояснение: цена записи в кэш и правила тарификации для 272K — ориентируйтесь на эту страницу
- Ссылка:
-
Статья Artificial Analysis: независимая оценка GPT-6.2 Astra и Sol
- Ссылка:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Пояснение: оценки Intelligence Index v5.0.1 по уровням рассуждений
- Ссылка:
-
Страница модели Artificial Analysis: Claude Fable 5.2
- Ссылка:
artificialanalysis.ai/models/claude-fable-5-2 - Пояснение: сводная оценка и стоимость одной задачи по агрегированному индексу
- Ссылка:
-
Документация Anthropic: обзор Claude Fable 5.2
- Ссылка:
platform.claude.com/docs/en/models/fable-5-2/overview - Пояснение: прайс-лист, чтение и запись кэша, настройки effort и параметров thinking
- Ссылка:
Автор: техническая команда APIYI
По техническим вопросам: обращайтесь к нам через главную страницу официального сайта APIYI; актуальные модели и цены смотрите в списке моделей на платформе.