Примечание автора: сравнение Qwen4-Max и Kimi K3.1 Pro по пяти параметрам: открытость весов, терминальные задачи, выполнение длинных задач, визуальный и видео-контент и стоимость за миллион токенов. А также объяснение, почему официальные результаты Terminal-Bench у двух компаний не совпадают.
Сначала вывод: если вам нужны веса для дообучения, квантования или приватного развёртывания — выбирайте Kimi K3.1 Pro. Если вам нужен хостинговый API, при этом важны визуальные задачи, видео и выполнение длинных задач, а стоимость за миллион токенов хочется свести к минимуму — выбирайте Qwen4-Max. Если ваша основная нагрузка — это командный агент в терминале, у Kimi K3.1 Pro сейчас явное преимущество.
Это не компромиссный разбор в духе «у каждого свои сильные стороны». Все цифры ниже указаны с источником: данные Qwen — из официального блога Alibaba и официально опубликованных сопоставлений на одних и тех же изображениях, данные Kimi — из официальной документации Moonshot, сторонние данные — из публичного снимка таблицы arena (2026-11-14). Почему у двух компаний не совпадает один и тот же бенчмарк из их собственных отчётов — разберём отдельно.
Главная ценность: дочитав статью, вы получите чёткую границу для выбора модели и поймёте, как перевести два преимущества — «дешевле» и «можно получить веса» — на свои конкретные задачи.
Ключевые различия Qwen4-Max и Kimi K3.1 Pro
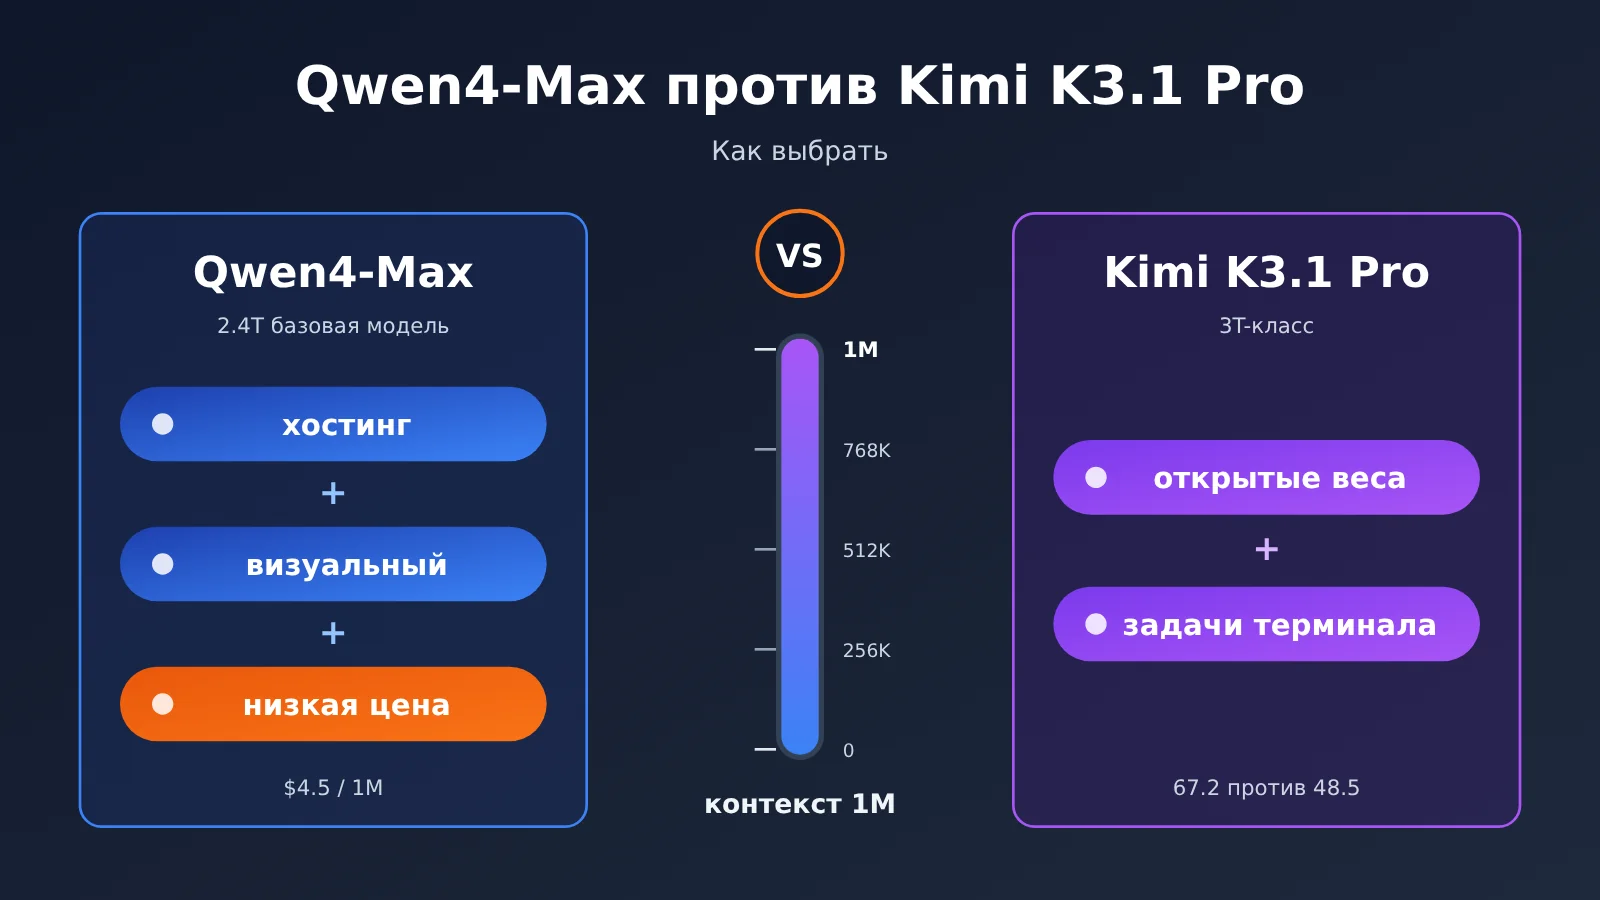
Обе модели — китайские флагманы второй половины 2026 года, контекст у обеих порядка 1M, по бумажным параметрам они близки, но позиционирование у них сильно разное. Qwen4-Max использует 2.4T-й backbone, 71B активных параметров и 328B N-gram Embedding, нативно поддерживает работу с изображениями, максимальный вывод — 393K, максимальная цепочка рассуждений — 262K, а reasoning_effort по умолчанию — high. Kimi K3.1 Pro — первая модель серии K3.1, относится к классу 3T; официально её называют самой сильной открытой моделью класса 3T с открытыми весами, контекст — 1,048,576 токенов.
| Критерий сравнения | Qwen4-Max | Kimi K3.1 Pro | Перевес |
|---|---|---|---|
| Масштаб | 2.4T backbone / 71B активных + 328B N-gram Embedding | Класс 3T | — |
| Веса | В открытых материалах упоминается только хостинговый API QwenCloud | Открытые веса | Kimi |
| Контекст | 1M, максимальный вывод 393K | 1,048,576 токенов | Паритет |
| Терминальные задачи (та же диаграмма Alibaba) | 48.5 | 67.2 | Kimi |
| Длительные задачи и отраслевые внедрения | Лидирует по ряду показателей | Чуть выше в AutomationBench | Qwen4 |
| Зрение и видео | Нативное зрение, лидирует по метрикам графиков и видео | Отстаёт по метрикам | Qwen4 |
| Цена за 1M выходных токенов | $4.5 | $10 | Qwen4 |
Если коротко: сильная сторона Kimi — «можно дообучать» и «тянет терминальные сценарии», а Qwen4 — «широкий охват внедрений» и «дешевле». Ниже разберём это по пяти измерениям.
Можно ли менять веса у Kimi K3.1 Pro и Qwen4-Max
Это самая жёсткая граница между ними. Kimi K3.1 Pro — модель с открытыми весами: команда может развернуть её на своём кластере, дообучить под конкретную предметную область, сжать квантованием, дистиллировать или запустить офлайн в среде с жёсткими требованиями по комплаенсу. Для команд, которым нужно «менять саму модель», альтернативы здесь нет — никакие высокие результаты бенчмарков этого не заменят.
В открытых материалах по Qwen4-Max пока упоминается только предоставление через QwenCloud в виде управляемого API, про открытые веса там ничего не сказано. Плюс управляемого варианта — не нужно думать о видеокартах, фреймворке инференса и масштабировании; минус — адаптировать бизнес можно только через промпты, контекст и вызов инструментов. Стоит отметить: открытые веса сами по себе не означают автоматически большей безопасности — она всё равно зависит от того, как вы разворачиваете модель, как настроен доступ и как ведётся аудит.
Как это прикинуть: если вы просто «вызываете модель», ценность открытых весов для вас примерно равна нулю; если же вам явно нужно дообучение или приватное развёртывание, Kimi — единственный вариант в этом сравнении, а остальные критерии нужны лишь для оценки того, «достаточно ли» её.
Qwen4-Max против Kimi K3.1 Pro: кто сильнее в терминальных задачах
Терминальные задачи — это когда модель в командной строке читает и записывает файлы, выполняет команды и итеративно исправляет ошибки по сообщениям об ошибках. Для агента-кодера это самый близкий к реальной работе сценарий. И здесь Kimi K3.1 Pro заметно сильнее: в сравнении на одном графике, которое приводит сама Alibaba, Qwen4-Max набирает в Terminal-Bench 4.0 48,5 балла, а Kimi K3.1 — 67,2. Разрыв 18,7 балла — самый большой отрыв Qwen4 на всём графике.
Почему данные двух источников по Terminal-Bench расходятся
Есть деталь, которую легко упустить: один и тот же Kimi K3.1 Pro в официальных материалах двух компаний имеет разные оценки Terminal-Bench 4.0.
| Источник | Kimi K3.1 Pro | Другие для сравнения |
|---|---|---|
| Официальная документация Moonshot | 65,7% | Claude Opus 5.5 — 66,4%, GPT-6 Astra — 58,2% |
| Сравнение на одном графике от Alibaba | 67,2 | Qwen4-Max — 48,5 |
У Kimi у себя написано 65,7%, а на графике Alibaba у Kimi стоит 67,2 — разница 1,5 балла. Она возникает из-за различий в harness оценки (агентный фреймворк, определения инструментов, политика тайм-аутов и повторов), настроек reasoning effort и версии набора задач. Это нельзя трактовать как подлог с чьей-либо стороны, и нельзя смешивать два числа в одно «Kimi в терминальных задачах» и потом на него ссылаться. Точно так же Claude Opus 5.5 в документации Moonshot — 66,4%, а в измерительной рамке Alibaba он даст другое число; склейка рейтингов из разных документов не работает.
Правильный способ чтения: сравнивать относительные позиции только в пределах одного графика и одного harness. По методике Moonshot Kimi чуть ниже Opus 5.5 и заметно выше GPT-6 Astra; по методике Alibaba Kimi сильно опережает Qwen4-Max. Оба вывода верны, и направление у них совпадает — терминальные способности Kimi K3.1 Pro относятся к верхнему эшелону.
🎯 Технический совет: базовые оценки колеблются в зависимости от harness и effort, поэтому надёжнее всего прогнать обе модели в своём агентном фреймворке на реальных задачах. С помощью APIYI (apiyi.com) можно одним и тем же API-ключом вызывать
kimi-k3.1-proи другие модели, оставляя фреймворк неизменным и переключая только параметрmodel— только так сравнение будет осмысленным.
Ещё один связанный пункт — остальные показатели задач кодирования. На том же графике Alibaba в DeepSWE v1.1 оба практически равны (75,7 против 75,5), а в ProgramBench Qwen4-Max выше на 6,5 балла (31,5 против 25,0). В официальной документации Moonshot также указано Kimi Code Bench 3.0 Long-horizon 61,2% — заметный рост по сравнению с 55,95% у предыдущего поколения K3. Поэтому точная формулировка такая: Kimi силён в терминальном взаимодействии, а Qwen4 в части нетерминальных задач кодирования не уступает.
Qwen4-Max и Kimi K3.1 Pro: длинные задачи и отраслевые результаты
Если ваш агент отвечает за «полную сдачу работы» — подготовку отчётов, прохождение бизнес-процессов, решение задач в узких профессиональных областях — Qwen4-Max в сравнении на одном и том же наборе задач от Alibaba выступает лучше. В таблице ниже — выдержка из официально опубликованных Qwen сопоставлений, касающихся длинных задач и отраслевых сценариев.
| Бенчмарк (сравнение на одном наборе задач по данным Qwen) | Qwen4-Max | Kimi K3.1 | Разница |
|---|---|---|---|
| JobBench | 68.5 | 61.2 | Qwen4 выше на 7.3 |
| APEX-Agents v1.1 | 72.1 | 65.5 | Qwen4 выше на 6.6 |
| HLAB-Vals-1.1 | 21.3 | 11.7 | Qwen4 выше на 9.6 |
| AA-Briefcase v1.1 Elo | 1686 | 1674 | Qwen4 выше на 12 |
| AgentArena Net Improvement | 7.5 | 3.9 | Qwen4 выше на 3.6 |
| AutomationBench-AA | 72.5 | 73.3 | Kimi выше на 0.8 |
| BioMysteryBench | 85.0 | 80.6 | Qwen4 выше на 4.4 |
| HealthBench Professional | 60.0 | 57.2 | Qwen4 выше на 2.8 |
| Humanity’s Last Exam | 51.7 | 51.1 | практически паритет |
Закономерность в этих данных очевидна: Qwen4-Max в большинстве случаев лидирует в профессиональных задачах, в работе агентов по сдаче результатов и в таких специализированных областях, как биология и медицина, — с отрывом от 3 до 10 баллов. Kimi лишь на AutomationBench-AA незначительно впереди — на 0.8 балла, а в HLE результаты почти одинаковы. Стоит напомнить, что это рамка оценки со стороны Alibaba, и цифры Kimi под собственным harness могут отличаться.
Максимальный вывод в 393K и максимальная цепочка рассуждений в 262K у Qwen4-Max тоже очень полезны для длинных задач. Это значит, что за один вызов можно сгенерировать очень длинный отчёт или файл кода, без необходимости постоянно дробить и склеивать куски, — меньше точек отказа при оркестрации агентов.
Возможности Qwen4-Max и Kimi K3.1 Pro в работе с изображениями и видео
Qwen4-Max нативно поддерживает визуальный ввод. Это также видно на сводной диаграмме Alibaba: в бенчмарке понимания диаграмм Chartography у Qwen4 — 54.2, у Kimi — 50.0; в бенчмарке понимания видео Video-Index — 68.1 и 63.2 соответственно. Qwen4 опережает на 4.2 и 4.9 балла.
Для задач, где нужно читать скриншоты, разбирать диаграммы в отчётах, понимать записи экрана продукта или анализировать видеоконтент, Qwen4-Max — более удобный вариант. У Kimi по этим двум пунктам тоже есть результаты, но если визуальные задачи — основная нагрузка, при масштабировании разрыв будет расти.
По генерации фронтенда стоит посмотреть на сторонние данные. В публичном снимке рейтинга Arena (2026-11-14) в Code Arena WebDev Qwen4-Max (xHigh) с 1750 баллами занимает 6-е место, но всё ещё помечен как Preliminary, голосов — 1,814. Kimi K3.1 Pro (Max) с 1686 баллами — на 13-м месте, 5,215 голосов, уже не preliminary. У Qwen4 балл выше, но выборка меньше, поэтому позиция в рейтинге в дальнейшем ещё может колебаться.
Qwen4-Max против Kimi K3.1 Pro: как посчитать стоимость
Официальные прайс-листы (за 1M токенов, данные на 2026-11-16)
| Статья тарифа | Qwen4-Max (QwenCloud) | Kimi K3.1 Pro (Moonshot) | Kimi K3.1 Pro Highspeed |
|---|---|---|---|
| Вход | $1.5 | $2 | $4 |
| Выход | $4.5 | $10 | $20 |
| Чтение кэша / попадание в кэш | $0.075 | $0.20 | $0.20 |
| Запись в кэш на 5 минут | $1.875 | $2 | — |
| Запись в кэш на 1 час | $3 | $4 | — |
Если пересчитать по прайсу, вход у Qwen4-Max — 75% от цены Kimi, выход — 45%, а чтение кэша — всего 37.5%. На типичной агентной нагрузке «100 млн входных + 10 млн выходных токенов» получается примерно $195 у Qwen4-Max и $300 у Kimi K3.1 Pro. У Kimi есть ещё режим Batch — 60% от стандартной цены, он хорошо подходит для офлайн-пакетных задач; версия Highspeed стоит вдвое дороже, зато даёт примерно в 2–3 раза большую скорость.
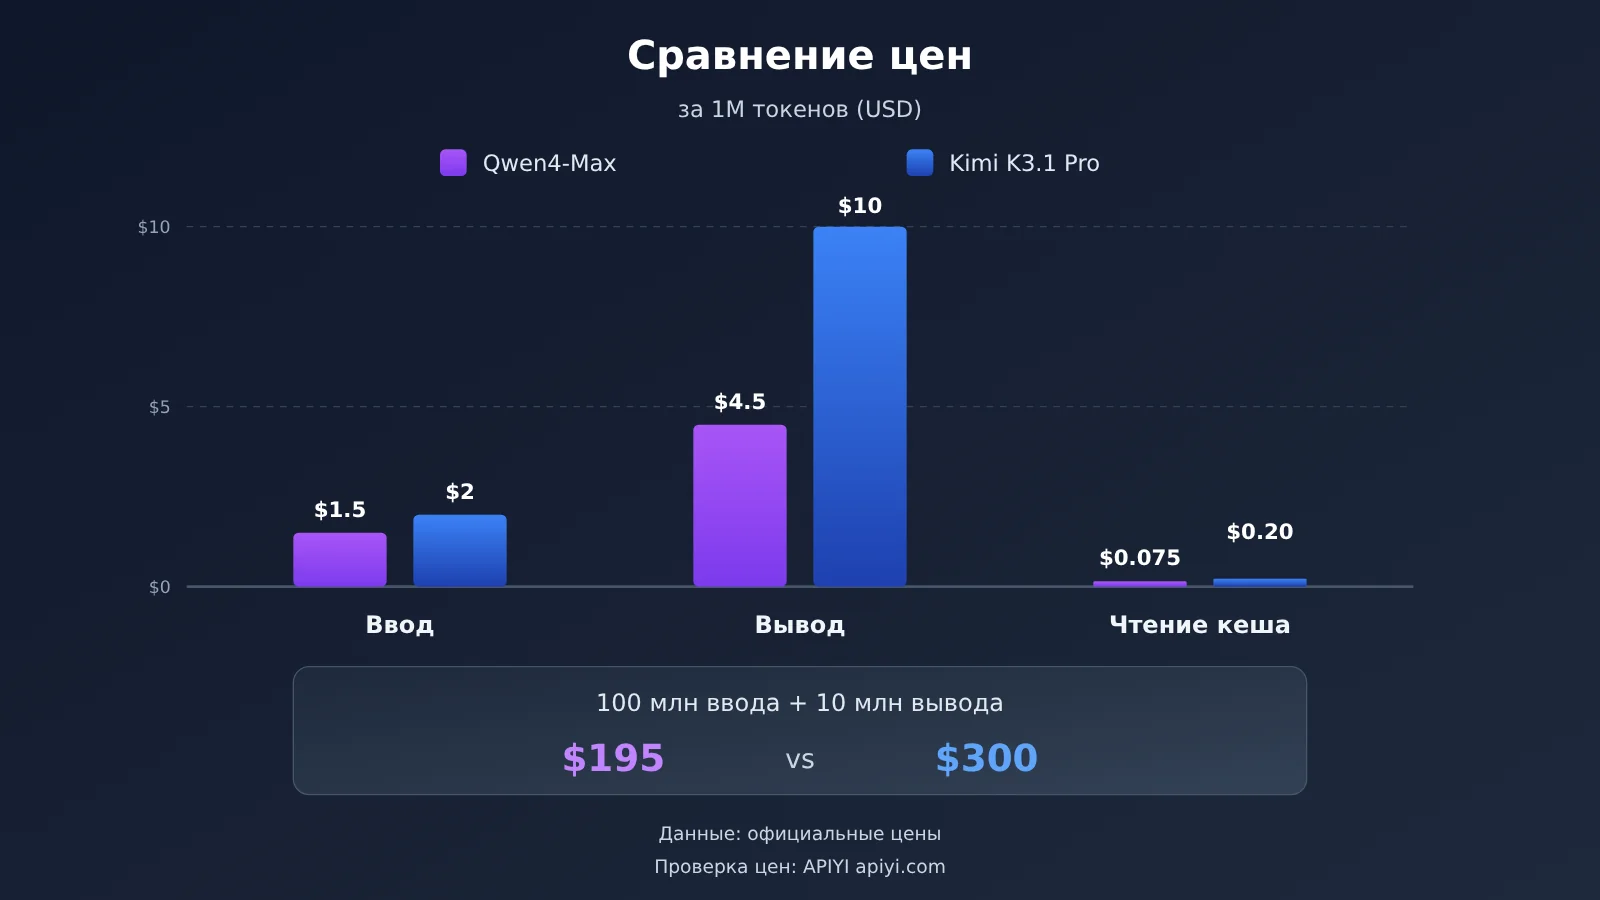
Дешевле за токен — не значит дешевле за задачу
Это, пожалуй, самый контринтуитивный момент в теме стоимости. Снимок arena показывает: стоимость одной задачи у Qwen4-Max (xHigh) — $4.18, а у Kimi K3.1 Pro (Max) — всего $0.89. Qwen4 дешевле за токен, но за задачу дороже в несколько раз: на высоком уровне effort модель генерирует массу токенов цепочки рассуждений, и объём выхода намного превышает показатель Kimi.
Поэтому реальную стоимость надо считать по формуле «цена × фактический расход токенов». У Qwen4-Max по умолчанию reasoning_effort = high; если задаче не нужно глубокое рассуждение, стоит вручную понизить effort — только так преимущество в цене за токен превратится в преимущество по итоговой стоимости.
Актуальные цены APIYI (2026-11-16)
| ID модели | Вход | Выход | Чтение кэша | Статус |
|---|---|---|---|---|
kimi-k3.1-pro |
$2 | $10 | $0.2 | Уже доступна |
kimi-k3.1-pro-highspeed |
$4 | $20 | $0.2 | Уже доступна |
qwen3.8-max |
$1.65 | $4.95 | $0.20625 | Уже доступна |
qwen4-max |
— | — | — | Пока не добавлена, добавим в ближайшее время |
Все цены выше — за 1M токенов. Модель qwen4-max пока отсутствует в списке моделей APIYI — мы добавим её в ближайшее время; а до тех пор можно собрать цепочку вызовов на qwen3.8-max. Названия моделей и цены всегда сверяйте со списком моделей на платформе APIYI apiyi.com: перед сменой модели лучше сначала проверить модель, сличить цену, а потом уже уточнять протокол вызова.
Как вызывать Kimi K3.1 Pro и семейство Qwen через APIYI
APIYI предоставляет OpenAI-совместимый интерфейс. Для подключения нужно всего три изменения, SDK менять не нужно:
- Установите
base_urlклиента наhttps://api.apiyi.com/v1, путь запроса —/chat/completions; - Укажите API-ключ, полученный в консоли APIYI;
- Задайте параметр
modelкакkimi-k3.1-pro,kimi-k3.1-pro-highspeedилиqwen3.8-max. После появленияqwen4-maxв каталоге просто замените название модели.
При A/B-сравнении советуем фиксировать промпт, определения инструментов и уровень effort, меняя только поле model, а также записывать количество входных, выходных и кэшированных токенов при каждом вызове. Так вы сможете и воспроизвести описанный выше эффект «harness меняет оценку», и рассчитать реальную стоимость одной задачи для каждой из двух моделей в вашем бизнесе.
🚀 Быстрый старт: после регистрации на APIYI apiyi.com новые пользователи получают бесплатную тестовую квоту. Одним и тем же ключом можно переключаться между Kimi и семейством Qwen: сначала проверьте результат на небольшом трафике, а потом решайте, какая модель станет основной в продакшене.
Рекомендации по сценариям для Qwen4-Max и Kimi K3.1 Pro
Когда выбирать Kimi K3.1 Pro
- Приватное развертывание и дообучение: нужны открытые веса для доменного дообучения, квантования или офлайн-развертывания;
- Терминальный coding-агент: основная нагрузка — цикл чтения, выполнения и исправления в командной строке;
- Офлайн-пакетная обработка: можно принимать асинхронные результаты и использовать Batch со скидкой 40%, чтобы снизить затраты;
- Интерактив с низкой задержкой: если важна скорость, выбирайте версию Highspeed — платите больше, но получаете скорость в 2–3 раза выше.
Когда выбирать Qwen4-Max
- Приоритет managed-решения: не хотите поддерживать inference-кластер, нужен только стабильный API;
- Изображения и видео: основной вход — понимание скриншотов, разбор диаграмм и анализ видео;
- Выполнение длинных задач: генерация отчетов, агенты для бизнес-процессов, профильные вопросы в медицине и биологии;
- Чувствительность к стоимости за токен: при контроле effort стоимость за миллион токенов минимальна.
Qwen4-Max и Kimi K3.1 Pro: рекомендации по выбору
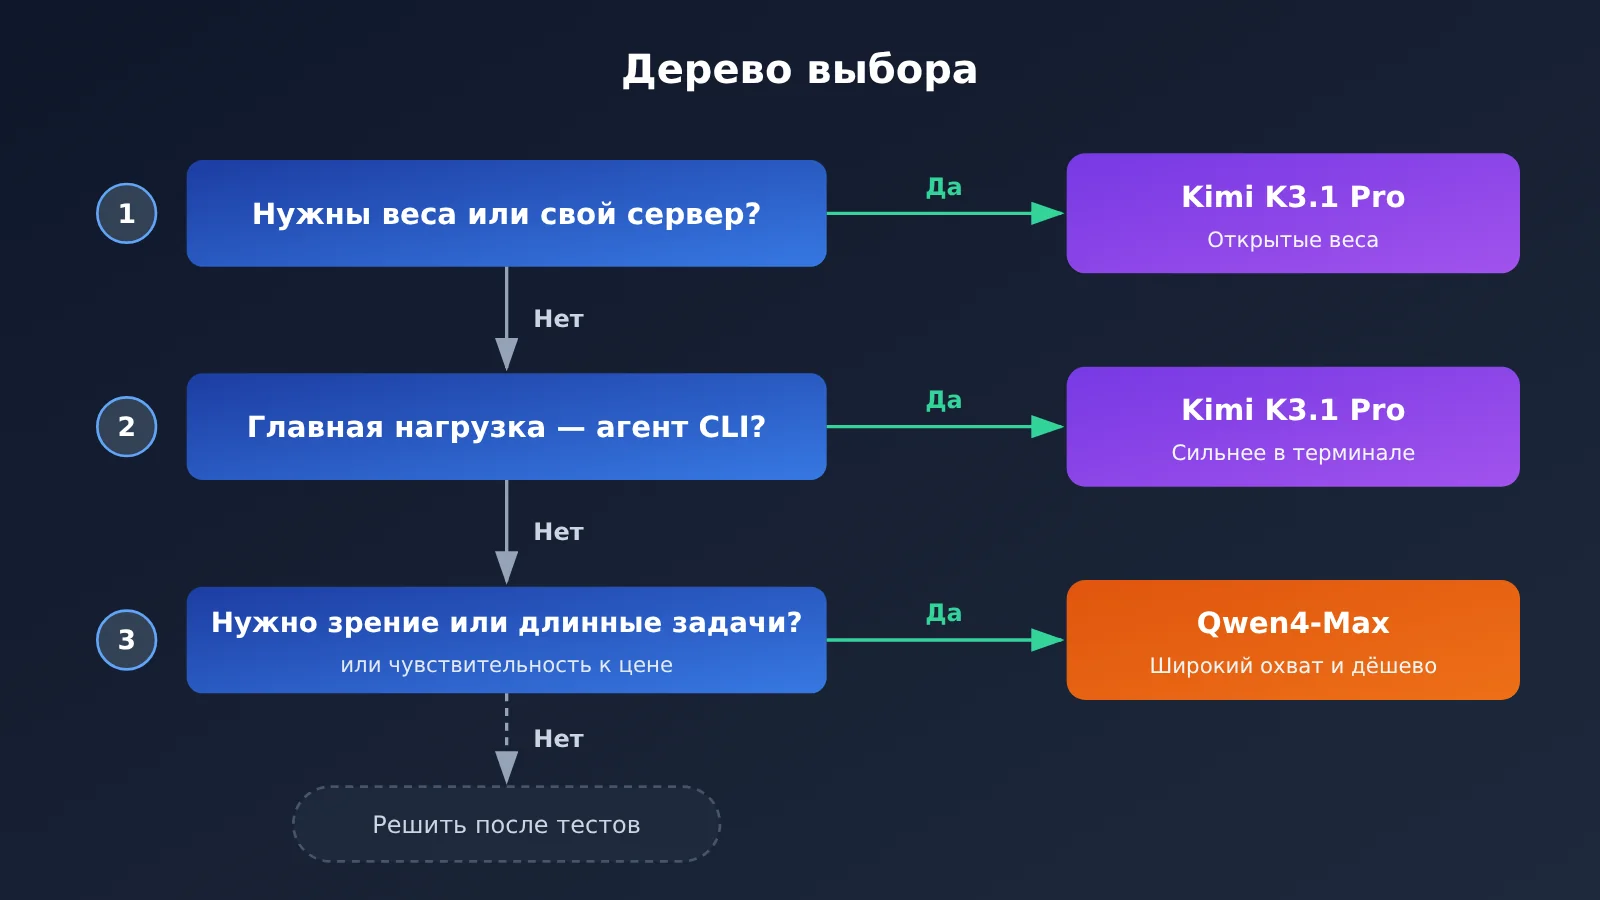
Сведите пять критериев к трём вопросам. Первый: обязательно ли получать веса модели? Если да — сразу выбирайте Kimi K3.1 Pro. Второй: основная нагрузка — это агент командной строки? Если да, Kimi стабильнее. Третий: если ни то ни другое, то Qwen4-Max выигрывает по работе с изображениями, выполнению длительных задач и цене за единицу.
Смешанное использование — тоже распространённая практика: Kimi K3.1 Pro отвечает за выполнение в терминале, а линейка Qwen — за понимание изображений и подготовку отчётов. Такая схема требует, чтобы обе модели работали через один и тот же интерфейс; единый шлюз избавит от немалой части работы по адаптации.
💡 Рекомендация по выбору: в конечном счёте выбор зависит от распределения ваших задач. Мы советуем на APIYI (apiyi.com) прогнать один раунд сравнения на реальных задачах, записать для обеих сторон успешность и расход токенов через один и тот же base_url — и уже потом решать, какая модель будет основной.
Частые вопросы (FAQ)
Q1: В чём главное отличие Qwen4-Max от Kimi K3.1 Pro?
Kimi K3.1 Pro — модель с открытыми весами уровня 3T: её можно развернуть и дообучить самостоятельно. Qwen4-Max доступна в виде управляемого API, нативно поддерживает изображения, а цена по прайс-листу у неё ниже. Первая сильнее в терминальных задачах, вторая — в визуальных задачах и выполнении длительных задач.
Q2: Так сколько у Kimi K3.1 Pro в Terminal-Bench — 65.7 или 67.2?
Оба значения верны, но методики разные. 65.7% взяты из официальной документации Moonshot, 67.2 — из сравнения, которое Qwen публикует сама на том же графике; разница объясняется harness, effort и версией набора задач. При цитировании обязательно указывайте источник: смешивать значения нельзя, как и склеивать рейтинг из разных документов.
Q3: Длина контекстного окна у них одинаковая?
В целом да. У Kimi K3.1 Pro — 1,048,576 токенов, у Qwen4-Max — 1M. Qwen4-Max дополнительно раскрывает максимальный объём вывода 393K и максимальную цепочку рассуждений 262K, что удобнее для длинного вывода за один вызов.
Q4: Почему Qwen4-Max дешевле за единицу, а стоимость одной задачи в arena всё равно выше?
В снимке arena Qwen4-Max использовала уровень xHigh, расход токенов на цепочку рассуждений большой: стоимость одной задачи — $4.18, тогда как у Kimi K3.1 Pro (Max) — $0.89. Реальная стоимость — это цена за единицу, умноженная на расход токенов; чтобы реализовать преимущество низкой цены, нужно снизить `reasoning_effort`.
Q5: Можно ли уже вызывать Qwen4-Max через APIYI?
`qwen4-max` пока нет в каталоге, но мы добавим её в ближайшее время. Сейчас на APIYI apiyi.com можно вызывать `kimi-k3.1-pro`, `kimi-k3.1-pro-highspeed` и `qwen3.8-max`, base_url — `https://api.apiyi.com/v1`. Актуальные модели и цены смотрите в каталоге моделей на платформе.
Q6: Какие известные недостатки есть у каждой из двух моделей?
Qwen4-Max заметно отстаёт в терминальных задачах (48.5 против 67.2 в том же сравнении Alibaba), её рейтинг в arena по-прежнему Preliminary, а высокий effort по умолчанию может увеличивать стоимость одной задачи. У Kimi K3.1 Pro цена за выходные токены более чем вдвое выше, чем у Qwen4, и она уступает в визуальных задачах, видео и большинстве отраслевых метрик качества выполнения.
Qwen4-Max против Kimi K3.1 Pro: ключевые выводы
- Веса — жёсткая граница: если нужно дообучение или приватное развёртывание, выбор только за Kimi K3.1 Pro.
- В терминальных задачах сильнее Kimi: на одной и той же диаграмме Alibaba Kimi опережает Qwen4-Max на 18,7 балла.
- Баллы зависят от методики: 65,7 и 67,2 получены в разных harness, смешивать их нельзя.
- Поставка задач и визуал — сильная сторона Qwen4: лидирует в JobBench, APEX-Agents, Video-Index и ряде других тестов.
- Цена за единицу у Qwen4 ниже: цена вывода — всего 45% от Kimi, но нужно контролировать effort.
- Как начать: в APIYI одним и тем же ключом переключаться между
kimi-k3.1-proи серией Qwen для сравнения.
Итог
Главные выводы из сравнения Qwen4-Max и Kimi K3.1 Pro:
- Можно ли менять модель: открытые веса — эксклюзивное преимущество Kimi K3.1 Pro;
- Терминал и поставка задач: Kimi силён в агентах командной строки, Qwen4-Max — в выполнении длительных задач, визуале и видео;
- Стоимость: Qwen4-Max дешевле всего за миллион токенов, но реальный счёт зависит от расхода токенов, который создаёт effort.
Баллы бенчмарков лишь задают направление — окончательный ответ нужно получить на своих задачах. Рекомендую через APIYI apiyi.com на едином интерфейсе прогнать небольшой сравнительный прогон; после выхода qwen4-max можно так же бесшовно заменить модель и продолжить проверку.
📚 Справочные материалы
- Официальный блог Qwen4-Max: спецификации модели, контекстное окно и цены QwenCloud
- Ссылка:
qwen.ai/blog?id=qwen4-max -
Описание: содержит официальные сравнительные данные, которые сама Qwen приводит на одних и тех же изображениях
-
Быстрый старт Kimi K3.1 Pro: официальная документация Moonshot
- Ссылка:
platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart.md -
Описание: содержит официально заявленные оценки Terminal-Bench 4.0 и Kimi Code Bench 3.0
-
Цены на чат-модель Kimi: официальная страница с ценами Moonshot
- Ссылка:
platform.kimi.ai/docs/pricing/chat.md -
Описание: правила тарификации стандартной версии, версии Highspeed и Batch
-
Arena Code Arena WebDev: снимок публичного рейтинга на 2026-11-14
- Ссылка:
arena.ai - Описание: рейтинг по голосам третьих сторон и стоимость одной задачи
Автор: техническая команда APIYI
Обсудить технические вопросы: пишите нам прямо на главной странице сайта APIYI, а больше материалов ищите в центре документации docs.apiyi.com