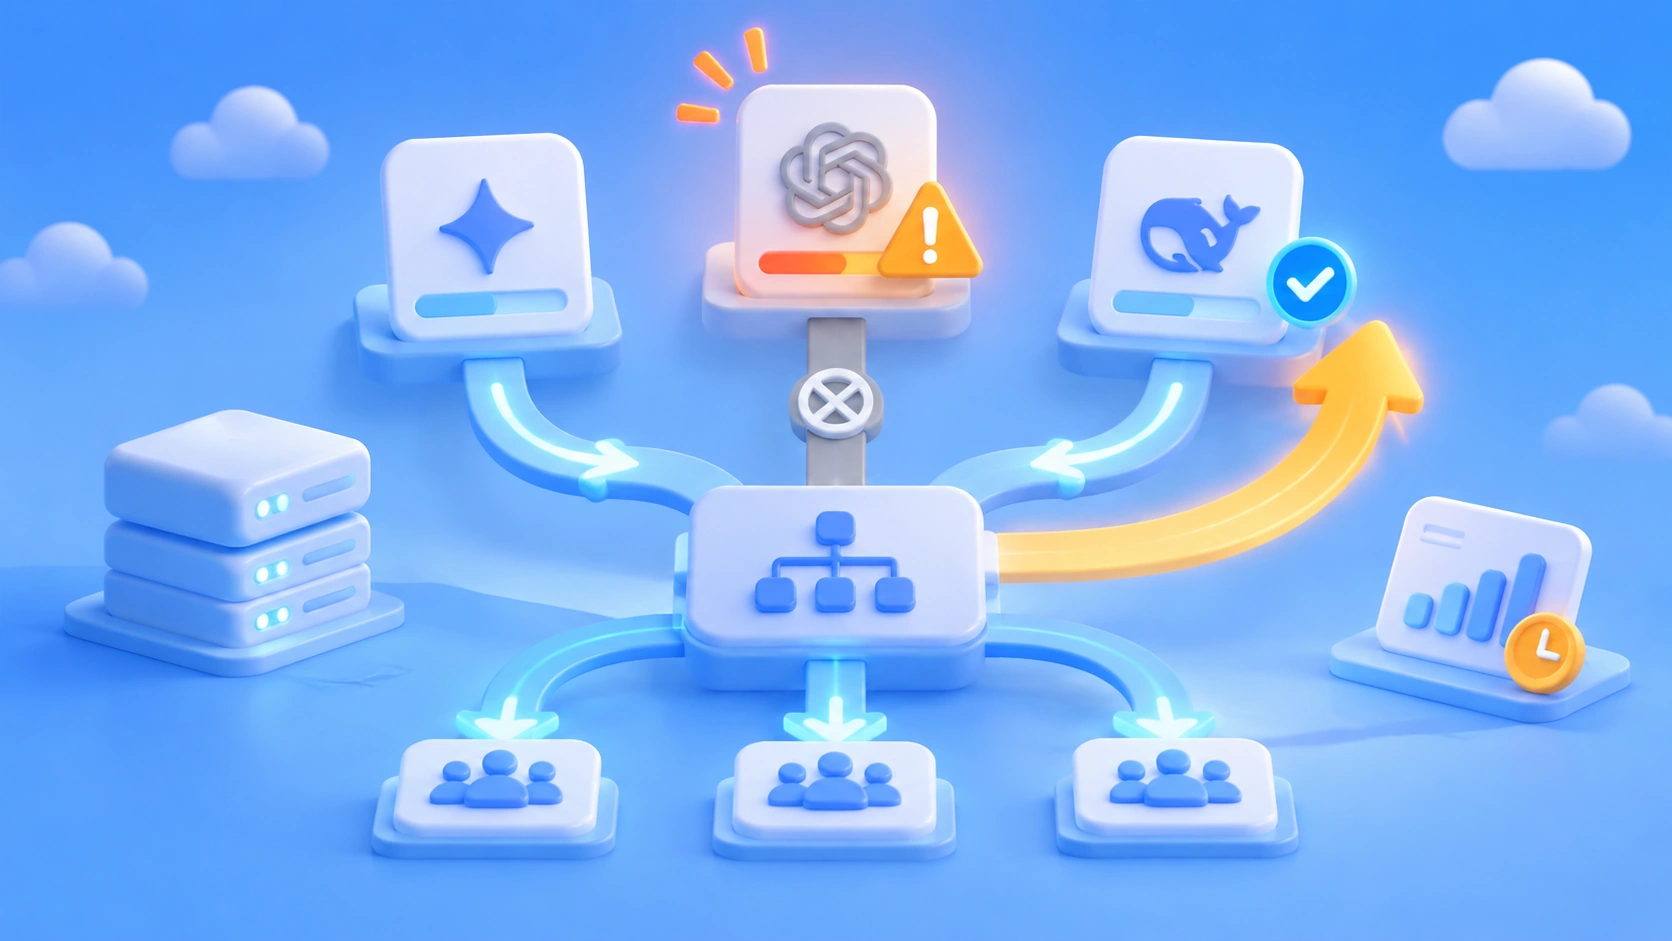
Nota do autor: atingir limites de cota, sofrer restrições de taxa e encontrar timeouts no lançamento de um novo modelo é algo previsível. Este artigo apresenta 5 pontos de projeto — divisão de modelos em camadas, mapeamento de alternativas, filas de prioridade, agendamento fora dos horários de pico, monitoramento e orçamento — além de um checklist de capacidade para o dia do lançamento.
Vamos direto ao ponto: atingir o limite de cota assim que um novo modelo é lançado não é um acidente, mas parte do ritmo do produto. As cotas gratuitas atraem muita gente para testar, o tráfego fica concentrado no dia do lançamento e o provedor precisa de tempo para ampliar a capacidade. Com tudo isso junto, a escassez de capacidade é praticamente inevitável. Do lado da aplicação, o que realmente importa é planejar com antecedência a alternância entre modelos e o agendamento fora dos horários de pico, em vez de repetir requisições sem parar depois que aparecer um 429.
Este não é um artigo para ensinar você a “adicionar mais algumas tentativas”. Novas tentativas podem lidar com oscilações momentâneas, mas não resolvem o esgotamento da cota nem a sobrecarga do provedor. No dia do lançamento, o que conta não é o número de tentativas, mas as camadas e filas planejadas com antecedência. Ao final, você terá um método prático para planejar a capacidade no dia do lançamento: divisão de modelos em camadas, mapeamento de alternativas, filas de prioridade, agendamento fora dos horários de pico, monitoramento e orçamento. Também saberá quando alternar, quando colocar requisições na fila e quando parar.
Por que é fácil atingir o limite no dia de lançamento de um modelo
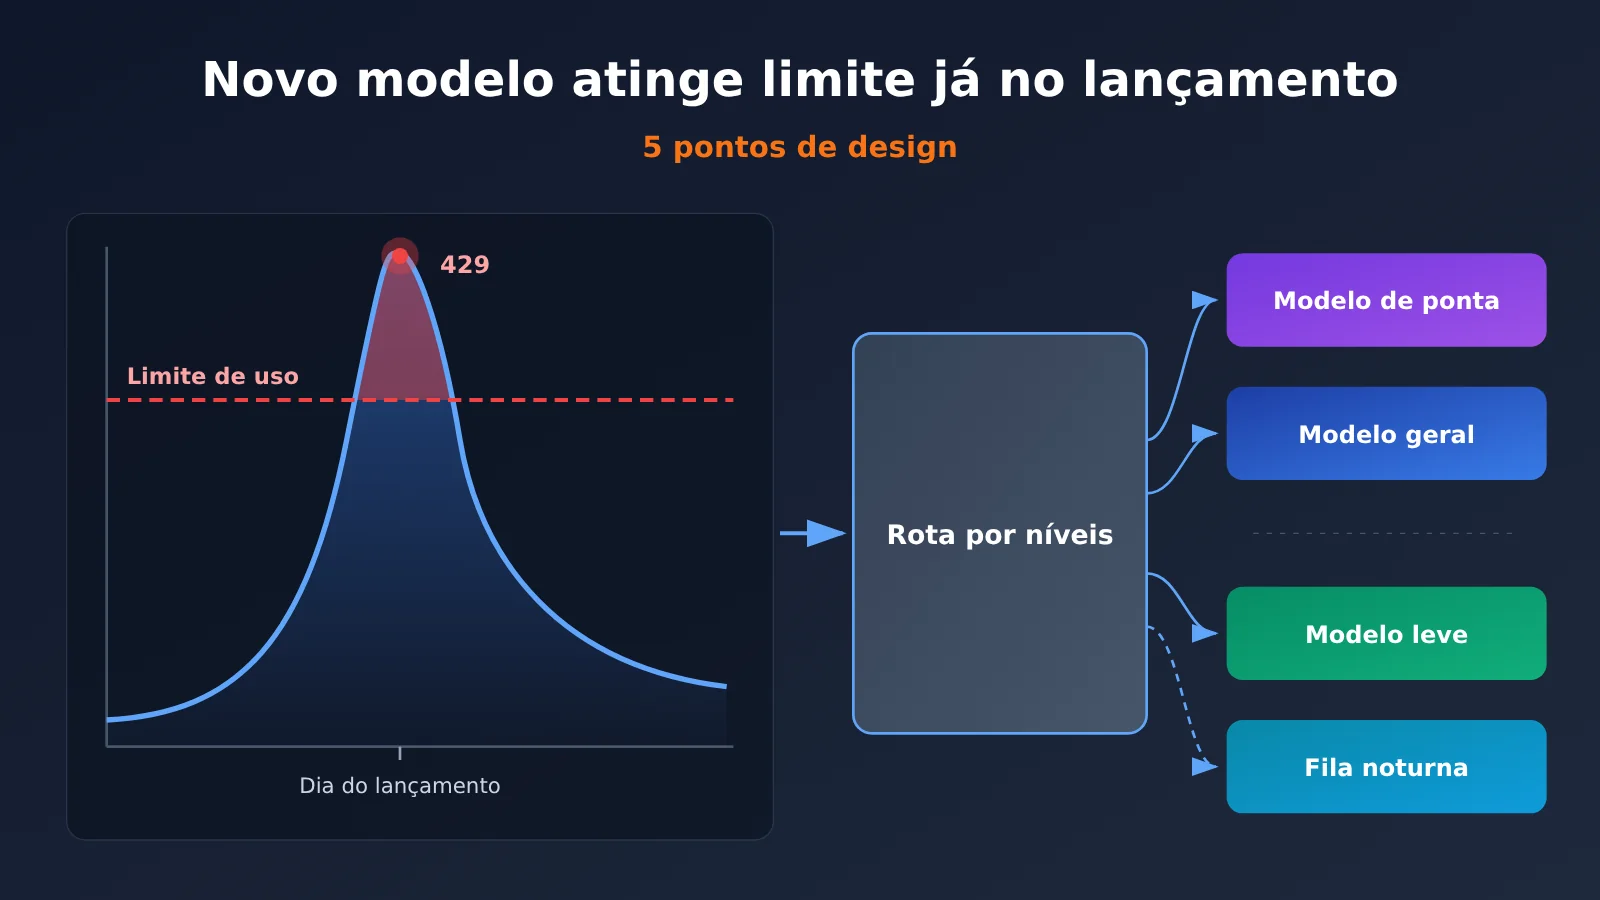
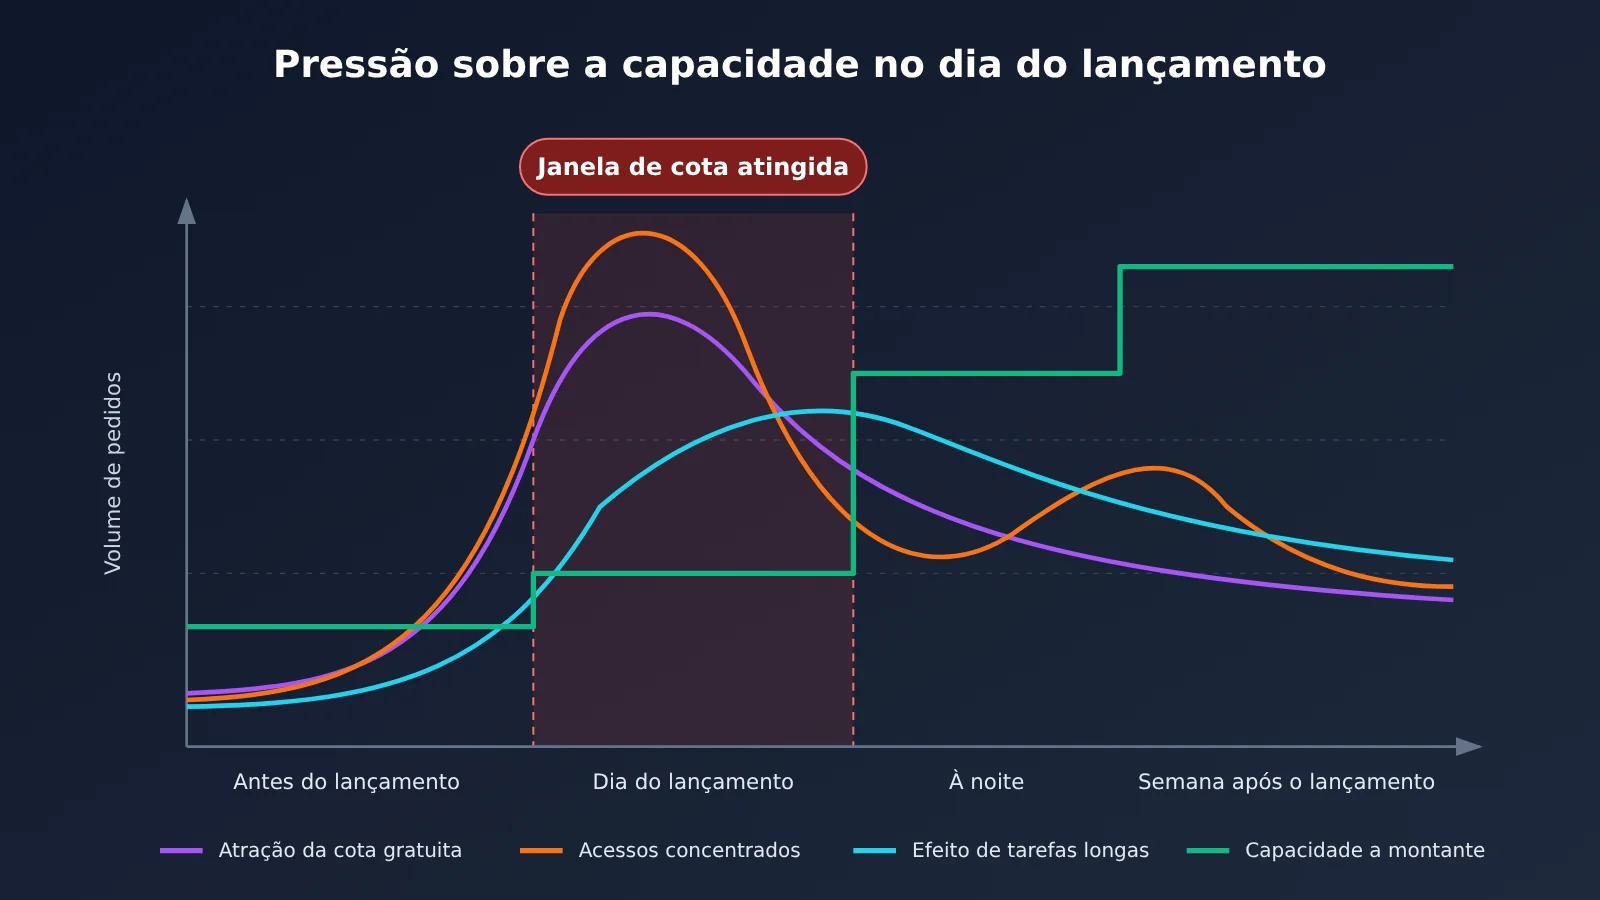
Em resumo: os limites são atingidos porque a demanda dispara de uma vez, enquanto a expansão da capacidade leva tempo. As aplicações devem ser projetadas considerando isso um evento previsível.
Um exemplo recente é o Hy4, da Tencent. Segundo informações públicas da empresa, o Hy4 estreou no WorkBuddy em 4 de novembro. No primeiro dia, muitos usuários atingiram o limite de uso. Em seguida, a Tencent multiplicou por dez a capacidade do cluster de inferência e aumentou a cota gratuita. A recomendação da empresa foi mudar para o Hy3 ao atingir o limite ou deixar tarefas não urgentes para a noite. A Tencent também estendeu o acesso gratuito por tempo limitado ao Hy3 até 15 de novembro, às 23:59.
Vale destacar que esse caso aconteceu no produto WorkBuddy: tratava-se de uma cota de uso para usuários finais e não pode ser equiparado diretamente à limitação de taxa da API. As cotas de produto geralmente são calculadas por conta ou nível de assinatura, enquanto os limites da API controlam a taxa e a concorrência por chave, organização ou modelo. As condições que os acionam e as formas de lidar com eles também são diferentes. Ainda assim, o caso revela um padrão geral: assim que um modelo é lançado, a demanda se concentra em um intervalo muito curto.
A escala dessa demanda também está crescendo rapidamente. No mesmo dia 4 de novembro, a DeepSeek informou que o Harness tinha cerca de 1,54 milhão de usuários ativos por dia e consumia aproximadamente 92 trilhões de tokens diariamente. Esses números foram divulgados pela própria empresa, sem auditoria independente, e servem apenas para dar uma ideia da escala, não como base precisa para planejar capacidade. Mesmo assim, mostram que o consumo de tokens em aplicações com agentes já supera em muito o de conversas comuns.
Quatro motivos para atingir o limite em um novo modelo
| Motivo | Como se manifesta | Impacto nas aplicações |
|---|---|---|
| Cota gratuita ou de teste | Novos modelos costumam oferecer uma cota de teste, atraindo muitos usuários ao mesmo tempo | A cota acaba rapidamente, gerando erros 402 ou 429 |
| Acessos concentrados | O tráfego do dia de lançamento, de períodos promocionais e do horário comercial se acumula | O pico pode chegar a 3-10 vezes o volume habitual |
| Tarefas longas | Múltiplas rodadas de agentes, chamadas de ferramentas e contextos longos | Cada requisição consome muitos tokens e ocupa recursos de inferência por mais tempo |
| Demora na expansão do provedor | Ampliar o cluster de inferência leva tempo | Erros 5xx, filas, timeouts e até oscilações na qualidade da saída |
Desses quatro fatores, as aplicações só podem controlar diretamente o formato e o agendamento das próprias requisições. Por isso, em vez de esperar que o provedor aguente o pico, é melhor preparar sua aplicação para distribuir e armazenar temporariamente as requisições.
Cinco tipos de problemas de capacidade em modelos novos
Conclusão: atingir um limite não é um único tipo de erro. Existem cinco problemas de capacidade diferentes, e cada um exige uma abordagem específica.
Muitas equipes tratam todas as falhas com a mesma lógica de repetição. Isso pode ampliar incidentes no dia do lançamento. Quando a cota acaba, novas tentativas continuarão falhando; quando o provedor está sobrecarregado, tentativas em sequência podem piorar o congestionamento. A tabela abaixo separa os cinco problemas para ajudar você a definir como tratar cada um.
| Problema | Códigos de status típicos | Causa | Tratamento |
|---|---|---|---|
| Cota esgotada | 402、429 |
Cota gratuita, cota de teste ou saldo da conta esgotado | Pare de tentar novamente, mude para um modelo de backup ou solicite a recarga |
| Limite de taxa ou de concorrência | 429, geralmente com Retry-After |
Limite de RPM, TPM ou concorrência por chave ou modelo excedido | Aguarde conforme Retry-After; se a espera superar o limite definido, mude de modelo ou coloque a tarefa na fila |
| Capacidade insuficiente no provedor | 500、502、503、529 |
Sobrecarga ou falha parcial no cluster de inferência | Faça poucas tentativas com espera exponencial; após falhas consecutivas, mude para um modelo de backup |
| Recursos ocupados por tarefas longas | Timeout, conexão interrompida | Múltiplas rodadas de agentes, chamadas de ferramentas ou contexto longo tornam cada requisição pesada demais | Divida as tarefas, limite o contexto e use um pool de concorrência separado para tarefas longas |
| Concentração de tráfego em horários de pico | Combinação de 429 e 5xx |
Acúmulo de tráfego durante o dia, em lançamentos ou em períodos de eventos | Use uma fila de prioridades e distribua as tarefas ao longo do tempo, adiando as que não são urgentes |
Dois detalhes merecem destaque. Primeiro, o código 429 é ambíguo: pode indicar tanto um limite de taxa excedido quanto uma cota esgotada. Para distinguir os casos, confira a mensagem de erro no corpo da resposta e o Retry-After. Segundo, códigos de sobrecarga como 529 indicam que o provedor está temporariamente indisponível. Nesse caso, reduzir a frequência das requisições é mais eficaz do que acelerar as tentativas.
Depois de distinguir os códigos de erro, fica mais fácil aplicar os cinco pontos de design a seguir: quando mudar de modelo, quando colocar uma tarefa na fila e quando simplesmente parar.
5 pontos de projeto para alternar entre modelos e distribuir a carga fora dos horários de pico
Em resumo: os cinco pontos respondem às perguntas “qual modelo usar, por qual substituí-lo, quem usa primeiro, quando usar e quanto foi gasto”. Se faltar algum deles, o problema vai aparecer no dia do lançamento.
Ponto 1: divisão dos modelos por nível
Como fazer: divida os modelos em três níveis, de acordo com capacidade e custo: avançado, geral e leve. Depois, associe as tarefas de negócio a cada nível conforme a prioridade e a dificuldade. Use o nível avançado para raciocínio complexo e geração de código crítico; o geral para perguntas e respostas, resumos e reescrita do dia a dia; e o leve para tarefas simples, como classificação, extração e reconhecimento de intenção. Quando um novo modelo é lançado, normalmente ele recebe apenas parte do tráfego do nível avançado, em vez de substituir todos os modelos de uma vez.
Quando aplicar: a divisão por níveis é uma configuração permanente, não algo ativado apenas em caso de falha. Ela determina o destino padrão de cada tipo de tarefa no dia a dia; no dia do lançamento, basta ajustar as proporções.
Como validar: use um conjunto fixo de testes para avaliar cada nível e registre a taxa de aprovação, a latência P95 e o custo em tokens por tarefa. Confirme que a qualidade não cai significativamente quando o nível leve assume tarefas simples.
Na implementação, o maior obstáculo costuma ser ter que lidar com um SDK e uma chave diferentes para cada fornecedor. Com uma plataforma agregadora como a APIYI apiyi.com, uma única chave permite invocar modelos de diferentes fornecedores, como OpenAI, Claude e Gemini. A interface é compatível com o formato da OpenAI, então basta alterar o nome do modelo ao configurar os níveis, sem precisar manter autenticação e clientes separados para cada um.
Ponto de atenção 2: mapeamento de modelos alternativos
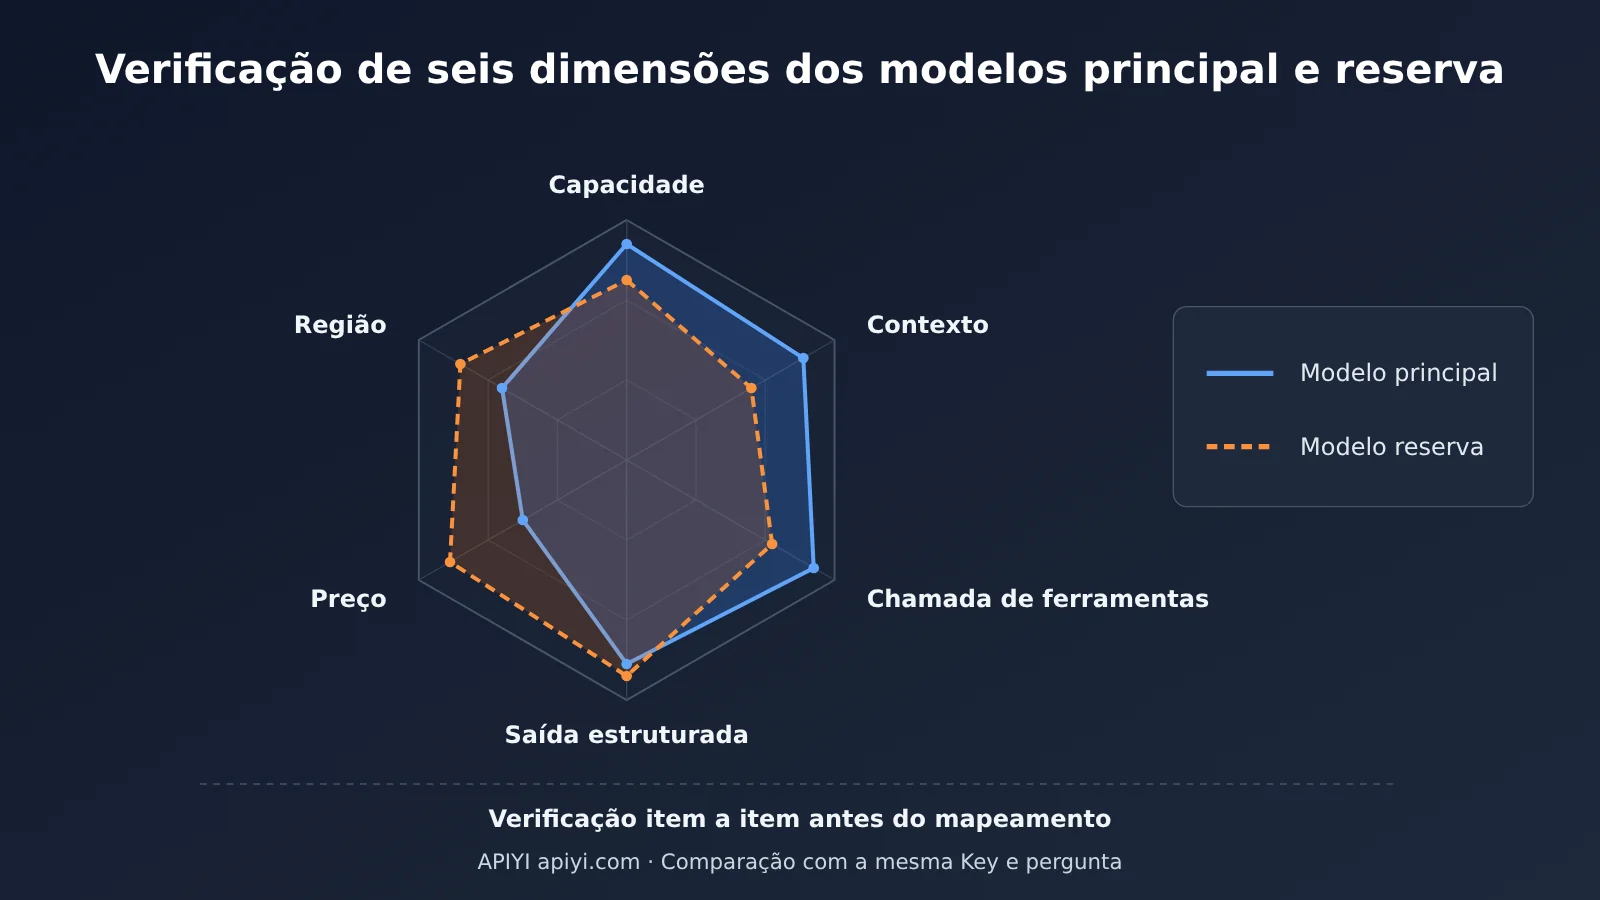
Como fazer: defina pelo menos um modelo alternativo para cada modelo principal. Ao fazer o mapeamento, confira seis aspectos: nível de capacidade, tamanho do contexto, suporte à chamada de ferramentas, capacidade de saída estruturada, preço e regiões disponíveis. Os pontos mais fáceis de esquecer são a chamada de ferramentas e a saída estruturada. Se o modelo alternativo não aceitar o mesmo formato de chamada de função, o Agent será interrompido assim que houver a troca.
Quando acionar a troca: defina condições específicas, como 2 respostas 5xx consecutivas, um Retry-After de 429 maior que o tempo de espera aceitável para a tarefa, latência P95 acima do dobro da linha de base por um período prolongado ou uma resposta explícita de esgotamento da cota. Não configure a troca para “qualquer falha”: isso faria até oscilações pontuais provocarem trocas em excesso.
Como validar: execute o mesmo conjunto de questões nos modelos principal e alternativo. Compare a taxa de aprovação, a taxa de validação das saídas estruturadas e a taxa de sucesso das chamadas de ferramentas. Se a diferença ultrapassar a tolerância do negócio, escolha outro modelo alternativo.
| Camada | Tarefas aplicáveis | Modelo principal | Modelo alternativo | Condição de troca |
|---|---|---|---|---|
| Camada flagship | Raciocínio complexo, código crítico, planejamento de Agent | Modelo flagship recém-lançado | Flagship da geração anterior ou modelo equivalente de outro fornecedor | 2 respostas 5xx consecutivas; Retry-After de 429 superior a 30 segundos |
| Camada geral | Perguntas e respostas, resumos, reformulação de textos, geração de relatórios | Modelo geral principal | Modelo geral equivalente de outro fornecedor | Latência P95 acima de 2 vezes a linha de base por 5 minutos |
| Camada leve | Classificação, extração, roteamento, identificação de intenção | Modelo leve | Modelo leve de outro fornecedor | Taxa de 5xx acima de 5%; esgotamento da cota |
| Camada de processamento em lote | Análise offline, anotação de dados, avaliação | Qualquer modelo de baixo custo disponível | Não troca, apenas adia | Sem troca imediata; entra na fila noturna |
| Plataformas disponíveis | Acesso unificado para todas as camadas acima | APIYI apiyi.com, APIs oficiais dos fornecedores | As mesmas | Consulte o console e a documentação |
Os limites da tabela são exemplos e devem ser ajustados à linha de base do seu negócio.
💡 Sugestão de fallback: se você não quiser manter toda a lógica de troca na aplicação, pode combiná-la com os recursos da plataforma. A APIYI apiyi.com informa oficialmente que usa implantação em múltiplos nós, roteamento inteligente, fallback automático e balanceamento de carga, o que pode ajudar a aliviar parte da pressão em falhas parciais nos serviços upstream. Consulte a documentação oficial para conhecer as condições de acionamento e as regras de troca. Ainda assim, é recomendável manter seus próprios mapeamentos de modelos alternativos na aplicação como garantia.
Ponto de projeto 3: filas de prioridade
Como fazer: divida as solicitações em três níveis de prioridade: tarefas pagas ou urgentes, tarefas internas e tarefas em lote. As tarefas urgentes vão direto para o modelo principal; as internas passam para o modelo alternativo quando o principal estiver ocupado; e as tarefas em lote entram na fila. Para cada fila, defina o limite de concorrência, o tempo máximo de espera e uma estratégia de fallback em caso de timeout. Assim, uma tarefa longa não ocupa toda a capacidade disponível.
Quando ativar: as filas entram em ação quando a taxa de respostas 429 do modelo principal ou o tamanho da fila ultrapassa o limite definido. Nesse momento, solicitações de baixa prioridade deixam de disputar a capacidade do modelo principal.
Como verificar: as filas precisam ser observáveis. No mínimo, acompanhe o tamanho da fila, o tempo médio de espera e a taxa de desistência. Durante os testes de carga, provoque uma limitação artificial no modelo principal e confirme que a latência das tarefas urgentes continua estável e que as tarefas de baixa prioridade ficam na fila, em vez de falhar.
Há uma regra obrigatória: solicitações não idempotentes não podem ser repetidas automaticamente. Em operações como fazer pedidos, enviar mensagens, gravar no banco de dados ou chamar ferramentas externas pagas, consulte primeiro o status após uma falha para confirmar se a tentativa anterior já teve efeito. Só então decida se deve reenviar a solicitação. Também é possível gerar uma chave de idempotência para que o servidor identifique e descarte duplicatas. Repetir automaticamente todos os erros é uma causa comum de cobranças e gravações duplicadas no dia do lançamento.
Ponto de atenção 4: agendamento fora do horário de pico
Como fazer: identifique tarefas que toleram atrasos, como relatórios offline, resumos em lote, anotação de dados e avaliações de regressão, e execute-as à noite ou em períodos de baixa demanda. Uma das recomendações da Tencent para usuários que atingem o limite do Hy4 é deixar as tarefas não urgentes para a noite. A mesma ideia vale para chamadas de API.
Quando acionar: é possível combinar dois tipos de acionamento. Um usa uma janela de tempo, executando tarefas em lote em horários fixos durante a noite. O outro se baseia na carga: quando a taxa de 429 ou a latência P95 durante o dia ultrapassar o limite definido, a execução da fila de processamento em lote é adiada automaticamente.
Como validar: verifique se o volume de requisições no pico diurno caiu e se a taxa de conclusão das tarefas noturnas e a taxa de falhas nas novas tentativas estão dentro de limites aceitáveis. Tarefas que falharem podem ser executadas novamente, mas devem continuar respeitando o princípio de idempotência.
Ponto de atenção 5: monitoramento e orçamento
Como fazer: acompanhe o uso por Key, modelo e tipo de tarefa, em vez de olhar apenas o total. Mesmo que o total esteja estável, o consumo de tokens de uma tarefa de Agent pode ter dobrado. Essa mudança só aparece quando os dados são separados por dimensão. Defina também um orçamento temporário e alertas para o dia do lançamento. Os limites dos alertas podem ser um pouco mais flexíveis, mas o teto de orçamento deve ser mantido.
Quando acionar: configure alertas para quatro tipos de sinal: aumento repentino na taxa de 429, aumento repentino na taxa de 5xx, consumo de tokens por tarefa acima da linha de base e consumo de uma determinada proporção do orçamento diário.
Como validar: antes do lançamento, faça um teste com pouco tráfego para confirmar que o painel separa os dados corretamente por dimensão e que os alertas chegam no prazo esperado.
| Métrica | Dimensão de análise | Descrição |
|---|---|---|
Taxa de 429 |
Key, modelo | Diferenciar excesso no limite de taxa de esgotamento da cota |
Taxa de 5xx |
Modelo | Identificar sobrecarga no provedor e acionar a troca |
| Latência P95 | Modelo, tipo de tarefa | Analisar tarefas longas separadamente para não elevar a linha de base geral |
| Tamanho da fila e tempo de espera | Fila de prioridade | Observar se tarefas de baixa prioridade estão se acumulando |
| tokens/tarefa, custo/tarefa | Tipo de tarefa | Múltiplas rodadas de Agent e chamadas de ferramentas podem ampliar bastante o consumo |
| Número de trocas e taxa de sucesso do fallback | Mapeamento principal-reserva | Verificar se o modelo reserva realmente absorveu o tráfego |
O acompanhamento dos custos pode contar com os recursos da plataforma. O console da APIYI apiyi.com oferece consultas à lista de modelos, uso, faturamento e logs, o que facilita conferir o consumo real por Key e modelo no dia do lançamento. Combinando esses dados com a instrumentação por tipo de tarefa, você consegue relacionar “quanto foi gasto” com “onde foi gasto”.
Para estimar a capacidade, use o número de usuários ativos diários, o volume de requisições e a média de tokens para calcular o QPS de pico. Depois, multiplique pelo fator de amplificação das múltiplas rodadas de Agent e das chamadas de ferramentas. No dia do lançamento, o pico pode ser de 3 a 10 vezes maior que o habitual. Reserve de 30% a 50% de capacidade extra ou deixe um modelo reserva pronto para receber o tráfego a qualquer momento. Estimar apenas com base em cenários de chat leva a uma subestimação significativa do consumo causado por contextos longos e chamadas de ferramentas.
Primeiros passos para alternar entre modelos: como validar a contingência
Conclusão: se o caminho de contingência nunca foi testado, é como se ele não existisse. A validação precisa acontecer antes da implantação.
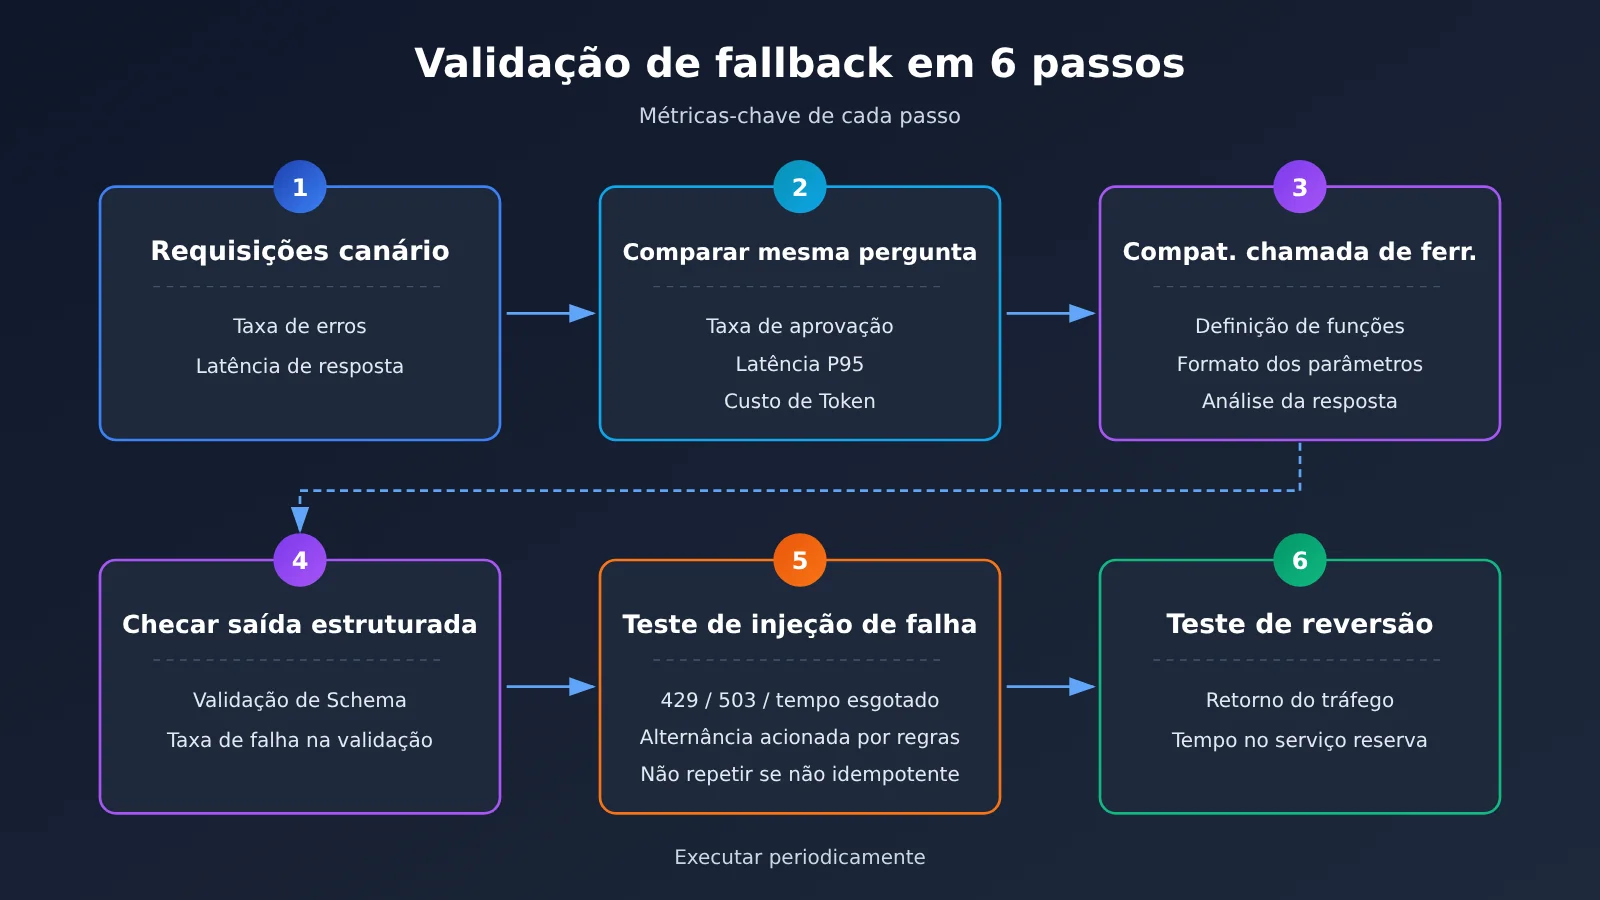
A mudança na integração não é complicada. Se você já usa um SDK compatível com a OpenAI, basta definir base_url como https://api.apiyi.com/v1 e trocar api_key pela chave fornecida pela plataforma. Assim, você pode alternar entre o modelo principal e o modelo de contingência alterando o parâmetro model, sem precisar de um novo cliente. O que realmente exige tempo é a validação. Recomendamos seguir esta ordem:
- Requisições canário: envie uma pequena parcela do tráfego real para o modelo de contingência e observe a taxa de erro e a latência.
- Comparação com as mesmas entradas: execute o modelo principal e o de contingência com um conjunto fixo de avaliação e compare a taxa de aprovação, a latência P95 e o custo em tokens.
- Compatibilidade de chamadas de ferramentas: verifique, uma a uma, se as definições das funções, os formatos dos parâmetros e a interpretação dos retornos funcionam no modelo de contingência.
- Validação de saída estruturada: valide as saídas JSON com um schema e registre a taxa de falhas na validação.
- Teste de injeção de falhas: simule
429,503e tempos limite para confirmar que a alternância é acionada conforme as regras e que requisições não idempotentes não são repetidas automaticamente. - Teste de reversão: depois que o modelo principal se recuperar, confirme que o tráfego volta para ele conforme o esperado e não fica muito tempo no modelo de contingência.
O ideal é testar a contingência regularmente, e não apenas uma vez antes da implantação. Os modelos dos provedores recebem atualizações, e seus comandos e definições de ferramentas também mudam. Um mapeamento validado há três meses pode não funcionar mais hoje.
🚀 Comece rapidamente: cadastre-se na APIYI apiyi.com e receba créditos gratuitos para testes. Use a mesma chave para comparar os modelos principal e de contingência com as mesmas entradas antes de decidir o mapeamento para o dia da implantação. Consulte o console e a documentação para verificar os preços e a disponibilidade dos modelos.
Perguntas frequentes FAQ
Conclusão: a maioria das dúvidas no dia de lançamento se resume a identificar o tipo de erro antes de decidir entre trocar de modelo, esperar na fila ou interromper as tentativas.
Q1: Vale a pena limitar a taxa no aplicativo antes do lançamento de um novo modelo?
Sim. Definir antecipadamente o limite de concorrência e uma fila de prioridades no aplicativo dá mais controle do que esperar um `429` do provedor. Assim, você decide quais usuários e tarefas têm prioridade, enquanto o limite do provedor não leva em conta as prioridades do seu negócio. Para definir o limite, use como referência o pico habitual multiplicado pelo fator de aumento estimado.
Q2: Ao receber um 429, devo trocar de modelo imediatamente?
Não necessariamente. Primeiro, confira o `Retry-After`. Se o tempo de espera for aceitável para a tarefa, aguarde e tente novamente. Se ultrapassar o limite ou se a resposta indicar claramente que a cota acabou, troque para o modelo alternativo. Ao usar uma única chave para chamar modelos de vários provedores pela APIYI apiyi.com, basta alterar o nome do modelo para fazer a troca. Isso permite ajustar os limites com mais precisão, sem precisar mudar tudo ao primeiro `429`.
Q3: Como organizar a fila de tarefas não urgentes?
Crie uma fila e um pool de concorrência separados para tarefas não urgentes e defina um tempo máximo de espera. Quando esse tempo for excedido, não descarte a tarefa: adie sua execução para a noite ou para um período de menor demanda. Monitore o tamanho da fila, o tempo de espera e a taxa de abandono. Tarefas que falharam podem ser executadas novamente, mas, no caso das não idempotentes, é preciso verificar o status antes.
Q4: O fallback automático pode reduzir a qualidade das respostas?
Pode. Por isso, antes de ativá-lo, compare os modelos usando as mesmas perguntas e mantenha a diferença de qualidade dentro de um nível aceitável para o negócio. A descrição oficial da APIYI apiyi.com informa que há suporte a fallback automático e balanceamento de carga, mas as regras de troca devem ser consultadas na documentação oficial. Você também precisa validar as diferenças de resultado com seu próprio conjunto de avaliação. Para tarefas sensíveis à qualidade, é melhor esperar na fila pelo modelo principal do que usar o fallback diretamente.
Q5: Como saber se a cota do produto acabou ou se a API está limitando a taxa?
Observe a origem e o critério de aplicação. A cota do produto aparece no aplicativo usado pelo usuário final, como a cota do Hy4 no WorkBuddy. Ela é calculada por conta e costuma ser indicada por uma mensagem na interface. Já o limite de taxa da API aparece na resposta da interface como `429`, possivelmente acompanhado de `Retry-After`, e é aplicado por chave, organização ou modelo. No primeiro caso, a solução é trocar de modelo no produto ou esperar a cota ser restaurada; no segundo, use espera progressiva, filas e mapeamento para modelos alternativos.
Principais pontos sobre alternância entre modelos e agendamento fora do pico
Conclusão: a estabilidade no dia do lançamento depende de uma boa preparação das camadas de modelos, das filas e do orçamento.
- A limitação de capacidade é previsível: atingir os limites no dia do lançamento de um modelo faz parte do ciclo do produto e exige planejamento antecipado.
- Os erros precisam ser classificados:
402,429,5xxe timeouts exigem tratamentos diferentes; não dá para simplesmente repetir todas as requisições. - Defina as camadas antes de alternar: distribua as tarefas entre modelos de ponta, de uso geral e leves; inicialmente, encaminhe apenas parte do tráfego ao novo modelo.
- Confira o mapeamento de modelos alternativos: verifique capacidade, contexto, chamadas de ferramentas, saída estruturada, preço e região.
- Não repita automaticamente requisições não idempotentes: após uma falha, consulte o status antes de decidir se deve reenviá-las.
- Distribua a carga fora do horário de pico: deixe tarefas que podem esperar para a noite e reserve a concorrência durante o dia para tarefas urgentes.
- Monitore por dimensão: use os logs de uso da APIYI apiyi.com para conferir o consumo real por chave e por modelo.
Resumo e checklist de capacidade para o dia do lançamento
Conclusão: no dia do lançamento, o que conta não é o número de tentativas, mas as camadas e filas preparadas com antecedência.
Quando um novo modelo atinge os limites assim que é lançado, geralmente há uma combinação de cotas gratuitas, acessos concentrados, tarefas longas e demora na expansão da capacidade do provedor. Do lado da aplicação, você pode definir o destino padrão das tarefas com camadas de modelos, preparar alternativas, proteger tarefas críticas com filas de prioridade e reduzir os picos com agendamento fora do horário de maior demanda. Monitoramento e orçamento ajudam a manter riscos e custos sob controle. O checklist abaixo reúne ações para antes e durante o dia do lançamento e pode ser usado diretamente na revisão pré-lançamento.
| Etapa | Item de verificação | Critério de conclusão |
|---|---|---|
| Antes do lançamento | Validar o principal e o alternativo | Ambos passaram pela comparação com as mesmas tarefas e pela validação de chamadas de ferramentas e saída estruturada |
| Antes do lançamento | Diferenciar códigos de erro | 402, 429, 500, 503, 529 e timeouts têm tratamentos independentes |
| Antes do lançamento | Não repetir automaticamente operações não idempotentes | Operações de escrita e chamadas de ferramentas pagas não são repetidas automaticamente; após uma falha, o status é consultado primeiro |
| Antes do lançamento | Fila de prioridade | Três níveis de prioridade, com concorrência máxima, tempo máximo de espera na fila e fallback em caso de timeout configurados |
| Antes do lançamento | Lista de tarefas fora do pico | Tarefas em lote que podem ser adiadas para a noite estão listadas e as regras de acionamento por carga estão configuradas |
| Antes do lançamento | Simulação | Testes de injeção de falhas, alternância e reversão foram concluídos e seus resultados registrados |
| Dia do lançamento | Monitoramento | Acompanhar taxas de 429 e 5xx, latência P95 e tamanho da fila por chave, modelo e tarefa |
| Dia do lançamento | Orçamento | Definir orçamento temporário e alertas, flexibilizando os limites de alerta sem remover o teto |
| Dia do lançamento | Acompanhar as alternâncias | Observar o número de alternâncias e a taxa de sucesso do retorno ao modelo principal; quando ele se recuperar, voltar conforme o plano |
| Dia do lançamento | Comunicação com as áreas de negócio | Informar antecipadamente os possíveis atrasos e o alcance das possíveis reduções de serviço |
Se você está se preparando para o próximo lançamento de modelo, vale usar a APIYI apiyi.com para testar os modelos principal e alternativo com uma única chave. Depois, use os logs de uso do console para definir o orçamento e coloque cada item deste checklist em prática.
📚 Referências
Conclusão: os materiais abaixo ajudam a verificar as formas de integração com os modelos e os recursos da plataforma. Para parâmetros específicos, consulte a versão mais recente da documentação oficial.
- Central de documentação da APIYI: lista de modelos, descrição das interfaces e consulta de uso e faturamento
- Link:
docs.apiyi.com -
Descrição: consulte os modelos disponíveis, o uso da interface compatível com a OpenAI e as informações sobre fallback automático
-
Códigos de erro da API da OpenAI: significado e recomendações para lidar com erros de limite de taxa, como
429 - Link:
platform.openai.com/docs/guides/error-codes -
Descrição: entenda a diferença entre limite de taxa e esgotamento da cota
-
Erros da API da Anthropic: inclui orientações para lidar com erros de sobrecarga
- Link:
docs.anthropic.com/en/api/errors - Descrição: entenda o significado do erro de sobrecarga
529
Autor: Equipe técnica da APIYI
Contato técnico: entre em contato conosco pela página inicial do site da APIYI. Para mais materiais sobre integração, acesse a central de documentação em docs.apiyi.com