Nota do autor: com base em um teste real do Apple Intelligence para a China continental no iOS 27.3, este artigo destrincha a lógica de divisão de trabalho entre modelos no dispositivo e Modelos de Linguagem Grandes na nuvem, além de apresentar um framework de decisão em 5 dimensões pronto para usar e etapas de implementação no produto.
Com a distribuição da versão beta para desenvolvedores do iOS 27.3, o Apple Intelligence para a China continental finalmente abriu os testes. A base é sustentada por modelos próprios da Apple e pelo Qwen, da Alibaba: remoção de elementos em fotos, retoque básico e tradução em tempo real rodam no dispositivo; tarefas longas da Siri e o “Perguntar” da Inteligência Visual ficam a cargo do Qwen na nuvem. Essa chegada à China continental é, portanto, um exemplo bem concreto de divisão de trabalho entre dispositivo e nuvem.
Não é mais um resumo de experiência com funcionalidades, mas sim um exercício de usar esse exemplo para destrinchar a lógica de design por trás da divisão entre dispositivo e nuvem: quais tarefas de IA fazem sentido no dispositivo, quais precisam ir para um Modelo de Linguagem Grande na nuvem e como desenvolvedores devem traçar essa linha nos próprios produtos.
Valor central: ao terminar a leitura, você terá em mãos um framework de decisão em 5 dimensões para a divisão entre dispositivo e nuvem, e conseguirá aplicar, em 4 etapas, uma arquitetura híbrida de “fallback no dispositivo + aprimoramento na nuvem” no seu aplicativo.
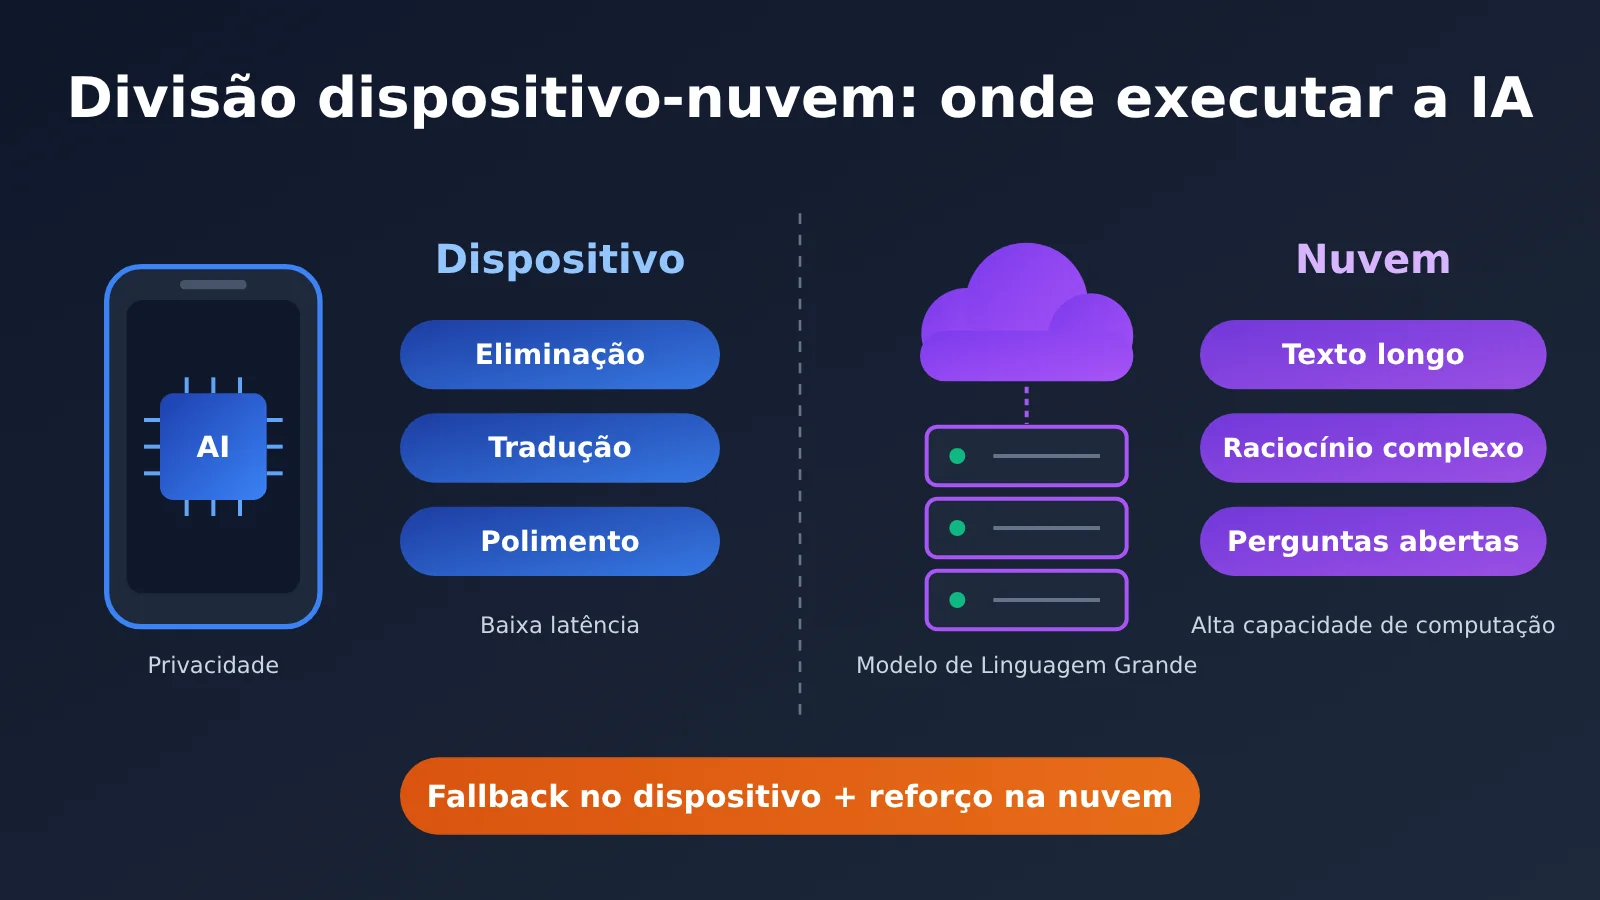
Pontos-chave da divisão entre dispositivo e nuvem do Apple Intelligence na versão chinesa
Primeiro, vamos reunir em uma tabela a divisão de tarefas que os testes reais conseguem confirmar. As colunas “Local de execução” e “Desempenho nos testes” vêm de testes públicos, e dá para perceber que a divisão da Apple não é aleatória — ela segue uma lógica bem clara.
| Função | Local de execução | Origem do modelo | Desempenho nos testes |
|---|---|---|---|
| Limpeza de fotos | No dispositivo | Modelo próprio da Apple para dispositivo | Fundos simples ficam limpos; texturas complexas tendem a deixar blocos de baixa resolução |
| Tradução em tempo real | No dispositivo | Modelo da Apple para dispositivo, requer download de pacotes de idioma (cerca de 2 GB cada) | Fala do dia a dia com latência inferior a 1 segundo e boa precisão |
| Ferramentas de escrita (polimento básico) | Principalmente no dispositivo | Modelo próprio da Apple | Chamada em nível de sistema é prática, mas a reescrita em chinês fica um pouco rígida |
| Resumo de notificações / busca em linguagem natural no álbum de fotos | No dispositivo | Modelo próprio da Apple, requer criação de índice local | Logo após a atualização, é preciso esperar um ou dois dias para o índice ficar pronto |
| Tarefas complexas da Siri | Na nuvem | Qwen (Alibaba), requer autorização do usuário e login na conta Qwen | Resultado em cerca de 7 a 8 segundos, conteúdo um tanto resumido |
| Inteligência visual “Perguntar” / “Buscar” | Na nuvem | “Perguntar” conecta ao Qwen; “Buscar” usa por padrão o modelo visual da Baidu, podendo integrar Apps de terceiros | Após a adaptação, Apps de terceiros podem aparecer na lista de serviços de busca |
Divisão de tarefas entre dispositivo e nuvem em detalhes: por que remoção em fotos e tradução ficam no dispositivo
A remoção em fotos e a tradução em tempo real têm três pontos em comum: a entrada é composta por dados privados do usuário (fotos, voz da chamada), são extremamente sensíveis à latência e têm limites de tarefa bem definidos. As informações de rosto e localização nas fotos não saem do dispositivo, o que minimiza o risco de privacidade; já a tradução precisa acontecer enquanto a conversa flui, e qualquer ida e volta pela rede quebra o ritmo do diálogo. A latência de menos de 1 segundo no dispositivo é justamente o que garante a experiência.
O custo também é evidente. O tamanho do modelo no dispositivo é limitado pela capacidade de processamento e pelo armazenamento do celular, então a remoção falha diante de texturas complexas, como grandes áreas de grama e seixos. Além disso, cada pacote de idioma para tradução ocupa cerca de 2 GB. O pacote de atualização do sistema chega a 12 GB; no fundo, é pagar aluguel pelos modelos no dispositivo.
Divisão de tarefas entre dispositivo e nuvem em detalhes: por que as tarefas longas da Siri vão para a nuvem
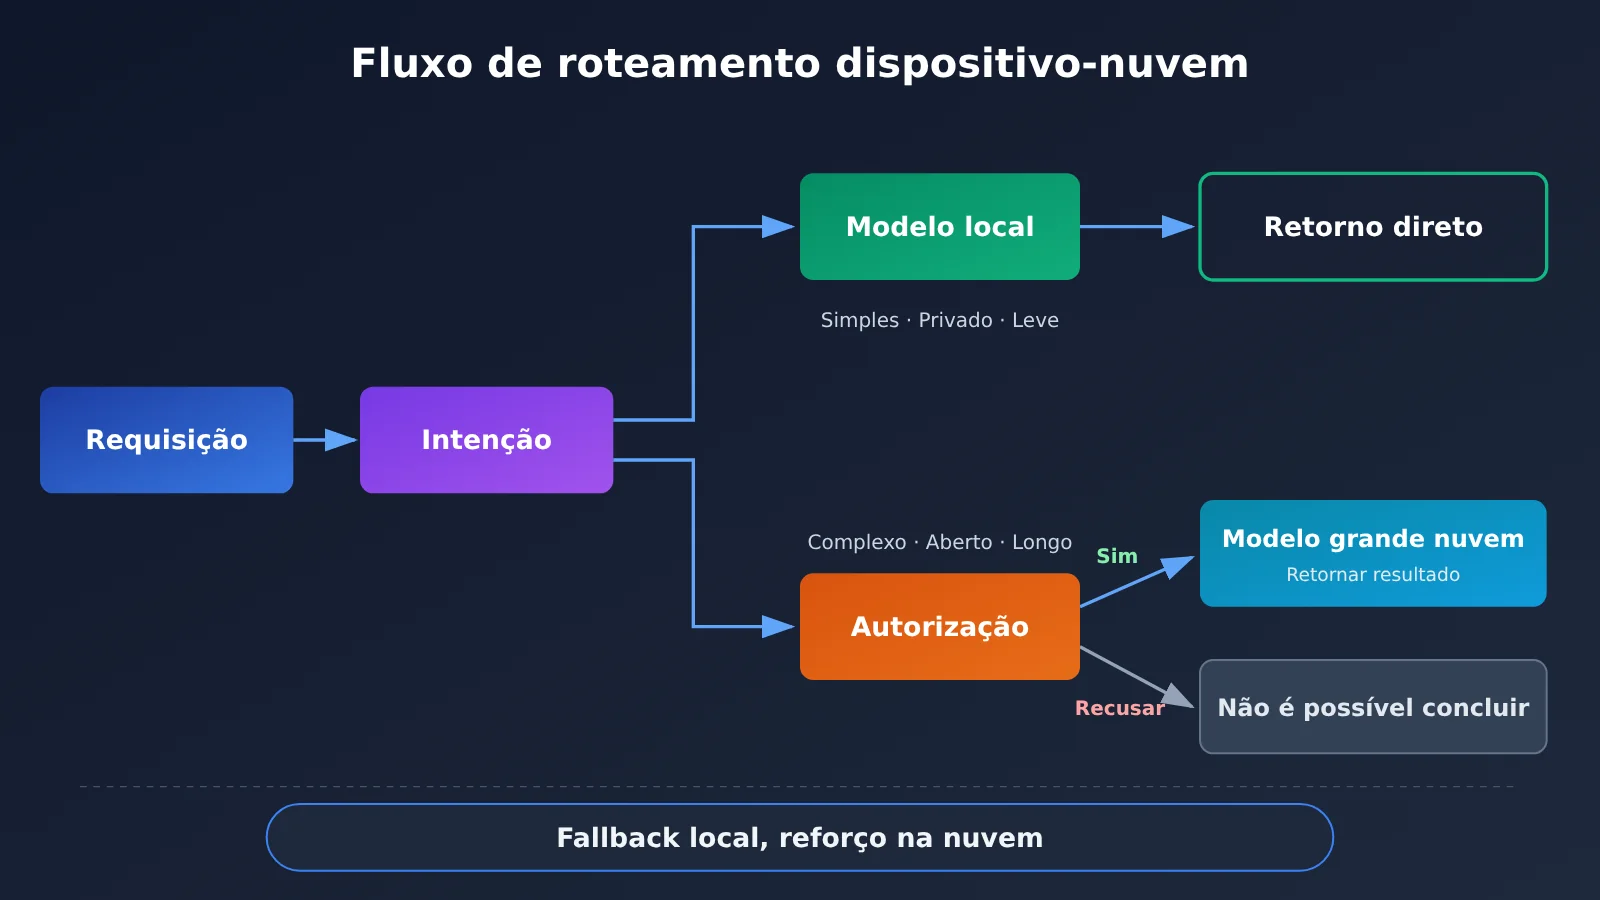
Pedidos como “me ajude a montar um roteiro de quatro dias em Jiuzhaigou” exigem muito conhecimento de mundo, geração de textos longos e planejamento em várias etapas; um modelo pequeno no dispositivo não dá conta. A abordagem da Apple é: quando a Siri identifica uma pergunta além da própria capacidade, abre um pop-up perguntando se o usuário autoriza chamar o Qwen; se o usuário recusar, ela simplesmente desiste de responder.
Esse pop-up é um ótimo exemplo para desenvolvedores. Ele deixa explícito para o usuário que “os dados vão sair do dispositivo” e devolve a decisão sobre privacidade. Ao mesmo tempo, os testes práticos também mostram que a qualidade do resultado na nuvem depende do contexto e do design do comando que o sistema fornece ao modelo. O roteiro da Siri é claramente inferior ao que se obtém perguntando diretamente no app Qwen, o que mostra que “conectar um Modelo de Linguagem Grande” não é o mesmo que “usá-lo bem”.
Estrutura para decidir entre dispositivo e nuvem: 5 dimensões que definem onde a tarefa deve rodar
A partir da divisão de trabalho do Apple Intelligence na versão chinesa, dá para abstrair 5 dimensões de avaliação. Na hora de montar um projeto, você pode pontuar cada tarefa nessas 5 dimensões: a maioria dos pontos indicando um lado, é ali que a tarefa fica.
| Dimensão de avaliação | Características que puxam para o dispositivo | Características que puxam para a nuvem | Exemplo no Apple Intelligence |
|---|---|---|---|
| Sensibilidade dos dados | Fotos, contatos, histórico de conversas e outros dados privados | Conhecimento público, perguntas enviadas ativamente pelo usuário | Remoção de objetos fica no dispositivo; perguntas e respostas de dicas vão para a nuvem |
| Exigência de latência | Precisa responder em menos de 1 segundo; se interromper, já era | Pode aceitar alguns segundos de espera | Tradução no dispositivo; tarefas longas do Siri levam cerca de 7 a 8 segundos |
| Complexidade da tarefa | Fronteiras claras, saída curta | Perguntas abertas, planejamento em várias etapas, geração de textos longos | Revisão básica no dispositivo; perguntas complexas vão para o Qwen |
| Atualidade do conhecimento | Não depende de informações externas recentes | Precisa de conhecimento de mundo ou busca em tempo real | A “busca” da inteligência visual conecta Baidu e terceiros |
| Disponibilidade offline | Precisa funcionar com rede fraca ou sem rede | Cenário padrão é online | Tradução em tempo real roda localmente depois de baixar o pacote de idiomas |
Erros comuns na divisão entre dispositivo e nuvem
Muitas equipes, ao definir essa divisão, acabam caindo em algumas armadilhas que vale a pena evitar desde o início:
- Erro 1: colocar tudo no dispositivo só porque dá. Modelos no dispositivo têm limite de capacidade. Forçar tarefas complexas ali só gera resultados de baixa qualidade, como uma remoção de objetos que sai errada, e isso prejudica a experiência.
- Erro 2: achar que basta conectar à nuvem. O exemplo das dicas do Siri mostra que o comando de sistema, a organização do contexto e o controle do tamanho da saída também determinam a qualidade.
- Erro 3: ignorar autorização e degradação. Chamadas à nuvem precisam prever caminhos de degradação para quando o usuário nega autorização ou a rede falha. A funcionalidade não pode simplesmente “desaparecer”.
- Erro 4: calcular o custo uma vez só. No dispositivo, o custo é pontual: armazenamento e tamanho do pacote. Na nuvem, é contínuo: cobrança por volume de chamadas. Os dois precisam ser calculados separadamente.
Divisão dispositivo-nuvem na prática: 4 passos para implementar no seu aplicativo
A seguir, transformamos o framework de decisão em etapas executáveis. Mesmo que você não esteja desenvolvendo um sistema operacional de celular, mas um aplicativo comum, um mini programa ou uma ferramenta desktop, essa abordagem também funciona.
Passo 1: faça um inventário das tarefas e etiquete-as conforme a divisão dispositivo-nuvem
Liste todos os recursos do produto que você planeja integrar com IA e avalie cada um usando as 5 dimensões da seção anterior. Recomenda-se gerar uma lista de tarefas com pelo menos as colunas “nome da tarefa, sensibilidade dos dados, requisito de latência, complexidade e local de execução”, para que a revisão fique bem clara.
Passo 2: escolha soluções leves para tarefas no dispositivo
Para tarefas no dispositivo, priorize recursos nativos do sistema ou modelos leves, como APIs de tradução, OCR e reconhecimento de voz fornecidas pelo sistema, ou modelos pequenos quantizados. O foco deve ser controlar o tamanho do modelo e a experiência do primeiro download. Siga a abordagem da Apple: baixe recursos grandes sob demanda e mostre um aviso claro no primeiro uso.
Passo 3: conecte APIs de Modelos de Linguagem Grande para tarefas na nuvem
Tarefas na nuvem exigem Modelos de Linguagem Grande suficientemente poderosos. Se você quiser usar a série Qwen como no Apple Intelligence da versão chinesa, ou comparar GPT, Claude e outros modelos ao mesmo tempo, pode chamar tudo de forma unificada via APIYI. A APIYI oferece chamadas para as principais APIs de Modelos de Linguagem Grande abordadas neste artigo e é compatível com os formatos de interface da OpenAI e da Anthropic. Em geral, para migrar código existente, basta substituir o endereço da API e a chave. Os modelos disponíveis estão listados na página de preços.
As principais configurações a observar na integração estão na tabela abaixo. Para o endereço da API, siga o que está documentado em docs.apiyi.com da APIYI:
| Item de configuração | Função | Recomendação para cenários de divisão dispositivo-nuvem |
|---|---|---|
| Endereço da API (base_url) | Define o servidor para onde a requisição é enviada | Preencha conforme a documentação da APIYI em docs.apiyi.com; os formatos OpenAI e Anthropic têm cada um seu próprio endereço, conforme a documentação |
| API Key | Autenticação e cobrança | Mantenha apenas no servidor; não inclua no pacote de instalação do cliente |
| model | Define o modelo a ser chamado | Para tarefas complexas de planejamento, escolha modelos com forte raciocínio; para reescritas simples, modelos leves |
| max_tokens | Controla o comprimento da saída | Para tarefas como guias e relatórios, aumente um pouco o limite para evitar respostas excessivamente resumidas no estilo Siri |
| stream | Define se a saída será em streaming | Para tarefas longas na nuvem, recomendamos ativar para compensar a latência percebida de alguns segundos de espera |
| Timeout e retentativas | Tratamento de falhas de rede | Defina timeouts razoáveis; em caso de falha, recorra a um resultado simplificado no dispositivo ou exiba uma mensagem clara |
Passo 4: projete o pop-up de autorização e os caminhos de fallback
Seguindo o exemplo do pop-up de confirmação que o Siri mostra antes de chamar o Qwen, qualquer recurso que envie dados do usuário para a nuvem deve explicar, na primeira chamada, “quais conteúdos serão enviados e para quem”. Se o usuário recusar, não desista de imediato como o Siri; volte para os recursos no dispositivo e ofereça um resultado simplificado, ou peça ao usuário para complementar as informações manualmente.
🚀 Comece rápido: sugerimos escolher primeiro a tarefa na nuvem de maior complexidade para validar em um protótipo. Após se cadastrar na APIYI (apiyi.com), você recebe créditos de teste. Use o mesmo formato compatível com OpenAI para alternar entre modelos, compare qual entrega a melhor qualidade de saída no seu cenário e só então defina a solução final.
Comparação de abordagens de divisão dispositivo-nuvem: apenas no dispositivo, apenas na nuvem e colaboração dispositivo-nuvem
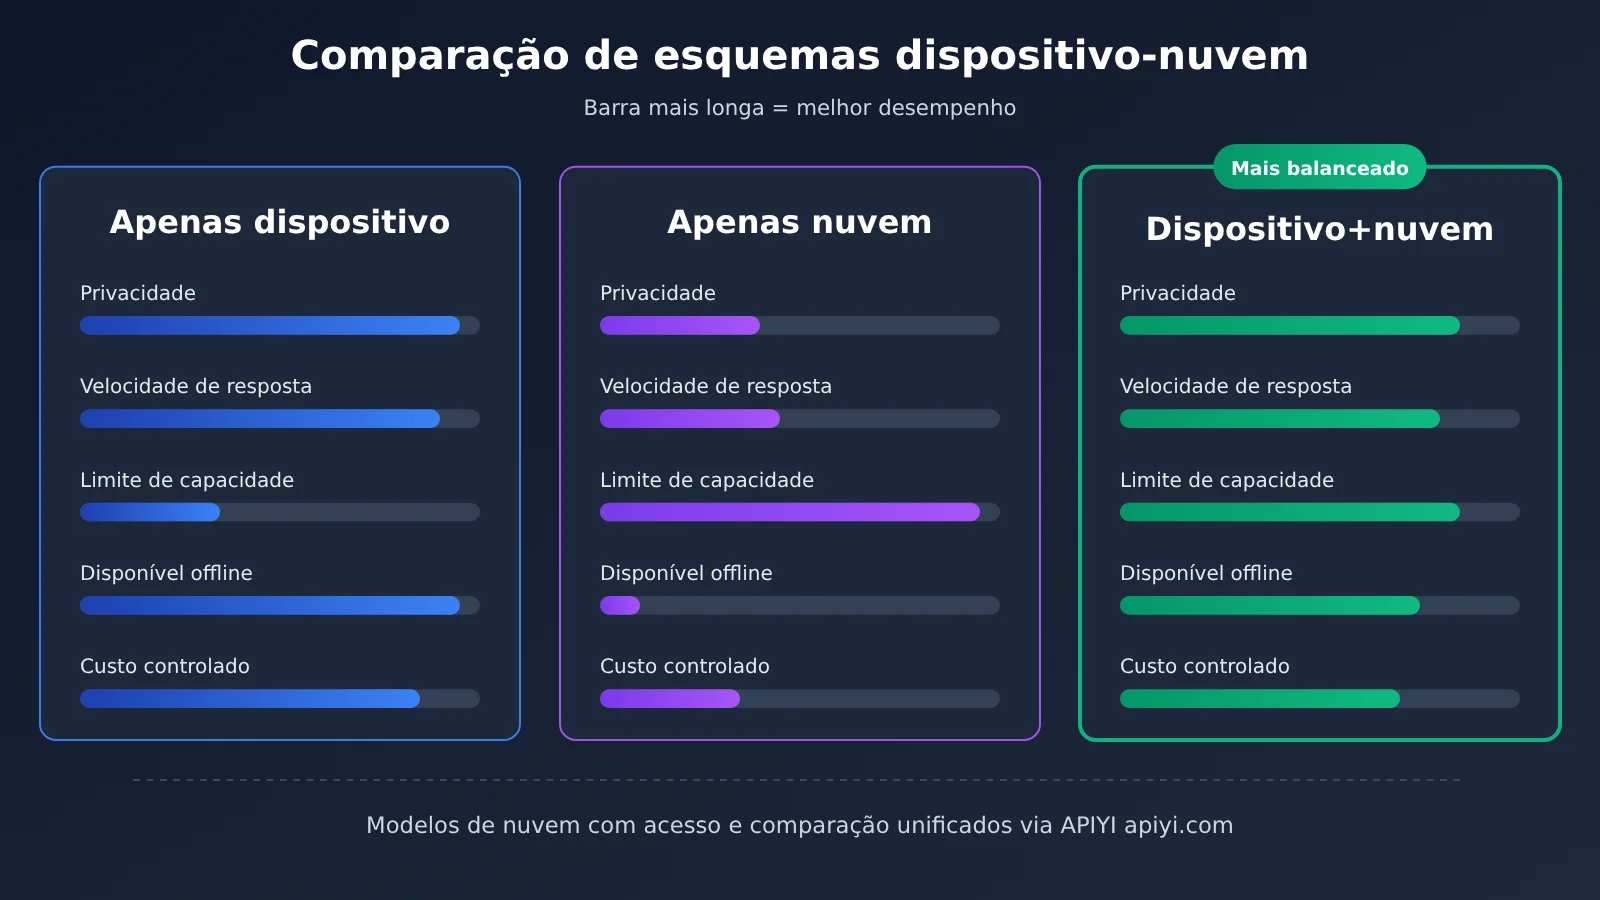
| Abordagem | Características principais | Cenários de uso | Principais limitações | Plataformas disponíveis para modelos em nuvem |
|---|---|---|---|---|
| Apenas no dispositivo | Dados não saem do dispositivo, funciona offline | Tradução, remoção de objetos, reconhecimento de voz e outras tarefas com escopo bem definido | Capacidade máxima baixa, grande pressão sobre o tamanho do aplicativo e o armazenamento | Não se aplica |
| Apenas na nuvem | Capacidade máxima alta, iteração rápida | Perguntas e respostas abertas, textos longos, planejamento em várias etapas | Depende da rede, gera preocupações de privacidade e custo contínuo de chamadas | APIYI apiyi.com, APIs oficiais de cada modelo |
| Colaboração dispositivo-nuvem | Dispositivo como fallback, nuvem para potencializar, roteamento por tarefa | A grande maioria dos produtos de IA voltados ao consumidor | Arquitetura complexa, exige projetar roteamento, autorização e degradação | APIYI apiyi.com, APIs oficiais de cada modelo |
Análise comparativa das abordagens de divisão dispositivo-nuvem
Análise comparativa: apenas no dispositivo: a abordagem apenas no dispositivo continua líder em privacidade e velocidade de resposta — a latência de menos de 1 segundo na tradução em tempo real é a melhor prova disso. Mas os modelos no dispositivo sofrem com limitações de poder computacional e armazenamento, e a qualidade cai visivelmente em tarefas como remoção de texturas complexas e reescrita complexa em chinês. Em comparação, a colaboração dispositivo-nuvem consegue transferir esses desafios para a nuvem, elevando a capacidade máxima sem abrir mão da privacidade.
Análise comparativa: apenas na nuvem: a abordagem apenas na nuvem se destaca pela amplitude de conhecimento e capacidade de geração; depois que a Siri integrou o Qwen, finalmente conseguiu responder a perguntas sobre roteiros e dicas práticas. Porém, cada chamada depende da rede e da autorização do usuário, e o recurso simplesmente deixa de funcionar se o usuário recusar a permissão ou estiver com rede fraca. Para funcionalidades essenciais que precisam estar “disponíveis a qualquer momento”, a colaboração dispositivo-nuvem continua sendo a escolha mais segura.
💡 Recomendação de escolha: a escolha da abordagem depende da composição das suas tarefas. Se a parte em nuvem precisar escolher entre modelos como Qwen, GPT e Claude, você pode usar a APIYI apiyi.com para fazer testes comparativos com as mesmas perguntas por meio de uma interface unificada, decidindo com base na qualidade real das saídas, e não em parâmetros de marketing.
A conta de custos da divisão dispositivo-nuvem: no dispositivo é gasto único, na nuvem é cobrança por uso
O custo é o item mais subestimado quando se fala em divisão dispositivo-nuvem. Do lado do dispositivo, o custo aparece principalmente no tamanho do pacote do app, no espaço ocupado no armazenamento do usuário e na experiência do primeiro download. O pacote de atualização de 12 GB da Apple desta vez e os pacotes de idioma de cerca de 2 GB cada são a tradução mais concreta desse custo. Já o custo na nuvem é a despesa contínua de invocação por uso: quanto mais ativo o usuário, maior a conta.
A própria Apple faz essa conta. Na teleconferência de resultados financeiros, a diretoria da Apple mencionou que, no futuro, recursos como o Siri AI e o retoque inteligente avançado de fotos — que dependem de Modelos de Linguagem Grande na nuvem — terão uma cota básica de uso, e usuários intensivos precisarão pagar por cotas adicionais. Em outras palavras, “cota básica gratuita + cobrança para uso intenso” provavelmente se tornará o modelo de negócio dominante dos recursos de IA na nuvem. Quem desenvolve produtos pode se inspirar nessa lógica.
Falando especificamente do custo de invocação de modelos na nuvem, os critérios variam muito entre modelos quanto ao preço unitário de entrada, ao preço unitário de saída e à forma de cobrança de cache, além de mudarem a qualquer momento. Este artigo não traz nenhum número de preço específico: todos os preços de modelos, critérios de cobrança, preços unitários de entrada e saída e preços de cache devem ser conferidos nos dados reais da página de preços da APIYI em https://docs.apiyi.com/models.
💰 Otimização de custos: ao calcular o custo na nuvem, o ideal é estimar com a lógica de “média de tokens de entrada por tarefa × preço unitário de entrada + média de tokens de saída × preço unitário de saída”, sempre pegando os preços unitários da página de preços da APIYI em docs.apiyi.com/models. Para prompts de sistema repetidos com alta frequência, vale verificar se a página de preços indica cobrança de cache, o que reduz ainda mais o custo contínuo.
Perguntas frequentes (FAQ)
P1: O que é a divisão de tarefas entre dispositivo e nuvem?
A divisão entre dispositivo e nuvem consiste em separar as tarefas de IA conforme suas características: uma parte é processada por um modelo local no próprio aparelho e a outra é enviada para um Modelo de Linguagem Grande na nuvem. O Apple Intelligence na versão chinesa é um caso típico: apagar objetos e tradução rodam no dispositivo, enquanto tarefas complexas da Siri e o “perguntar” da inteligência visual vão para o Qwen na nuvem.
P2: Qual é a diferença central entre um modelo no dispositivo e um Modelo de Linguagem Grande na nuvem?
Os modelos no dispositivo mantêm vantagem em privacidade, latência e funcionamento offline, mas seu teto de capacidade é limitado por poder de processamento e armazenamento. Já os Modelos de Linguagem Grande na nuvem têm conhecimento amplo e forte capacidade de geração, porém dependem de rede, exigem autorização do usuário e geram custo contínuo de invocação. Não é uma relação de substituição, e sim de complementaridade.
P3: Quando o Apple Intelligence na versão chinesa poderá ser usado oficialmente?
O Apple Intelligence na versão chinesa abriu testes com a versão de desenvolvedor do iOS 27.3, acessível em atualização de software após login no app Apple Developer. A primeira versão do firmware de teste tem bugs e, segundo relatos públicos, a versão final deve sair em dezembro — para o aparelho principal, é melhor esperar a versão final para atualizar.
P4: Quais tarefas de IA são mais adequadas para rodar no dispositivo?
Principalmente os seguintes cenários:
– **Processamento de dados privados**: apagar objetos em fotos, busca em linguagem natural na galeria, resumo de notificações
– **Interação com latência ultrabaixa**: tradução de voz em tempo real, sugestões do teclado
– **Funcionalidades essenciais offline**: tradução, reconhecimento de voz e revisão básica de texto em redes fracas
P5: Como chamar rapidamente modelos na nuvem como o Qwen via API?
A recomendação é testar por meio de uma plataforma de agregação multimodelo:
1. Acesse APIYI apiyi.com, registre uma conta e obtenha uma chave API
2. No central de documentação docs.apiyi.com, consulte as instruções de integração no formato compatível com OpenAI ou com Anthropic
3. Na página de preços docs.apiyi.com/models, confirme os modelos disponíveis e os critérios de cobrança; basta substituir o endereço do endpoint e a chave para fazer a invocação
Assim, você pode comparar o desempenho do Qwen com outros modelos mainstream usando a mesma interface.
P6: E se o usuário recusar a autorização durante a chamada à nuvem?
A abordagem da Siri é simplesmente desistir de responder, o que deixa a experiência um pouco rígida. Uma solução melhor é projetar um caminho de degradação: voltar ao dispositivo para dar um resultado simplificado, ou orientar o usuário a complementar informações e tentar de novo — sempre respeitando a escolha dele, sem bombardear com pop-ups repetidos.
P7: Quais são as limitações conhecidas da divisão de tarefas entre dispositivo e nuvem?
De forma objetiva, são principalmente três:
– **Complexidade da arquitetura**: é preciso manter roteamento de intenções, fluxo de autorização e lógica de degradação
– **Consistência da experiência**: o estilo de saída do dispositivo e da nuvem é diferente, e o usuário pode sentir uma quebra
– **Fronteiras do ecossistema**: como os testes práticos apontaram, a IA do sistema não entra em apps de terceiros como WeChat e Meituan, o contexto pessoal continua fragmentado, e a divisão entre dispositivo e nuvem não resolve o problema das ilhas de dados
Pontos-chave da divisão de trabalho entre dispositivo e nuvem
- A essência da divisão: tarefas privadas, de baixa latência e com limites bem definidos ficam no dispositivo; tarefas complexas, abertas e com textos longos vão para a nuvem
- Exemplo da versão para a China: o modelo próprio da Apple cuida da limpeza de fotos e da tradução; o Qwen, da Alibaba, assume as tarefas longas da Siri e as perguntas visuais
- Estrutura de avaliação: pontue cada tarefa em cinco dimensões — sensibilidade dos dados, latência, complexidade, atualidade e disponibilidade offline
- Consentimento é obrigatório: obtenha o consentimento explícito do usuário antes de qualquer dado sair do dispositivo e prepare um caminho de degradação para o caso de recusa
- Qualidade é o ponto crítico: conectar o Modelo de Linguagem Grande é só o começo; comando, contexto e tamanho da saída é que definem a experiência final
- Como começar: modelos na nuvem podem ser acessados de forma unificada via APIYI apiyi.com, com compatibilidade aos formatos OpenAI e Anthropic
Conclusão
A chegada do Apple Intelligence na versão para a China nos deu uma referência bem clara de como dividir o trabalho entre dispositivo e nuvem:
- O dispositivo preserva privacidade e velocidade: tarefas como limpeza de fotos, tradução e resumo de notificações ficam no aparelho — o preço é o tamanho do pacote e o armazenamento
- A nuvem eleva o teto de capacidade: perguntas complexas e consultas visuais vão para o Qwen — o preço é latência, consentimento e custo contínuo
- A colaboração é a regra: dispositivo como base, nuvem como reforço, junto com pop-ups de consentimento e caminhos de degradação — esse é o formato de produto que dá para colocar no ar
Para quem desenvolve, o caminho mais pragmático é primeiro classificar as tarefas com a estrutura de avaliação e depois escolher uma tarefa de nuvem para validar em um protótipo. A recomendação é usar a APIYI apiyi.com para comparar, com uma interface unificada, o desempenho real de diferentes Modelos de Linguagem Grande. Preços e critérios de cobrança dos modelos devem ser consultados na página de preços docs.apiyi.com/models.
📚 Referências
- 爱范儿: teste prático do AI do iPhone versão China: teste prático da primeira versão de teste para desenvolvedores do Apple Intelligence versão China
- Link:
ifanr.com/1687733 -
Descrição: Fonte dos fatos deste artigo, incluindo a divisão de funções entre processamento no dispositivo e na nuvem, além do desempenho nos testes práticos
-
Central de Documentação da APIYI: instruções de integração com formatos compatíveis com OpenAI e Anthropic
- Link:
docs.apiyi.com -
Descrição: O endereço da interface, o método de autenticação e os parâmetros de chamada têm como base este documento
-
Página de preços de modelos da APIYI: lista de modelos disponíveis e critérios de cobrança
- Link:
docs.apiyi.com/models - Descrição: O preço unitário de entrada e saída, o preço de cache e outras informações de cobrança têm como base os dados reais desta página
Autor: Equipe Técnica da APIYI
Contato técnico: Fique à vontade para nos contatar na página inicial da APIYI, em apiyi.com. Mais materiais de integração podem ser encontrados no centro de documentação docs.apiyi.com