Nota do autor: Para o mesmo Gemini 4 Neon, o anúncio da API Gemini e a documentação do modelo Antigravity informam janelas de contexto diferentes. Este artigo separa os dois números por entrada e apresenta a ordem de verificação antes de registrar o número da janela em um plano de Agente.
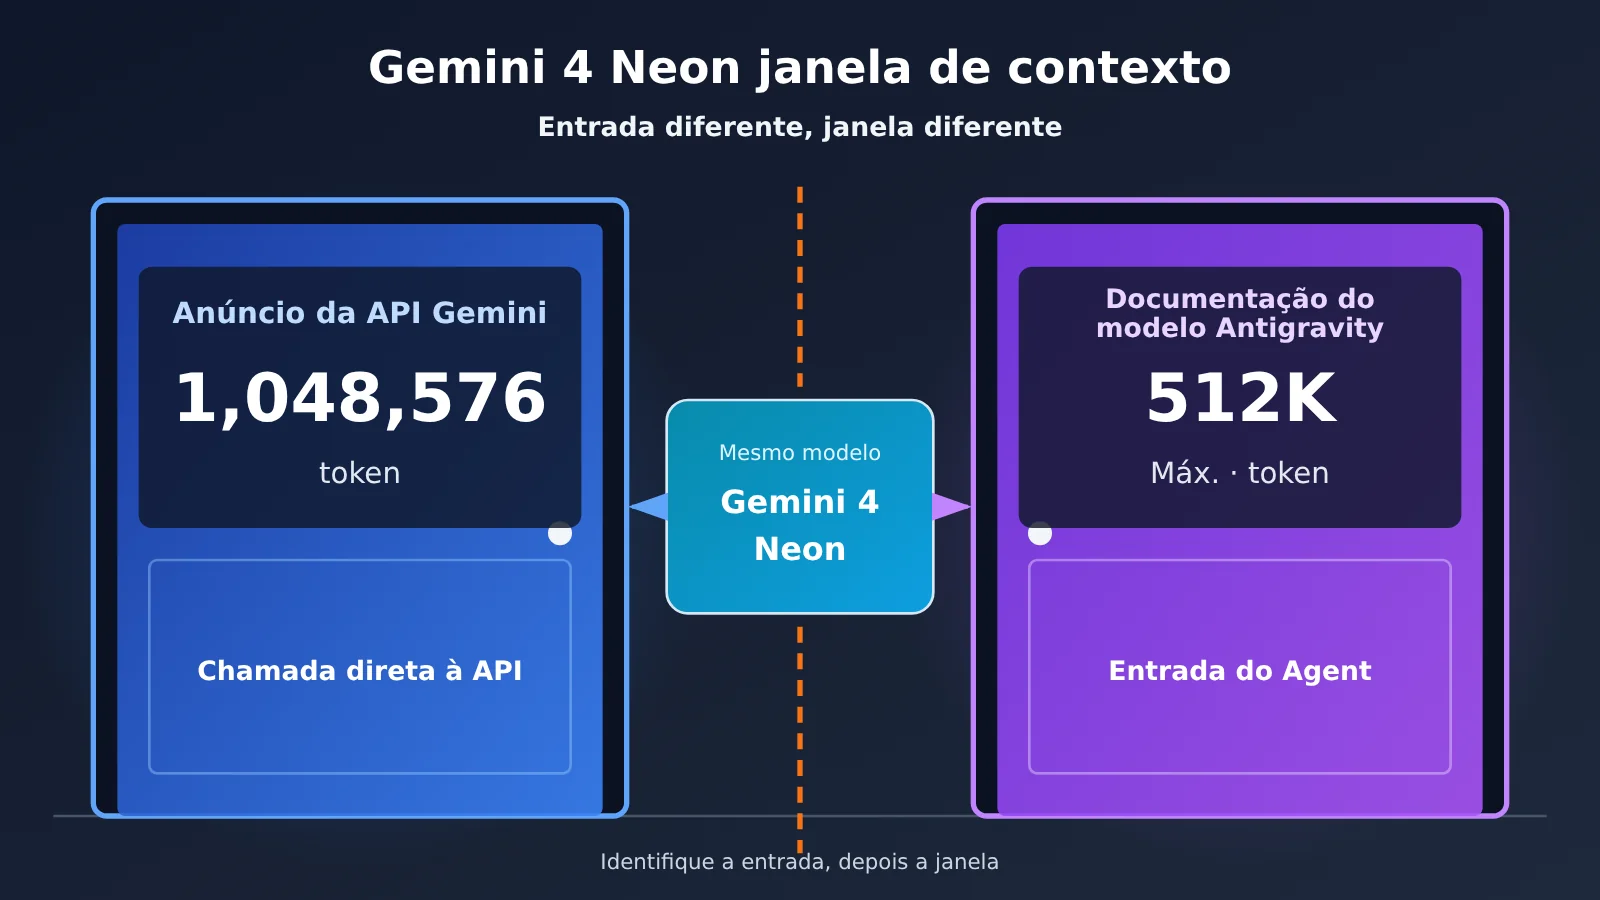
Equipes que trabalham com Agentes muitas vezes copiam a janela de contexto da página promocional direto para o plano, por exemplo: “O Neon suporta 1M, então dá para colocar o repositório inteiro de código de uma vez”. Nesta geração do Gemini 4 Neon, esse tipo de redação costuma dar problema. O anúncio da API Gemini informa 1,048,576 token, enquanto a documentação do modelo Antigravity informa até 512K token, e os dois números vêm do Google, publicados na mesma semana, sem que as duas páginas façam referência uma à outra.
Não é que uma das partes tenha errado. Elas descrevem duas interfaces de chamada diferentes: uma é a API que invoca o modelo diretamente, a outra é a entrada do Agente no Antigravity. Qual número usar no plano depende de qual entrada sua requisição realmente utiliza.
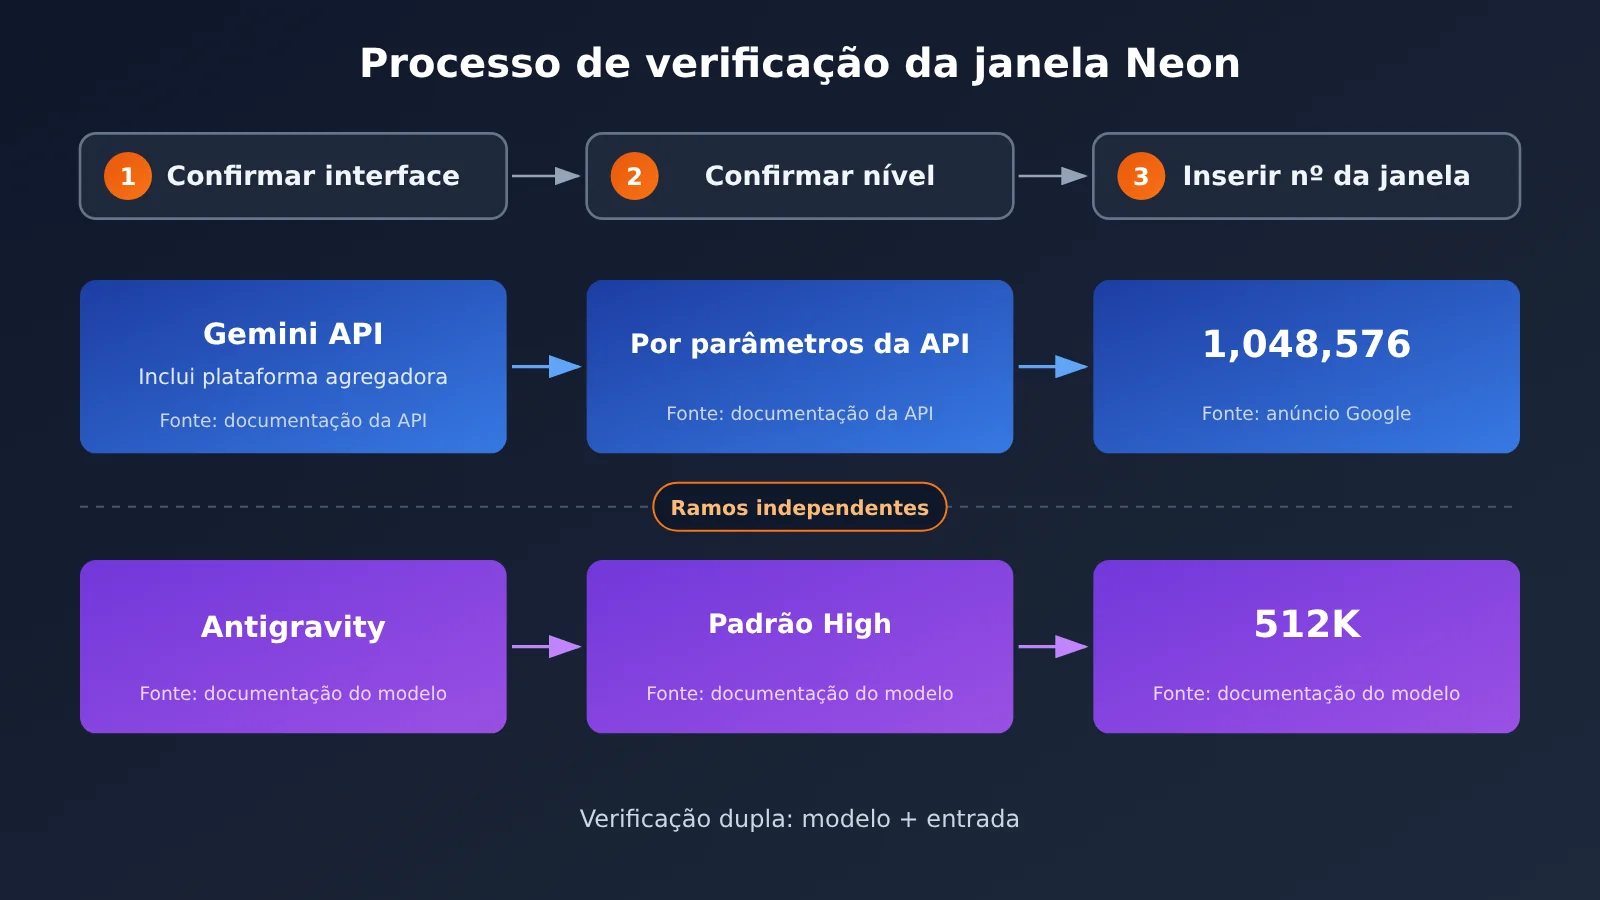
O ponto central: depois de ler este artigo, você saberá a origem de cada um dos dois números de janela do Gemini 4 Neon e também terá em mãos a ordem de verificação “primeiro identifique a entrada, depois veja o nível de raciocínio e, por fim, escreva a janela”. Seguindo essa ordem, você não vai planejar com 1M uma entrada que só oferece 512K.
Pontos essenciais da janela de contexto do Gemini 4 Neon
Vamos começar reunindo numa tabela os fatos que dá para confirmar nas referências. Os números da tabela são o texto original de cada documento, não estimativas nem resultados de teste.
| Ponto | Texto original do documento | O que significa para o projeto |
|---|---|---|
| Janela da Gemini API | Comunicado do Google de 2026-11-18: contexto unificado do Neon com 1,048,576 tokens |
Limite de planejamento ao chamar a API diretamente |
| Janela no Antigravity | Documentação de modelos do Antigravity: contexto do Gemini 4 Neon de até 512K tokens |
Limite de planejamento ao rodar agentes dentro do Antigravity |
| Nível de raciocínio | A documentação do Antigravity lista Low, Medium, High (padrão) e Extra | O padrão já é High, então confirme isso antes de estimar |
| Relação entre os dois documentos | Publicados na mesma semana, mas as páginas não se referenciam entre si | Não dá para usar o número de um lado para deduzir o outro |
| Preço da API | Entrada $3, entrada em cache $0.15, saída $15 (por milhão de tokens) |
Para estimar custo, tome como base o valor cobrado na API |
Por que os dois números do Gemini 4 Neon estão certos
1M e 512K vêm ambos do Google oficial, só estão escritos em páginas diferentes. O comunicado da Gemini API fala do contexto unificado do modelo na API, e o texto original diz 1,048,576 tokens. A documentação de modelos do Antigravity fala do contexto do Neon dentro do produto Antigravity, e o texto original diz “até 512K tokens”. As duas páginas descrevem duas superfícies distintas, cada uma válida por si só, então não há contradição entre elas.
O OrcaRouter apontou essa diferença num artigo de 2026-11-19. O artigo também menciona que o usuário @kimmonismus publicou, em 18 de novembro, um registro de chamada de ferramentas. Trata-se de um post de terceiros, não de uma explicação do Google sobre a janela, portanto não serve como especificação da janela. Na hora de escrever o projeto, só aceite os números de janela que vêm das próprias páginas de documentação do Google, e deixe claro de qual página se trata.
Não misture a janela do Gemini 4 Neon com a de outros modelos da linha
Outra armadilha fácil de pisar é pegar números emprestados de outro modelo. A página do Gemini 4 Carbon também traz 1,048,576 como contexto, mas essa é a janela do Carbon na API e não pode ser aplicada ao Neon dentro do Antigravity. Da mesma forma, a janela de API do Neon não pode ser jogada direto no Neon do Antigravity. O número precisa bater nos dois eixos ao mesmo tempo, modelo e ponto de entrada, e se faltar um deles a verificação não está completa.
Gemini 4 Neon: comparação entre os dois pontos de entrada
A tabela abaixo separa os dois pontos de entrada. A coluna “Recomendação de planejamento” traz sugestões práticas de como montar o plano, não especificações da documentação.
| Dimensão | Gemini API (incluindo a interface agregada compatível com OpenAI) | Antigravity |
|---|---|---|
| Janela declarada | 1,048,576 tokens (comunicado do Google) |
até 512K tokens (documentação do modelo) |
| Fonte | Gemini API / comunicado do Google de 18/11/2026 | antigravity.google/docs/models |
| Nível de raciocínio | Conforme os parâmetros da documentação da API | Low, Medium, High (padrão), Extra |
| Cobrança | Por token, com preço para entrada em cache | Conforme as regras do produto Antigravity |
| Recomendação de planejamento | Dá para dimensionar requisições únicas pensando em contexto longo, mas ainda assim deixe margem | Dimensione com base em 512K; tarefas longas exigem segmentação e compressão |
Análise comparativa do ponto de entrada da API: ao chamar a API direto, a janela é maior, o que cai bem para colocar de uma vez um lote grande de documentos, logs longos ou um bloco inteiro de código para análise. Só que janela grande não quer dizer que você deva encher tudo toda vez: quanto mais longa a entrada, maiores o custo e a latência. Em compensação, tratar a API como um ponto de entrada de “ler o material longo de uma vez só”, junto com o preço de entrada em cache, funciona melhor para processamento em lote offline e para análises de trechos grandes depois de uma etapa de recuperação.
Análise comparativa do ponto de entrada Antigravity: o Antigravity é voltado para fluxos de trabalho de agentes, e a documentação informa uma janela de até 512K. O agente vai acumulando histórico ao longo de várias rodadas de chamadas de ferramentas, então o espaço realmente disponível se esgota mais rápido do que numa requisição única. Para equipes que rodam tarefas longas no Antigravity, é mais seguro projetar com base em 512K, com estratégias de segmentação, sumarização e descarte de contexto — não faça a estimativa pensando em 1M.
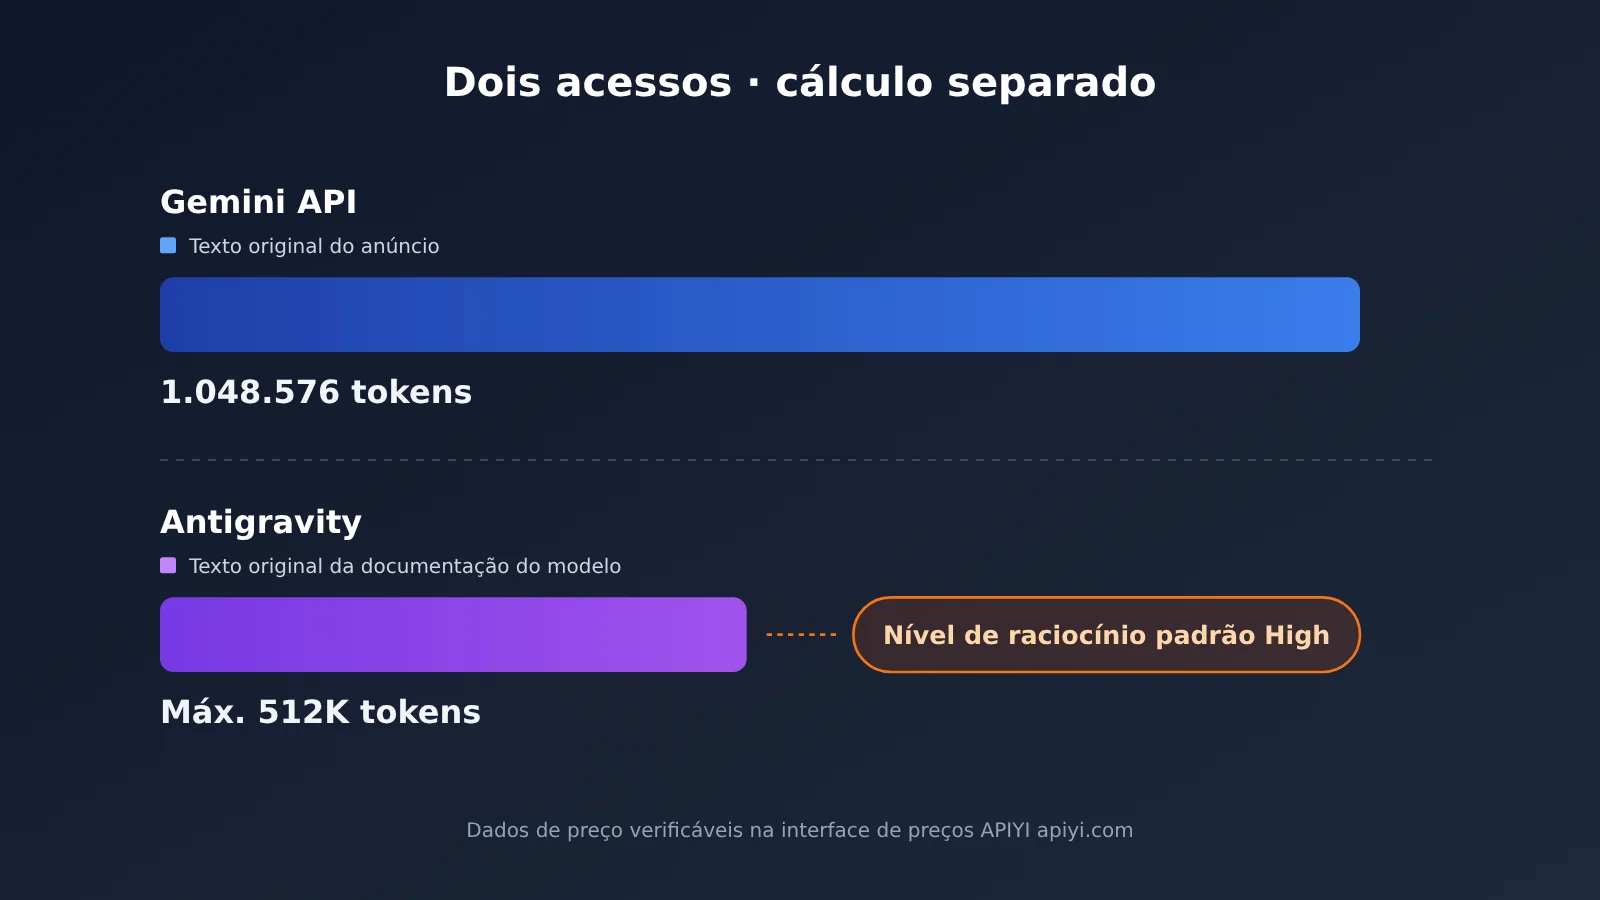
Níveis de raciocínio do Gemini 4 Neon no Antigravity
A documentação do Antigravity lista quatro níveis de raciocínio, com High como padrão. Muita gente não repara no valor padrão e sai orçando direto pelo limite máximo da janela. A tabela abaixo organiza as recomendações por nível: os nomes dos níveis e o valor padrão vêm da documentação, e a parte de recomendação é prática geral.
| Nível de raciocínio | Marcação na documentação | Recomendação de planejamento |
|---|---|---|
| Low | Opcional | Bom para cadeias curtas e chamadas de ferramentas com alta previsibilidade |
| Medium | Opcional | Bom para codificação rotineira e recuperação em várias etapas |
| High | Padrão | Sem mexer na configuração, é este nível; faça o orçamento por ele |
| Extra | Opcional | Para problemas difíceis, reserve mais margem e mais tempo de espera |
O nível de raciocínio afeta o custo de inferência e o tempo de resposta; como isso entra no contexto e na cobrança, siga a documentação do Antigravity. Na verificação, confirme primeiro qual nível a equipe realmente usa — especialmente o High, que é o padrão — e só depois decida quanto espaço sobra a cada rodada para histórico e material recuperado.
Gemini 4 Neon: Guia Rápido
Primeiro passo: descubra qual superfície você está usando
Antes de tudo, responda a uma pergunta: de onde a requisição realmente sai? Se você dispara chamadas via SDK dentro do código, você está na superfície da API, e a janela deve ser dimensionada considerando 1,048,576. Já se você coloca o Agent para trabalhar dentro do Antigravity, você está na superfície do Antigravity, e a janela deve ser dimensionada com no máximo 512K. Se o mesmo projeto usar as duas abordagens, o documento de arquitetura precisa ter duas seções separadas — não saia por aí somando tudo em um número só.
Segunda etapa: fazer uma requisição pela interface compatível com OpenAI
Ao usar a superfície da API, você pode chamar o Neon pela interface compatível com OpenAI do APIYI — o ID do modelo é gemini-4-neon. Uma chamada mínima exige apenas três ajustes:
- Crie o cliente:
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Especifique o modelo:
model="gemini-4-neon" - Envie a mensagem:
client.chat.completions.create(model="gemini-4-neon", messages=[{"role": "user", "content": "总结这份日志"}])
Depois que a requisição retorna, basta ler response.usage.prompt_tokens e response.usage.completion_tokens para saber o consumo real dessa chamada. Na hora de planejar a janela, use esse valor de retorno como referência — não fique estimando por contagem de palavras.
Ver a abordagem completa de chamadas segmentadas
Quando o material longo passa do orçamento único que você definiu para si mesmo, dá para segmentar seguindo esta lógica:
1. Inicialização: `client = OpenAI(api_key=”YOUR_API_KEY”, base_url=”https://api.apiyi.com/v1″)`
2. Defina o orçamento: na superfície da API é possível definir `budget = 1048576 * 0.7`; se a mesma lógica também precisar ser reutilizada no lado do Antigravity, ajuste para setenta por cento de 512K
3. Divida o material: separe o documento em `chunks` por capítulos ou arquivos e rode cada bloco uma vez com `usage.prompt_tokens` para registrar o comprimento real
4. Resuma por segmento: para cada chunk, chame `model=”gemini-4-neon”` pedindo um resumo em formato fixo
5. Combine e raciocine: junte todos os resumos em novas `messages` e faça uma síntese ou uma tomada de decisão
6. Registre o uso: a cada rodada, grave `prompt_tokens` e `completion_tokens` no log, para conferir o custo depois
Os setenta por cento do orçamento são só uma prática empírica para deixar margem — não é algo previsto na documentação, então dá para ajustar conforme a tarefa.
🚀 Início rápido: antes de montar o plano, você pode se cadastrar no APIYI apiyi.com, resgatar a cota gratuita de teste, rodar um material real com
gemini-4-neone, só depois de obter o retorno deusage, definir o orçamento da janela.
Etapa 3: Verificar o modelo e o preço
A verificação de preços tem dois pontos de entrada: a tabela geral de modelos da APIYI em https://docs.apiyi.com/models.md e a interface de preços em https://api.apiyi.com/api/pricing. Na verificação feita em 2026-11-20, a última atualização da tabela geral era de 2026-11-19 10:59 (UTC+8), e essa versão ainda não incluía o gemini-4-neon; já a interface de preços (versão shell-api-modelmak-v1) trazia esse modelo. Na hora de consultar o preço do Neon, use a interface de preços como referência.
Na interface de preços, model_ratio igual a 1 corresponde a uma entrada de $2/milhão de tokens. O gemini-4-neon tem model_ratio de 1.5, completion_ratio de 5 e cache_ratio de 0.05; após a conversão, isso dá entrada de $3, saída de $15 e leitura de cache de $0.15, batendo com o preço de tabela do Google.
| Modelo | Entrada ($/milhão de tokens) | Leitura de cache | Saída | Observações |
|---|---|---|---|---|
gemini-4-neon |
3 |
0.15 |
15 |
Igual ao preço de tabela do Google; vale a interface de preços |
gemini-4-carbon |
2 |
0.1 |
10 |
Corresponde ao preço de lançamento do Google até 2026-11-30 |
gemini-4-hydrogen |
1.5 |
0.075 |
7.5 |
Interface de preços |
gemini-4-argon |
2 |
0.1 |
10 |
Tabela geral de modelos |
| Plataformas disponíveis | APIYI, API oficial do Google | — | — | Endereço de invocação https://api.apiyi.com/v1 |
Tem um detalhe importante no Carbon: o preço padrão do Google a partir de 1º de dezembro é entrada de $4 e saída de $20, e o preço de lançamento vale só até 2026-11-30. Orçamentos de custo que atravessam a virada do mês precisam ser calculados em dois trechos.
💡 Sugestão de escolha: para uma mesma tarefa, você pode rodar primeiro o
gemini-4-neone ogemini-4-hydrogene comparar os resultados e ousage. A APIYI oferece uma interface unificada compatível com OpenAI, então trocar de modelo é só alterar o parâmetromodel.
Como incluir o orçamento de contexto do Gemini 4 Neon no plano
Depois de confirmar o ponto de entrada e o nível de raciocínio, dá para colocar os números da janela no plano. A seguir, algumas ideias de planejamento para tarefas comuns de Agent. A coluna “estratégia sugerida” da tabela é prática de engenharia, não especificação de documentação.
| Tipo de tarefa | Entrada | Limite de planejamento (texto original da documentação) | Estratégia sugerida |
|---|---|---|---|
| Análise de código do repositório inteiro | API | 1,048,576 tokens |
Primeiro recuperar os arquivos relevantes, depois enviar o bloco completo, mantendo margem |
| Troubleshooting de logs longos | API | 1,048,576 tokens |
Dividir por janelas de tempo; prefixos repetidos vão para entrada em cache |
| Refatoração multi-turno na IDE | Antigravity | máximo 512K tokens |
Resumir o histórico periodicamente e descartar saídas antigas de ferramentas |
| Tarefas longas de Agent com múltiplas ferramentas | Antigravity | máximo 512K tokens |
Dividir em subtarefas e gravar memória estruturada ao final de cada trecho |
| Reutilizar o mesmo fluxo entre entradas | ambos | adotar 512K como limite comum |
Projetar com a janela menor; também roda direto no lado da API |
A última linha é a que mais passa despercebida. Se a mesma lógica de Agent precisa rodar tanto no Antigravity quanto via API, a abordagem mais segura é projetar o fluxo comum com 512K. Assim ele também roda direto na API, só não usa a janela inteira. Por outro lado, se você projetar com 1M, ao chegar no Antigravity vai precisar reescrever a lógica de segmentação.
Na hora de escrever os números da janela no plano, recomendo o formato “número + fonte + entrada”, por exemplo: “Documentação do modelo Antigravity: Gemini 4 Neon máximo 512K tokens, nível de raciocínio padrão High”. Na revisão, dá para ver de cara a qual superfície esse número corresponde, e quando a documentação for atualizada também fica fácil conferir item por item.
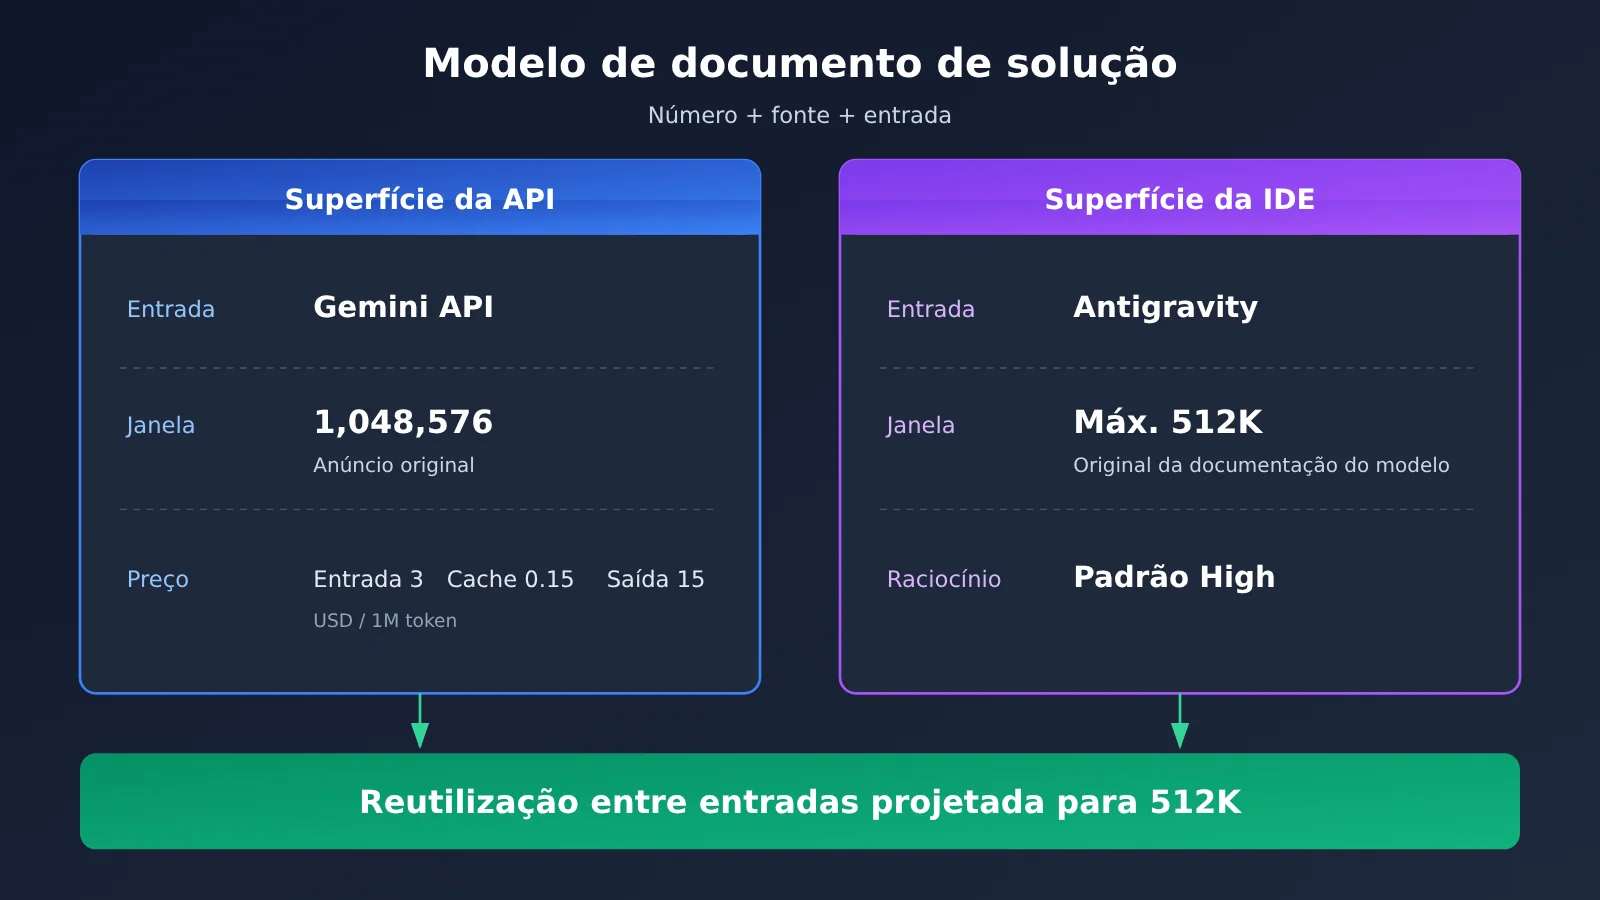
Perguntas frequentes (FAQ)
P1: Qual é o tamanho real da janela de contexto do Gemini 4 Neon?
Depende do ponto de acesso. O anúncio da Gemini API / Google de 2026-11-18 diz janela de contexto unificada de `1,048,576` token; a documentação de modelos do Antigravity diz até `512K` token. Ambos são textos oficiais do Google, cada um corresponde a uma superfície de invocação diferente.
P2: O 1M da API e o 512K do Antigravity entram em conflito?
Não entram. Os dois documentos descrevem superfícies de produtos diferentes, publicados na mesma semana, sem referência cruzada entre as páginas. O conflito só aparece no planejamento: usar o número da API para planejar tarefas dentro do Antigravity vai dar problema.
P3: Dá para usar como base da janela os registros de chamada de ferramentas que alguém postou na internet?
Não. Um artigo do OrcaRouter de 2026-11-19 menciona que o registro de chamada de ferramentas postado por @kimmonismus em 18 de novembro é um post de terceiros, não uma declaração de janela do Google. Os números de janela só citam o anúncio e as páginas de documentação do Google.
P4: O Carbon também tem 1,048,576, dá para aplicar ao Neon do Antigravity?
Não. O `1,048,576` na página de modelo do Carbon é a janela da API do Carbon. Modelo diferente, ponto de acesso diferente, as duas dimensões não batem, e o Neon no Antigravity continua sendo planejado pelo máximo de 512K da sua documentação de modelo.
P5: Como invocar o Gemini 4 Neon rapidamente via API?
1. Registre-se em APIYI apiyi.com e obtenha a chave API e a cota gratuita de teste
2. Defina o `base_url` do SDK como `https://api.apiyi.com/v1`
3. Preencha o modelo como `gemini-4-neon` e leia o campo `usage` para conferir o consumo real
Assim você usa a superfície da API, com a janela planejada conforme os `1,048,576` token do anúncio do Google.
P6: Não encontro o gemini-4-neon na tabela geral de modelos, onde consulto o preço oficial?
Use a interface de preços como referência. A versão de 2026-11-19 da tabela geral ainda não inclui esse modelo, mas a interface de preços já tem: o resultado convertido é `$3` de entrada, `$0.15` de leitura de cache e `$15` de saída, em linha com o preço divulgado pelo Google. Para conferir, basta consultar a interface de preços do APIYI apiyi.com.
P7: O nível de raciocínio padrão do Antigravity afeta o planejamento?
Afeta. A documentação deixa claro que o nível padrão é High; sem alterar a configuração, ele roda nesse nível. O nível de raciocínio afeta o custo de inferência e o tempo de resposta; o orçamento precisa ser estimado com base no nível realmente usado, e a forma exata de contabilização segue a documentação do Antigravity.
P8: Quais são as limitações que precisam de atenção no Gemini 4 Neon?
– A janela varia conforme o ponto de acesso; não existe um número universal
– Entradas longas elevam custo e latência; mesmo com janela grande, não precisa preencher tudo toda vez
– A documentação pode mudar; os números no planejamento devem indicar a fonte e a data de verificação
Gemini 4 Neon: Principais conclusões
- Os dois números constam nos textos oficiais: no comunicado da API,
1,048,576tokens; na documentação do Antigravity, no máximo 512K tokens - Identifique o ponto de entrada antes de escrever o número: cite a documentação correspondente ao ponto de entrada de onde a requisição é enviada
- O nível de raciocínio padrão é High: no Antigravity, sem alterar as configurações, ele já vem como High; faça a estimativa de orçamento com base nisso
- Posts de terceiros não valem como especificação: registros de chamadas de ferramentas não substituem as especificações da janela do Google
- Janelas de modelos não são intercambiáveis: a janela da API do Carbon não pode ser aplicada ao Neon do Antigravity
- Reutilização entre pontos de entrada usa a janela menor: para fluxos que precisam rodar nos dois lados, projete sempre com 512K
- Confirme o preço no endpoint de precificação: chame
gemini-4-neonvia APIYI e use o campousagepara calibrar o orçamento
Resumo
Pontos centrais do planejamento de contexto do Gemini 4 Neon:
- O ponto de entrada determina a janela: no ponto de entrada da API,
1,048,576tokens; no ponto de entrada do Antigravity, no máximo 512K tokens — indique a fonte de cada um - A ordem de verificação é fixa: confirme primeiro o ponto de entrada, depois o valor padrão do nível de raciocínio e, só então, inclua o número da janela no plano
- Calibre com o uso real: baseie-se no
usageretornado; combine segmentação, resumos e entrada em cache para controlar custos
Ao montar um plano de agente, trate “número + fonte + ponto de entrada” como um todo. Assim, você evita planejar com 1M para um ponto de entrada que entrega apenas 512K. Recomendamos rodar um caso real com gemini-4-neon via APIYI apiyi.com, obter os dados de uso e só então finalizar o documento. A plataforma oferece cota gratuita e uma interface unificada para múltiplos modelos.
📚 Referências
-
Gemini API / Comunicado do Google (2026-11-18): Contexto unificado e preços da API do Gemini 4 Neon
- Descrição: fonte original da janela de
1,048,576tokens e dos preços de entrada, entrada em cache e saída
- Descrição: fonte original da janela de
-
Documentação do modelo Antigravity: Contexto e níveis de pensamento do Gemini 4 Neon no Antigravity
- Link:
antigravity.google/docs/models - Descrição: fonte do máximo de 512K tokens e dos níveis de pensamento Low, Medium, High (padrão) e Extra
- Link:
-
Artigo do OrcaRouter (2026-11-19): Aponta a diferença entre os números de janela dos dois documentos
- Descrição: também deixa claro que registros de invocação de ferramentas de terceiros não podem ser usados como explicação da janela
-
Tabela geral de modelos e interface de preços da APIYI: Ponto de verificação de modelos e preços
- Descrição: veja os dois endereços na seção “Terceiro passo: verificar modelo e preço” acima; para
gemini-4-neon, vale a interface de preços
- Descrição: veja os dois endereços na seção “Terceiro passo: verificar modelo e preço” acima; para
Autor: Equipe técnica da APIYI
Contato técnico: Fique à vontade para falar com a gente pela página inicial do site APIYI; mais materiais estão disponíveis no centro de documentação docs.apiyi.com