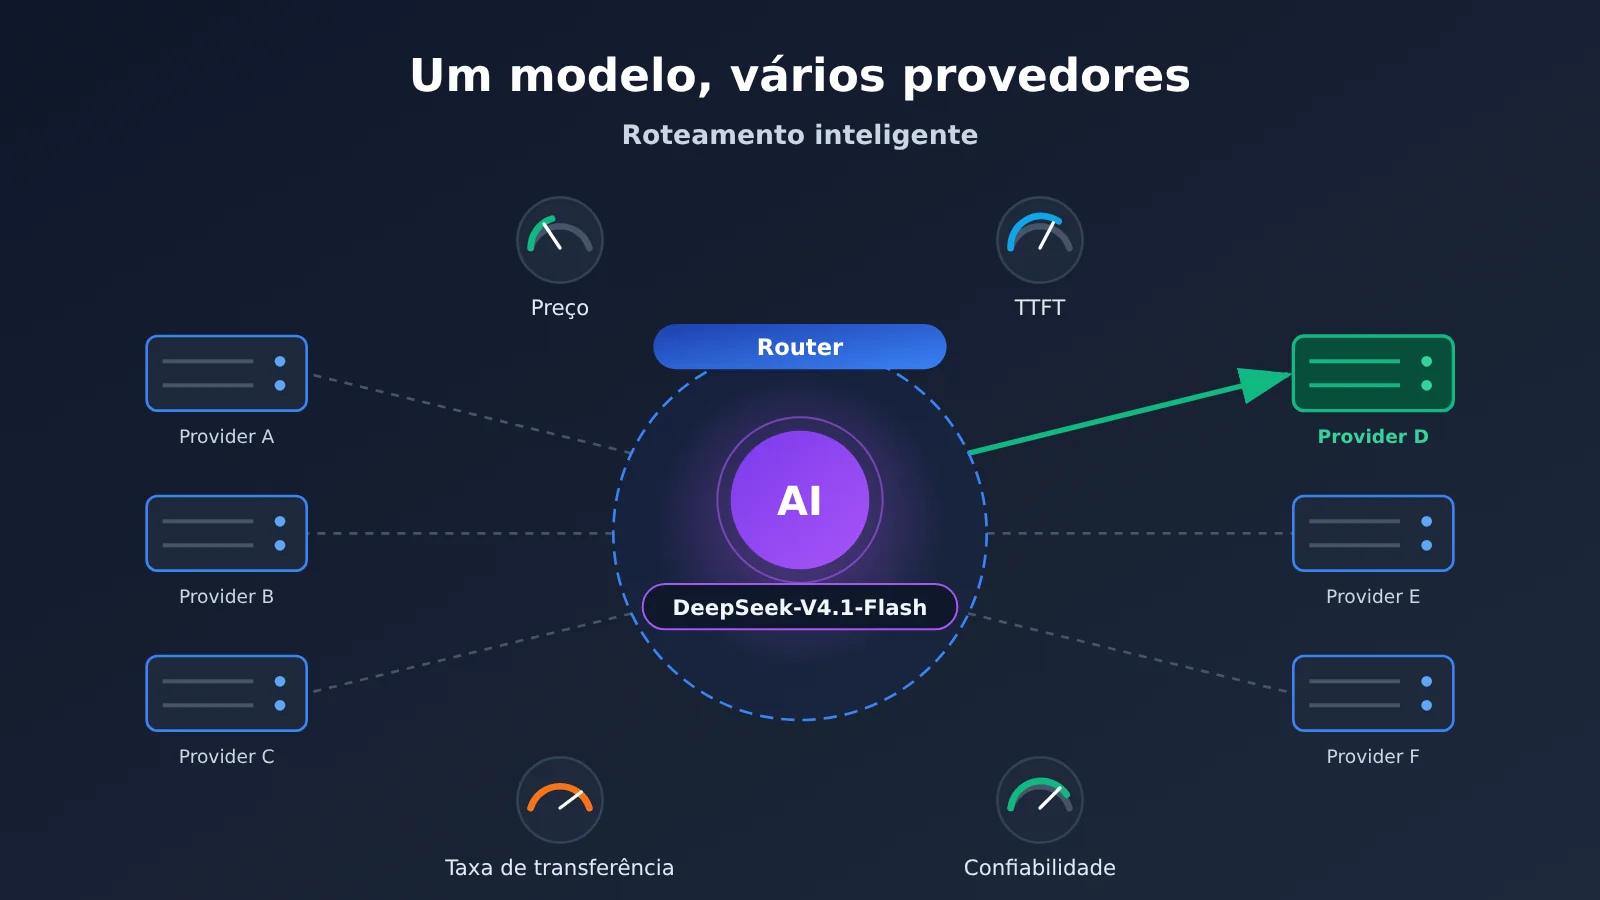
Resposta direta: O mesmo modelo de pesos abertos pode ser implantado por muitos provedores de inferência diferentes, por isso surgem dezenas de provedores de API. O OpenRouter não escolhe simplesmente quem tem o preço de tabela mais baixo; ele seleciona o provedor pelo custo combinado de uma resposta utilizável. Ele avalia ao mesmo tempo 6 indicadores — preço efetivo real, latência do primeiro token, throughput, limites de taxa, confiabilidade e qualidade da resposta — e então entrega a requisição ao Provider mais adequado no momento; em caso de falha, tenta outro provedor novamente.
Isso mostra que a competição na agregação de APIs de IA já passou de “oferecer uma interface unificada” para “roteamento dinâmico entre provedores”. Em 16 de novembro de 2026, o Hugging Face anunciou que delegaria ao OpenRouter o roteamento de modelos de linguagem do Inference Providers. Essa parceria oferece um exemplo concreto para entender como esses indicadores se transformam em um mecanismo automático de escolha de provedores.
O que você vai aprender ao ler este artigo?
- Por que o mesmo modelo de IA pode ter vários provedores de API e qual é a diferença entre quem desenvolve o modelo e quem oferece inferência
- Quais indicadores de decisão o roteamento de Provider usa e qual problema cada um resolve
- O que o failover consegue fazer e quais são seus limites
- Como usar os metadados da API de catálogo de modelos do Hugging Face para comparar provedores por conta própria
Índice: A seção de fatos objetivos segue esta ordem: primeiro, explica de onde vêm os vários provedores de API; depois, detalha o que o roteamento inteligente decide e quais são os 6 indicadores; em seguida, aborda o fluxo e as limitações do failover; por fim, mostra como desenvolvedores podem comparar Providers por conta própria usando a interface de catálogo. Ao longo do texto, serão intercalados dados de experimentos de roteamento e mudanças na cobrança divulgados pelo OpenRouter. A seção de análise e opinião discute para onde vai a competição entre plataformas de agregação de API e como desenvolvedores devem escolher e validar soluções em seus aplicativos.
Conceitos-chave para entender vários provedores de API e o roteamento de Providers
| Conceito | Explicação resumida |
|---|---|
| Provider | Provedor que implanta modelos e de fato oferece o serviço de inferência, como Together AI e Novita |
| Router | Camada de roteamento que decide para onde enviar a requisição com base nas condições da requisição e no estado dos provedores disponíveis |
| Modelo de pesos abertos | Modelo que publica os pesos após o treinamento e pode ser implantado por conta própria de acordo com sua licença |
| TTFT | Time to First Token, o tempo de espera entre o envio da requisição e o retorno do primeiro token |
| Vazão (throughput) | Quantidade de tokens gerados por unidade de tempo, geralmente medida em tok/s |
| Failover | Troca automática para outro provedor e nova tentativa quando o provedor atual falha |
| Cache de prompt | O provedor armazena em cache entradas repetidas para reduzir custo computacional e tempo de resposta |
| BYOK | Bring Your Own Key: usar sua própria chave do provedor e consumir a cota da conta correspondente |
| P50 / P95 | Quantis estatísticos; P50 é a mediana e P95 reflete os 5% de requisições mais lentas |
Visão rápida dos impactos das mudanças no roteamento entre vários provedores de API
- Desenvolvedores: Em princípio, o código e o Token do lado do Hugging Face não precisam ser alterados, mas o provedor efetivo será decidido pelo roteamento, e o mesmo ID de modelo pode ser direcionado a Providers diferentes em requisições distintas. Aplicações que dependem de chamadas de ferramentas e saídas estruturadas precisam passar por novos testes de regressão. Desenvolvedores que antes configuravam no Hugging Face uma chave de Provider para modelos de linguagem próprios não podem mais seguir esse caminho e precisam confirmar novamente a chave e a quem a cobrança será atribuída.
- Compras corporativas e equipes de plataforma: Os critérios de homologação de fornecedores, as estratégias de recuperação de desastres e as condições de processamento de dados precisam ser reavaliados. A organização pode desativar Providers específicos, mas isso não equivale a obter garantias completas de residência de dados ou conformidade; ainda é preciso verificar individualmente as políticas de dados de cada provedor.
O mesmo modelo de IA em vários provedores de API: fatos objetivos
Por que um mesmo modelo pode ter vários provedores de API
Desenvolvedor do modelo e provedor de inferência são dois papéis distintos. O desenvolvedor treina o modelo e publica os pesos. Para modelos de pesos abertos, qualquer instituição com capacidade computacional e que cumpra os requisitos da licença pode implantar os pesos em seu próprio cluster de GPU e oferecer uma API. Por isso, modelos como DeepSeek, Qwen e GLM costumam rodar simultaneamente em várias infraestruturas de inferência.
Usando deepseek-ai/DeepSeek-V4.1-Flash como exemplo, o desenvolvedor solicita o mesmo nome de modelo, mas a inferência de fato pode ser executada pela Together AI, Novita ou outro provedor compatível. Cada um usa hardware, escala de cluster, agendamento e estratégia de preços diferentes; por isso, o preço, a velocidade e a capacidade do mesmo modelo também variam. Alguns cobram menos, mas sofrem limitação de taxa em horários de pico; outros retornam o primeiro token mais rápido; outros suportam contexto mais longo; e outros têm suporte mais completo ao formato de chamadas de ferramentas.
Dados de escala mostram o quanto esse mercado é fragmentado. A OpenRouter informou em comunicado de parceria que sua plataforma, como um todo, suporta mais de 600 modelos, conecta-se a mais de 80 provedores, processa mais de 800 trilhões de tokens por mês e atende mais de 10 milhões de usuários. Esses são dados de toda a plataforma OpenRouter, não o volume trazido especificamente por essa parceria. A página de provedores do Hugging Face também lista mais de dez provedores, como Baseten, Cerebras, DeepInfra, Fireworks, Nebius, Novita e Together AI, mas os provedores disponíveis variam conforme o modelo.
Um modelo corresponde a vários provedores, e as condições de cada um mudam em tempo real. “Para quem entregar esta requisição” passa a ser uma decisão contínua, e é daí que surge o roteamento entre múltiplos provedores.
O que o roteamento inteligente decide, afinal
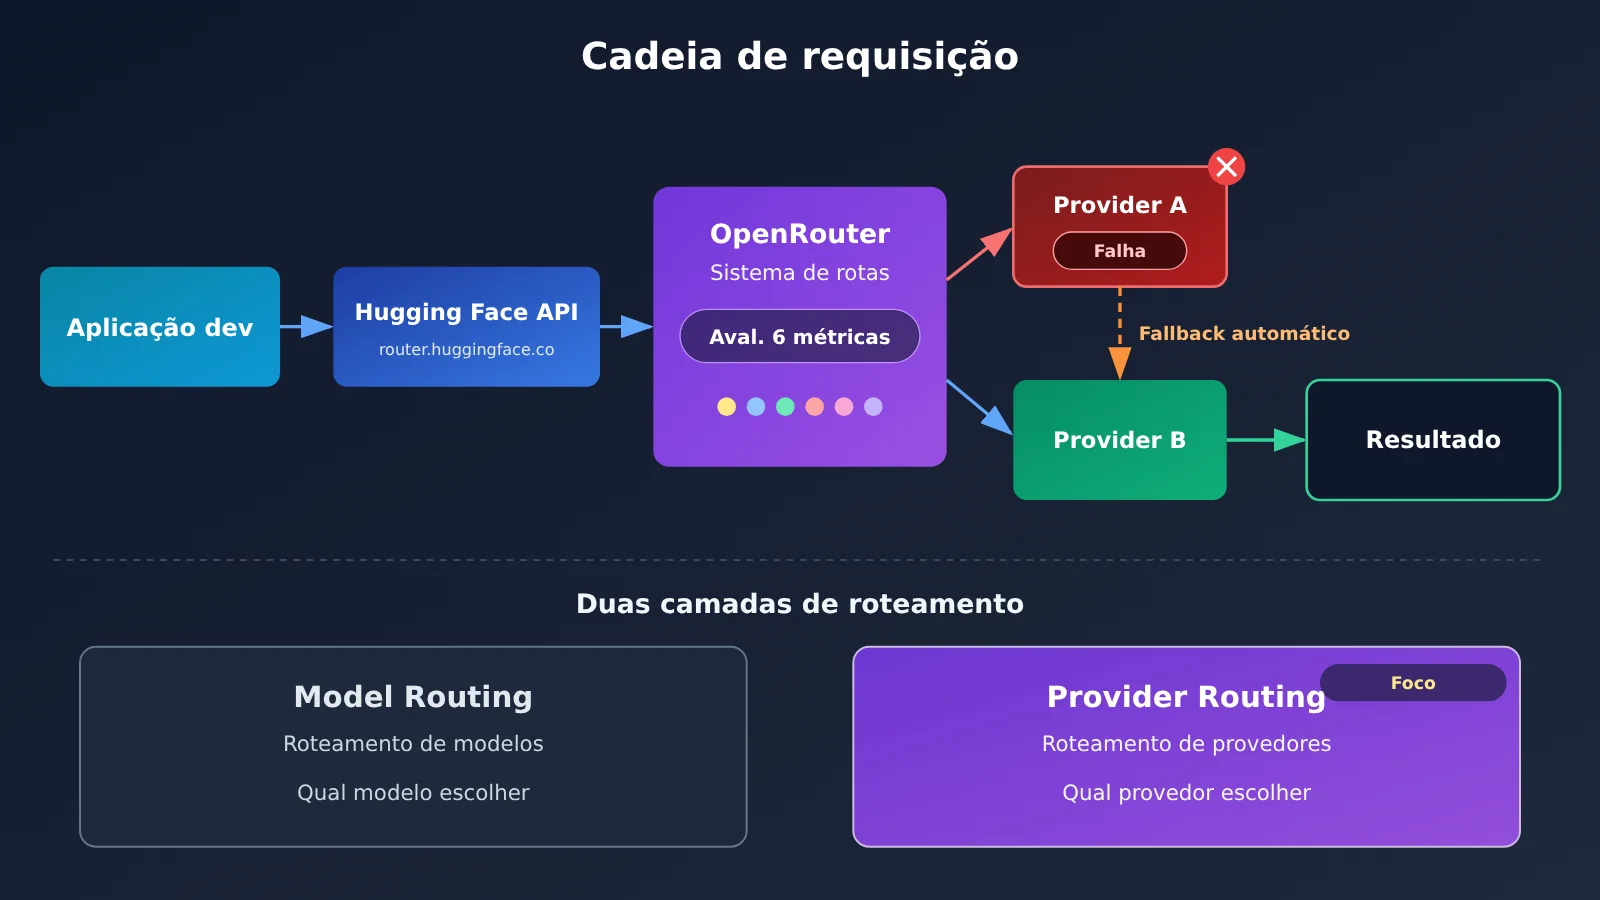
Primeiro, é preciso separar dois conceitos que costumam se confundir. Model Routing (roteamento de modelos) decide qual modelo vai responder — por exemplo, perguntas simples vão para um modelo menor e perguntas complexas para um modelo maior. Provider Routing (roteamento de provedores) parte do princípio de que o modelo já está definido e decide qual provedor vai executar a inferência. A parceria entre OpenRouter e Hugging Face discutida neste artigo é deste segundo tipo: o modelo é indicado pelo desenvolvedor, e a camada de roteamento só escolhe o provedor; ela não troca o modelo por você.
Depois da parceria, o fluxo de uma requisição a um modelo de linguagem fica assim: aplicação do desenvolvedor ou Coding Agent → Hugging Face API (router.huggingface.co) → sistema de roteamento do OpenRouter → inferência em algum provedor → retorno do resultado. O OpenRouter aqui cuida do roteamento da requisição e da escolha do provedor, mas não executa a inferência de todos os modelos. O usuário continua usando o Hugging Face Token e a cobrança passa pela conta pessoal ou organizacional da Hugging Face. A Hugging Face afirma não aplicar acréscimo sobre o preço de inferência dos provedores.
Em termos de controle, a Hugging Face oferece três níveis:
- Roteamento automático padrão: o cliente oficial usa
provider="auto", e o sistema escolhe o provedor combinando preço, velocidade e confiabilidade. - Provedor específico: por exemplo,
provider="together", ou adicionando o sufixo:novitaao ID do modelo; a requisição é enviada fixamente para esse provedor. - Roteamento por estratégia: a interface compatível com OpenAI aceita os sufixos
:cheapest(prioridade de preço) e:fastest(prioridade de throughput).
Vale notar que :fastest otimiza throughput, não “rapidez” em todos os sentidos. TTFT, velocidade de geração e tempo total da requisição são três métricas diferentes. Para respostas curtas, de uma ou duas frases, a latência do primeiro token costuma pesar mais na percepção do que o throughput.
| Item de comparação | Roteamento original da Hugging Face | Novo roteamento do OpenRouter |
|---|---|---|
| Sistema de roteamento | Roteador próprio da Hugging Face | OpenRouter |
| Seleção de provedor | Mecanismo de seleção anterior | Avaliação abrangente em tempo real |
| Base de preço | Estratégia de preços anterior | Preço efetivo real |
| Fatores de velocidade | Mecanismo de desempenho anterior | Inclui TTFT e throughput |
| Falha única | Pode retornar erro diretamente | Pode tentar outro provedor na mesma requisição |
| Cache de sessão | Estratégia anterior | Suporta manter o provedor por sessão |
| Credenciais do usuário | Hugging Face Token | Continua usando Hugging Face Token |
Quais métricas observar em um sistema de roteamento multiprovedor realmente qualificado
Em 28 de outubro de 2026, a OpenRouter divulgou a nova geração do algoritmo Provider Routing. O roteamento padrão antigo dependia bastante do preço por Token de entrada, e provedores com preço baixo tendiam a receber mais tráfego. O novo algoritmo combina as 6 categorias de sinais abaixo em um custo de roteamento em tempo real (Routing Cost), com o objetivo de otimizar o custo total de “uma resposta bem-sucedida e utilizável”, em vez de buscar apenas o menor preço unitário.
① Effective Price (preço efetivo real) — resolve o problema de que “preço de tabela baixo não significa conta baixa”. Ele combina os três tipos de preço unitário (entrada não cacheada, entrada cacheada e saída) e faz o cálculo com base na proporção real de entrada e saída da requisição e na taxa de acerto de cache daquele provedor. O exemplo dado pela OpenRouter: 40.000 Tokens de entrada não cacheada (US$ 2/M) = US$ 0,080; 60.000 Tokens de entrada cacheada (US$ 0,50/M) = US$ 0,030; 4.000 Tokens de saída (US$ 8/M) = US$ 0,032; total de US$ 0,142. Em cenários de Agent, a proporção de entrada cacheada costuma ser alta, e comparar apenas o preço de tabela da entrada pode levar à escolha do provedor errado.
② TTFT (latência do primeiro Token) — resolve a questão de “quanto tempo o usuário espera até ver a resposta”. Interfaces de chat e chamadas de ferramentas em múltiplas rodadas de Agent são as mais sensíveis a isso, porque cada rodada precisa esperar primeiro pelo primeiro Token.
③ Throughput (vazão) — mede a velocidade depois que a geração começa. O novo algoritmo olha para a vazão de geração ao longo de toda a resposta, e não apenas para o pico instantâneo. Tarefas com grande volume de saída, como geração de textos longos e autocompletar de código, são as mais afetadas por ela.
④ Rate Limits (limites de taxa) — foca principalmente nos erros HTTP 429, resolvendo o problema de “capacidade insuficiente do provedor”. Se um Provider retorna 429 com frequência, isso indica que a capacidade de computação está apertada, e o roteamento reduz o tráfego direcionado a ele.
⑤ Reliability (confiabilidade) — mede a frequência de falhas nas requisições. Se a taxa de erro de um provedor for claramente maior que a de outros provedores do mesmo modelo, o sistema reduz o desvio de tráfego e, se necessário, pausa o envio até que ele se recupere.
⑥ Quality (qualidade da resposta) — resolve a questão de “o mesmo modelo ter desempenho inconsistente em implantações diferentes”. De acordo com as explicações públicas atuais, os sinais de qualidade envolvem principalmente se a chamada de ferramenta retorna corretamente e se a estrutura atende aos requisitos. Provedores que apresentam formatos anormais de chamada de ferramenta ou precisão de benchmark claramente inferior têm a competitividade reduzida.
Além dessas 6 métricas, a própria documentação de roteamento da OpenRouter também coloca a política de dados como condição restritiva. Por exemplo, data_collection: "deny" permite excluir Providers que não atendem aos requisitos de coleta de dados, e zdr: true exige o uso de endpoints com retenção zero de dados. A documentação de segurança do Hugging Face explica que ele não usa os dados das requisições dos usuários para treinar modelos, não armazena o corpo da requisição nem a resposta durante o roteamento, e mantém logs de depuração por no máximo 30 dias, sem dados do usuário nem Tokens. Mas ao mesmo tempo ela alerta os desenvolvedores de que ainda é preciso consultar a política de segurança de dados do Provider efetivo. A promessa da plataforma não substitui o acordo de processamento de dados de cada provedor.
Dados e trade-offs do experimento de roteamento do OpenRouter
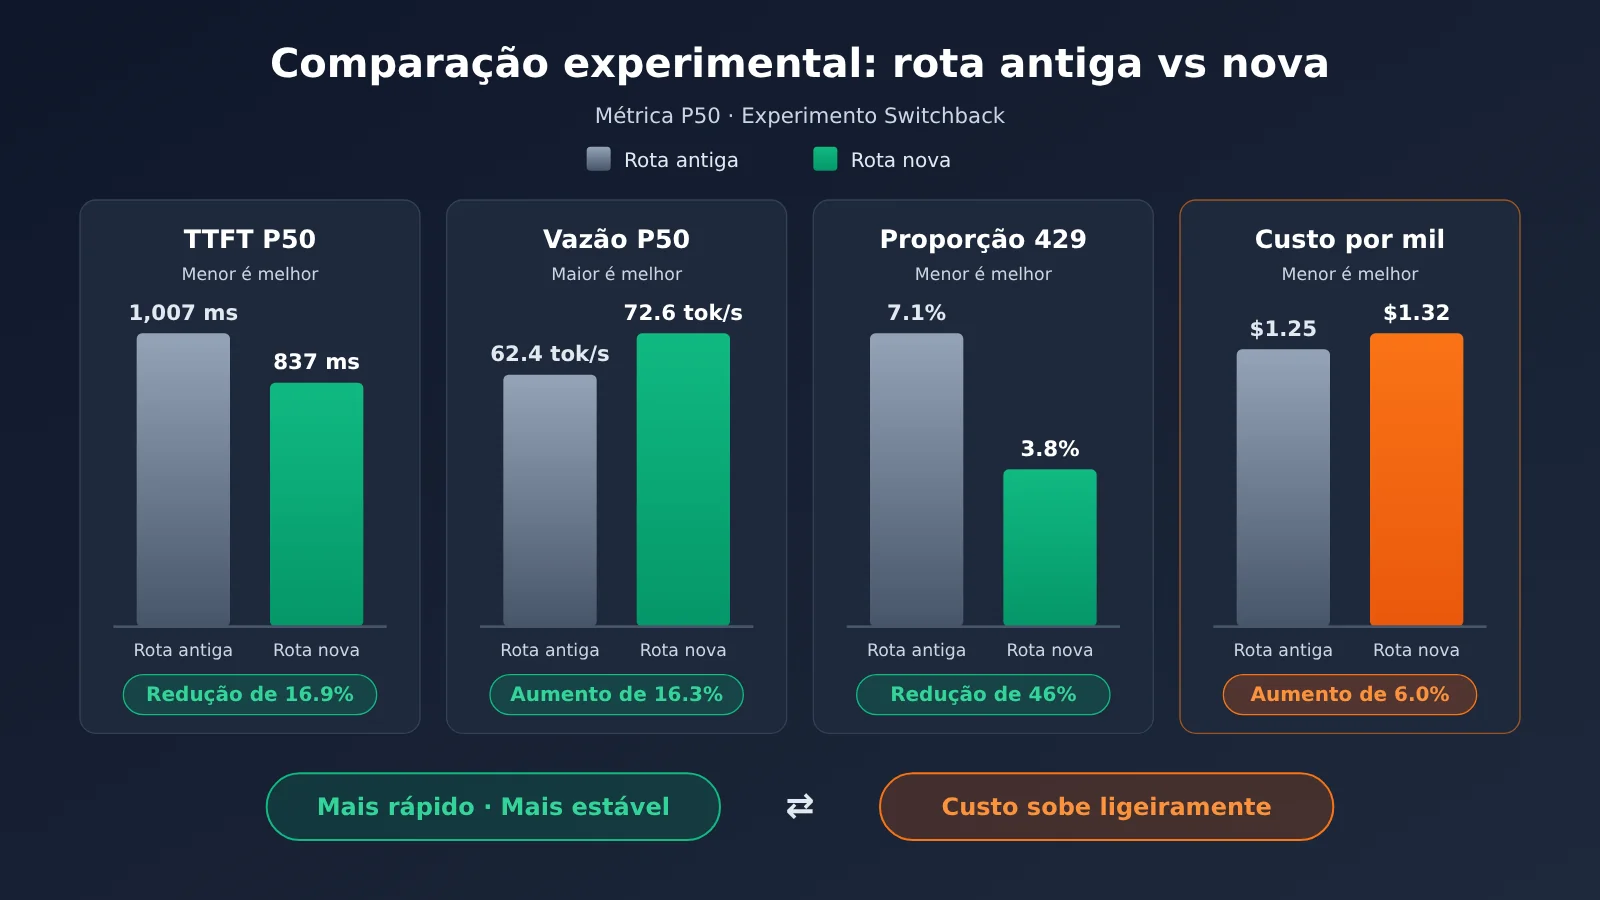
Antes do lançamento do novo algoritmo, a OpenRouter realizou, em outubro de 2026, um experimento alternado do tipo switchback com duração de uma semana. Cada dia foi dividido em blocos de 3 horas; blocos correspondentes usaram o algoritmo antigo e o novo, e após cada troca havia 1 hora de aquecimento que não era contabilizada na medição. No total, foram mais de 24 milhões de requisições e 103 bilhões de tokens de entrada. Optou-se pelo experimento alternado em vez da divisão aleatória de usuários porque, quando o novo algoritmo desloca o tráfego de provedores sobrecarregados, o grupo do algoritmo antigo também se beneficia, o que interferiria na comparação.
| Métrica | Roteamento antigo | Novo roteamento | Variação |
|---|---|---|---|
| TTFT P50 | 1.007 ms | 837 ms | redução de 16,9% |
| TTFT P95 | 4.601 ms | 3.733 ms | redução de 18,9% |
| Throughput P50 | 62,4 tok/s | 72,6 tok/s | aumento de 16,3% |
| Tempo total da requisição P50 | 4,00 s | 3,24 s | redução de 19,0% |
| Requisições com pelo menos um 429 | 7,1% | 3,8% | redução de 46% |
| Requisições que precisaram de retry | 10,4% | 6,9% | redução de 34% |
| Custo por mil requisições | US$ 1,25 | US$ 1,32 | aumento de 6,0% |
| Custo por milhão de tokens | US$ 0,301 | US$ 0,324 | aumento de 7,3% |
Esses dados mostram o trade-off central do novo roteamento: cerca de 6% mais custo por mil requisições em troca de menor latência e menos erros de capacidade. Alguns pontos precisam ser esclarecidos: o experimento foi desenhado e divulgado pela própria OpenRouter, sem auditoria de terceiros; a amostra é um conjunto representativo de modelos abertos e não representa todos os modelos e provedores; os resultados são estatísticas agregadas e não significam que toda requisição terá uma melhoria de 16,9%. Esses dados também vêm de um experimento da OpenRouter realizado antes da parceria, e não de um teste independente após o lançamento no Hugging Face.
💡 Sugestão de teste: O experimento de roteamento fornece estatísticas gerais; o desempenho do seu próprio negócio ainda precisa ser testado por você. Se precisar comparar horizontalmente a qualidade de saída e o custo de vários modelos principais no mesmo código, você pode usar o APIYI apiyi.com para chamar tudo com uma única chave API, primeiro definir a escolha no nível do modelo e depois considerar otimizações no nível do provedor.
Como o sistema faz failover quando um Provider apresenta falha
O fluxo típico do failover automático é: o roteamento seleciona o Provider A; se o A está normal, a resposta volta direto; se o A dá erro ou enfrenta problema de capacidade, o sistema tenta o Provider B na mesma requisição; se o B funciona, o resultado é retornado. No experimento, as “requisições que precisaram de retry” caíram de 10.4% para 6.9%, e o tempo gasto por requisição em tentativas falhas caiu de 349 ms para 242 ms. Isso mostra que um bom roteamento não precisa apenas saber repetir a tentativa, mas também evitar desde o início provedores em mau estado.
O fallback automático e a especificação de Provider são uma escolha que se limita mutuamente. O roteamento padrão permite a troca, o que dá maior disponibilidade. Já especificar o Provider fixa a requisição em uma única empresa, atendendo a exigências de homologação de fornecedor, mas abre mão da margem de tolerância a falhas. A própria API do OpenRouter oferece a combinação de only (permite apenas o Provider especificado) com allow_fallbacks: false (sem fallback automático), o que faz a requisição falhar diretamente quando não há provedor em conformidade, em vez de ser encaminhada a outro fornecedor. Vale distinguir: esses são parâmetros da API completa do OpenRouter e não devem ser entendidos como algo já totalmente exposto na interface do Hugging Face. Do lado do Hugging Face, a capacidade correspondente é especificar o Provider e desativar Providers nas configurações.
Retry também tem custo, e não é ilimitado:
- Custo de tempo: cada tentativa falha alonga o tempo total, o que afeta visivelmente interações em tempo real.
- Saída em streaming: uma resposta em streaming que já começou a ser emitida não pode ser continuada de forma transparente em outro provedor.
- Efeitos colaterais duplicados: se uma chamada de ferramenta já disparou uma ação externa na primeira tentativa, o retry pode causar execução duplicada, e a aplicação precisa cuidar da idempotência por conta própria.
- Perda de cache: o Prompt Caching geralmente está vinculado a um provedor específico, e trocar de provedor pode jogar fora o ganho de cache. Para isso o Hugging Face oferece o cabeçalho de requisição
X-HF-Session-Id, usando um UUID estável para manter a mesma sessão o máximo possível no Provider que detém o cache. - Nenhum provedor disponível: se um modelo tiver apenas um Provider, ou se os outros Providers não suportarem os parâmetros atuais, não há para onde trocar. Problemas como cota insuficiente, permissões de token insuficientes, requisição inválida e janela de contexto excedida também não são resolvidos pelo roteamento.
Mudanças na cobrança do Hugging Face e nas chaves próprias
Essa parceria traz uma mudança que quebra compatibilidade: ao chamar modelos de linguagem pelo Hugging Face, não será mais possível usar sua própria chave API do provedor configurada. Todas as requisições relacionadas são roteadas pelo OpenRouter, e os custos são lançados na conta do Hugging Face ou da organização. As chaves próprias para tarefas de geração de imagens e vídeos continuam disponíveis, conforme as instruções oficiais.
Se os desenvolvedores quiserem continuar usando a cota do provedor que compraram, podem chamar diretamente a API desse provedor ou passar a usar a própria conta do OpenRouter. Segundo a documentação atual de BYOK do OpenRouter: a cota gratuita do BYOK é medida pelo custo equivalente de inferência no catálogo; contas Pay-as-you-go têm US$ 25.000 por mês, e Enterprise tem cota personalizada; o excedente é cobrado a 5% do custo equivalente de inferência, deduzido dos Credits da plataforma. Os 25.000 aqui são o custo de inferência medido em dólares, e não o número de requisições. Além disso, o fallback para capacidade compartilhada pode consumir Credits da plataforma. A integração direta com o OpenRouter é outra relação, independente, de conta e cobrança; as chaves existentes não migram automaticamente para lá.
Na documentação de preços atual do Hugging Face, usuários Free não têm uma cota mensal fixa de cortesia; usuários PRO recebem US$ 2 por mês; Team e Enterprise recebem US$ 2 por assento por mês. Essas cotas são Compute Credits genéricos, que podem ser usados para abater serviços como Inference Providers, Inference Endpoints e Spaces. Vale destacar também: o mecanismo de preços dos provedores não muda, mas isso não significa que o custo de cada requisição permaneça o mesmo, porque o roteamento pode escolher um provedor um pouco mais caro, porém mais rápido e estável.
Como desenvolvedores podem usar a API de catálogo para comparar vários provedores por conta própria
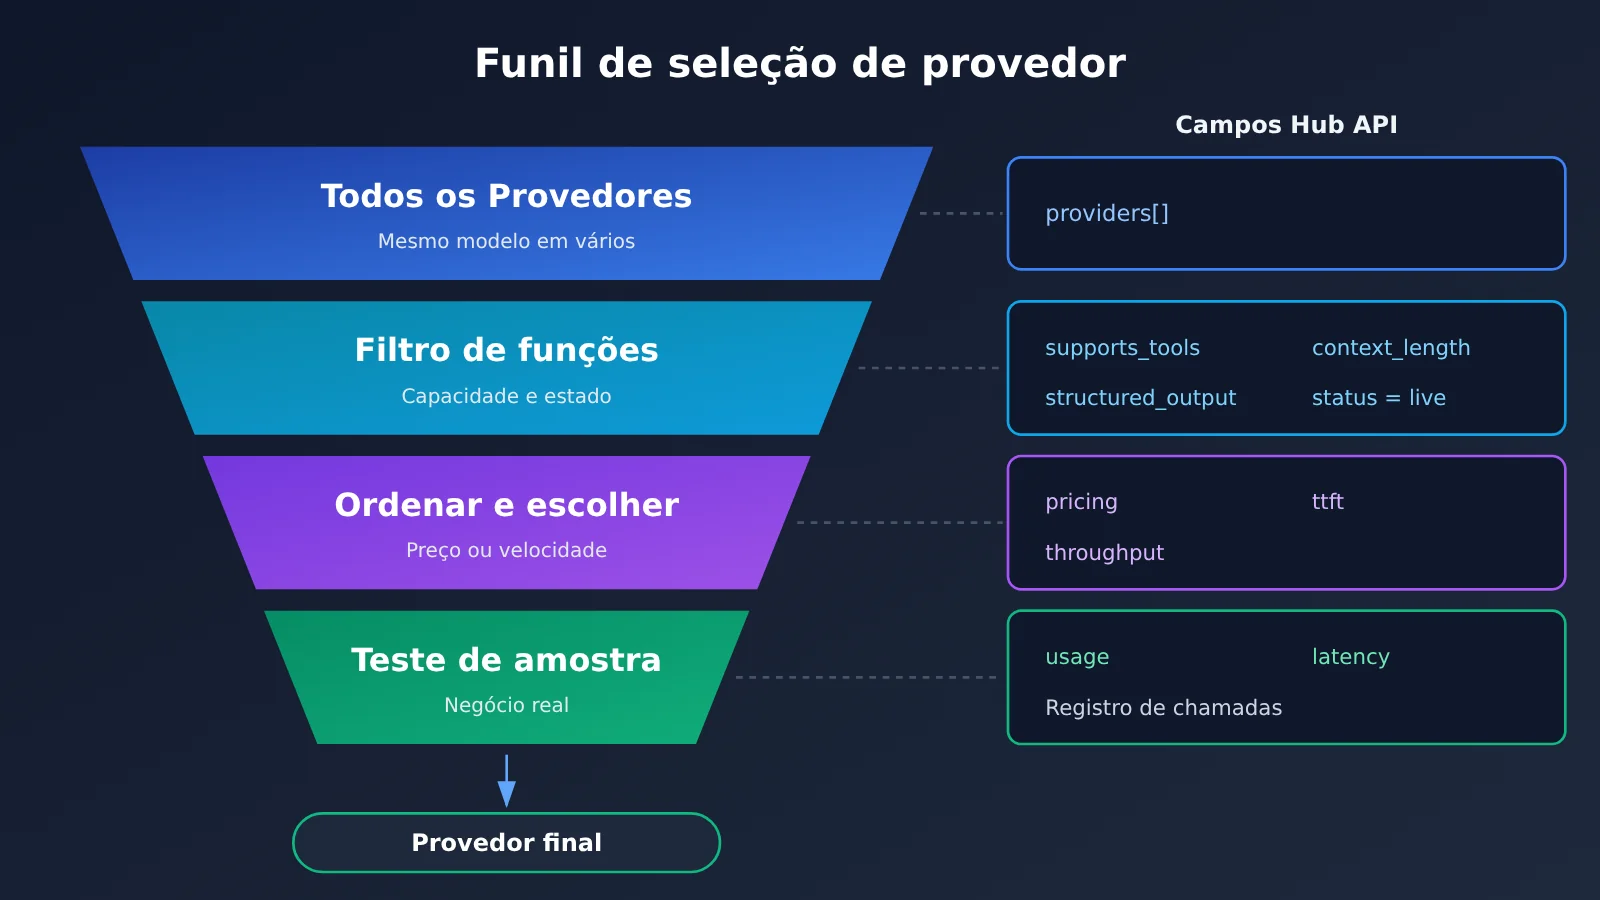
O Hugging Face disponibiliza uma interface consultável de catálogo de modelos, que é uma janela pública pela qual o sistema de roteamento obtém a base para suas decisões:
- Todos os modelos:
GET https://router.huggingface.co/v1/models - Modelo individual:
GET https://router.huggingface.co/v1/models/deepseek-ai/DeepSeek-V4-Pro
| Campo | Significado | Papel na seleção |
|---|---|---|
| provider | Provedor que efetivamente oferece a inferência | Define a lista de candidatos |
| status | Status atual, como live, error | Exclui provedores indisponíveis |
| context_length | Comprimento de contexto suportado por esse provedor | Filtra requisitos de contexto longo |
| pricing.input / pricing.output | Preço em dólares por milhão de tokens de entrada e saída | Ordenação por custo |
| supports_tools | Se suporta chamada de ferramentas | Condição obrigatória para cenários de Agent |
| supports_structured_output | Se suporta saída estruturada | Condição obrigatória para saída JSON |
| first_token_latency_ms | Latência do primeiro token na verificação de sondagem mais recente | Ordenação para casos de interação |
| throughput | Velocidade de geração na verificação de sondagem mais recente | Ordenação para casos de saída longa |
| is_free / is_model_author | Campanha gratuita temporária / se é o autor do modelo | Referência auxiliar |
Esses campos não estão completos em todos os provedores, e os dados de desempenho também vêm da verificação de sondagem mais recente, não sendo equivalentes ao seu próprio desempenho real de ponta a ponta. A abordagem razoável é “primeiro filtrar, depois ordenar”: use primeiro os campos de funcionalidade para eliminar provedores incompatíveis e, em seguida, ordene por custo ou velocidade. O exemplo abaixo demonstra essa ideia; para a estrutura de retorno, consulte a documentação oficial da Hub API:
import os
import requests

HF_TOKEN = os.environ["HF_TOKEN"]
MODEL = "deepseek-ai/DeepSeek-V4.1-Flash"

resp = requests.get(
    f"https://router.huggingface.co/v1/models/{MODEL}",
    headers={"Authorization": f"Bearer {HF_TOKEN}"},
    timeout=30,
)
data = resp.json()
providers = data.get("providers", [])  # A estrutura exata está sujeita à documentação oficial

# Primeiro passo: filtragem por funcionalidades (o Agent precisa de chamada de ferramentas + saída estruturada + contexto de 64K)
candidates = [
    p for p in providers
    if p.get("status") == "live"
    and p.get("supports_tools")
    and p.get("supports_structured_output")
    and (p.get("context_length") or 0) >= 64_000
]

# Segundo passo: ordenar pelo preço unitário de saída, campos ausentes vão para o final
candidates.sort(key=lambda p: (p.get("pricing") or {}).get("output", float("inf")))

for p in candidates:
    print(p["provider"], p.get("pricing"), p.get("first_token_latency_ms"), p.get("throughput"))
Depois de filtrar os candidatos, é obrigatório testar novamente com requisições reais do seu negócio. Os metadados do catálogo indicam apenas “o que o provedor afirma suportar” e não substituem a acurácia, a taxa de sucesso na chamada de ferramentas e a taxa de conclusão final na sua própria tarefa.
Antes de fazer ajustes finos no nível do provedor, normalmente é preciso primeiro definir qual modelo usar. O trecho de código abaixo demonstra como comparar em lote as respostas de vários modelos usando a mesma interface compatível com OpenAI; substitua os IDs dos modelos pelos nomes reais da lista de modelos da plataforma:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI: uma única chave API para chamar modelos de vários provedores
)

prompt = "用 JSON 返回:{\"city\": 城市名, \"reason\": 一句话理由},推荐一个适合冬季旅行的城市"

for model in ["model-id-a", "model-id-b", "model-id-c"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content)
🚀 Início rápido: Novos usuários podem resgatar uma cota de teste gratuita na APIYI apiyi.com e usar o trecho de código acima para rodar um conjunto de amostras do próprio negócio. O log de chamadas no backend registrará, para cada requisição, o modelo, o consumo de Tokens e o custo, facilitando o cálculo do custo real por tarefa, em vez de olhar apenas para o preço de tabela.
Vale esclarecer que a integração unificada com logs de chamada e os dados de desempenho em tempo real no nível de Provider exibidos pelo Hugging Face pertencem a camadas diferentes de funcionalidade: a primeira resolve “conectar e calcular com precisão”, enquanto a segunda mostra o estado dinâmico dos provedores subjacentes. As duas podem ser combinadas.
Múltiplos provedores de API e roteamento inteligente: análise e julgamento
Onde está a próxima competição das plataformas de agregação de API
Se desmontarmos as capacidades da OpenRouter, dá para dividi-las em três camadas: a agregação de modelos resolve “como acessar modelos diferentes”; a agregação de provedores resolve “quem faz a inferência de um mesmo modelo”; e o roteamento dinâmico resolve “para quem essa requisição deve ir desta vez”. A interface unificada já resolveu, em grande parte, o problema de integração; essa cooperação mostra que a segunda e a terceira camadas estão se tornando os novos pontos de competição. A base para essa conclusão: a Hugging Face decidiu abrir mão de construir seu próprio roteador e passou a usar uma capacidade de roteamento externa; e a OpenRouter também tornou seu algoritmo de roteamento público separadamente, comprovando seu valor com experimentos em produção.
Dá para prever que otimização de custos, estabilidade e governança de dados se tornarão novas dimensões de comparação entre plataformas de API. A seguir, algumas previsões que ainda precisam ser verificadas: a transparência do roteamento vai ficar cada vez mais importante — os desenvolvedores vão querer saber em qual provedor a requisição caiu, por que ele foi escolhido e quanto custou; e as restrições de política de dados podem deixar de ser um item opcional para virar uma condição obrigatória na compra empresarial.
Só que roteamento não é solução mágica. Os dados dos experimentos mostram que a contrapartida por mais velocidade e mais estabilidade é um custo unitário mais alto. Os próximos passos anunciados na parceria (como conectar as contas dos dois lados e colocar mais tarefas no roteamento da OpenRouter) ainda são apenas planos. E o roteamento também não resolve questões de qualidade, licença e adequação ao negócio do próprio modelo.
Demanda por modelos de pesos abertos e pressão de custos nas empresas
Os dados do lado da demanda sustentam a tese de que “a orquestração entre provedores está se tornando importante”. Segundo estatísticas do OpenRouter, calculando pelo volume semanal de tokens dos 50 modelos mais usados, em 28 de setembro de 2026 os modelos de pesos abertos chegaram a 71,7%. Esse é o critério de medição dentro da plataforma OpenRouter e não pode ser generalizado como participação de mercado global. Quanto maior o uso de modelos de pesos abertos, mais comum fica a coexistência de vários provedores para um mesmo modelo — e mais evidente se torna o valor do roteamento.
Do lado dos custos, a Capgemini entrevistou 500 executivos (CXO) de grandes empresas em setembro de 2026: 59% afirmaram que os gastos com IA superaram claramente o esperado; entre as empresas afetadas, o estouro médio foi de 24%. Esses números representam apenas a amostra daquela pesquisa, mas, combinados com a conclusão do experimento de roteamento — “ganho de velocidade vem acompanhado de aumento de custo” —, servem de alerta para as empresas: o roteamento automático busca por padrão a melhor experiência global, e não necessariamente a fatura mais baixa. Para operações sensíveis a custo, vale escolher ativamente uma estratégia com prioridade em preço ou definir um teto de preço, além de conferir tudo continuamente nos logs de invocação.
Como cada perfil deve decidir
- Desenvolvedores individuais e times pequenos: o roteamento automático padrão já elimina o trabalho de construir a própria redundância; o foco deve ser validar, com amostras reais, se a chamada de ferramentas e a saída em JSON são estáveis. Começar definindo o modelo por meio de uma interface unificada como a APIYI apiyi.com e só depois otimizar no nível do provedor, conforme a necessidade, é um caminho de baixo investimento.
- Produtos interativos: priorize o TTFT P95 em vez da taxa de transferência. O
:fastestpode não melhorar a percepção em respostas curtas. - Saídas longas e tarefas em lote: taxa de transferência e preço efetivo são mais importantes; vale considerar a estratégia com prioridade em preço e usar sticky sessions (aderência de sessão) para preservar os ganhos de cache.
- Empresas e times de plataforma: primeiro mapeie quais aplicações dependem de Provider Key própria e quais negócios exigem um provedor fixo; depois decida entre permitir fallback, restringir provedores ou conectar-se direto ao provedor. Os acordos de tratamento de dados devem ser checados provedor por provedor.
Independentemente da estratégia escolhida, tudo termina na mesma ação: rodar uma rodada de testes com as suas próprias requisições e as suas próprias métricas. Usar a cota gratuita na APIYI apiyi.com para uma comparação em pequena escala, ou filtrar provedores candidatos com a API de catálogo do Hugging Face, são pontos de partida de custo muito baixo. Os 16,9% do experimento oficial são uma média geral; quanto o seu negócio vai ganhar, só dá para saber testando.
The proof of the pudding is in the eating. (Só provando se sabe; o resultado real se comprova na prática.)