작성자 주: 공식 공개 자료를 바탕으로 Astra for Law의 2억 3천만 개 URL 법률 검색 인덱스, 테스트 성적, API 가격을 살펴보고 전문성의 근원을 짚어봐요.
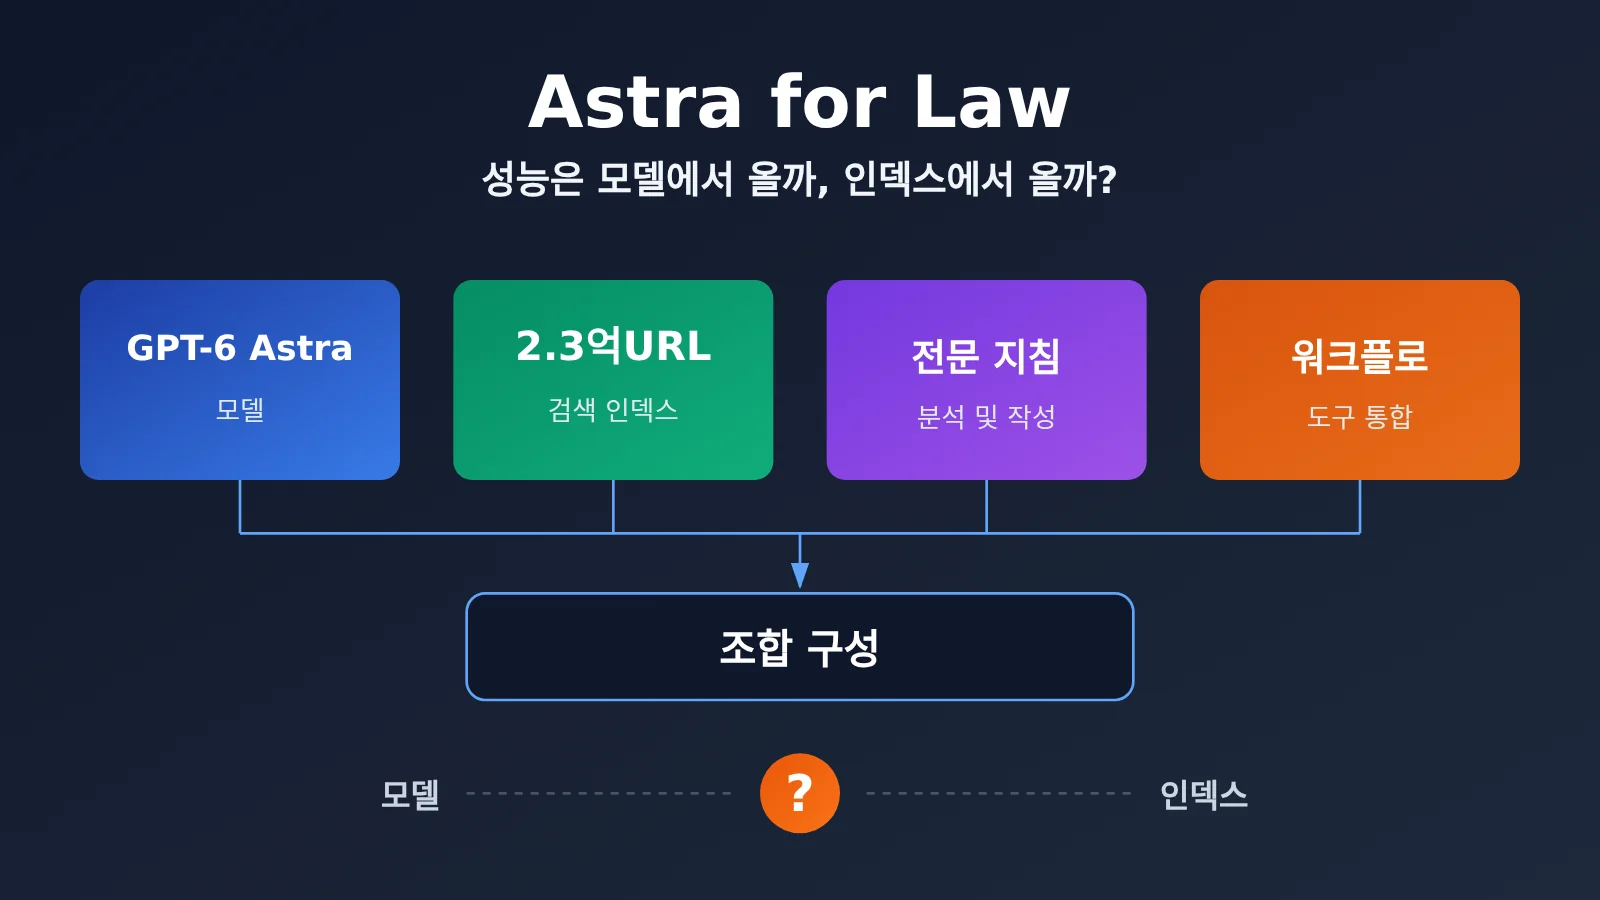
OpenAI의 공식 API 가격 페이지에 법률 분야용 구성인 gpt-6-astra-law가 추가됐어요. 여러 기술 매체가 2026년 10월 31일 이 항목에 주목했죠. 함께 관심을 받은 것은 Astra for Law의 2억 3천만 개 이상의 URL을 포함한 법률 검색 인덱스예요. 여기서 핵심 질문이 생겨요. 전문성은 모델에서 나올까요, 아니면 인덱스에서 나올까요?
이건 확인되지 않은 소문이 아니에요. 제품 설명과 인덱스 규모, 가격은 모두 OpenAI 공식 페이지에서 확인할 수 있어요. 다만 현재 공식 데이터로는 “전체 구성이 범용 구성보다 우수하다”는 것만 알 수 있어요. 성능 향상에 모델, 인덱스, 지침이 각각 얼마나 기여했는지는 아직 구분할 수 없어요.
핵심 요약: Astra for Law의 실제 구성과 주요 수치의 정확한 의미, 개발자가 현시점에서 할 수 있는 일을 3분 만에 알아봐요.
Astra for Law의 2억 3천만 URL 핵심 정보
2026년 11월 2일 기준, 공개된 정보는 다음과 같아요. 가장 오해하기 쉬운 부분은 API 상태예요. 가격은 공개됐지만, 모든 개발자가 호출할 수 있다는 뜻은 아니에요.
| 항목 | 내용 |
|---|---|
| 출시일 | 2026년 9월 17일 |
| 출시 기업 | OpenAI |
| 제품 포지셔닝 | 로펌과 법률 기술 기업을 위한 전문 AI 기반 플랫폼 |
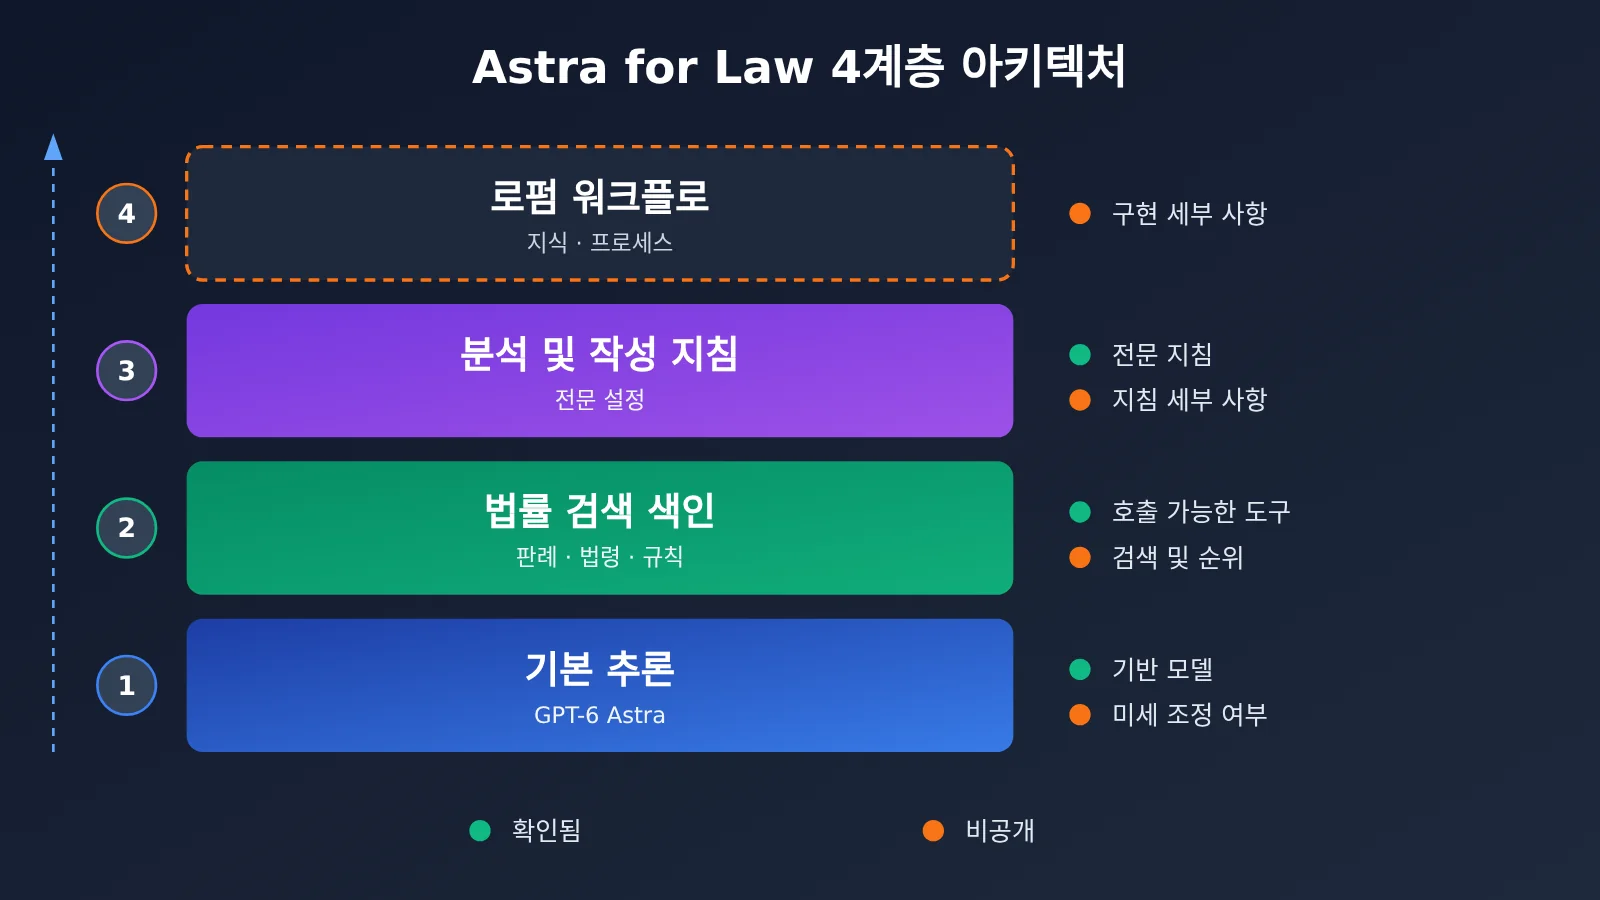
| 기술 구성 | GPT-6 Astra, 법률 검색 인덱스, 법률 분석 및 문서 작성 지침, 도구 및 워크플로 통합 |
| 인덱스 규모 | 2억 3천만 개 이상의 URL, 매일 새 출처 추가 |
| 이용 범위 | 초기에는 Trusted Access를 통해 자격을 갖춘 미국 로펌에 제공 |
| API 상태 | 공식적으로 향후 공개 예정으로 안내 중이며, 정식 공개일은 미발표 |
Astra for Law의 2억 3천만 URL 법률 검색 인덱스에는 무엇이 담겨 있나요?
이 인덱스는 미국 판례법, 성문법, 행정 규정, 법원 규칙, 행정 결정을 포괄해요. OpenAI는 비영리 단체인 Free Law Project와 협력해 CourtListener의 미국 판례 데이터도 리서치 환경에 도입했어요.
하나의 URL은 페이지, 문서, 기록 또는 기타 법률 자료에 해당할 수 있어요. 따라서 ‘2억 3천만 URL’이 곧 ‘판결문 2억 3천만 건’을 뜻하지는 않아요. 아래 수치들도 각각 집계 기준이 달라서 서로 빼거나 다른 자료의 수를 추산하는 데 사용할 수 없어요.
| 수치 | 공개 기관 | 정확한 의미 | 이렇게 이해하면 안 돼요 |
|---|---|---|---|
| 2억 3천만 개 이상의 URL | OpenAI | 전체 법률 검색 인덱스의 규모 | 독립된 판결문 2억 3천만 건 |
| 900만 건 이상 | Free Law Project | CourtListener의 법적 판단 기록 | OpenAI 인덱스의 전체 내용 |
| 법원 2,000곳 이상 | Free Law Project | CourtListener의 데이터 출처 범위 | 전 세계 법원 포괄 |
| 99.9% 이상 | Free Law Project | 공개된 미국 선례적 판례의 수록률 | 모든 법률 자료의 완전성 |
포괄 범위에도 분명한 한계가 있어요. 현재 이 인덱스는 미국 법률 자료를 중심으로 하며, 중국의 현행 법령, 재판 문서, 사법 해석을 동등한 수준으로 전문적으로 수록한다는 신뢰할 만한 공식 자료는 아직 없어요.
Astra for Law의 전문성은 모델에서 나올까요, 법률 검색 인덱스에서 나올까요?
현재로서는 두 요소의 조합에서 나오며, 각각의 기여도를 정확히 분리할 수 없다는 게 가장 정확한 답이에요. OpenAI는 Astra for Law를 GPT-6 Astra 기반의 법률 전문 구성으로 정의하고, 법률 검색 인덱스를 호출 가능한 도구 중 하나로 명시했어요. 공개 설명은 구성, 검색, 도구, 지침에 초점을 맞추고 있으며, 법률 분야 파인튜닝이나 증류, 별도의 파라미터 학습을 진행했는지는 확인하지 않았어요.
가장 설득력 있는 데이터는 OpenAI가 보고한 테스트에서 나왔어요. Vals AI Legal Research Bench의 비공개 검증 세트에 포함된 미국 법률 연구 문제 200개를 사용해, 최고 추론 강도에서 두 구성을 비교했어요.
| 비교 지표 | Astra for Law | 범용 Astra + 웹 검색 | 차이 |
|---|---|---|---|
| 전체 정확성 검사 통과율 | 54.0% | 38.7% | 15.3%포인트 상승, 상대적으로 약 40% 향상 |
| 판례법 문제에서 참고한 판례 수 | 더 많음 | 기준 | 24% 더 많음 |
| 올바른 판결문에서 찾은 관련 문단 수(동일 추론 강도) | 더 많음 | 기준 | 최대 54% 증가 |
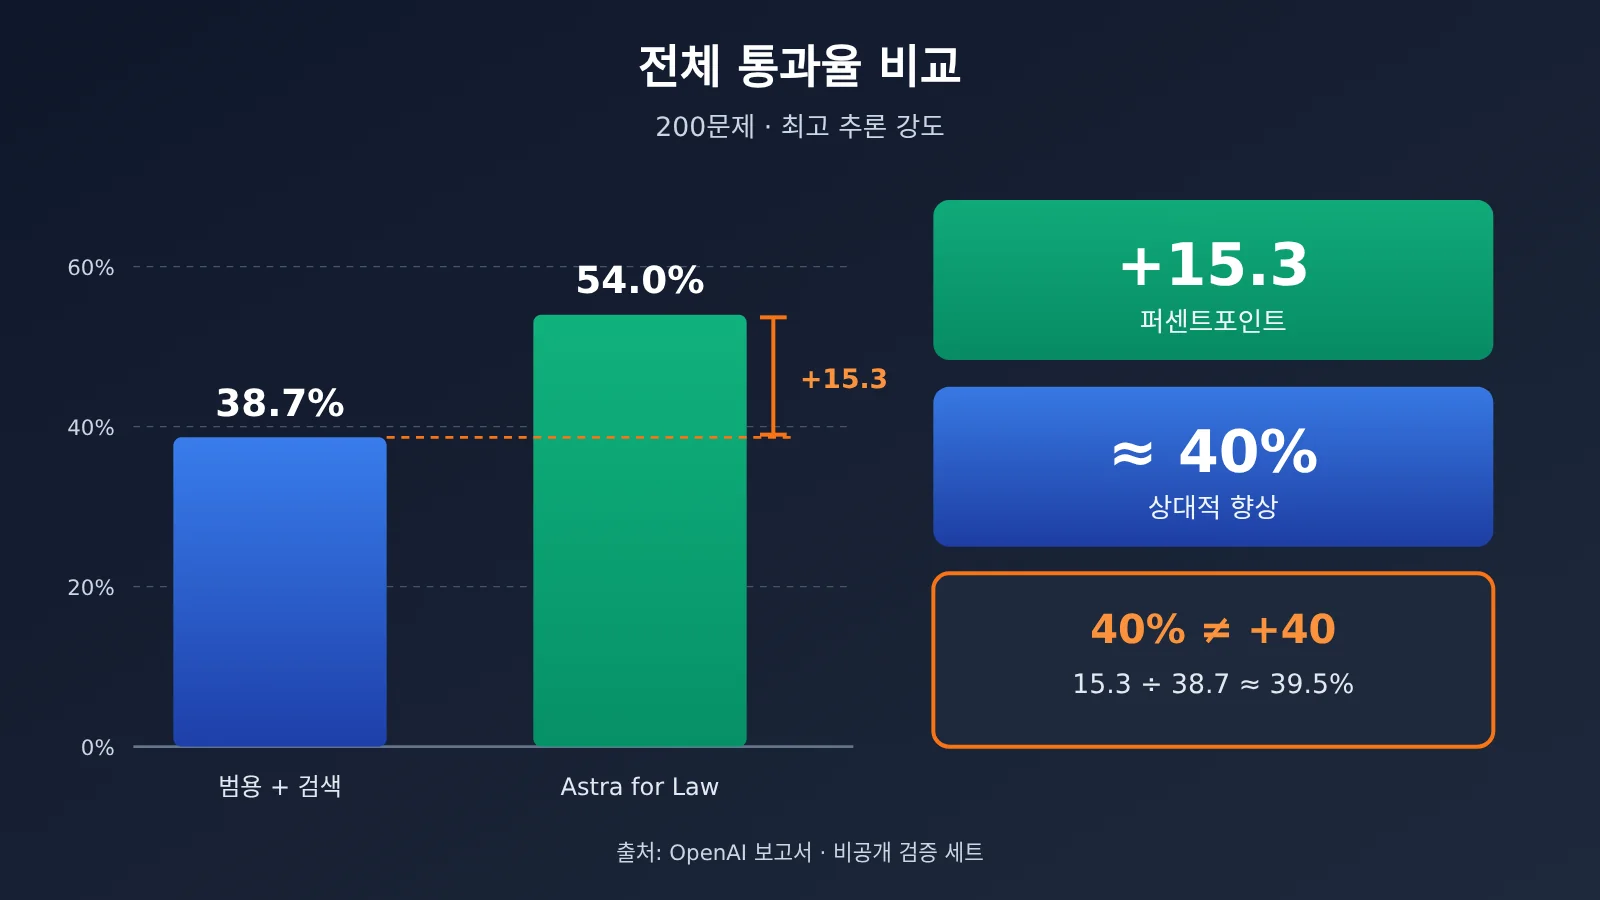
이 결과에서 세 가지를 짚어볼 수 있어요.
- 기반 모델은 여전히 토대예요: 자료를 찾은 뒤 이해하고 추론하며 결과를 생성하는 과정은 GPT-6 Astra에 의존해요. 다만 이 테스트는 모델 자체의 기여도를 따로 측정하지 않았어요.
- 검색 지표가 뚜렷하게 개선됐어요: 판례 수와 관련 문단 지표는 모두 전용 검색의 성능이 더 좋다는 점을 보여줘요. 하지만 더 많은 판례를 찾았다고 해서 법률 의견이 반드시 더 정확한 것은 아니에요.
- 단일 구성 요소의 성과로 돌릴 수 없어요: 테스트는 전체 구성을 비교했어요. 인덱스, 지침, 기타 설정이 동시에 달라졌으므로 “법률 인덱스만으로 40% 향상됐다”고 할 수는 없어요.
이 결과를 해석할 때는 분명한 한계도 있어요. OpenAI가 비공개 검증 세트를 사용해 보고한 성적일 뿐, Vals AI가 독립적으로 재현한 결과는 아니에요. 법률 자문, 승소 예측 또는 계약서 검토의 정확도가 54%라는 뜻도 아니고요. 공개 순위표의 범용 모델 결과 역시 이번 테스트와 구성이 달라 직접 섞어 순위를 매길 수 없어요.
법률 검색 인덱스를 웹 검색만으로 대체할 수 없는 이유
법률 연구에서는 의미상 관련이 있는 텍스트만 찾는 것으로는 부족해요. 법원의 위계와 관할, 판례의 구속력, 해당 판례가 뒤집혔거나 적용이 제한됐는지에 따라 법적 근거의 실제 가치가 달라져요. 같은 계약 분쟁도 주마다 법체계가 달라 결론이 달라질 수 있어요.
일반 검색으로 관련 내용을 찾을 수는 있지만, 인용한 법적 근거가 해당 사안에 실제로 적용되는지는 보장할 수 없어요. 전용 법률 인덱스와 전문 지침은 함께 이 문제를 해결하려는 것이에요. 다만 그렇다고 모든 인용의 유효성이 자동으로 검증됐다고 볼 수는 없어요.
🎯 기술 제안: 특정 분야의 지식 베이스를 구축한다면 같은 문제 세트로 ‘모델만 사용’, ‘모델 + 일반 검색’, ‘모델 + 전용 지식 베이스’ 세 가지 구성을 비교해 보세요. APIYI apiyi.com의 통합 인터페이스로 모델을 전환하면 반복적인 연동 작업을 줄일 수 있어요.
Astra for Law와 기존 RAG 아키텍처는 어떤 관계가 있나요?
기존 RAG는 사용자의 질문을 바탕으로 지식 베이스를 검색하고, 관련 문서 조각을 가져와 모델이 이를 참고해 답변을 생성하는 방식이에요. Astra for Law도 모델 파라미터에 담긴 지식에만 의존하지 않는다는 점에서 비슷해요. 다만 이는 아이디어 차원의 유사성일 뿐, 일반적인 RAG 솔루션을 Astra for Law의 내부 구현 방식으로 단정할 수는 없어요.
| 기술적 질문 | 공개 여부 | 올바른 설명 |
|---|---|---|
| 법률 검색 인덱스 사용 여부 | 확인됨 | Astra for Law가 호출할 수 있는 도구 중 하나 |
| 인덱스에 포함된 콘텐츠 유형 | 확인됨 | 판례법, 성문법, 법규, 법원 규칙, 행정 결정 |
| 벡터 검색 또는 하이브리드 검색 방식 | 공개되지 않음 | 구체적인 방식을 단정해서는 안 됨 |
| 임베딩과 리랭킹 | 공개되지 않음 | 구체적인 모델이나 알고리즘을 추측해서는 안 됨 |
| 청킹 전략과 검색 결과 수 | 공개되지 않음 | 일반적인 파라미터를 그대로 적용해서는 안 됨 |
| 권위에 따른 순위 지정 구현 방식 | 공개되지 않음 | 목표만 설명할 수 있으며, 구현 방식은 설명할 수 없음 |
OpenAI의 범용 File Search는 벡터 저장소를 사용하며, 의미 검색과 키워드 검색을 결합해요. 하지만 법률 인덱스와 동일한 기반 기술을 사용한다는 공개 정보는 없어요. 따라서 File Search의 파라미터를 법률 버전에 그대로 적용할 수는 없어요.
RAG 방식으로 법률 리서치의 기본 패턴 구현하기
아래 예제는 gpt-6-astra-law를 호출하지 않으며, Legal Search Index를 재현할 수도 없어요. “근거 검색, 출처 제한, 인용 요구”라는 일반적인 패턴만 보여줍니다. 모델 이름은 실제 사용 가능한 목록을 확인해 주세요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

context = "[DOC-1] 示例资料:此处放入检索到的法律片段"
response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "system", "content": "仅依据给定资料回答,并标注来源编号。资料不足时明确说明。"},
        {"role": "user", "content": f"资料:{context}\n问题:该条款有哪些风险?"}
    ]
)
print(response.choices[0].message.content)
메타데이터 필터링을 적용한 전체 예제 보기
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 以下均为虚构演示数据,不是真实法律资料
DOCS = [
    {
        "id": "DOC-1",
        "title": "示例判决 A",
        "jurisdiction": "示例州",
        "year": 2024,
        "text": "示例内容:合同终止条款需要事先书面通知。"
    },
    {
        "id": "DOC-2",
        "title": "示例判决 B",
        "jurisdiction": "其他州",
        "year": 2023,
        "text": "示例内容:合同终止通知可以采用电子方式。"
    }
]


def retrieve(keywords, jurisdiction, top_k=3):
    """按司法辖区过滤,再按关键词命中数和年份排序"""
    candidates = [d for d in DOCS if d["jurisdiction"] == jurisdiction]
    scored = []
    for doc in candidates:
        score = sum(keyword in doc["text"] for keyword in keywords)
        if score > 0:
            scored.append((score, doc["year"], doc))
    scored.sort(key=lambda item: (item[0], item[1]), reverse=True)
    return [item[2] for item in scored[:top_k]]


def answer(question, keywords, jurisdiction):
    docs = retrieve(keywords, jurisdiction)
    if not docs:
        return "未检索到符合司法辖区要求的资料,请人工复核。"

    context = "\n".join(
        f"[{d['id']}] {d['title']}({d['jurisdiction']},{d['year']}):{d['text']}"
        for d in docs
    )
    response = client.chat.completions.create(
        model="gpt-6.1-sol",  # 以平台实际可用模型为准
        messages=[
            {
                "role": "system",
                "content": (
                    "你是法律研究助手。仅依据给定资料回答,并标注来源编号。"
                    "指出不确定性和缺失信息。输出仅供专业人员复核,不构成法律意见。"
                )
            },
            {
                "role": "user",
                "content": f"资料:\n{context}\n\n问题:{question}"
            }
        ]
    )
    return response.choices[0].message.content


print(answer("终止合同是否需要书面通知?", ["合同", "通知"], "示例州"))
추천: APIYI apiyi.com에서 무료 테스트 크레딧을 받아 직접 준비한 질문으로 모델별 성능을 검증해 보세요. 평가할 때는 답변의 유창함뿐 아니라 인용이 정확한지, 근거가 적절한지도 함께 기록하는 것이 좋아요.
Astra for Law API 가격이 개발자에게 미치는 영향
가격표에서 주목할 점이 있어요. gpt-6-astra-law의 기본 Token 단가는 범용 모델인 gpt-6-astra와 같으며, 현재 추가 프리미엄이 붙지 않아요. 아래는 공식 가격 페이지에 공개된 표준 모드 요금으로, 프로모션 가격은 최소 2026년 12월 31일까지 유지돼요.
| 모델 | 입력 / 백만 Token | 캐시 입력 / 백만 Token | 출력 / 백만 Token |
|---|---|---|---|
gpt-6-astra-law |
$10 | $1 | $50 |
gpt-6-astra |
$10 | $1 | $50 |
gpt-6.1-sol |
$2 | $0.10 | $10 |
gpt-6.1-terra |
$1 | $0.05 | $5 |
단가를 기준으로 일반 입력 10만 Token과 출력 1만 Token을 사용하면 약 $1.50이 들어요. 입력 전체가 캐시 요금 적용 조건을 충족한다면 약 $0.60이에요. 이는 예시 비용일 뿐이며, 도구 사용, 검색, 특수 처리에 따른 추가 비용은 포함하지 않았어요. API에서 법률 인덱스에 요금이 어떻게 부과되는지도 아직 완전히 확인되지 않았으므로, 검색이 무료라고 단정해서는 안 돼요.
💰 비용 안내: 법률 모델의 Token 단가는 Sol의 5배지만, 실제 작업 비용은 출력 길이, 도구 호출, 작업 성공률에도 영향을 받아요. 예산에 민감한 프로젝트라면 먼저 APIYI apiyi.com에서 기존 모델로 검색 프로세스를 구축한 뒤, 전체 작업 비용을 기준으로 업그레이드 필요성을 평가해 볼 수 있어요.
개발자에게 미치는 영향
- 역량 구축의 중심 변화: 버티컬 AI의 경쟁력은 모델 선택뿐 아니라 데이터 품질, 출처 추적, 전문 규칙 설계에도 달려 있어요.
- 평가 방식 개선 필요: 동일한 문제 세트에서 전체 구성을 비교하고, 인용 정확성과 관할 지역에 대한 적용 가능성도 평가 지표에 포함해야 해요.
- 출시 일정에 여유 확보: 공개일, 속도 제한, 도구 파라미터가 모두 확정되지 않았으므로 당분간 이를 제품 출시의 유일한 의존 요소로 삼는 것은 피하는 게 좋아요.
법률 AI 업계에 미치는 영향
- 경쟁 심화: Anthropic, Google, Thomson Reuters, Harvey, Legora 모두 법률 AI 제품이나 기능을 개발하고 있어요.
- 경쟁과 협력의 공존: Harvey와 Legora는 경쟁자가 될 수도 있지만, OpenAI가 미래의 API 고객으로도 언급한 기업이에요.
- 로펌 내부 지식의 가치 유지: Sullivan & Cromwell의 계약 분석기는 내부 협상 매뉴얼과 과거 계약 선례를 활용해요. 이는 공개 법률 인덱스가 조직 내부 지식을 대체할 수 없다는 점을 보여줘요. Ropes & Gray, Cooley 등의 협력 사례도 비슷하지만, 모두 최종 API의 실제 운영 환경 테스트로 볼 수는 없어요.
자주 묻는 질문 FAQ
Q1: Astra for Law는 독립적으로 학습된 법률 모델인가요?
현재로서는 이를 뒷받침할 근거가 없어요. 공식적으로는 GPT-6 Astra를 기반으로 법률 인덱스, 전문 지침, 도구를 갖춘 법률 전문 구성으로 소개하고 있어요. 법률 분야에서 추가로 미세 조정이나 파라미터 학습을 거쳤는지는 공개적으로 확인되지 않았어요.
Q2: 54.0%는 법률 상담 정확도를 뜻하나요?
아니요. 54.0%는 특정 법률 조사 테스트에서 전반적인 정확성 검사에 통과한 비율이에요. 모든 법률 상황에 적용할 수 없으며, 승소율이나 계약서 검토 정확도를 뜻하지도 않아요. 제품의 결과물은 여전히 변호사의 검토가 필요해요.
Q3: 지금 gpt-6-astra-law를 호출할 수 있나요?
현재 일반 개발자도 호출할 수 있다고 보기는 어려워요. 공식 도움말 센터에 따르면 초기에는 자격 요건을 충족하는 미국 로펌을 대상으로 제공하며, API는 향후 공개될 예정이에요. 모델 식별자와 가격이 공개됐다고 해서 모든 API 키에 접근 권한이 있는 것은 아니에요.
Q4: 2억 3천만 개 URL은 중국 법률 업무에도 적합한가요?
현재로서는 확인할 수 없어요. 이 인덱스는 미국 법률 자료를 중심으로 구축됐으며, 중국 법률을 동등한 수준으로 다룬다는 신뢰할 만한 공식 자료는 없어요. 중국 법률 업무에 활용하려면 규정을 준수하는 현지 데이터 소스를 연결하고 별도로 테스트해야 해요.
Q5: 현재 유사한 법률 RAG 솔루션을 어떻게 검증할 수 있나요?
다음 세 단계로 진행할 수 있어요.
1. APIYI apiyi.com에 가입해 API 키와 무료 테스트 크레딧을 받으세요.
2. 본문의 예제를 활용해 보유한 규정 준수 법률 자료를 연결하세요.
3. 정답이 포함된 문제 세트를 만들어 여러 모델과 검색 방식을 비교하세요.
Q6: Astra for Law의 현재 한계는 무엇인가요?
접근 대상이 제한적이고 API 세부 정보가 공개되지 않았으며, 독립적인 제3자의 대규모 테스트도 부족해요. 지연 시간, 처리량, 실제 오류율, 사건당 비용에 관한 데이터도 충분하지 않아요. 개인정보 보호 기능이 있어도 환각이나 잘못된 인용을 없앨 수는 없으므로 최종 결론은 사람이 다시 검토해야 해요. 범용 모델의 성능을 먼저 비교하고 싶다면 APIYI apiyi.com에서 소규모 테스트를 진행할 수 있어요.
Astra for Law 핵심 요약 Key Takeaways
- 제품의 본질: Astra for Law는 GPT-6 Astra를 법률 업무에 맞게 구성한 제품이에요. 독립적인 모델인지는 확인되지 않았어요.
- 인덱스 규모: 2억 3천만은 판결문 수가 아니라 URL 수예요. 주로 미국 법률 자료를 다뤄요.
- 성능의 기반: 전문적인 성능은 모델, 인덱스, 지침, 워크플로의 조합에서 나와요. 현재 데이터로는 각 요소의 기여도를 정확히 구분할 수 없어요.
- 테스트 결과: 공식 보고 결과는 54.0% 대 38.7%로, 상대적으로 약 40% 향상됐어요.
- 가격 정보: 법률 버전과 범용 Astra의 기본 단가는 같지만, 검색 도구 비용은 아직 완전히 확인되지 않았어요.
- API 현황: 가격은 공개됐지만, 일반 개발자를 위한 공개 시점과 접근 권한은 아직 확인되지 않았어요.
- 활용 방법: 먼저 APIYI apiyi.com을 통해 범용 모델을 테스트하고, 자체 지식 베이스와 검색 프로세스를 검증할 수 있어요.
정리: Astra for Law의 2억 3천만 URL이 주는 시사점
처음 질문으로 돌아가면, Astra for Law의 전문성을 모델이나 인덱스 한 가지 덕분이라고 단정할 수는 없어요. 모델은 이해와 추론, 생성을 담당하고, 법률 검색 인덱스는 출처를 추적할 수 있는 근거를 제공해요. 전문 지침은 분석과 작성 방식을 정하고, 로펌의 지식은 이 기능을 실제 워크플로에 적용할 수 있게 해줘요.
공식 테스트는 특정 법률 조사 업무에서 전체 구성의 우수성을 보여줬지만, 각 구성 요소의 기여도는 밝히지 않았어요. 개발자라면 먼저 자체 데이터와 검색·평가 체계를 구축하고, API의 정식 공개 정보를 계속 살펴보는 편이 실용적이에요.
전문 지식 베이스 애플리케이션을 계획하고 있다면, APIYI apiyi.com의 통합 인터페이스로 여러 모델을 비교하고 비교적 적은 비용으로 방안의 실현 가능성을 먼저 검증해 보세요.
📚 참고 자료
- OpenAI: Astra for Law 제품 출시: 제품 포지셔닝, 인덱스 규모, 테스트 결과 및 협업 사례
- 링크:
openai.com/index/astra-for-law -
설명: 이 글의 핵심 기술 정보와 공식 테스트 데이터의 주요 출처예요.
-
OpenAI API 가격 페이지: 법률용 모델 식별자와 토큰 가격
- 링크:
developers.openai.com/api/docs/pricing -
설명: 가격과 프로모션 기간을 확인할 수 있어요. 호출하기 전에 다시 확인하는 것이 좋아요.
-
OpenAI 도움말 센터: Astra for Law: 이용 자격과 API 제공 현황
- 링크:
help.openai.com/en/articles/20001528-astra-for-law -
설명: 현재 이용 가능한지 확인할 때 가장 먼저 살펴볼 자료예요.
-
Free Law Project: CourtListener 데이터 범위: 미국 판례 데이터의 출처와 제공 범위
- 링크:
wiki.free.law/c/courtlistener/help/data-coverage/case-law -
설명: 99.9%의 커버리지가 정확히 무엇을 의미하는지 이해하는 데 도움이 돼요.
-
Vals AI Legal Research Bench: 법률 리서치 테스트 방법과 공개 리더보드
- 링크:
www.vals.ai/benchmarks/legal_research -
설명: 법률 AI의 평가 기준을 설계할 때 참고하기 좋아요.
-
OpenAI File Search 기술 설명: 범용 파일 검색 도구의 작동 방식
- 링크:
developers.openai.com/api/docs/guides/tools-file-search -
설명: RAG 기술의 참고 자료로 활용할 수 있지만, 법률 인덱스의 내부 구현을 설명하는 것은 아니에요.
-
Reuters: OpenAI 법률 사업 출시 보도: 법률 AI 시장의 경쟁 배경
- 링크:
www.reuters.com/legal/litigation/openai-launches-legal-focused-ai-platform-escalating-race-law-firm-users-2026-09-17 - 설명: 업계의 경쟁 구도를 이해하는 데 도움이 돼요.
작성자: APIYI 기술팀
기술 관련 문의: APIYI 웹사이트 홈에서 문의해 주세요. 더 많은 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.