이 글은 GPT-6.1 Sol과 GPT-6.2 Sol의 마이그레이션, 고객 지원, 코드 사례를 통해 비즈니스 수용 기준을 먼저 고정한 뒤, 안정적으로 기준을 통과하는 추론 레벨을 고르고, 기준을 통과한 작업마다 드는 비용을 산정하는 방법을 설명해요.
먼저 결론부터 말하면: 레벨을 조정할 때 비교해야 하는 건 “기준을 통과한 작업마다 돈이 얼마나 들고 시간이 얼마나 걸리는지”예요. 단일 호출의 표기가격은 그중 한 항목일 뿐이에요. 공개된 소표본 실측에서 GPT-6.2 Sol의 low는 고객 지원 정책 문제와 코드 문제 묶음 모두에서 medium과 같은 통과 수를 기록했고, 소요 시간은 더 짧았어요. 코드 문제에서 low의 표기가격을 기준으로 환산한 비용은 medium의 약 70% 수준이에요. 이 결론이 성립하려면 두 가지 조건이 필요해요. 우선 여러분의 작업이 테스트 작업과 충분히 비슷해야 하고, 수용 기준이 통과율만 보는 게 아니라 가짜 링크, 금액 필드, 재작업 여부까지 확인해야 해요. 여러 자료가 서로 충돌하거나 도구 의존성이 복잡하거나 제약 조건을 놓치기 쉬운 작업은 여전히 medium 이상 레벨을 별도로 검증해야 해요.
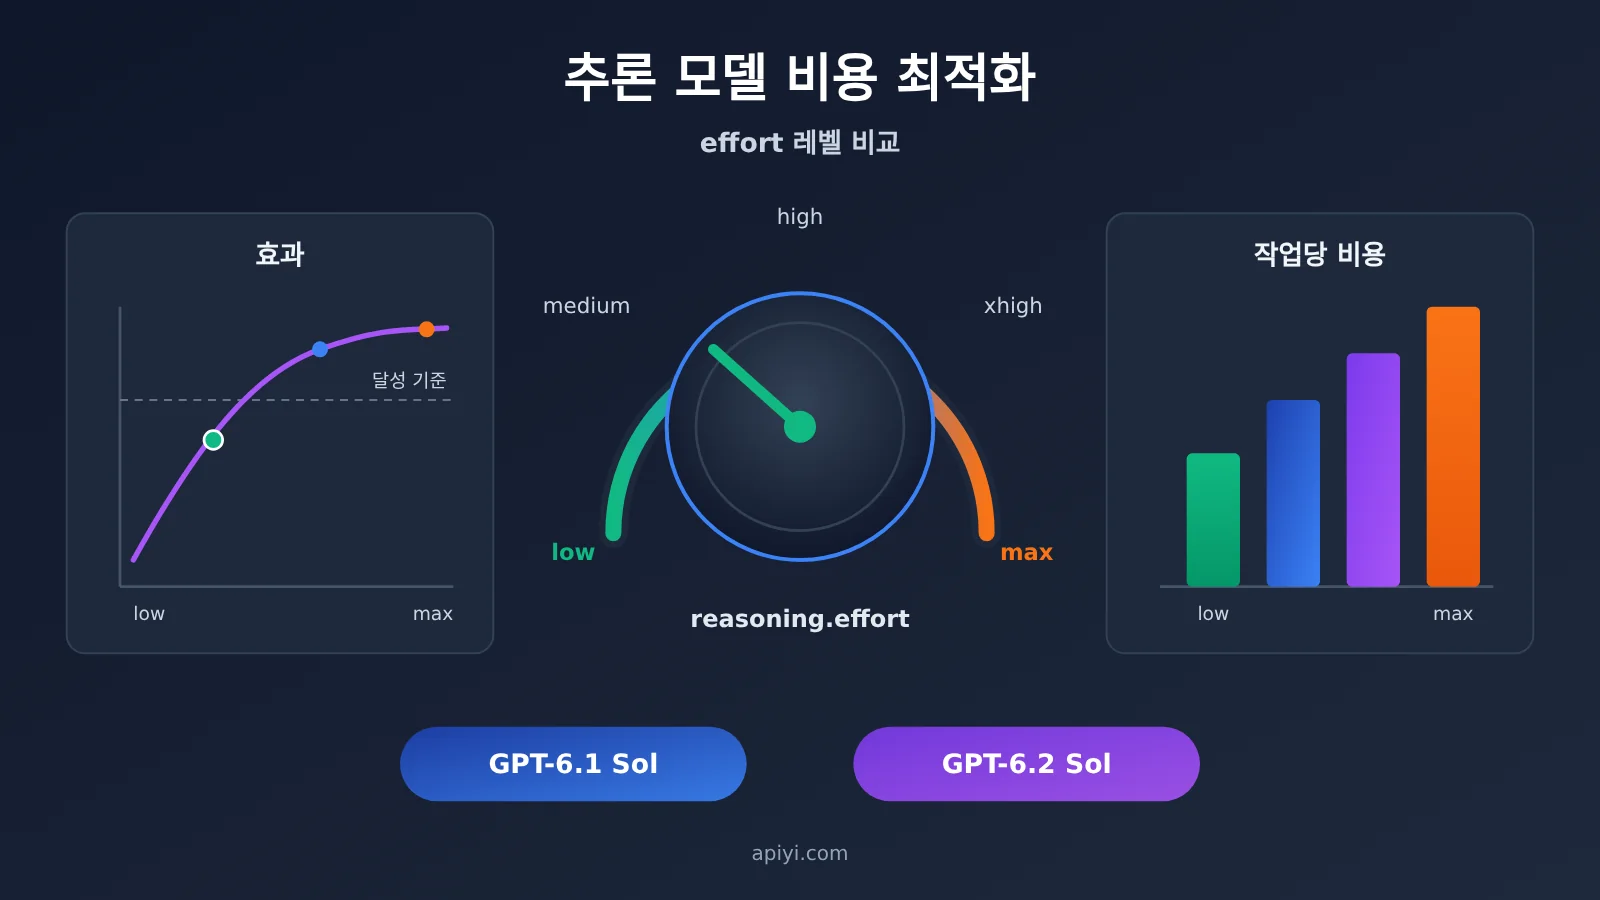
추론 모델 effort 레벨 비교 한눈에 보기
아래 표는 이 글에서 사용할 몇 가지 근거를 정리한 거예요. 각 행에는 출처와 측정 기준이 적혀 있어요. 서로 다른 출처의 숫자는 그대로 더하거나 섞어서 비교할 수 없어요.
| 비교 항목 | GPT-6.1 Sol | GPT-6.2 Sol | 차이가 의미하는 것 |
|---|---|---|---|
| 선택 가능한 레벨 (OpenAI 문서) | low, medium, high, xhigh, max | 같은 다섯 레벨, none 거부 |
none/minimal을 설정할 수 있는 모델에서 마이그레이션할 때는 시작 레벨을 바꿔야 함 |
| APIYI 짧은 컨텍스트 표기가격 (2026-11-20 전체 표, USD/백만 토큰) | 입력 $2, 캐시 읽기 $0.10, 출력 $10 | 왼쪽과 동일 | 짧은 컨텍스트에서는 두 세대 가격이 같고, 비용 차이는 주로 사용량에서 발생 |
| 272,000 입력 토큰 초과 구간의 입력 가격 | APIYI와 OpenAI Standard 모두 $4로 표기 | APIYI는 $3, OpenAI Standard는 $4로 표기 | 긴 입력 시나리오에서는 채널 간 가격 차이가 생김 |
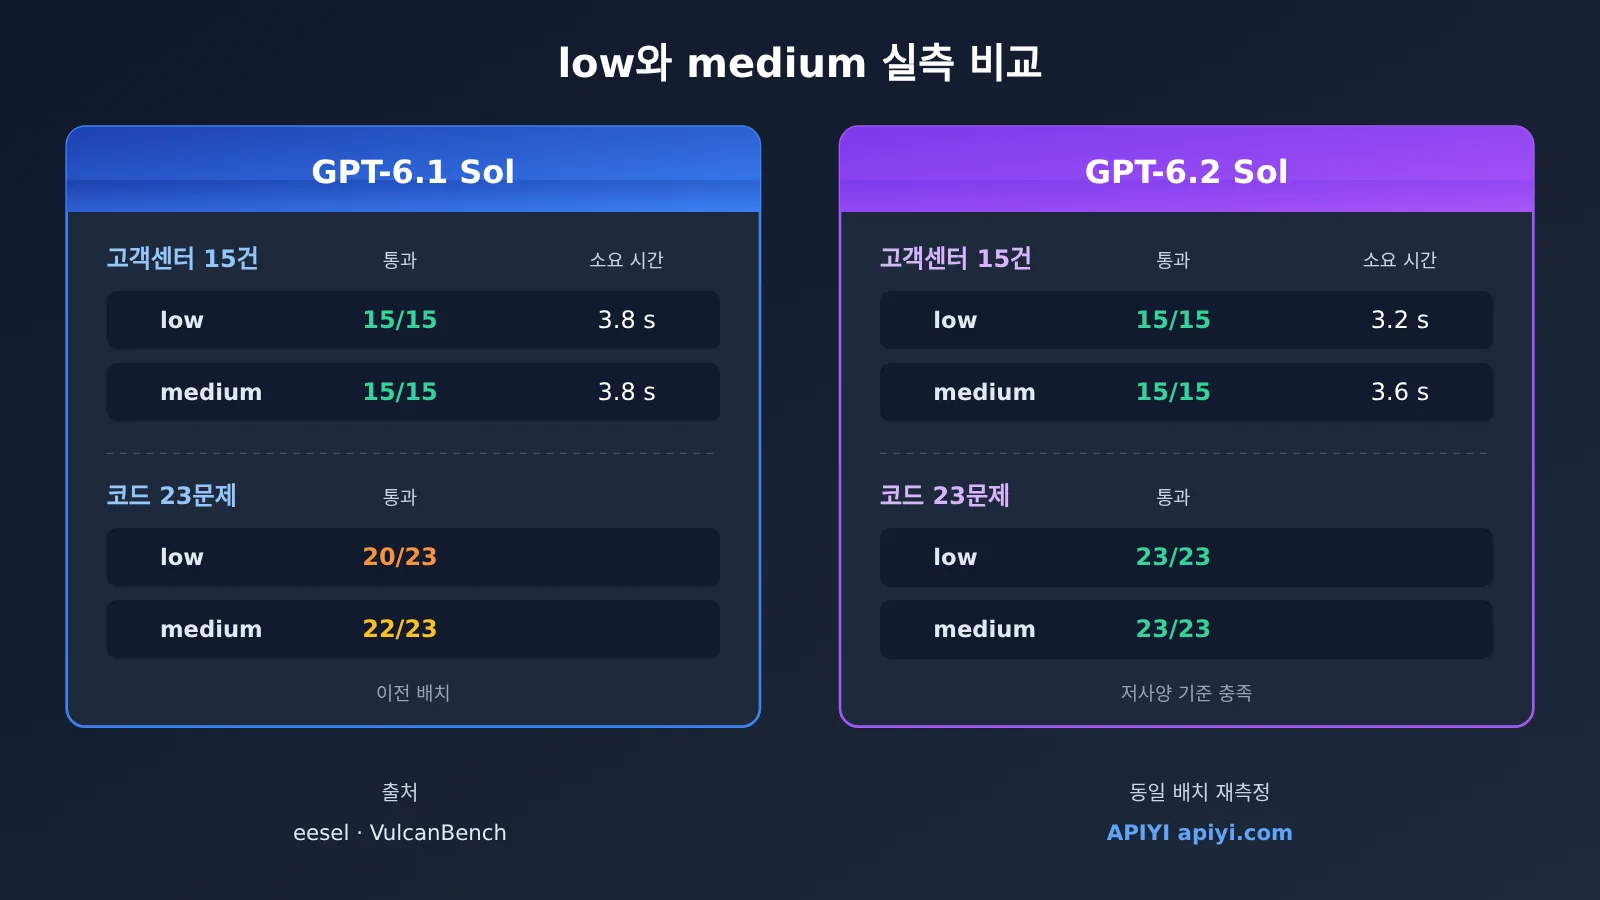
| eesel 고객 지원 15개 티켓 (low / medium) | 15/15, 3.8초; 15/15, 3.8초 | 15/15, 3.2초; 15/15, 3.6초 | 통과율은 같고, 레벨 간 비용 차이는 매우 작음 |
| VulcanBench 코드 문제 23개 (low / medium) | 20/23; 22/23 (과거 배치) | 23/23; 23/23 | 6.2 Sol은 낮은 레벨에서도 기준을 충족했고, 버전 간 숫자는 서로 다른 배치에서 나온 것 |
| Artificial Analysis Index (OrcaRouter 인용, low / medium) | 35; 46 | 41; 53 | 제3자 종합 지수이며, 레벨 라벨은 해당 벤치마크가 자체적으로 매핑한 값 |
본문은 다음 순서로 이어져요. 1절에서는 연동 가능 여부와 과금 방식을 확인하고, 2절에서는 같은 작업의 실측 결과를 살펴봐요. 3절에서는 마이그레이션과 수용 절차를 제시하고, 4절에서는 멀티턴 대화 중간에 레벨을 바꾸는 문제를 다뤄요. 이미 모델 라우팅과 가격을 확인했다면 2절부터 읽어도 돼요.
추론 effort 단계 관련 용어 알아두기
| 용어 | 설명 |
|---|---|
reasoning.effort |
Responses API에서 모델의 사고 강도를 설정하는 필드 |
| 추론 토큰 | 모델이 답을 도출하기 위해 소비하는 추론 사용량. 과금되는 output_tokens에 포함되며, 사용자가 실제로 볼 수 있는 출력과 구분해야 함 |
low / medium |
두 가지 추론 단계. 같은 단계라도 새 버전으로 옮기면 다시 검증해야 함 |
| 캐시 읽기 단가 | 재사용 가능한 프리픽스와 매칭된 입력 부분에만 적용되며, 총 토큰 수로 직접 추산할 수 없음 |
| 요청 프리픽스 | 현재 메시지 이전에 이미 존재하는 컨텍스트. 초기 이력을 수정하면 캐시와 추론 항목의 재사용에 영향이 생김 |
configuration_update |
해당 기능을 지원하는 Responses 세션에서 이후 설정을 조정하는 데 쓰이는 입력 항목 |
| 검증 기준 | 정책 정확성, 기능 통과 또는 재작업 수준에 설정하는 최소 허용 기준 |
| 달성 과제당 비용 | 전체 실험의 호출, 재시도, 도구 및 수작업 재작업 비용을 달성 과제 수로 나눈 값 |
1. 추론 모델 비용 최적화 전: effort 단계를 조정할 만한 시점
1.1 두 세대 Sol의 APIYI 연동 현황
APIYI 플랫폼 동향에 따르면 GPT-6.1 Sol은 2026-09-30에 출시됐고, GPT-6.2 Astra와 Sol은 2026-11-18에 출시가 공지됐어요. 2026-11-20 기준 가격 총표를 보면 두 Sol 모두 responses와 chat 두 라우트를 동시에 제공하며, 관련 그룹은 CodexResponses, Codex_Reverse, Default, SVIP예요. 계정에서 실제로 어떤 기능을 호출할 수 있는지는 토큰이 속한 그룹을 기준으로 판단해요.
OpenAI 문서에 따르면 두 세대 Sol 모두 Chat Completions와 Responses를 지원하지만, 도구 호출은 반드시 Responses를 거쳐야 하고, 추론 강도는 reasoning.effort로 설정해요. 그래서 주문 조회나 코드 실행 같은 도구 단계가 비즈니스에 조금이라도 들어간다면 평가든 출시든 Responses 라우트로 통일하는 게 좋아요. 두 라우트의 동작 차이가 비교 결과에 섞여 들어오는 걸 막기 위해서죠.
1.2 두 가지 가격 기준: APIYI 표시가와 업스트림 표준가
| 모델 ID(APIYI 총표, 2026-11-20) | 일반 입력 | 캐시 읽기 | 출력 | 사용 가능 플랫폼 |
|---|---|---|---|---|
gpt-6.2-sol |
$2 | $0.10 | $10 | APIYI apiyi.com, OpenAI 공식 |
gpt-6.1-sol |
$2 | $0.10 | $10 | APIYI apiyi.com, OpenAI 공식 |
gpt-6-sol |
$2 | $0.20 | $10 | APIYI |
gpt-6.2-astra |
$8 | $0.40 | $40 | APIYI |
위 표는 짧은 컨텍스트의 기본 표시가이며, 단위는 달러/백만 토큰이에요. OrcaRouter가 정리한 업스트림 가격 카드에는 두 세대 Sol의 입력, 캐시 읽기, 출력 가격이 똑같이 적혀 있고, 캐시 쓰기는 별도로 $2.50로 표시되어 있어요. 긴 컨텍스트는 따로 확인해야 하는데, gpt-6.2-sol은 입력이 272,000 토큰을 넘으면 APIYI가 현재 $3으로, OpenAI 공식 Standard가 $4로 표시해요. gpt-6.1-sol은 양쪽 모두 $4예요. 긴 구간의 캐시 가격과 출력 가격은 각 채널의 실시간 과금 규칙을 기준으로 확인하세요.
1.3 비용은 실제 응답과 청구서에서 읽어야 해요
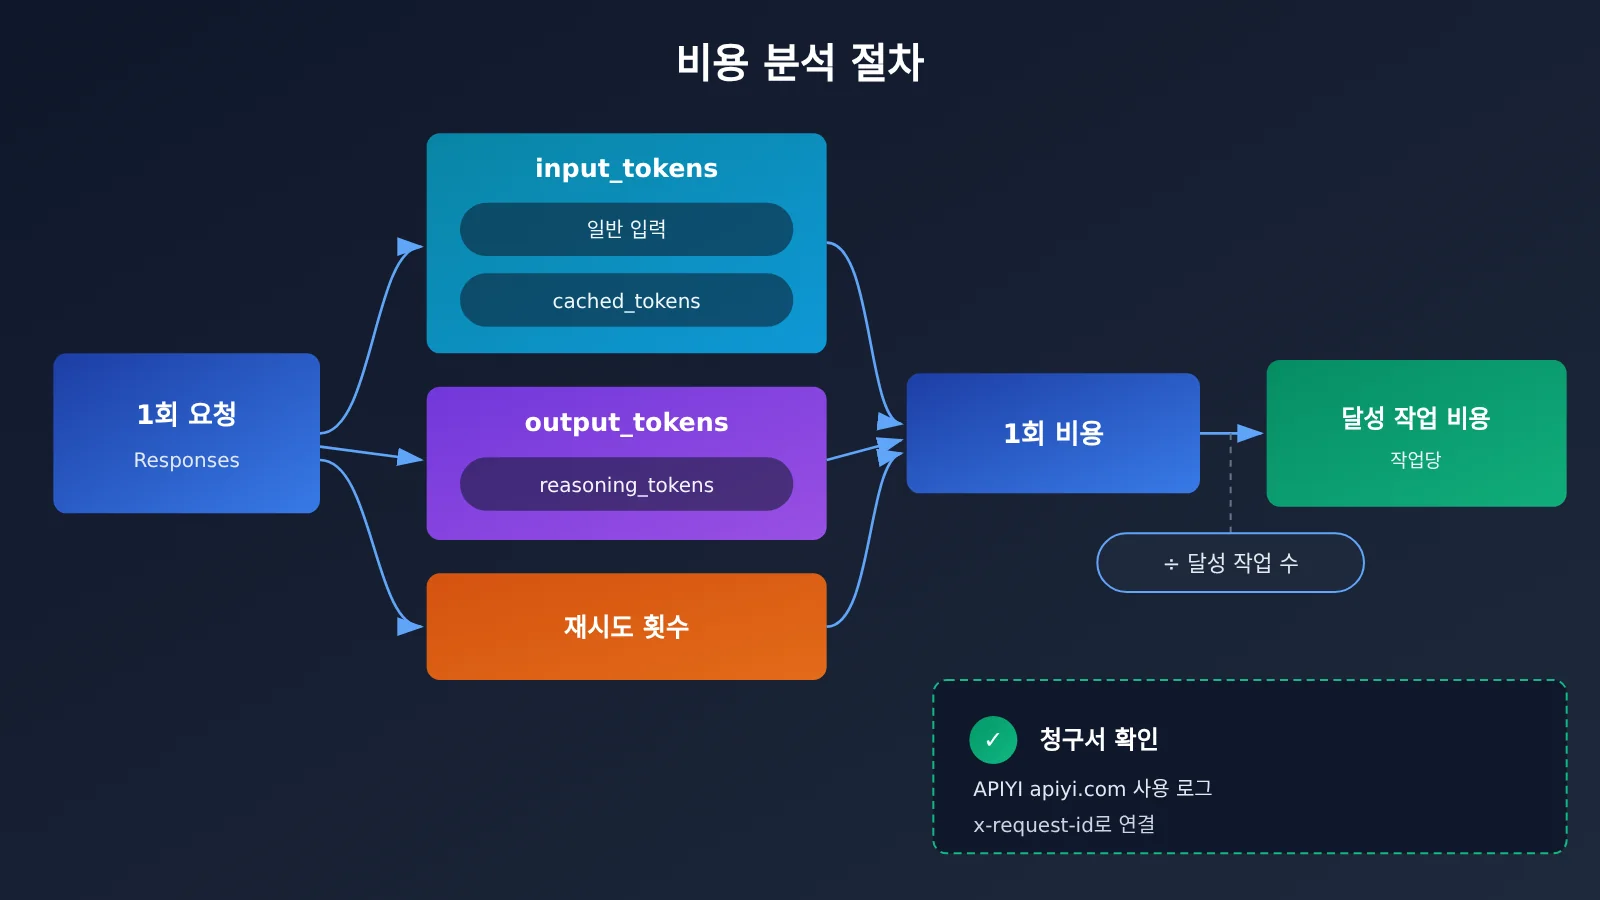
정가는 추정에만 쓸 수 있어요. 아래에서는 가상의 계산 예시로 비용이 어떻게 나뉘는지 설명할게요. 매 라운드 입력이 12,000 토큰이고, 캐시 쓰기와 도구 비용이 없다고 가정해요:
- 접두사 유지: 캐시 읽기 9,000, 총 출력 1,000, 추정 약 $0.0169.
- 접두사 수정: 캐시 읽기 3,000으로 감소, 총 출력 1,600으로 증가, 추정 약 $0.0343.
두 값의 차액 중 약 $0.0114는 6,000개 입력 토큰이 캐시 가격에서 일반 가격으로 돌아간 데서 나오고, 약 $0.0060은 추가된 600개 출력 토큰에서 나와요. 이건 가정 데이터이고, 실제 차액은 usage를 기준으로 해요. 캐시 쓰기가 별도 항목으로 존재한다면 일반 입력·캐시 읽기·캐시 쓰기를 세 가지 상호 배타적 범주로 각각 계산해야 해요.
실제 과금을 확인하는 방법: 응답 헤더의 x-request-id로 APIYI 소비 로그에서 type=2인 기록을 연결하고, quota ÷ 500,000으로 실제 청구된 달러 값을 환산해요. 동시에 모델, 토큰 그룹, 호출 시간대, 입력·출력 사용량, 재시도 횟수를 기록해 두세요.
아래는 가장 간단한 호출 예시로, 진단에 필요한 사용량 필드들도 함께 읽어 와요:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "low"},
    input=[{"role": "user", "content": "根据退款政策判断工单 #1024 是否可退"}],
)

u = resp.usage
print(resp.output_text)
print("输入:", u.input_tokens, "缓存命中:", u.input_tokens_details.cached_tokens)
print("总输出:", u.output_tokens, "其中推理:", u.output_tokens_details.reasoning_tokens)
🚀 빠른 시작: 먼저 APIYI apiyi.com에서 신규 사용자 무료 크레딧으로 위 예시를 실행해 보고, 대상 그룹이
cached_tokens와reasoning_tokens를 정상적으로 반환하는지 확인한 뒤, 배치 평가를 시작하는 걸 권장해요.
2. 동일 작업 비교: low와 medium 티어의 실측 결과
2.1 고객 지원 티켓: 낮은 티어의 이점은 크지 않아요
eesel의 테스터는 2026-11-18에 Responses API를 통해 두 세대의 Sol을 각각 low와 medium 두 티어로 테스트했고, 총 60회 호출했어요. 각 구성은 동일한 15개 티켓을 다뤘으며, 내용은 환불, 배송 조회, 주문 도구 실패였고, 사람이 가상의 SaaS 정책에 따라 점수를 매겼어요.
| 구성(eesel, 15개 티켓) | 통과 | 평균 소요 시간 | 정가 환산/1,000건 |
|---|---|---|---|
| GPT-6.1 Sol low | 15/15 | 3.8초 | $1.32 |
| GPT-6.1 Sol medium | 15/15 | 3.8초 | $1.35 |
| GPT-6.2 Sol low | 15/15 | 3.2초 | $1.41 |
| GPT-6.2 Sol medium | 15/15 | 3.6초 | $1.42 |
이 데이터에서는 low와 medium이 1,000건당 몇 센트 차이밖에 나지 않아서, 티어를 고르는 기준은 비용보다 지연 시간에 더 가까워요. 또 실제 사용량으로 환산하면 GPT-6.2 Sol이 이 고객 지원 과제 세트에서는 6.1 Sol보다 오히려 조금 더 비쌌어요. 그런데 더 중요한 점은, 네 구성 모두 통과율은 만점이었지만 6.2 Sol이 도구 응답에 존재하지 않는 배송 링크를 출력하는 사례를 발견했다는 거예요. 이 말은 고객 지원 검증에서 “정책에 맞게 답했는지”만 보면 이런 문제를 놓칠 수 있다는 뜻이에요. 링크와 필드의 출처는 따로 확인해야 해요. 이 증거는 이 티켓 세트, 이 채점 기준, OpenAI 테스트 환경에만 해당해요.
2.2 코드 작업: 낮은 등급의 문제당 비용은 직접 측정해 볼 만해요
VulcanBench는 2026-11-19에 Codex를 사용해 GPT-6.2 Sol을 동일한 23문제 테스트 세트에서 등급별로 실행했으며, 총 115회를 진행했어요. 아래 표의 금액은 실행 영수증을 기준으로 API 표준 가격으로 환산한 값이고, APIYI 계정의 실제 결제 금액은 아니에요.
| 구성(VulcanBench, 23문제) | 통과 | 평균 소요 시간 | 표준가 환산/문제 | 종합 점수 |
|---|---|---|---|---|
| GPT-6.2 Sol low | 23/23 | 2.8분 | $0.23 | 88.44 |
| GPT-6.2 Sol medium | 23/23 | 4.4분 | $0.33 | 88.94 |
| GPT-6.2 Sol max | — | 11.3분 | $0.55 | 88.74 |
| GPT-6.1 Sol low(과거 배치) | 20/23 | 6.9분 | $0.31 | — |
| GPT-6.1 Sol medium(과거 배치) | 22/23 | 10.6분 | $0.40 | — |
GPT-6.2 Sol만 보면, low와 medium의 통과 수는 같지만 문제당 비용은 약 30% 낮고 소요 시간도 더 짧아요. max의 종합 점수는 medium을 넘지 못했고요. 버전 간 비교는 신중해야 해요. 6.1 Sol 데이터는 같은 문제 세트의 과거 평가에서 가져온 것으로, 서로 다른 테스트 배치에 속하거든요. 종합 점수는 코드 품질 평가이고 통과율은 또 다른 지표라서, 두 지표를 서로 대신할 수는 없어요.
OrcaRouter가 인용한 Artificial Analysis Index v5.0.1(2026-11-20 조회)은 또 다른 관점을 보여줘요. low 등급에서 6.2 Sol은 41점, 작업당 $0.18이고, 6.1 Sol은 35점, $0.16이에요. medium 등급에서는 각각 53점, $0.41과 46점, $0.36이고요. 이 종합 순위표의 등급 라벨은 평가 기관이 자체적으로 매핑한 방식이라, 여러분이 사용하는 프레임워크가 같은 매핑을 쓰지 않을 수도 있어요.
💡 선택 제안: 위 두 가지 실측 결과는 통과 기준선, 재시도율, 수동 재작업이 모두 “가장 경제적인 등급”을 바꿀 수 있다는 걸 보여줘요. 하지만 그 어느 것도 여러분 비즈니스의 실제 청구서는 아니에요. APIYI apiyi.com에서 같은 그룹, 같은 샘플 배치로 다시 측정한 뒤에 결정하시길 권해요.
3. 추론 모델 비용 최적화를 위한 마이그레이션 순서와 검증 기준
3.1 먼저 베이스라인을 유지한 뒤, 단계(티어)를 조정하세요
OpenAI 《Using GPT-6.2》의 권장 사항에 따르면, 마이그레이션할 때 한 번에 하나의 변수만 바꿔야 해요:
- 현재 6.1 Sol
low사용 중: 먼저 6.2 Sollow로 교체해 대조군을 만들고, 그다음medium을 별도로 테스트하세요. - 현재 6.1 Sol
medium사용 중: 먼저 모델만 바꾸고medium은 유지하세요. 검증을 통과한 뒤, 동일한 작업 묶음으로low를 비교하세요. - 신규 도입:
medium부터 시작하세요. none또는minimal을 설정할 수 있는 모델에서 마이그레이션하는 경우: GPT-6.2 Sol은low부터 테스트하세요.
제약이 명확한 단순 작업은 low부터 검증을 시작할 수 있고, 복합 작업은 결과에 따라 단계적으로 티어를 올리면 돼요. 평가 기간 동안에는 프롬프트, 도구 정의, 그룹, 테스트 샘플을 고정해야 해요. 동시에 공식 안내에 따라 더 이상 적용되지 않는 파라미터를 정리하세요. 예를 들어 Responses 요청에서는 temperature, top_p, top_logprobs를 제거하는 식이에요.
3.2 시나리오별로 검증 기준을 정의하세요
| 시나리오 | 검증 기준 | 티어 업그레이드를 고려할 시점 |
|---|---|---|
| 일반 고객 지원 | 정책 일관성, 금액 필드 정확성, 인간 상담원 이관 트리거 조건; 링크와 단일 번호는 반드시 도구 반환값에서 가져와야 함 | 정책 충돌이 얽히거나 여러 도구를 연쇄 호출할 때 |
| 코드 수정 | 테스트 통과, 핵심 기능 완성도, 코드 리뷰 재작업량 | 낮은 티어의 통과율이 떨어지거나 재작업이 눈에 띄게 늘어날 때 |
| 짧은 콘텐츠 | 제약 준수, 사실 필드, 수동 수정 소요 시간 | 제약 누락이나 사실 오류가 나타날 때 |
각 기준을 통과한 작업의 비용은 호출, 재시도, 도구, 수동 재작업 비용을 모두 합산한 뒤 통과한 작업 수로 나눠 계산해요. low가 합의된 기준을 충족하기만 하면 low를 선택해도 돼요. 다만 low에서 재시도가 여러 번 필요하거나 수동 보완이 발생하면, 장부상의 저렴함이 상쇄될 수 있어요.
💰 비용 최적화: 티어 비교를 진행할 때 APIYI apiyi.com에서 평가 전용 토큰을 별도로 생성하면, 로그를 토큰과 모델 기준으로 바로 필터링할 수 있어 전체 실험의 실제 비용을 간편하게 산정할 수 있어요.
4. 멀티턴 대화 중간에 effort 단계 조정하기
4.1 configuration_update로 단계 조정하고 프리픽스 유지하기
이 기능을 지원하는 OpenAI HTTP Responses 단일 에이전트 세션에서는 요청 수준의 reasoning.effort를 초기값 그대로 두고, 아래 항목을 다음 사용자 메시지 앞에 넣습니다.
{"type": "configuration_update", "reasoning": {"effort": "medium"}}
이 설정은 다음 업데이트 전까지 계속 적용됩니다. 이렇게 하면 초기 이력을 다시 쓸 필요가 없고 요청 프리픽스가 그대로 유지된다는 장점이 있어요. OpenAI 문서에 따르면 GPT-6.2부터는 초기 이력을 편집하면 prefix_mismatch가 발생할 수 있고, 이로 인해 기존 추론 항목이 제거될 수 있어요. 모델 패밀리를 바꾸거나 성능이 더 낮은 모델로 내려가도 추론 항목이 제거될 수 있습니다. 프리픽스를 다시 쓰는 비용은 두 가지예요. 캐시 읽기가 줄어들 수 있고, 사용 가능한 추론 항목을 잃은 뒤 새 추론 출력이 생성될 수도 있습니다. 공식 설명에 따르면 항목을 통째로 삭제하고 나머지 항목은 그대로 두거나, 추론 항목 뒤에 새 항목을 추가하는 경우에는 이 제거가 발생하지 않지만 캐시 적중량은 여전히 달라질 수 있어요. 또한 GPT-6.2의 최상위 instructions는 input 뒤에 추가되며, 캐시되지 않은 입력으로 청구됩니다.
4.2 컨텍스트 압축과 APIYI 라우팅 주의사항
서버 측 context_management를 사용할 때는 업데이트된 설정을 계속 이어갈 수 있어요. 이전 configuration_update가 포함된 이력을 독립적인 /responses/compact 엔드포인트에 그대로 넘기면 요청이 거부됩니다. 올바른 방법은 공식 설명대로 먼저 설정 항목을 분리하고, 압축이 끝난 뒤 최신 설정 한 건을 추가하는 것입니다.
APIYI에서는 현재 input 이력을 직접 관리하고 previous_response_id에 의존하지 않는 방식이 안전합니다. 그 이유는 APIYI 네이티브 호출 가이드의 기록이 서로 일치하지 않기 때문이에요. 본문에서는 체인형 이어붙이기가 동작하지 않는다고 하는데, FAQ에는 2026-09-02에 실제로 사용할 수 있었다고 기록되어 있습니다. APIYI 문서에는 현재 각 그룹에서 configuration_update를 검증한 결과도 나와 있지 않아요. 따라서 이런 특수 설정, 암호화된 추론 항목의 반환, 캐시 진단 필드는 대상 채널에서 짧은 세션으로 먼저 따로 검증하고, 사용 가능한 것을 확인한 뒤 정식 워크플로에 연결해야 합니다.
🎯 기술 제안: APIYI apiyi.com의 Responses 라우트에서 먼저 두 턴짜리 짧은 세션을 실행해 보세요. ‘추가만 하기’와 ‘프리픽스 다시 쓰기’ 두 샘플의
cached_tokens,reasoning_tokens, 소요 시간을 비교한 뒤 동작을 확인하고 나서 중간에 단계를 조정하는 구현 방식을 정하는 게 좋습니다.
마지막 한마디: 단계를 선택하는 기준은 고정된 검수 기준을 통과한 작업당 비용이어야 합니다. APIYI apiyi.com에서 자신의 샘플과 청구 내역으로 한 차례 대조 실험을 해 보는 것이 어떤 순위표보다도 문제를 더 잘 설명해 줍니다.
참고 자료
- OpenAI 《Using GPT-6.2》: 마이그레이션 및 시작 설정 권장 사항
- 링크:
developers.openai.com/api/docs/guides/latest-model
- 링크:
- OpenAI 《Reasoning models》:
configuration_update및 추론 항목 재사용- 링크:
developers.openai.com/api/docs/guides/reasoning
- 링크:
- OpenAI 《Compaction》: 컨텍스트 압축 규칙
- 링크:
developers.openai.com/api/docs/guides/compaction
- 링크:
- OpenAI 《Keep the prefix unchanged》: 프리픽스 및 캐시 진단
- 링크:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- 링크:
- eesel AI 《GPT-6.2 Sol: what’s new, pricing, benchmarks》: 고객 지원 티켓 실측, 2026-11-18
- 링크:
eesel.ai/blog/gpt-6-2-sol
- 링크:
- VulcanBench 《GPT-6.2 Sol across effort levels》: 코드 문제 단계별 평가, 2026-11-19
- 링크:
vulcanbench.com/benchmarks/swe-v4-gpt62-sol-v331.html
- 링크:
- OrcaRouter 《GPT-6.2 vs GPT-6.1 Sol》: 가격표 및 종합 지수 인용, 2026-11-20
- 링크:
orcarouter.ai/blog/gpt-6-2-vs-gpt-6-1-sol
- 링크:
- APIYI 《모델 가격 총표》: 데이터 업데이트 2026-11-20
- 링크:
docs.apiyi.com/models
- 링크:
작성자: APIYI 기술팀
기술 문의: APIYI apiyi.com 홈페이지에서 저희에게 연락 주시면 됩니다. 더 많은 연동 안내는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요.