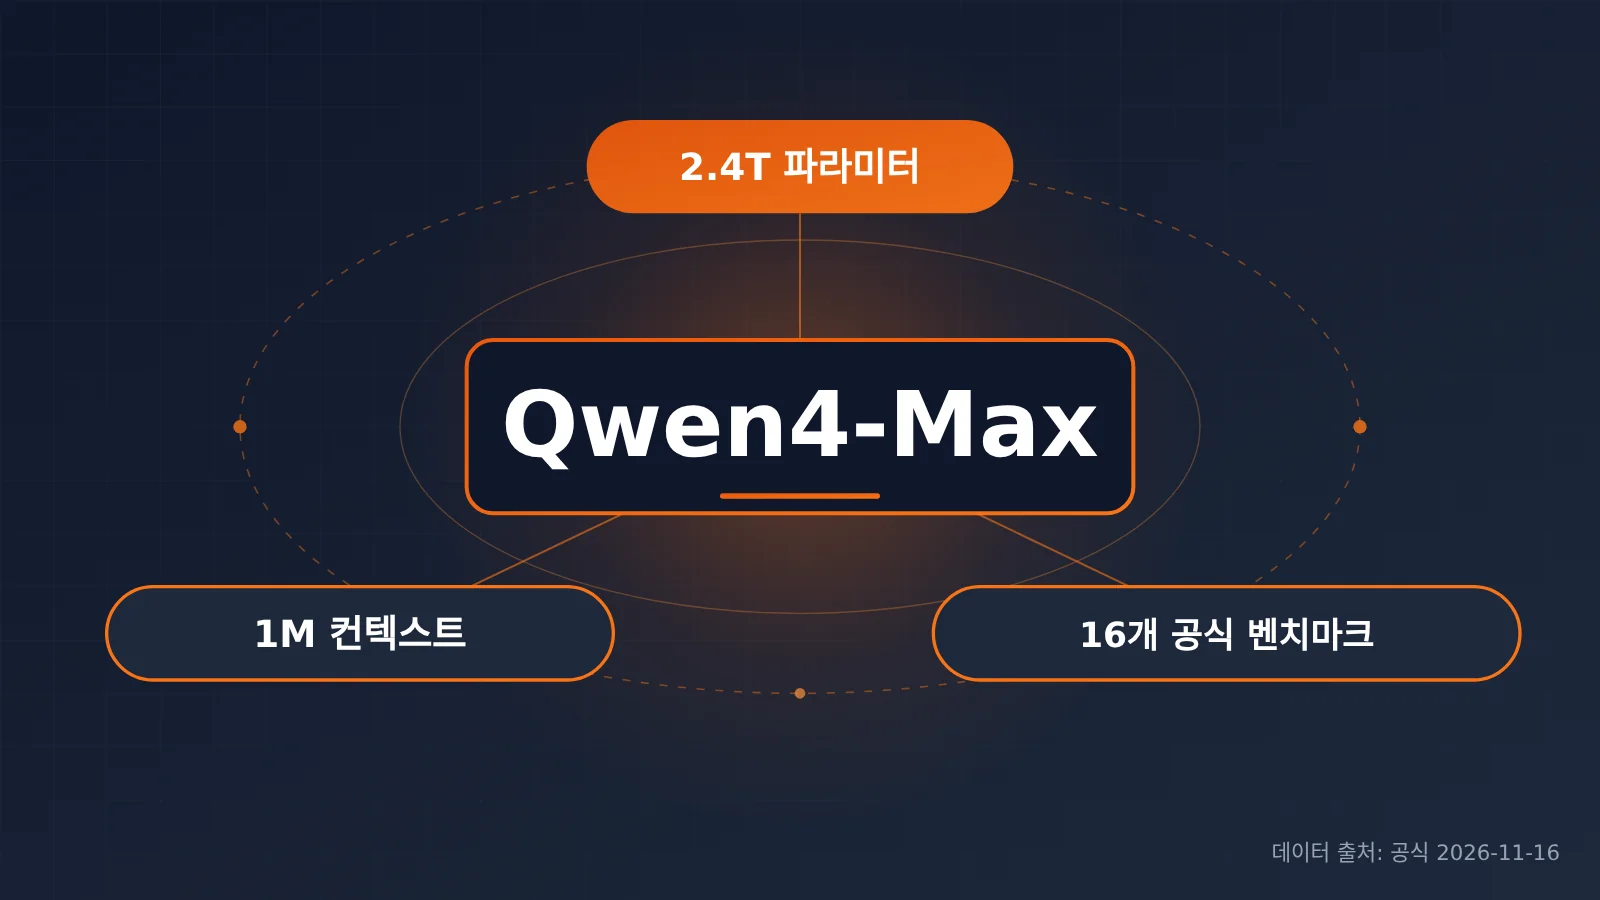
알리바바 통이(Tongyi) 팀이 2026-11-16 오전에 Qwen4-Max를 공개했어요. 백본 파라미터는 2.4T, 컨텍스트 윈도우는 1M이며, 동시에 16개 항목의 벤치마크 점수를 담은 비교표도 함께 내놓았죠.
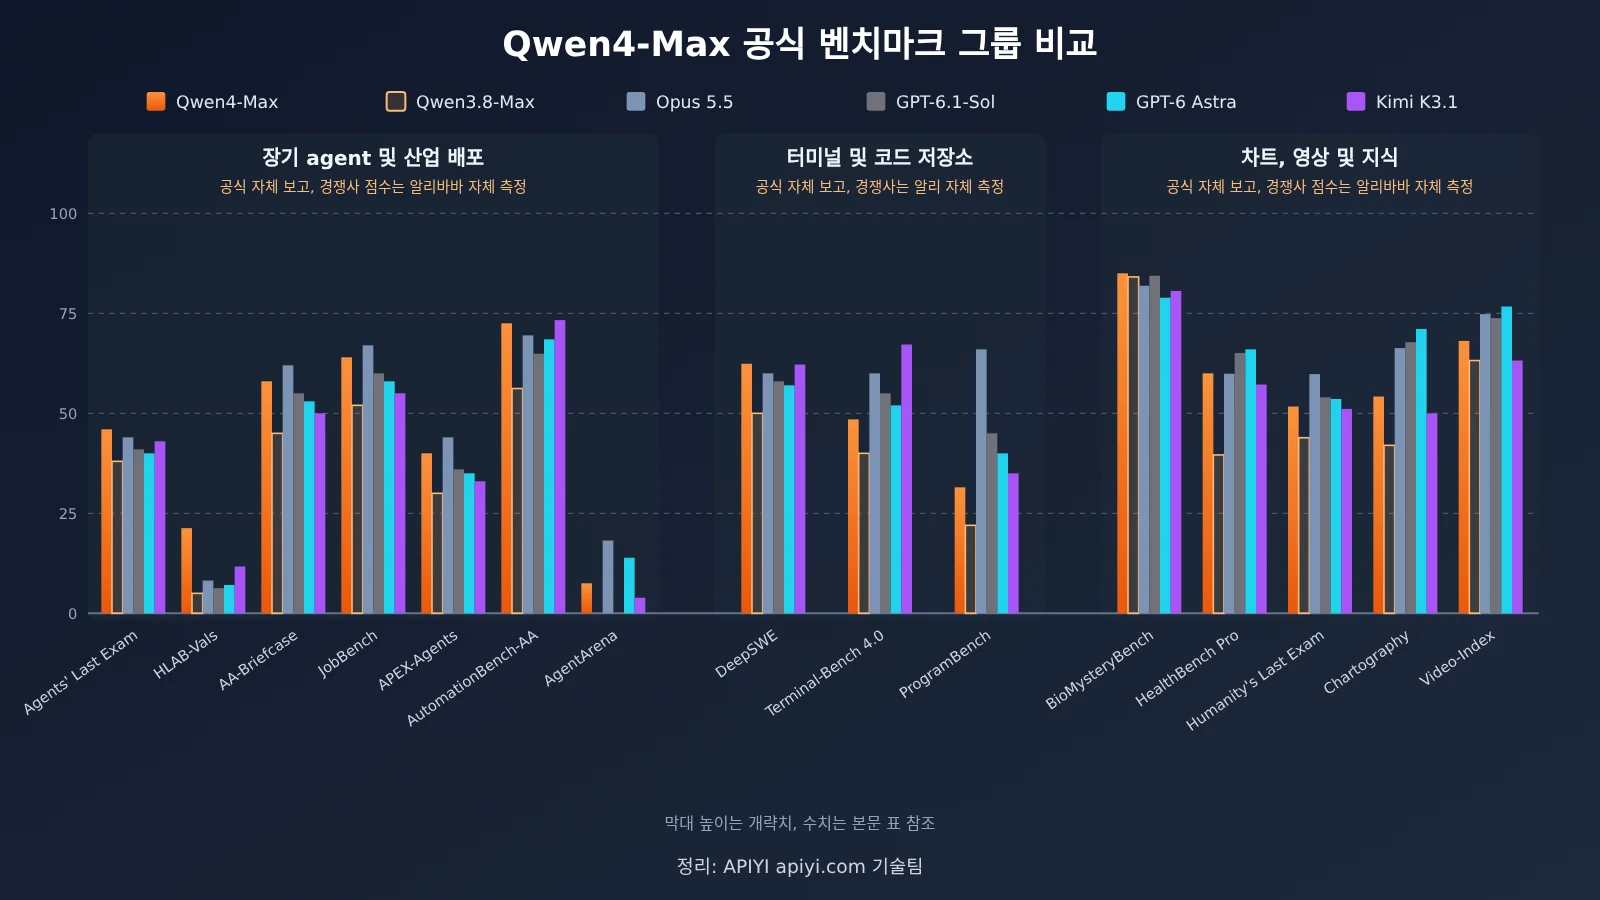
먼저 결론부터 말하자면, Qwen4-Max가 진짜로 앞서는 분야는 토큰 효율과 장기 작업 완수 능력이고, 모든 항목에서 1위를 차지한 것은 아니에요. 16개 항목의 공식 자체 보고 벤치마크에서는 1위 4개, 2위 4개를 기록했어요. 터미널 조작, 프로그램 빌드, 차트 이해, 비디오 이해 항목은 같은 표에 있는 상위 경쟁 모델보다 여전히 확실히 뒤지고 있고요.
이 글의 정보 출처는 세 가지뿐이에요: 2026-11-16 공식 발표 자료, arena.ai Code Arena WebDev 공개 리더보드의 최종 스냅샷(2026-11-14), 그리고 QwenCloud와 Qianwen AI 플랫폼 두 곳의 공시 가격이에요. 공개되지 않은 파라미터 세부 사항과 제3자 재현 결과는 이 글에서 다루지 않아요. 지금 Qwen3.8-Max나 다른 플래그십 모델을 운영 중이라면, 이 글을 읽고 세 가지 작업 유형별로 교체 여부를 판단한 뒤 입력 단가·출력 단가·캐시 단가로 직접 비용을 계산해 보세요.
Qwen4-Max 출시 정보 한눈에 보기
| 항목 | 상세 |
|---|---|
| 출시 시각 | 2026-11-16 10:01 (UTC+8) |
| 출시 주체 | 알리바바 통이치엔원(Qwen) 팀 |
| 파라미터 규모 | 2.4T 백본 파라미터, 토큰당 71B 활성화, 별도로 328B N-gram Embedding 파라미터 |
| 컨텍스트 | 1M, 네이티브 비전 |
| 공식 채널 | QwenCloud API, Qwen Studio, QwenWork, Qoder, 첸원 앱 |
| 오픈소스 계획 | 더 작은 크기의 Qwen4는 가중치를 공개한다고 밝혔지만, Max 자체의 오픈소스화는 언급하지 않음 |
출시 흐름을 보면 이번은 단순한 API 모델 하나의 업데이트가 아니에요. Qwen4-Max는 자사 제품인 QwenWork(오피스)와 Qoder(프로그래밍)에 동시에 투입됐고, 공식 자료도 에이전트의 장기 과제와 산업 현장 적용에 초점을 맞추고 있어요. 순수 질의응답 능력을 전면에 내세우지는 않았죠.
Qwen4-Max 아키텍처의 세 가지 변경
공식 블로그에서 세 가지 구조 변경을 제시했는데, 각각 어떤 문제를 해결하는지 하나씩 살펴볼게요.
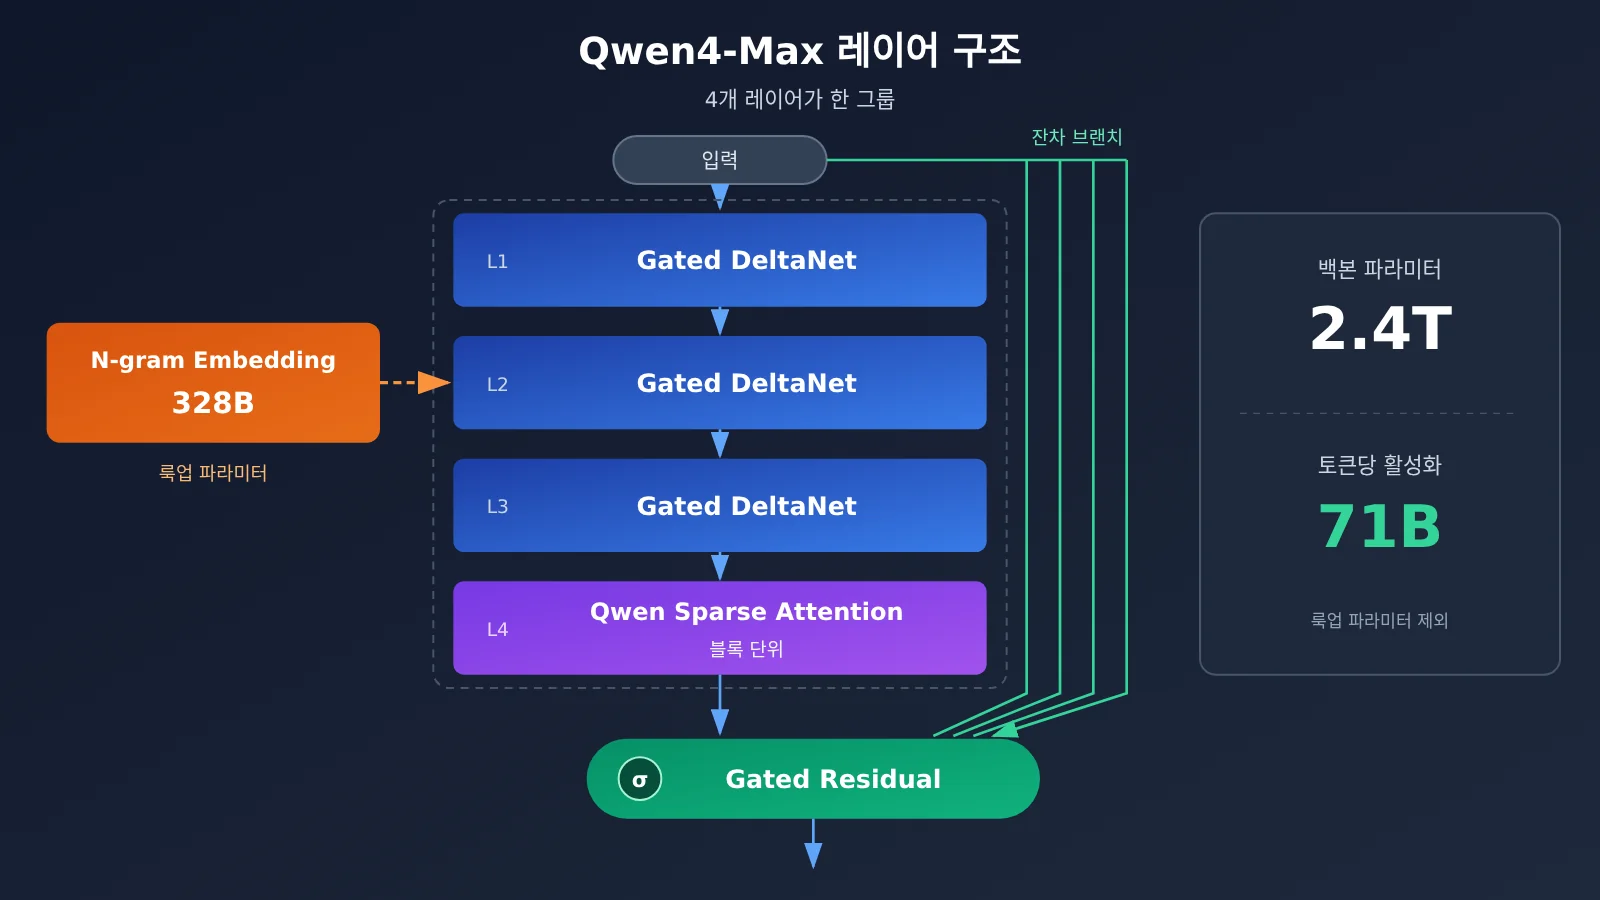
- GDN + QSA 하이브리드 어텐션: 4개 층 중 3개 층은 Gated DeltaNet을, 나머지 한 층은 Qwen Sparse Attention을 사용하며 block 단위로 컨텍스트를 선택해요. 이렇게 배치한 주된 목적은 1M 장문 컨텍스트에서의 연산 오버헤드를 줄이는 거예요.
- Gated Residual: 잔차 경로를 4개의 병렬 브랜치로 나눈 뒤 게이팅으로 합쳐서, 깊은 네트워크의 표현력을 끌어올리는 데 사용해요.
- N-gram Embedding: 두 번째 층에서 룩업 테이블을 조회해 로컬 토큰 패턴을 보완해요. 328B의 추가 파라미터가 여기서 나오는데, 룩업 파라미터라서 토큰당 활성화 연산에는 참여하지 않아요.
한 가지 짚고 넘어갈 점이 있어요. 2.4T는 백본 파라미터 총량이고, 토큰당 실제로 활성화되는 건 71B예요. 다른 모델과 “파라미터 크기”를 비교할 때는 양쪽이 같은 기준을 쓰고 있는지 먼저 확인해야 해요.
Qwen4-Max 사양과 프로토콜
| 사양 항목 | Qwen4-Max |
|---|---|
| 컨텍스트 윈도우 | 1M |
| 최대 입력 | 991K (사고 모드에서는 983K) |
| 최대 출력 | 393K |
| 최대 사고 과정 | 262K |
| TPM | 500만 |
| 호환 프로토콜 | OpenAI Chat Completions, Responses, Anthropic Messages, DashScope |
기본 reasoning_effort |
high (Qwen3.8-Max는 기본값이 xhigh) |
마지막 줄은 쉽게 지나치기 쉬워요. Qwen4-Max의 기본 추론 단계는 high로, 이전 세대의 기본값인 xhigh보다 한 단계 낮아요. 기본 파라미터로 신구 세대를 그대로 비교하면, 토큰이 줄어든 부분 중 일부는 단계 차이에서 나온 것이지 전적으로 모델 자체에서 나온 게 아니에요. A/B 테스트를 할 때는 reasoning_effort를 같은 값으로 명시해 두는 걸 권해요.
Qwen4-Max 16개 공식 벤치마크: 앞서는 항목과 뒤지는 항목
아래 표의 모든 점수는 공식 발표된 동일한 차트에서 가져온 공식 자체 보고 수치예요. 차트에 나온 경쟁 모델 점수 역시 알리바바가 직접 측정한 것이라, Anthropic, OpenAI, Moonshot AI가 공식 발표한 성적으로 받아들이면 안 돼요. 이 가운데 CodeArena와 AgentArena는 LM Arena에서, AA-Briefcase와 AutomationBench-AA는 Artificial Analysis에서 인용했고, APEX-Agents는 Mercor 리더보드에서, JobBench는 알리바바가 업데이트된 데이터셋과 평가 코드로 직접 테스트한 결과예요.
| 벤치마크 | Qwen4-Max | Qwen3.8-Max-0902 | Opus 5.5 | GPT-6.1-Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 |
| CodeArena WebDev (Elo) | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 |
| ProgramBench | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 |
| AA-Briefcase v1.1 (Elo) | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam v1.1 | 46.7 | 27.9 | 43.4 | 42.6 | 43.4 | 미표기 |
| JobBench | 68.5 | 65.3 | 75.4 | 66.2 | 66.1 | 61.2 |
| APEX-Agents v1.1 | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 |
| HLAB-Vals-1.1 | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 |
| AutomationBench-AA | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 |
| AgentArena (Net Improvement) | 7.5 | — | 18.2 | — | 13.9 | 3.9 |
| BioMysteryBench | 85.0 | 84.1 | 81.9 | 84.4 | 78.9 | 80.6 |
| HealthBench Professional | 60.0 | 39.6 | 59.9 | 65.1 | 66.0 | 57.2 |
| Humanity’s Last Exam | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 |
| Chartography | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 |
| Video-Index | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 |
Qwen4-Max가 앞서는 항목
Qwen4-Max가 1위를 차지한 항목은 네 개예요. DeepSWE, Agents’ Last Exam, HLAB-Vals, BioMysteryBench가 바로 그것들이죠. 그중 HLAB-Vals의 격차가 가장 큰데, 21.3점은 2위인 Kimi K3.1의 약 두 배에 달해요. DeepSWE는 Kimi보다 고작 0.2점 높은 수준이라, 이 차이는 사실상 동률로 봐도 무방해요.
나머지 네 항목에서는 2위를 기록했어요. AA-Briefcase, JobBench, APEX-Agents, AutomationBench-AA가 여기에 해당해요. 앞의 세 항목 1위는 모두 Opus 5.5이고, 마지막 항목의 1위는 Kimi K3.1이에요. 이 벤치마크들은 모두 장기 실행 에이전트와 사무직 업무 결과물 전달 쪽에 치우쳐 있는데, 이는 공식 측이 이번에 주력으로 내세운 방향이기도 해요.
Qwen4-Max가 뒤처지는 항목
터미널과 프로그램 빌드가 이번의 가장 뚜렷한 약점이에요. Terminal-Bench 4.0에서 48.5점으로 여섯 모델 중 5위를 기록했는데, 1위인 Kimi보다 18.7점 낮은 점수예요. ProgramBench의 31.5점은 Opus 5.5의 절반에도 미치지 못해요. 여러분의 에이전트가 주로 셸에서 빌드, 디버깅, 배포를 실행한다면, 이 두 항목이 DeepSWE보다 참고 가치가 더 커요.
차트와 영상 이해 능력도 마찬가지로 뒤처져요. Chartography와 Video-Index는 둘 다 4위에 머물렀는데, 1위인 GPT-6 Astra와 각각 16.9점, 8.6점 차이가 나요. Humanity’s Last Exam 역시 4위예요. 그래서 “네이티브 비전”이라는 말은 해당 능력을 갖추고 있다는 뜻이지, 이 분야에서 앞선다는 의미는 아니에요.
Qwen4-Max, Code Arena 공개 리더보드에서의 위치
arena.ai Code Arena WebDev의 공개 리더보드 최종 스냅샷(2026-11-14)에는 총 1,007,405표, 159개 모델이 올라 있어요. Qwen4-Max(xHigh)는 1750점으로 6위에 이름을 올렸고, Preliminary로 표시되어 있으며 표 수는 1,814장에 불과해요. 페이지에 표시된 단일 작업 비용 P50은 $4.18이에요. 앞서 있는 모델은 차례로 Claude Fable 5.2, Claude Opus 5.5, Claude Sonnet 5.5, Gemini 4 Carbon(Preliminary), GPT-6 Astra예요.
이전 세대 Qwen3.8-Max(0902)는 같은 리더보드에서 1676점, 16위였으니, 이번 세대는 74점, 10계단 올라선 셈이에요. 다만 Qwen4-Max의 표 수가 아직 적어서 이후 순위는 더 바뀔 수 있어요.
Qwen4-Max의 token 효율과 “비용 60% 절감”은 어디서 왔나
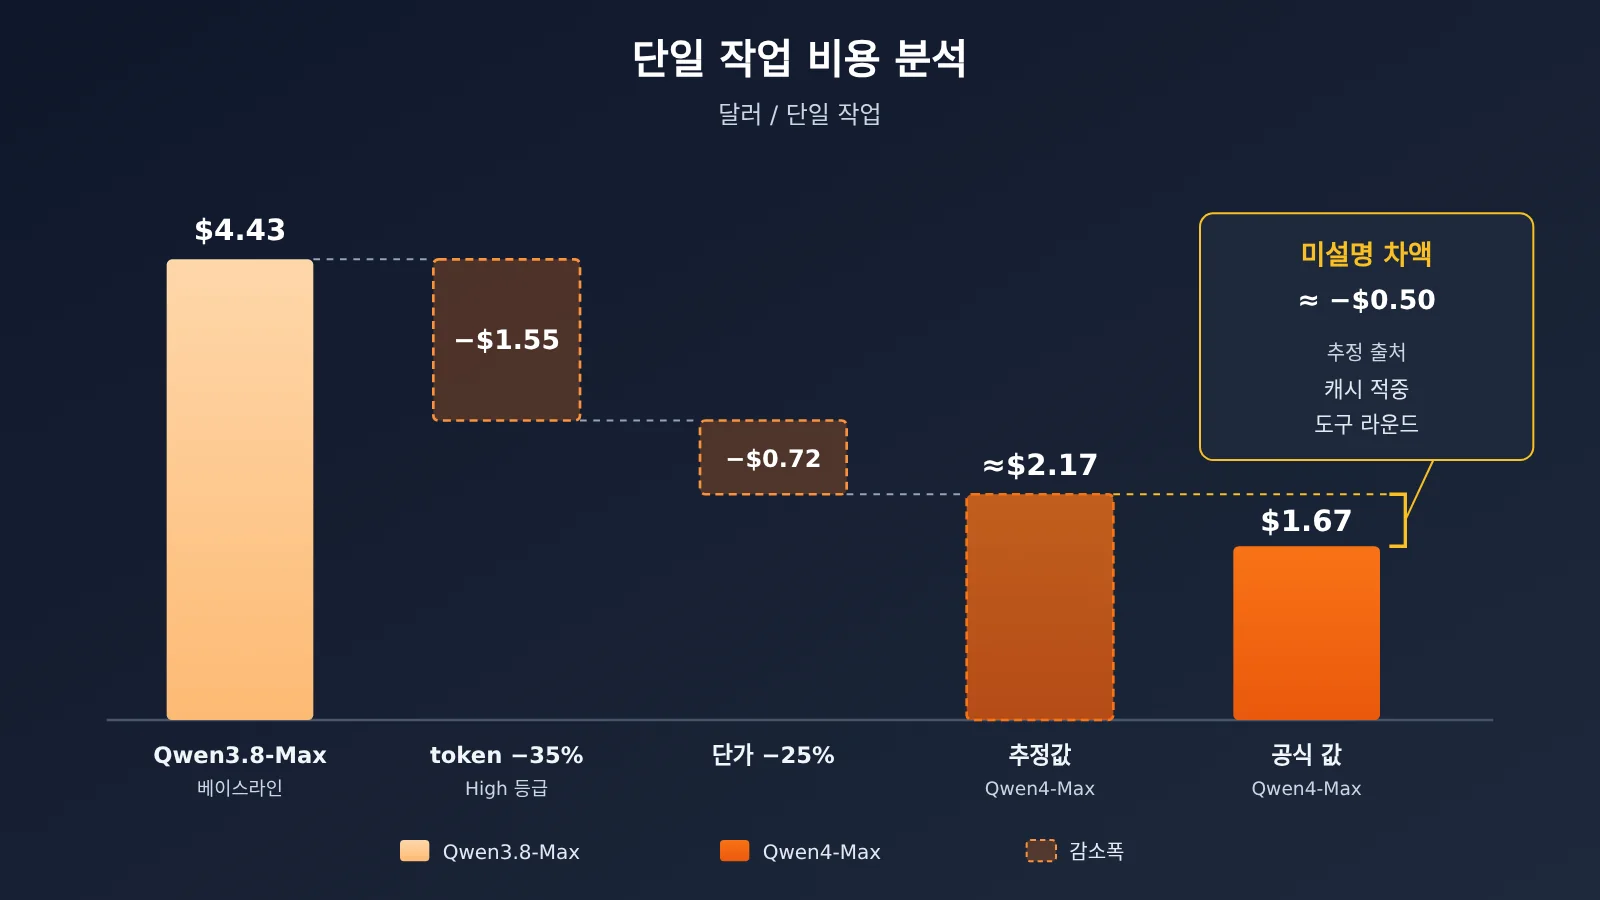
공식 효율 수치는 자체 구축한 Work360 시나리오 벤치마크에서 나왔어요. 이 벤치마크는 26개의 1차 영역, 182개의 2차 영역, 721개의 3차 영역으로 구성되어 있고, Qwen4-Max는 52.69점, Qwen3.8-Max는 47.74점을 기록했어요. token 소비량을 보면 Work360의 Xhigh 등급은 약 24%, High 등급은 약 35% 더 적어요. Terminal-Bench 4.0에서는 두 등급이 각각 약 48%와 49% 더 적게 써요.
단일 작업 평균 비용은 공식 수치가 $4.43에서 $1.67로 떨어졌고, 중국 블로그 기준으로는 ¥26.58에서 ¥11.16으로 58% 줄었어요. 달러 수치로 계산한 감소 폭은 약 62%예요. 하지만 “token 35% 절감 × 단가 25% 인하”만으로 추산하면 약 0.65 × 0.75 ≈ 0.49, 즉 약 51% 감소에 그쳐요. 이 중간 차액에 대해 공식은 설명하지 않았어요. 그럴듯한 원인으로는 캐시 적중률 상승과 도구 호출 라운드 감소가 꼽히지만, 이는 어디까지나 추측일 뿐 확인된 원인으로 보기는 어려워요.
보안 측면에서는 Last Secure Code Bench 함수 단위의 “기능 및 취약점 동시 통과율”이 22.0%에서 31.8%로 올랐어요. 함수, 파일, 리포지토리 세 가지 단위 모두 안전한 코드를 생성한 비율은 8%에서 14.7%로 높아졌어요. 절대값은 여전히 낮은 편이라, 생성된 코드는 여전히 수동 검토가 필요해요.
Qwen4-Max 가격은 어떻게 계산하나요?
아래에 Qwen4-Max의 공식 가격과, 이전 세대 모델의 공식 가격 및 APIYI 현재 가격을 정리했어요. 단위는 모두 달러 / 1M tokens이고, 기준일은 2026-11-16이에요.
| 과금 항목 | Qwen4-Max (QwenCloud 공식) | Qwen3.8-Max (공식) | qwen3.8-max (APIYI apiyi.com 현재 가격) |
|---|---|---|---|
| 입력 | $1.5 | $2 | $1.65 |
| 출력 | $4.5 | $6 | $4.95 |
| 캐시 읽기 / 적중 | $0.075 | $0.25 | $0.20625 |
| 5분 명시적 캐시 생성 | $1.875 | — | — |
| 1시간 명시적 캐시 생성 | $3 | — | — |
위안화 가격은 Qwen AI 플랫폼 기준이며, 단위는 위안 / 1M tokens, 기준일은 2026-11-16이에요:
- 입력 ¥10, 출력 ¥30, 캐시 적중 ¥0.5
- 5분 명시적 캐시 생성 ¥12.5, 1시간 명시적 캐시 생성 ¥20
이전 세대 공식 가격과 비교하면 Qwen4-Max의 입력 가격과 출력 가격은 각각 25% 낮고, 캐시 읽기 가격은 70% 낮아요. 캐시 읽기 가격의 인하 폭이 가장 커서 장시간 실행되는 에이전트에 미치는 영향이 커요. 다중 턴 작업에서는 반복되는 시스템 프롬프트와 과거 컨텍스트가 많아 캐시 가격으로 과금되기 때문이죠.
비용을 직접 추산할 때는 다음 공식처럼 나눠서 계산해 보세요: 캐시 미적중 입력 × 입력 가격 + 캐시 적중 × 캐시 가격 + 명시적 캐시 생성량 × 생성 가격 + 출력(사고 사슬 포함) × 출력 가격. 가정 예를 하나 들어볼게요. 한 작업에 입력이 1M 있고, 그중 60만이 캐시에 적중했으며 출력이 10만이라고 해요. Qwen4-Max 공식 가격으로 계산하면 약 $0.6 + $0.045 + $0.45 ≈ $1.10이에요. 같은 토큰 사용량에서 Qwen3.8-Max 공식 가격으로 계산하면 약 $1.55가 되고요. 실제 차이는 토큰 소비량 변화까지 더해야 하므로, 가장 확실한 방법은 자신의 실제 로그로 다시 한 번 돌려보는 거예요.
💰 비용 계산 팁: APIYI에서는 아직 qwen4-max를 제공하고 있지 않아요. 이 모델은 최대한 빨리 제공할 예정이에요. 구체적인 모델명과 가격은 apiyi.com 플랫폼의 모델 목록을 기준으로 해요. 출시 전에는 플랫폼의
qwen3.8-max로 비용 기준선을 만들어 두고, 새 모델이 출시되면 두 청구서를 바로 비교해 보세요.
시나리오별로 Qwen4-Max로 바꿔야 할지 판단하는 방법
| 시나리오 | Qwen4-Max의 성능(공식 자체 발표 기준) | 권장 |
|---|---|---|
| 장기 실행 에이전트와 산업형 딜리버리(사무 자동화, 리서치, 결과 문서) | HLAB-Vals, Agents’ Last Exam 1위, APEX, JobBench, AA-Briefcase 2위, 토큰을 눈에 띄게 덜 씀 | 우선 평가해 보세요. Qwen3.8-Max에서 업그레이드했을 때 이득이 가장 명확해요 |
| 터미널과 코드 저장소(shell agent, 빌드, 크로스 레포 수정) | DeepSWE 1위지만 격차가 아주 작음, Terminal-Bench 5위, ProgramBench 4위 | 터미널 작업이 주를 이룬다면 Kimi K3.1, Opus 5.5와 먼저 비교한 뒤 결정하세요 |
| 프런트엔드 WebDev | Code Arena 공개 리더보드 6위, 1750점(Preliminary) | 가성비 옵션으로는 쓸 만하지만 1위는 아니에요 |
| 차트·비디오 이해, 멀티모달 장문 문서 | Chartography, Video-Index 모두 4위 | 이미지·비디오를 많이 읽는 파이프라인이라면 아직은 이것만 쓰는 건 권하지 않아요 |
| 생물·의료 Q&A | BioMysteryBench 1위, HealthBench Professional 3위 | 테스트에 포함할 수는 있지만 도메인 전문가의 검수가 필요해요 |
비교적 안전한 방법은 트래픽을 나누는 거예요. 장기 실행 에이전트와 문서 딜리버리 같은 작업은 Qwen4-Max에 맡기고, 터미널 중심의 무거운 작업과 차트·비디오 작업은 현재 그 영역에서 더 나은 성능을 보이는 모델에 계속 맡기는 식이죠. 이렇게 하면 모든 트래픽을 한 번에 옮기지 않아도 되고, 토큰 절감 효과를 먼저 누릴 수 있어요.
🎯 선정 가이드: 분리의 전제는 같은 코드로 모델을 바꿀 수 있어야 한다는 점이에요. APIYI apiyi.com은 OpenAI 호환 인터페이스를 제공하고, API 키 하나로 여러 플래그십 모델을 호출할 수 있으니
model필드만 바꾸면 A/B 테스트를 할 수 있어요.
Qwen4-Max 빠르게 시작하기
공식 채널은 QwenCloud API이며, OpenAI Chat Completions, Responses, Anthropic Messages, DashScope 네 가지 프로토콜을 지원해요. 이미 쓰고 있는 OpenAI SDK나 Anthropic SDK 모두 바로 연결할 수 있어요. 연결할 때는 아래 몇 가지를 주의하세요.
- 모델명 확인: 공식 모델 ID는
qwen4-max로 표기하며, 모델 페이지를 기준으로 해요. 기본reasoning_effort는high이고, 비교 테스트를 할 때는 같은 단계를 명시적으로 지정하세요. 예를 들어xhigh처럼요. - 출력 공간 확보: 최대 출력 393K, 최대 사고 사슬(chain-of-thought) 262K예요. 긴 작업에서는
max_tokens나 해당 파라미터를 충분히 크게 잡아야 해요. 그렇지 않으면 사고 사슬이 출력 할당량을 다 차지해 버려요. - 캐시 활성화: 암묵적 캐시 적중 가격은 $0.075예요. 시스템 프롬프트가 길고 반복해서 쓰인다면 5분 또는 1시간짜리 명시적 캐시를 쓸 만한지 따져 보세요. 캐시 생성에는 별도 요금이 붙기 때문에 재사용 횟수가 너무 적으면 오히려 손해예요.
- 대조군 준비: APIYI에 등록한 뒤 API 키를 발급받고,
base_url을https://api.apiyi.com/v1로,model을qwen3.8-max로 설정해서 같은 작업 묶음으로 구 모델의 토큰 소비와 점수를 베이스라인으로 뽑아 두세요. - 신모델 출시 후 전환: qwen4-max가 APIYI에 올라오면
model필드만 바꾸면 돼요. 나머지 코드는 그대로 두고도 신구 세대의 비교 데이터를 바로 얻을 수 있어요.
🚀 빠른 시작: 신규 사용자는 APIYI apiyi.com에서 등록하면 무료 테스트 크레딧을 받을 수 있어요.
qwen3.8-max의 베이스라인을 먼저 뽑아 두기에 충분하고, 이후 모델을 바꿀 때 다시 연결할 필요가 없어요.
Qwen4-Max 자주 묻는 질문 FAQ
Q1: Qwen4-Max는 무엇인가요?
Qwen4-Max는 2026-11-16에 통이첸원(Qwen)이 공개한 플래그십 모델이에요. 2.4T 백본 파라미터에 토큰당 71B를 활성화하며, 시각 입력을 네이티브로 지원하고 컨텍스트 윈도우는 1M이에요. 주로 장기 실행 에이전트와 산업 현장 딜리버리 작업을 겨냥하고 있죠.
Q2: Qwen4-Max와 Qwen3.8-Max의 차이는 무엇인가요?
공식 자체 보고 기준 16개 벤치마크에서 Qwen4-Max는每一项…
Q3: 16개 벤치마크 점수를 믿어도 되나요?
이 점수들은 모두 공식 자체 보고이고, 경쟁 모델 점수도 알리바바가 직접 측정한 거예요. 아직 제3자 재현은 없어요. 참고할 만한 외부 신호는 Code Arena WebDev 공개 리더보드인데, 2026-11-14 최종 리더보드 스냅샷에서 Qwen4-Max는 6위를 기록했어요. 다만 여전히 Preliminary 상태이고 투표 수가 적은 편이에요.
Q4: “비용 60% 절감”을 제 비즈니스에 바로 적용할 수 있나요?
바로 적용할 수는 없어요. 이 수치는 공식 Work360 시나리오에서 나온 것으로, 토큰과 단가만으로 계산한 결과보다 절감 폭이 커요. 그 차액에 대해서는 공식이 설명하지 않았고요. 실제 절감 폭은 캐시 적중률, 도구 호출 라운드 수, 추론 단계에 따라 달라지니 여러분의 작업 로그로 직접 측정해 보셔야 해요.
Q5: APIYI를 통해 Qwen4-Max를 호출할 수 있나요?
2026-11-16 11:00 기준으로 APIYI의 모델 목록에는 아직 qwen4-max가 없어요. 최대한 빠르게 등록할 예정이에요. 현재 판매 중인 Qwen 플래그십은 `qwen3.8-max`이고, 가격은 입력 $1.65, 출력 $4.95, 캐시 읽기 $0.20625예요(단위: 1M tokens). 등록 일정과 가격은 apiyi.com의 모델 목록을 기준으로 확인해 주세요.
Q6: Qwen4-Max의 약점은 무엇인가요?
터미널 조작(Terminal-Bench 5위), 프로그램 빌드(ProgramBench 4위), 차트 및 영상 이해(모두 4위), HLE(4위) 모두 같은 표의 상위권 경쟁 모델들보다 뒤처져요. 안전 코드의 이중 통과율도 개선되긴 했지만 31.8%에 그쳤고요. 또한 Max 사이즈는 현재 오픈 웨이트 공개 계획이 없어요.
정리: Qwen4-Max, 갈아탈 만한가
- 포지셔닝: 2.4T 백본에 토큰당 71B 활성화, 1M 컨텍스트를 갖춘 플래그십 모델로, 롱-호라이즌 에이전트와 산업 현장 딜리버리를 전면에 내세웁니다.
- 앞서는 항목: 공식 자체 보고 16개 벤치마크 중 4개 1위, 4개 2위를 기록했고, 주로 에이전트와 화이트칼라 업무 딜리버리 계열 벤치마크에서 강합니다.
- 뒤처지는 항목: 터미널 조작, 프로그램 빌드, 차트, 영상, HLE 모두 4~5위권에 머물러서, 모델 하나로 모든 작업을 커버할 수는 없어요.
- 공개 리더보드 위치: Code Arena WebDev 최종 보드 스냅샷(2026-11-14) 기준 6위, 1750점이며 아직 Preliminary 상태입니다.
- 비용: 공식 단가 25% 인하, 캐시 읽기 70% 인하, 토큰 소모도 눈에 띄게 줄었습니다. “60% 절감”이라는 부분은 자체 데이터로 검증이 필요해요.
주요 워크로드가 롱-호라이즌 에이전트와 문서 딜리버리라면 Qwen4-Max를 우선 평가해 볼 만합니다. 반대로 터미널 중심의 무거운 작업이나 차트·영상 이해가 중심이라면 지금 더 강한 모델로 계속 분산하는 편이 좋아요. qwen4-max가 출시되기 전에 APIYI apiyi.com의 OpenAI 호환 인터페이스로 qwen3.8-max를 사용해 비용과 효과의 기준선을 세워 두면, 새 모델이 나온 뒤 필드 하나만 바꿔서 비교를 마무리할 수 있습니다.
📚 참고 자료
- Qwen 공식 X 게시물: Qwen4-Max 출시 공지
- 링크:
x.com/Alibaba_Qwen/status/2122148127520289151 -
설명: 공개 시점과 공식 제공 채널
-
Qwen 공식 블로그(중문): 아키텍처, 스펙, 16개 항목 벤치마크 점수와 효율 수치
- 링크:
qwen.ai/blog?id=qwen4-max -
설명: 이 글의 아키텍처, 스펙, 벤치마크 데이터는 모두 이 글에서 가져왔어요
-
QwenCloud 모델 페이지: 달러 기준 정가
- 링크:
qwencloud.com/models/qwen4-max -
설명: 달러/1M tokens 기준 입력, 출력, 캐시 가격
-
QianwenAI 플랫폼 모델 페이지: 위안 기준 정가
- 링크:
qianwenai.com/models/qwen4-max -
설명: 위안/1M tokens 기준 가격
-
arena.ai Code Arena WebDev: 공개 리더보드
- 링크:
arena.ai - 설명: 이 글에서는 2026-11-14 최종 리더보드 스냅샷을 인용했어요
작성자: APIYI 기술팀
기술 교류: 모델 출시 진행 상황과 연동 방법이 궁금하다면 APIYI 웹사이트 첫 페이지에서 연락 주세요. 문서는 docs.apiyi.com에서 확인할 수 있어요.