Claude Code は、終了して再起動するたびに、前回何を変更したかを忘れてしまいます。そこで、多くの人が 10 万スターを獲得した claude-mem を導入しています。インストールしてもよいですが、インストーラーで何も確認せずに Enter キーを押し続けるのは避けましょう。 2026 年 10 月時点の v15 インストーラーでは、ホスト型の CMEM Pro オブザーバーがデフォルトで選択されており、30 日間の試用期間が終わると月額 30 ドルが課金されます。月額料金をかけたくない場合は、インストール時に --provider claude を指定するか、インストール後にオブザーバーを自分のキーを使う設定に変更できます。
これは「インストールすれば永久に記憶できる」という宣伝記事ではありません。 以下では「公式の公表情報 / 第三者による単一事例 / 私自身の実測 / 不明な点」を分けて紹介します。すべてのデータの確認日時は 2026-10-30 です。
claude-mem の要点
まずは一覧を見て、続きを読むか判断してみてください。
| 要点 | 説明 | あなたへの影響 |
|---|---|---|
| 注目度 | GitHub thedotmack/claude-mem は 105,017 stars、Apache-2.0(2026-10-30 時点の GitHub API の値) |
星の数は注目度を示すものです。使いやすいかどうかは自分で判断しましょう |
| バージョン | npm と GitHub release の最新版はいずれも 15.6.0(2026-10-29)。README のバッジは 15.7.0 となっており、一致していません | npm のバージョンを基準にし、バッジに惑わされないようにしましょう |
| デフォルトは有料 | インストーラーでは CMEM Pro がデフォルトで選択され、30 日間の試用後は月額 $30 | サブスクリプションを利用したくなければ、別の方法を選びましょう |
| 月額料金なしの方法 | --provider claude で自分の Claude プランを使うか、インストール後に自分のキーを使う設定に変更 |
プランの利用枠または API の残高から費用が発生します |
| 完全なローカル処理ではない | observer モデルがツール呼び出しの内容を読み取ります | 機密情報を含むリポジトリで使う場合は、事前によく検討しましょう |
📷 スクリーンショット挿入位置、編集時に追加:GitHub リポジトリのトップページ(
thedotmack/claude-mem、星の数と最新 release を表示)
claude-mem は何を記憶するのか
一言でいうと、claude-mem はローカルで動作する記憶レイヤーです。新しいチャットモデルでも、クラウドノートでもありません。セッション中に「何が起きたか」を取得して圧縮・保存し、次のセッションで Claude に再び渡します。
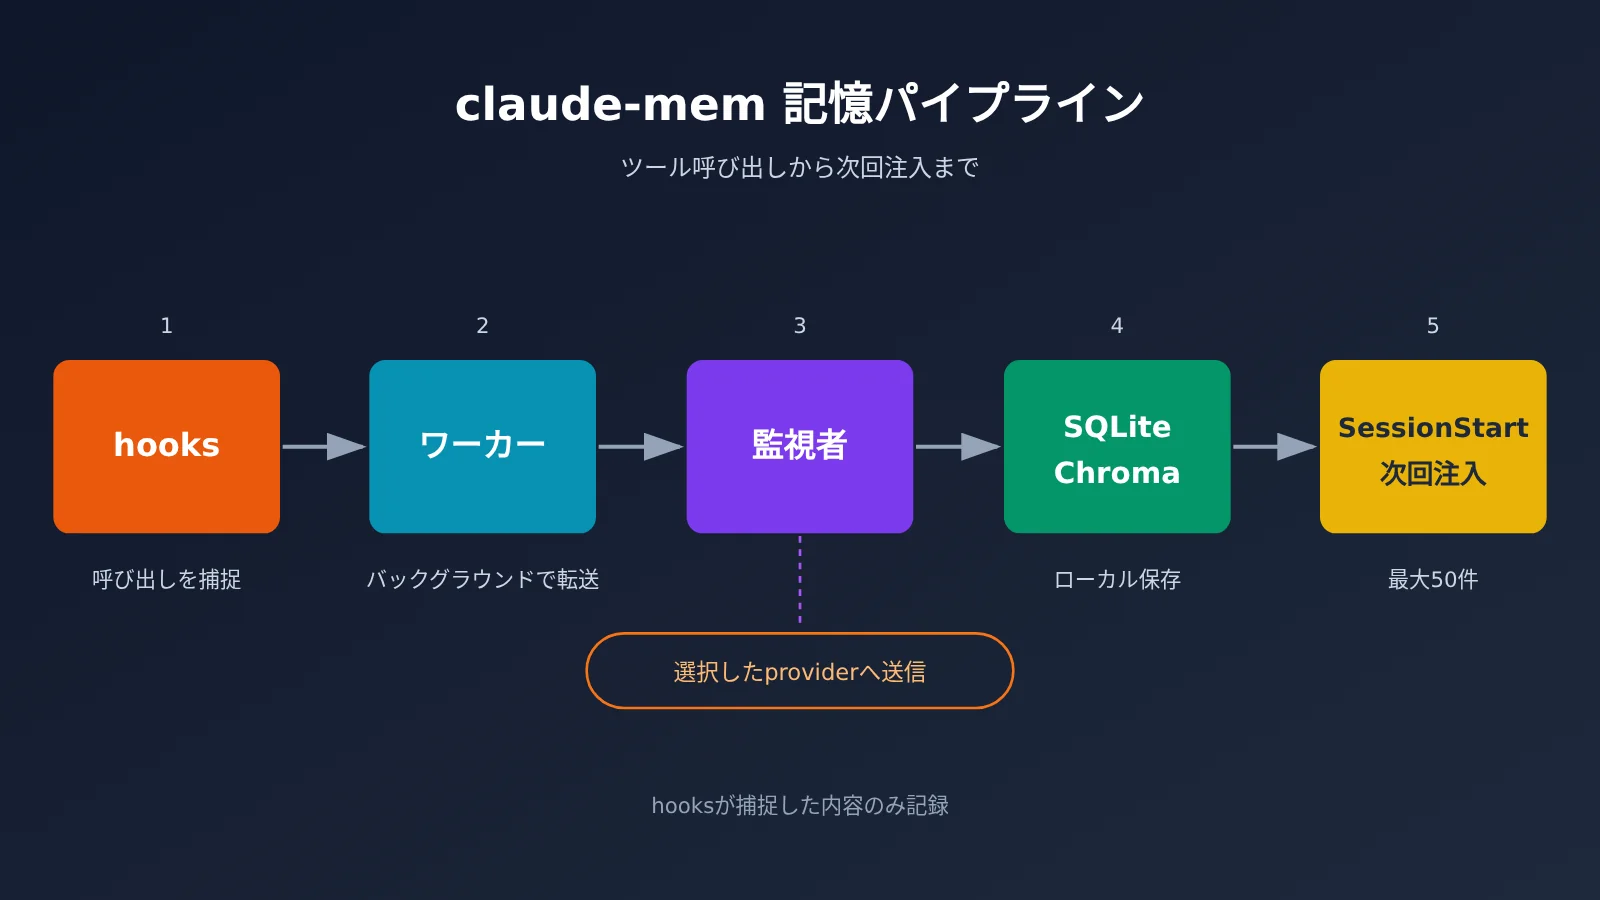
処理の流れは 5 段階です。
- hooks(ライフサイクルフック):Claude Code は、セッション開始時、プロンプト送信時、ツール呼び出しの前後、停止時、終了時にイベントを発生させます。claude-mem はこれらのタイミングにフックを設定します。
- worker:ローカルで Bun を使って動かす HTTP サービスで、hook イベントの受信を担当します。デフォルトのポートは
37700 + (uid % 100)なので、必ずしも 37700 とは限りません。 - observer(観察者モデル):worker は元のツール呼び出し内容をモデルに渡し、構造化された observation に圧縮します。
- observation(観察記録):各記録には種類、タイトル、説明、関連ファイルが含まれ、
~/.claude-mem/claude-mem.db(SQLite)に書き込まれます。ベクトルインデックスは~/.claude-mem/chroma/に保存されます(Chroma は意味検索に使うベクトルデータベースです)。 - 次回の SessionStart で注入:新しいセッションが始まると、現在のプロジェクトに関連する最近の observation が自動的に注入されます。デフォルトでは最大 50 件です。Claude は MCP ツール(
search→timeline→get_observationsの 3 段階)を使い、必要に応じてさらに古い記憶を検索することもできます。
注意したいのは、記録されるのは hooks が取得した内容だけという点です。セッション外で思いついたことや、ツール呼び出しを経ていない議論は、自動的にはデータベースに入りません。また、Claude Code に標準搭載されているネイティブ memory(MEMORY.md)と claude-mem は別のシステムです。デフォルトでは並行して動作し、同じものではありません。
claude-mem をインストールする前の3つの必須条件
次の3つのうち、1つでも満たしていなければ、インストールを進める前に確認しましょう。
- Claude Code ≥ 2.1.139:これより古いバージョンでは hook の
argsが無視され、エラーが出ないまま記録されないため、原因の特定が困難です。まずclaude --versionを実行し、バージョンが足りなければclaude updateを実行してください。 - Node 20+:npm パッケージが指定する要件は
^20.19.0 || >=22.12.0です。node -vで確認してください。Bun(≥1.1.31)と uv はインストーラーによって自動的にインストールされます。第三者による Ubuntu 26.04 での単一事例の検証では、Bun、uv、Chroma の合計で約 1.2 GB のディスク容量を使用しました。 - observer にツール呼び出しの内容を見られても問題ないこと:どの方法を選んでも、ツール呼び出し、プロンプト、要約の元データは、選択した observer プロバイダーに送信されます。リポジトリに秘密鍵、顧客データ、未公開のコードが含まれている場合は、導入前に慎重に検討してください。
Windows ユーザーの場合、hooks に Git Bash は必要ありません。ただし、インストール後は新しい PATH を反映するため、ターミナルまたは IDE を再起動してください。
claude-mem の3つのインストール方法をどう選ぶか
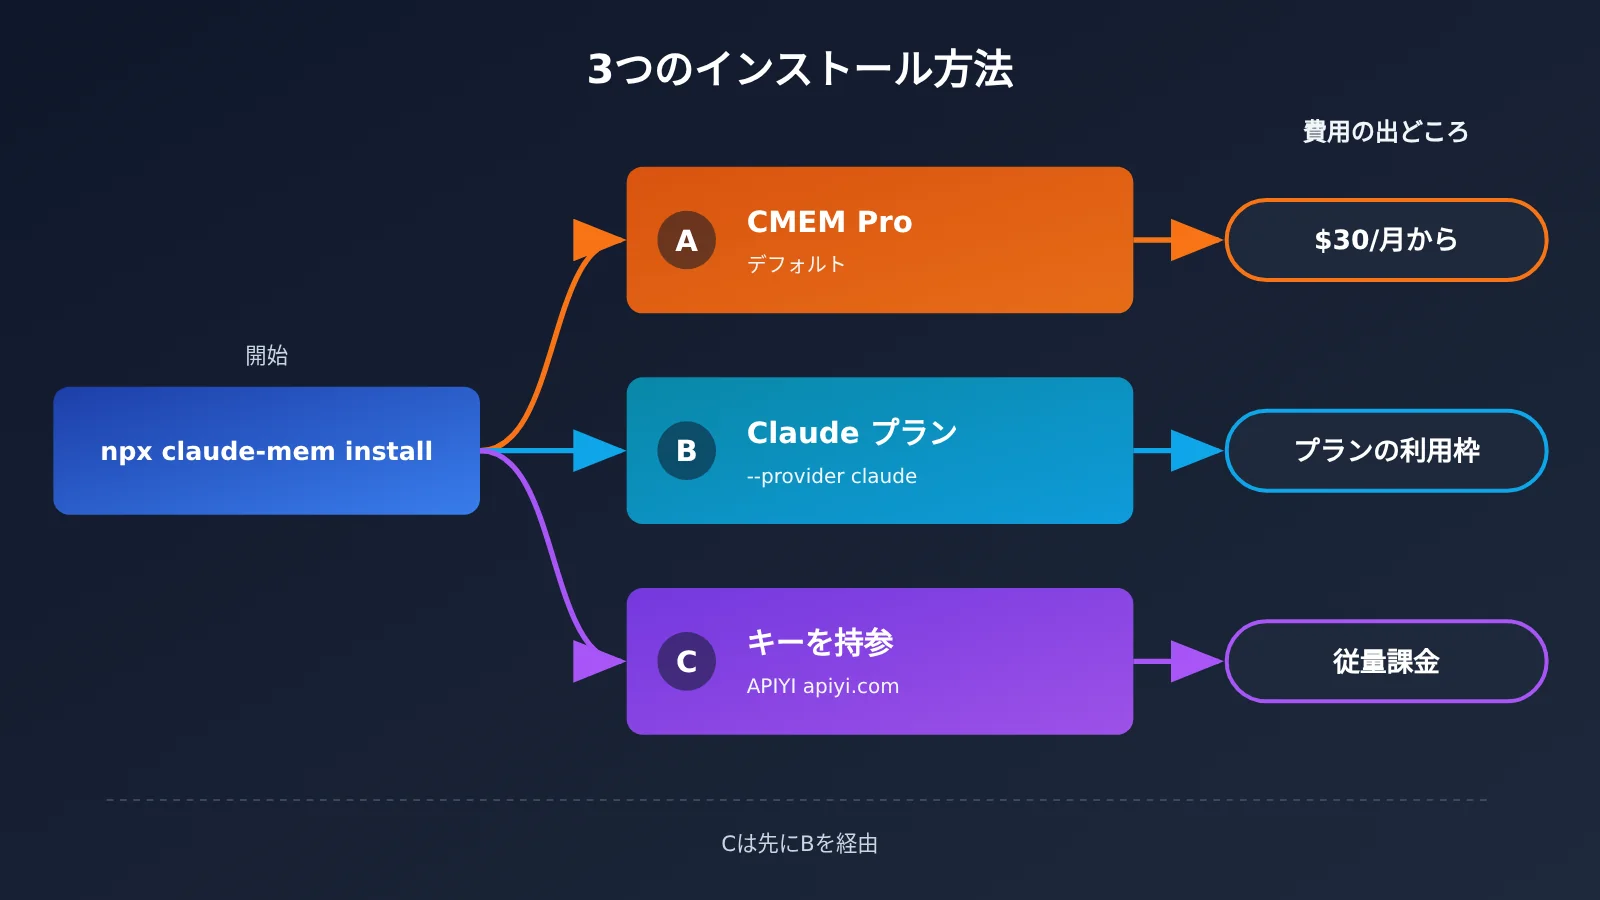
| 方法 | cmem アカウントは必要? | 費用の支払い先 | データの送信先 | おすすめの人 |
|---|---|---|---|---|
| A:デフォルトの CMEM Pro | 必要。試用にもカード登録が必要 | 月額 $30〜、30日間の試用あり | cmem.ai がホストする observer | key を設定したくない人、クラウド同期や複数端末での利用が必要な人 |
B:--provider claude |
不要 | Claude プランの利用枠を消費 | Anthropic | Claude のサブスクリプションを利用している人 |
| C:B でインストール後、自分の key に変更 | 不要 | プロバイダーの利用量に応じた課金 | 設定したエンドポイント(例:APIYI apiyi.com) | コストを管理したい人、API の残高がある人 |
プラグインマーケットも別の導入方法です。以下では、方法 C’ として個別に説明します。3つ目の方法では、まず B でインストールする必要があります。openai-compatible はインストーラーの --provider で選択できないため、インストール後に settings を手動で変更してください。
ルート A:デフォルトの CMEM Pro(claude-mem インストーラーの初期選択)
npx claude-mem installを実行します。- 表示される内容:最初のステップでは、検出された Agent が事前に選択され、ランタイムがインストールされます。次に
XXXX-XXXX形式のデバイスコードが表示され、ブラウザを開いて OAuth 認証を行います(ログイン手順でつまずかないようにしましょう)。3つ目のステップでは、記憶の provider として CMEM Pro がデフォルトで選択されています。そのまま選ぶと、決済ページまたはトライアルページが開きます。 - 注意したい利用条件(公式料金ページを2026-10-30に確認):
- トライアルにはクレジットカードまたはデビットカードが必要です。プリペイドカードは使えません。
- 「トライアル終了」または「含まれる利用枠の使い切り」のうち、早い方から課金が始まります。
- 自動アップグレードの設定によっては、サブスクリプションが Pro から Heavy(月額70ドル)または Max(月額100ドル)に引き上げられる場合があります。「カード不要」とだけ書き、この点に触れていないチュートリアルも少なくありません。
- 成功の確認方法:インストール完了後に Version、Plugin dir、IDEs、Account、Cloud sync、Worker URL が表示されたら、後述の5項目で動作を確認します。
ルート B:--provider claude で claude-mem を月額料金なしでインストール
npx claude-mem install --provider claudeを実行します。- 記憶機能を1つだけにしたい場合は、代わりに
npx claude-mem install --provider claude --disable-auto-memoryを使います。このパラメーターによってCLAUDE_CODE_DISABLE_AUTO_MEMORY=1が設定され、Claude Code 標準の auto-memory が無効になります。 - 表示される内容:
Skipping claude-mem login: --provider claude runs memory on your own Anthropic plan.、Cloud sync: OFF (local)、Auto-memory: left enabled(disable パラメーターを付けていない場合)が表示されます。インストーラーでは observer モデルの選択も求められますが、Opus ではなく Haiku を選びましょう。 - 成功の確認方法:インストール中に cmem のログイン画面や決済画面が表示されず、
npx claude-mem doctorの全項目にチェックが付けば成功です。
ソースコード上でログインが不要なのは、claude と host の2つの provider だけです。第三者の実測では、--provider openrouter は Waiting for OAuth login in the browser… の画面で止まります。そのため、サードパーティのキーを使いたい場合は、まずルート B でインストールを完了し、その後に設定を変更するのが正しい順序です。
方法 C’:Claude Code プラグインマーケットプレイス
- Claude Code で
/plugin marketplace add thedotmack/claude-memと入力します。 - 続けて
/plugin install claude-memと入力し、Claude Code を再起動します。 - インストール後の動作:最初のセッションでは launcher がまだコンパイル中のため、記憶がない場合があります。この空白期間をなくしたい場合は、追加で
npx claude-mem install --provider claudeを実行してください。 npm install -g claude-memは使わないでください:SDK ライブラリをインストールするだけで、hooks の登録も worker の起動も行いません。さらに、本来の launcher が使われなくなる原因にもなります。
claude-mem のインストール後に確認したい5項目
まず覚えておきたいのは、最初のセッションは「情報を収集する場」だということです。注入できる履歴がまだないため、記憶が見えるようになるのは2回目のセッションからです。最初から「自分のことを覚えている」と期待すると、失敗したと誤解しやすくなります。
| # | チェック項目 | コマンド / 操作 | 合格の目安 |
|---|---|---|---|
| 1 | doctor | npx claude-mem doctor |
Bun、uv、Plugin、Hook launcher、Worker、Claude Code version(2.1.139+)、Chroma がすべて ✓ |
| 2 | status | npx claude-mem status |
worker が正常に動作し、ポート番号が表示される |
| 3 | viewer | ブラウザで http://127.0.0.1:<PORT>/ を開く。記憶は /viewer に表示される |
ページが開き、1回のセッションを終えた後に項目が表示される |
| 4 | sqlite count | sqlite3 ~/.claude-mem/claude-mem.db "select count(*) from observations;" |
最初のセッション終了後、戻り値が 0 より大きい |
| 5 | context inject | curl "http://127.0.0.1:<PORT>/api/context/inject?project=<项目名>" |
返される内容が、次のセッションに注入される記憶 |
ポート番号は ~/.claude-mem/settings.json の CLAUDE_MEM_WORKER_PORT で確認できます。また、curl http://127.0.0.1:<PORT>/api/health でも確認できます。doctor の出力で最も問題が起きやすいのは Hook launcher の行です。not on PATH または is not the claude-mem hook launcher と表示された場合は、ほかの項目を確認する前に対処してください。
📷 スクリーンショット挿入位置。編集時に追加:worker viewer ページ(
/viewer、observation の一覧を表示)
claude-mem のコスト:公式の「96%削減」と第三者テストの「+4,226トークン」
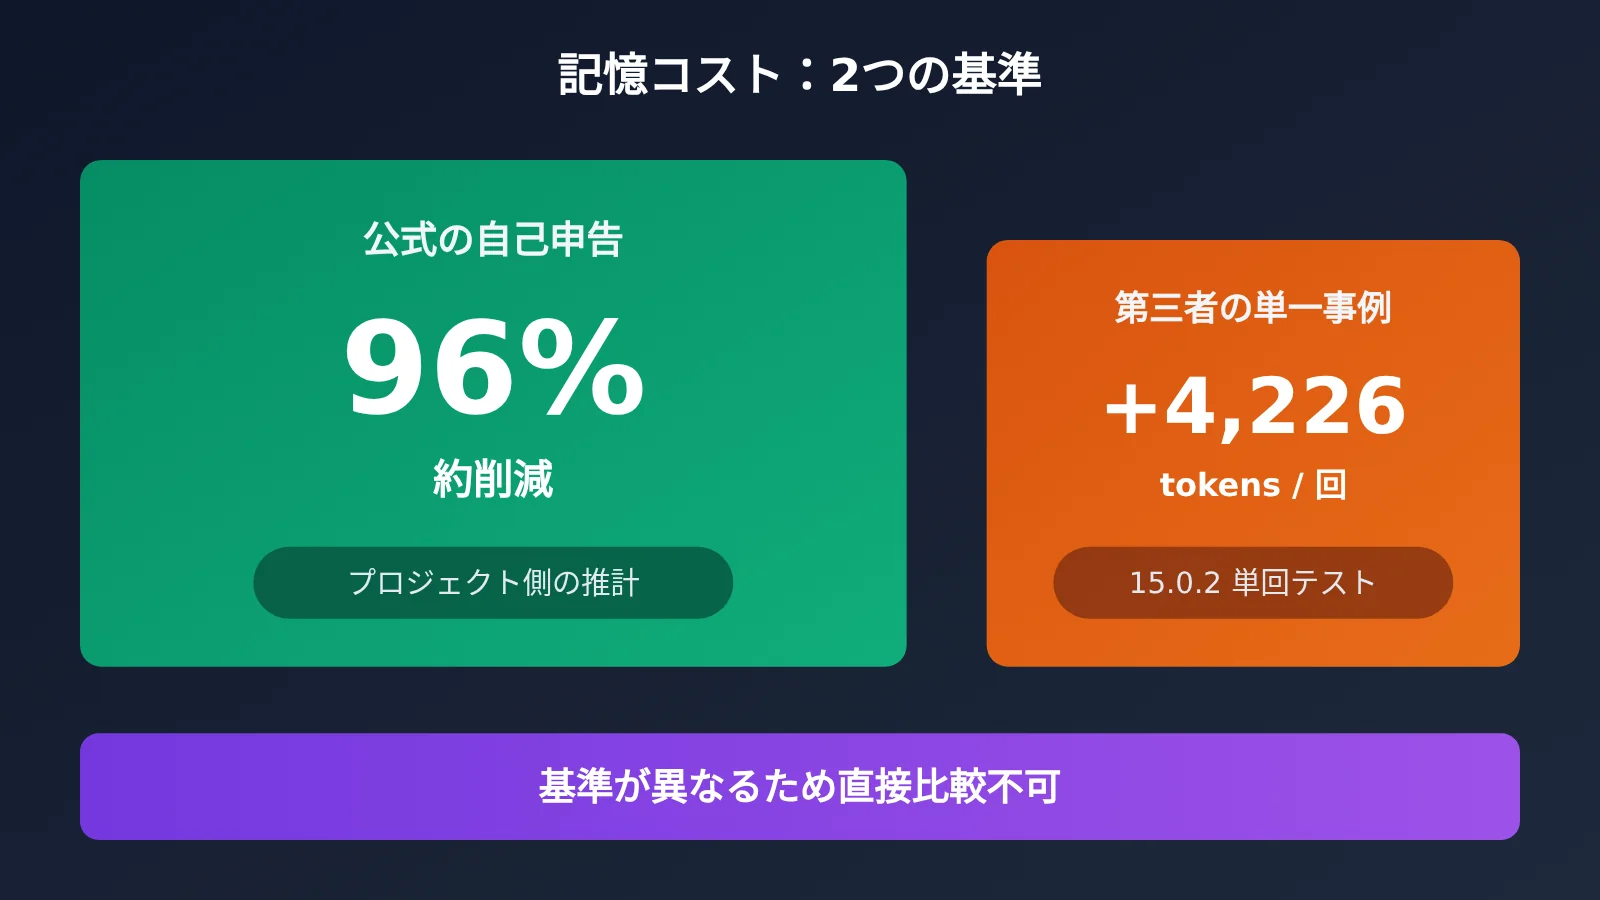
どちらの数字も正しいものの、測定対象が異なるため、混同はできません。
- 公式の自己申告:4件の observation は約1,093トークンで、元の作業量は26,447トークン。そのため「約96%削減」としています。また、MCPの3層検索は「すべてを注入する場合より約10倍効率的」としています。いずれもプロジェクト側の推定であり、第三者による監査ではありません。
- 第三者による単一事例(ComputingForGeeks、2026年10月24日、claude-mem 15.0.2、OpenRouter経由のSonnet):同じ「Reply with the single word ready」という指示に対し、claude-mem を使わない場合の入力は28,489トークンでした。有効にすると、記憶が空でも入力は32,715トークンとなり、4,226トークン増(約14.8%増)、コストは0.010ドル増えました。これは1台のマシン、1回、1プロジェクトでのテストにすぎず、あなたの請求額を示すものではありません。
結論から言うと、「削減」は記憶そのものが元の記録よりコンパクトになること、「増加」はセッションごとに固定的な追加コストがかかることを指しています。 プロジェクトの作業が活発になり、注入される記憶の件数が増えるほど、オーバーヘッドも大きくなります。2026年上半期の Issue #618 と #2469 でも、トークンがすぐに消費されるというユーザーの報告がありました。これは旧バージョンでの体験であり、15.6.0 の現状と同じとは限りませんが、記憶の利用には常にコストがかかることを示しています。
claude-mem のコストを抑える5つの設定
CLAUDE_MEM_CONTEXT_OBSERVATIONS:デフォルトは 50。10〜20 に下げると、注入される情報量を直接減らせます。CLAUDE_MEM_SEMANTIC_INJECT:デフォルトのfalseを維持します。有効にすると、プロンプトごとに関連する記憶が追加されます。CLAUDE_MEM_SESSION_START_INCLUDE_ALL_SOURCES:デフォルトのfalseを維持します。有効にすると、すべてのホストの記憶が注入されます。CLAUDE_MEM_DISABLE_TOOL_HOOKS=1:ツール呼び出し単位の observation を無効にし、セッション単位の要約だけを残します。トークンとプロセスのオーバーヘッドを節約できます。CLAUDE_MEM_OPENAI_COMPAT_OBSERVATION_BATCH_SIZE:デフォルトは 1。イベントが滞留したときに少しずつ増やし、最初から 32 に設定するのは避けましょう。
3つの方法の料金比較
| 方案 | 課金方式 | 料金(米ドル) | 向いている人 |
|---|---|---|---|
| CMEM Pro | サブスクリプション | $30/月、30日間のトライアル(Heavy $70、Max $100) | ヘビーユーザー、クラウド同期が必要な人 |
| Claude プラン | サブスクリプションの利用枠を消費 | 別料金はかからないが、コーディングと利用枠を分け合う | Claude をすでに契約している人 |
APIYI claude-haiku-5-5 |
従量課金 | 100万トークンあたり入力 $0.1 / 出力 $0.5 / キャッシュ読み取り $0.01(1回あたり 100,000 トークン以下。100,000 トークンを超える場合、入力は $0.5/1M の段階料金) | 低頻度・中頻度のユーザー |
料金データは APIYI(apiyi.com)の料金一覧に基づきます(ページ更新日時:2026-10-27 14:50 UTC+8)。モデルと料金はプラットフォームのモデル一覧、実際の請求額はコンソールでご確認ください。参考までに、同プラットフォームの claude-haiku-4-5-20251001 は入力 $1 / 出力 $5 / キャッシュ読み取り $0.1、claude-sonnet-5-5 は $2 / $10 / $0.1、claude-opus-5-5 は $4 / $20 / $0.2 です。observer は高頻度で実行される構造化された小さなタスクなので、Haiku クラスのモデルで十分です。従量課金は低頻度・中頻度の利用に向いています。ヘビーユーザーは1週間の実際の使用量から費用を計算し、$30/月と比較してみてください。
claude-mem の observer を APIYI に切り替える
これはルート C の具体的な手順です。すでに API の残高があり、メモリ機能のために別途サブスクリプションを契約したくない開発者に向いています。APIYI は人民元でのチャージに対応し、公式料金ページによると 1:7 の固定レートで決済されます。
- まずルート B の手順でインストールします:
npx claude-mem install --provider claude。 ~/.claude-mem/settings.jsonを開き、4つのキーを設定します:"CLAUDE_MEM_PROVIDER": "openai-compatible""CLAUDE_MEM_OPENAI_COMPAT_BASE_URL": "https://api.apiyi.com/v1""CLAUDE_MEM_OPENAI_COMPAT_MODEL": "claude-haiku-5-5""CLAUDE_MEM_OPENAI_COMPAT_API_KEY": "sk-あなたのAPIYIキー"- APIキーを settings に平文で書きたくない場合は、代わりに
~/.claude-mem/.envに記述できます:OPENAI_COMPAT_API_KEY=sk-あなたのAPIYIキー(ディレクトリの権限は 0700、ファイルの権限は 0600)。 npx claude-mem restartを実行します。認証情報は worker の起動時にのみ読み込まれるため、再起動しないと設定は反映されません。- 成功の確認方法:
npx claude-mem doctorで provider が openai-compatible と表示されることを確認します。新しいセッションで生成された次の observation が viewer に表示されれば成功です。
あらかじめ避けておきたい落とし穴が2つあります。1つ目は、base URL に必ず /v1 を含め、末尾にスラッシュを付けないことです。スラッシュが二重になり、404 エラーの原因になります。3種類の base URL の違いについては、こちらを参照してください:help.apiyi.com/apiyi-base-url-v1-claude-gemini-endpoint-config-guide.html。2つ目は、4つのキーのうち1つでも欠けると、claude-mem は通知なく Claude ルートに戻ることです。見た目は正常でも、料金がプランから消費されます。
API の実測結果(2026-10-30 に APIYI の APIキーを使ってテスト):
GET /v1/modelsは 200 を返し、claude-haiku-5-5を含む計259モデルが確認できました。POST /v1/chat/completionsでclaude-haiku-5-5を使用し、response_format: {type: "json_object"}を指定したところ、200 が返り、所要時間は約2.0秒でした。有効な JSON が返され、使用量は59トークンでした。- claude-mem が送信する
reasoning: {enabled: false}フィールドを付けた場合も 200 が返り、400 エラーは発生しませんでした。 - Anthropic ネイティブの
/v1/messagesも 200 を返しました。
検証範囲について:以上で確認できたのは、「APIYI のエンドポイントが claude-mem に必要なリクエスト形式を受け付けること」だけです。手元の環境で claude-mem の observation 処理を最初から最後まで動かしたわけではありません。API のテストに通ったことは、プラグイン全体の処理が検証済みであることを意味しません。
🚀 手軽に始めるためのおすすめ:まず APIYI の apiyi.com コンソールで、claude-mem 専用の個別の APIキーを作成しましょう。1週間後にそのキーの使用量を個別に確認でき、従量課金とサブスクリプションのどちらがお得か判断できます。Claude Code 本体も接続する予定なら、こちらを参照してください:help.apiyi.com/claude-code-apiyi-integration-tutorial.html。
claude-mem のプライバシー:ローカルに残るものと外部に送信されるもの
ローカルに保存されるもの(すべて ~/.claude-mem/ に保存され、CLAUDE_MEM_DATA_DIR で場所を変更可能):claude-mem.db(セッション、観測記録、要約、プロンプト)、chroma/ のベクトルインデックス、logs/、settings.json、およびデフォルトでは無効なスクリーンショット用ディレクトリ media-v1/。
外部に送信されるもの:
- observer の呼び出し:ツール呼び出しの内容、プロンプト、要約の素材が、選択したプロバイダーに送信されます。Anthropic を選べば Anthropic に、CMEM を選べば cmem.ai に、APIYI を選べば APIYI に送られます。
- テレメトリーはデフォルトで有効:データは PostHog に送信され、ランダムなインストール UUID が使われます。エラー情報は機密情報を除去したうえで送信されます。無効にするには
npx claude-mem telemetry disableを実行するか、DO_NOT_TRACK=1を設定します。インストーラーの最後でも設定を確認されます。 - クラウド同期は明示的に有効化する必要あり:デフォルトでは無効です。有効にすると、観測記録、セッションの要約、プロンプトの全文が cmem.ai にアップロードされます。
利用できる制御手段:
<private>...</private>で囲んだ内容は、フックの段階で取り除かれ、データベースには保存されません。- 自動マスキングはデフォルトで無効です。
CLAUDE_MEM_REDACT_ENABLED=trueを設定すると、組み込みの16種類のキーパターン(AWS、GitHub PAT、OpenAI/Anthropic のキー、JWT、PEM など)が有効になります。さらにCLAUDE_MEM_REDACT_GENERIC_ENABLED=trueを設定すると、汎用パターンが3種類追加されます。デフォルトでマスキングされるとは思わないようにしましょう。
claude-mem のよくあるトラブルと対処法
| 症状 | 原因 | 対処法 |
|---|---|---|
すべてのフックで Executable not found in $PATH: "claude-mem" と表示される |
ランチャーが PATH にない | npx claude-mem install で再インストールし、ターミナル、IDE、Claude Code を再起動する |
セッションに memory hooks are not active と表示される |
ランチャーが有効になっていない | 上記と同じ手順を実行し、npx claude-mem doctor で Hook launcher の行を確認する |
| 何も記録されず、エラーも表示されない | Claude Code のバージョンが 2.1.139 より古い | claude update を実行する |
claude-mem コマンドが別のプログラムに隠れている |
過去に npm install -g claude-mem を実行した |
which -a claude-mem で確認し、npm uninstall -g claude-mem を実行する |
| ビューアーを開けない | ポートが 37700 ではない、または worker が起動していない | settings でポートを確認し、curl http://127.0.0.1:<PORT>/health を実行する |
| ポートが使用中 | 別のプロセスと競合している | export CLAUDE_MEM_WORKER_PORT=38000 を設定してから worker を再起動する |
| カスタムエンドポイントで 404 が返る | ベース URL が間違っている | OpenAI 互換の場合は /v1、Anthropic ネイティブの場合はルートドメインを使う。モデル ID が /v1/models に表示されることを確認する |
| サードパーティのキーを設定したのに、Claude が使われる | 4 つの設定項目がすべて記入されておらず、エラーを出さずにフォールスルーしている | settings の不足項目を埋め、npx claude-mem restart を実行する |
| observation が空になる、または途中で切れる | 小規模モデルが JSON の構造に従わない、または出力上限に達している | CLAUDE_MEM_OBSERVER_MAX_OUTPUT_TOKENS(デフォルトは 4096)を大きくするか、より安定したモデルに変更する |
| タイムアウトが繰り返される | ストリーミングリクエストで 90 秒間トークンが届かないと処理が中断される | CLAUDE_MEM_LLM_STREAM_IDLE_TIMEOUT_MS を大きくするか、小規模モデルに変更する |
| フックが worker を繰り返し強制終了する | プラグインと worker のバージョンが一致していない(#3857、#3940。修正済み) | npx claude-mem update を実行し、必要に応じて npx claude-mem@latest install を実行する |
| 2 つのメモリ機能が互いに干渉する | 標準の auto-memory と claude-mem が並行して動いている | 再インストール時に --disable-auto-memory を追加する |
claude-mem のリスクとアカウント停止は自己責任
インストール前にこのセクションを最後までお読みください。
- コミュニティプロジェクトであり、公式の保証なし:claude-mem はコミュニティによるオープンソースプロジェクトであり、APIYI の公式製品ではありません。APIYI はその利用を保証せず、SLA も提供していません。
- 内容の外部送信:ツール呼び出しの内容は、選択した observer に送信されます。キー、顧客データ、未公開コードを含むリポジトリでは、まず利用を控えてください。
- 利用枠の消費:大量のトークンやプランの利用枠を消費する可能性があります。まずは小さなプロジェクトで1週間試し、請求額を確認してから判断することをおすすめします。
- 不正利用対策とレート制限:頻繁に実行される hooks、共有アカウント、API中継サービスのキーは、いずれもプラットフォームの不正利用対策やレート制限の対象となる可能性があります。専用のキー、別アカウント、単一のプロジェクトで試すことをおすすめします。利用に伴う結果は読者の自己責任です。この記事で確認できたのは、APIYI のインターフェースが実際のテストで動作したことだけであり、レート制限がかからないことは保証できません。
- アンインストール後もファイルが残る:
npx claude-mem uninstallの実行後も~/.claude-memは残ります。この中にはデータベースや、保存されている可能性のあるキーが含まれるため、手動でrm -rf ~/.claude-memを実行する必要があります。また、第三者による実測では~/.bunと~/.cache/uvが合わせて約 1.1 GB を占めています。ほかのプロジェクトで使っていなければ、これらも削除できます。
claude-mem のよくある質問 FAQ
Q1:10万スターを獲得していれば、claude-mem は必ず使いやすいですか?
そうとは限りません。スター数は人気の指標にすぎません。トークンの消費量、プライバシーの範囲、バージョンアップのペースは自分で評価する必要があります。また、スター数の増加に不自然な点がないかについても、独立した監査は行われていません。
Q2:claude-mem と Claude Code 標準の memory は同じものですか?
違います。標準の memory は MEMORY.md ですが、claude-mem は独立した hooks とデータベースを使います。デフォルトでは両方が並行して動作します。どちらか一方だけを使いたい場合は、インストール時に `–disable-auto-memory` を追加してください。
Q3:インストール後、最初のセッションから記憶は使えますか?
いいえ。最初のセッションでは情報の収集と圧縮を行い、2回目のセッションから注入されます。動作確認の第4項(sqlite count)と第5項(context inject)で確認してください。
Q4:カード登録やサブスクリプションなしでも claude-mem を使えますか?
使えます。`–provider claude` を指定してインストールすると、Claude プランの利用枠を消費します。または、インストール後に observer を APIYI(apiyi.com)の従量課金キーに変更する方法もあります。この場合は実際に使用したトークン数に応じた課金となり、新規ユーザーは無料のテスト枠で試せます。
Q5:observer にはどのモデルが適していますか?
`claude-haiku-5-5` のような Haiku クラスのモデルがおすすめです。observation は高頻度で発生する小規模な構造化タスクです。Opus のようなフラッグシップモデルはコストが高いうえ、出力予算を思考に費やしがちです。
Q6:ローカルモデルだけを使えますか?
使えます。`openai-compatible` の接続先を Ollama、LM Studio、または vLLM に設定してください。ただし、小型モデルが observation の JSON 構造を安定して出力できないと、空のレコードが生成されてしまいます。
Q7:中国語の observation を有効にするにはどうすればいいですか?
settings で `”CLAUDE_MEM_MODE”: “code–zh”` を設定し、Claude Code を再起動します。これは組み込みモードなので、追加のインストールは不要です。
claude-mem の重要ポイント
- 仕組み:hooks がツール呼び出しを取得し、observer が圧縮して SQLite に保存。次のセッションで注入します。
- デフォルト設定の注意点:v15 のインストーラーでは CMEM Pro が事前選択されています。試用にはカードの登録が必要で、その後は月額30ドルです。
- 月額料金をかけずに使う:
--provider claudeを指定してインストールし、必要に応じて settings を変更して自分の APIキーを使います。 - コスト:公式は「96%削減」と報告する一方、第三者の単一事例では「4,226トークン増」。両者は測定条件が異なります。
- プライバシー:observer は内容を外部に送信し、テレメトリーはデフォルトで有効です。機密情報のマスキングとクラウド同期は、どちらも手動で有効にする必要があります。
- 始め方:APIYI apiyi.com で専用のキーを作成し、
claude-haiku-5-5を従量課金で1週間使ってからコストを計算します。
まとめ:claude-mem のセッションをまたぐ記憶機能、導入すべき人・避けるべき人
導入をおすすめする3タイプ:
- 同じプロジェクトを長期的に保守し、Claude Code のセッションを頻繁に終了・再開する人。
- 「前回なぜこう変更したのか」「あのバグを最終的にどう修正したのか」をよく確認する人。
- 初回設定に10分ほどかけられ、observer がツール呼び出しの内容を読み取ることを許容できる人。
導入をおすすめしない3タイプ:
- 使い捨てのスクリプトだけを実行し、プロジェクトに継続性がない人。CLAUDE.md と自分のメモを使うほうが安く済みます。
- コードやデータをローカル環境の外、または指定されたコンプライアンス上の地域の外に出せない人。
- ディスク容量や CPU に余裕がないマシンを使っている人や、「インストールするだけですぐに賢くなる」と期待している人。
導入するなら、「ルートB → 5項目の確認 → 注入する件数を減らす → 必要に応じて observer を変更する」の順に進めると、つまずきにくくなります。従量課金で observer のコストを検証したい場合は、APIYI apiyi.com の無料枠を使って、まずは小さなプロジェクトで試してみましょう。
📚 参考資料
- claude-mem GitHubリポジトリ:ソースコード、リリース、issues
- リンク:
github.com/thedotmack/claude-mem -
内容: スター数、バージョン、#618、#2469、#3857、#3940などの問題に関する記録
-
claude-mem公式ドキュメント:インストール、設定、トラブルシューティング
- リンク:
docs.claude-mem.ai/installation -
内容: システム要件、settingsのデフォルト値、openai-compatibleプロバイダーの設定
-
CMEM料金ページ:CMEM Pro / Heavy / Maxの利用条件
- リンク:
cmem.ai/pricing -
内容: 30日間のトライアル、カード登録の要件、課金開始時点(2026-10-30確認)
-
ComputingForGeeksによる第三者実測:15.0.2のインストールとトークン消費量
- リンク:
computingforgeeks.com/claude-mem-claude-code -
内容: +4,226トークンの単一事例データの出典(2026-10-24)
-
APIYIモデルドキュメント:モデルと料金の一覧
- リンク:
docs.apiyi.com/models - 内容: モデルと料金はプラットフォームのモデル一覧をご確認ください
著者:APIYI技術チーム
技術的なお問い合わせ:設定中にエンドポイントやモデルの問題が発生した場合は、APIYI公式サイトのトップページからお問い合わせください。接続方法の詳細は、docs.apiyi.comのドキュメントセンターをご覧ください。