Gemini 4 Argon に新たな進展がありました。9月30日の発表後、まず Fairwind 計画のネットワーク防御担当者に提供されていましたが、Gemini 4 Argon が Vertex AI から利用できるようになり、Google Cloud での提供が本格的に始まりました。多くの開発者にとって、次に気になるのは「Gemini 4 Argon の料金はいくらなのか」「導入すると毎月どれくらいかかるのか」という点でしょう。
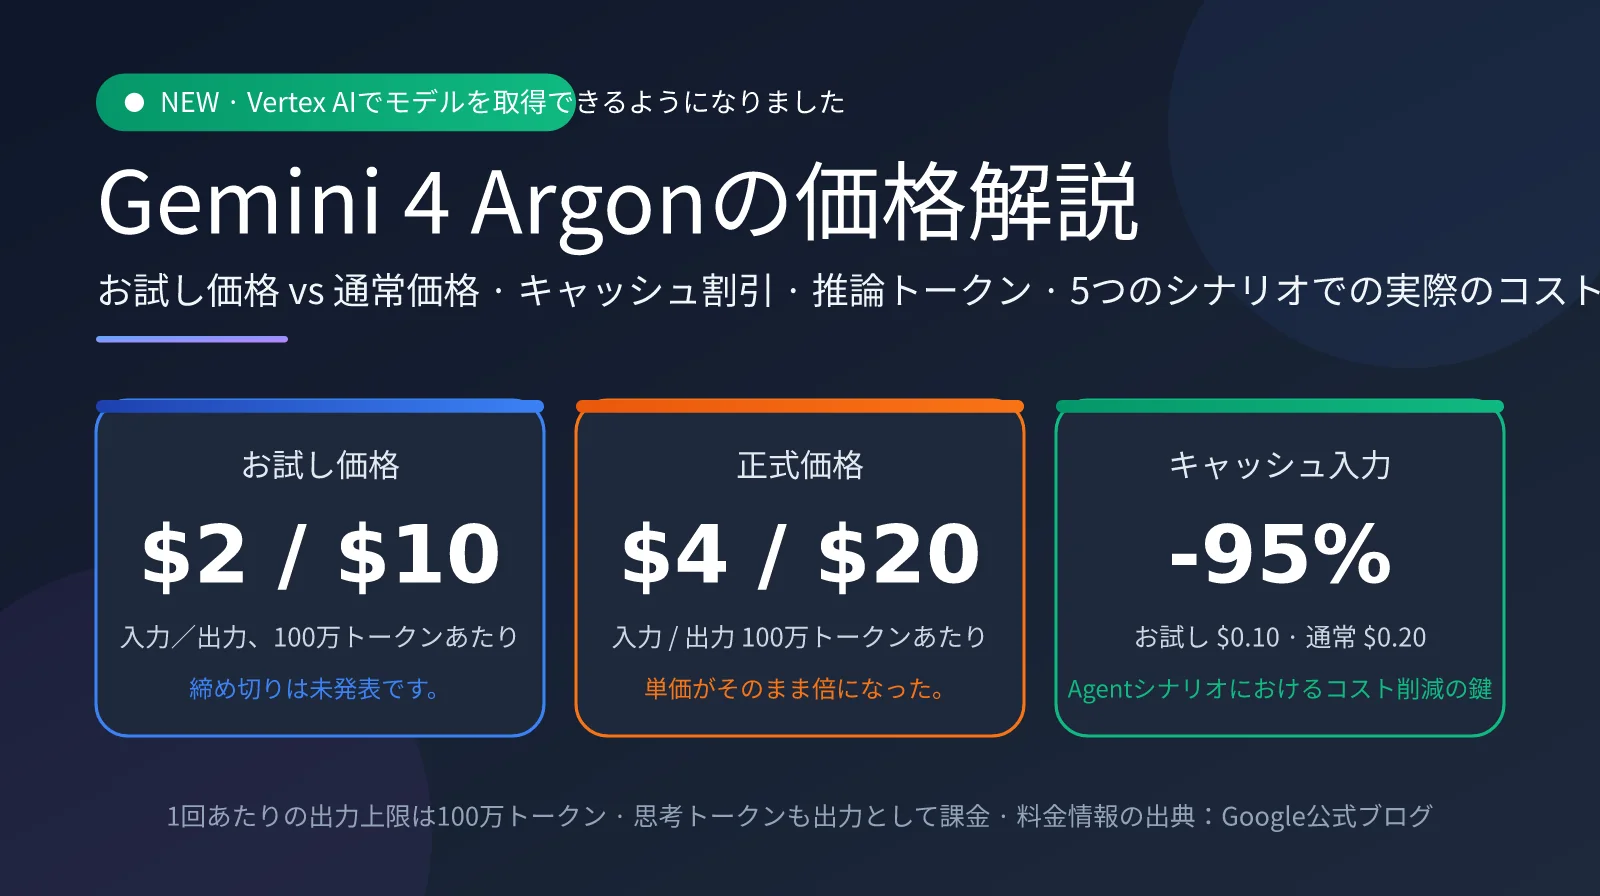
料金体系は、一見するとシンプルです。先行提供価格は入力が100万トークンあたり2ドル、出力が10ドル。正式価格ではそれぞれ4ドル、20ドルとなり、キャッシュ入力には95%の割引が適用されます。しかし、この料金表にはいくつかの変動要素もあります。推論トークンの料金はどう計算されるのか、出力上限の100万トークンによって1回のリクエスト料金が膨らむ可能性はあるのか、Argonのトークン消費量は競合モデルよりどの程度多いのか。本記事では、Googleの公式ブログや複数の英語メディア、第三者評価機関が公開しているデータをもとに、Gemini 4 Argonの料金を項目ごとに解説し、代表的な5つのシナリオでコストを試算します。
この記事でわかること:Gemini 4 Argonを自社の業務で使う場合の、タスクあたりの実コストを把握できます。また、先行提供期間の終了後に料金がどう変わるのか、キャッシュや出力上限を活用してコストを抑える方法も確認できます。
Gemini 4 Argonの料金一覧
まず、Googleが公式に発表した料金を表にまとめます。特に注意したいのは、Googleが公表しているのは先行提供価格と正式価格の2種類のみで、先行提供期間の長さは明らかにされていない点です。また、Batch、Flex、長文コンテキストの料金区分、キャッシュの保存料などの詳細も発表されていません。
| 課金項目 | 先行提供価格(100万トークンあたり) | 正式価格(100万トークンあたり) | 備考 |
|---|---|---|---|
| 入力 | $2.00 | $4.00 | 先行提供期間は未公表 |
| 出力 | $10.00 | $20.00 | 推論トークンの課金方法は公式に個別説明なし |
| キャッシュ入力 | $0.10 | $0.20 | 入力料金から95%割引。正式価格も同じ割引率で算出 |
| 1回あたりの出力上限 | 100万トークン | 100万トークン | これまでのGeminiモデルは64K |
| Batch / Flex | 未公表 | 未公表 | 既存のGeminiモデルには通常、Batch割引あり |
| 長文コンテキストの料金区分 | 未公表 | 未公表 | 入力コンテキストウィンドウも公式には未公表 |
Gemini 4 Argonの料金で押さえておきたい3つのポイント
1つ目は、推論トークンです。GoogleはArgonの思考トークンの課金方法を個別に説明していません。ただし、現在のGeminiシリーズでは、思考トークンは出力料金として課金されるのが一般的です。予算を立てる際は、Argonもこのルールに従うと仮定するのが無難でしょう。つまり、思考プロセスのトークンもすべて、100万トークンあたり先行提供価格では10ドル、正式価格では20ドルとして計上します。
2つ目は、キャッシュ割引です。キャッシュへの95%割引が適用されると、先行提供期間中のキャッシュ入力は100万トークンあたりわずか0.10ドルです。エージェント型のワークフローでは、システムプロンプトやツール定義、コードベースのコンテキストを各ターンで繰り返し送信します。キャッシュヒット率が70%を超えるケースも多く、この割引は入力単価の2ドル以上に、請求総額を左右する可能性があります。
3つ目は、先行提供期間がいつ終わるかわからないことです。先行提供期間が終了すると、すべての単価が一気に2倍になりますが、Googleは終了時期を公表していません。先行提供価格をもとにROIを試算する場合は、正式価格での試算も用意しておくと、ある日突然請求額が倍増する事態に備えられます。
🎯 予算を立てる際のポイント:Gemini 4 Argonには複数の料金変動要素があるため、まずは少量のトラフィックで実際のトークン消費の傾向を確認してから、大規模な切り替えを検討しましょう。APIYI(apiyi.com)を利用すれば、共通のインターフェースからGemini、GPT、Claudeなど複数シリーズのモデルを呼び出せます。同じタスクを使って、実際のコストを比較しやすくなります。
Gemini 4 ArgonのVertex AI対応に関する最新動向
Argonの公開スケジュールは、開発者にとって特に気になるポイントです。Googleのブログによると、まずFairwindプログラムの信頼できるネットワーク防御担当者とGoogle社内に提供され、その後、有料APIの利用者とGoogle AI Ultraの加入者に公開されます。最後に、より幅広い開発者、企業、一般ユーザーへと提供される予定です。以下の表に、発表からVertex AIで利用できるようになるまでの流れをまとめました。
| 時期 | 出来事 | 情報源 |
|---|---|---|
| 9月3日 | Fairwindプログラムを開始。初回提供モデルはGemini 3.8 Flash Cyber | Google公式ブログ |
| 9月30日 | Gemini 4 Argonを発表。Fairwindの参加者に提供 | Google公式ブログ |
| 9月30日 | DataCampが確認したところ、Vertex AIやGemini CLIなどでは未提供 | DataCamp |
| 10月7〜8日 | コミュニティがVertex AIでgemini-4-argon-cyber-permissiveの項目を発見 |
コミュニティおよびテクノロジーメディア |
| 10月中旬 | Vertex AIでGemini 4 Argonを利用可能に | 最新動向 |
コミュニティが最初に見つけたgemini-4-argon-cyber-permissiveというIDは興味深いものです。「cyber-permissive」は、ネットワーク防御担当者向けにサイバーセキュリティのガードレールを緩和したバージョンであることを示唆しています。これは、Googleのブログにある「信頼できる防御担当者に対してはサイバーセキュリティのガードレールを設けない」という説明とも一致します。一般の有料顧客向けには別のIDが使われ、安全対策も完全な形で維持される可能性が高いでしょう。そのため、接続時には、オンラインで出回っている名称をそのまま使うのではなく、ご自身のGoogle CloudコンソールのModel Gardenに表示されるモデルIDを確認してください。
Vertex AIにおけるGemini 4 Argonの価格とプラットフォームの変更
コミュニティの情報によると、Vertex AIに表示されているArgonのグローバル価格は、100万トークンあたり入力が4ドル、出力が20ドルで、Googleのブログに記載された正式価格です。これは重要な点です。企業がVertex AI経由で接続し、正式価格がそのまま適用される場合、入力2ドル・出力10ドルのお試し価格をもとにした試算は、いずれも2倍にする必要があります。お試し価格がどのチャネルに適用されるのか、Googleは現時点で明確に説明していません。接続前に、コンソールの請求ページで実際の単価を確認してください。
見落とされがちなもう一つの変更は、プラットフォームそのものです。Googleは2026年4月のCloud Nextで、Vertex AIのサービスをGemini Enterprise Agent Platformに統合しました。旧版のVertex AIドキュメントには、今後更新されない旨が記載されています。既存のエンドポイントは引き続き利用できますが、Argonのような新しいモデルのドキュメントや新機能は、Agent Platform側で優先的に公開される予定です。また、Gemini 2.5 Pro、2.5 Flash、2.5 Flash-Liteは10月16日に提供終了となります。これらのモデルを使っているチームにとっては、この機会に移行をまとめて進めるのもよいでしょう。
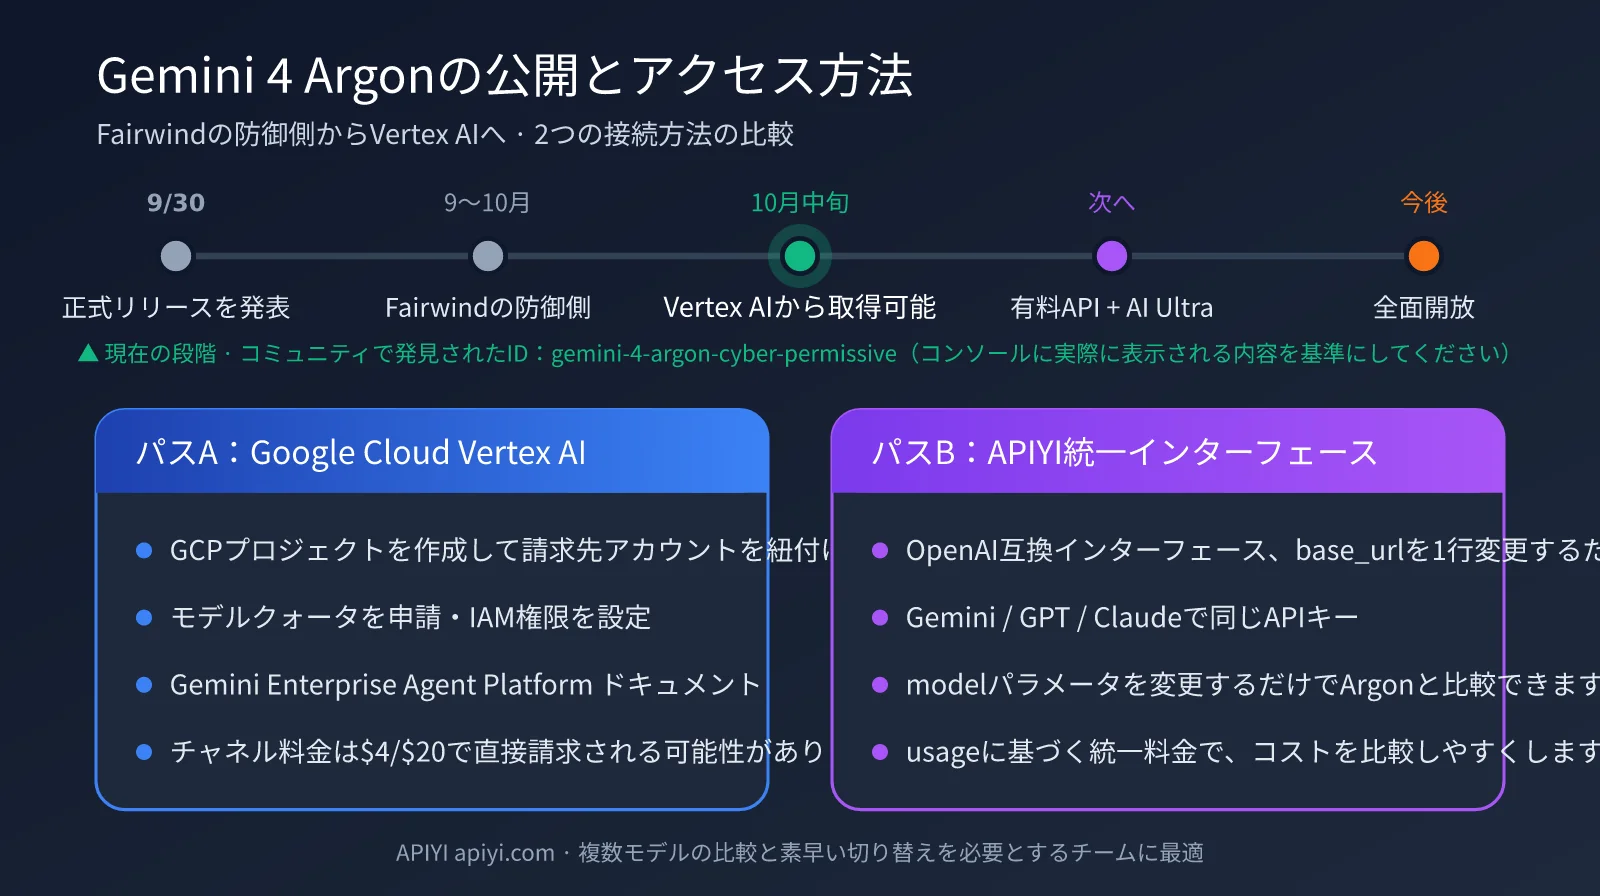
🚀 接続のヒント:Vertex AIを直接利用するには、GCPプロジェクト、課金アカウント、クォータの申請、IAMの設定が必要で、中小規模のチームにとってはハードルが高めです。APIYI apiyi.comのOpenAI互換インターフェース経由でGeminiシリーズのモデルにまとめて接続すれば、
modelパラメーターを変更するだけでArgonとほかのモデルを切り替えられます。
Gemini 4 Argonの価格比較:同門モデルと競合モデル
単価だけを見ても、Argonが高いかどうかは判断しにくいものです。同門のGemini 3.8 Flashや競合のフラッグシップモデルと並べて比較してみましょう。以下は各モデルの表示価格です。競合モデルの価格は第三者による調査をもとにしているため、各社の公式ページもあわせてご確認ください。
| モデル | 入力 / 100万トークン | 出力 / 100万トークン | 1回あたりの出力上限 | 位置づけ |
|---|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | — | 日常利用の主力、高いコストパフォーマンス |
| Gemini 4 Argon(先行価格) | $2.00 | $10.00 | 1M | 長い推論チェーンに対応するフラッグシップ |
| Gemini 4 Argon(正式価格) | $4.00 | $20.00 | 1M | 長い推論チェーンに対応するフラッグシップ |
| Claude Opus 5.5 | $4.00 | $20.00 | 128K | 競合フラッグシップ |
| GPT-6 Astra | $10.00 | $50.00 | 128K | 競合フラッグシップ |
単価で比べると、Argonの先行価格はGemini 3.8 Flashの約2.7倍です。正式価格はClaude Opus 5.5と同額で、GPT-6 Astraの40%にとどまります。ただし、単価はコストの半分にすぎません。同じタスクを完了するために何トークン必要かという点こそ、Argonの価格を評価するうえで注意すべきポイントです。
Gemini 4 Argonのタスクあたりのコスト:鍵を握るのはトークン消費量
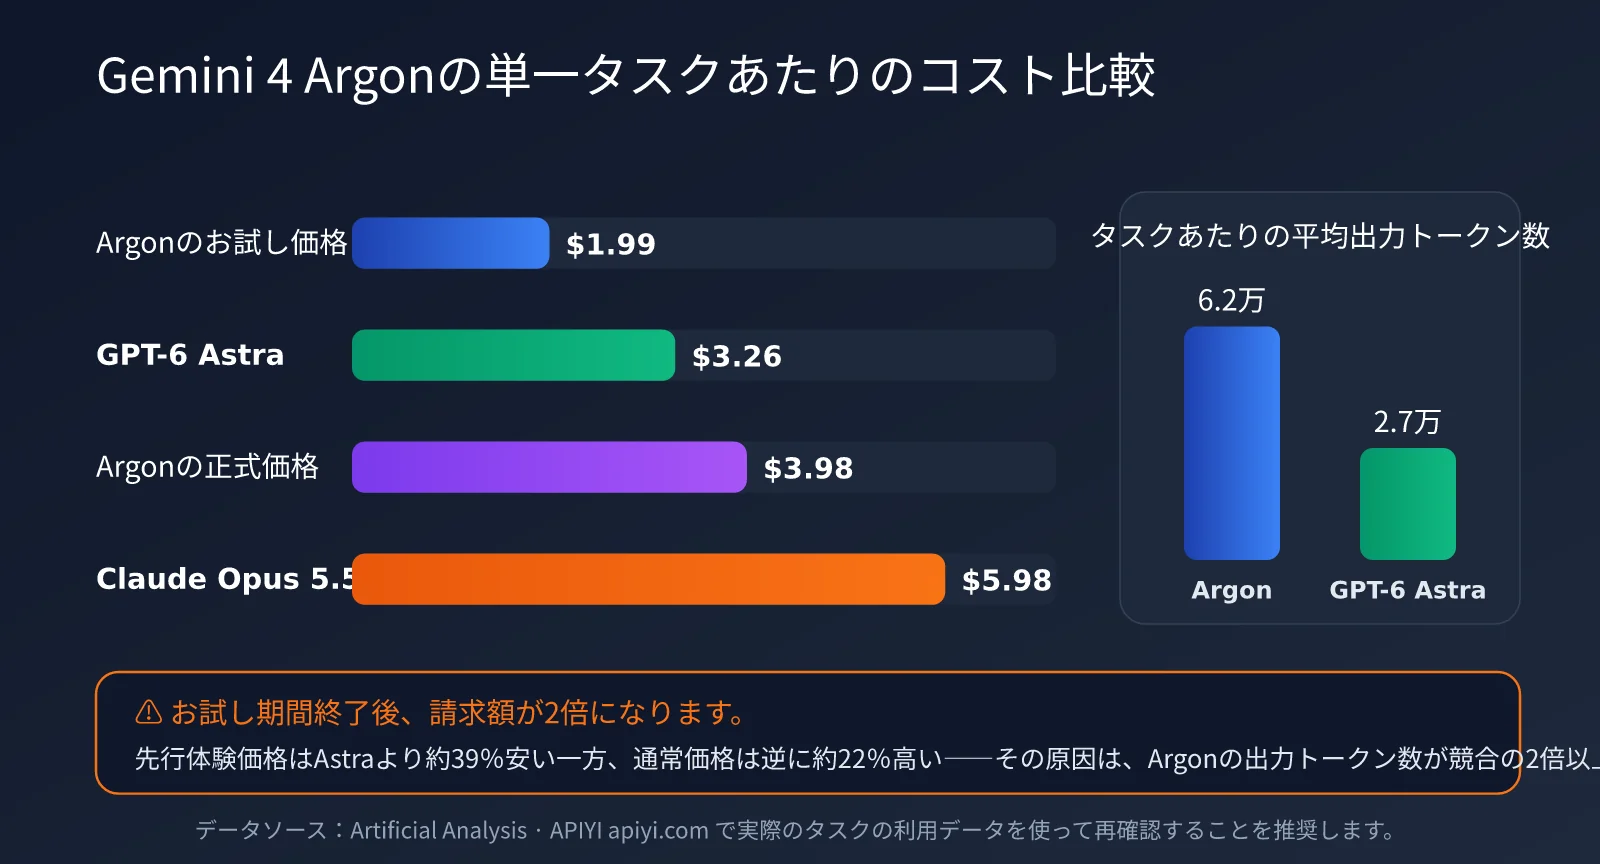
第三者評価機関が算出したタスクあたりのコストを見ると、単価だけでは分からないことが見えてきます。Artificial Analysisのデータによると、Argonはインテリジェンス指数のテストで、タスクあたり平均約6.2万個の出力トークンを生成しました。一方、同じスコアを獲得したGPT-6 Astraの出力は約2.7万個にとどまり、Argonは競合の2倍以上のトークンを使っています。
| 評価指標 | Gemini 4 Argon | 比較モデル | 結論 |
|---|---|---|---|
| AAのタスクあたりコスト(先行価格) | $1.99 | GPT-6 Astra $3.26 | 先行価格の期間中はAstraより約39%安い |
| AAのタスクあたりコスト(正式価格) | $3.98 | GPT-6 Astra $3.26 | 正式価格ではAstraより約22%高い |
| AAのタスクあたりコスト | $1.99 | Claude Opus 5.5 $5.98 | Opus 5.5の約3分の1 |
| Valsのテスト1回あたりのコスト | $15.68 | Opus 5.5 $32.14 / Sonnet 5.5 $21.34 | このワークロードでは最安 |
| タスクあたりの平均出力トークン数 | 約6.2万 | GPT-6 Astra 約2.7万 | Argonの推論プロセスは明らかに長い |
この表から分かる、Gemini 4 Argonの価格に関する最も重要な点は、先行価格の期間中はコストパフォーマンスが高い一方、その期間が終わると、一部のワークロードでは単価が高いGPT-6 Astraよりもコストがかかる可能性があるということです。原因は出力トークンの消費量にあります。ただし、Valsのテストでは別の種類のワークロードでArgonが最安となっています。結論はタスクによって大きく変わるため、自社のデータを使った試算が欠かせません。
💡 モデル選定のヒント:単価が安くても、請求額が安くなるとは限りません。APIYI apiyi.comで同じ実タスクをArgonと他のフラッグシップモデルに実行させ、リクエストごとの
usageフィールドを記録してみましょう。表示価格ではなく、実際のトークン消費量をもとにルーティング方針を決めるのがおすすめです。
Gemini 4 Argonの実コストを試算:代表的な5つのシナリオ
以下では、Googleが公表している単価を使い、先行価格と正式価格それぞれで、代表的な5つのシナリオにおける1回のリクエストコストを試算します。思考トークンはすべて出力トークンに含めています。
| シナリオ | 入力トークン | 出力トークン | 先行価格でのコスト | 正式価格でのコスト |
|---|---|---|---|---|
| 日常的な質問応答 | 2万 | 5000 | $0.09 | $0.18 |
| 長文ドキュメントの分析 | 20万 | 5万 | $0.90 | $1.80 |
| Agentによるコーディング(キャッシュヒット率80%) | 60万 | 6.2万 | $0.91 | $1.82 |
| 大規模なコード移行 | 30万 | 40万 | $4.60 | $9.20 |
| 出力上限1Mを使い切る場合 | 無視できる程度 | 100万 | $10.00 | $20.00 |
Agentによるコーディングのシナリオを例に見てみましょう。入力60万トークンのうち48万トークンがキャッシュにヒットするため、$0.10の単価で計算するとコストはわずか$0.048です。残りの12万トークンは$2の単価で$0.24、出力6.2万トークンは$10の単価で$0.62となり、合計は約$0.91です。キャッシュが十分に活用されている場合、出力トークンが総コストの約7割を占めます。入力を減らすより、出力の長さを抑えるほうが重要です。
大規模なコード移行と、出力上限の1Mを使い切るケースは特に注意が必要です。1Mの出力上限はArgonの大きな特長ですが、正式価格では上限いっぱいまで出力すると1回で$20かかります。クライアントのタイムアウト設定が適切でないと、リクエストの失敗後に自動で再試行され、コストがそのまま倍増する可能性があります。長時間のタスクを1日に何百回も実行するチームでは、こうした見えにくいコストが月額請求を膨らませかねません。
Gemini 4 Argonで見落としやすいコスト
ここまでの試算を踏まえ、Argonを導入する際は、次のような隠れたコストに注意しましょう。
- 推論トークンの増加:Argonの平均出力トークン数はGPT-6 Astraの2倍以上です。出力単価で課金される思考プロセスが、タスクあたりのコストを大きく押し上げる可能性があります。
- 長すぎる出力と再試行:出力上限が1Mの場合、クライアントやロードバランサーのタイムアウト設定が適切でないと、長時間のリクエストが失敗して再試行され、コストが倍増することがあります。
- キャッシュミス:プロンプトの構成が適切でないとキャッシュヒット率が低くなり、95%の割引を活用できません。
- 先行価格の終了:すべての単価が2倍になりますが、終了時期は明確に示されていません。
- 利用チャネルによる価格差:Vertex AIでは先行価格ではなく、正式価格が表示される可能性があります。その場合、先行価格をもとにした試算とは2倍の差が生じます。
Gemini 4 Argonをコストを抑えて導入する方法
前述した隠れたコストを抑えるには、リクエストごとに出力上限を明確に設定する、変わらない内容をプロンプトの先頭に置いてキャッシュのヒット率を高める、タスクの難易度に応じてモデルを振り分ける、という3つの方法が効果的です。以下の例ではOpenAI互換インターフェースを使用し、モデルIDを環境変数で設定しています。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 互換接口
)

# モデル ID 以平台或 Vertex AI 控制台实际显示为准
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")

resp = client.chat.completions.create(
    model=ARGON,
    max_tokens=16000,  # 显式设置输出上限,避免默认放开到 1M
    messages=[{"role": "user", "content": "分析这段代码的并发安全问题"}],
)
u = resp.usage
print(f"输入 {u.prompt_tokens} / 输出 {u.completion_tokens} token")
コード全体を見る:難易度に応じた振り分けとコスト記録
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

# 模型与单价全部配置化,尝鲜期结束后只需改环境变量
ROUTES = {
    "easy": {
        "model": os.getenv("FLASH_MODEL", "gemini-3.8-flash"),
        "price_in": 0.75, "price_out": 3.75, "max_tokens": 8000,
    },
    "hard": {
        "model": os.getenv("ARGON_MODEL", "gemini-4-argon"),
        "price_in": float(os.getenv("ARGON_PRICE_IN", "2")),
        "price_out": float(os.getenv("ARGON_PRICE_OUT", "10")),
        "max_tokens": 64000,
    },
}

# 稳定前缀放在最前面,提升缓存命中率
SYSTEM_PREFIX = open("system_prompt.md", encoding="utf-8").read()


def classify(task: str) -> str:
    """简单示例:长任务、迁移、审计类任务走 Argon,其余走 Flash"""
    keywords = ("迁移", "重构", "审计", "漏洞", "多文件")
    return "hard" if len(task) > 4000 or any(k in task for k in keywords) else "easy"


def run(task: str) -> str:
    route = ROUTES[classify(task)]
    resp = client.chat.completions.create(
        model=route["model"],
        max_tokens=route["max_tokens"],
        messages=[
            {"role": "system", "content": SYSTEM_PREFIX},
            {"role": "user", "content": task},
        ],
        timeout=600,  # 长输出任务放宽超时,避免失败重试导致成本翻倍
    )
    u = resp.usage
    cost = (u.prompt_tokens * route["price_in"]
            + u.completion_tokens * route["price_out"]) / 1_000_000
    print(f"[{route['model']}] in={u.prompt_tokens} out={u.completion_tokens} "
          f"估算成本 ${cost:.4f}(未计缓存折扣)")
    return resp.choices[0].message.content


if __name__ == "__main__":
    print(run("把 legacy/ 目录下的 C 模块迁移为 Rust,并保持接口一致"))
このコードでは、コストを抑えるための3つの原則を実践しています。1つ目は、max_tokensを明示的に設定することです。モデルのデフォルト設定による大きな出力上限に頼らないようにします。2つ目は、システムプロンプトを変わらないプレフィックスとして先頭に置くことです。複数回のリクエストでキャッシュができるだけヒットするようにします。3つ目は、難易度に応じてモデルを振り分けることです。簡単なタスクは、単価がArgonの約3分の1のGemini 3.8 Flashに任せ、長い手順を要する難しいタスクだけをArgonに割り当てます。
おすすめ:まずはAPIYI(apiyi.com)でテスト用クレジットを取得し、上記の振り分けスクリプトで実際のトラフィックを1週間処理してみましょう。その後、usageログを参考に振り分けのしきい値や出力上限を調整するのがおすすめです。
よくある質問
Q1:Gemini 4 Argonの現在の価格は$2/$10ですか、それとも$4/$20ですか?
Googleが公式に発表した期間限定価格は$2/$10、通常価格は$4/$20です。ただし、期間限定価格がいつまで続くのか、また提供チャネルによって価格が異なるのかは明らかにされていません。Vertex AIでは通常価格の$4/$20が表示されているというコミュニティの情報もあります。実際に利用するチャネルの請求単価を確認し、両方の価格を想定して予算を組むことをおすすめします。
Q2:Vertex AIのgemini-4-argon-cyber-permissiveはそのまま使えますか?
IDの名称から、このモデルはサイバー防御を行うユーザー向けにネットワークセキュリティのガードレールを緩和したバージョンと考えられます。Fairwindプログラムのアクセス権限に対応しているため、通常のプロジェクトでは呼び出せないことが一般的です。通常の有料ユーザーは、自分のコンソールのModel Gardenに表示されるモデルIDを確認してください。GCPのプロジェクトやクォータ、権限の設定を避けたい場合は、APIYI(apiyi.com)などの集約プラットフォームからGeminiシリーズのモデルをまとめて呼び出す方法もあります。
Q3:Argonの思考トークンには追加料金がかかりますか?
Googleから個別の説明はありません。ただし、既存のGeminiモデルでは思考トークンも出力料金で課金されるため、同じルールで予算を見積もるのがおすすめです。Argonは平均的に出力トークン数が多く、思考トークンがコストの大部分を占めることもあります。max_tokensを制限し、推論の強度を調整することでコストを抑えられます。
Q4:どのような用途ならGemini 4 Argonに料金を払う価値がありますか?
大規模なコード移行、長文書の専門的な分析、法律・金融分野のエージェント、安全性監査など、長い手順を要するタスクではArgonの性能が活きるため、料金を払う価値があります。一方、日常的な質問、簡単なコード補完、高並列の軽量タスクには、Gemini 3.8 Flashなどの低価格モデルのほうが適しています。APIYI(apiyi.com)で実際のタスクを使ってA/Bテストを行い、その結果をもとにモデルの振り分け比率を決めるのが確実です。
まとめ
Gemini 4 Argonの料金は、「表示価格は魅力的だが、変動要因が多い」とまとめられます。試用価格の$2/$10は、最上位モデルの中でも非常に競争力があります。また、キャッシュ利用時の95%割引は、特にAgentの用途に適しています。一方で、推論トークンの消費量が多いこと、試用期間の終了後に単価が2倍になること、Vertex AIでは通常価格が適用される可能性があることには注意が必要です。こうした要因により、実際の請求額が表示価格から大きくずれることがあります。
Gemini 4 ArgonはすでにVertex AIから利用できますが、次にすべきことは、いきなり全面的に切り替えることではありません。まず実際のトラフィックでトークン消費量の分布を測定し、出力上限の設定、キャッシュのプレフィックス利用、難易度に応じたモデルの振り分けによってコストを管理しましょう。Argonは「難問専用」の最上位モデルとして位置づけ、Flashクラスのモデルと組み合わせて使うことをおすすめします。
Geminiシリーズのモデルは、APIYI(apiyi.com)経由で一元的に利用するのがおすすめです。同じインターフェースからArgonとほかのモデルのコストや性能を比較し、表示価格ではなく実際のデータに基づいてモデル戦略を決められます。
参考資料:
- Google公式ブログのGemini 4 Argon発表記事: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Google Fairwind Programの紹介ページ: deepmind.google/fairwind-program
- DataCampによるGemini 4 Argonのベンチマークと料金のまとめ: datacamp.com/blog/gemini-4-argon
- Artificial Analysisのモデルコストと知能指数: artificialanalysis.ai
- Vals AIのモデル評価とコストデータ: vals.ai
著者:APIYI Team | 大規模言語モデルの料金や利用方法に関する最新情報をお届けしています。AIモデルの利用に関する情報は、APIYI(apiyi.com)をご覧ください。