著者注:iOS 27.3の中国本土向けApple Intelligenceの実機検証をサンプルに、デバイス側モデルとクラウド大規模言語モデルの役割分担ロジックを分解し、そのまま適用できる5次元の判断フレームワークとアプリ実装のステップを提示します。
iOS 27.3開発者ベータ版の配信に伴い、中国本土向けApple Intelligenceがついにテスト開放されました。基盤はApple自社モデルとAlibaba Qwenが共同で支えており、写真消去、基本的な文章推敲、リアルタイム翻訳はデバイス側で動作し、Siriの長時間タスクやビジュアルインテリジェンスの「問い合わせ」はQwenのクラウドに任されています。今回の中国本土向け展開は、まさに具体的な端末・クラウドの役割分担のサンプルです。
これはまた別の機能レビュー記事ではありません。このサンプルを通じて、端末・クラウドの役割分担の設計ロジックを分解します。どのAIタスクがデバイス側に適し、どれがクラウド大規模言語モデルに任せるべきか、開発者は自身のプロダクトでこの線をどう引くべきか、という点です。
本記事のコアバリュー:本記事を読み終えると、5次元の端末・クラウド役割分担を判断するフレームワークを身につけ、4つのステップに沿って自身のアプリに「デバイス側フォールバック + クラウド強化」のハイブリッドアーキテクチャを実装できるようになります。
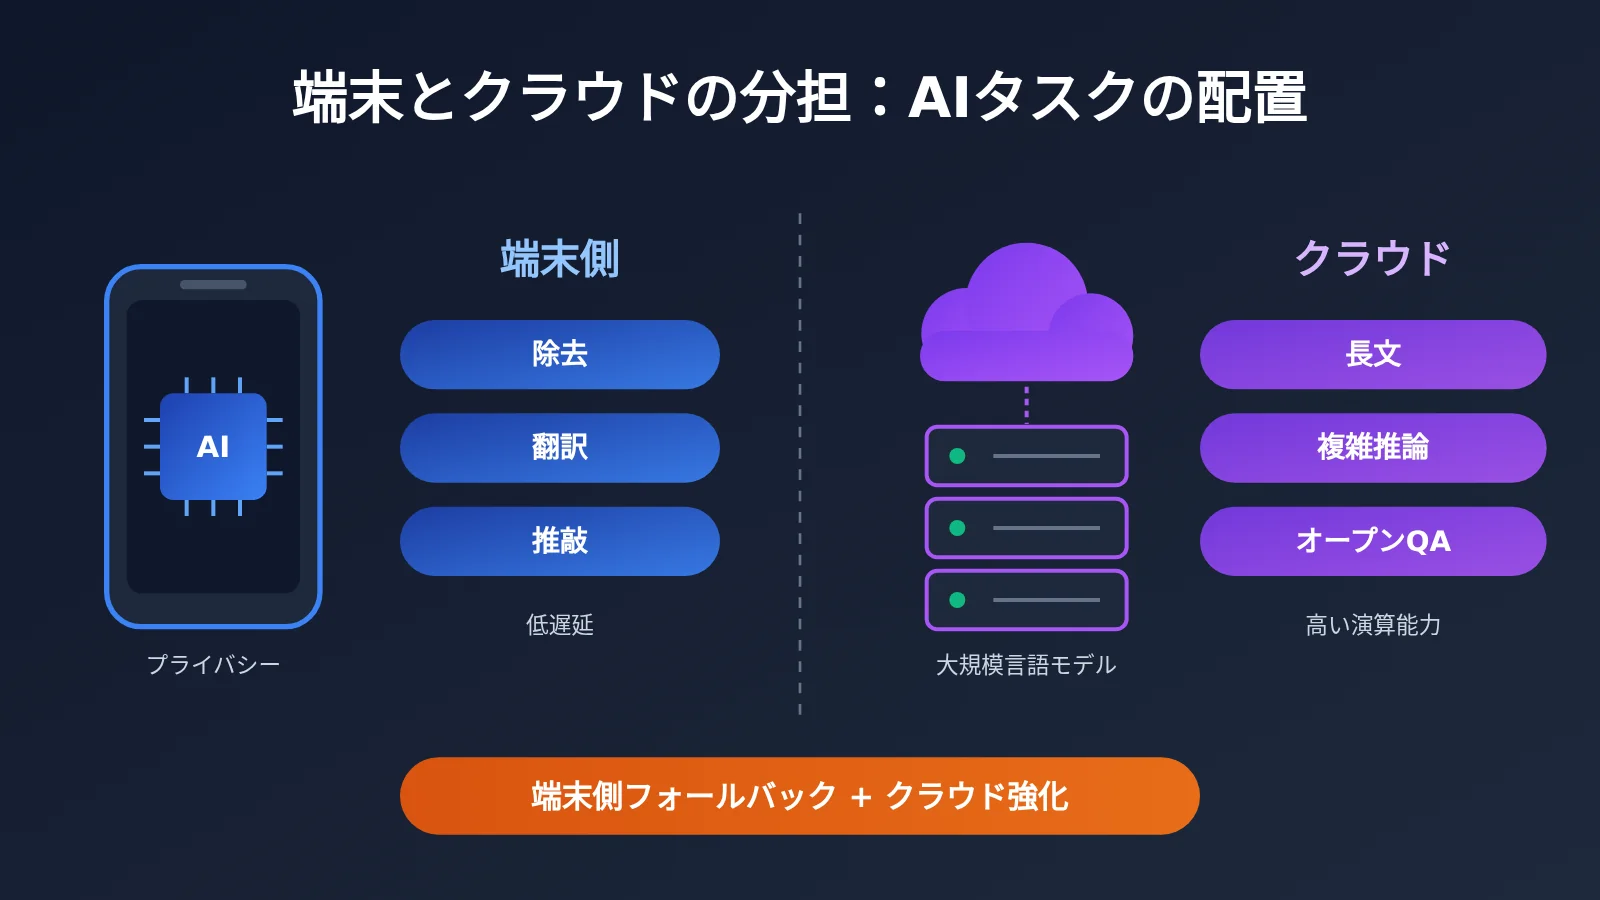
中国国内版 Apple Intelligence の端末・クラウド分担の核心ポイント
まず、実測で確認できた分担状況を一つの表にまとめます。表の「実行場所」と「実測での挙動」は公開された実測に基づくもので、Apple の分担は場当たり的ではなく、明確な法則があることがわかります。
| 機能 | 実行場所 | モデルの提供元 | 実測での挙動 |
|---|---|---|---|
| 写真のクリーンアップ | 端末側 | Apple 自社開発の端末側モデル | 単純な背景ではきれいに仕上がるが、複雑なテクスチャでは低解像度の色ムラが残りやすい |
| リアルタイム翻訳 | 端末側 | Apple の端末側モデル。言語パックのダウンロードが必要(各約 2GB) | 日常会話の遅延は 1 秒未満で、精度も良好 |
| ライティングツール(基本的な推敲) | 主に端末側 | Apple 自社開発モデル | システムレベルの呼び出しは便利だが、中国語の書き換えはやや硬い |
| 通知の要約 / 写真ライブラリの自然言語検索 | 端末側 | Apple 自社開発モデル。ローカルインデックスの構築が必要 | アップグレード直後はインデックス完成まで 1〜2 日待つ必要がある |
| Siri の複雑なタスク | クラウド | Alibaba の Qwen(千問)。ユーザー承認と Qwen アカウントへのログインが必要 | 約 7〜8 秒で結果が出るが、内容はやや簡略 |
| ビジュアルインテリジェンスの「質問」/「検索」 | クラウド | 「質問」は Qwen に接続、「検索」はデフォルトで Baidu のビジョンモデル。サードパーティ製アプリも接続可能 | サードパーティ製アプリが対応すると、検索サービスのリストに表示される |
端末・クラウド分担の重点解説:なぜクリーンアップと翻訳は端末側に残るのか
写真のクリーンアップとリアルタイム翻訳には三つの共通点があります。入力がユーザーのプライベートデータ(写真、通話音声)であること、遅延に極めて敏感であること、タスクの境界が明確であることです。写真に含まれる顔や位置情報がデバイスの外に出ないため、プライバシーリスクは最小限に抑えられます。翻訳は会話しながらリアルタイムに訳す必要があり、ネットワークの往復が一度でも入ると会話のテンポが崩れてしまいます。端末側で 1 秒未満に収まる遅延こそが、体験の鍵なのです。
代償も明らかです。端末側モデルはパラメータ規模がスマートフォンの演算能力とストレージに制限されるため、クリーンアップでは広い草地や玉石のような複雑なテクスチャに遭遇すると失敗しやすくなります。翻訳の言語パックも一つあたり約 2GB を占有します。今回のシステムアップデートパッケージが 12GB にも達したのは、本質的に端末側モデルのために「家賃を払っている」ようなものです。
端末・クラウド分担の重点解説:なぜ Siri の長いタスクはクラウドに任せるのか
「九寨溝 4 日間旅行のプランを立てて」のような要望には、大量の世界知識、長文生成、多段階の計画が必要で、端末側の小型モデルでは到底対応できません。Apple のやり方はこうです。Siri が自身の能力を超える質問を認識すると、Qwen の呼び出しに同意するかどうかをポップアップでユーザーに確認し、拒否された場合は回答をそのまま諦めます。
このポップアップは開発者にとって非常に参考になります。「データがデバイスの外に出る」ことを明示的にユーザーへ伝え、プライバシーに関する判断権をユーザーに返しているからです。同時に実測は、クラウド側の結果品質がシステムからモデルへ渡すコンテキストとプロンプトの設計に依存することを教えてくれます。Siri 版の旅行プランは、Qwen アプリで直接質問するより明らかに見劣りします。これは「大規模言語モデルに接続した」ことが「大規模言語モデルを使いこなした」ことではない、ということを示しています。
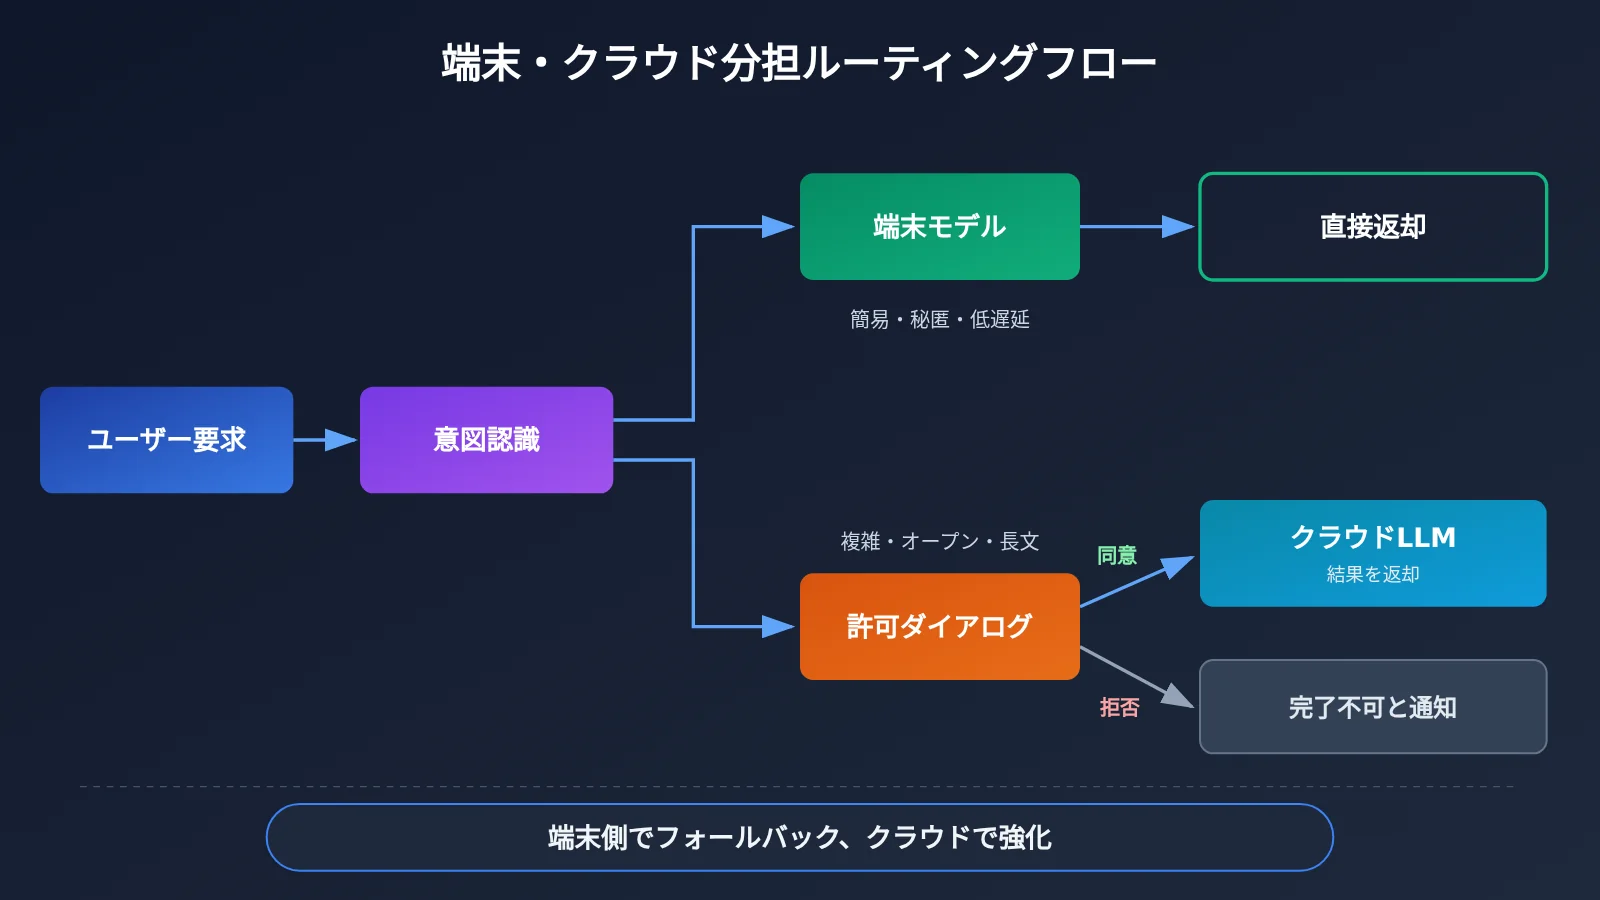
エッジ・クラウド分業の判断フレームワーク:5つの次元でタスクの配置先を決める
中国版 Apple Intelligence の分業体制からは、5つの判断次元を抽象化できます。実際にソリューションを設計する際は、各タスクをこの5つの次元で一つずつ採点し、多くの次元がどちら側に傾くかで配置先を決めるとよいでしょう。
| 判断次元 | エッジ側に傾く特徴 | クラウド側に傾く特徴 | Apple Intelligence における例 |
|---|---|---|---|
| データ機密度 | 写真、連絡先、チャット履歴などのプライベートデータ | 公開知識、ユーザーが自発的に投稿した質問 | 消去はエッジ側、攻略Q&Aはクラウド経由 |
| レイテンシ要件 | 1秒以内の応答が必要で、中断すると無効になる | 数秒の待ち時間を許容できる | 翻訳はエッジ側、Siriの長いタスクは約7〜8秒 |
| タスクの複雑度 | 境界が明確で、出力が短い | オープンなQ&A、多段階の計画、長文生成 | 基本的な推敲はエッジ側、複雑な質問はQwenに委ねる |
| 知識の鮮度 | 外部の最新情報に依存しない | 世界知識やリアルタイム検索が必要 | ビジュアルインテリジェンスの「検索」はBaiduやサードパーティに接続 |
| オフライン可用性 | 弱いネットワークやオフラインでも利用可能でなければならない | デフォルトでオンラインのシナリオ | リアルタイム翻訳は言語パックをダウンロードすればローカル実行可能 |
エッジ・クラウド分業によくある誤解
多くのチームがエッジ・クラウドの分業を設計する際、次のようないくつかの誤解に陥りがちです。事前に回避しておく価値があります。
- 誤解1:エッジ側に置けるものはすべてエッジ側に置く。 エッジ側モデルの能力には上限があり、複雑なタスクを無理に詰め込むと、消去機能の失敗のような低品質な結果しか得られず、かえって体験を損なってしまいます。
- 誤解2:クラウドに接続すれば万事解決。 Siriの攻略の例が示すように、システムプロンプト、コンテキストの構成、出力長の制御も同様に品質を左右します。
- 誤解3:認可とフォールバックを軽視する。 クラウド呼び出しでは、ユーザーが認可を拒否した場合やネットワーク障害時のフォールバック経路を考慮する必要があり、機能をそのまま「消滅」させるわけにはいきません。
- 誤解4:コストを一度しか計算しない。 エッジ側は一度きりのストレージとパッケージサイズのコスト、クラウドは継続的な従量課金の呼び出しコストであり、両者を分けて計上する必要があります。
端末とクラウドの役割分担をすぐに実践:自分のアプリに取り入れる4ステップ
ここからは、判断フレームワークを実行可能な実装ステップに落とし込みます。スマートフォンのOSではなく、一般的なアプリ、ミニアプリ、デスクトップツールを開発している場合でも、この考え方はそのまま活用できます。
ステップ1:タスクを洗い出し、端末とクラウドの役割分担でタグ付けする
プロダクト内でAIを組み込む予定の機能をすべて列挙し、前節の5つの軸で1つずつ評価します。タスク一覧を「タスク名、データの機密度、レイテンシ要件、複雑さ、配置先」といった列を含む形で出力しておくと、レビュー時に全体像が一目で把握できます。
ステップ2:端末側のタスクには軽量なソリューションを選ぶ
端末側のタスクでは、OS標準の機能や軽量モデルを優先的に使いましょう。たとえば、OSが提供する翻訳、OCR、音声認識のインターフェースや、量子化した小規模パラメータモデルなどです。モデルのサイズと初回ダウンロードの体験をしっかり管理することがポイントです。Appleのやり方を参考に、大容量リソースはオンデマンドでダウンロードし、初回利用時には分かりやすい案内を表示します。
ステップ3:クラウド側のタスクには大規模言語モデルAPIを接続する
クラウド側のタスクには、十分な能力を持つ大規模言語モデルを接続する必要があります。中国本土版のApple IntelligenceのようにQwenシリーズを使いたい場合や、GPT、Claudeなどを同時に比較したい場合は、APIYIを通じて統一的に呼び出せます。APIYIは本記事で扱う主要な大規模言語モデルのAPI呼び出しを提供しており、OpenAIとAnthropicの2種類のインターフェース形式に対応しています。既存のコードは、通常はエンドポイントとAPIキーを差し替えるだけで移行できます。利用可能なモデルの詳細は価格ページの一覧をご確認ください。
接続時に注目すべき主要な設定項目は次の表のとおりです。エンドポイントはAPIYIのドキュメント docs.apiyi.com に記載されたものを使用してください。
| 設定項目 | 役割 | 端末とクラウドの役割分担における推奨 |
|---|---|---|
| エンドポイント(base_url) | リクエストの送信先サーバーを指定 | APIYIのドキュメント docs.apiyi.com に従って設定。OpenAI形式とAnthropic形式はそれぞれ対応するアドレスの説明に従う |
| API Key | 認証と課金 | サーバー側でのみ保持し、クライアントのインストールパッケージには含めない |
| model | 呼び出すモデルを指定 | 複雑な計画系タスクには推論能力の高いモデル、簡単なリライトには軽量モデルを選択 |
| max_tokens | 出力長を制御 | 攻略記事やレポート系タスクでは余裕を持たせ、Siriのような過度に簡潔な回答を避ける |
| stream | ストリーミング出力の有無 | クラウドの長時間タスクでは有効化を推奨。数秒の待ち時間による体感レイテンシを補う |
| タイムアウトとリトライ | ネットワーク異常への対応 | 適切なタイムアウトを設定し、失敗時は端末側の簡易結果にフォールバックするか明示的に通知する |
ステップ4:認可ダイアログとフォールバック経路を設計する
SiriがQwenを呼び出す前の確認ダイアログを参考に、ユーザーデータをクラウドへ送信する機能では、初回呼び出し時に「どの情報が、誰に送信されるのか」を必ず説明しましょう。ユーザーが拒否した場合、Siriのようにそのまま諦めるのではなく、端末側の機能に戻って簡易版の結果を返したり、ユーザーに情報の追加入力を促したりできます。
🚀 クイックスタート:まずは最も複雑なクラウドタスクを1つ選んでプロトタイプ検証することをおすすめします。APIYI apiyi.com で登録すればテスト用のクレジットを取得でき、同じOpenAI互換フォーマットのままモデルを切り替えて、どのモデルがあなたのシナリオで最も良い出力を出すかを比較してから、本番方案を決められます。
端末・クラウド分担方式の比較:完全オンデバイス、完全クラウド、デバイス・クラウド協調
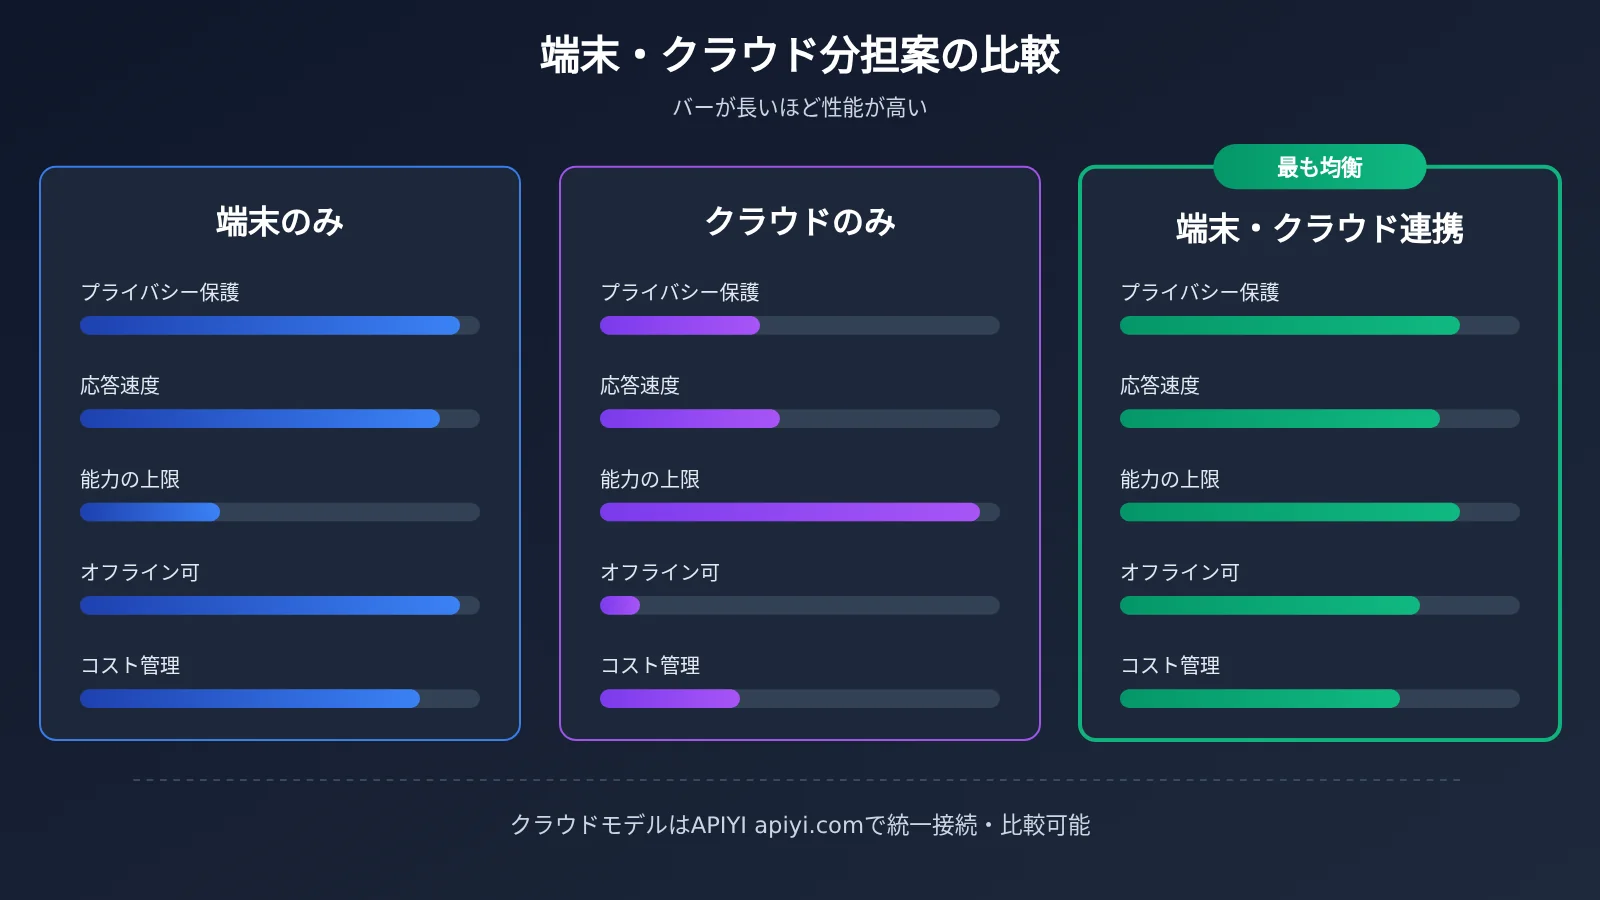
| 方式 | 主な特徴 | 向いている場面 | 主な弱点 | クラウドモデルを利用できるプラットフォーム |
|---|---|---|---|---|
| 完全オンデバイス | データがデバイス外に出ず、オフラインでも利用可能 | 翻訳、消去、音声認識など、境界が明確なタスク | 能力の上限が低く、アプリサイズとストレージの負荷が大きい | 対象外 |
| 完全クラウド | 能力の上限が高く、改善サイクルが速い | オープンな質問応答、長文、多段階プランニング | ネットワークに依存し、プライバシー面の懸念と継続的な呼び出しコストがある | APIYI apiyi.com、各モデル公式API |
| デバイス・クラウド協調 | 端末側でフォールバックし、クラウドで強化。タスクに応じてルーティング | ほとんどの消費者向けAI製品 | アーキテクチャが複雑で、ルーティング、認可、フォールバックの設計が必要 | APIYI apiyi.com、各モデル公式API |
端末・クラウド分担方式の比較解説
完全オンデバイスの比較分析:完全オンデバイスは、プライバシーと応答速度の面で優位に立ちます。リアルタイム翻訳が1秒未満で返る遅延は、その最たる証拠です。ただし端末側のモデルは計算資源とストレージの制約を受けるため、複雑なテクスチャ消去や込み入った中国語の書き換えでは品質が明らかに低下します。これに対してデバイス・クラウド協調は、こうした難題をクラウドに回せるため、プライバシーの最低ラインを守りながら能力の上限を引き上げられます。
完全クラウドの比較分析:完全クラウドは、知識の広さと生成能力で優れた性能を発揮します。Siri が Qwen と接続したことで、攻略系の質問にも答えられるようになりました。しかし呼び出しのたびにネットワークとユーザー認可に依存するため、ユーザーが拒否した場合や電波が弱い場合には機能がそのまま使えなくなります。「いつでも使える」ことが求められる中核機能では、デバイス・クラウド協調のほうが依然として堅実な選択です。
💡 選択のヒント:どの方式を選ぶかは、タスクの構成によって決まります。クラウド側で Qwen、GPT、Claude などのモデルを比較検討する必要があるなら、APIYI apiyi.com の統一インターフェースを使って同じ課題で比較テストを行い、宣伝上のパラメータではなく実際の出力品質で判断しましょう。
端末とクラウドの役割分担におけるコスト計算:端末側は一度きり、クラウドは従量課金
コストは、端末とクラウドの役割分担の中で最も過小評価されがちな要素です。端末側のコストは主に、パッケージサイズ、ユーザーのストレージ占有量、初回ダウンロードの体験に表れます。Apple の今回の 12GB のアップデートパッケージと、1つあたり約 2GB の言語パックは、端末側コストを端的に示す例です。一方、クラウド側のコストは継続的に発生する従量課金であり、ユーザーが活発になるほど費用も高くなります。
Apple 自身もこのコストを計算しています。決算説明会で Apple の経営陣は、今後 Siri AI や高度なスマート写真編集など、クラウド上の大規模言語モデルに依存する機能について基本利用枠を設け、ヘビーユーザーは追加枠を購入する必要があると述べました。つまり、「無料の基本枠 + ヘビーユーザーの課金」がクラウド AI 機能の主流ビジネスモデルになる可能性が高く、開発者が自社製品を設計する際にもこの考え方を参考にできます。
クラウドモデルの呼び出しコストについて言えば、モデルごとに入力単価、出力単価、キャッシュ課金の基準が大きく異なり、しかも随時調整されます。本記事では具体的な価格は一切示しません。すべてのモデル価格、課金基準、入出力単価、キャッシュ価格については、APIYI の価格ページ https://docs.apiyi.com/models の実際のデータを参照してください。
💰 コスト最適化:クラウドコストを計算する際は、「1タスクあたりの平均入力 token × 入力単価 + 平均出力 token × 出力単価」という考え方で見積もることをおすすめします。単価はすべて APIYI の価格ページ docs.apiyi.com/models から取得してください。頻繁に繰り返されるシステムプロンプトについては、価格ページにキャッシュ課金の記載があるか確認し、継続コストをさらに下げましょう。
よくある質問(FAQ)
Q1:端末とクラウドの役割分担とは何ですか?
端末とクラウドの役割分担とは、AIタスクをその特性に応じて切り分け、一部はデバイス上のオンデバイスモデルで処理し、残りはクラウドの大規模言語モデルに送って処理する考え方です。中国版 Apple Intelligence はその典型例で、クリーンアップや翻訳はオンデバイス側で、Siri の複雑なタスクや視覚インテリジェンスの「Ask」は Qwen(千问)のクラウド側で処理します。
Q2:オンデバイスモデルとクラウドの大規模言語モデルの核心的な違いは何ですか?
オンデバイスモデルは、プライバシー、レイテンシー、オフラインでの可用性の面で優位に立ちますが、能力の上限は演算能力とストレージに制約されます。一方、クラウドの大規模言語モデルは知識が広く生成能力も高いものの、ネットワークへの依存、ユーザー認可、継続的な呼び出しコストが伴います。両者は代替関係ではなく、補完関係にあります。
Q3:中国版 Apple Intelligence はいつ正式に使えるようになりますか?
中国版 Apple Intelligence は iOS 27.3 の開発者向けベータ版でテストが開放されました。Apple Developer アプリでサインインしたうえで、ソフトウェアアップデートから入手できます。最初のベータ版ファームウェアには不具合があり、公開報道によれば正式版は12月のリリースが見込まれています。メインで使っている端末は、正式版を待ってからアップデートするのがおすすめです。
Q4:どんな AI タスクがオンデバイス向きですか?
主に次のようなシーンが適しています:
– **プライベートなデータ処理**:写真のクリーンアップ、写真ライブラリの自然言語検索、通知の要約
– **超低レイテンシーが求められる操作**:リアルタイム音声翻訳、入力予測
– **オフラインで必須の機能**:電波が弱い環境での翻訳、音声認識、基本的な文章校正
Q5:API 経由で Qwen などのクラウド大規模言語モデルを手軽に呼び出すには?
マルチモデル集約プラットフォームでのテストがおすすめです:
1. APIYI(apiyi.com)にアクセスしてアカウントを登録し、APIキーを取得します
2. ドキュメントセンター(docs.apiyi.com)で OpenAI 互換フォーマットまたは Anthropic 互換フォーマットの接続手順を確認します
3. 料金ページ(docs.apiyi.com/models)で利用可能なモデルと課金体系を確認したら、エンドポイントとキーを差し替えるだけで呼び出せます
これにより、同じインターフェースのまま Qwen と他の主要モデルの効果を比較できます。
Q6:クラウド呼び出し時にユーザーが認可を拒否した場合はどうすればよいですか?
Siri の場合、回答をそのまま諦めてしまうため、体験としてはややぶっきらぼうに感じられます。より良いのはフォールバック経路を設計することです。オンデバイス側に戻して簡易的な結果を返したり、情報の追加を促してから再試行したりしつつ、ユーザーの選択を尊重し、何度もダイアログを出して邪魔をしないようにします。
Q7:端末とクラウドの役割分担には、どのような既知の制約がありますか?
客観的には、主に次の3点です:
– **アーキテクチャの複雑さ**:意図ルーティング、認可フロー、フォールバック処理を別途保守する必要があります
– **体験の一貫性**:オンデバイス側とクラウド側で出力のスタイルが異なり、ユーザーがちぐはぐさを感じる可能性があります
– **エコシステムの境界**:実機検証で指摘されているとおり、システムの AI は WeChat や美団(Meituan)といったサードパーティ製アプリには入り込めず、個人のコンテキストは依然として分断されたままです。端末とクラウドの役割分担では、データサイロの問題は解決できません
エッジとクラウドの役割分担:核心的なポイント Key Takeaways
- 役割分担の本質:プライベートで低遅延、境界がはっきりしたタスクは端末側に、複雑でオープンな長文タスクはクラウドに
- 中国国内版の事例:Apple自社開発モデルが消去と翻訳を担当し、AlibabaのQwenがSiriの長めのタスクと視覚に関する問い合わせを担当
- 判断フレームワーク:データの機密度、遅延、複雑さ、鮮度、オフライン可用性の5つの軸で一つずつ採点
- 認可が必須:データがデバイスの外に出る前に、明示的にユーザーの同意を得る。拒否された場合のフォールバック経路も用意しておく
- 品質の鍵:大規模言語モデルにつなぐのはあくまでスタート地点。プロンプト、コンテキスト、出力長が最終的な体験を決める
- 導入方法:クラウドモデルはAPIYI apiyi.comから統一的に接続でき、OpenAIとAnthropicのフォーマットに対応
まとめ
中国国内版のApple Intelligenceの実装は、エッジとクラウドの役割分担について明確な参考例を示してくれました。
- 端末側でプライバシーと速度を守る:消去、翻訳、通知の要約といったタスクはデバイス上に残す。その代償はアプリサイズとストレージです
- クラウドで能力の上限を補う:複雑な質疑応答や視覚に関する問い合わせはQwenに任せる。その代償は遅延、認可、そして継続的なコストです
- 協調こそが当たり前の形:端末側でフォールバックし、クラウドで強化する。さらに認可ダイアログとフォールバック経路を組み合わせてこそ、実装可能な製品形態になります
開発者にとって最も現実的な道筋は、まず判断フレームワークでタスクにラベルを付け、そのうえでクラウドタスクを1つ選んでプロトタイプ検証を行うことです。APIYI apiyi.comを通じて統一インターフェースでさまざまな大規模言語モデルの実効性を比較することをおすすめします。モデルの価格と課金の基準については、価格ページ docs.apiyi.com/models を参照してください。
📚 参考資料
- 爱范儿:iPhone 中国国内版 AI を実測:中国国内版 Apple 智能 初版開発者テストの実測
- リンク:
ifanr.com/1687733 -
説明: 本文におけるオンデバイスとクラウドの機能分担、実測結果などの事実の出典
-
APIYI ドキュメントセンター:OpenAI および Anthropic 互換フォーマットの接続ガイド
- リンク:
docs.apiyi.com -
説明: エンドポイント、認証方式、呼び出しパラメータはこちらを基準とします
-
APIYI モデル価格ページ:利用可能なモデル一覧と課金基準
- リンク:
docs.apiyi.com/models - 説明: 入力・出力の単価、キャッシュ価格などの課金情報は、このページの実際のデータを基準とします
作者:APIYI 技術チーム
技術交流:APIYI(apiyi.com)のトップページからお気軽にお問い合わせください。その他の接続資料は docs.apiyi.com ドキュメントセンターでご覧いただけます