
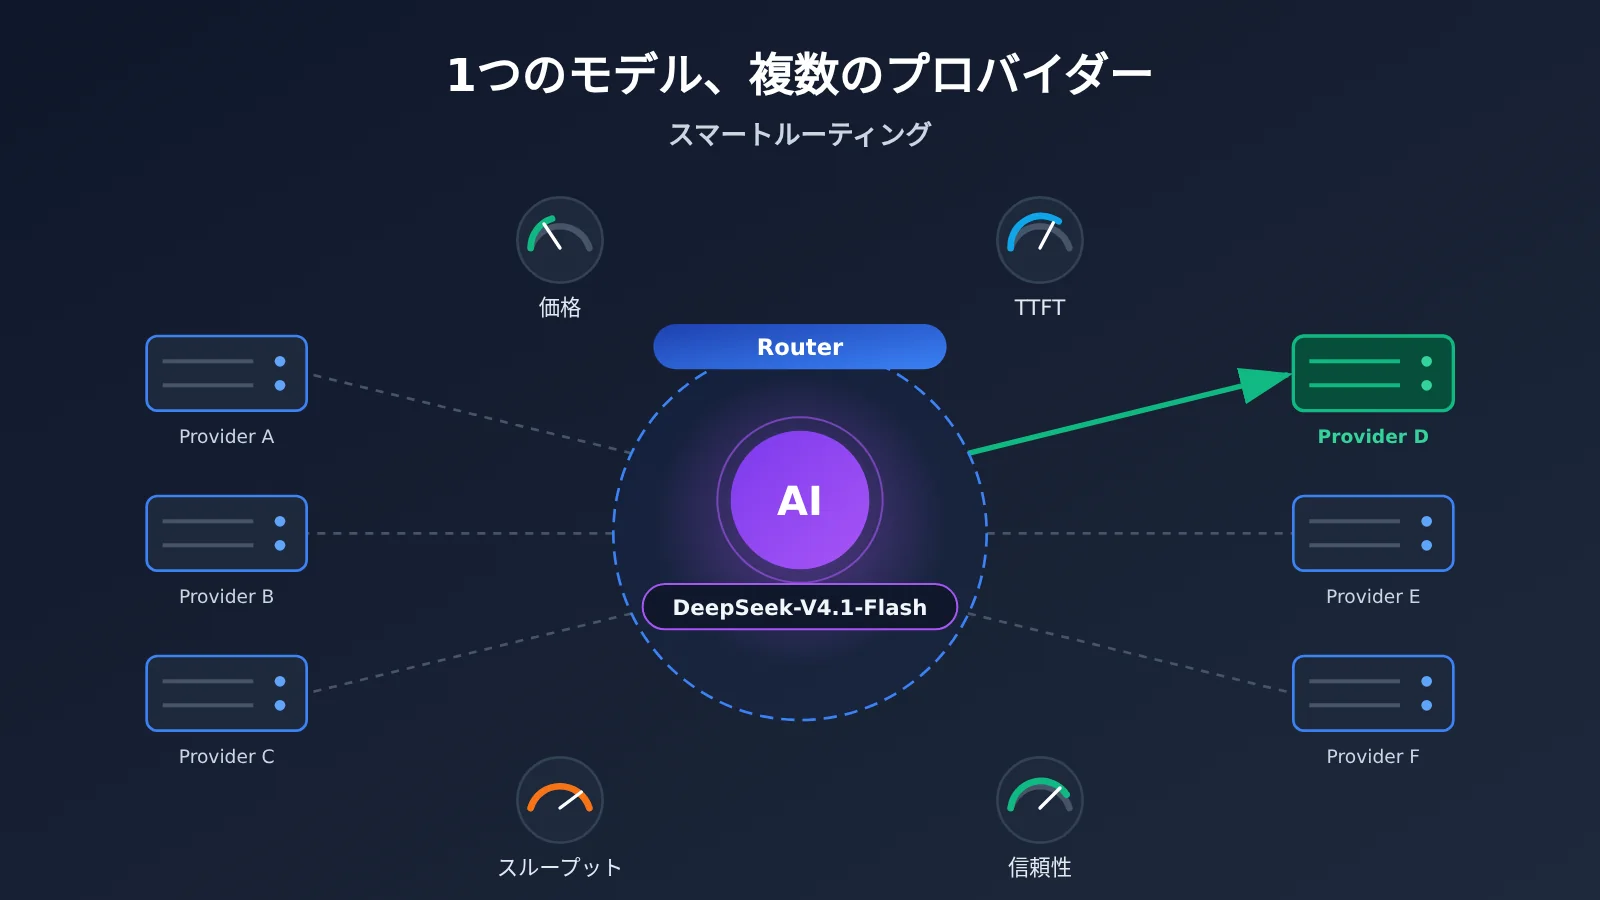
直接回答: 同じオープンウェイトモデルでも、多くの推論プロバイダーがそれぞれデプロイできるため、数十社のAPIプロバイダーが存在します。OpenRouter は単に表示価格が最も安いプロバイダーを見るのではなく、1回の応答を利用可能にするまでの総合コストに基づいてプロバイダーを選びます。実効価格、最初のトークンまでの遅延(TTFT)、スループット、レート制限、信頼性、応答品質という6項目の指標を同時に評価し、その時点で最適なプロバイダーにリクエストを渡します。失敗した場合は別のプロバイダーに切り替えて再試行します。
これは、AI APIアグリゲーションの競争が「統一インターフェースの提供」から「プロバイダーの動的スケジューリング」へと広がっていることを示しています。2026年11月16日、Hugging Face は Inference Providers の言語モデルルーティングを OpenRouter に委ねると発表しました。この提携は、こうした指標がどのようにしてプロバイダーを自動選択する仕組みへと変わるのかを見極めるための具体的なサンプルになっています。
この記事を読むと何がわかるのか?
- 同じAIモデルに複数のAPIプロバイダーが存在する理由、モデル開発元と推論プロバイダーの違い
- プロバイダールーティングがどの判断指標に依存しているのか、各指標がそれぞれ何を解決するのか
- フェイルオーバーで実現できることと、その限界
- Hugging FaceモデルカタログAPIのメタデータを使って、異なるプロバイダーを自分で比較する方法
目次: 客観的事実のパートは次の順序で展開します。まず複数のAPIプロバイダーが生まれる背景を説明し、次にインテリジェントルーティングの判断対象と6つの指標を分解します。続いてフェイルオーバーの流れと制限を説明し、最後に開発者がカタログAPIを使ってプロバイダーを自分で比較する方法を実演します。その合間には、OpenRouterが公開したルーティング実験のデータと課金の変化を挟み込みます。分析・判断のパートでは、APIアグリゲーションプラットフォームの次なる競争の方向性と、開発者がアプリケーション内でどう取捨選択し、検証すべきかを論じます。
複数のAPIプロバイダーとプロバイダールーティングに関する知っておきたい概念
| 概念 | 簡単な説明 |
|---|---|
| プロバイダー | モデルをデプロイし、実際に推論サービスを提供するベンダー。例:Together AI、Novita |
| ルーター | リクエスト条件と利用可能なプロバイダーの状態に基づいて、リクエストの送信先を決めるルーティング層 |
| オープンウェイトモデル | 学習後の重みを公開し、そのライセンスに従って自身でデプロイできるモデル |
| TTFT | Time to First Token。リクエストを送信してから最初のトークンが返るまでの待ち時間 |
| スループット | 単位時間あたりに生成されるトークン数。通常は tok/s で表す |
| フェイルオーバー | 現在のプロバイダーで障害が発生した際に、自動的に別のプロバイダーへ切り替えて再試行すること |
| プロンプトキャッシュ | プロバイダーが繰り返し入力をキャッシュし、計算コストと応答時間を削減すること |
| BYOK | Bring Your Own Key。自身のプロバイダーキーを持ち込み、対応するアカウントの枠を利用すること |
| P50 / P95 | 統計的なパーセンタイル。P50は中央値、P95はより遅い5%のリクエストを反映する |
複数のAPIプロバイダーにおけるルーティング変更の影響の概要
- 開発者: Hugging Face側のコードとトークンは原則として変更不要ですが、実際のプロバイダーはルーティングによって決まります。同じモデルIDでも、リクエストごとに異なるプロバイダーに振り分けられる可能性があります。ツール呼び出しや構造化出力に依存するアプリケーションは、回帰テストをやり直す必要があります。これまでHugging Faceで自前の言語モデルプロバイダーキーを設定していた開発者にとって、この経路はすでに停止しているため、キーと課金の帰属を再確認する必要があります。
- 企業の調達担当とプラットフォームチーム: ベンダーの受け入れ条件、災害対策戦略、データ処理条件を再評価する必要があります。組織は特定のプロバイダーを無効にできますが、それで完全なデータレジデンシーやコンプライアンスの保証が得られるわけではありません。各プロバイダーのデータポリシーを個別に確認する必要があります。
同じAIモデルを複数のAPIプロバイダーが提供する:客観的事実
同じモデルに複数のAPIプロバイダーが存在する理由
モデルの開発元と推論サービス事業者は、別々の役割を担います。開発元はモデルを学習し、重みを公開します。オープンウェイトモデルの場合、計算資源を持ち、ライセンス条件を満たす組織であれば、重みを自社のGPUクラスタにデプロイしてAPIを提供できます。そのためDeepSeek、Qwen、GLMといったモデルは、複数の推論インフラ上で同時に稼働していることがよくあります。
deepseek-ai/DeepSeek-V4.1-Flash を例に取ると、開発者がリクエストするモデル名は同じでも、実際に推論を実行するのはTogether AI、Novita、その他の対応プロバイダーかもしれません。各社が使うハードウェア、クラスタ規模、スケジューリング方式、価格戦略は異なるため、同じモデルでも価格、速度、処理可能な容量には差が出ます。料金が安い代わりにピーク時にレート制限されやすいところ、最初のトークンが速く返るところ、より長いコンテキストをサポートするところ、ツール呼び出し形式の対応がより完全なところなどがあります。
規模のデータから、この市場がどれほど分散しているかがわかります。OpenRouterは提携の発表で、プラットフォーム全体として600以上のモデルに対応し、80以上のプロバイダーと接続、月間800兆トークン以上を処理し、1,000万人以上のユーザーにサービスを提供していると明らかにしました。これらはOpenRouter全プラットフォームのデータであり、今回の提携だけで生まれた規模ではありません。Hugging Faceのプロバイダーページにも、Baseten、Cerebras、DeepInfra、Fireworks、Nebius、Novita、Together AIなど十数社のサービス事業者が掲載されていますが、モデルごとに利用できるプロバイダーは異なります。
1つのモデルに複数のプロバイダーが対応し、各社の条件もリアルタイムに変化するため、「今回のリクエストを誰に任せるか」は継続的に判断が必要な問題になります。ここからマルチプロバイダールーティングが生まれました。
スマートルーティングは一体何を決めているのか
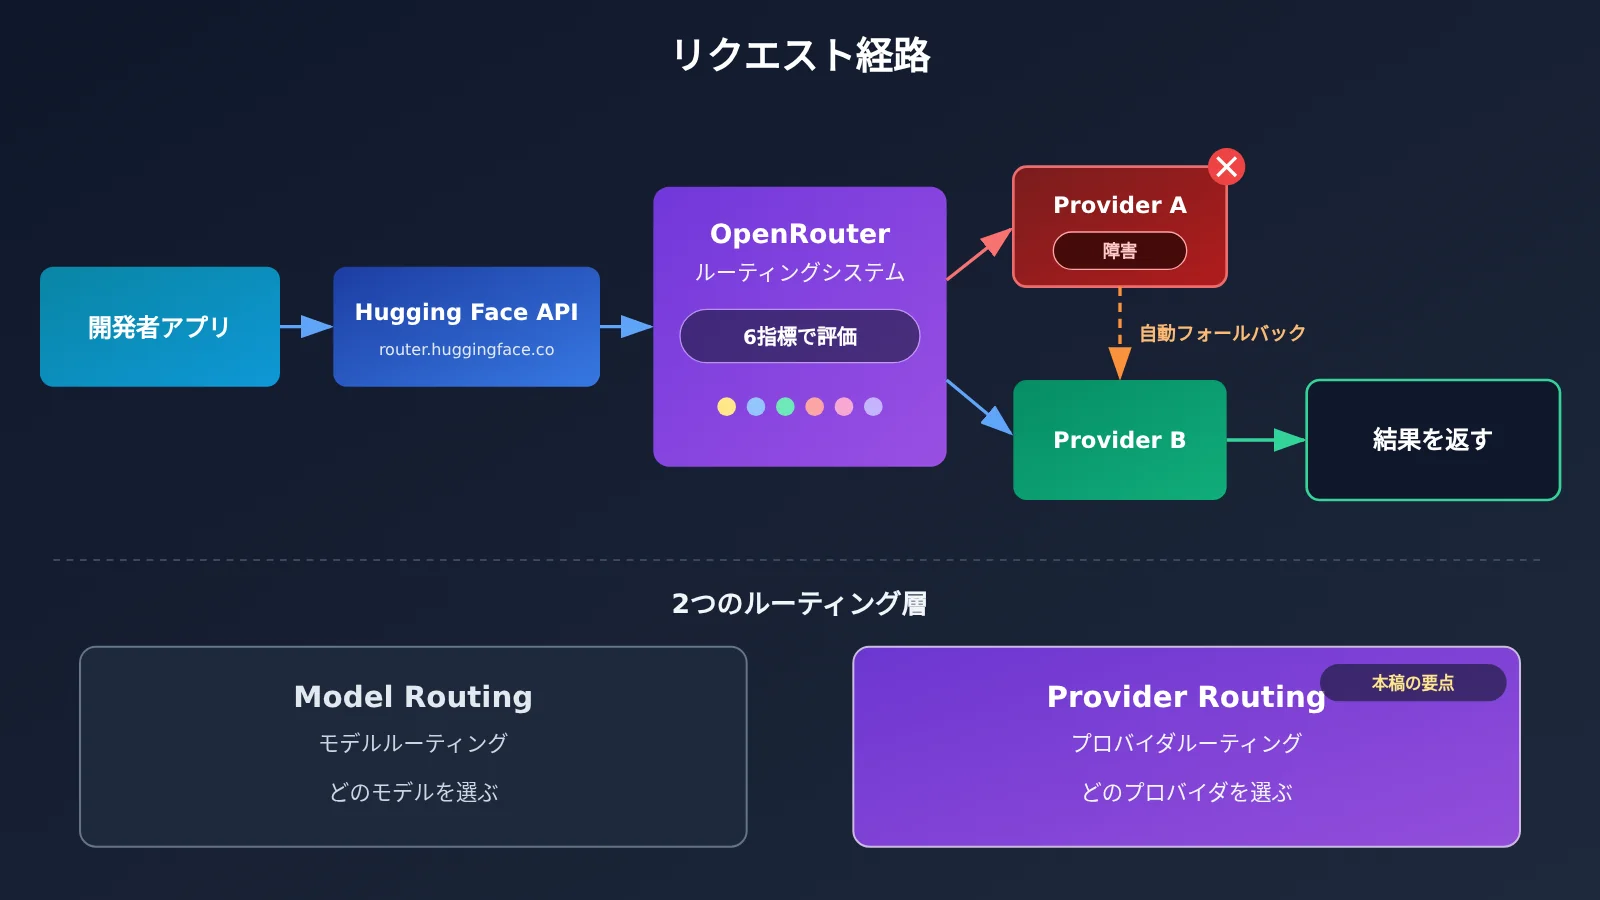
まず、混同しやすい2つの概念を区別しましょう。Model Routing(モデルルーティング) は、どのモデルに回答させるかを決めます。たとえば、簡単な質問は小さいモデルに、複雑な質問は大規模言語モデルに任せます。Provider Routing(プロバイダールーティング) は、モデルがすでに決まっている前提で、どのプロバイダーが推論を実行するかを決めます。本記事で扱う OpenRouter と Hugging Face の提携は後者に当たります。モデルは開発者が指定し、ルーティング層はプロバイダーを選ぶだけで、モデルを勝手に切り替えることはありません。
提携後、言語モデルへの1回のリクエストは次の経路を通ります。開発者アプリまたは Coding Agent → Hugging Face API(router.huggingface.co)→ OpenRouter のルーティングシステム → いずれかのプロバイダーが推論 → 結果を返す。ここで OpenRouter はリクエストのルーティングとプロバイダー選択を担当し、すべてのモデルの推論を実行するわけではありません。ユーザーは引き続き Hugging Face Token を使用し、Hugging Face のアカウントまたは組織アカウント経由で精算します。Hugging Face は、プロバイダーの推論価格に追加のマージンを上乗せしないと説明しています。
Hugging Face では、制御方法として3つのレベルを用意しています。
- デフォルトの自動ルーティング: 公式クライアントでは
provider="auto"を使用し、システムが価格、速度、信頼性を総合的に評価してプロバイダーを選択します。 - プロバイダーの指定: たとえば
provider="together"を指定するか、モデル ID の後ろに:novitaサフィックスを付けると、リクエストはそのプロバイダーに固定されます。 - ポリシールーティング: OpenAI 互換インターフェースでは、
:cheapest(価格優先)と:fastest(スループット優先)のサフィックスを利用できます。
注意すべき点は、:fastest が最適化するのはスループットであり、あらゆる意味での「速さ」ではないことです。TTFT、生成速度、リクエスト全体の時間は、それぞれ異なる指標です。わずか1〜2文しか出力しない短い応答では、最初の Token までの遅延のほうがスループットよりも体感に影響しやすいです。
| 比較項目 | 従来の Hugging Face ルーティング | 新しい OpenRouter ルーティング |
|---|---|---|
| ルーティングシステム | Hugging Face 独自のルーター | OpenRouter |
| プロバイダー選択 | 従来の選択メカニズム | リアルタイムの総合評価 |
| 価格の根拠 | 従来の価格設定ポリシー | 実際の有効価格 |
| 速度要素 | 従来の性能メカニズム | TTFT とスループットを考慮 |
| 1回の失敗 | そのままエラーを返す可能性がある | 同じリクエスト内で別のプロバイダーに再試行できる |
| セッションキャッシュ | 従来のポリシー | セッション単位でプロバイダーを保持できる |
| ユーザー認証情報 | Hugging Face Token | 引き続き Hugging Face Token を使用 |
優れたマルチプロバイダールーティングシステムを評価する際の指標
OpenRouterは2026年10月28日に、次世代のProvider Routingアルゴリズムを公開しました。従来のデフォルトルーティングは入力トークンの表示価格に依存する傾向があり、低価格のプロバイダーがより多くのトラフィックを獲得しやすくなっていました。新しいアルゴリズムでは、以下の6種類のシグナルをリアルタイムのRouting Cost(ルーティングコスト)に統合します。目的は、単に最低単価を追求するのではなく、「一度で成功し、利用可能な応答」の総合コストを最適化することです。
① Effective Price(実効価格) は、「表示価格が安い=請求額が安いとは限らない」という問題を解決します。未キャッシュ入力、キャッシュ入力、出力の3種類の単価を総合し、実際のリクエストにおける入出力比率と、そのプロバイダーのキャッシュヒット率を組み合わせて計算します。OpenRouterの例では、40,000個の未キャッシュ入力トークン($2/M)が$0.080、60,000個のキャッシュ入力トークン($0.50/M)が$0.030、4,000個の出力トークン($8/M)が$0.032、合計$0.142となります。エージェントのシナリオではキャッシュ入力の比率が高くなりがちなので、入力の表示価格だけを比較するとプロバイダーの選択を誤る可能性があります。
② TTFT(最初のトークンまでの遅延) は、「ユーザーが応答を見るまでどれだけ待つか」という問題を扱います。チャットUIやエージェントのマルチターンツール呼び出しでは、各ターンで最初に最初のトークンを待つ必要があるため、特に影響が大きくなります。
③ Throughput(スループット) は、生成開始後の速度を測ります。新しいアルゴリズムでは、瞬間的なピークだけでなく、応答全体の生成過程におけるスループットを評価します。長文生成やコード補完など、出力量の多いタスクは主にこの影響を受けます。
④ Rate Limits(レート制限) は主にHTTP 429エラーに着目し、「プロバイダーの容量不足」という問題を扱います。特定のプロバイダーが頻繁に429を返す場合は計算リソースが逼迫していることを示すため、ルーティングはそのプロバイダーへ割り当てるトラフィックを減らします。
⑤ Reliability(信頼性) はリクエストの失敗頻度を測ります。あるプロバイダーのエラー率が同じモデルの他のプロバイダーより明らかに高い場合、システムは配分を減らし、必要に応じて回復するまでトラフィックを一時停止します。
⑥ Quality(応答品質) は、「同じモデルでもデプロイによって挙動が異なる」という問題を解決します。現在の公開情報によると、品質シグナルは主に、ツール呼び出しが正しく返るか、構造が要求を満たしているかに関係します。ツール呼び出しの形式が異常なプロバイダーや、ベンチマーク精度が明らかに劣るプロバイダーは、競争力が引き下げられます。
これら6つの指標に加えて、OpenRouter自身のルーティングドキュメントではデータポリシーも制約条件に含めています。たとえばdata_collection: "deny"はデータ収集要件を満たさないプロバイダーを除外でき、zdr: trueはゼロデータ保持エンドポイントの使用を要求します。Hugging Faceのセキュリティドキュメントでは、ユーザーのリクエストデータをモデルのトレーニングに使用せず、ルーティング時にリクエスト本文とレスポンスを保存せず、デバッグログは最長30日間保持され、ユーザーデータやトークンを含まないと説明されています。ただし、実際のプロバイダーのデータセキュリティポリシーを確認する必要があるとも開発者に注意を促しています。プラットフォームの約束は、各プロバイダーのデータ処理契約に代わるものではありません。
OpenRouter ルーティングの実験データとトレードオフ
新アルゴリズムの本番投入前に、OpenRouter は 2026 年 10 月に 1 週間のスイッチバック(交互切り替え)実験を行いました。1 日を 3 時間ごとのブロックに分割し、条件を揃えたブロックで新旧アルゴリズムをそれぞれ使用し、切り替えごとに 1 時間のウォームアップ期間を設けて測定から除外しました。合計は 2,400 万回を超えるリクエスト、1,030 億の入力トークンに及びます。ユーザーをランダムに群分けするのではなく交互切り替え方式を採用したのは、新アルゴリズムが過負荷のプロバイダーからトラフィックを移すことで旧アルゴリズム群にも恩恵が及び、比較が乱されるためです。
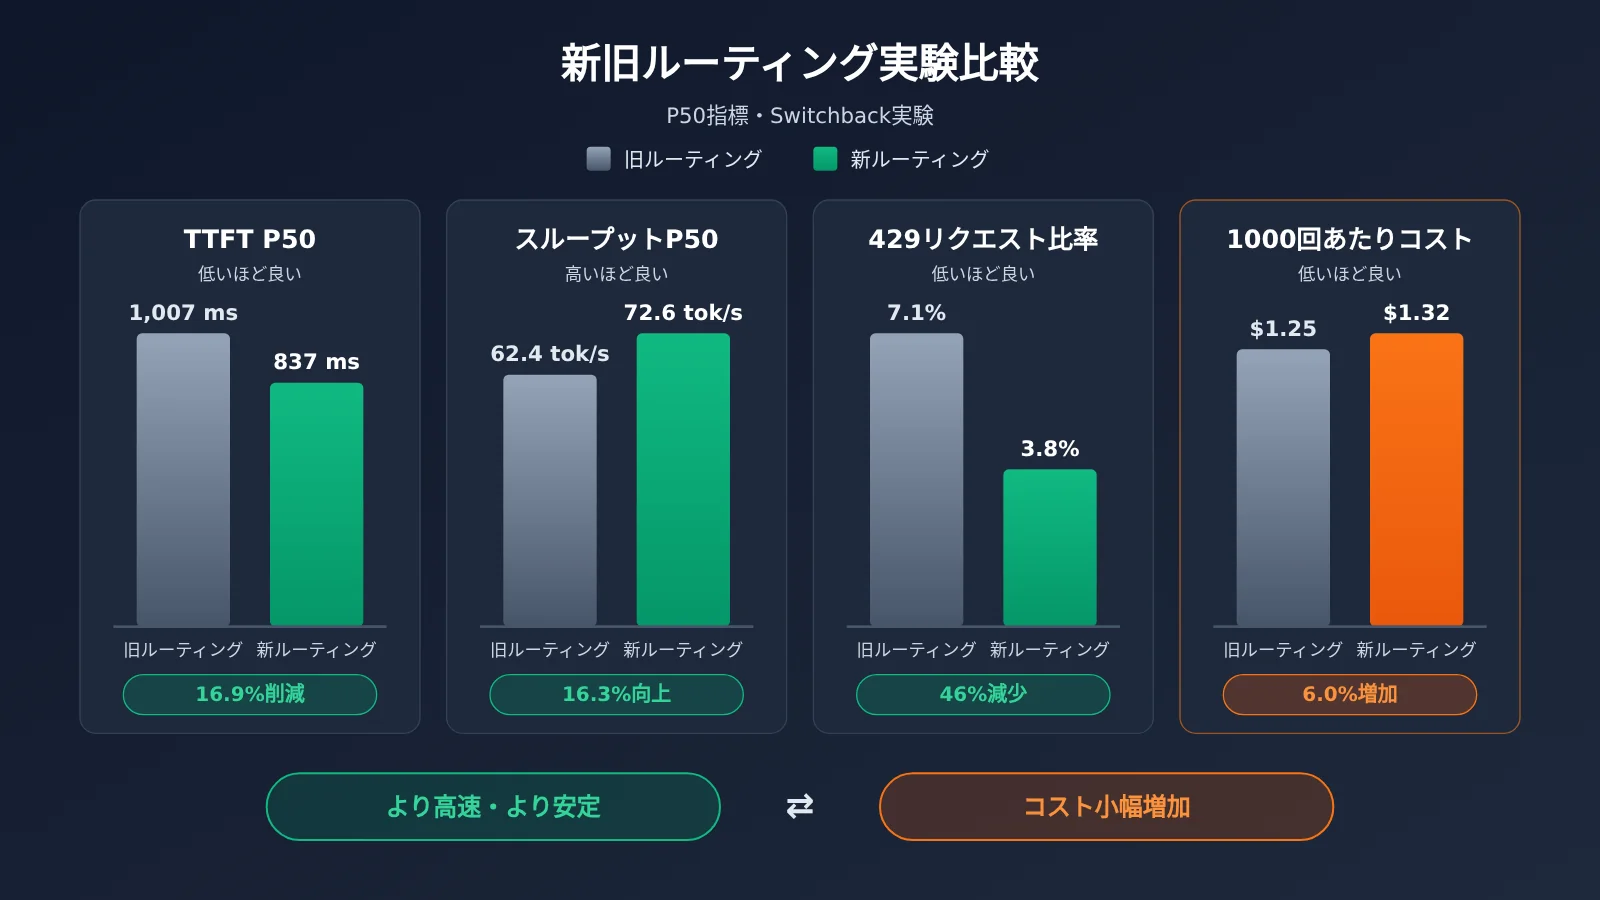
| 指標 | 旧ルーティング | 新ルーティング | 変化 |
|---|---|---|---|
| TTFT P50 | 1,007 ms | 837 ms | 16.9% 低下 |
| TTFT P95 | 4,601 ms | 3,733 ms | 18.9% 低下 |
| スループット P50 | 62.4 tok/s | 72.6 tok/s | 16.3% 向上 |
| リクエスト完了までの時間 P50 | 4.00 s | 3.24 s | 19.0% 低下 |
| 少なくとも 1 回 429 が発生したリクエスト | 7.1% | 3.8% | 46% 減少 |
| リトライが必要だったリクエスト | 10.4% | 6.9% | 34% 減少 |
| 1,000 リクエストあたりのコスト | $1.25 | $1.32 | 6.0% 増加 |
| 100 万トークンあたりのコスト | $0.301 | $0.324 | 7.3% 増加 |
このデータは新ルーティングの核心的なトレードオフを示しています。すなわち、1,000 リクエストあたり約 6% のコスト増と引き換えに、より低いレイテンシとより少ない容量エラーを得るというものです。いくつか制約も説明しておきます。実験は OpenRouter 自身が設計・公表したもので、第三者による監査は受けていません。サンプルは代表的なオープンモデルの一群であり、すべてのモデルやプロバイダーを代表するものではありません。結果は全体の統計であり、個々のリクエストが必ず 16.9% 改善するという意味ではありません。これらのデータも提携前の OpenRouter による実験に基づくもので、Hugging Face 上での提供開始後の独立した実測ではありません。
💡 テストのヒント: ルーティング実験が示すのは全体の統計であり、自社のビジネスでのパフォーマンスは自分で測定する必要があります。同じコードの中で複数の主要モデルの出力品質とコストを横並びで比較したい場合は、APIYI apiyi.com から 1 つの Key で統一的に呼び出せます。まずモデル層での選択を確定し、そのうえでプロバイダー層の最適化を検討するとよいでしょう。
Provider に障害が発生したとき、システムはどう切り替えるのか
自動 Failover の典型的な流れは次のとおりです。まずルーティングが Provider A を選び、A が正常ならそのまま結果を返します。A がエラーを返したり容量の問題に直面したりすると、システムは同一リクエストの中で Provider B を試します。B が成功すれば、その結果を返します。実験では「リトライが必要なリクエスト」が 10.4% から 6.9% に減り、1リクエストあたり失敗した試行に費やす時間も 349 ms から 242 ms に短縮されました。つまり、優れたルーティングはリトライできるだけでは足りず、そもそも最初から状態の良くないプロバイダを避ける必要がある、ということです。
自動フォールバックと Provider の指定は、互いにトレードオフの関係にあります。デフォルトのルーティングは切り替えを許容するため可用性が高くなります。一方、Provider を指定するとリクエストは1社に固定され、ベンダー受け入れ要件を満たせますが、フェイルオーバーの余地は失われます。OpenRouter 自身の API は、only(指定した Provider のみを許可)と allow_fallbacks: false(自動フォールバックを行わない)を組み合わせて提供しており、これによりコンプライアンスを満たすプロバイダが存在しない場合に、他のベンダーへ転送するのではなく、リクエストをそのまま失敗させることができます。ここで区別しておきたいのは、これらが OpenRouter の完全な API のパラメータであり、Hugging Face のインターフェースで全面的に開放されていると解釈してはいけないという点です。Hugging Face 側の対応する機能は、Provider の指定と、設定画面での Provider の無効化です。
リトライにはコストが伴い、無制限に行えるものではありません:
- 時間コスト: 失敗した試行のたびに全体の所要時間が延び、リアルタイムなインタラクションへの影響は顕著です。
- ストリーミング出力: すでに出力が始まっているストリーミング応答は、別のプロバイダへシームレスに引き継ぐことができません。
- 副作用の重複: ツール呼び出しが最初の試行ですでに外部アクションを起こしている場合、リトライによって二重に実行される可能性があり、アプリケーション側で冪等性を担保する必要があります。
- キャッシュの損失: Prompt Caching は通常、特定のプロバイダに紐づいており、プロバイダを切り替えるとキャッシュの恩恵を失うことがあります。Hugging Face はこのために
X-HF-Session-Idリクエストヘッダを提供しており、安定した UUID を使うことで、同じセッションをできるだけキャッシュを保持している Provider に留められます。 - 利用可能なプロバイダがない: あるモデルを提供するのが1社だけの場合、あるいは他の Provider が現在のパラメータに対応していない場合、切り替え先が存在しません。クォータ不足、Token 権限不足、無効なリクエスト、コンテキストの上限超過といった問題も、ルーティングでは解決できません。
Hugging Faceの課金と独自キーに関する変更
今回の提携により、破壊的変更が1つ導入されます。Hugging Face経由で言語モデルを呼び出す場合、自前で設定したプロバイダーのAPIキーは使用できなくなります。関連するリクエストはすべてOpenRouter経由でルーティングされ、費用はHugging Faceのアカウントまたは組織アカウントに計上されます。画像・動画生成タスクでは自前のキーが引き続き利用できますが、詳細は公式の説明をご確認ください。
開発者が引き続き自身で購入したプロバイダーの利用枠を使いたい場合は、そのプロバイダーのAPIを直接呼び出すか、OpenRouter自身のアカウントに切り替える方法があります。OpenRouterの現在のBYOKドキュメントの記載によると、BYOKの無料枠は同等の推論カタログコストで計測され、Pay-as-you-goアカウントでは月額25,000ドル、Enterpriseではカスタム枠となります。超過分は同等の推論費用の5%で課金され、プラットフォームのCreditsから差し引かれます。ここでの25,000はドル建ての推論コストであり、リクエスト回数ではありません。また、共有キャパシティにフォールバックすると、プラットフォームのCreditsを消費する場合があります。OpenRouterへ直接接続する場合は、別途独立したアカウントと課金関係になり、既存のキーが自動的に移行されることはありません。
Hugging Faceの現在の料金ドキュメントでは、Freeユーザーに固定の月次付与枠はなく、PROユーザーは月額2ドル、TeamとEnterpriseは1席あたり月額2ドルです。これらの枠は汎用のCompute Creditsであり、Inference Providers、Inference Endpoints、Spacesなどのサービスに充当できます。もう1点注意すべきは、Providerの価格設定メカニズムが変わらないことは、リクエストごとのコストが変わらないことを意味しないという点です。ルーティングによって、やや高価でも高速で安定したプロバイダーが選ばれる可能性があるためです。
開発者がカタログAPIを使って複数のプロバイダーを自分で比較する方法
Hugging Face は照会可能なモデルカタログインターフェースを提供しています。これは、ルーティングシステムが判断材料を得るための公開窓口の一つです:
- すべてのモデル:
GET https://router.huggingface.co/v1/models - 個別モデル:
GET https://router.huggingface.co/v1/models/deepseek-ai/DeepSeek-V4-Pro
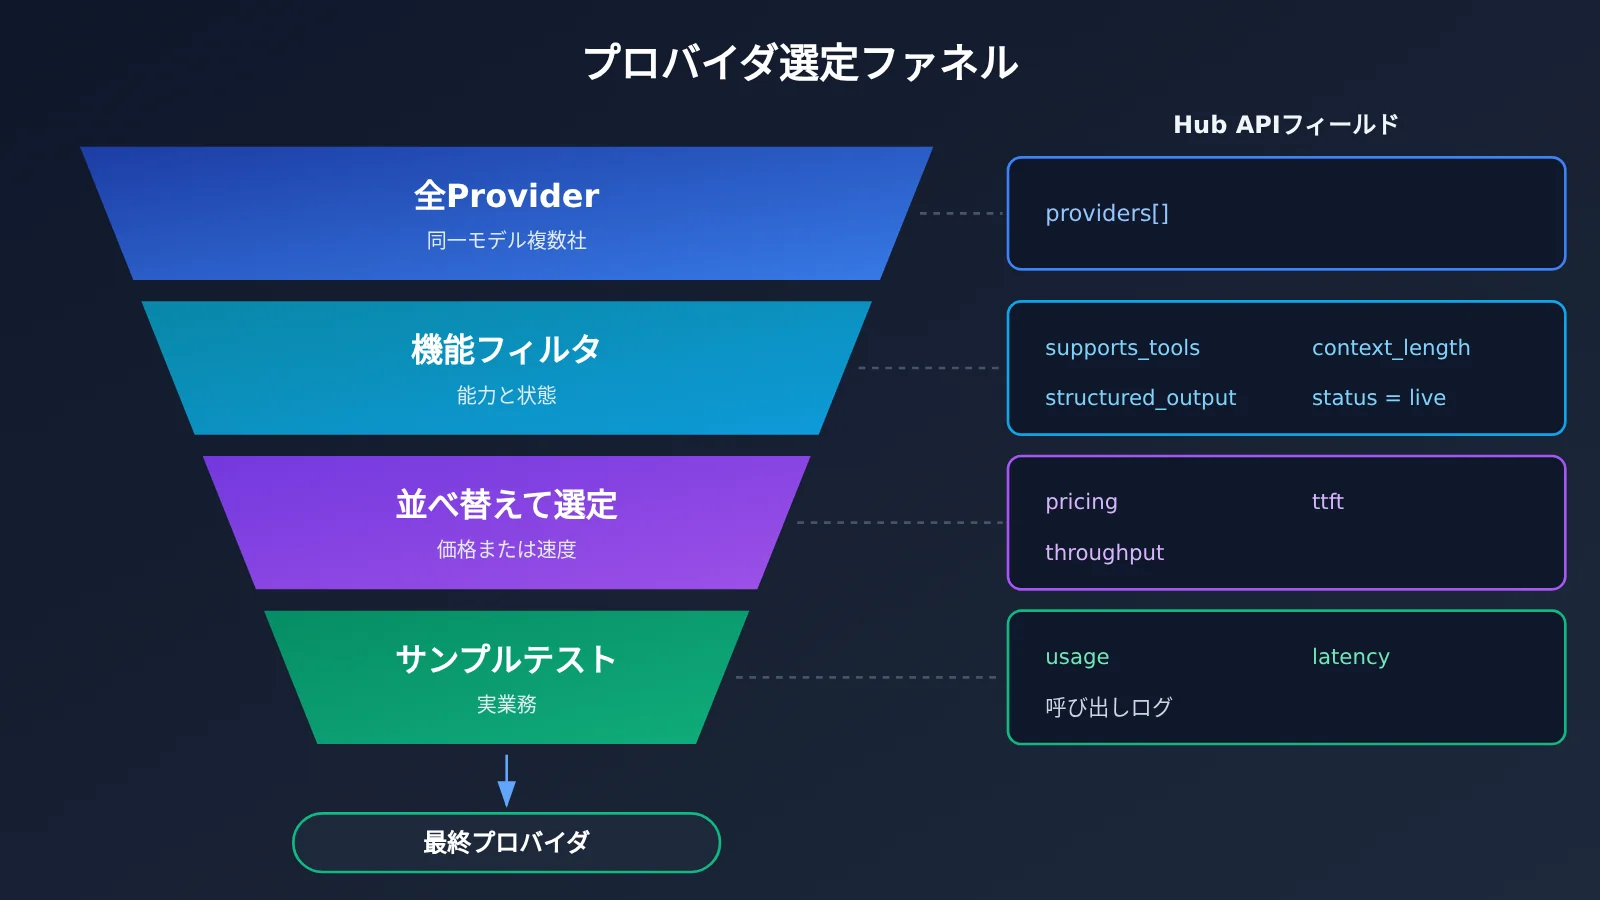
| フィールド | 意味 | 選定における役割 |
|---|---|---|
| provider | 実際に推論を提供するプロバイダー | 候補リストの確定 |
| status | 現在の状態(live、error など) | 利用不可のプロバイダーを除外 |
| context_length | そのプロバイダーがサポートするコンテキスト長 | 長いコンテキスト要件でフィルタリング |
| pricing.input / pricing.output | 100万入力・出力Tokenあたりの米ドル価格 | コスト順の並べ替え |
| supports_tools | ツール呼び出しをサポートするか | エージェントシナリオの必須条件 |
| supports_structured_output | 構造化出力をサポートするか | JSON 出力の必須条件 |
| first_token_latency_ms | 直近の検証プローブにおける最初のTokenの遅延 | 対話型の並べ替え |
| throughput | 直近の検証プローブにおける生成速度 | 長い出力向けの並べ替え |
| is_free / is_model_author | 一時的な無料キャンペーン / モデル公開者かどうか | 補助的な参考 |
これらのフィールドはすべての Provider が完全に提供しているわけではなく、性能データも直近の検証プローブに基づくもので、あなた自身のエンドツーエンドのリアルタイム性能とは異なります。合理的な方法は「まずフィルタリングし、次に並べ替える」ことです。まず機能フィールドで互換性のないプロバイダーを除外し、その後コストや速度で並べ替えます。以下の例はこの考え方を示したもので、返却構造は公式 Hub API ドキュメントを基準にしてください:
import os
import requests

HF_TOKEN = os.environ["HF_TOKEN"]
MODEL = "deepseek-ai/DeepSeek-V4.1-Flash"

resp = requests.get(
    f"https://router.huggingface.co/v1/models/{MODEL}",
    headers={"Authorization": f"Bearer {HF_TOKEN}"},
    timeout=30,
)
data = resp.json()
providers = data.get("providers", [])  # 具体的な構造は公式ドキュメントを基準にしてください

# 第一步:機能フィルタリング(エージェントにはツール呼び出し + 構造化出力 + 64K コンテキストが必要)
candidates = [
    p for p in providers
    if p.get("status") == "live"
    and p.get("supports_tools")
    and p.get("supports_structured_output")
    and (p.get("context_length") or 0) >= 64_000
]

# 第二步:出力単価で並べ替え、欠損フィールドは最後に回す
candidates.sort(key=lambda p: (p.get("pricing") or {}).get("output", float("inf")))

for p in candidates:
    print(p["provider"], p.get("pricing"), p.get("first_token_latency_ms"), p.get("throughput"))
候補を絞り込んだ後は、必ず実際の業務リクエストで一度テストする必要があります。カタログのメタデータはプロバイダーが「何をサポートすると主張しているか」を示すものであり、自分のタスクにおける精度、ツール呼び出し成功率、最終完了率の代わりにはなりません。
プロバイダーレベルで細かく調整する前に、通常はまずどのモデルを使うかを決めます。以下のコードは、同じ OpenAI 互換インターフェースを使って複数モデルの回答を一括比較する例です。モデル ID はプラットフォームのモデル一覧にある実際の名前に置き換えてください:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェース、1つの APIキーで複数のモデルを呼び出し
)

prompt = "用 JSON 返回:{\"city\": 城市名, \"reason\": 一句话理由},推荐一个适合冬季旅行的城市"

for model in ["model-id-a", "model-id-b", "model-id-c"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content)
🚀 クイックスタート: 新規ユーザーは APIYI apiyi.com で無料テスト枠を受け取り、上記のコードを使って自分の業務サンプルを一通り実行できます。バックエンドの呼び出しログには、各リクエストのモデル、Token 消費量、費用が記録されるため、表示価格だけを見るのではなく、実際のタスク単価を算出できます。
補足しておきたいのは、統一アクセスと呼び出しログ、そして Hugging Face が表示する Provider レベルのリアルタイム性能データは、それぞれ異なるレイヤーの機能だという点です。前者は「接続できること・正確に計測できること」を解決し、後者はさらに基盤サービスプロバイダーの動的な状態を可視化します。両者は組み合わせて使うことができます。
複数の API サービスプロバイダーとインテリジェントルーティング:分析と判断
API聚合プラットフォームの次なる競争軸はどこにあるのか
OpenRouterの機能を分解して見ると、3つの層に分けられます。モデル集約は「異なるモデルへどうアクセスするか」を解決し、Provider集約は「同じモデルを誰が推論するか」を解決し、動的ルーティングは「今回のリクエストを誰に委ねるべきか」を解決します。統一インターフェースによって接続の問題はほぼ解決済みであり、今回の提携は、第2層と第3層が新たな競争点になりつつあることを示しています。この判断の根拠は、Hugging Faceが自社ルーターの構築を断念し、外部のルーティング機能を採用したこと、そしてOpenRouterもルーティングアルゴリズムを単独で公開し、本番環境での実験によってその価値を実証したことです。
コスト最適化、安定性、データガバナンスが、APIプラットフォームの新たな比較軸になると予想されます。以下は予測であり、今後の検証を待つ必要があります。ルーティングの透明性はますます重要になり、開発者はリクエストがどのサービス提供元に届いたのか、なぜそれが選ばれたのか、いくら支払ったのかを知りたがるでしょう。データポリシーによる制約は、追加オプションから企業調達の必須条件へと変わる可能性があります。
ただし、ルーティングは万能薬ではありません。実験データが示すのは、より速く、より安定させる代償として単位コストが高くなるということです。提携発表に含まれる今後の計画(両者のアカウントを連携させる、より多くのタスクをOpenRouterのルーティングに組み込むなど)も、まだ計画にすぎません。ルーティングはまた、モデル自体の品質、ライセンス、ビジネスへの適合性といった問題を解決することもできません。
オープンウェイトモデルの需要と企業のコストプレッシャー
需要側のデータは、「プロバイダーのルーティングが重要になる」という判断を裏付けています。OpenRouterの統計によると、上位50モデルの週間トークン量で計算した場合、2026年9月28日時点でオープンウェイトモデルが占める割合は71.7%に達しました。これはOpenRouterプラットフォーム内の集計基準であり、世界市場のシェアとして一般化することはできません。オープンウェイトモデルの利用量が増えるほど、同じモデルを複数のプロバイダーが提供する状況は一般的になり、ルーティングの価値もより明確になります。
コスト面では、Capgeminiが2026年9月に大企業のCXO 500人を対象に調査したところ、59%がAI支出は明らかに想定を超えていると回答しました。影響を受けた企業における平均超過額は24%です。このデータはあくまで同調査のサンプルを表すものですが、ルーティング実験で「速度向上に伴いコストも上昇する」という結論と併せて考えると、企業に次のことを促します。自動ルーティングがデフォルトで追求するのは総合的な体験であり、必ずしも最低の請求額ではありません。コストに敏感な業務では、価格優先戦略を積極的に選ぶか価格上限を設定し、呼び出しログを使って継続的に確認すべきです。
役割別にどう使い分けるか
- 個人開発者と小規模チーム: デフォルトの自動ルーティングだけでも、自前で障害復旧体制を構築する手間を省けます。重要なのは、実際のサンプルを使ってツール呼び出しとJSON出力が安定しているかを検証することです。まずAPIYI(apiyi.com)のような統一インターフェースでモデルを決め、その後、必要に応じてプロバイダー層で最適化するのが、低コストな進め方です。
- 対話型プロダクト: スループットではなく、TTFT P95に注目してください。
:fastestは短い応答の体感を必ずしも改善しません。 - 長い出力やバッチ処理のタスク: スループットと実効価格のほうが重要です。価格優先戦略を検討し、セッションを同じプロバイダーに固定するスティッキーセッションを活用して、キャッシュの効果を維持することもできます。
- 企業やプラットフォームのチーム: まず、どのアプリケーションが独自のProvider Keyに依存しているか、どの業務がプロバイダーを固定しなければならないかを棚卸しします。そのうえで、フォールバックを許可するのか、プロバイダーを限定するのか、それともプロバイダーへ直接接続するのかを決めます。データ処理契約はプロバイダーごとに個別に確認する必要があります。
どの戦略を選ぶとしても、最終的には同じ行動に行き着きます。自分のリクエストと自分の指標を使って、一度実行してみることです。APIYI(apiyi.com)で無料枠を使った小規模な比較を行う、あるいはHugging FaceのカタログAPIで候補プロバイダーを先に絞り込む。どちらもコストの低い出発点です。公式実験の16.9%は全体の平均値であり、自社の業務でどれだけの効果が得られるかは、実際に測定してみるまで分かりません。
The proof of the pudding is in the eating.(プディングの良し悪しは食べてみて初めて分かる、つまり実際の効果は実践で検証するしかないという意味です。)


