著者注:ターミナルとコードリポジトリ、オフィス系の長時間タスク、マルチモーダル長文ドキュメント、コストという4つのタスク類型について、Qwen4-Max と Claude Opus 5.5 のベンチマーク結果、仕様、キャッシュ価格、移行コストを比較し、実行可能な選定アドバイスを示します。
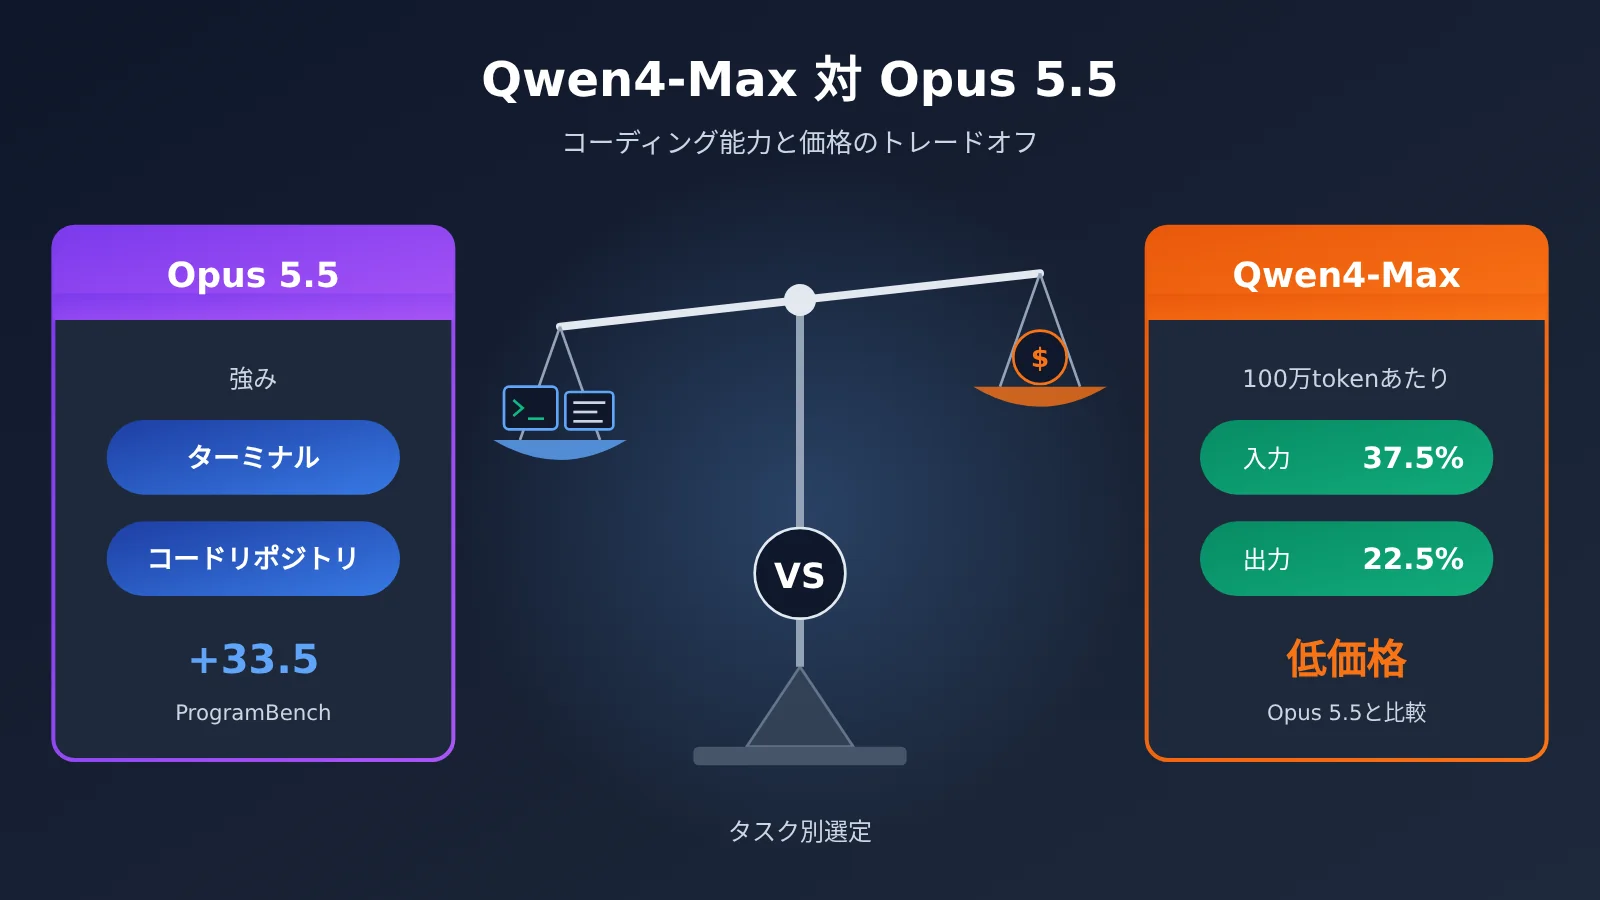
もしあなたのチームがすでに Claude Opus 5.5 を主力として、Claude Code や自社構築の agent で本番運用しているなら、2026-11-16 にリリースされた Qwen4-Max は、もう一度コストを計算し直すきっかけになるでしょう。その入力価格は Opus 5.5 の 37.5% にとどまり、出力価格も 22.5% にすぎません。
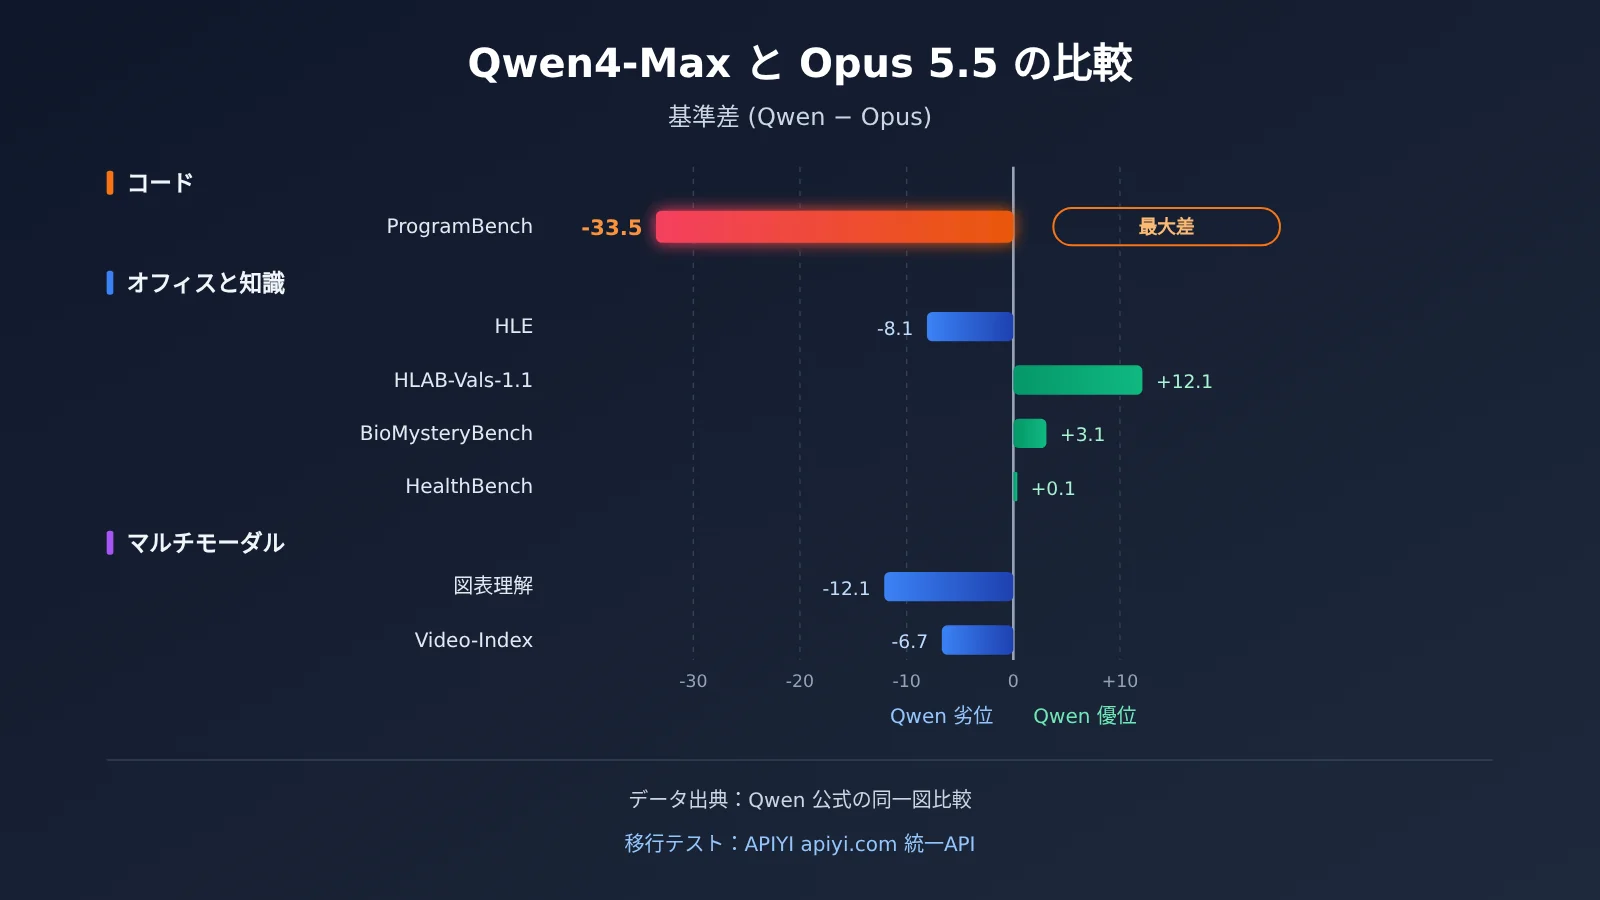
まず結論から。妥協案は示しません:ターミナル操作とリポジトリ全体のリファクタリングは引き続き Opus 5.5 に任せるべきです。Qwen4-Max は ProgramBench で 33.5 ポイントの遅れをとっており、これが今回の比較における最大の弱点です。ワークフロー自動化、コストに敏感な高コンカレンシー agent、超長文出力を伴うドキュメントタスクでは、Qwen4-Max を優先的に試す価値があります。一方、オフィス向け成果物、図表、動画理解系のタスクでは、Opus 5.5 に依然として明確な優位性があります。
コアバリュー:本記事を読み終えると、タスク別のトレードオフ表が手に入り、両者のキャッシュ価格、デフォルト推論レベル、実際の移行手順の違いが明確になります。
Qwen4-Max と Opus 5.5 の核心的な違い早見表
まずはデータの前提をはっきりさせておきます。本記事の数値は3つの異なる出典に由来しており、混同して読むことはできません。
- Qwen公式が自己申告した同一画像での比較:Alibaba は発表ブログで同じ1枚の画像を使い、Qwen4-Max と Opus 5.5 のスコアを並べています。これはベンダー自身が実施したもので、第三者による再現ではありません。
- 公開ランキングのスナップショット(2026-11-14):arena.ai の Code Arena WebDev ランキングで、公開投票に基づくものです。
- Anthropic公式ドキュメントの原文:Opus 5.5 の仕様と価格は、Anthropic の公式モデルページおよび価格ページから引用しています。
次の表は記事全体の結論を凝縮したものです。以降の章で根拠を項目ごとに展開します。
| タスク種別 | 推奨 | 主な根拠 | ひと言の理由 |
|---|---|---|---|
| 端末操作とリポジトリ全体のリファクタリング | Opus 5.5 | Terminal-Bench で 11.1 低い、ProgramBench で 33.5 低い | 多段コマンドチェーンとリポジトリ全体にわたる変更は、Qwen4-Max の最も弱い部分 |
| 単一 issue 修正系のコーディング | Qwen4-Max を試せる | DeepSWE で 1.5 高い | 局所的な修正能力はすでに同等で、価格優位は明らか |
| オフィス成果物と長時間タスク | Opus 5.5 | AA-Briefcase で 115 Elo 低い、JobBench で 6.9 低い | ドキュメントやレポート類の成果物品質の差は体感できる |
| ワークフロー自動化 | Qwen4-Max | AutomationBench で 3.0 高い | ルールが明確なフロー作業では劣らず、コストも低い |
| グラフ・動画の理解 | Opus 5.5 | Chartography で 12.1 低い、Video-Index で 6.7 低い | マルチモーダルの画像読解にはまだ差がある |
| コスト重視の高並行 agent | Qwen4-Max | 入力 37.5%、出力 22.5% | 量が多いと請求額の差は倍々で拡大する |
Qwen4-Max と Opus 5.5 のスペック差
スペック面では、両者ともコンテキストは 1M ですが、出力と推論のデフォルト値は大きく異なります。
- Qwen4-Max:2.4T の本体、71B のアクティブ、加えて 328B の N-gram Embedding。ネイティブ視覚。最大出力 393K、最大思考チェーン 262K。デフォルトの
reasoning_effortは high。 - Opus 5.5(Anthropic公式ドキュメントの原文):長時間走行する agentic コーディングとナレッジワーク向け。最大出力 128K。デフォルトの effort は medium。知識カットオフは 2026年6月。
デフォルトの設定という点は見落とされやすいものです。Qwen4-Max はデフォルトで high に設定されており、思考プロセスも出力として課金されるため、実際の請求額の差は通常、表示価格上の 22.5% より小さくなります。後述の価格パートでは、公開ランキング上のある傍証を示します。
Qwen4-Max と Opus 5.5 の比較:ターミナルとコードリポジトリのタスク
これは既存の Opus ユーザーが最も気にする部分であり、Qwen4-Max が最も慎重に扱うべき部分でもあります。
| ベンチマーク(Qwen 公式が自己申告した同一画像対照) | Qwen4-Max | Opus 5.5 | 差 |
|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 74.2 | Qwen が 1.5 高い |
| CodeArena WebDev Elo | 1750 | 1816 | Qwen が 66 低い |
| Terminal-Bench 4.0 | 48.5 | 59.6 | Qwen が 11.1 低い |
| ProgramBench | 31.5 | 65.0 | Qwen が 33.5 低い |
それぞれが実際の業務にとって何を意味するかを見てみましょう:
- DeepSWE が 1.5 高い:指定された issue に対するピンポイント修正のようなタスクでは、Qwen4-Max はすでに Opus 5.5 と同じレベルにあり、1.5 点はほぼ同等と見なせます。リスクの低いバグ修正キューを回すのに向いています。
- WebDev が 66 Elo 低い:フロントエンドページ生成の全体的な見栄えについて、ユーザー投票は Opus に偏っており、ランディングページやコンポーネントのプロトタイプを作る際にその差は肉眼で分かります。
- Terminal-Bench が 11.1 低い:ターミナルでコマンドを連続実行し、出力を読み、次のステップを判断する能力が明らかに劣っています。これはまさに Claude Code 系ワークフローの日常であり、乗り換えると途中で詰まったり、人手での引き継ぎが必要になる場面が増えることを意味します。
- ProgramBench が 33.5 低い:これは今回の比較で最大の弱点であり、スコアはほぼ半減しています。ゼロからの構築や大規模な書き換えを伴うプログラムのタスクでは、Qwen4-Max は現時点で Opus 5.5 の代替には適していません。
公開ランキングも同様の位置情報を示しています。公開ランキングのスナップショット、2026-11-14 によると、arena.ai Code Arena WebDev は合計 1,007,405 票、159 モデルです:Opus 5.5(Max)は 1816 点で 2 位、Qwen4-Max(xHigh)は 1750 点で 6 位ですが、後者はわずか 1,814 票で、まだ Preliminary とマークされており、順位は今後変動する可能性があります。
コードリポジトリ場面での Qwen4-Max 利用提案
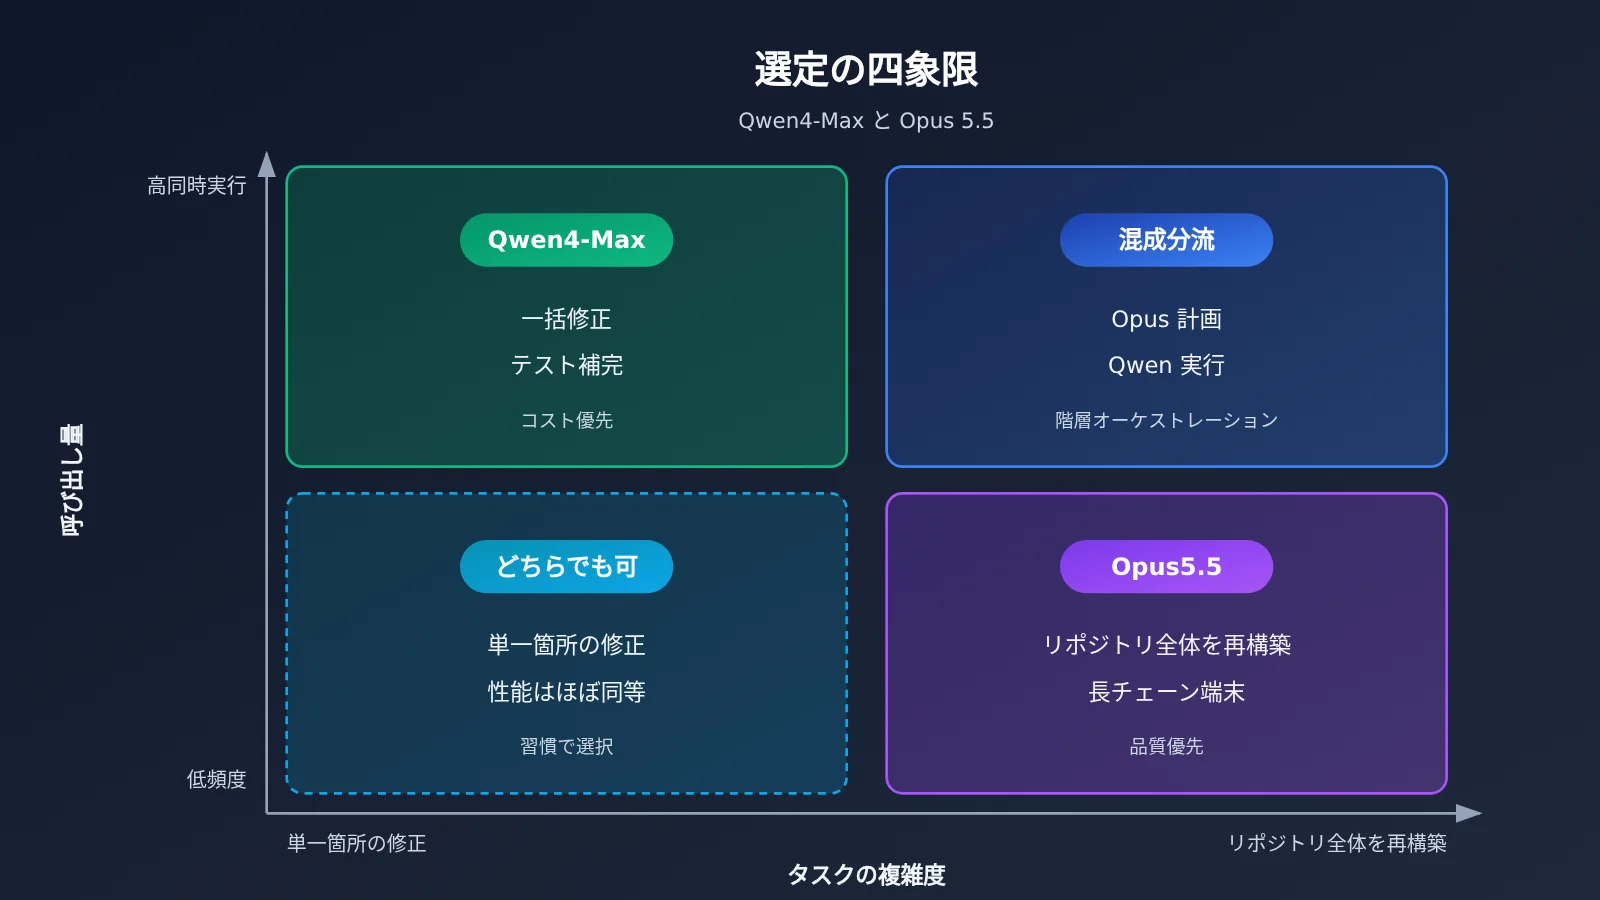
如果你的 agent が主にリポジトリ全体のリファクタリング、モジュール間の移行、長いチェーンのターミナル操作を行うなら、Opus 5.5 をそのまま維持することをおすすめします。タスクを「計画 + 実行」の 2 層に分割している場合は、Opus 5.5 に計画と重要な変更を担当させ、単一ファイルの修正やテスト補完といった局所的なタスクを Qwen4-Max に振り分けることを検討できます。
Qwen4-Max 対 Opus 5.5:オフィス業務と長時間タスク
オフィス業務や長時間エージェントタスクの結果は、コーディングよりもさらに分かれており、勝ちもあれば負けもあります。
| ベンチマーク(Qwen 公式が自己申告した同一図表ベースの比較) | Qwen4-Max | Opus 5.5 | 差分 |
|---|---|---|---|
| AA-Briefcase v1.1 Elo | 1686 | 1801 | Qwen が115低い |
| JobBench | 68.5 | 75.4 | Qwen が6.9低い |
| APEX-Agents v1.1 | 72.1 | 73.5 | Qwen が1.4低い |
| AutomationBench-AA | 72.5 | 69.5 | Qwen が3.0高い |
| AgentArena Net Improvement | 7.5 | 18.2 | Qwen が10.7低い |
実際の業務に当てはめると:
- AA-Briefcase が115 Elo低い:レポート、提案書、表といった業務成果物では、Opus 5.5 の完成品のほうがそのまま採用されやすく、オフィス業務シーンで最も差が大きい項目です。
- JobBench が6.9低い:実際の職務タスクに近い総合的な完了度では依然として Opus がリードしており、エンドツーエンドで納品する際の手戻り率が高くなる可能性があります。
- APEX-Agents が1.4低い:汎用エージェントタスクではほぼ互角で、モデルを切り替えても明確な体験の差は出にくいでしょう。
- AutomationBench が3.0高い:ルールが明確な業務プロセス自動化はむしろ Qwen4-Max の得意分野で、フォーム処理、データ転送、定期タスクのオーケストレーションは優先的に移行するのに適しています。
- AgentArena Net Improvement が10.7低い:複数ラウンドの反復で継続的に改善する能力は弱く、長時間タスクが進むほどモデルの自己修正に依存する場面では、Opus のほうが安定します。
また、Qwen4-Max の最大出力393Kと思考連鎖の上限262Kは、超長文を一度に生成する必要がある長時間タスクでは確かな強みです。Opus 5.5 の最大出力は128Kです。
Qwen4-Max と Opus 5.5 の比較:中国語とマルチモーダル長文ドキュメント
まず前提としてお伝えします。参考資料の比較図には中国語に特化したベンチマークがないため、本記事では「中国語ではどちらが優れているか」を数値で答えることはできません。中国語の品質が最重要指標であれば、ご自身のサンプルセットで A/B テストを行い、二次的な結論に頼らないようにしてください。
数値で語れるのはマルチモーダルと知識系のタスクです:
| ベンチマーク(Qwen 公式の自己申告による同一図表比較) | Qwen4-Max | Opus 5.5 | 差分 |
|---|---|---|---|
| Chartography | 54.2 | 66.3 | Qwen が 12.1 低い |
| Video-Index | 68.1 | 74.8 | Qwen が 6.7 低い |
| Humanity’s Last Exam | 51.7 | 59.8 | Qwen が 8.1 低い |
| HLAB-Vals-1.1 | 21.3 | 9.2 | Qwen が 12.1 高い |
| BioMysteryBench | 85.0 | 81.9 | Qwen が 3.1 高い |
| HealthBench Professional | 60.0 | 59.9 | ほぼ互角 |
これらの数値が実際に意味するのは、次のとおりです。グラフの読み取りや、決算資料・リサーチレポート内の図形データの抽出では、Qwen4-Max は 12.1 ポイント劣り、座標の読み漏れや誤読が起きやすいということです。動画理解にも 6.7 ポイントの差があります。高難度の総合知識問題(HLE)では 8.1 ポイント劣ります。一方で、生物学的推論や医療専門の質疑応答では Qwen4-Max は互角かやや優位で、HLAB-Vals では 12.1 ポイントリードしています。
したがって長文ドキュメントのタスクはさらに細分化する必要があります。テキスト中心で超長文の出力が求められるドキュメントでは、Qwen4-Max を第一候補にできます。図表が密集した PDF、あるいは動画素材を含む資料では、引き続き Opus 5.5 を利用することをおすすめします。
Qwen4-Max と Opus 5.5 の100万トークンあたり価格とキャッシュの計算
価格は Qwen4-Max の最も強力な論拠です。以下の表の単位はすべて 1M トークンあたりで、公式価格はそれぞれ QwenCloud と Anthropic のドキュメント原文から、APIYI の現価格は docs.apiyi.com/models から取得しています(取得日: 2026-11-16)。
| 課金項目($/1M tokens) | Qwen4-Max 公式 | Opus 5.5 公式 | Qwen/Opus | APIYI qwen3.8-max |
APIYI claude-opus-5-5 |
|---|---|---|---|---|---|
| 入力 | 1.5 | 4 | 37.5% | 1.65 | 4 |
| 出力 | 4.5 | 20 | 22.5% | 4.95 | 20 |
| キャッシュ読み取り | 0.075 | 0.20 | 37.5% | 0.20625 | 0.2 |
| 5分間キャッシュ書き込み | 1.875 | 5 | 37.5% | プラットフォームの一覧を参照 | プラットフォームの一覧を参照 |
| 1時間キャッシュ書き込み | 3 | 8 | 37.5% | プラットフォームの一覧を参照 | プラットフォームの一覧を参照 |
両社のキャッシュ構造は実は完全に同型です。キャッシュ読み取りはいずれも入力価格の 5%、5分間キャッシュ書き込みはいずれも入力価格の 1.25 倍、1時間キャッシュ書き込みはいずれも 2 倍です。つまり、Opus で設計したキャッシュ戦略はそのまま Qwen4-Max に移せ、請求額は 37.5% に等比縮小されます。注意すべき点として、APIYI 上の qwen3.8-max のキャッシュ読み取りは入力価格の 12.5% で、Qwen4-Max 公式の比率とは異なります。移行時は実際のモデルごとに個別に計算してください。
具体的な試算
1億入力 + 1000万出力を例にすると、Qwen4-Max は約 $195(150 + 45)、Opus 5.5 は約 $600(400 + 200)となります。差額は約 $405 で、Opus の請求額の約3分の2に相当します。
しかし、表示価格は実払額と同じではありません。公開ランキングのスナップショット、2026-11-14 では1タスクあたりのコスト P50 が示されており、Opus 5.5(Max)$8.99、Qwen4-Max(xHigh)$4.18 で、比率は約 46% であり、表示価格の 22.5% ではありません。理由は両者の推論レベルが異なることにあり、Qwen4-Max はデフォルトが high で、思考の連鎖は出力として課金されるため、トークン消費がより多くなります。実際にいくら節約できるかはタスクの長さと推論レベルによって変わるため、ご自身のトラフィックでリプレイして一度測定することをおすすめします。
💰 コストのヒント:請求額を比較する際は、単価だけでなく、入力・出力・キャッシュ読み取り・キャッシュ書き込みの4項目のトークン量を同時に記録してください。APIYI apiyi.com を使って同一アカウントで2つのモデルを並行して呼び出せば、使用量の明細を1か所で揃えて確認できます。
Qwen4-Max と Opus 5.5 の比較:意思決定のポイントと移行3ステップ
エージェントをOpusからQwenへ切り替えるには、モデル確認・価格比較・プロトコル確認の3ステップを避けて通れません。
ステップ1:モデルを確認する。 2026年11月16日時点では、Qwen4-Max は APIYI のラインナップにまだ追加されていません。できるだけ早く追加する予定です。現在Qwen側で最も強力なのは qwen3.8-max です。Opus側では claude-opus-5-5 が利用でき、ほかに claude-opus-5-5-thinking もありますが、価格は同じです。モデルと価格は apiyi.com ドキュメントセンターのモデル一覧を正とし、追加前は qwen3.8-max で段階展開用のパイプラインを先に用意しておくとよいでしょう。
ステップ2:価格を比較する。 前節の方法に沿って、1週間分の実トラフィックで両側のコストを見積もり、推論レベルを揃えたうえで比較します。APIYI apiyi.com のモデル一覧は、入力・出力・キャッシュ読み取りをすべて同じ一覧表に記載しているため、そのまま試算表のデータソースとして使えます。
ステップ3:プロトコルを確認する。 APIYI はOpenAI互換インターフェースを提供しており、エンドポイントは https://api.apiyi.com/v1 です。モデルを切り替えるときは model フィールドを変更するだけで、たとえば claude-opus-5-5 から qwen3.8-max に変更しても、api_key と base_url はそのまま維持できます。追加で2点を確認する必要があります。推論強度のパラメータはQwen側では reasoning_effort と呼ばれ、デフォルトは high です。Opus の medium に揃えたい場合は明示的に設定してください。また、キャッシュの書き込み期間とヒットルールも、対象モデルごとに再検証が必要です。
🎯 段階展開の提案:エージェント全体を一度に切り替えないでください。同じ
base_url(https://api.apiyi.com/v1)配下のトラフィックをタスク種別で振り分け、まず自動化タスクと部分的な修正タスクを移行することをおすすめします。ターミナル操作とリポジトリ全体に関わるタスクは Opus 5.5 に残し、2週間の手戻り率を観察してから次のステップを決めましょう。
よくある質問 FAQ
Q1:Qwen4-Max と Opus 5.5、コーディングエージェントにはどちらが適していますか?
タスクの粒度によります。単一 issue の修正(DeepSWE)では両者互角で、コストを抑えたいなら Qwen4-Max がおすすめです。一方、ターミナルでの多段階操作やリポジトリ全体のビルド(Terminal-Bench、ProgramBench)では Opus 5.5 が明確にリードしており、特に ProgramBench では 33.5 ポイントの差があります。こうしたタスクでは引き続き Opus を使うのが賢明です。
Q2:Alibaba のグラフ上のスコアと arena ランキングは同じ土俵で比較できますか?
同じ基準として扱うことはできません。前者は Qwen 公式が自己申告した同一画像での比較結果であり、後者は公開ランキングのスナップショット(2026-11-14)です。しかも Qwen4-Max はランキング上でわずか 1,814 票、ステータスはまだ Preliminary のままです。両者は傾向として相互参照はできますが、「何ポイント先行しているか」という単一の結論にまとめるべきではありません。
Q3:Qwen4-Max に切り替えると実際にいくら節約できますか?
定価ベースでは入力が 62.5%、出力が 77.5% の節約になります。ただし公開ランキング上のタスク単価コストは P50 比で約 46% にとどまります。これは Qwen4-Max がデフォルトでより高い推論レベルを使い、思考トークンが増えるためです。実際の節約額は、皆さんのトラフィックを使ってリプレイ測定する必要があります。
Q4:今すぐ APIYI で Qwen4-Max を呼び出せますか?
現時点ではできません。Qwen4-Max はまだラインナップに追加されておらず、できるだけ早く追加する予定です。現在は `qwen3.8-max` を使って移行経路を構築でき、追加後は `model` フィールドを変更するだけで済みます。モデルの提供状況は APIYI apiyi.com のモデル一覧をご確認ください。
Q5:Opus から Qwen に切り替えるのに、どれくらいコードを変更する必要がありますか?
すでに OpenAI 互換インターフェースを使っている場合は、`base_url` を `https://api.apiyi.com/v1` に向けたうえでモデル名を変更し、必要に応じて `reasoning_effort` を設定するだけです。APIYI apiyi.com に登録すると、新規ユーザー向けの無料テスト枠でまず一度比較を試せます。
Q6:Qwen4-Max にはどのような既知の制限がありますか?
最も大きな弱点はターミナル操作とリポジトリ全体のコーディングです。加えてグラフ理解は 12.1 ポイント下回り、オフィス系成果物の Elo は 115 低く、多ターンでの自己改善能力もやや弱めです。さらに、比較スコアはすべてベンダーの自己申告であり、サードパーティによる再現はまだ行われていません。中国語能力についても専用のベンチマークデータが不足しています。
Qwen4-Max と Opus 5.5 の比較:主要ポイント
- 最大の弱点:ProgramBench が 33.5 ポイント低く、リポジトリ全体のビルドとリファクタリングは今後も Opus 5.5 を使い続けるべきです。
- 互角の領域:DeepSWE、APEX-Agents、HealthBench はほぼ互角で、優先的に振り分けることができます。
- Qwen の強み:ワークフロー自動化、バイオメディカル推論、393K の超長出力。
- 価格構造:入力 37.5%、出力 22.5% で、キャッシュ 4 項目の比率も Opus と完全に同じ構成です。
- 実費の差:デフォルトの推論ティアは high で、公開ベンチマークタスクのコスト比は約 46% です。
- 移行パス:APIYI apiyi.com で同じエンドポイントを使い、まず
qwen3.8-maxを実行し、Qwen4-Max がリリースされたらそのまま置き換えます。
まとめ
Qwen4-Max と Opus 5.5 の選択は、次の 3 点に集約できます。
- ターミナルとコードリポジトリは Opus 5.5 に任せる:Terminal-Bench と ProgramBench の差は、価格差では手戻りコストをカバーできません。
- 自動化と高並列処理は Qwen4-Max に任せる:能力が互角またはリードしているタスクでは、請求額の 3〜5 割がそのまま純粋な利益になります。
- タスクごとに振り分け、全体を置き換えない:同じインターフェースを使い、タスク種別ごとにルーティングするのがリスク最低の移行方法です。
まず APIYI apiyi.com で qwen3.8-max と claude-opus-5-5 を使って自分のタスクのリプレイを一巡し、Qwen4-Max がリリースされた後に最終的な切り替え判断を行うことをお勧めします。
📚 参考資料
- Qwen4-Max リリースブログ:モデル仕様と公式自己申告ベンチマークの対照
- リンク:
qwen.ai/blog?id=qwen4-max -
説明:アーキテクチャパラメータ、コンテキストと出力上限、および同一グラフ上での比較スコアを含む
-
Anthropic モデル概要:Opus 5.5 の仕様説明
- リンク:
platform.claude.com/docs/en/about-claude/models/overview.md -
説明:コンテキスト、最大出力、デフォルトの effort、知識カットオフ
-
Anthropic 料金ページ:Opus 5.5 の入出力価格とキャッシュ価格
- リンク:
platform.claude.com/docs/en/about-claude/pricing.md -
説明:5 分キャッシュと 1 時間キャッシュの書き込み価格を含む
-
APIYI モデル一覧:プラットフォームの現在価格と利用可能なモデル
- リンク:
docs.apiyi.com/models - 説明:移行前にモデルの提供状況と価格を確認
著者:APIYI 技術チーム
技術交流:APIYI apiyi.com のウェブサイトトップページからお問い合わせください。導入に関する資料は docs.apiyi.com のドキュメントセンターでご覧いただけます