gemini-4-argon dirilis pada 13 Oktober 2026. Tak lama setelah mengintegrasikannya, banyak developer langsung menemui error 429: begitu jumlah permintaan bersamaan meningkat, error pun muncul. Terkadang, satu permintaan saja bisa gagal. Banyak orang langsung berpikir, “Batas permintaan bersamaan di AI Studio terlalu rendah.” Namun, kemungkinan besar anggapan ini keliru. Artikel ini menguraikan mekanisme pembatasan laju gemini-4-argon yang sebenarnya di AI Studio dan memberikan solusi 429 yang bisa langsung diterapkan.
Ini bukan sekadar tutorial umum yang menyarankan “tambahkan retry saja”. Pertama-tama, mari luruskan satu fakta penting: Google belum merilis batas jumlah permintaan bersamaan yang tetap dan berlaku umum untuk gemini-4-argon. Jadi, angka “10 permintaan bersamaan” atau “50 permintaan bersamaan” yang beredar di internet tidak memiliki dasar yang jelas.
Manfaat utama: Setelah membaca artikel ini, Anda akan memahami perbedaan empat penyebab 429—RPM, TPM, laju konsumsi, dan kapasitas upstream—serta mempelajari penerapan exponential backoff dan pembatasan laju. Anda juga akan mengetahui cara mengatasi kendala kuota per project di AI Studio melalui kanal permintaan bersamaan tinggi APIYI apiyi.com.
Poin-poin utama gemini-4-argon
Berikut ringkasan kesimpulan artikel dalam bentuk tabel. Setiap poin akan dibahas lebih lanjut di bagian berikutnya.
| Poin utama | Penjelasan | Manfaat |
|---|---|---|
| Tidak ada batas permintaan bersamaan tetap yang dipublikasikan | Google belum merilis batas permintaan bersamaan universal untuk gemini-4-argon. Pembatasan laju didasarkan pada metrik seperti RPM, TPM, dan RPD | Menghindari perencanaan kapasitas berdasarkan angka yang keliru |
| RPM tidak sama dengan jumlah permintaan bersamaan | Jumlah permintaan yang sedang diproses bergantung pada waktu rata-rata permintaan, bukan hanya jumlah permintaan per menit | Membantu memperkirakan kebutuhan permintaan bersamaan dengan tepat |
| Batas dihitung per project | Membuat beberapa kunci API dalam project yang sama tidak akan melipatgandakan kuota | Tidak perlu lagi membuang waktu untuk merotasi kunci API |
| Batas konsumsi 10 menit | Tier 1 sebesar $10, Tier 2 sebesar $50, dan Tier 3 sebesar $200 | Menjelaskan mengapa error 429 bisa terjadi meski RPM belum terlampaui |
| Penanganan 429 perlu dilakukan bertahap | Periksa respons mentah terlebih dahulu, lalu terapkan pembatasan laju dan backoff, ganti kanal, atau tingkatkan kuota | Menyelesaikan masalah secara bertahap sesuai prioritas |
| Kanal permintaan bersamaan tinggi APIYI | APIYI apiyi.com mendukung permintaan bersamaan tinggi untuk gemini-4-argon. Untuk RPM di bawah 500, Anda tidak perlu khawatir soal pembatasan laju | Solusi praktis untuk bisnis skala kecil hingga menengah |
Mengapa 429 tidak selalu berarti jumlah permintaan bersamaan terlampaui
Banyak developer menganggap 429 sama dengan “jumlah permintaan bersamaan terlalu tinggi”. Namun, dalam sistem pembatasan laju Google, jumlah permintaan bersamaan bukanlah metrik tersendiri. 429 RESOURCE_EXHAUSTED bisa dipicu oleh jumlah permintaan per menit, jumlah Token input per menit, jumlah permintaan per hari, nilai konsumsi bergulir selama 10 menit, atau bahkan kapasitas upstream yang belum mencukupi pada masa awal peluncuran model.
gemini-4-argon baru dirilis kurang dari seminggu, sehingga sumber daya upstream mungkin masih dalam tahap peningkatan kapasitas. Artinya, Anda tetap bisa ditolak sementara meski kuota Anda mencukupi. Karena itu, langkah pertama untuk menyelidiki error 429 adalah memastikan jenis batas mana yang terpicu—bukan langsung mengurangi jumlah permintaan bersamaan secara membabi buta.
Berapa batas konkurensi gemini-4-argon di AI Studio?
Jawaban singkat: tidak ada nilai tetap yang berlaku untuk semua pengguna. Di AI Studio, setiap project memiliki kuota RPM, TPM, dan RPD yang berlaku untuk gemini-4-argon. Angka pastinya bergantung pada tingkat Tier dan status project. Anda perlu memeriksanya di konsol.
Lima jenis batas di AI Studio
Mekanisme pembatasan resmi Google dapat dirangkum dalam tabel berikut. Jika salah satu batas tercapai, permintaan bisa mengembalikan error 429.
| Metrik batas | Arti | Bisa menyebabkan 429? |
|---|---|---|
| RPM | Jumlah permintaan per menit | Ya |
| TPM | Jumlah token input per menit | Ya |
| RPD | Jumlah permintaan per hari | Ya |
| Laju konsumsi | Jumlah biaya konsumsi API dalam jendela bergulir 10 menit | Ya |
| Kapasitas layanan aktual | Sumber daya yang tersedia di sisi Google | Bisa |
Perhatikan baris terakhir: kekurangan kapasitas termasuk kondisi yang “tidak bisa diatasi dengan mengubah parameter”. Solusinya hanya mengurangi laju trafik, menunda percobaan ulang, atau beralih ke kanal lain.
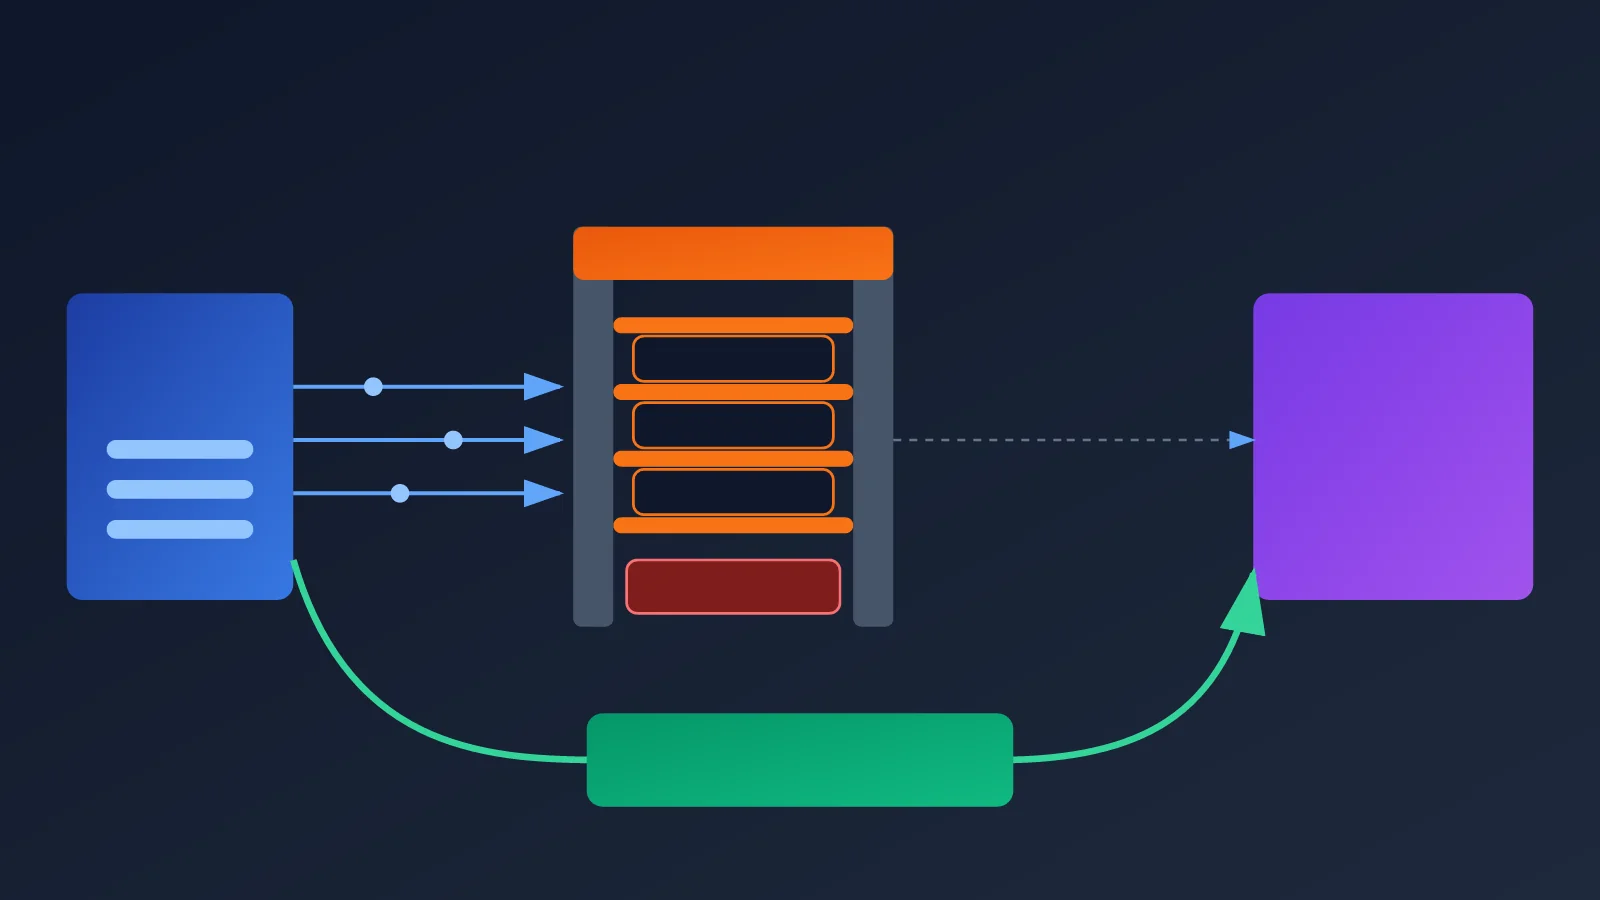
Hubungan antara RPM dan konkurensi
RPM adalah “jumlah total permintaan dalam satu menit”, sedangkan konkurensi adalah “jumlah permintaan yang sedang berlangsung pada waktu yang sama”. Keduanya berkaitan melalui durasi permintaan. Misalnya, sebuah project memiliki batas 60 RPM (sekadar contoh perhitungan, bukan kuota aktual Argon):
- Jika rata-rata durasi permintaan 5 detik, secara teori rata-rata ada sekitar 5 permintaan yang sedang berlangsung.
- Jika rata-rata durasi permintaan 30 detik, secara teori rata-rata ada sekitar 30 permintaan yang sedang berlangsung.
- Mengirim 60 permintaan sekaligus bisa memicu pembatasan sementara atau batas kapasitas, meskipun jumlah totalnya dalam satu menit belum melampaui batas.
Kondisi ketiga ini paling sering luput dari perhatian. Banyak skrip uji beban mengirim permintaan secara serentak dalam satu batch. Lonjakan trafik seperti ini lebih mudah memicu pembatasan dibandingkan aliran trafik yang stabil, sekalipun jumlah totalnya sepenuhnya sesuai batas.
Cara melihat kuota aktual gemini-4-argon di konsol
Buka halaman Rate Limits Google AI Studio di aistudio.google.com/usage, lalu pilih tab rate-limit. Anda juga bisa membuka halaman tersebut melalui dokumentasi batas laju resmi di ai.google.dev/gemini-api/docs/rate-limits. Pilih project dan gemini-4-argon yang sesuai untuk melihat RPM, TPM, RPD, serta tingkat Tier saat ini.
Google menjelaskan bahwa batas dihitung berdasarkan project, bukan berdasarkan kunci API. Artinya, membuat kunci sebanyak apa pun dalam project yang sama tidak akan melipatgandakan kuota. Jadi, cara memperbesar kapasitas dengan “merotasi banyak kunci” tidak akan berhasil di AI Studio.
5 penyebab umum 429 pada gemini-4-argon
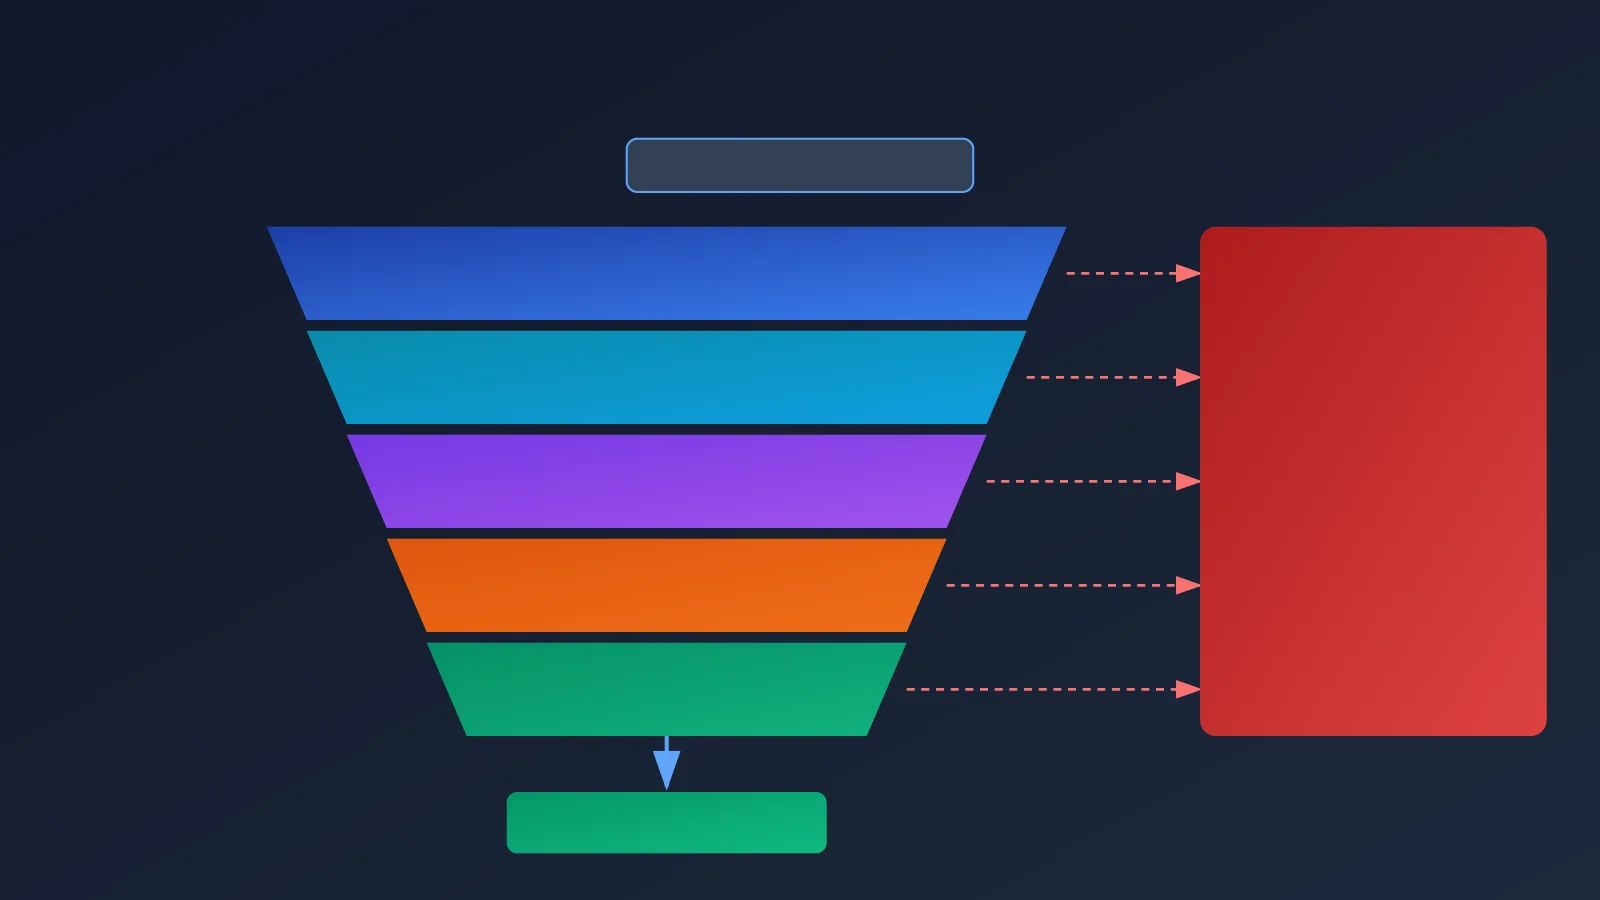
Setelah memahami metrik batas, mari kita lihat situasi yang sering terjadi di lapangan. Lima penyebab berikut mencakup sebagian besar laporan 429 pada gemini-4-argon.
- Laju permintaan sesaat terlalu tinggi: Tugas batch atau skrip uji beban mengirim banyak permintaan sekaligus, sehingga terjadi lonjakan yang melebihi kapasitas RPM sesaat.
- TPM mencapai batas: Konteks yang panjang dan dokumen berukuran besar menghabiskan Token dengan cepat. Jumlah permintaan mungkin tidak banyak, tetapi batas TPM sudah lebih dulu tercapai.
- Batas konsumsi 10 menit tercapai: Ini yang paling sering terlewat. Penjelasan khususnya ada di bawah.
- Kuota RPD harian habis: Jika 429 baru muncul setelah berjalan beberapa waktu, biasanya itu tanda kuota harian sudah habis.
- Kapasitas upstream tidak mencukupi: Saat model baru diluncurkan, sumber daya bisa terbatas. Permintaan mungkin tetap ditolak meskipun kuota masih tersedia.
Penyebab yang sering terlewat: batas konsumsi 10 menit
Menurut dokumentasi resmi Google yang diperbarui pada 15 Oktober 2026, setiap tingkat akun memiliki batas konsumsi dalam jendela bergulir 10 menit.
| Tingkat akun | Batas konsumsi per 10 menit |
|---|---|
| Tier 1 | $10 |
| Tier 2 | $50 |
| Tier 3 | $200 |
Contohnya, jika akun Tier 1 menghabiskan total $10 dalam 10 menit, akun tersebut mungkin menerima respons 429 RESOURCE_EXHAUSTED meskipun RPM dan TPM belum terlampaui. Sebagai model generasi baru, biaya per pemanggilan gemini-4-argon mungkin lebih tinggi daripada model lama. Permintaan dengan konteks panjang juga lebih mudah membuat konsumsi melonjak. Inilah salah satu penyebab umum “permintaan tidak banyak, tetapi tetap terkena pembatasan laju”.
Perlu diingat juga bahwa kuota Argon Batch API yang tercantum di dokumentasi Google adalah kuota Token untuk antrean pemrosesan batch. Kuota ini tidak bisa digunakan sebagai kuota konkurensi API real-time.
Bagaimana mengetahui penyebab 429 pada gemini-4-argon?
Gejala yang berbeda biasanya menunjukkan akar masalah yang berbeda. Pemeriksaan yang terarah jauh lebih efektif daripada mengubah parameter secara membabi buta.
| Gejala | Hal yang perlu diperiksa terlebih dahulu | Cara mengatasinya |
|---|---|---|
| 429 sering muncul begitu konkurensi meningkat | Laju permintaan sesaat, RPM, kapasitas upstream | Lakukan uji beban bertahap dengan laju permintaan yang merata. Konkurensi tetap tidak berarti RPM juga tetap |
| 429 mulai muncul setelah berjalan beberapa waktu | Batas konsumsi 10 menit, RPD, akumulasi TPM | Periksa kurva konsumsi dan penggunaan kuota harian |
| 429 muncul pada satu permintaan atau konkurensi yang sangat rendah | Kapasitas upstream tidak mencukupi, akun atau proyek dibatasi | Periksa respons asli dan pertimbangkan untuk beralih ke jalur lain |
| Beberapa kunci API mengalami 429 secara bersamaan | Beberapa kunci API berada dalam proyek yang sama dan berbagi kuota | Kurangi total trafik proyek atau gunakan jalur dengan kuota terpisah |
Dua informasi paling penting saat melakukan pemeriksaan adalah tingkat akun AI Studio Anda—Tier 1, 2, atau 3—dan detail kesalahan 429 yang asli, terutama error.message, error.details, serta Retry-After pada header respons. Kedua informasi ini biasanya cukup untuk membedakan apakah penyebabnya adalah kuota akun yang terlalu rendah, trafik permintaan yang terlalu tinggi, atau pasokan model baru Google Argon yang belum mencukupi. Ketiganya membutuhkan solusi yang sangat berbeda.
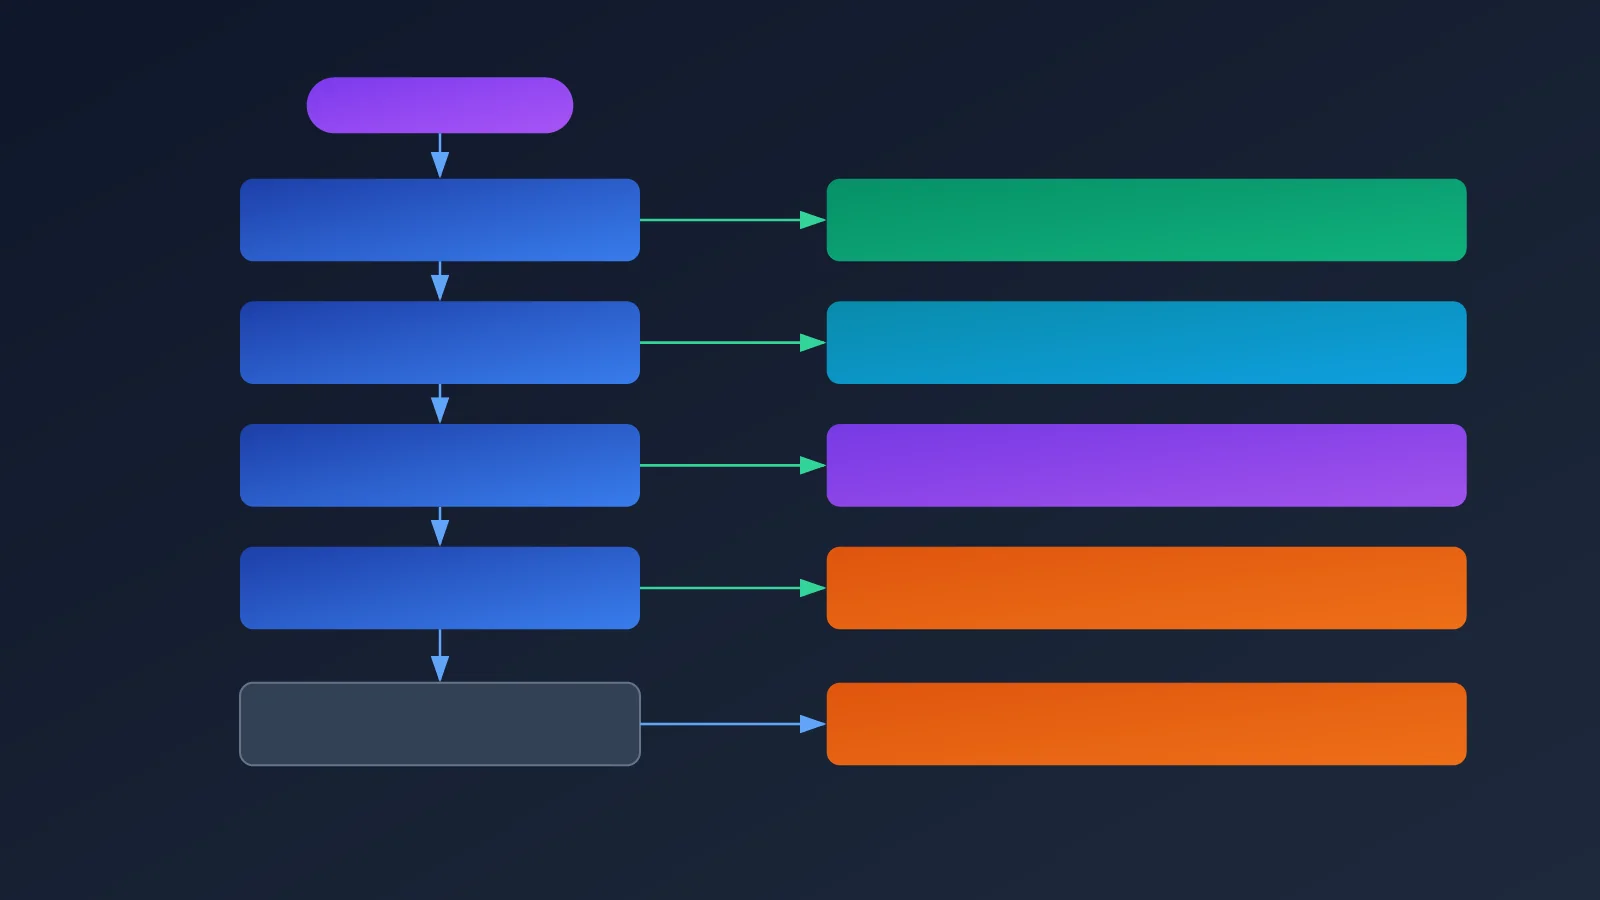
6 Langkah Mengatasi Error 429 pada gemini-4-argon
Berikut langkah-langkah penanganan berdasarkan prioritas. P0 wajib dilakukan terlebih dahulu, sedangkan P2 merupakan perencanaan jangka panjang.
| Prioritas | Langkah penanganan | Manfaat |
|---|---|---|
| P0 | Periksa respons 429 asli dan Retry-After |
Mengetahui penyebab spesifik pembatasan laju |
| P0 | Atur pembatasan RPM, TPM, dan laju konsumsi per proyek | Mencegah kuota terus terlampaui |
| P0 | Gunakan exponential backoff dengan jitter acak saat menerima 429 | Mengurangi dampak pembatasan laju mendadak |
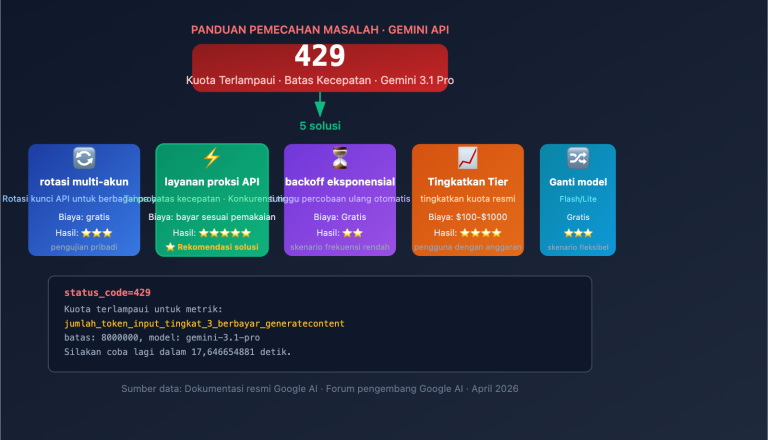
| P1 | Alihkan permintaan secara otomatis ke kanal sehat dengan kuota terpisah saat terjadi 429 | Meningkatkan tingkat keberhasilan |
| P1 | Tingkatkan Tier atau ajukan kenaikan kuota ke Google | Menambah kapasitas jangka panjang |
| P2 | Evaluasi Vertex AI atau kanal lain dengan otorisasi resmi | Memperluas ketersediaan sumber daya |
Langkah pertama: Pahami respons 429 asli
Jangan langsung mencoba ulang hanya karena melihat kode status. Cetak isi error dan header respons secara lengkap, terutama error.message, error.details, dan Retry-After. Jika layanan hulu sudah memberi tahu berapa lama Anda harus menunggu, ikuti waktu tersebut terlebih dahulu daripada menentukan jeda sendiri.
Langkah kedua: Terapkan pembatasan laju di sisi klien
Atur RPM pada kisaran 70% hingga 80% dari batas yang terlihat di konsol, kelola TPM secara terpisah, dan pantau juga jumlah pengeluaran selama 10 menit. Tujuan menyisakan kapasitas adalah menyediakan ruang untuk lonjakan trafik dan fluktuasi layanan hulu. Banyak tim hanya membatasi jumlah permintaan, tetapi mengabaikan Token dan biaya. Akibatnya, permintaan tetap ditolak meskipun “RPM belum terlampaui”.
Langkah ketiga: Gunakan exponential backoff dengan jitter acak
Google menyarankan penggunaan exponential backoff untuk error 429, misalnya menunggu 1, 2, 4, lalu 8 detik, dengan tambahan jitter acak. Ini mencegah banyak permintaan mencoba ulang secara bersamaan dan menimbulkan kepadatan baru. Batasi percobaan ulang hingga 2–3 kali, dan utamakan waktu tunggu yang dikembalikan oleh layanan hulu.
Langkah keempat: Beralih kanal jika error 429 terus terjadi
Jika proyek yang sama terus mengembalikan 429, jangan terus mencoba ulang ke proyek tersebut karena tindakan ini hanya akan memperparah pembatasan laju. Sebaiknya kurangi trafik atau beralih ke kanal sehat dengan kuota terpisah. Di sinilah layanan agregator berguna: melalui APIYI apiyi.com, permintaan dapat didistribusikan ke beberapa kanal dengan kuota terpisah sehingga seluruh beban tidak bertumpu pada satu proyek AI Studio.
Langkah kelima: Tingkatkan Tier atau ajukan kenaikan kuota
Dalam jangka panjang, kapasitas yang tidak mencukupi perlu diatasi dengan meningkatkan tingkat akun atau mengajukan kenaikan kuota ke Google. Setelah Tier ditingkatkan, batas RPM dan TPM akan lebih longgar, begitu juga batas pengeluaran selama 10 menit, yang dapat naik dari $10 menjadi $50 hingga $200. Namun, proses kenaikan kuota membutuhkan waktu dan riwayat penggunaan, sehingga biasanya tidak selesai tepat waktu untuk peluncuran bisnis.
Langkah keenam: Evaluasi kanal lain dengan otorisasi resmi
Jika skala bisnis terus bertumbuh, pertimbangkan Vertex AI atau kanal lain dengan otorisasi resmi untuk memperluas ketersediaan sumber daya. Menjalankan beberapa kanal secara bersamaan juga merupakan cara yang andal untuk mengurangi risiko titik kegagalan tunggal.
Saran pengujian beban untuk kanal baru
Untuk kanal baru yang terhubung ke Argon, sebaiknya mulai dengan konkurensi 5 hingga 10 untuk pengujian beban. Perlu diingat, ini hanya parameter awal pengujian, bukan batas konkurensi resmi. Setelah itu, tingkatkan beban secara bertahap. Kirim permintaan secara merata pada setiap tahap, lalu catat tingkat 429, RPM aktual, TPM, konsumsi selama 10 menit, dan durasi permintaan berdasarkan penyedia, proyek Google, serta model. Lanjutkan ke tahap berikutnya setelah hasilnya dipastikan stabil.
Panduan singkat gemini-4-argon: Memanggil model melalui APIYI
Setelah membahas teorinya, mari lihat kodenya. APIYI menyediakan antarmuka yang kompatibel dengan OpenAI. Anda hanya perlu mengganti base_url untuk memanggil gemini-4-argon.
Contoh sederhana
Kode berikut, yang terdiri dari sekitar 10 baris, cukup untuk menjalankan satu pemanggilan:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

response = client.chat.completions.create(
    model="gemini-4-argon",
    messages=[{"role": "user", "content": "用一句话解释什么是 429 限流"}]
)
print(response.choices[0].message.content)
Lihat kode lengkap: pemanggilan konkuren dengan exponential backoff, jitter acak, dan Retry-After
import random
import time
from concurrent.futures import ThreadPoolExecutor

import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

MAX_RETRIES = 3       # 最多重试 2-3 次
BASE_DELAY = 1.0      # 指数退避起点:1、2、4、8 秒


def call_argon(prompt: str) -> str:
    """调用 gemini-4-argon,429 时指数退避并优先遵循 Retry-After"""
    for attempt in range(MAX_RETRIES + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-argon",
                messages=[{"role": "user", "content": prompt}],
                max_tokens=512,
            )
            return resp.choices[0].message.content
        except openai.RateLimitError as e:
            if attempt == MAX_RETRIES:
                return f"Error after retries: {e}"
            # 优先使用上游返回的 Retry-After
            retry_after = None
            try:
                retry_after = float(e.response.headers.get("Retry-After"))
            except (AttributeError, TypeError, ValueError):
                pass
            delay = retry_after if retry_after else BASE_DELAY * (2 ** attempt)
            delay += random.uniform(0, 0.5)  # 随机抖动,避免集体重试
            print(f"429,第 {attempt + 1} 次重试,等待 {delay:.1f}s")
            time.sleep(delay)
        except Exception as e:
            return f"Error: {e}"


if __name__ == "__main__":
    prompts = [f"请用一句话介绍第 {i} 种限流策略" for i in range(10)]
    # 并发度从 5 起步压测,不是官方上限
    with ThreadPoolExecutor(max_workers=5) as pool:
        for result in pool.map(call_argon, prompts):
            print(result)
Mulai cepat: Sebaiknya daftar melalui APIYI apiyi.com dan dapatkan API Key untuk langsung menguji pemanggilan gemini-4-argon dengan kode di atas. Platform ini menyediakan antarmuka terpadu yang kompatibel dengan OpenAI, jadi Anda tidak perlu mengajukan dan mengelola beberapa proyek Google sendiri.
Implementasi sederhana pembatasan laju di sisi klien
Selain mencoba ulang, yang lebih penting adalah “jangan terus menabrak tembok”. Berikut pembatas laju sederhana dengan pendekatan token bucket yang dapat meratakan ritme permintaan dan mencegah lonjakan:
import threading
import time


class RateLimiter:
    """按目标 RPM 匀速放行请求,避免瞬时尖峰"""

    def __init__(self, rpm: int):
        self.interval = 60.0 / rpm
        self.lock = threading.Lock()
        self.next_time = time.monotonic()

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
            self.next_time = max(now, self.next_time) + self.interval


limiter = RateLimiter(rpm=300)  # 按后台限额的 70%-80% 设置

# 在每次调用前执行:
# limiter.wait()
Letakkan pembatas laju di awal fungsi pemanggilan, lalu kombinasikan dengan mekanisme backoff pada contoh sebelumnya. Dengan begitu, Anda mendapatkan perlindungan dua lapis: pembatasan laju aktif dan backoff reaktif.
Kanal berkonkurensi tinggi gemini-4-argon dari APIYI
Kendala utama saat terhubung langsung ke AI Studio adalah kuota tetap untuk setiap proyek. Akun Tier 1 juga dibatasi pengeluaran sebesar $10 dalam 10 menit. Sementara itu, layanan agregator dapat membagi trafik ke beberapa kanal dengan kuota terpisah, lalu otomatis beralih ke kanal yang masih sehat jika salah satu kanal terus-menerus mengembalikan error 429.
APIYI apiyi.com kini mendukung gemini-4-argon dengan konkurensi tinggi. Untuk RPM di bawah 500, Anda tak perlu khawatir soal pembatasan laju. Silakan langsung mencobanya. Untuk sebagian besar aplikasi skala kecil hingga menengah, alat internal, alur kerja otomatis, serta pengujian dan uji beban, kapasitas ini sudah cukup untuk kebutuhan sehari-hari. Anda tak perlu lagi memikirkan tingkat Tier, kuota proyek, atau batas pengeluaran dalam jendela 10 menit.
| Aspek perbandingan | Terhubung langsung ke AI Studio | Memanggil lewat APIYI |
|---|---|---|
| Kepemilikan kuota | Satu proyek, digunakan bersama oleh beberapa Key | Kuota terpisah di beberapa kanal, dikelola oleh platform |
| Penanganan 429 | Perlu menerapkan jeda bertahap dan pengalihan sendiri | Platform memprioritaskan pengalihan ke kanal yang sehat; klien cukup mempertahankan mekanisme percobaan ulang dasar |
| Batas pengeluaran | Terikat batas pengeluaran 10 menit sesuai Tier | Tidak perlu mengelola tingkat akun Google sendiri |
| Cara integrasi | Perlu mengajukan proyek dan mengatur Tier | Antarmuka kompatibel dengan OpenAI; cukup ganti base_url |
| Skala yang sesuai | Trafik rendah atau sudah meningkatkan Tier | Untuk RPM di bawah 500, tak perlu khawatir soal pembatasan laju |
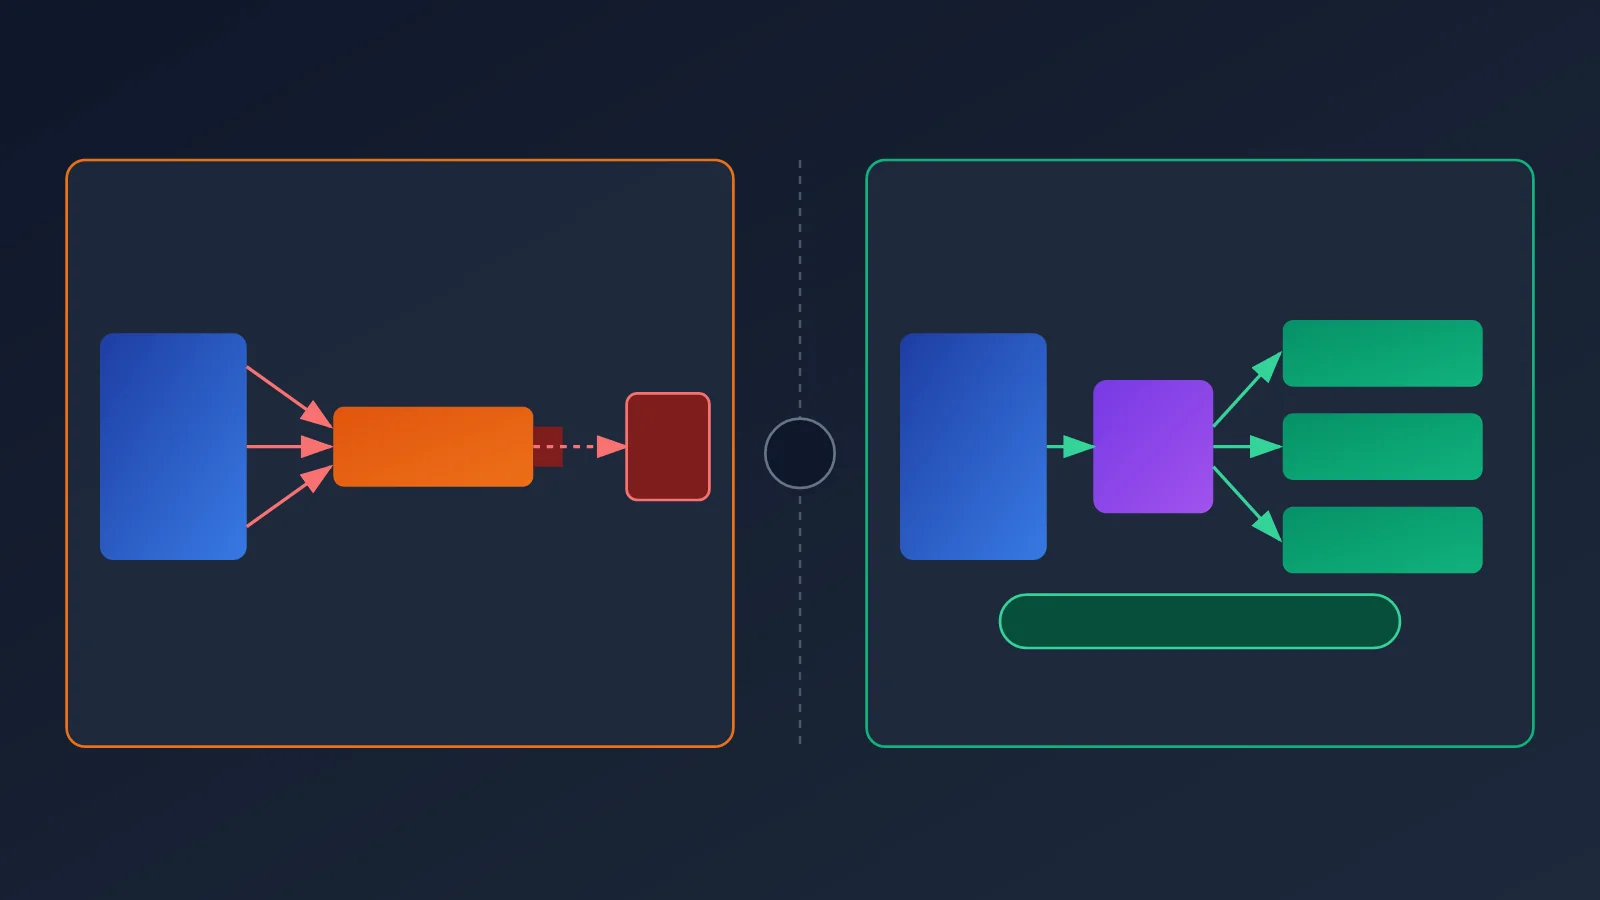
🎯 Saran teknis: Jika puncak trafik bisnis Anda tidak melebihi 500 RPM, Anda bisa langsung memanggil gemini-4-argon lewat APIYI apiyi.com dan berfokus pada logika bisnis. Jika perkiraan trafik melebihi kisaran ini, lakukan uji beban bertahap terlebih dahulu dan bicarakan rencana kapasitas dengan platform sejak awal.
Meski menggunakan kanal berkonkurensi tinggi, tetap gunakan jeda eksponensial untuk percobaan ulang di sisi klien dan atur batas waktu dengan wajar. Gangguan jaringan dan fluktuasi singkat di sisi hulu bisa saja terjadi. Mekanisme percobaan ulang yang baik membantu layanan Anda tetap stabil dalam situasi ekstrem.
FAQ
Q1: Berapa sebenarnya batas konkurensi gemini-4-argon di AI Studio?
Google tidak mengumumkan angka batas konkurensi tetap yang berlaku untuk semua pengguna. Batas sebenarnya ditentukan oleh RPM, TPM, RPD, serta batas konsumsi 10 menit pada proyek Anda. Buka halaman Rate Limits di AI Studio, lalu pilih proyek dan model yang sesuai untuk melihat batasnya. Angka konkurensi spesifik yang beredar di internet tidak memiliki dasar resmi, jadi sebaiknya jangan dijadikan acuan untuk perencanaan kapasitas.
Q2: Apakah membuat beberapa kunci API bisa meningkatkan kuota gemini-4-argon?
Tidak. Google menjelaskan bahwa batas dihitung berdasarkan proyek, bukan kunci API. Beberapa kunci di bawah proyek yang sama berbagi kuota yang sama. Untuk mendapatkan kuota terpisah, Anda memerlukan proyek Google yang berbeda atau layanan agregasi multikanal seperti APIYI apiyi.com.
Q3: Mengapa saya masih menerima 429 padahal RPM dan TPM belum terlampaui?
Penyebab yang paling umum adalah batas konsumsi 10 menit telah tercapai: $10 untuk Tier 1, $50 untuk Tier 2, dan $200 untuk Tier 3. Selain itu, kapasitas upstream yang belum mencukupi saat model baru diluncurkan juga dapat menyebabkan permintaan ditolak meskipun kuota belum habis. Periksa juga `error.details` pada isi respons asli untuk memastikan penyebabnya.
Q4: Bagaimana cara melakukan percobaan ulang yang tepat saat terjadi 429?
Gunakan jeda eksponensial, misalnya 1, 2, 4, lalu 8 detik, dengan menambahkan jeda acak. Batasi percobaan ulang hingga 2–3 kali dan utamakan nilai `Retry-After` pada header respons. Jika 429 terus terjadi pada proyek yang sama, kurangi trafik atau beralih ke kanal dengan kuota terpisah, alih-alih terus mencoba ulang.
Q5: Bagaimana cara cepat memanggil gemini-4-argon melalui APIYI?
1. Kunjungi APIYI apiyi.com, daftar akun, lalu dapatkan kunci API.
2. Atur `base_url` dalam kode menjadi `https://api.apiyi.com/v1`.
3. Atur nama model menjadi `gemini-4-argon`, lalu jalankan contoh kode dalam artikel ini.
APIYI mendukung pemanggilan gemini-4-argon dengan konkurensi tinggi. Untuk RPM di bawah 500, Anda tidak perlu khawatir soal pembatasan laju. Cocok untuk pengujian cepat dan peluncuran dalam skala kecil hingga menengah.
Q6: Apakah saya masih bisa mengalami 429 setelah menggunakan APIYI?
Dalam penggunaan normal dengan RPM di bawah 500, Anda umumnya tidak perlu khawatir soal pembatasan laju. Namun, layanan upstream mana pun bisa mengalami gangguan sementara, jadi sebaiknya tetap siapkan percobaan ulang dengan jeda eksponensial. Jika trafik bisnis Anda berpotensi melampaui batas tersebut, lakukan uji beban bertahap terlebih dahulu, lalu konfirmasikan kapasitasnya dengan platform melalui APIYI apiyi.com.
Q7: Apakah kuota Batch API bisa dijadikan acuan untuk kuota konkurensi real-time?
Tidak. Kuota Argon Batch API yang tercantum dalam dokumentasi Google adalah kuota Token untuk antrean pemrosesan batch, yang digunakan untuk tugas offline. Kuota ini berbeda sistem dengan batas konkurensi dan RPM pada API real-time, jadi keduanya tidak bisa disamakan.
Poin Utama tentang 429 pada gemini-4-argon
- Tidak ada batas konkurensi tetap: Google tidak mengumumkan batas konkurensi gemini-4-argon yang berlaku untuk semua pengguna. Acuannya adalah kuota aktual di dasbor.
- RPM tidak sama dengan konkurensi: Konkurensi bergantung pada durasi pemrosesan permintaan. Trafik yang memuncak lebih mudah memicu pembatasan laju dibandingkan trafik yang stabil.
- Batas dihitung berdasarkan proyek: Menambah kunci API tidak menambah kapasitas karena kuota dibagikan oleh seluruh kunci dalam proyek yang sama.
- Waspadai batas konsumsi 10 menit: Batas Tier 1 hingga Tier 3 masing-masing adalah $10, $50, dan $200. Anda bisa menerima 429 meskipun RPM belum terlampaui.
- Terapkan jeda, pembatasan laju, dan pengalihan: Gunakan jeda eksponensial dengan jeda acak. Jika 429 terus terjadi, beralihlah ke kanal dengan kuota terpisah.
- Konkurensi tinggi jadi lebih mudah dikelola: APIYI apiyi.com mendukung pemanggilan gemini-4-argon dengan konkurensi tinggi. Untuk RPM di bawah 500, Anda tidak perlu khawatir soal pembatasan laju.
Ringkasan
429 sering muncul saat menggunakan gemini-4-argon di AI Studio. Penyebab utamanya bukan sekadar “konkurensi terlalu rendah”, melainkan gabungan beberapa batasan, seperti RPM, TPM, RPD, laju konsumsi dalam 10 menit, dan kapasitas upstream model baru. Penanganannya juga perlu dilakukan bertahap: pahami dulu respons aslinya, lalu terapkan pembatasan laju secara proaktif, gunakan exponential backoff dengan jitter acak, dan beralih kanal jika 429 terus terjadi. Untuk jangka panjang, tingkatkan Tier atau perluas kanal akses resmi agar kapasitas bertambah.
Bagi developer yang ingin mengurangi kerepotan mengelola kuota, menggunakan kanal agregasi bisa menjadi pilihan yang lebih praktis. Coba verifikasi hasilnya melalui APIYI, apiyi.com. Platform ini mendukung pemanggilan gemini-4-argon dengan konkurensi tinggi. Anda bisa menggunakannya dengan tenang selama RPM di bawah 500. Silakan coba.
Referensi
- Halaman penggunaan dan batas laju Google AI Studio: Periksa RPM, TPM, RPD, dan tingkat Tier untuk proyek
- Tautan:
aistudio.google.com/usage -
Keterangan: Pilih proyek dan gemini-4-argon untuk melihat kuota sebenarnya
-
Dokumentasi batas laju Gemini API: Mekanisme pembatasan laju resmi dan saran penanganan 429
- Tautan:
ai.google.dev/gemini-api/docs/rate-limits - Keterangan: Mencakup batas konsumsi 10 menit dan saran exponential backoff
Penulis: APIYI Team
Diskusi teknis: Silakan bahas pengalaman mendiagnosis 429 pada gemini-4-argon di kolom komentar. Untuk informasi integrasi lainnya, kunjungi pusat dokumentasi APIYI di docs.apiyi.com.