Catatan penulis: Setelah model diperbarui, petunjuk dan kode patch tidak bisa dihapus hanya berdasarkan firasat. Artikel ini menggunakan taksonomi 4 kategori dan alur regresi 5 langkah untuk membantu Anda menilai mana yang sebaiknya dihapus, diubah, atau dipertahankan.
Pada November 2026, laporan 36Kr tentang tokoh kunci Claude Code yang meninggalkan Anthropic kembali memantik perbincangan para developer soal alat pemrograman AI. Di luar kisah personalnya, persoalan yang lebih nyata bagi banyak tim adalah: setiap kali model diperbarui, petunjuk dan kode patch terus bertambah — apakah semuanya masih perlu dipertahankan? Artikel ini memperkenalkan metode pembersihan klasifikasi dulu, bandingkan kemudian, uji canary di akhir yang membantu Anda mengurangi beban tanpa mengorbankan stabilitas.
Ini bukan artikel yang mendorong Anda untuk “hapus semua dengan berani”. Di dalam petunjuk mungkin tersimpan aturan bisnis, di dalam kode patch mungkin tersimpan pagar pengaman; biaya satu kesalahan hapus sering kali lebih besar daripada membayar lebih banyak token. Artikel ini juga tidak menyediakan benchmark umum, karena hasil pembersihan bergantung pada sampel bisnis Anda — Anda perlu menarik kesimpulan dari data Anda sendiri.
Nilai inti: Setelah membaca artikel ini, Anda akan mampu menilai petunjuk dan kode patch mana yang boleh dihapus setelah model diperbarui, serta menyelesaikan pembersihan dengan alur yang bisa di-rollback.
Poin-Poin Inti Pembersihan Petunjuk dan Kode Patch Setelah Peningkatan Model
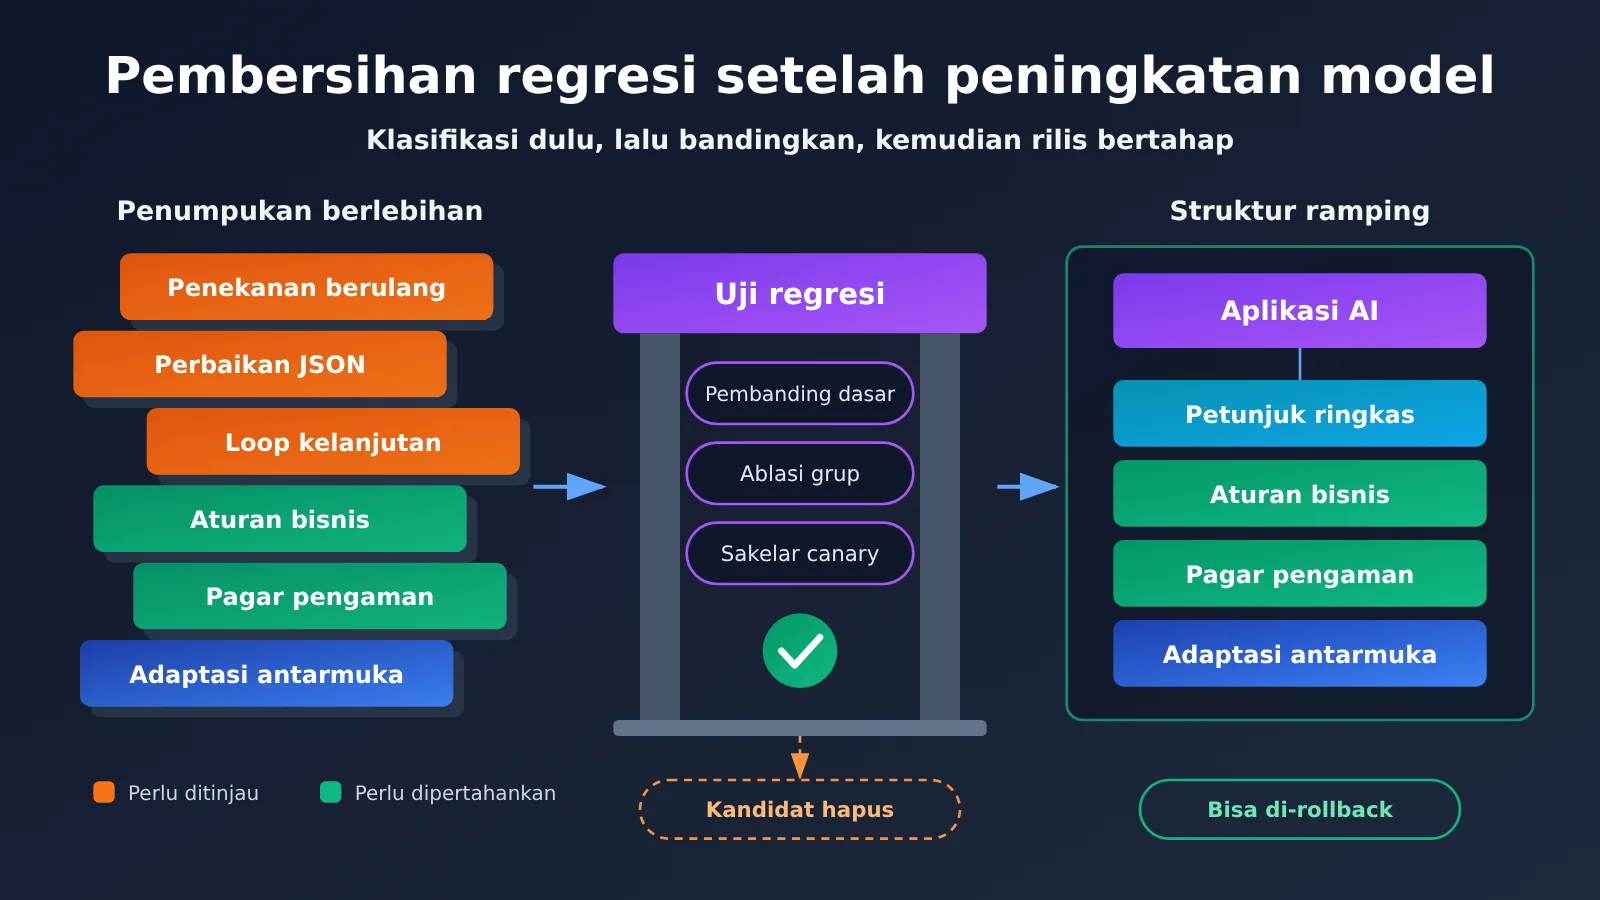
Ingat dulu satu prinsip penilaian: sebuah petunjuk atau patch, jika tujuannya untuk menutupi kekurangan model lama, harus siap ditinjau ulang; jika tujuannya untuk menyatakan aturan bisnis atau mengendalikan risiko, maka tidak boleh dihapus hanya karena modelnya di-upgrade. Tabel di bawah adalah versi ringkas dari alur yang dijelaskan setelah ini.
| Poin | Penjelasan | Nilai |
|---|---|---|
| Klasifikasikan dulu, baru bertindak | Bagi menjadi 4 kategori: kompensasi model, aturan bisnis, pagar pengaman, dan adaptasi antarmuka | Menghindari penghapusan logika penting secara keliru |
| Hanya ganti model sebagai baseline | Putaran pertama biarkan petunjuk dan kode tetap sama | Membedakan perubahan karena model dengan perubahan karena pembersihan |
| Uji ablasi berkelompok | Setiap kali hapus hanya satu kelompok lalu bandingkan hasilnya | Memetakan peran tiap bagian secara akurat |
| Peluncuran bertahap dengan feature flag | Hasil pembersihan dikendalikan lewat konfigurasi, bisa di-rollback kapan saja | Mengurangi risiko insiden di produksi |
| Tinjau tagihan secara terpisah | Petunjuk yang lebih pendek belum tentu berarti biaya total turun | Mencegah salah penilaian hanya dari jumlah token |
Mengapa Petunjuk dan Kode Patch Menjadi Usang Setelah Peningkatan Model
Sebagian besar petunjuk di aplikasi AI “dibesarkan” oleh masalah di produksi. Model melewatkan format, tambahkan satu kalimat penegasan; keluaran model terpotong, tambahkan satu loop penyambungan; model kadang menulis JSON sembarangan, tambahkan lagi satu fungsi perbaikan. Semua cara itu wajar pada masanya, tetapi yang diikat adalah perilaku model lama—dan ikatan seperti ini jarang dicatat.
Setelah model di-upgrade, konten tersebut bisa berada dalam tiga kondisi: masalahnya sudah hilang dan patch menjadi kode mati; masalahnya masih ada sehingga patch tetap berguna; atau perilaku model berubah sehingga cara lama justru menimbulkan efek samping. Contohnya, kalimat penegasan yang dulu diulang-ulang agar model memperhatikan, ketika dipakai pada model baru yang merespons instruksi dengan cara berbeda, bisa membuatnya mengeksekusi suatu aturan secara berlebihan. Karena itu, tujuan peninjauan setelah upgrade bukanlah “semakin pendek semakin baik”, melainkan memastikan setiap bagian punya alasan keberadaan yang jelas.
Cara membagi petunjuk dan kode patch menjadi 4 kategori
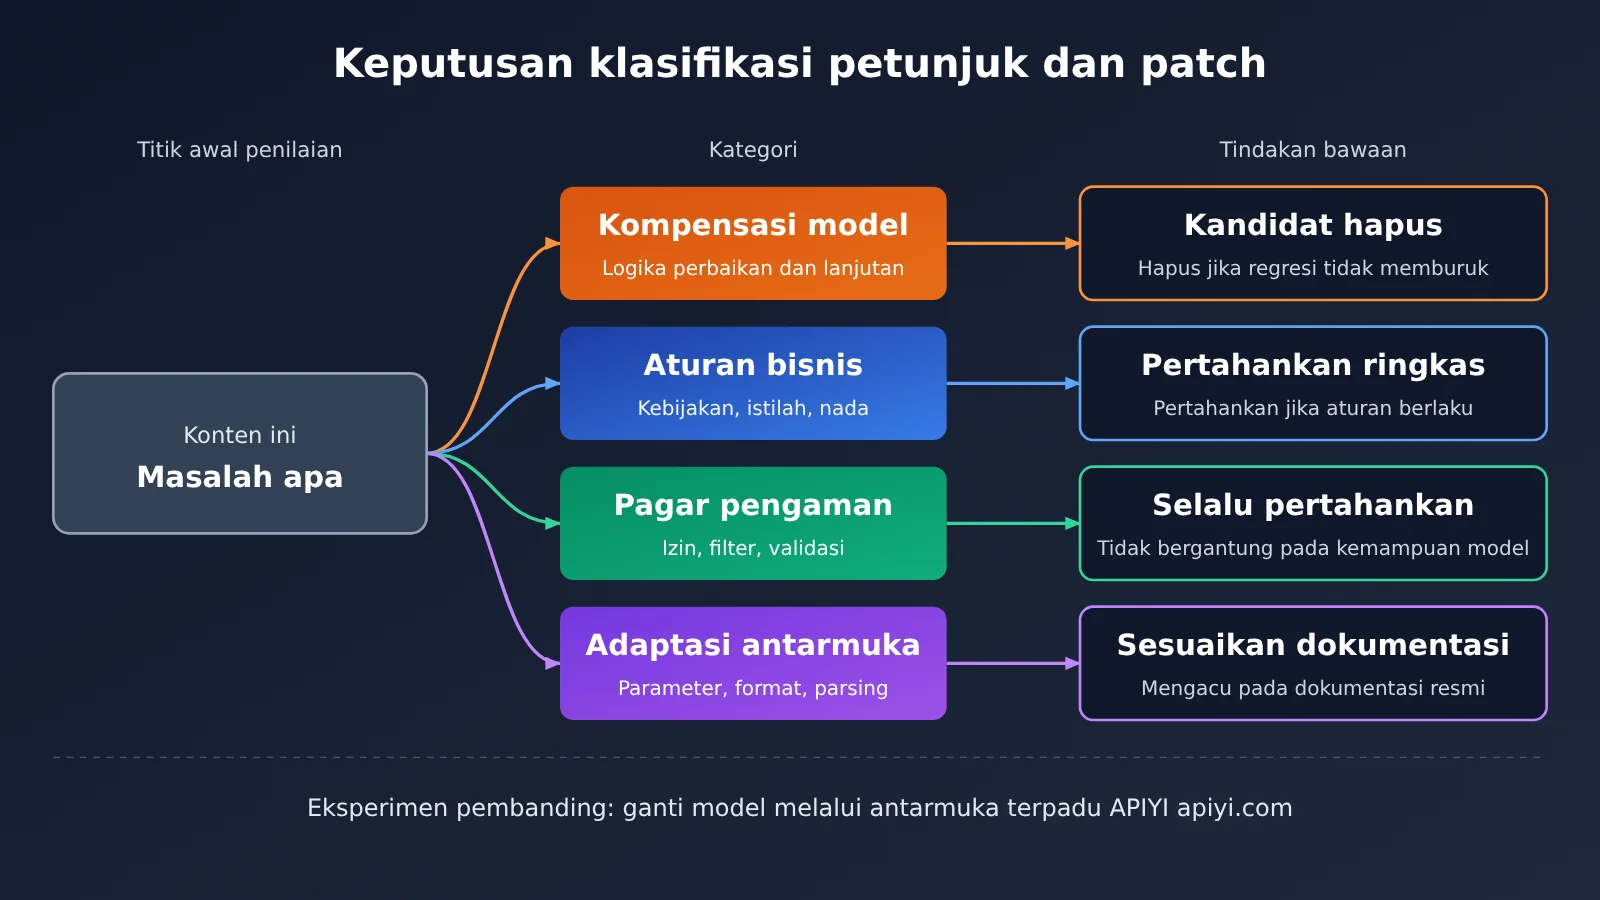
Sebelum membersihkan, pisahkan dulu system prompt berdasarkan paragraf, lalu daftar satu per satu logika pemrosesan sebelum dan sesudah pemanggilan model. Setelah itu, klasifikasikan menggunakan tabel di bawah ini agar keputusan penghapusan berikutnya punya dasar yang jelas.
| Kategori | Contoh umum | Tindakan default | Dasar penilaian |
|---|---|---|---|
| Kompensasi model | Pengulangan “jangan lewatkan”, fungsi perbaikan JSON, loop lanjutan saat output terpotong | Masukkan ke daftar kandidat penghapusan | Hapus hanya jika pengujian regresi tidak menunjukkan degradasi |
| Aturan bisnis | Kebijakan refund, glosarium, nada merek, batasan domain | Pertahankan dan ringkas ekspresinya | Pertahankan jika aturan masih berlaku |
| Guardrail keamanan | Verifikasi izin, penyaringan informasi sensitif, validasi output, perlindungan terhadap injeksi | Selalu pertahankan | Tidak bergantung pada kemampuan model |
| Adaptasi antarmuka | Pemetaan parameter, konversi format pemanggilan alat, parsing respons | Sesuaikan dengan model baru | Mengacu pada dokumentasi antarmuka resmi |
Ada satu detail yang perlu dijelaskan terpisah: logika perbaikan dapat dipertimbangkan untuk dihapus, tetapi logika validasi tidak boleh dihapus. Ketika output terstruktur dari model baru lebih stabil, kode regex untuk memperbaiki JSON mungkin sudah bisa dinonaktifkan, tetapi validasi Schema tetap harus dipertahankan. Dengan cara yang sama, loop lanjutan untuk output yang terpotong dapat ditinjau ulang, sedangkan retry untuk kesalahan jaringan dan pembatasan laju tidak terkait dengan kemampuan model sehingga tidak boleh dimasukkan ke cakupan pembersihan.
Panduan Cepat Membersihkan Petunjuk dan Kode Patch Setelah Upgrade Model
Proses 5 langkah di bawah ini tidak menuntut platform yang rumit—framework pengujian dan spreadsheet yang sudah ada pun cukup. Kuncinya adalah mengubah satu variabel saja dalam satu waktu, lalu mencatat setiap keputusan.
Langkah 1: Inventarisasi sumber petunjuk dan kode patch
Gunakan git log dan git blame untuk melacak kapan setiap potongan konten diperkenalkan beserta masalah yang terkait dengannya, lalu catat empat informasi dalam daftar: lokasi konten, kategorinya, masalah yang ditargetkan, dan cara verifikasinya. Jika ada bagian petunjuk yang sudah tidak ada seorang pun bisa menjelaskan asal-usulnya, tandai sebagai “perlu verifikasi”—jangan langsung menganggapnya tidak berguna.
Langkah 2: Membangun set sampel regresi untuk peningkatan model
Set regresi sebaiknya mencakup tiga bagian: permintaan umum nyata dari lingkungan produksi, sampel kegagalan yang pernah menyebabkan insiden, dan skenario batas bisnis. Skala sampel dapat ditentukan berdasarkan tingkat risiko; bagi tim kecil, memulai dengan beberapa puluh sampel bernilai tinggi pun tetap bermakna. Karena output model bersifat tidak pasti, sampel kunci sebaiknya dijalankan berulang kali agar kelulusan kebetulan tidak dianggap sebagai kelulusan yang stabil.
Langkah 3: Hanya mengganti model, bangun baseline kontrol
Pada putaran pertama, ubah hanya nama model, biarkan petunjuk dan kode tetap seperti semula, serta kunci parameter yang dapat dikontrol seperti temperature. Dengan cara ini Anda bisa mendapatkan perbedaan antara “model lama + konfigurasi lama” dan “model baru + konfigurasi lama”, sekaligus mendeteksi lebih awal perubahan pada parameter antarmuka atau struktur respons. Jika platform mendukung nama model dengan versi tetap, utamakan menggunakan versi tetap untuk mencegah model berubah selama pengujian dan mengganggu hasil.
Tabel berikut mencantumkan item konfigurasi yang perlu dikonfirmasi saat mengintegrasikan eksperimen kontrol.
| Item konfigurasi | Cara pengisian | Catatan |
|---|---|---|
base_url |
Gunakan alamat antarmuka yang sesuai yang tercantum dalam dokumentasi APIYI | Alamat dan path format OpenAI serta Anthropic mengikuti dokumentasi |
api_key |
Gunakan kunci yang dibuat di konsol | Kelola melalui variabel lingkungan, jangan tulis ke repositori |
model |
Isi nama model dari halaman harga atau dokumentasi | Kelompok eksperimen lama dan baru harus konsisten kecuali nama model |
temperature |
Semua kelompok eksperimen menggunakan nilai yang sama | Rentang parameter beberapa model mungkin berbeda, perlu memeriksa dokumentasi |
max_tokens |
Setel ruang yang cukup untuk model lama dan baru | Mencegah pemotongan disalahartikan sebagai masalah kualitas model |
🚀 Saran memulai cepat: Hal yang paling memakan waktu dalam eksperimen kontrol biasanya adalah menyesuaikan dengan berbagai antarmuka. APIYI menyediakan pemanggilan API untuk model Claude, GPT, dan lainnya yang dibahas dalam artikel ini, serta kompatibel dengan format antarmuka OpenAI dan Anthropic. Biasanya Anda hanya perlu menyesuaikan
base_url,api_key, danmodeluntuk mulai menguji. Penjelasan integrasi dapat dilihat di dokumentasi APIYI: https://docs.apiyi.com
Langkah 4: Ablasi Petunjuk dan Kode Patch secara Berkelompok
Setelah baseline stabil, mulailah menghapus kelompok demi kelompok, dimulai dari kategori kompensasi model. Setiap kelompok hanya boleh berisi konten yang menyelesaikan masalah yang sama. Misalnya, hapus dulu petunjuk terkait “penekanan format” beserta fungsi perbaikannya, jalankan regresi hingga selesai, baru lanjut ke kelompok berikutnya. Jika terlalu banyak dihapus sekaligus, saat hasil memburuk akan sulit melacak penyebabnya, dan akhirnya sering kali hanya bisa melakukan rollback menyeluruh.
| Metrik | Yang diamati | Rujukan keputusan |
|---|---|---|
| Tingkat kelulusan sampel kritis | Apakah insiden historis dan skenario berisiko tinggi lolos | Jika terjadi degradasi, pulihkan konten kelompok tersebut |
| Tingkat kelulusan tugas secara keseluruhan | Perubahan kualitas permintaan biasa | Nilai berdasarkan ambang batas yang ditetapkan tim sebelumnya |
| Tingkat pemicuan patch | Jumlah pemicuan aktual logika perbaikan atau kelanjutan | Jika mendekati nol dalam jangka panjang, dapat dijadikan dasar untuk menghapus |
| Token dan latensi | Penggunaan input, output, dan waktu respons | Untuk mengevaluasi manfaat nyata dari pembersihan |
| Tingkat intervensi manual | Proporsi eskalasi ke agen manusia atau pekerjaan ulang pengguna | Pantau terus setelah peluncuran untuk menutupi blind spot sampel offline |
Kriteria penilaian harus ditulis sebelum pengujian dijalankan. Jika tidak, tim mudah menyesuaikan standar secara ad hoc berdasarkan hasil. Untuk kode patch, Anda juga bisa terlebih dahulu hanya mencatat tanpa melakukan intervensi: biarkan tetap berjalan, sekaligus laporkan “apa yang akan terjadi jika patch ini tidak ada”. Beberapa hari kemudian, putuskan apakah akan menghapusnya berdasarkan data pemicuan. Ini sangat berguna terutama untuk bisnis berisiko tinggi.
Langkah 5: Rilis Bertahap dan Tetap Sediakan Kemampuan Rollback
Versi yang sudah dibersihkan sebaiknya dirilis melalui feature flag: awalnya hanya untuk sebagian kecil trafik, lalu perluas cakupannya setelah metrik dipastikan stabil. Catatan penghapusan harus memuat alasannya secara jelas, misalnya “regresi model versi tertentu lolos dan tingkat pemicu patch terus mendekati nol”, supaya penilaian yang sama bisa langsung dipakai lagi saat upgrade berikutnya.
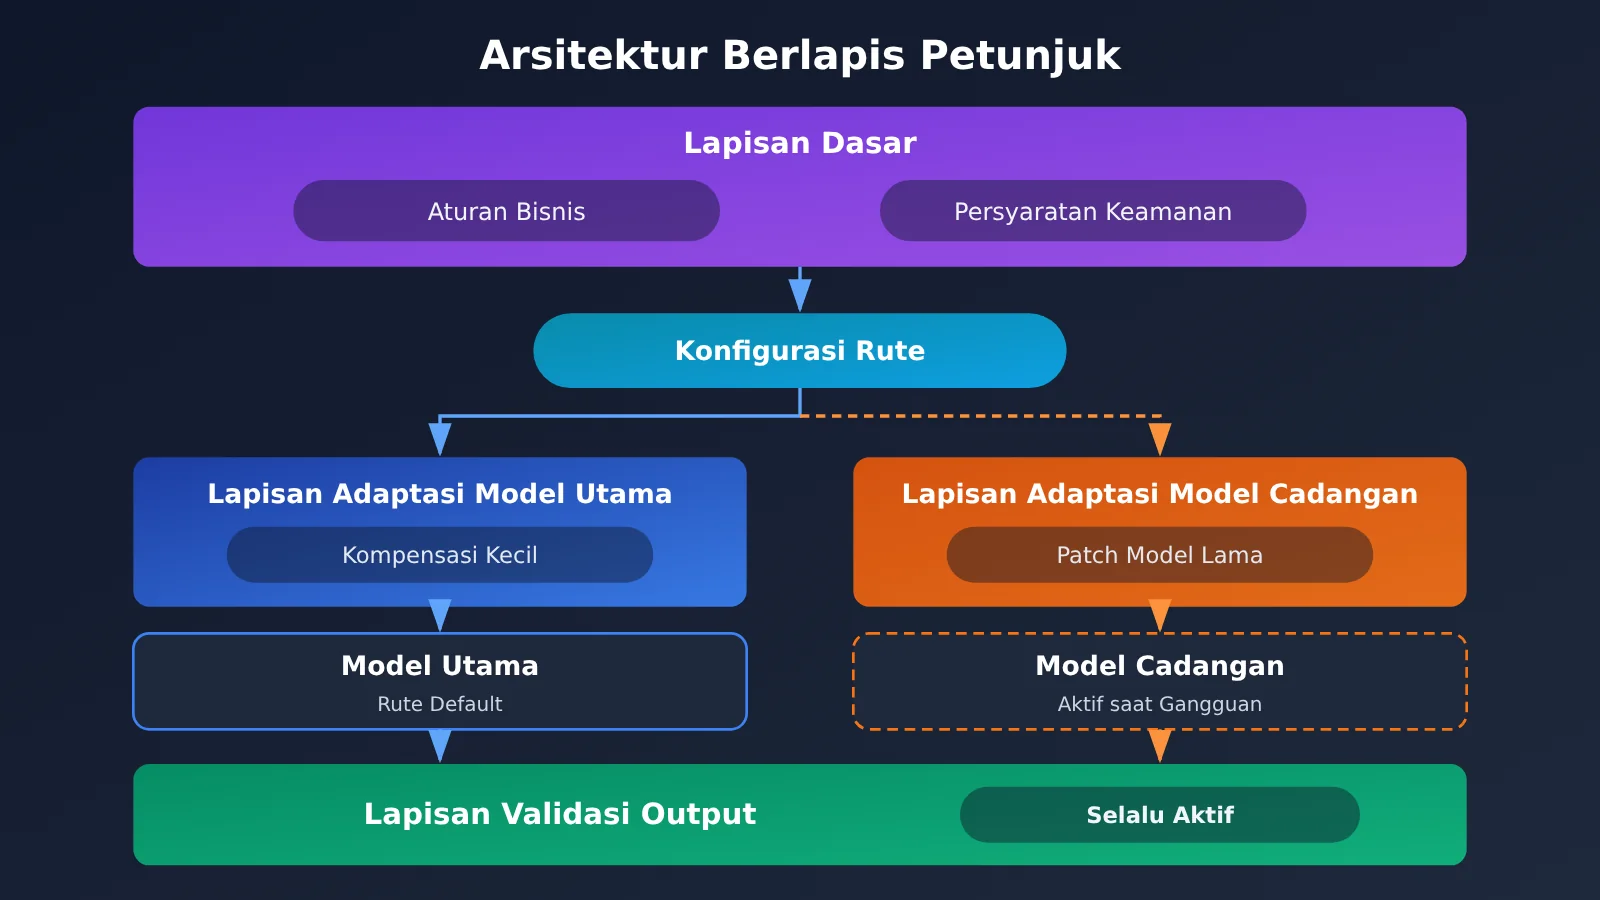
Jangan lupa periksa secara khusus jalur degradasi model. Jika model utama tidak tersedia dan sistem beralih ke model lama, patch yang ditulis untuk model lama bisa jadi masih diperlukan. Pendekatan yang lebih aman adalah membagi petunjuk menjadi dua lapis: aturan bisnis dan persyaratan keamanan diletakkan di lapisan dasar, sedangkan konten terkait model diletakkan di lapisan adaptasi, lalu dimuat per model oleh konfigurasi routing.
Perbandingan 3 Strategi Penanganan Petunjuk dan Kode Patch Setelah Upgrade Model
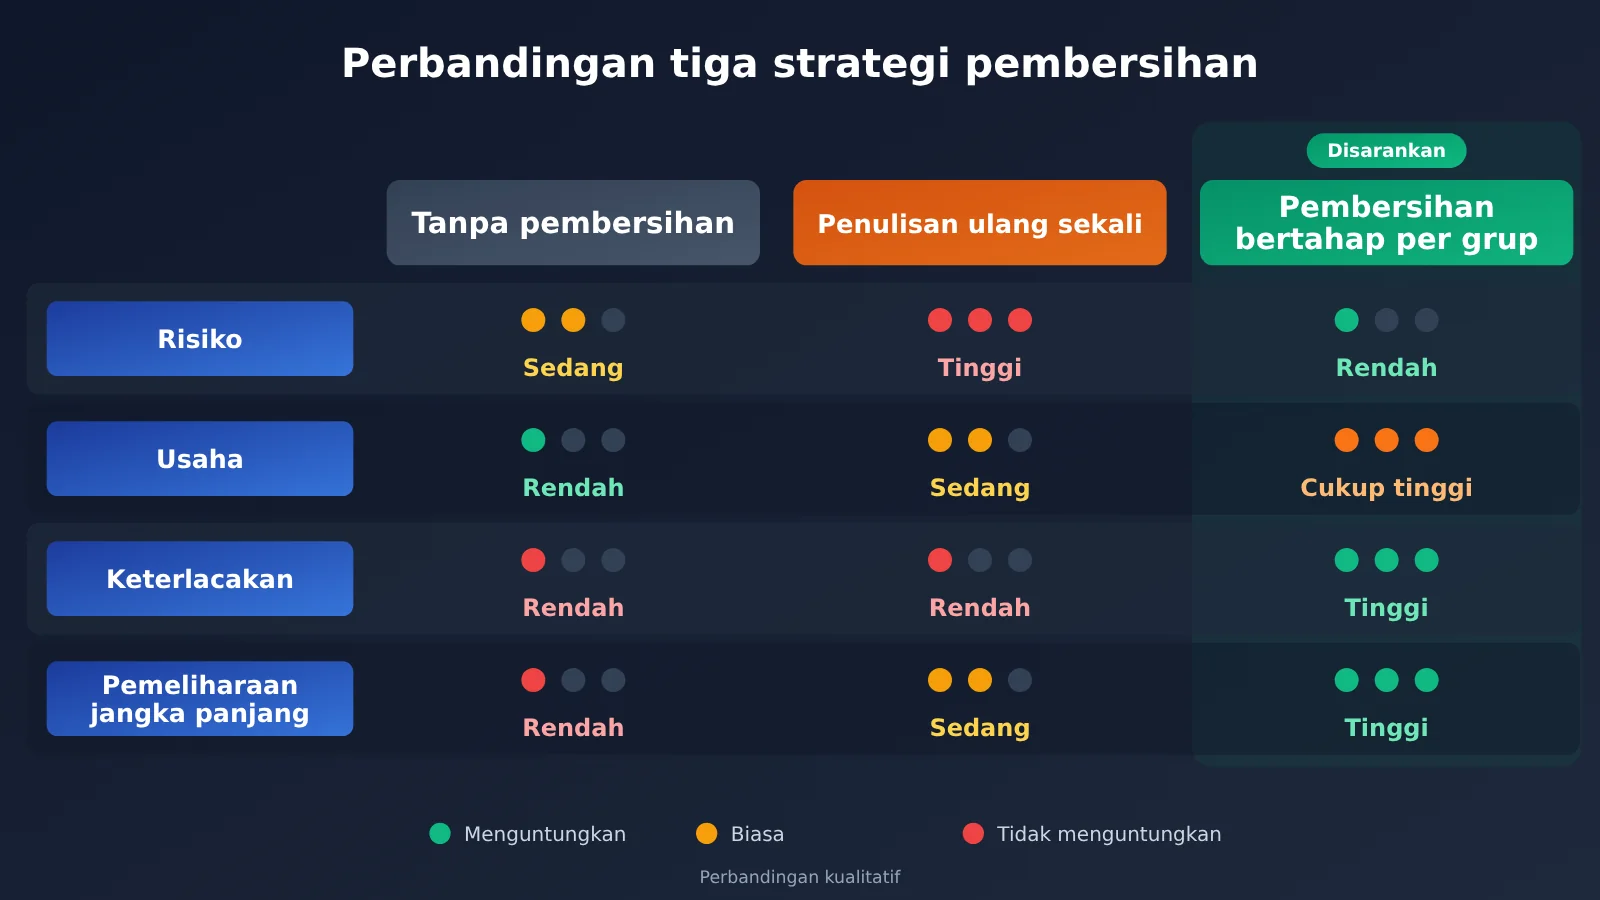
Pembersihan bukan hanya soal “hapus semua” atau “biarkan apa adanya”. Tabel berikut membandingkan tiga strategi umum; Anda bisa memilih berdasarkan risiko bisnis dan investasi tim.
| Strategi | Cara | Risiko utama | Cocok untuk |
|---|---|---|---|
| Pertahankan apa adanya | Hanya ganti nama model, konten lain tidak diubah | Konten tidak efektif terus menumpuk; potensi model baru sulit dimanfaatkan | Upgrade sementara atau belum ada sumber daya pengujian dalam waktu dekat |
| Tulis ulang sekaligus | Tulis dari awal mengikuti panduan petunjuk model baru | Aturan bisnis tersirat berpotensi hilang | Skala petunjuk kecil atau bisnis sedang direstrukturisasi |
| Pembersihan bertahap per kelompok | Kelompokkan, lakukan ablasi per kelompok, lalu rilis bertahap | Perlu waktu untuk membangun set regresi | Lingkungan produksi dan sebagian besar aplikasi yang dipelihara jangka panjang |
Analisis pembanding: pertahankan apa adanya — Strategi ini unggul dalam kecepatan rilis, tetapi efek samping petunjuk lama dan beban pemeliharaannya tidak akan hilang sendiri. Sebagai pembanding, pembersihan bertahap per kelompok lebih cocok untuk sistem produksi yang perlu iterasi jangka panjang.
Analisis pembanding: tulis ulang sekaligus — Strategi ini menonjol dalam kerapian struktur petunjuk, tetapi pengalaman bisnis yang tersimpan di patch historis mudah terlewat. Jika tetap memilih menulis ulang, sebaiknya tetap verifikasi dengan set regresi yang sama dan periksa aturan bisnis di versi lama satu per satu.
Perhitungan Biaya Pembersihan Petunjuk dan Kode Patch Setelah Upgrade Model
Petunjuk yang lebih pendek tidak berarti total biaya turun. Biaya satu pemanggilan dapat diperkirakan dengan “token input × harga satuan input + token output × harga satuan output”; saat menggunakan cache, bedakan juga penagihan baca dan tulis cache, serta hitung panggilan tambahan akibat retry dan degradasi. Output model baru bisa lebih panjang, dan mengubah prefiks petunjuk dapat memengaruhi cache hit, jadi verifikasi dengan penggunaan nyata dalam eksperimen.
💰 Catatan dasar harga: Artikel ini tidak mencantumkan harga satuan spesifik. Untuk harga model, dasar penagihan, harga satuan input/output, dan harga cache, gunakan data aktual di halaman harga APIYI https://docs.apiyi.com/models, dan catat tanggal pengecekan saat menghitung biaya.
FAQ (Pertanyaan yang Sering Diajukan)
Q1: Apa yang dimaksud dengan “kompensasi model” pada petunjuk (prompt) dan kode patch?
Kompensasi model adalah konten yang ditambahkan untuk mengakali kekurangan model tertentu, misalnya mengulang-ulang penekanan pada format keluaran, memperbaiki JSON yang rusak, atau menyambung hasil yang terpotong. Bedanya dengan aturan bisnis: setelah model diganti dengan yang kemampuannya lebih tinggi, konten semacam ini mungkin sudah tidak diperlukan lagi.
Q2: Setelah model di-upgrade, apakah petunjuk dan kode patch harus dihapus semua lalu ditulis ulang?
Umumnya tidak disarankan. Menulis ulang semuanya memang terlihat rapi, tetapi mudah menghilangkan aturan bisnis yang tersirat dan pengalaman dari insiden. Untuk sistem produksi, lebih cocok membersihkan secara bertahap per kelompok; jika ukuran petunjuk sangat kecil atau bisnis sedang direstrukturisasi, penulisan ulang bisa dipertimbangkan, tetapi tetap harus diverifikasi lewat set regresi.
Q3: Kapan waktu yang tepat untuk membersihkan petunjuk dan kode patch?
Waktu terbaik adalah periode evaluasi saat pergantian model, karena pada saat itu memang sudah harus menjalankan regresi. Selain itu, ketika tingkat pemicu patch sudah lama mendekati nol, atau petunjuk sudah terlalu banyak sampai tidak ada yang berani mengubahnya, sebaiknya jadwalkan pembersihan khusus. Jangan melakukan pembersihan terpusat menjelang promo besar atau puncak bisnis.
Q4: Petunjuk dan kode patch mana yang sama sekali tidak boleh dihapus hanya karena model di-upgrade?
Validasi izin akses, penyaringan informasi sensitif, validasi Schema keluaran, perlindungan terhadap prompt injection, dan log audit harus selalu dipertahankan. Semua itu mengendalikan risiko sistem dan tidak boleh bergantung pada asumsi bahwa model “kemungkinan besar berperilaku baik”. Logika retry untuk kesalahan jaringan dan pembatasan laju juga termasuk infrastruktur, sehingga tidak boleh masuk cakupan pembersihan.
Q5: Bagaimana cara cepat membandingkan model lama dan baru lewat API?
Setelah set regresi siap, buat grup eksperimen lama dan baru memakai petunjuk serta parameter yang sama, hanya nama modelnya yang diubah. Lewat APIYI, Anda dapat memanggil berbagai model dengan format antarmuka yang kompatibel dengan OpenAI atau Anthropic, sehingga mudah berganti model dalam satu skrip pengujian yang sama. Untuk konfigurasi detailnya, silakan lihat dokumentasi: https://docs.apiyi.com
Q6: Bagaimana memastikan pembersihan benar-benar menghemat biaya?
Hitung secara terpisah jumlah token masukan, token keluaran, cache hit, dan jumlah retry sebelum dan sesudah pembersihan, lalu kalikan dengan harga satuan saat ini. Untuk harga satuan dan penagihan cache, silakan cek halaman harga APIYI: https://docs.apiyi.com/models . Selain membandingkan biaya per pemanggilan, lihat juga biaya per tugas yang berhasil, karena angka itu lebih mendekati biaya bisnis yang sebenarnya.
Q7: Apa saja keterbatasan alur pembersihan ini?
Set regresi hanya bisa mencakup masalah yang sudah diketahui; lulus pengujian bukan berarti tidak akan ada situasi baru di produksi, jadi canary release dan pemantauan tidak boleh dilewati. Alur ini juga memerlukan tenaga kerja, sehingga alat internal yang frekuensinya rendah atau risikonya kecil tidak perlu diikuti sepenuhnya. Jika sampel sedikit, fluktuasi metrik bisa cukup besar, jadi jangan mengambil kesimpulan yang terlalu detail berdasarkan data tersebut.
Key Takeaways: Pembersihan Petunjuk dan Kode Patch Setelah Upgrade Model
- Kriteria penilaian: lihat apakah konten tersebut mengompensasi model lama, atau justru mengungkapkan aturan bisnis dan pengendalian risiko.
- Pembagian 4 kategori: kompensasi model, aturan bisnis, pagar pengaman (guardrail), dan adaptasi antarmuka masing-masing mengambil tindakan berbeda.
- Prioritas baseline: putaran pertama hanya mengganti model, tidak sekaligus mengubah petunjuk dan kode patch.
- Ablasi bertahap: setiap kali hanya menghapus satu kelompok konten terkait, agar saat terjadi degradasi bisa ditemukan dengan tepat.
- Pertahankan validasi: logika perbaikan JSON bisa ditinjau ulang, validasi Schema dan pemeriksaan izin sebaiknya dipertahankan.
- Pemeriksaan fallback: sebelum menghapus patch, pastikan dulu apakah model lama dalam rantai rollback masih bergantung padanya.
- Alat perbandingan: bisa memanfaatkan antarmuka kompatibel APIYI, menggunakan set skrip yang sama untuk mengganti model dan melakukan regresi.
Ringkasan
Setelah upgrade model, apakah petunjuk dan kode patch harus dihapus, jawabannya tidak bergantung pada promosi model baru, melainkan pada data regresi Anda. Pekerjaan pembersihan bisa diringkas menjadi tiga poin:
- Pahami dulu asalnya: jelaskan masalah apa yang diselesaikan setiap bagian konten, lalu arsipkan berdasarkan 4 kategori.
- Ambil keputusan lewat eksperimen: bangun baseline, lakukan ablasi berkelompok, gunakan metrik yang sudah disiapkan sebelumnya untuk menentukan dipertahankan atau tidak.
- Buat perubahan bisa di-rollback: luncurkan secara bertahap lewat feature flag, dan kelola konten terkait model serta aturan bisnis secara berlapis.
Disarankan memulai dari skenario dengan volume panggilan yang wajar dan risiko yang terkendali, jalankan dulu alur lengkapnya, baru kemudian perluas ke bisnis inti. Jika perlu membandingkan antar beberapa model, Anda bisa memanggil model yang dibahas di artikel ini melalui APIYI, cara integrasinya lihat https://docs.apiyi.com , untuk biaya silakan mengacu pada data aktual di halaman harga https://docs.apiyi.com/models .
📚 Referensi
- 36Kr – Mahasiswi berprestasi CS Princeton yang tiba-tiba meninggalkan Anthropic, dan membuat Claude Code populer: sumber konteks terkini di awal artikel ini
- Tautan:
36kr.com/p/4055331476526214 -
Keterangan: Dipublikasikan pada 4 November 2026. Metode pembersihan dalam artikel ini merupakan rangkuman praktik rekayasa umum, bukan transkripsi dari isi laporan tersebut.
-
Dokumentasi APIYI: penjelasan format antarmuka dan konfigurasi integrasi
- Tautan:
docs.apiyi.com -
Keterangan: Digunakan untuk memastikan
base_url, jalur endpoint, dan cara pemanggilan. -
Halaman Model dan Harga APIYI: daftar model serta informasi penagihan
- Tautan:
docs.apiyi.com/models -
Keterangan: Harga model, dasar penagihan, dan harga cache yang dibahas dalam artikel ini mengacu pada data aktual di halaman tersebut.
-
Dokumentasi resmi Anthropic: panduan model dan petunjuk Claude
- Tautan:
docs.anthropic.com -
Keterangan: Saat melakukan upgrade model Claude, Anda dapat merujuk pada perubahan antarmuka dan saran petunjuk.
-
Dokumentasi resmi OpenAI: panduan model dan API GPT
- Tautan:
platform.openai.com/docs - Keterangan: Saat melakukan upgrade model GPT, Anda dapat merujuk pada perubahan parameter dan panduan migrasi.
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami melalui halaman utama situs APIYI, materi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com