Note de l’auteur : cet article explique comment répartir les tâches selon leur difficulté entre MiniMax M3.1 Flash et Claude Opus 5.5, afin de réduire la facture sans sacrifier la qualité nécessaire.
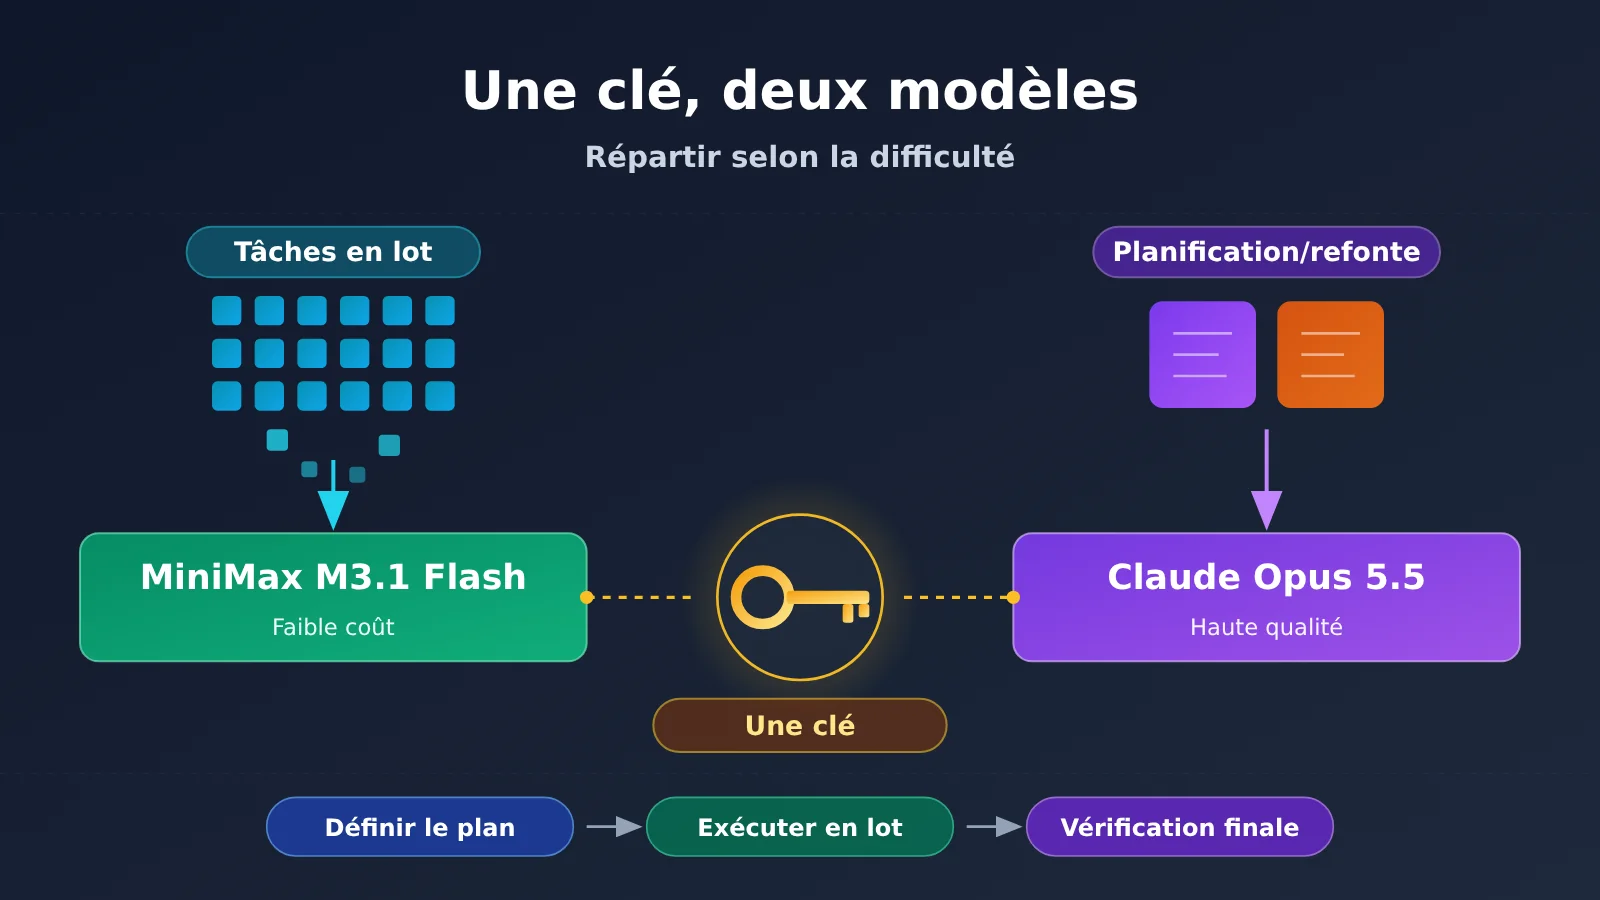
En bref : confiez les tâches volumineuses, répétitives et bien définies à MiniMax M3.1 Flash ; réservez les tâches complexes qui demandent de la planification, du discernement ou des changements importants à Claude Opus 5.5.
Quand on utilise un grand modèle de langage, on a souvent tendance à choisir le plus puissant et à tout lui confier. C’est pratique, mais dès qu’on lance des tâches en série, la facture grimpe vite — alors que la plupart ne nécessitent pas le modèle le plus puissant. Cet article présente une méthode de répartition fondée sur le principe « Opus 5.5 définit le plan, M3.1 Flash exécute les tâches en série, Opus 5.5 vérifie un échantillon et finalise ». Elle vous aide à utiliser chaque modèle là où il est le plus adapté, avec une seule clé API.
Il ne s’agit pas d’un nouvel article d’annonce. Le site a déjà publié un article consacré à la sortie de M3.1 Flash. Ici, nous nous concentrons sur la répartition des tâches, le calcul des coûts et les cas où il n’est pas nécessaire de répartir le travail.
Ce que vous allez y gagner : une grille de répartition que vous pourrez reprendre telle quelle, un processus en trois étapes assorti de critères de validation et une méthode pour changer de modèle dans une interface graphique en modifiant simplement son nom.
Points clés : associer M3.1 Flash à Opus 5.5
Commençons par définir deux termes qui reviendront souvent. Un token est l’unité utilisée pour facturer les modèles et mesurer la longueur des calculs. On peut le voir, à peu près, comme un « morceau de texte » : selon la conversion officielle, 750 mots anglais correspondent à environ 1 000 tokens. Un agent désigne un mode d’utilisation où le modèle peut appeler des outils de lui-même, étape par étape, pour mener une série d’actions à bien — par exemple, mettre automatiquement un tableau en ordre ou suivre une procédure dans un logiciel.
| Point clé | Explication | Avantage |
|---|---|---|
| Répartir le travail selon sa difficulté | Confier les tâches répétitives et à grande échelle à M3.1 Flash, et la planification ou la refactorisation à Opus 5.5 | Trouver le bon équilibre entre qualité et coût |
| Un gros écart de prix | Aux tarifs officiels, l’entrée d’Opus 5.5 coûte environ 26,7 fois plus cher que celle de Flash, et sa sortie environ 33,3 fois plus cher | Remplacer Flash par un autre modèle pour les tâches en série permet de réaliser les économies les plus importantes |
| Un flux de travail en trois étapes | Planifier → exécuter les tâches en série → vérifier un échantillon et finaliser, avec des critères de réussite à chaque étape | Maîtriser les retouches et éviter que les modifications ne deviennent incontrôlables |
| Un seul Key pour passer de l’un à l’autre | Avec une interface compatible avec OpenAI, il suffit de changer le nom du modèle | Inutile de gérer deux comptes et deux soldes |
La logique qui sous-tend la répartition entre M3.1 Flash et Opus 5.5
Cette répartition est pertinente parce que les deux modèles présentent des écarts marqués, tant en matière de prix que de capacités. Côté tarifs, d’après la page officielle de MiniMax, M3.1 Flash coûte 0,15 $ par million de tokens en entrée, 0,60 $ en sortie et 0,015 $ pour la lecture depuis le cache. Il n’y a pas de supplément pour les longs contextes. Claude Opus 5.5 coûte officiellement 4 $ en entrée et 20 $ en sortie. La lecture depuis le cache signifie que les préfixes identiques envoyés plusieurs fois sont facturés à un tarif réduit. Les longues invites communes à plusieurs tâches en série en tirent donc un avantage notable.
Côté capacités, M3.1 Flash se distingue dans l’automatisation bureautique, la compréhension visuelle et les tâches liées à la finance et à la fiscalité. En revanche, il est nettement moins performant que le modèle phare de Claude pour les tâches en ligne de commande comportant de nombreuses étapes et la refactorisation de code. Autrement dit, il sait bien « répéter une tâche en suivant les règles », mais il est moins à l’aise pour « déterminer par lui-même comment s’y prendre ». Opus 5.5 complète donc parfaitement ses points forts.
💡 Recommandation officielle : avant de mettre en place cette répartition, il est conseillé de tester quelques exemples concrets de vos tâches sur APIYI apiyi.com, avec le même Key pour les deux modèles. Vous pourrez ainsi comparer leurs résultats sur vos propres cas d’usage et définir la répartition qui vous convient.
Pourquoi M3.1 Flash et Opus 5.5 doivent se partager les tâches : commençons par vérifier l’origine des données
Avant de parler de répartition des tâches, il faut distinguer les différents niveaux de fiabilité des données. Les chiffres ci-dessous se répartissent en trois catégories : déclarés par le fabricant désigne les résultats publiés par MiniMax ; évaluations indépendantes renvoie aux tests menés par des organismes indépendants comme Vals AI ; inconnu / non publié regroupe les informations pour lesquelles aucune source fiable n’est disponible à ce jour. Un benchmark est un ensemble de tests standardisés qui permet de comparer les capacités de plusieurs modèles.
| Projet | Résultat | Catégorie |
|---|---|---|
| Automation-Bench v1.0.6 (automatisation bureautique) | Flash : 62,2 ; Opus 5 : 50,3 | Déclaré par le fabricant |
| BankerToolBench (tâches liées aux outils financiers) | 76,2, à égalité avec Opus 5 | Déclaré par le fabricant |
| BabyVision (vision, avec outils) | 91,0 | Déclaré par le fabricant |
| Terminal Bench 4.0 (tâches longues en ligne de commande) | 38,1 ; Opus 5 : 51,8 | Déclaré par le fabricant |
| SWE Refactor Bench (refactorisation de code) | 23,0 ; Opus 5 : 31,0 | Déclaré par le fabricant |
| Tax Agent Bench / Finance Agent v2.1 | 32,14 % / 58,83 %, tous deux en hausse par rapport à M3 | Évaluation indépendante (Vals) |
| Terminal-Bench 4.0 | 25,25 %, 22e sur 51 modèles | Évaluation indépendante (Vals) |
| Indice global de Vals | 53,78 %, 15e sur 22 modèles | Évaluation indépendante (Vals) |
| Comparaison détaillée avec Opus 5.5 | Non publié | Inconnu |
| Rapport technique détaillant les changements apportés à Flash | Non publié | Inconnu |
Un point mérite d’être précisé : dans son tableau comparatif, MiniMax prend Opus 5 comme référence, et non Opus 5.5. Opus 5.5 reste le modèle phare le plus puissant d’Anthropic, mais l’entreprise ne l’a pas comparé à Flash tâche par tâche. On ne peut donc pas affirmer que Flash a « rattrapé » ou « dépassé » Opus 5.5 ; les données du tableau montrent uniquement l’écart entre Flash et Opus 5.
Par ailleurs, même s’il s’agit dans les deux cas de Terminal-Bench 4.0, le résultat déclaré par MiniMax est de 38,1, tandis que Vals obtient 25,25 %. Les conditions de test diffèrent — Vals a utilisé l’API officielle avec le paramètre effort réglé sur max —, il n’est donc pas pertinent de soustraire directement ces résultats. Les deux séries de données mènent toutefois à la même conclusion : les tâches en ligne de commande qui impliquent de longues séquences et plusieurs étapes constituent un point faible marqué de Flash.
Tableau de répartition entre M3.1 Flash et Opus 5.5 : à qui confier chaque type de tâche ?
Le tableau ci-dessous peut servir directement de base pour répartir les tâches. La dernière colonne indique la disponibilité sur APIYI ; au moment de la rédaction, consultez la page des tarifs pour vérifier les informations à jour.
| Type de tâche | Modèle à privilégier | Pourquoi | Disponibilité sur APIYI |
|---|---|---|---|
| Automatisation bureautique : organiser des tableaux en lot, remplir des formulaires, suivre des procédures fixes | M3.1 Flash | Selon les chiffres publiés par le fournisseur, son score à Automation-Bench est de 62,2, contre 50,3 pour Opus 5 ; son score à OSWorld V2 est de 61,7 | Consultez la page des tarifs ; MiniMax-M3 est disponible pour le moment |
| Extraction et vérification en lot de documents financiers et fiscaux | M3.1 Flash | Selon les chiffres publiés par le fournisseur, son score à BankerToolBench est de 76,2, à égalité avec Opus 5 ; ses résultats dans les catégories finance et fiscalité de Vals sont en hausse par rapport à M3 | Même indication |
| Analyse et étiquetage en lot de captures d’écran, d’images et de vidéos | M3.1 Flash | Selon les chiffres publiés par le fournisseur, son score à BabyVision est de 91,0 ; la documentation officielle précise que les images et les vidéos sont prises en charge en entrée | Même indication |
| Génération en lot de petits scripts et d’ébauches de pages | M3.1 Flash | Son score à Vibe Code Bench de Vals atteint 73,94 %, contre 47,57 % pour M3, soit une nette progression | Même indication |
| Dépannage en plusieurs étapes et tâches longues en ligne de commande | Opus 5.5 | Selon les chiffres publiés par le fournisseur, son score à Terminal Bench est de 38,1, inférieur aux 51,8 d’Opus 5 ; ses résultats sont plutôt faibles aux tests comparables de Vals | claude-opus-5-5 |
| Refactorisation de grande ampleur sur plusieurs fichiers | Opus 5.5 | Selon les chiffres publiés par le fournisseur, son score à SWE Refactor Bench est de 23,0, contre 31,0 pour Opus 5 | claude-opus-5-5 |
| Décomposition des tâches, définition des critères et validation finale | Opus 5.5 | Ces tâches exigent du discernement et une vision d’ensemble ; Opus 5.5 est actuellement le modèle phare le plus performant d’Anthropic | claude-opus-5-5 |
Pour savoir à qui confier une tâche, posez-vous cette question : peut-on la formuler ainsi : « Suis ce modèle et répète l’opération N fois » ? Si oui, Flash est probablement le bon choix. Si la tâche ne se prête pas à un modèle et exige de prendre des décisions au fil de l’exécution, Opus 5.5 sera plus sûr. M3.1 Flash prend en charge une fenêtre de contexte de 1 million de tokens (la quantité maximale de contenu que le modèle peut « voir » en une seule fois). Le traitement par lots de longs documents ne pose donc pas de problème en soi : tout dépend de la nécessité ou non d’une planification approfondie.
M3.1 Flash + Opus 5.5 : le workflow recommandé en 3 étapes
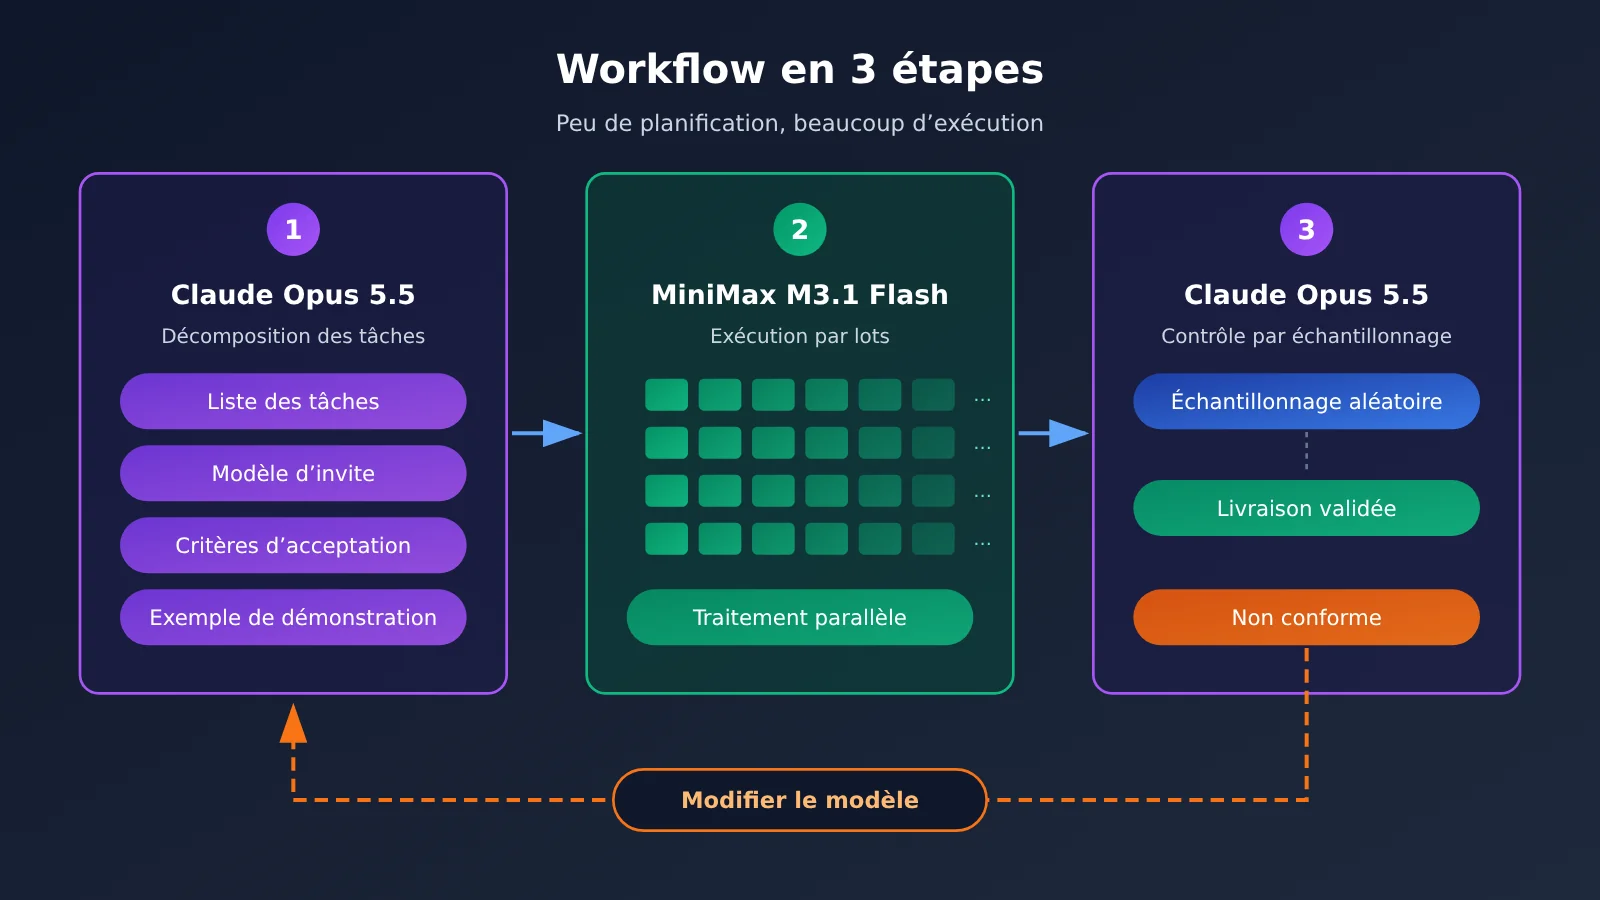
L’idée centrale de ce workflow est simple : réserver les modèles coûteux aux quelques tâches à forte valeur ajoutée, et confier les tâches répétitives en grand volume aux modèles moins chers. À chaque étape, précisez clairement ce qui constitue un résultat satisfaisant. Sinon, vous risquez de découvrir une fois le traitement terminé que vous êtes parti dans la mauvaise direction, et les coûts de reprise annuleront les économies réalisées.
| Étape | Qui s’en charge ? | Tâches | Critères de réussite |
|---|---|---|---|
| 1. Élaborer le plan et découper les tâches | Opus 5.5 | Comprendre l’objectif, le découper en sous-tâches pouvant être exécutées indépendamment, rédiger un modèle d’invite commun, définir le format de sortie et les critères d’acceptation, puis ajouter quelques exemples | Chaque sous-tâche peut être exécutée sans demander de précisions ; le format de sortie peut être vérifié directement à l’œil ou par un programme ; au moins 3 à 5 exemples conformes sont disponibles |
| 2. Traiter les éléments en série | M3.1 Flash | Traiter chaque élément à l’aide du modèle, avec un niveau de réflexion faible à moyen | Tous les éléments ont un résultat ; le taux de réussite aux vérifications de format atteint le seuil fixé à l’avance ; les éléments en échec sont répertoriés séparément |
| 3. Effectuer le contrôle et finaliser | Opus 5.5 | Vérifier un échantillon aléatoire de résultats ainsi que tous les éléments en échec, puis résumer les problèmes et finaliser la livraison | Si le taux d’erreur de l’échantillon est inférieur au seuil, livrer le résultat ; s’il est supérieur, revenir à l’étape 1 pour modifier le modèle, plutôt que de demander à Opus 5.5 de tout refaire élément par élément |
Étape 1 : confier une bonne fois pour toutes les tâches « difficiles » à Opus 5.5
C’est l’étape où l’investissement est le plus rentable. Fournissez à Opus 5.5 la demande d’origine et quelques exemples de données réelles, puis demandez-lui de produire trois éléments : une liste de sous-tâches, un modèle d’invite destiné à Flash et des critères d’acceptation. Plus le modèle est précis, plus les résultats de Flash seront réguliers. Précisez par exemple : « Produire uniquement du JSON, avec les champs A, B et C ; indiquer null si une donnée est manquante. »
Étape 2 : traiter les éléments en série avec M3.1 Flash, en ajustant le niveau de réflexion
M3.1 Flash propose plusieurs niveaux de réflexion (effort) : low, medium, high, xhigh et max. Si vous ne définissez pas de niveau, max est sélectionné par défaut. Plus le niveau est élevé, plus le modèle réfléchit, produit de tokens et prend de temps. Pour les traitements en série qui disposent déjà d’un modèle, commencez par tester un petit lot avec le niveau medium. Si la qualité est suffisante, gardez ce réglage ; sinon, augmentez-le. Selon le fournisseur, Flash peut atteindre au quotidien une vitesse de sortie de plus de 200 TPS (tokens par seconde), ce qui réduit considérablement la durée totale des traitements en série.
Étape 3 : demander à Opus 5.5 de contrôler un échantillon, pas de tout refaire
Le but du contrôle par échantillonnage est de déterminer si le modèle est fiable, et non de faire reprendre le travail par Flash. Si le contrôle révèle des erreurs récurrentes du même type, c’est que le modèle présente un défaut. Revenez alors à l’étape 1 pour demander à Opus 5.5 de le corriger, puis faites relancer par Flash les éléments concernés. Vous limitez ainsi l’utilisation du modèle coûteux à une petite partie du travail.
M3.1 Flash avec Opus 5.5 : faisons le calcul
Prenons un exemple hypothétique : traiter 200 documents en lot, extraire les informations de chacun et en générer un résumé. Tous les nombres de tokens ci-dessous sont des hypothèses destinées à illustrer le calcul, et non des données mesurées. Les tarifs sont les tarifs officiels : Opus 5.5 coûte 4 $ en entrée et 20 $ en sortie ; M3.1 Flash, 0,15 $ en entrée et 0,60 $ en sortie (par million de tokens). La méthode de calcul est conforme aux indications officielles de MiniMax : volume utilisé ÷ 1 000 000 × tarif, puis addition des différents postes.
Utilisation hypothétique :
– Planification : 50 000 tokens en entrée et 10 000 en sortie ;
– Traitement par lots : 200 documents × 8 000 tokens en entrée et 2 000 en sortie par document, soit 1 600 000 tokens en entrée et 400 000 en sortie ;
– Contrôle par échantillonnage : 20 documents × 10 000 tokens en entrée et 1 000 en sortie, soit 200 000 tokens en entrée et 20 000 en sortie (uniquement pour le scénario avec répartition des tâches).
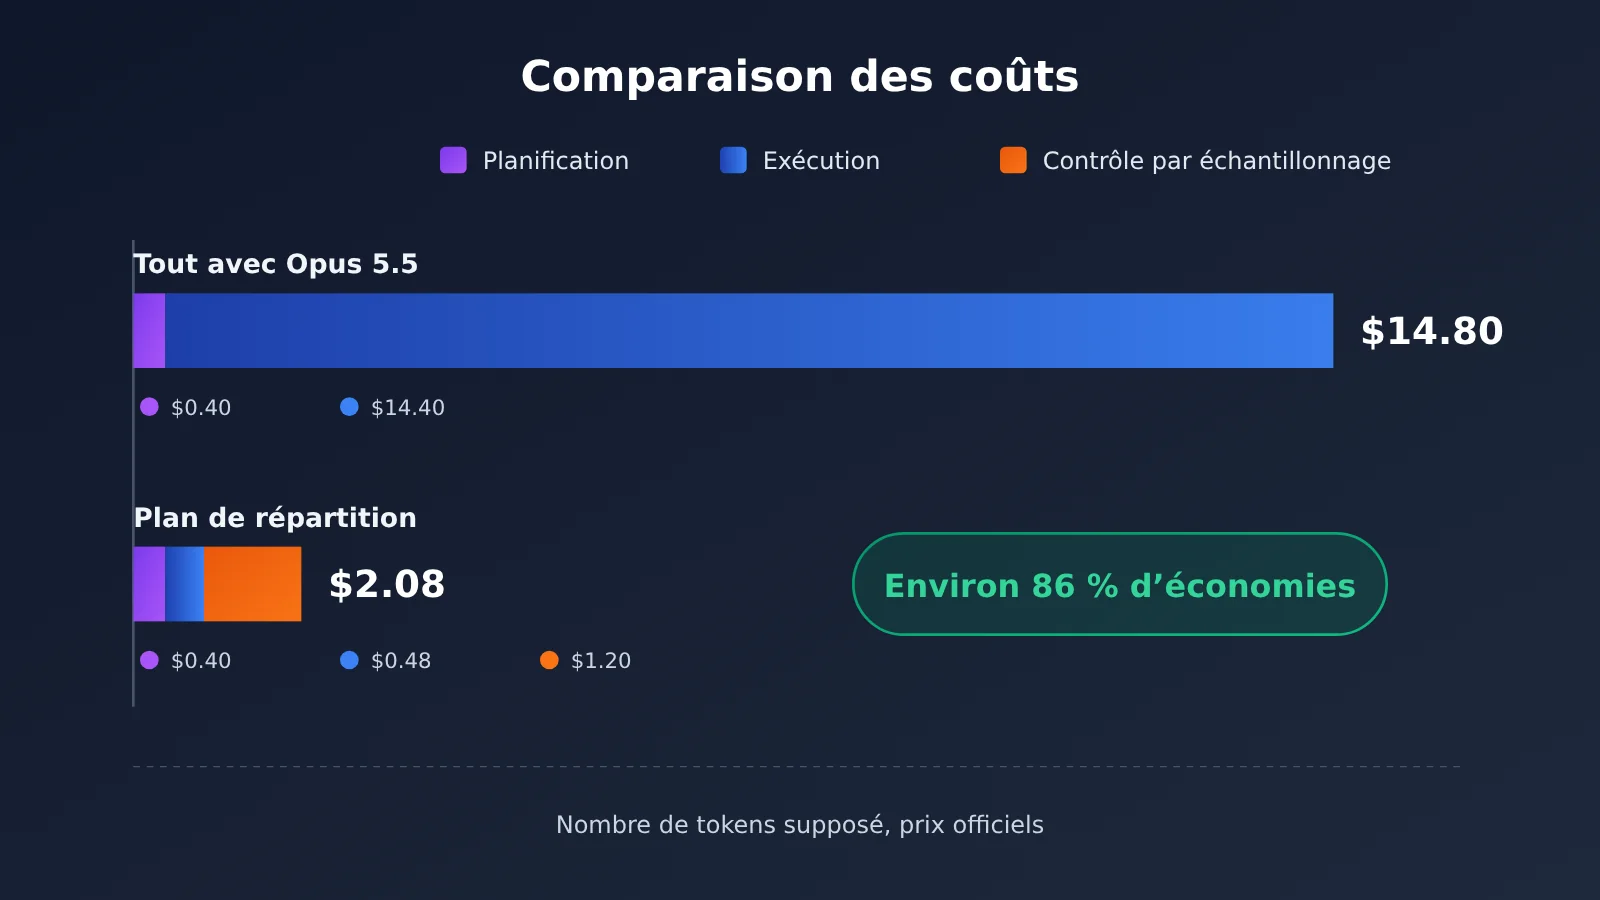
| Étape | Tout faire avec Opus 5.5 | Scénario avec répartition des tâches |
|---|---|---|
| Planification (Opus 5.5) | 0.05×4 + 0.01×20 = $0.40 | 0.05×4 + 0.01×20 = $0.40 |
| Traitement par lots | Opus : 1.6×4 + 0.4×20 = 6.40 + 8.00 = $14.40 | Flash : 1.6×0.15 + 0.4×0.60 = 0.24 + 0.24 = $0.48 |
| Contrôle par échantillonnage (Opus 5.5) | Aucun | 0.2×4 + 0.02×20 = 0.80 + 0.40 = $1.20 |
| Total | $14.80 | $2.08 |
Dans le tableau, « 0.05 » correspond à 50 000 ÷ 1 000 000 ; même principe pour les autres valeurs. Vérification : 14.80 − 2.08 = 12.72, et 12.72 ÷ 14.80 ≈ 0.86. Avec ces hypothèses, le scénario avec répartition des tâches permet donc d’économiser environ 86 % : son coût représente environ 14 % de celui du scénario entièrement exécuté avec Opus 5.5.
Trois points sont à prendre en compte. Premièrement, le mode de réflexion de M3.1 Flash ne peut pas être désactivé ; le nombre réel de tokens en sortie peut donc dépasser l’hypothèse. Même si le nombre de tokens en sortie double pendant l’exécution, pour atteindre 800 000, le coût de cette étape ne passe qu’à 0.24 + 0.48 = $0.72, soit un total de $2.32. La conclusion ne change pas. Deuxièmement, la réduction liée au cache n’est pas prise en compte : si un même modèle de prompt est utilisé, le coût réel pourrait être encore plus bas. Troisièmement, si le contrôle par échantillonnage révèle des problèmes et qu’il faut relancer le traitement, il faut aussi inclure le coût de ces reprises. C’est l’une des raisons pour lesquelles il est important de soigner le modèle de prompt dès la première étape.
Si vous remplacez provisoirement Flash par MiniMax-M3 pour l’exécution, le tarif officiel de MiniMax (0,30 $ / 1,20 $ lorsque l’entrée est ≤512K) donne un coût de 1.6×0.30 + 0.4×1.20 = 0.48 + 0.48 = $0.96 pour cette étape. Le total s’élève alors à 0.40 + 0.96 + 1.20 = $2.56, ce qui reste bien inférieur aux $14.80 du scénario entièrement exécuté avec Opus 5.5.
💰 Optimisation des coûts : les calculs ci-dessus utilisent les tarifs officiels. Pour connaître les tarifs réellement appliqués sur APIYI (apiyi.com), consultez la page des prix. Il est conseillé de commencer par un petit essai sur 20 à 50 données réelles, puis d’estimer le coût du traitement complet au prorata.
Comment passer de M3.1 Flash à Opus 5.5 avec une seule clé depuis une interface graphique
La répartition des tâches peut sembler complexe, mais en pratique, il suffit de « changer le nom du modèle ». Une interface compatible avec OpenAI utilise le format de requête d’OpenAI. La plupart des clients de chat et des applications open source la prennent aujourd’hui en charge. Si votre outil propose une option « fournisseur personnalisé » ou « compatible avec OpenAI », suivez les étapes ci-dessous.
Configuration dans un client de chat
- Ouvrez les paramètres du client, repérez la section « Fournisseur de modèles » ou « Paramètres API », puis ajoutez un fournisseur de type OpenAI compatible ;
- Dans le champ de l’adresse de l’interface (Base URL), saisissez l’adresse indiquée dans la console APIYI, généralement
https://api.apiyi.com/v1; - Dans le champ API Key, saisissez la clé créée dans votre espace APIYI ;
- Ajoutez manuellement les noms de modèles suivants à la liste :
claude-opus-5-5etMiniMax-M3. SiMiniMax-M3.1-Flashapparaît déjà sur la page des tarifs, ajoutez-le également ; - Lors d’une nouvelle conversation, sélectionnez le modèle voulu dans le menu déroulant. Utilisez Opus 5.5 pour la planification et les contrôles ponctuels, et MiniMax pour le traitement par lots.
Configuration dans votre propre application
Si vous utilisez une plateforme d’agent open source, un outil d’automatisation ou une application que vous avez créée, la page des paramètres comporte généralement trois champs : « Adresse de l’interface », « API Key » et « Nom du modèle ». Il suffit de renseigner les deux premiers une seule fois ; pour répartir les tâches, vous n’avez qu’à modifier le champ « Nom du modèle ». De nombreux outils permettent de choisir un modèle différent pour chaque nœud. Vous pouvez ainsi définir claude-opus-5-5 pour les nœuds « Planification » et « Contrôle ponctuel », et un modèle de la gamme MiniMax pour le nœud « Traitement par lots ».
Deux pièges à éviter avec le mode réflexion de M3.1 Flash
- Ne désactivez pas la réflexion : selon la documentation officielle de MiniMax, la réflexion de M3.1 Flash ne peut pas être désactivée. Lui transmettre une instruction de désactivation entraîne une erreur 400 :
model "MiniMax-M3.1-Flash" requires adaptive thinking. Si votre client propose une option « Désactiver la réflexion », laissez-la activée avec Flash. Pour réduire le temps de réponse et la consommation de tokens, diminuez plutôt l’intensité du raisonnement ; - Le contenu de la réflexion est affiché séparément : avec le protocole compatible avec OpenAI, le raisonnement se trouve dans un champ distinct,
reasoning_content, tandis que le corps de la réponse ne contient que la réponse finale. Si votre outil récupérait auparavant le raisonnement à partir des balisesthinkde M3, vous devrez l’adapter pour utiliser Flash.
🚀 Pour commencer rapidement : créez une clé sur APIYI, sur apiyi.com, puis configurez
claude-opus-5-5etMiniMax-M3dans votre client. Posez la même question aux deux modèles à partir des mêmes documents : en quelques minutes, vous pourrez comparer directement leurs réponses et leur vitesse.
À noter : MiniMax propose aussi sa propre application de bureau, MiniMax Code. Il suffit de se connecter avec un compte abonné à M Plan pour utiliser M3.1 Flash. C’est la solution officielle de MiniMax, mais une clé d’abonnement M Plan et une clé API facturée à l’usage sont deux types de clés différents. La répartition des tâches entre plusieurs modèles présentée dans cet article ne dépend pas de MiniMax Code.
Quand il n’est pas nécessaire de répartir le travail entre M3.1 Flash et Opus 5.5
Répartir le travail a ses avantages, mais aussi un coût de gestion : il faut rédiger des modèles, effectuer des contrôles par échantillonnage et changer de modèle. Dans les cas suivants, utiliser un seul modèle est plus simple.
- Le volume est faible : vous ne traitez qu’une dizaine de documents. Le coût total d’Opus 5.5 reste modeste, et le temps passé à rédiger des modèles risque de coûter plus cher ;
- Le processus est court : une simple question suivie d’une réponse suffit. Il n’y a pas de phase de « planification » à isoler, donc inutile de procéder en deux étapes ;
- Le niveau de qualité attendu est modeste : pour des brouillons internes ou des notes personnelles, utilisez directement toute la gamme MiniMax, sans demander à Opus 5.5 d’effectuer des contrôles par échantillonnage ;
- Chaque cas est complexe : si chaque élément demande une analyse approfondie, par exemple pour diagnostiquer des pannes complexes une par une, il n’y a pas de partie répétitive à confier à Flash. Utilisez Opus 5.5 pour l’ensemble du travail ;
- Aucune erreur n’est acceptable : pour des conclusions qui engagent votre responsabilité, notamment dans les domaines juridique ou financier, un contrôle par échantillonnage signifie que certains éléments ne seront pas vérifiés. Dans ces cas, utilisez un modèle puissant pour traiter l’ensemble des éléments et prévoyez une vérification humaine ;
- Les besoins ne sont pas encore bien définis : tant que vous ne savez pas précisément ce que vous voulez, commencez par mener le processus à bien avec Opus 5.5. Une fois qu’il est stabilisé, vous pourrez envisager de confier les tâches répétitives à Flash.
Utiliser une seule clé API APIYI pour appeler les modèles MiniMax et Claude Opus 5.5
Le principal écueil d’une répartition des tâches entre modèles, c’est de devoir gérer deux comptes différents : deux soldes à recharger, deux clés API et deux URL d’API. Avec autant de paramètres, les erreurs sont vite arrivées. APIYI permet d’utiliser une seule clé pour appeler aussi bien Claude, GPT et Gemini que des modèles chinois comme DeepSeek et MiniMax. Pour passer de l’un à l’autre, il suffit de changer le nom du modèle.
Au 22 octobre 2026, les modèles concernés disponibles sur APIYI incluent claude-opus-5-5, claude-opus-5, ainsi que les modèles de la série MiniMax : MiniMax-M3 (compatible avec les formats d’API OpenAI et Anthropic), MiniMax-M2.7, MiniMax-M2.5, entre autres. MiniMax-M3.1-Flash n’apparaît pas encore sur la page des tarifs ; sa mise en ligne est prévue prochainement. Pour savoir s’il est disponible, consultez la page des tarifs d’APIYI. En attendant, vous pouvez confier les tâches d’exécution en lot à MiniMax-M3. Le flux de travail et la configuration restent identiques : il suffira ensuite de remplacer le nom du modèle.
La répartition recommandée est simple : confiez les tâches courantes en lot, moins coûteuses, à MiniMax ; gardez Opus 5.5 pour la planification complexe, la refactorisation et la validation finale. Pour créer un compte et obtenir une clé API, rendez-vous sur le site d’APIYI : api.apiyi.com.
FAQ : questions fréquentes
Q1 : Que signifie répartir les tâches entre M3.1 Flash et Opus 5.5 ?
Il s’agit de choisir le modèle en fonction de la difficulté de la tâche : Opus 5.5 se charge de décomposer les tâches, de définir les critères et de contrôler un échantillon des résultats ; M3.1 Flash exécute les tâches en série en suivant un modèle. L’objectif est de réserver le modèle le plus coûteux à quelques étapes clés, tout en maintenant une qualité suffisante.
Q2 : M3.1 Flash a-t-il déjà dépassé Claude Opus 5.5 ?
On ne peut pas l’affirmer. Le tableau comparatif officiel de MiniMax porte sur Claude Opus 5 : Flash le devance en automatisation bureautique, mais est moins performant sur les longues chaînes d’opérations en ligne de commande et la refactorisation de code. Opus 5.5 reste le modèle phare le plus puissant d’Anthropic, et l’entreprise ne l’a pas comparé point par point à Flash.
Q3 : Peut-on déjà utiliser M3.1 Flash via APIYI ?
À la date de publication, MiniMax-M3.1-Flash ne figure pas encore sur la page des tarifs d’APIYI. Consultez cette page pour savoir s’il est disponible. En attendant, vous pouvez utiliser MiniMax-M3 pour les tâches en série. `claude-opus-5-5` est directement disponible ; une même clé vous permet d’utiliser les deux modèles sur APIYI, via apiyi.com.
Q4 : Peut-on désactiver le raisonnement de M3.1 Flash ? Comment économiser des jetons ?
Non. La documentation officielle indique que désactiver le raisonnement entraîne une erreur 400. Pour réduire le temps de traitement et la consommation de jetons, vous pouvez uniquement diminuer la profondeur de raisonnement, réglée par défaut sur max. Pour les tâches en série, commencez par essayer medium, puis augmentez le niveau si la qualité n’est pas suffisante.
Q5 : Quelle proportion de résultats faut-il contrôler ?
Il n’existe pas de règle universelle. Vous pouvez commencer par contrôler environ 10 % des résultats, ainsi que tous ceux qui ne respectent pas le format demandé. Si plusieurs contrôles successifs ne révèlent aucun problème, réduisez progressivement cette proportion. Si les erreurs se concentrent dans une catégorie, modifiez d’abord le modèle de tâche plutôt que d’augmenter le volume des contrôles.
Q6 : Quelles sont les limites connues de M3.1 Flash ?
Dans le classement général de Vals, un classement réalisé par un tiers, il arrive en 15e position sur 22 modèles et se montre moins performant sur les tâches d’agent impliquant de longues chaînes d’opérations. MiniMax n’a pas encore publié de rapport technique. Le coût annoncé comme étant égal au tiers de celui de M3 est calculé par tâche, mais la méthode de calcul n’a pas été rendue publique. Les chiffres de vitesse ne sont pas tout à fait cohérents non plus : l’article de lancement indique plus de 200 TPS, tandis que la page produit mentionne environ 150 tokens par seconde.
Q7 : Peut-on utiliser cette répartition sans écrire de code ?
Oui. Dans un client de chat ou un outil d’automatisation compatible avec l’interface OpenAI, renseignez l’adresse de l’API et la clé API d’APIYI, ajoutez les noms des modèles Opus 5.5 et MiniMax, puis passez de l’un à l’autre selon les étapes. Tout se fait depuis une interface graphique.
M3.1 Flash avec Opus 5.5 : points clés
- Principe de répartition : confiez à Flash les tâches répétitives qu’on peut automatiser avec un modèle, et à Opus 5.5 celles qui demandent du jugement ou des changements importants.
- Écart de prix : selon les tarifs officiels, l’entrée d’Opus 5.5 coûte environ 26,7 fois plus cher que celle de Flash, et sa sortie environ 33,3 fois plus cher.
- Points forts de Flash : selon les résultats publiés par le fournisseur, Flash se démarque dans l’automatisation bureautique, les outils financiers et les tâches visuelles.
- Limites de Flash : il est moins performant qu’Opus 5 pour les longues chaînes d’opérations en ligne de commande et la refactorisation de code. Les évaluations indépendantes sont également plutôt défavorables.
- Base de comparaison : la comparaison officielle porte sur Opus 5, et non sur Opus 5.5. On ne peut donc pas affirmer que Flash a déjà rattrapé le modèle phare.
- Exemple de coût : dans le scénario proposé, la répartition des tâches revient à environ 2,08 $, contre 14,80 $ en utilisant uniquement Opus 5.5.
- Comment basculer : gardez la même clé API et changez uniquement le nom du modèle. Vérifiez sur la page des tarifs d’APIYI si Flash est disponible.
Conclusion
Les points essentiels à retenir sur l’association de MiniMax M3.1 Flash et de Claude Opus 5.5 :
- Répartissez les tâches selon leur difficulté : confiez à M3.1 Flash les tâches répétitives, en lot et bien définies, et à Opus 5.5 la planification, la refactorisation et la validation.
- Suivez un processus en trois étapes : Opus 5.5 élabore le plan et décompose les tâches → Flash les exécute en lot → Opus 5.5 vérifie un échantillon et finalise. Définissez un critère d’achèvement pour chaque étape.
- Faites les calculs avant de vous lancer : testez les coûts sur un petit échantillon de données réelles, en tenant aussi compte du coût des retouches.
- Sachez quand éviter de répartir les tâches : si le volume est faible, le processus court, les exigences de qualité modérées ou chaque tâche très complexe, utiliser un seul modèle sera plus simple.
L’intérêt de cette répartition n’est pas simplement de « passer à un modèle moins cher », mais de confier à chaque modèle les tâches qu’il maîtrise le mieux. Commencez par une petite tâche répétitive et faites tourner le processus en trois étapes sur APIYI apiyi.com avec la même clé API. Une fois la qualité confirmée, vous pourrez augmenter le volume.
📚 Références
- Article officiel de MiniMax : scores, vitesse et tarifs de M3.1 Flash
- Lien :
minimax.io/blog/minimax-m31f -
Remarque : principale source des données publiées par MiniMax
-
Documentation de MiniMax sur l’invocation des modèles : nom du modèle, fenêtre de contexte, niveau de raisonnement et format de l’interface
- Lien :
platform.minimax.io/docs/guides/text-generation -
Remarque : détails sur les paramètres, notamment l’impossibilité de désactiver le raisonnement et
reasoning_effort -
Page officielle des tarifs de MiniMax : règles de facturation de M3.1 Flash et de M3
- Lien :
platform.minimax.io/docs/guides/pricing -
Remarque : tarifs unitaires et méthode de calcul utilisés pour vérifier les coûts dans cet article
-
Page d’évaluation des modèles de Vals AI : résultats de l’évaluation indépendante de M3.1 Flash
- Lien :
vals.ai/models/minimax_MiniMax-M3.1-flash -
Remarque : données de l’évaluation indépendante et conditions des tests
-
Article de MarkTechPost : tableau comparatif officiel et données détaillées face à Opus 5
- Lien :
marktechpost.com/2026/10/19/minimax-m3-1-flash-release - Remarque : synthèse des chiffres de comparaison avec Opus 5 figurant dans le tableau officiel
Auteur : équipe technique d’APIYI
Échanges techniques : pour nous contacter, rendez-vous sur le site officiel d’APIYI, à l’adresse api.apiyi.com. Vous trouverez d’autres ressources d’intégration dans le centre de documentation : docs.apiyi.com