Résumé : DeepSeek ouvre aux développeurs les capacités de recherche, d’analyse de fichiers, de lecture de liens et de voix de son application, et fait exécuter les workflows d’outils essentiels par le serveur de l’API.
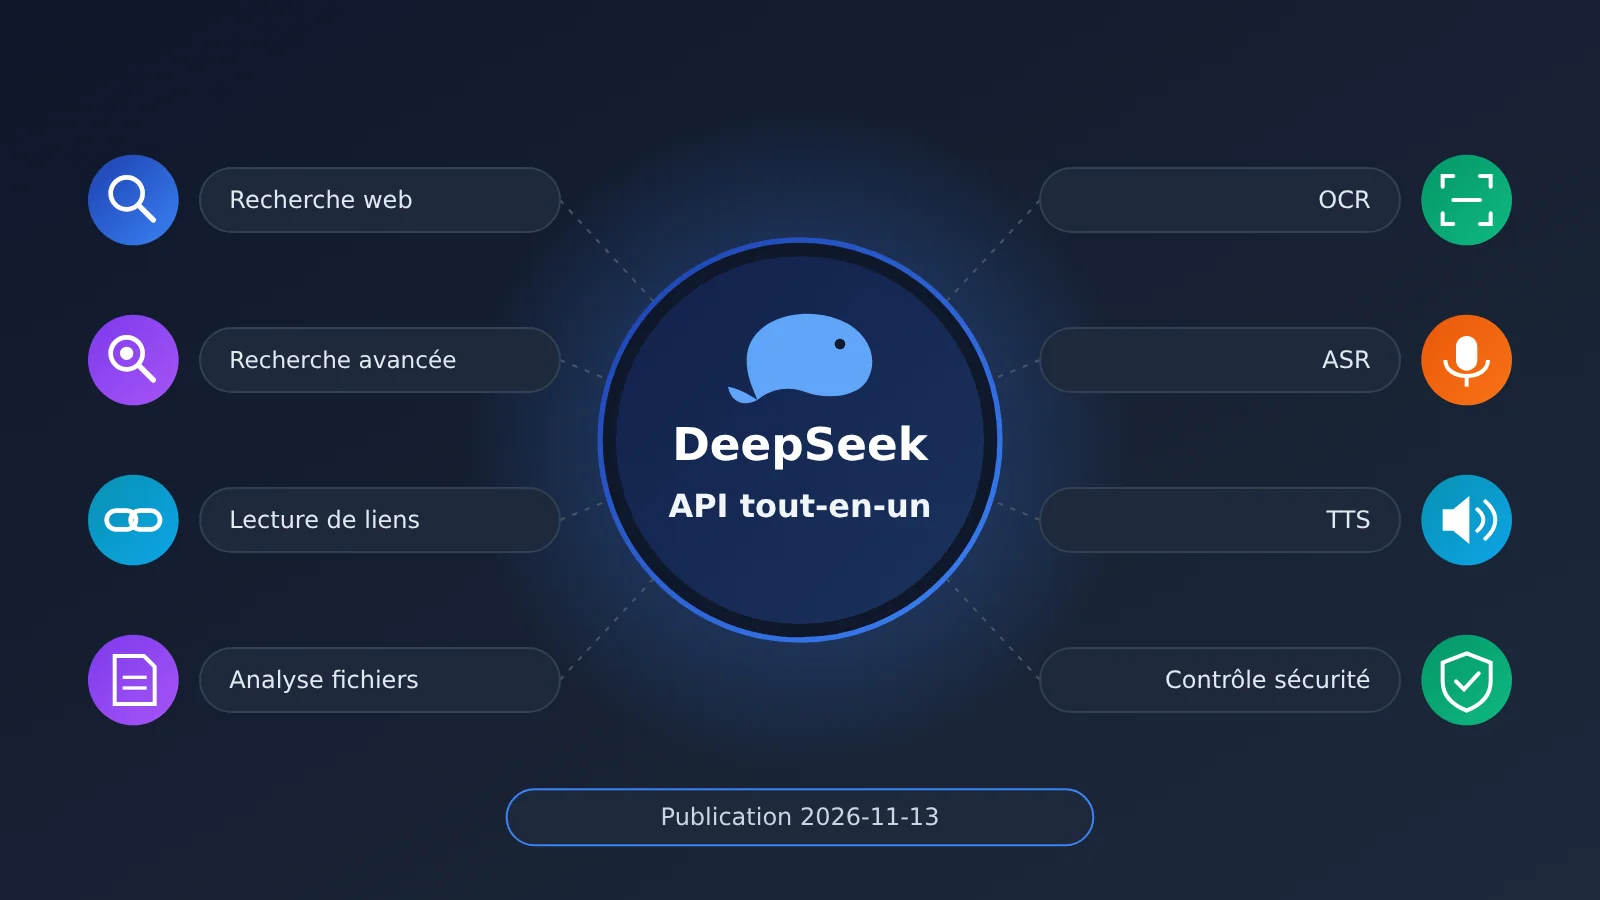
Le 13 novembre 2026, DeepSeek a officiellement lancé l’API de la suite complète d’applications. La recherche web, la recherche avec réflexion approfondie, la lecture de liens, l’entrée de fichiers, la validation de sécurité du modèle, ainsi que les interfaces autonomes Search, Fetch, OCR, ASR et TTS, qui étaient auparavant intégrées à l’application DeepSeek et à sa version web, sont désormais accessibles via l’API. Le changement central de cette mise à jour : après que le développeur a déclaré dans la requête des outils comme deepseek_web_search et deepseek_read_url, la recherche, la lecture de pages web et l’assemblage du contexte sont assurés par le serveur DeepSeek ; le client n’a plus besoin d’orchestrer lui-même la chaîne d’appels « modèle → recherche → récupération → renvoi → nouvelle requête ». DeepSeek indique que cette API permet d’obtenir des fonctionnalités quasiment identiques à celles de l’application DeepSeek.
Dans la suite, nous verrons d’abord quelles capacités sont ouvertes et quels modèles et protocoles peuvent les utiliser ; puis nous détaillerons, point par point, les workflows techniques et les limites de la recherche web, de la recherche approfondie, des fichiers et liens, de la voix et de l’OCR ; nous comparerons ensuite les anciennes et les nouvelles façons de développer, en précisant ce qui reste à la charge du frontend ; enfin, à partir de trois types de produits — questions-réponses sur l’actualité, lecture de rapports financiers et assistants vocaux — nous donnerons des pistes de choix entre la route d’intégration via les outils intégrés et celle via les outils autonomes.
À savoir : terminologie liée aux API de la suite DeepSeek
| Terme | Explication |
|---|---|
| API | Interface permettant à des logiciels d’échanger requêtes et résultats selon un format convenu |
| Harness | Framework d’exécution qui gère le déroulement de l’Agent, les modèles, les outils et le contexte |
| Server-side Tool | Outil exécuté côté serveur du modèle ; le client ne reçoit que le résultat de l’exécution |
| Deep Thinking Search | Pendant son raisonnement, le modèle effectue plusieurs recherches, ouvre des pages web et va chercher des informations |
| Chat Completions | Interface de complétion de dialogue classique, de style OpenAI |
| Responses API | Interface prenant en charge les réponses structurées, l’appel d’outils et les interactions multi-tours |
| Messages API | Interface de messages de style Anthropic |
| Files API | Interface qui permet de téléverser et d’analyser des fichiers, puis de renvoyer un file_id à référencer dans la conversation |
| OCR | Reconnaissance du texte présent dans une image ou un document, converti en texte exploitable |
| ASR | Conversion de la parole en texte |
| TTS | Conversion du texte en parole |
| Citation | Mécanisme de citation qui relie le contenu d’une réponse à une source d’information précise |
| tool_choice | Paramètre de requête qui contrôle la manière dont le modèle appelle les outils |
1 L’API DeepSeek Family Bucket ouvre les capacités cœur de l’App aux développeurs
1.1 Qu’a publié l’API DeepSeek Family Bucket le 13 novembre
Les capacités dévoilées lors de cette publication se divisent en deux catégories : d’une part les outils côté serveur intégrés à la conversation, que le modèle invoque de manière autonome lorsqu’il répond ; d’autre part les interfaces d’outils indépendantes, que les développeurs peuvent appeler séparément et combiner librement.
| Capacité | Nom anglais | Forme d’appel | Fonction |
|---|---|---|---|
| Recherche web | Web Search | Outil intégré à la conversation | Le modèle décide lui-même s’il doit chercher et renvoie une réponse avec citations |
| Recherche en réflexion profonde | Deep Thinking Search | Outil intégré à la conversation | Recherche multi-étapes, ouverture de pages web, recherche dans la page |
| Lecture de lien | Read URL | Outil intégré à la conversation | Lit le lien web contenu dans le message de l’utilisateur |
| Entrée de fichier | File Input | Files API + conversation | PDF, Office et images analysés puis injectés dans le contexte |
| Sécurité du modèle | Safety Check | Paramètre de requête | Contrôle l’entrée, les résultats d’outils et la sortie |
| Recherche web | Search API | Interface indépendante | Renvoie des résultats de recherche structurés |
| Récupération web | Fetch API | Interface indépendante | Extrait le corps de la page web |
| OCR | Optical Character Recognition | Interface indépendante | Reconnaît le texte des images et documents ainsi que leur position sur la page |
| ASR | Automatic Speech Recognition | Interface indépendante | Convertit l’audio en texte |
| TTS | Text-to-Speech | Interface indépendante | Convertit le texte en voix, avec prise en charge du streaming via WebSocket |
Cette mise à jour se concentre sur la couche des capacités applicatives du modèle. Au-delà des capacités de raisonnement du modèle lui-même, les composants dont dépend l’expérience au niveau de l’App — recherche, documents, voix, contrôle des risques, etc. — sont ouverts dans leur ensemble. Les développeurs obtiennent ainsi un ensemble d’infrastructures qu’ils peuvent assembler directement pour construire leurs produits.
Le même jour, DeepSeek a également open-sourcé un Chat Demo front-end léger, servant d’implémentation de référence pour reproduire l’expérience de l’App. En guise de contexte, DeepSeek avait open-sourcé le 13 août le framework d’exécution d’agents DeepSeek Harness, qui relève, avec l’API Family Bucket, de deux couches distinctes — la couche framework et la couche interface — formant deux lignes de produits indépendantes mais liées.
1.2 Quels modèles et protocoles l’API DeepSeek Family Bucket prend-elle en charge
L’intégration complète des outils au niveau de la conversation est actuellement portée par deepseek-flash, correspondant à la version officielle DeepSeek-V4.1-Flash-1017. Ce modèle prend en charge les modes réflexion et non-réflexion, la recherche web, la recherche en réflexion profonde, la lecture de liens, l’analyse de fichiers, la compréhension d’images et la validation de sécurité, avec une fenêtre de contexte de 1M et une sortie maximale de 384K. L’intégration d’outils annoncée cible explicitement deepseek-flash ; pour d’autres modèles comme DeepSeek-V4-Pro, l’étendue du support des outils reste à préciser selon les explications ultérieures officielles.
| Protocole | Adresse de requête | Caractéristiques |
|---|---|---|
| OpenAI Chat Completions | POST api.deepseek.com/chat/completions |
Complétion de conversation classique, coût de migration le plus faible |
| OpenAI Responses | POST api.deepseek.com/responses |
Réponses structurées et interactions multi-tours avec outils |
| Anthropic Messages | POST api.deepseek.com/anthropic/v1/messages |
Format de message de style Anthropic |
Les trois protocoles permettent tous d’utiliser la recherche côté serveur, la lecture de liens et les capacités de fichiers, mais les paramètres de requête et la structure des réponses diffèrent. Les équipes disposant déjà de code avec le SDK OpenAI privilégieront Chat Completions ou Responses, tandis que les projets bâtis sur l’écosystème Claude pourront choisir le protocole Messages.
2 Comment l’API de la suite complète DeepSeek prend en charge des tâches auparavant dispersées
2.1 Recherche web DeepSeek : c’est le modèle qui décide quand chercher
Une fois deepseek_web_search déclaré dans les tools de la requête, le modèle évalue la question et décide s’il doit aller sur Internet. Il génère lui-même les termes de recherche, le serveur exécute la recherche, puis le modèle organise les informations et ajoute les citations des sources. Cet outil prend en charge la recherche de pages web et la recherche d’images.
Prenons l’exemple d’une requête d’actualité tech du type « quelles nouvelles fonctionnalités API DeepSeek a-t-il récemment publiées » : la réponse contient les termes de recherche utilisés, des résultats structurés, les URL des sources, les titres, les dates de publication et les informations de citation. Le corps de requête Chat Completions donné dans la documentation officielle ressemble à ceci ; il active en même temps le mode réflexion, la recherche web et la lecture de liens :
{
  "model": "deepseek-flash",
  "thinking": { "type": "enabled" },
  "tools": [
    { "type": "deepseek_web_search" },
    { "type": "deepseek_read_url" }
  ],
  "messages": [
    { "role": "user", "content": "调查DeepSeek最近发布了哪些API新功能" }
  ],
  "stream": true
}
Les règles de contrôle de l’appel d’outils méritent une attention particulière :
- Une fois l’outil déclaré dans
tools, c’est le modèle qui décide de l’appeler ou non. tool_choicene permet pas de forcer l’utilisation dedeepseek_web_searchou dedeepseek_read_url.tool_choice: nonedésactive tous les outils.- La combinaison des outils web avec d’autres outils côté serveur est soumise à des limites de prise en charge ; en dehors du périmètre autorisé, la requête renvoie une erreur 400.
2.2 DeepSeek Recherche approfondie : d’une simple requête à une recherche multi-étapes
Une fois le mode réflexion activé, la recherche web se transforme en recherche à réflexion approfondie. Pendant son raisonnement, le modèle alterne trois actions : search pour rechercher des mots-clés, open_page pour ouvrir les pages web trouvées, et find_in_page pour localiser une information précise à l’intérieur d’une page.
Le résultat de chaque étape influence la décision suivante. Le modèle peut ajouter de nouveaux mots-clés à partir des résultats du premier tour, ouvrir des annonces officielles pour vérifier les détails, puis recouper plusieurs sources, et enfin fournir une réponse sourcée après une vingtaine d’appels d’outils maximum. Pour les questions de type recherche, c’est un peu comme intégrer un petit agent de recherche directement dans l’API.
2.3 DeepSeek fichiers et liens : laisser le modèle lire directement des ressources externes
deepseek_read_url sert spécifiquement à lire les adresses fournies par l’utilisateur, selon les règles suivantes :
- Seules les URL du dernier message utilisateur sont reconnues, avec au maximum les 10 premières URL différentes prises en compte ; une URL répétée ne compte qu’une fois.
- C’est le modèle qui décide quelles URL sont réellement lues.
- Lorsqu’on lit plusieurs longues pages web dans le même tour, le contexte disponible pour chaque page diminue.
- Si la réflexion est activée et que
deepseek_web_searchest déclaré en même temps, ce tour utilise le mécanisme de recherche à réflexion approfondie.
La capacité fichier passe par l’API Files : on appelle POST /files pour téléverser un fichier, le serveur renvoie un file_id une fois l’analyse terminée, et il suffit de référencer cet ID dans la conversation. Lors du téléversement, il faut préciser l’objectif de l’analyse ; la différence entre les deux modes tient à la capacité du modèle à voir ou non les graphiques :
- text_recognition : seul le texte brut est conservé, adapté aux contrats, articles scientifiques et autres documents textuels ; le contenu des graphiques est abandonné.
- rich_layout_recognition : le texte est conservé, et les images et graphiques sont automatiquement découpés puis transmis au modèle à leur position d’origine ; adapté aux rapports financiers, PPT et rapports mêlant texte et images, avec une consommation supplémentaire de Tokens d’image.
Les formats pris en charge incluent PDF, DOC/DOCX, PPT/PPTX, ainsi que les images PNG, JPEG, WebP, GIF, BMP, TIFF, etc. La taille maximale d’un fichier est de 100 MiB et de 1000 pages ; le téléversement et l’analyse doivent chacun se terminer en 120 secondes ; une requête peut référencer au maximum 20 fichiers. Les fichiers XLSX, CSV, EPUB, etc. peuvent être téléversés comme user_data ; le système les convertit en Markdown, sans frais d’analyse.
Une fois les résultats d’analyse intégrés au contexte du modèle, celui-ci peut répondre, résumer ou comparer à partir du texte intégral ; le contenu des fichiers historiques est conservé tout au long des conversations multi-tours. Référencer à nouveau un fichier déjà analysé n’entraîne plus de frais d’analyse, mais est facturé selon les Tokens d’entrée réellement injectés dans le contexte. Côté technique, deux détails : lors d’un téléversement Multipart, le champ purpose doit précéder le champ file ; si un document trop long dépasse le contexte, la requête renvoie une erreur 400.
2.4 DeepSeek voix et OCR : compléter les capacités d’entrée et de sortie des applications
OCR, ASR et TTS sont des interfaces indépendantes, avec respectivement les chemins /v1/tools/ocr, /v1/tools/asr et /v1/tools/tts.
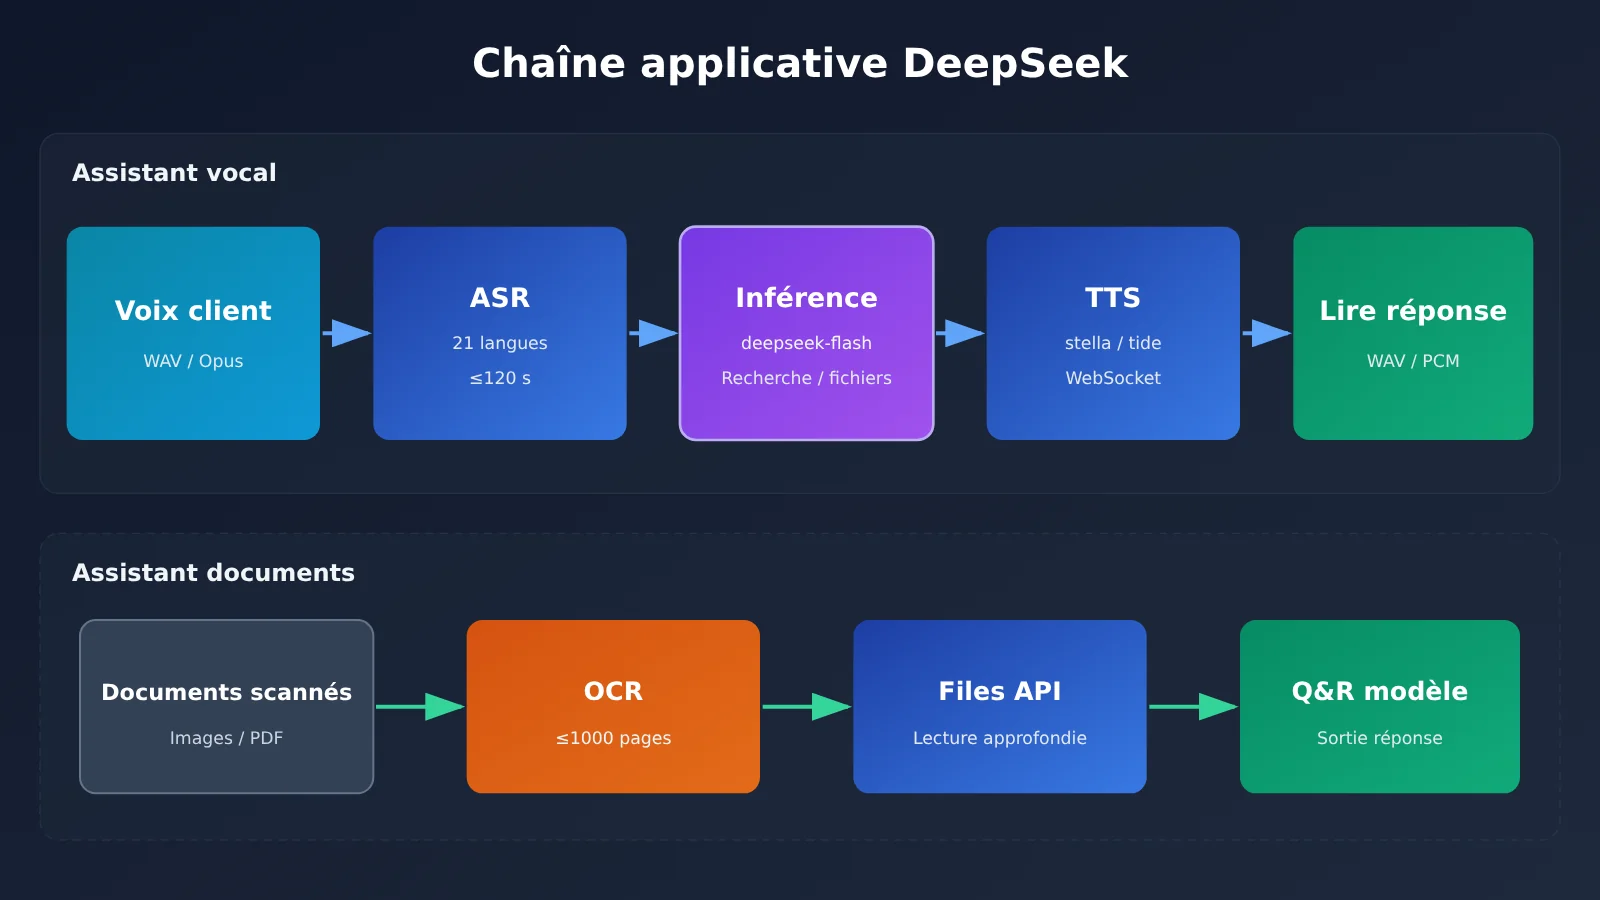
- OCR : reconnaît le texte et la position des pages dans les images, PDF, Word et PowerPoint. Un fichier de 100 MiB, jusqu’à 1000 pages, avec un délai de traitement de 180 secondes. Son rôle diffère de celui de l’analyse de fichiers : l’OCR extrait le texte de manière autonome, tandis que l’analyse de fichiers insère le contenu dans le contexte du modèle.
- ASR : prend en charge 21 langues, dont le chinois, le cantonais, l’anglais et le japonais, avec détection automatique de la langue. Le format d’entrée est WAV PCM 16 bits ou Ogg Opus. Fichier unique de 8 MiB maximum, 120 secondes maximum, avec une reconnaissance non streaming par envoi du fichier complet.
- TTS : propose deux timbres : stella (Étoile de mer, voix féminine, par défaut) et tide (Marée sombre, voix masculine). Prend en charge 10 langues, dont le mandarin, le cantonais et l’anglais. Jusqu’à 10 000 caractères facturables en entrée par requête, et jusqu’à 30 minutes d’audio en sortie. Les formats de sortie sont WAV et PCM. La synthèse en streaming via WebSocket est prise en charge ; le réglage de la vitesse de parole n’est pas encore disponible.
En chaînant ces trois briques à un modèle de dialogue, on obtient une chaîne complète d’assistant vocal : l’ASR transcrit la voix de l’utilisateur en texte, deepseek-flash répond en s’appuyant sur la recherche ou le raisonnement sur fichiers, puis le TTS lit la réponse à voix haute. Pour l’assistant documentaire, on peut d’abord utiliser l’OCR pour extraire en lot le texte des scans et créer un index, puis recourir à Files API pour permettre au modèle de lire en profondeur un fichier donné.
3 La suite complète d’API DeepSeek transforme la façon dont les développeurs s’intègrent
3.1 Comment on développait un assistant IA connecté à Internet autrefois
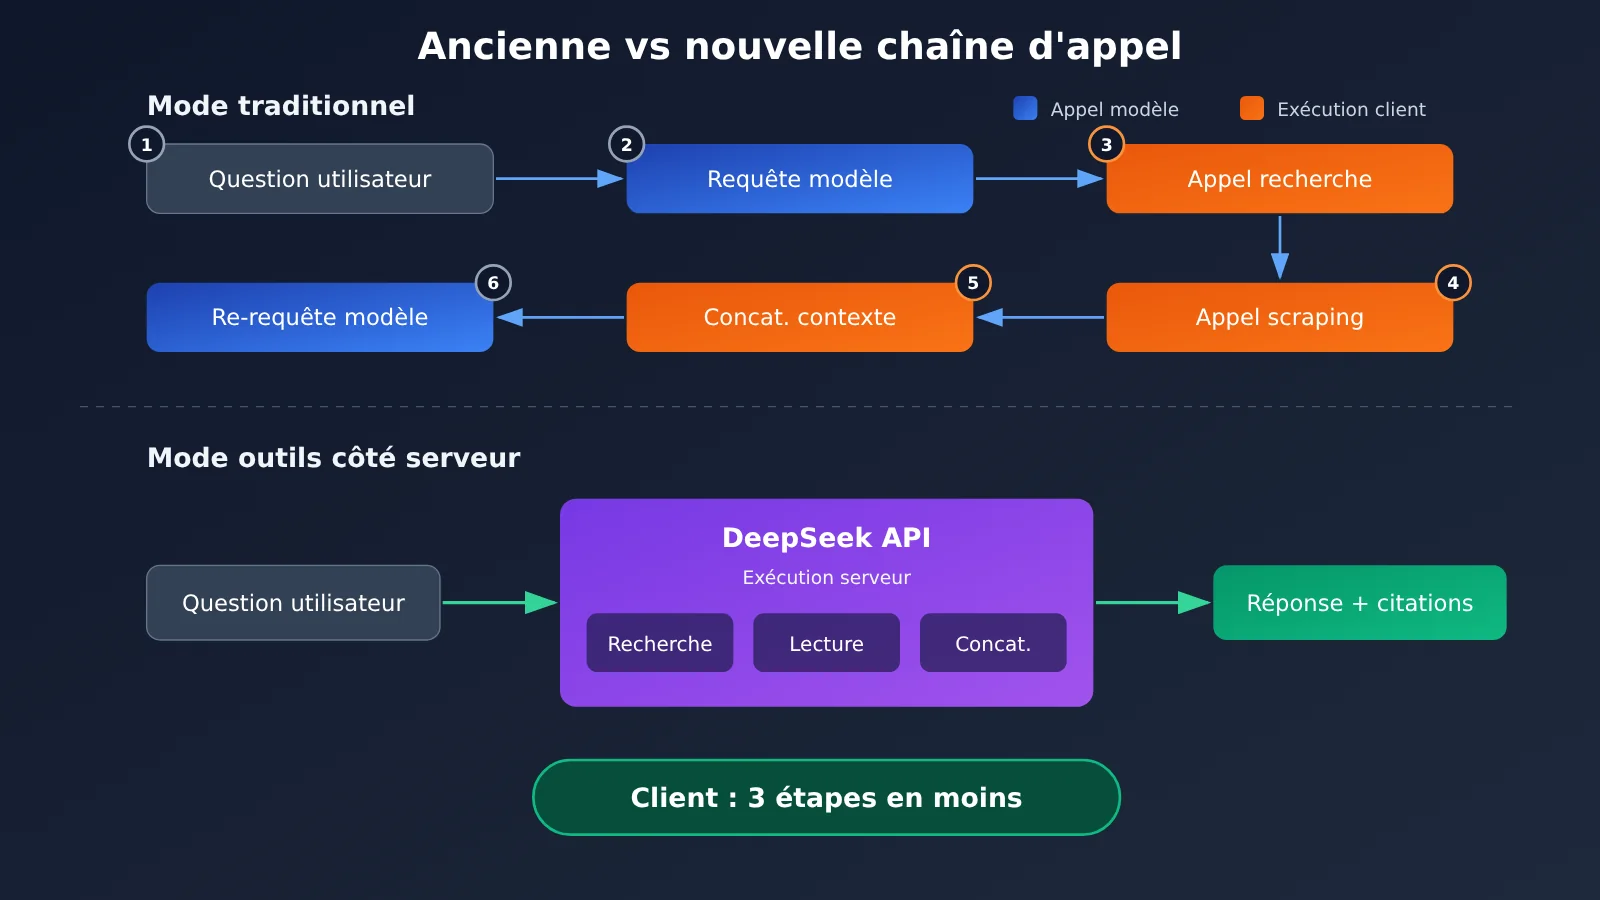
Avant l’arrivée des outils côté serveur, développer un assistant capable d’accéder à Internet obligeait le client à gérer lui-même la boucle d’outils :
- Une fois la question de l’utilisateur posée, on envoie une requête à l’API du modèle.
- Le modèle juge qu’une recherche est nécessaire et renvoie une demande d’appel d’outil.
- Le client appelle une API de recherche tierce.
- Le client appelle un service de scraping pour récupérer le corps de la page web.
- Le client assemble les résultats dans le contexte et renvoie une requête au modèle.
- Le modèle génère la réponse finale.
Sur ce parcours, les services de recherche, de scraping, l’analyse de fichiers, l’OCR, la voix et la modération de contenu viennent souvent de fournisseurs différents, et chacun demande une intégration séparée de l’authentification, de la facturation, de la gestion des erreurs et des délais d’attente.
3.2 Comment le pack complet d’API DeepSeek raccourcit la chaîne d’appels
Dans ce nouveau mode, le développeur se contente de déclarer l’outil dans sa requête. Le modèle DeepSeek décide lui-même s’il doit lancer une recherche, le serveur exécute la recherche et la lecture des pages web, organise les résultats des outils et le contexte, puis le modèle poursuit son raisonnement et renvoie enfin la réponse avec les citations de sources. Les étapes 2 à 5, qui incombaient auparavant au client, sont désormais entièrement prises en charge côté serveur.
Le serveur prend en charge le déroulement de l’exécution, mais aussi une partie des paramètres de génération. Lorsque l’outil de recherche web intégré, la validation de sécurité ou la fonction de titre de session sont activés, les paramètres temperature, top_p, frequency_penalty, presence_penalty, stop, seed, n et parallel_tool_calls de Chat Completions peuvent être ignorés. max_tokens reste actif, mais il limite la longueur de sortie de chaque étape de raisonnement. Dans les cas où les paramètres d’échantillonnage doivent être strictement contrôlés, il convient d’évaluer séparément la pertinence du mode avec outils intégrés.
La validation de sécurité s’active via le paramètre de requête "safety_check": {"level": "high"} ; elle couvre l’entrée utilisateur, les résultats renvoyés par les outils et la sortie finale du modèle. En cas de risque détecté, une erreur 400 est renvoyée ou la réponse se termine par un refus. La documentation officielle le précise clairement : cette capacité fournit un contrôle des risques de base, et le fournisseur de l’application doit continuer à assumer ses obligations en matière de modération de contenu, d’enregistrement du grand modèle de langage, d’étiquetage IA, etc.
3.3 Ce que le front-end doit encore gérer avec l’API DeepSeek « suite complète »
DeepSeek se charge d’exécuter les outils et d’organiser le contexte, mais l’expérience produit reste à construire côté client. Les champs de réponse clés à traiter sont les suivants :
server_tool_use: quels appels d’outils ont été exécutés côté serveur.web_search_tool_result,web_fetch_tool_result: les résultats de recherche et de récupération de pages web.citations: les références de sources dans la réponse, transmises en streaming via des événements commecitations_delta.signature: la signature nécessaire pour conserver une partie du contexte des outils.
Dans un dialogue multi-tours, il faut renvoyer les blocs de contenu concernés tels quels. Le corps de la page lu par deepseek_read_url est conservé via une signature chiffrée : si le client modifie ou abandonne la signature, les tours suivants ne pourront plus restaurer le contexte de la page. Les citations doivent être rattachées au bloc de texte correspondant au moment de l’affichage. Autre détail en streaming : une partie du contenu peut déjà avoir été affichée avant qu’un refus de réponse ne soit finalement décidé ; le front-end doit alors retirer le contenu affiché et le remplacer par le message de refus.
Le Chat Demo open source officiel est une excellente référence. Il implémente la génération automatique des titres de conversation, l’édition des messages, la régénération, la génération continue, l’import/export de l’historique des conversations, le rendu Markdown et Mermaid, les thèmes clair et sombre, la modération de sécurité des images, la saisie vocale et la lecture à voix haute ; la clé API, l’historique des conversations et les images sont stockés localement dans le navigateur. Une application commerciale complète doit encore ajouter par-dessus des couches métier : comptes, gestion des données, paiement, permissions et modération de sécurité.
4 Les types de produits les plus adaptés à la gamme complète d’API DeepSeek
4.1 Questions-réponses sur l’actualité et assistant de recherche IA
Lorsqu’un utilisateur pose une question sur des informations en temps réel, comme les récentes sorties de modèles ou l’actualité du secteur, le modèle récupère des données via la recherche en ligne, ouvre les annonces officielles pour vérifier, puis fournit une réponse accompagnée de citations. La recherche avec réflexion approfondie convient aux questions de recherche qui nécessitent une vérification croisée de plusieurs sources ; la lecture de liens, elle, convient aux cas où l’utilisateur colle directement une URL et demande un résumé ou une comparaison.
4.2 États financiers PDF et assistant de connaissances d’entreprise
Les rapports financiers, livres blancs techniques et présentations internes contiennent généralement beaucoup de graphiques. Avec le mode rich_layout_recognition, le modèle comprend en même temps le texte principal et le contenu des graphiques, comme les courbes de tendance des revenus, et peut répondre à des questions qui dépendent des graphiques, du type « quel trimestre a enregistré la croissance la plus rapide ». Pour les contrats et documents de règles purement textuels, text_recognition suffit, et coûte moins cher.
4.3 Applications d’interaction vocale
La combinaison ASR + deepseek-flash + TTS couvre les applications de questions-réponses vocales, de mise en forme des enregistrements de réunion, de transcription d’interviews et de lecture à voix haute. À noter : l’ASR est limité à 120 secondes par segment audio et fonctionne en reconnaissance non streaming ; les longs enregistrements doivent donc être découpés côté client. Le TTS, lui, prend en charge la synthèse en streaming via WebSocket : on peut générer et lire en même temps, ce qui réduit le temps d’attente avant le premier caractère.
Voici les tarifs officiels des outils DeepSeek, selon le document tarifaire officiel du 15 novembre 2026 :
| Fonctionnalité | Unité de facturation | Tarif catalogue | Offre limitée |
|---|---|---|---|
| Search (recherche) | 1000 requêtes réussies | ¥5 | ¥5 |
| Fetch (récupération de pages web) | 1000 requêtes réussies | ¥5 | ¥5 |
| Analyse de fichiers | 1000 pages | ¥1.5 | ¥1.5 |
| OCR | 1000 pages | ¥1.5 | ¥1.5 |
| ASR | 1 heure d’audio | ¥0.78 | ¥0.39 |
| TTS | 10 000 caractères facturables | ¥3 | ¥1.5 |
Les frais d’outils sont calculés séparément des frais de tokens du modèle. Pour DeepSeek-V4.1-Flash, le prix de sortie par million de tokens est de ¥4 en période creuse et de ¥8 en période de pointe ; les périodes de pointe correspondent aux jours ouvrés, heure de Pékin, de 09:00 à 12:00 et de 14:00 à 18:00. Les requêtes d’outils échouées, sans résultat ou expirées ne sont pas facturées. La recherche intégrée au modèle est facturée selon le nombre réel de termes de recherche effectués, la récupération de pages web selon le nombre de pages récupérées avec succès, et la recherche dans la page lors d’une recherche approfondie n’est pas facturée séparément : une seule conversation peut donc engendrer plusieurs frais de recherche.
5. La suite complète d’API DeepSeek fait évoluer l’invocation d’un modèle unique vers une application IA complète
La suite complète d’API abaisse le seuil d’ingénierie nécessaire à l’intégration des capacités applicatives : recherche, lecture, documents, voix et gestion des risques sont regroupés sous un seul compte et un système de facturation unique, ce qui permet aux développeurs de concentrer leurs efforts sur l’interaction produit et la logique métier. Pour les capacités web, deux voies d’intégration sont actuellement disponibles.
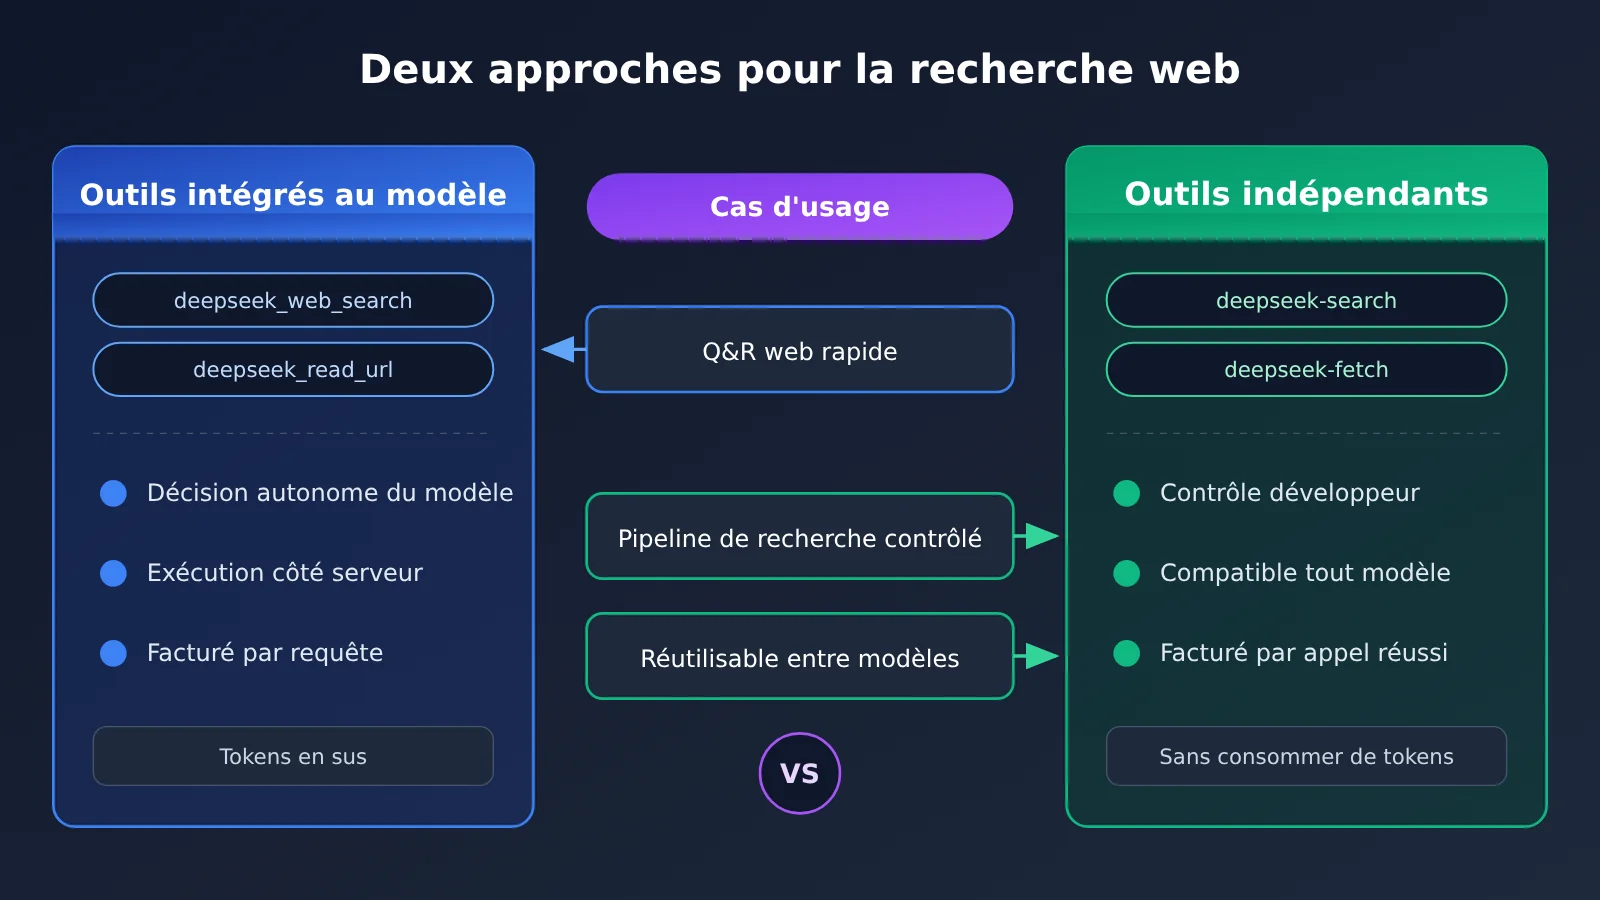
| Dimension | Outil côté serveur intégré au modèle | Outils Search / Fetch indépendants |
|---|---|---|
| Mode d’appel | Déclarer deepseek_web_search et deepseek_read_url dans la requête de conversation |
Appeler séparément les API de recherche et de récupération |
| Contrôle du flux | Le modèle décide quand rechercher et quelles pages lire | Le développeur décide du moment de la recherche, du filtrage et de l’assemblage des résultats |
| Périmètre des modèles | deepseek-flash |
Non lié à un modèle ; peut s’intégrer à des Agent, RAG et n’importe quel grand modèle de langage |
| Mode de facturation | Facturation par requête et par page récupérée, plus les Token | Facturation par appel réussi ; ne consomme pas de Token de modèle en soi |
| Scénarios d’usage | Reproduire rapidement des questions-réponses web façon application | Nécessite un flux de recherche contrôlable et une réutilisation des résultats de recherche entre modèles |
| Plateformes disponibles | API officielle DeepSeek | API officielle DeepSeek ; APIYI apiyi.com propose déjà deepseek-search et deepseek-fetch |
APIYI a mis en ligne le 21 octobre les deux interfaces d’outils indépendantes deepseek-search et deepseek-fetch, disponibles dans les groupes default et svip. Pour la recherche intégrée au modèle ouverte le 13 novembre, APIYI classe dans sa documentation les travaux de compatibilité pour l’appel client à la recherche intégrée parmi les évolutions à venir. Par conséquent, pour utiliser les capacités web de DeepSeek via APIYI, c’est actuellement la voie des outils indépendants qui est retenue : appeler soi-même la recherche et la récupération, puis confier les résultats à n’importe quel modèle pour l’inférence.
5.1 Intégrer la recherche DeepSeek via un outil indépendant
Exemple minimal : appel de Search pour obtenir des résultats structurés (les noms de champs de la requête suivent la documentation APIYI) :
import requests

BASE_URL = "https://api.apiyi.com/v1"  # Interface unifiée APIYI
headers = {"Authorization": "Bearer YOUR_API_KEY"}

resp = requests.post(f"{BASE_URL}/tools/search", headers=headers, json={
    "model": "deepseek-search",
    "query": "DeepSeek 全家桶应用 API",
    "count": 5,
})
print(resp.json())
Voir l’implémentation complète : recherche + extraction + synthèse par le modèle
import requests
import openai

API_KEY = "YOUR_API_KEY"
BASE_URL = "https://api.apiyi.com/v1"  # Recherche, extraction et invocation du modèle partagent la même entrée
HEADERS = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}


def search(query: str, count: int = 5) -> dict:
    """Appelle deepseek-search et renvoie des résultats de recherche structurés (les noms de champs suivent la documentation)"""
    r = requests.post(f"{BASE_URL}/tools/search", headers=HEADERS, json={
        "model": "deepseek-search", "query": query, "count": count,
    }, timeout=30)
    r.raise_for_status()
    return r.json()


def fetch(url: str) -> dict:
    """Appelle deepseek-fetch et renvoie le corps Markdown de la page web ; une requête échouée n'est pas facturée"""
    r = requests.post(f"{BASE_URL}/tools/fetch", headers=HEADERS, json={
        "model": "deepseek-fetch", "url": url,
    }, timeout=60)
    r.raise_for_status()
    return r.json()


def answer(question: str, context: str, model: str = "your-model-id") -> str:
    """Confie le contenu récupéré à n'importe quel modèle pour générer une réponse avec les sources"""
    client = openai.OpenAI(api_key=API_KEY, base_url=BASE_URL)
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "根据提供的资料回答,并注明来源 URL。"},
            {"role": "user", "content": f"资料:\n{context}\n\n问题:{question}"},
        ],
    )
    return resp.choices[0].message.content


if __name__ == "__main__":
    q = "DeepSeek 11 月 13 日开放了哪些 API 能力?"
    results = search(q)
    # Récupérer les premières URL selon la structure réellement renvoyée, puis extraire le contenu et le confier au modèle
    print(results)
🚀 Conseil pour démarrer rapidement : si vous voulez d’abord vérifier la qualité de la recherche, vous pouvez vous inscrire sur APIYI apiyi.com pour obtenir un quota d’essai, puis utiliser une seule clé API pour appeler à la fois deepseek-search, deepseek-fetch et les principaux modèles de conversation, afin de comparer la qualité des réponses produites par différents modèles à partir des mêmes résultats de recherche.
Les données d’auto-évaluation d’APIYI montrent que Search renvoie une réponse en environ 1,8 seconde avec count=5, et en environ 3 secondes avec count=50 ; 20 requêtes concurrentes se terminent toutes en environ 2 secondes. Fetch, pour une page web ordinaire, renvoie en environ 1,6 seconde un corps Markdown d’environ 6 400 caractères. Il s’agit de résultats de tests uniques dans un environnement réseau donné ; le temps réel dépend du site cible.
5.2 Comment choisir sa voie d’accès à Internet pour DeepSeek
- Choisir l’outil intégré : si vous voulez reproduire le plus vite possible l’expérience de l’application DeepSeek, accepter que le modèle décide lui-même du chemin de recherche, et utiliser
deepseek-flash. - Choisir l’outil indépendant : si vous avez besoin de contrôler vous-même les termes de la requête, de filtrer les sources, de mettre en cache les résultats, ou si vous souhaitez confier le même résultat de recherche à différents modèles comme Claude, GPT, Gemini, etc.
- Utiliser les deux en mixte : l’outil intégré pour les questions-réponses en front-office, et les Search / Fetch indépendants pour la collecte de données par lots en arrière-plan et l’indexation RAG.
FAQ
Q1 : Qu’est-ce que l’API « 全家桶 » (suite complète) de DeepSeek ?
C’est un ensemble d’API de capacités applicatives ouvertes par DeepSeek le 13 novembre 2026, couvrant la recherche en ligne, la recherche avec réflexion approfondie, la lecture de liens, l’entrée de fichiers, la validation de sécurité, ainsi que les interfaces indépendantes Search, Fetch, OCR, ASR, TTS. Elles couvrent les principales capacités qui se cachent derrière l’application DeepSeek.
Q2 : Quelle est la différence entre l’API 全家桶 de DeepSeek et DeepSeek Harness ?
Harness est le framework d’exécution d’Agent open source du 13 août, qui gère les modèles, outils, plugins et le contexte ; l’API 全家桶 est l’interface de service des modèles et des outils. Les développeurs peuvent utiliser Harness pour construire un Agent, puis accéder aux capacités de recherche, de fichiers et de voix via l’API.
Q3 : Quels modèles peuvent utiliser les outils intégrés de l’API 全家桶 de DeepSeek ?
L’intégration complète des outils au niveau de la conversation est actuellement fournie par `deepseek-flash` (DeepSeek-V4.1-Flash-1017), qui prend en charge trois protocoles : Chat Completions, Responses et Anthropic Messages. OCR, ASR, TTS, Search et Fetch sont des interfaces indépendantes, que l’on peut appeler séparément.
Q4 : Quelles capacités de l’API 全家桶 de DeepSeek peut-on appeler via APIYI ?
APIYI a déjà mis en ligne les outils indépendants Search et Fetch de DeepSeek (deepseek-search, deepseek-fetch), facturés à l’appel réussi, disponibles dans les groupes default et svip. La compatibilité côté client pour la recherche intégrée au modèle est encore en cours de planification ; pour l’état d’avancement précis, référez-vous à la documentation APIYI apiyi.com.
Q5 : Comment tester rapidement les effets de la recherche DeepSeek et d’une combinaison multi-modèles ?
1. S’inscrire sur APIYI apiyi.com et récupérer une clé API ainsi qu’un quota de test.
2. Utiliser le code de cet article, en définissant base_url sur `https://api.apiyi.com/v1`.
3. Appeler d’abord deepseek-search pour obtenir les résultats, puis deepseek-fetch pour lire le corps du texte, et enfin confier le tout à n’importe quel modèle de dialogue pour générer une réponse.
Q6 : Quelles sont les limitations connues de l’API 全家桶 de DeepSeek ?
– `tool_choice` ne peut pas forcer l’appel des outils en ligne : la recherche est décidée par le modèle.
– Une fois les outils intégrés activés, des paramètres d’échantillonnage comme `temperature` ou `top_p` peuvent être ignorés.
– L’ASR est limité à 120 secondes par segment et fonctionne en non-streaming ; le TTS ne permet pas encore de régler la vitesse de parole.
– Un fichier peut faire au maximum 100 MiB et 1000 pages ; au-delà de la fenêtre de contexte, une erreur 400 est renvoyée.
– La validation de sécurité fournit un contrôle des risques de base ; l’application reste responsable de la modération du contenu.
Points clés de l’API DeepSeek Family
- Date de lancement : le 13 novembre 2026, ouverture des 10 capacités applicatives qui font tourner l’App.
- Changement majeur : la recherche et la lecture de pages web sont exécutées côté serveur ; le client se contente de déclarer les outils.
- Modèle porteur : l’intégration d’outils au niveau de la conversation est fournie par
deepseek-flash, avec prise en charge de trois protocoles. - Recherche approfondie : search, open_page et find_in_page s’exécutent en alternance, pour un maximum d’environ 20 appels d’outils.
- Analyse de fichiers : deux modes selon que l’on conserve ou non les graphiques ; pour les documents de type rapport financier, on privilégie le mode image + texte.
- Rôle du front-end : l’affichage des citations, le renvoi de signature et le retrait d’un refus en cours de streaming restent à la charge du client.
- Voies d’intégration : lorsque vous avez besoin d’une recherche contrôlable, vous pouvez appeler les services Search / Fetch indépendants via APIYI apiyi.com.
En résumé
Les points essentiels de l’API DeepSeek Family se résument en trois idées :
- Ouverture de la couche de capacités : recherche, documents, voix, contrôle des risques et modèles sont réunis dans une seule API ; l’éditeur indique qu’il est possible de reproduire l’expérience de l’App à partir de celle-ci.
- Chaîne d’appel raccourcie : les outils côté serveur prennent en charge la recherche, la récupération et l’assemblage du contexte, ce qui permet aux développeurs de concentrer leurs efforts sur l’interaction et la logique métier.
- Deux approches coexistent : les outils intégrés conviennent pour construire rapidement un système de questions-réponses façon App ; les services Search / Fetch indépendants conviennent à une recherche contrôlable et à une réutilisation entre plusieurs modèles.
Pour prototyper un système de questions-réponses connecté au web, vous pouvez d’abord valider l’expérience avec les outils intégrés ; si vous avez besoin d’un contrôle fin du processus de recherche ou de combiner plusieurs modèles, il est recommandé de passer par APIYI apiyi.com pour accéder aux outils de recherche et de récupération indépendants, et de les associer à une interface multi-modèles unifiée afin de comparer rapidement les résultats.
📚 Références
- DeepSeek publie l’API de sa suite d’applications : annonce officielle du 2026-11-13
- Lien :
api-docs.deepseek.com/zh-cn/news/news261113/ -
Description : la liste complète des capacités ouvertes cette fois
-
Documentation des outils web de DeepSeek : recherche côté serveur et lecture de liens
- Lien :
api-docs.deepseek.com/zh-cn/guides/web_tools/ -
Description : déclaration des outils, règles d’invocation et mode de facturation
-
Documentation d’analyse de fichiers DeepSeek : guide d’utilisation de la Files API
- Lien :
api-docs.deepseek.com/zh-cn/guides/document_parsing/ -
Description : les deux modes d’analyse et les limites de fichiers
-
Guide DeepSeek pour construire un chatbot : points clés du développement côté client
- Lien :
api-docs.deepseek.com/zh-cn/guides/build_a_chatbot/ -
Description : champs renvoyés, renvoi sur plusieurs tours et paramètres dont la gestion est transférée
-
Modèles et tarifs DeepSeek : prix des tokens et des outils
- Lien :
api-docs.deepseek.com/zh-cn/quick_start/pricing/ -
Description : tarifs aux heures de pointe et aux heures creuses
-
DeepSeek Chat Demo : exemple front-end open source officiel
- Lien :
github.com/deepseek-ai/chat-demo -
Description : implémentation de référence pour l’affichage des citations, les fichiers et les interactions vocales
-
Documentation APIYI DeepSeek Search & Fetch : description des interfaces d’outils indépendantes
- Lien :
docs.apiyi.com/api-capabilities/deepseek-search-fetch/overview - Description : paramètres de l’interface, disponibilité par groupe et tarification
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus de ressources d’intégration, rendez-vous sur le centre de documentation docs.apiyi.com