Note de l’auteur : décryptage du mécanisme de partage des rôles entre planification et exécution dans Google Antigravity Orchestrator, de la signification des 24 % de quota et 19 % de vitesse des tests officiels, et des différences de choix avec les modèles autonomes et les agents parallèles.
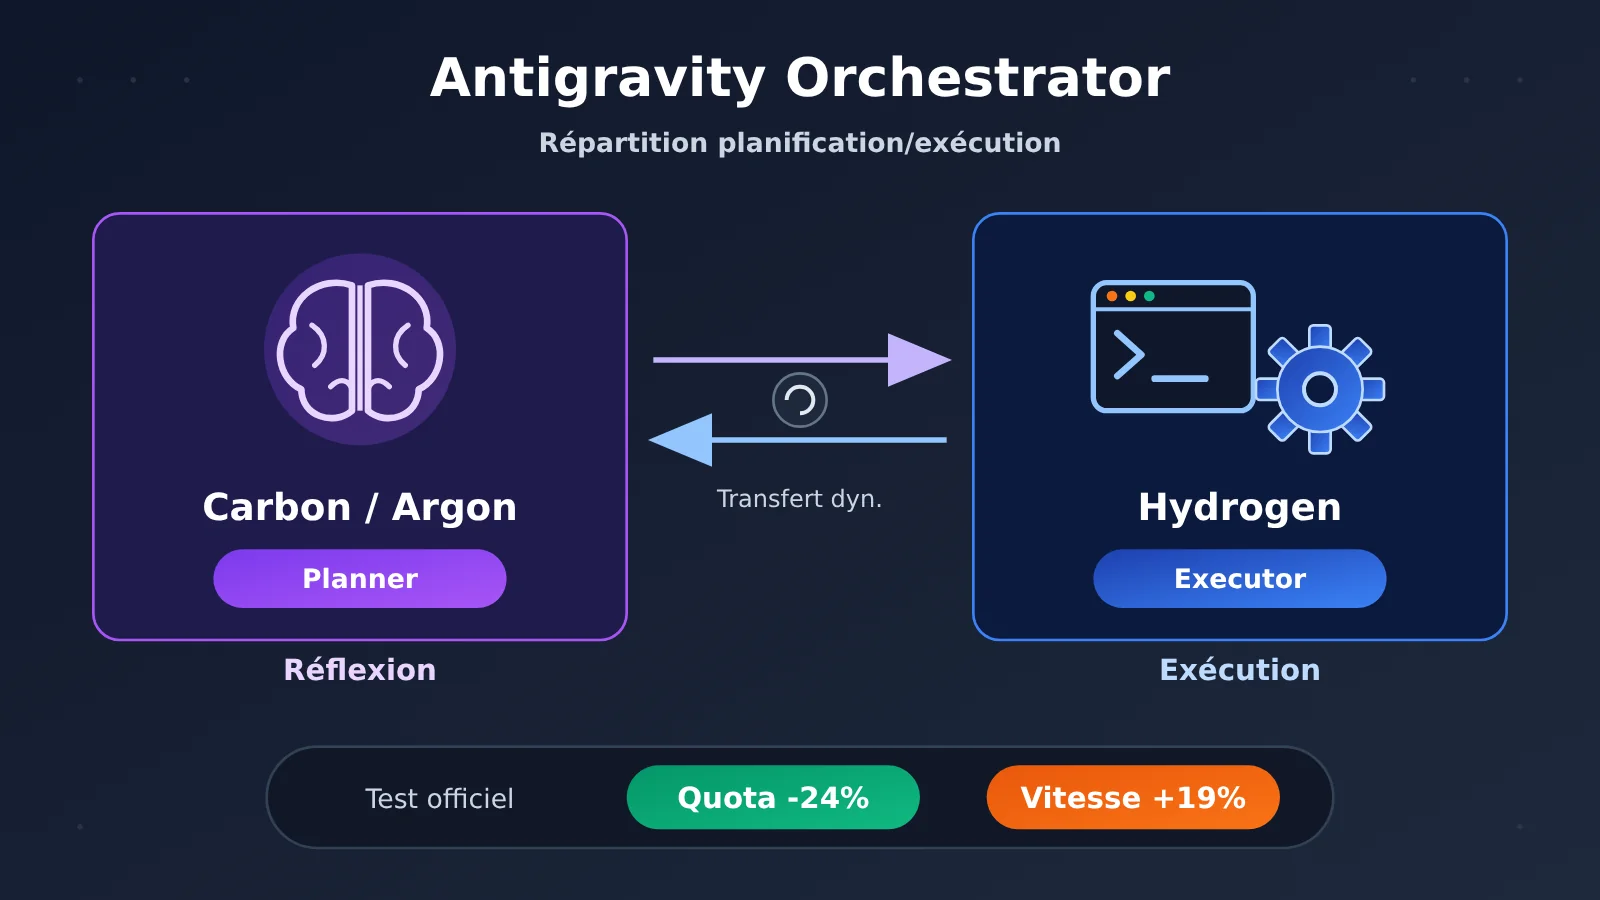
Le 12 novembre 2026, Google a publié Gemini 4 Hydrogen et a lancé dans Antigravity l’orchestration multi-modèles Orchestrator. Le principe : dans une même tâche de développement, Carbon ou Argon se charge de la planification, Hydrogen de l’exécution. Les tests comparatifs officiels de Google montrent qu’Orchestrator réduit en moyenne la consommation de quota de 24 % par rapport à Carbon utilisé seul, et accélère la réalisation de 19 %.
Ce ne sont pas des rumeurs de couloir : le blog officiel de Google Antigravity, la documentation de sélection des modèles et la synthèse de lancement de Google confirment tous cette fonctionnalité. Cet article rassemble les informations déjà publiques sur Google Antigravity Orchestrator : le mécanisme de fonctionnement, la bonne façon de lire les chiffres des tests, les forfaits et les points d’entrée, ainsi que le type de tâches pour lesquelles il est pertinent.
L’essentiel : après lecture, vous saurez si votre tâche d’ingénierie doit passer par Orchestrator, par Hydrogen en mode autonome, ou par Carbon / Argon en mode autonome.
Résumé en une phrase : Antigravity Orchestrator confie la planification à Carbon ou Argon et l’exécution à Hydrogen dans une seule et même session d’agent ; Google rapporte officiellement des gains de quota et de vitesse.
À savoir : 5 termes à comprendre avant de lire
- Planner (planificateur) : le rôle de modèle chargé d’analyser la tâche, d’établir un plan et de replanifier si nécessaire ; dans Orchestrator, il est tenu par Carbon ou Argon.
- Executor (exécuteur) : le rôle qui modifie le code, exécute les outils et vérifie les résultats selon le plan ; dans Orchestrator, il est tenu par Hydrogen.
- Agent : un système qui accomplit des tâches à plusieurs étapes grâce au modèle et à l’environnement d’exécution des outils ; ce n’est pas la même chose qu’un modèle unique.
- Quota : le volume alloué par la plateforme pour limiter la quantité de service disponible. Une baisse de quota ne se traduit pas directement par une baisse de la facture réelle.
- Harness : le cadre de test qui organise les entrées du modèle, l’exécution des outils et la notation des tâches. Un même modèle placé dans un Harness différent peut obtenir un score différent.
Aperçu des informations clés de Google Antigravity Orchestrator
| Élément d’information | Détails |
|---|---|
| Date de sortie | 12 novembre 2026, sortie simultanée avec Gemini 4 Hydrogen |
| Éditeur | Google (équipe Antigravity, modèles Google DeepMind) |
| Mécanisme central | Au sein d’une même session Agent, passation dynamique entre Planner et Executor |
| Modes disponibles | Orchestrator (Carbon), Orchestrator (Argon), le modèle d’exécution étant Hydrogen dans les deux cas |
| Résultats des tests officiels | Par rapport à l’utilisation seule de Carbon : consommation de quota -24 % en moyenne, vitesse d’achèvement +19 %, performance de réussite des tâches proche de Carbon |
| Périmètre d’accès | Google AI Ultra peut utiliser les deux modes, les comptes Google AI Pro éligibles peuvent utiliser le mode Argon |
| Paramètres de réflexion | Configuration fixe, impossible d’ajuster séparément le niveau de réflexion |
Pourquoi Google lance Antigravity Orchestrator
Une véritable tâche de développement logiciel comporte généralement plusieurs types de travail : d’abord comprendre le codebase et les dépendances, puis décider où modifier et comment, ensuite éditer les fichiers en lot, lancer les builds et les tests, et enfin vérifier les résultats. Ces étapes ont des exigences très différentes en matière de capacité de raisonnement. « Décider comment modifier » demande un jugement approfondi ; « modifier dix fichiers selon le plan et lancer les tests » privilégie davantage la vitesse, l’édition précise et la stabilité des appels d’outils.
Si l’on confie toute la tâche à un modèle de raisonnement haut de gamme comme Carbon, les nombreuses opérations répétitives de la phase d’exécution vont aussi consommer le rythme et le quota d’un modèle haut de gamme, ce qui allonge le temps de la tâche et fait grimper les coûts en quota. À l’inverse, un modèle léger seul risque de se tromper sur la conception du plan ou sur les erreurs délicates, ce qui entraîne des reprises.
Le positionnement de Hydrogen comble précisément ce créneau. Google le définit comme un modèle d’exécution Agent et de programmation quotidienne à haut rendement, en mettant l’accent sur l’édition précise, les appels multi-outils et la capacité à ajuster la stratégie après l’échec d’un outil ; Google indique explicitement qu’il peut jouer le rôle d’exécuteur ou de validateur dans un système multi-modèles. Orchestrator, c’est justement la productisation de cette division du travail : le modèle coûteux n’est utilisé que là où le jugement est le plus nécessaire.
Comment fonctionne Antigravity Orchestrator : Carbon pense, Hydrogen exécute
Selon la documentation officielle de Google Antigravity, l’Orchestrator ne se contente pas d’évaluer la difficulté une seule fois à la réception d’une requête, puis de choisir un modèle pour mener toute la tâche. Il alterne planning et exécution entre les modèles au sein d’une même tâche.
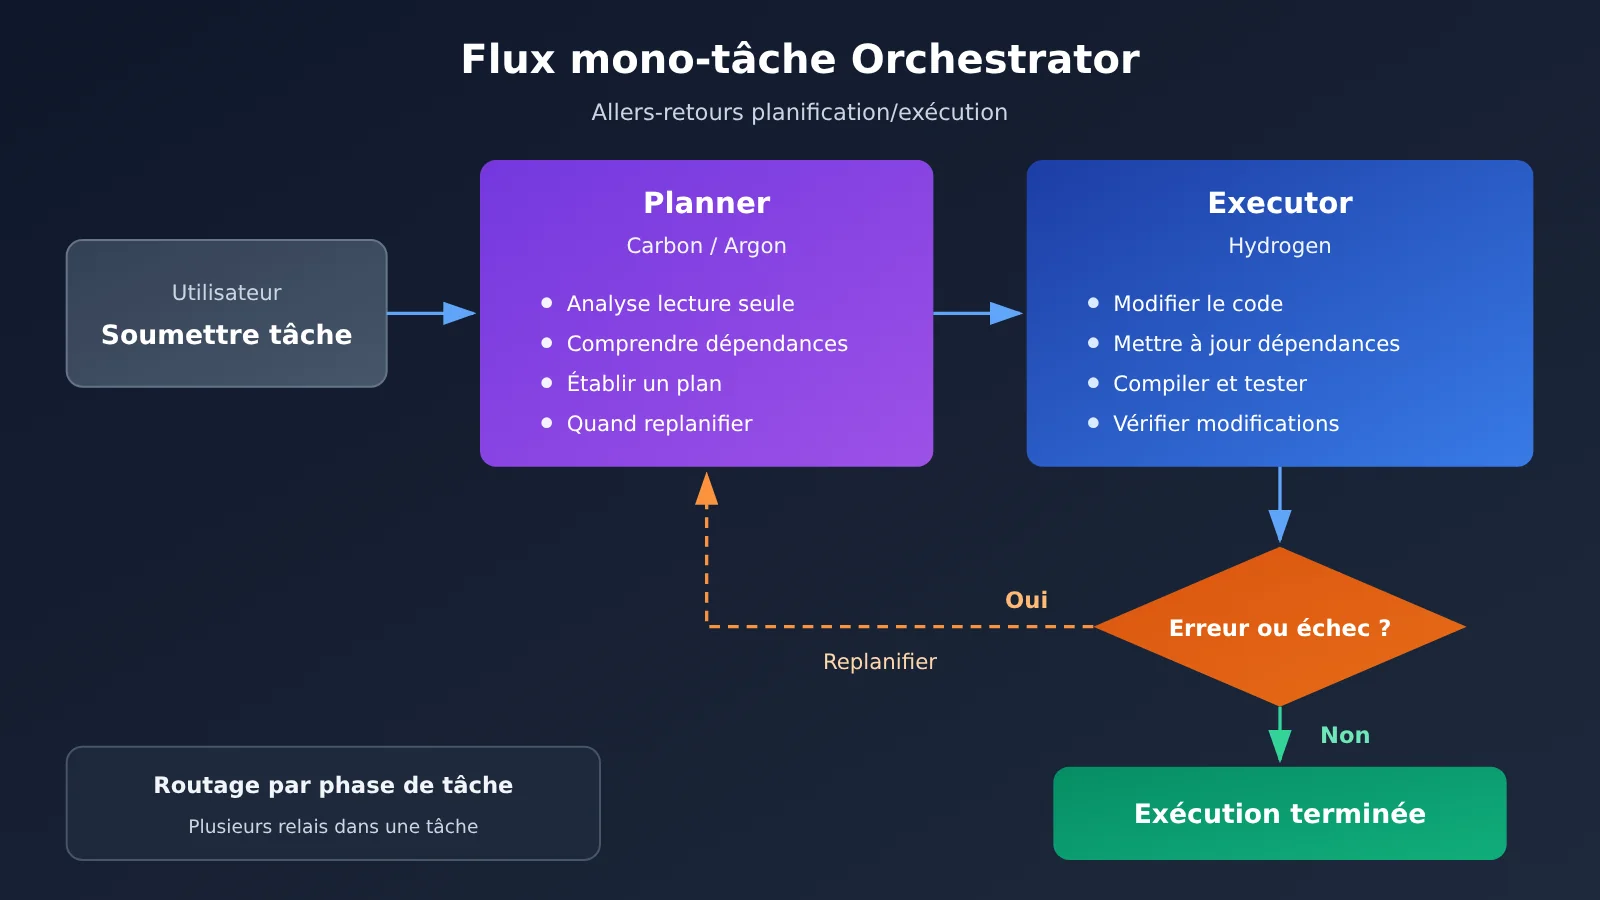
Le flux de travail en cinq étapes de l’Orchestrator
Prenons l’exemple officiel du scénario de mise à niveau des dépendances, un cycle complet se déroule approximativement ainsi :
- Analyser le dépôt de code : Carbon (ou Argon) parcourt en lecture seule la structure du code et les relations de dépendances.
- Élaborer un plan : le Planner détermine l’étendue et les étapes des modifications, tout en définissant dans quels cas une replanification est nécessaire.
- Modifier le code : Hydrogen prend en charge les éditions concrètes et la mise à niveau des dépendances.
- Exécuter les tests : Hydrogen lance la compilation et les tests pour vérifier que les modifications prennent effet.
- Vérifier les résultats : en cas de succès, on inspecte les résultats et on clôture la tâche ; en cas d’erreur complexe, on renvoie la main au Planner.
Les conditions déclenchant une replanification de l’Orchestrator
La documentation officielle énumère plusieurs situations qui rendent le contrôle au Planner : l’étape de vérification échoue deux fois consécutivement, le comportement de l’interface ne correspond pas aux attentes, ou une décision de conception non couverte par le plan initial apparaît lors de la mise en œuvre. Après une nouvelle évaluation, le Planner ajuste le plan, puis le confie de nouveau à Hydrogen pour la suite des modifications et des vérifications.
Ce mécanisme est crucial. Le modèle d’exécution ne réessaie pas aveuglément sans fin : dès que l’on sort du plan initial, il remonte la décision à temps, et le modèle haut de gamme n’intervient qu’aux points critiques.
La différence entre le transfert dynamique et le routage de modèle ponctuel
Le « routage de modèle » courant consiste à effectuer une classification unique à l’entrée de la requête : tâche simple confiée à un petit modèle, tâche complexe à un grand modèle, sans changement par la suite. La différence de l’Orchestrator réside dans le fait que, au sein d’une même tâche, plusieurs transferts ont lieu, la planification et l’exécution étant assurées par des modèles différents, et que l’on peut revenir à la phase de planification à tout moment pendant l’exécution. Ce qu’il route, ce sont les phases de la tâche, et non l’ensemble de la requête.
Tests officiels d’Orchestrator : que signifient 24 % de quota et 19 % de vitesse ?
Les données ci-dessous proviennent toutes des tests comparatifs officiels de Google sur des tâches en terminal, comparant « Orchestrator » à « Carbon utilisé seul ».
| Indicateur | Orchestrator vs Carbon seul | Bonne façon de l’interpréter |
|---|---|---|
| Réussite des tâches | Proche de Carbon utilisé seul | Il n’est pas affirmé qu’il dépasse Carbon, mais qu’il s’en « approche » |
| Consommation de quota | Réduction moyenne de 24 % | C’est une variation du quota Antigravity, pas une baisse de facture de 24 % garantie |
| Vitesse d’exécution | Gain de 19 % | Résultat moyen des tâches du test officiel ; cela ne veut pas dire que toutes les tâches sont 19 % plus rapides |
Pourquoi la répartition entre plusieurs modèles permet d’économiser du quota
Le gain vient surtout de la phase d’exécution. L’édition de code, la mise à jour des dépendances et les exécutions répétées de tests sont des étapes très sollicitées, avec un contexte long : si Carbon s’en chargeait à chaque fois, le modèle haut de gamme serait appelé en masse et à répétition. Une fois ces tâches confiées à Hydrogen, Carbon ne garde que la planification initiale et la replanification en cours de route, ce qui fait naturellement baisser le volume d’appels au raisonnement haut de gamme. L’écart de coût entre les deux se lit aussi dans les tarifs API : au 13 novembre 2026, selon les prix standards officiels de Google AI Studio, Hydrogen facture l’entrée et la sortie respectivement 1,50 USD et 7,50 USD par million de tokens ; Carbon est à 2 USD et 10 USD par million de tokens jusqu’au 30 novembre 2026, la page officielle précisant un passage à 4 USD et 20 USD à partir du 1er décembre.
Attention toutefois : ce sont là des prix API, alors qu’Orchestrator fonctionne dans le système de quotas d’abonnement d’Antigravity ; les deux ne se mesurent pas de la même manière. On ne peut donc pas déduire le « coût réel » d’Orchestrator à partir des prix API.
Ce que ces chiffres signifient pour une équipe de développement
Pour une équipe, l’efficacité d’un outil de programmation IA ne se juge pas uniquement sur la qualité d’une réponse isolée : il faut regarder trois dimensions à la fois — le taux de réussite des tâches, la consommation de quota et le temps de complétion. Les résultats officiels d’Orchestrator montrent que, à taux de réussite quasiment identique, les deux autres indicateurs s’améliorent. C’est une piste à considérer pour les équipes : évaluer séparément la « qualité de planification » et le « débit d’exécution », plutôt que de ne fixer que le modèle le plus puissant.
💡 Note sur les données : les chiffres d’efficacité de cette section proviennent des tests comparatifs officiels de Google et n’ont pas encore été reproduits par un tiers indépendant. Si vous souhaitez vérifier dans votre propre activité l’effet de la répartition « modèle de planification + modèle d’exécution », vous pouvez, via APIYI apiyi.com, appeler des modèles de différents niveaux avec une même clé API et concevoir vous-même votre expérience comparative.
Orchestrator : comparaison avec les modèles indépendants et les Agents parallèles
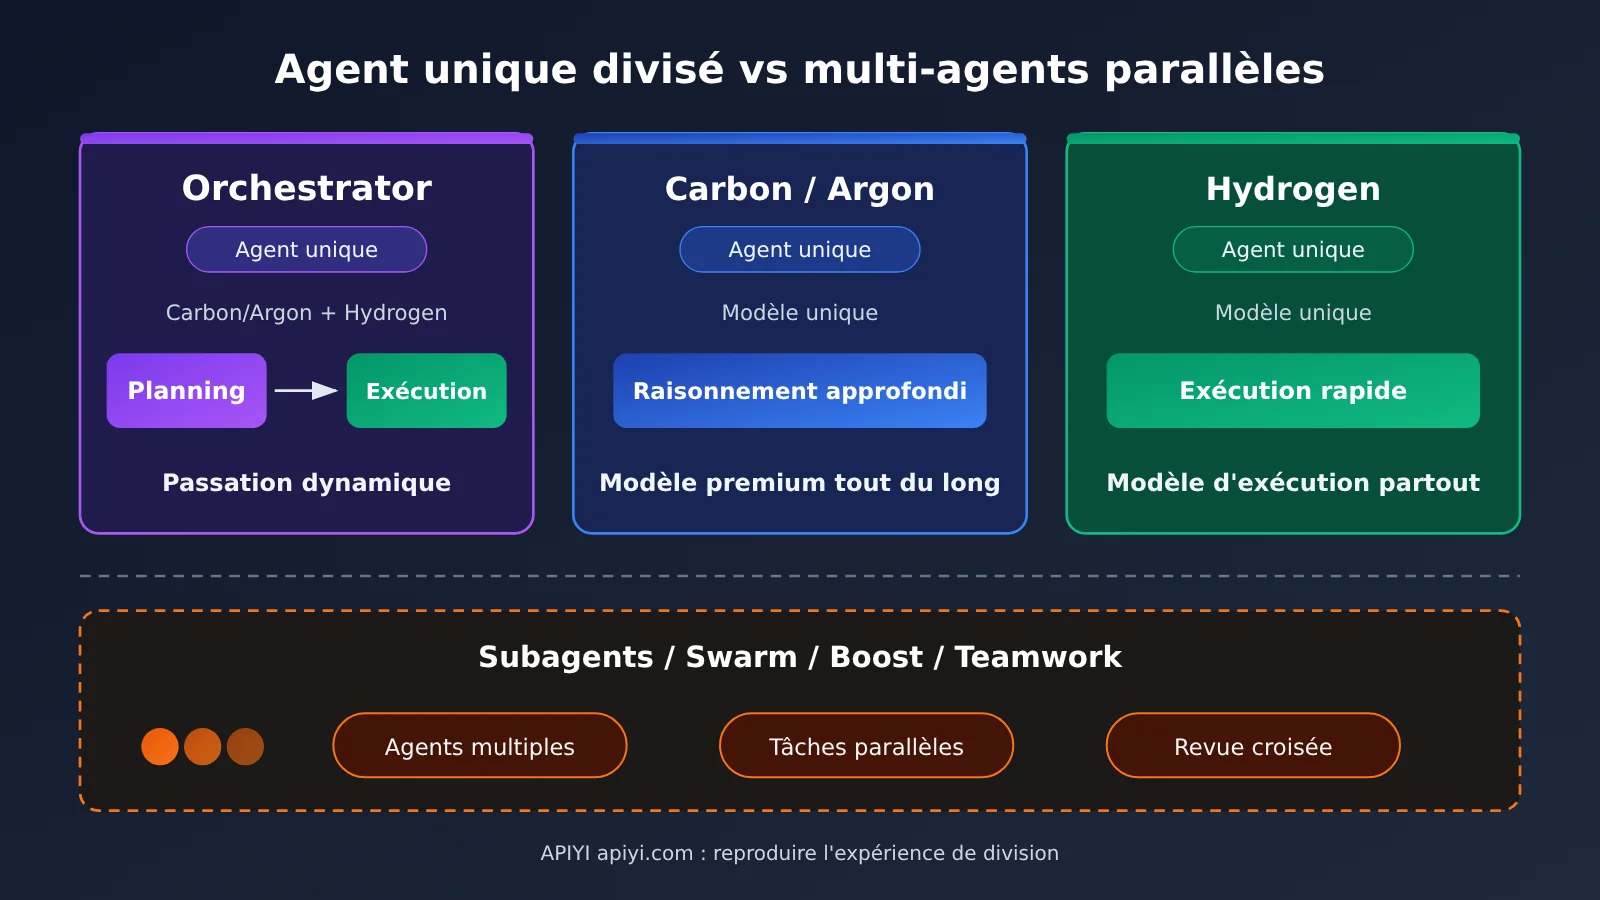
| Solution | Nombre d’Agents | Mode d’utilisation des modèles | Niveau de raisonnement | Complexité d’ingénierie adaptée |
|---|---|---|---|---|
| Orchestrator | 1 | Carbon/Argon planifient, Hydrogen exécute, bascule automatique | Configuration fixe | Complexité moyenne, tâches à plusieurs phases |
| Carbon / Argon indépendants | 1 | Un seul modèle haut de gamme assure toute la durée | Personnalisable | Chaque étape exige un raisonnement approfondi |
| Hydrogen indépendant | 1 | Un seul modèle d’exécution assure toute la durée | Personnalisable | Tâches courantes aux besoins bien définis |
| Subagents / Swarm, etc. | plusieurs | Plusieurs Agents en parallèle ou en relecture croisée | Selon la configuration | Gros travail parallèle décomposable |
Analyse comparative avec Carbon indépendant : Carbon garde son avance sur les jugements complexes, mais lors des opérations répétitives de la phase d’exécution, il consomme lui aussi le quota et le temps d’un modèle haut de gamme. À l’inverse, sur la plupart des tâches d’ingénierie courantes mêlant planification et exécution, l’Orchestrator obtient des performances proches pour une consommation de quota plus faible.
Analyse comparative avec Hydrogen indépendant : Hydrogen est rapide et précis dans ses modifications, mais face à un choix de conception non couvert par la solution initiale, il n’a pas de modèle plus puissant pour prendre le relais. Pour les tâches aux besoins clairs et sans décisions à répéter, il reste l’option la plus directe.
Analyse comparative avec les Agents parallèles multiples : Google le précise clairement, l’Orchestrator ne maintient qu’un seul Agent dans une conversation et s’appuie sur la passation entre plusieurs modèles pour couvrir les différentes phases. Si vous avez besoin de plusieurs Agents travaillant simultanément sur des sous-tâches ou se relisant mutuellement, il faut se tourner vers des fonctions comme Subagents, Swarm, Boost ou Teamwork. Les deux répondent à des problèmes différents : l’un concerne « comment répartir le travail au sein d’une même tâche », l’autre « faut-il augmenter le nombre d’Agents ».
Comment utiliser Orchestrator dans Antigravity
Correspondance entre les modes Orchestrator et les offres
| Mode | Modèle de planification | Modèle d’exécution | Offres disponibles |
|---|---|---|---|
| Orchestrator (Carbon) | Gemini 4 Carbon | Gemini 4 Hydrogen | Google AI Ultra |
| Orchestrator (Argon) | Gemini 4 Argon | Gemini 4 Hydrogen | Google AI Pro et Ultra éligibles |
| Modèle autonome Hydrogen | — | Gemini 4 Hydrogen | Déployé progressivement auprès des utilisateurs Pro et Ultra |
Dans l’application Antigravity, ouvrez le menu de sélection du modèle situé près du champ de saisie de la conversation, puis choisissez Orchestrator (Carbon) ou Orchestrator (Argon). Dans l’Antigravity CLI, l’exemple officiel est le suivant (la syntaxe ci-dessous provient de la documentation officielle et n’a pas été testée localement pour cet article) :
# Afficher les modèles disponibles pour le compte actuel
agy models

# Une fois dans la session, utiliser /model pour choisir Orchestrator

# Vous pouvez aussi le spécifier directement au démarrage
agy -p "Add input validation to the signup form and run the tests." --model "Orchestrator (Argon)"
À noter qu’Orchestrator utilise une configuration de réflexion fixe : impossible de lui attribuer séparément un niveau Low, Medium, High ou Extra. Si vous avez besoin de personnaliser le niveau de réflexion, passez plutôt à un modèle autonome. Par ailleurs, le jour du lancement, des utilisateurs ont signalé que l’option du modèle était visible mais que l’invocation échouait, et que l’ouverture n’était pas synchronisée d’un compte à l’autre. Ces situations sont plus probablement liées à un déploiement progressif ; si vous les rencontrez, réessayez un peu plus tard.
Reproduire la répartition planification / exécution dans son propre agent
L’Orchestrator est une fonctionnalité produit d’Antigravity, mais l’idée « un modèle puissant planifie, un modèle rapide exécute, et au bout de deux échecs on repasse la main au planificateur » peut très bien s’implémenter dans votre propre agent. Voici un exemple minimal basé sur une interface compatible OpenAI — les noms de modèles sont à prendre dans la liste de modèles de la plateforme que vous utilisez :
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

PLANNER = "your-reasoning-model"   # modèle de planification, voir la liste de modèles de la plateforme
EXECUTOR = "your-fast-model"       # modèle d'exécution, voir la liste de modèles de la plateforme

def ask(model, system, user):
    r = client.chat.completions.create(model=model, messages=[
        {"role": "system", "content": system}, {"role": "user", "content": user}])
    return r.choices[0].message.content

plan = ask(PLANNER, "你是架构师,输出分步实施方案。", "为注册表单增加输入校验")
print(ask(EXECUTOR, "严格按方案执行,只输出代码改动。", plan))
Voir l’exemple complet avec « deux échecs avant re-planification »
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PLANNER = "your-reasoning-model"
EXECUTOR = "your-fast-model"
MAX_FAILS = 2  # cf. doc Antigravity : après deux échecs de validation consécutifs, on repasse au planificateur

def ask(model: str, system: str, user: str) -> str:
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": system},
                  {"role": "user", "content": user}],
    )
    return r.choices[0].message.content

def run_tests(patch: str) -> tuple[bool, str]:
    """Remplacez ceci par votre propre logique de build et de test, renvoie (réussi, journal)"""
    raise NotImplementedError

def orchestrate(task: str, max_replans: int = 3) -> str:
    plan = ask(PLANNER, "你是规划者,输出分步方案及重新规划条件。", task)
    for _ in range(max_replans):
        fails, log = 0, ""
        while fails < MAX_FAILS:
            patch = ask(EXECUTOR, "你是执行者,严格按方案修改代码。",
                        f"方案:\n{plan}\n上次测试日志:\n{log}")
            ok, log = run_tests(patch)
            if ok:
                return patch
            fails += 1
        # Échecs consécutifs : on repasse la main au modèle de planification pour réévaluer
        plan = ask(PLANNER, "执行连续失败,请根据日志修订方案。",
                   f"原任务:{task}\n原方案:{plan}\n失败日志:{log}")
    raise RuntimeError("多次重新规划后仍未通过验证")
🚀 Conseil pour démarrer rapidement : quand vous montez ce genre de prototype « planification + exécution », le plus simple est de récupérer un quota d’essai gratuit via APIYI apiyi.com. Une seule clé API suffit pour appeler OpenAI, Claude, Gemini et les autres modèles phares ; pour basculer entre PLANNER et EXECUTOR, il suffit de changer une chaîne de caractères, ce qui rend la comparaison des combinaisons très rapide.
Analyse d’impact d’Antigravity Orchestrator : quelles tâches de développement sont les plus adaptées
Impact pour les développeurs
- Développement de fonctionnalités classiques : la répartition en trois phases — planification, implémentation, tests — est claire, et c’est le scénario le plus typique pour Orchestrator.
- Correction de bugs sur plusieurs fichiers : Planner identifie la cause racine, Hydrogen modifie plusieurs fichiers et lance les tests pour valider ; en cas d’échec, le dossier revient à Planner pour décision.
- Refactorisation de complexité moyenne : l’approche reste pilotée par le modèle de planification, tandis que les nombreuses modifications concrètes sont confiées au modèle d’exécution, ce qui évite que le modèle haut de gamme se perde dans des éditions mécaniques.
- Gestion des quotas plus proactive : pour les abonnés, traiter les tâches quotidiennes avec Orchestrator permet de réserver davantage de crédits aux travaux qui demandent vraiment une réflexion approfondie.
Impact pour le secteur
- Le duo « planificateur + exécuteur » devient un modèle produit : les fournisseurs de modèles commencent à intégrer directement la collaboration multi-modèles dans les outils de développement, au lieu de laisser les utilisateurs tout orchestrer eux-mêmes.
- Des indicateurs d’évaluation plus variés : au-delà du taux de réussite, la consommation de quotas et le temps de complétion apparaîtront de plus en plus dans les comparaisons d’outils Agent.
Recommandations de choix de scénario pour Orchestrator
| Type de tâche | Mode recommandé | Raison (d’après les recommandations officielles de Google) |
|---|---|---|
| Ingénierie courante avec collaboration multi-phases : planification, développement, tests, retouches | Orchestrator | Le modèle haut de gamme n’intervient qu’aux points clés |
| Architecture de système distribué complexe, migration entre dépôts | Modes autonomes Carbon ou Argon | Chaque étape clé exige une réflexion approfondie |
| Mise à jour de dépendances, écriture de tests, refactorisation simple, scripts et documentation | Mode autonome Hydrogen | Besoin clair, priorité à l’efficacité d’exécution |
| Gros travaux parallélisables ou nécessitant une relecture croisée | Subagents, Swarm, etc. | Besoin de plusieurs agents plutôt que de plusieurs modèles |
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que Google Antigravity Orchestrator ?
C’est la fonction d’orchestration multi-modèles d’Antigravity. Dans une session Agent, Carbon ou Argon joue le rôle de planificateur, Hydrogen celui d’exécuteur, et les relais s’effectuent dynamiquement selon le déroulement de l’exécution.
Q2 : Quelle est la différence entre Orchestrator, Swarm et Subagents ?
Avec Orchestrator, il n’y a toujours qu’un seul Agent ; ce qui change, ce sont les modèles utilisés à chaque étape. Des fonctions comme Swarm et Subagents lancent plusieurs Agents pour traiter des sous-tâches en parallèle ou se contrôler mutuellement ; elles conviennent aux gros travaux que l’on peut découper.
Q3 : Une économie de 24 % sur le quota équivaut-elle à 24 % d’économie sur la facture ?
Non. Les 24 % correspondent à la variation moyenne de la consommation de quota Antigravity dans le test comparatif officiel de Google, par rapport à l’utilisation de Carbon seul. Le coût réel dépend de l’abonnement, du type de tâche, du nombre de tentatives, etc. ; on ne peut pas le transposer directement en montant de facture.
Q4 : Le test officiel utilise-t-il Terminal-Bench 4.0 ou 4.1 ?
Les deux annonces officielles ne portent pas la même référence : l’aperçu publié par Google et l’annonce officielle en chinois indiquent 4.0, tandis que l’annonce dédiée à Antigravity indique 4.1. Les chiffres d’amélioration donnés sont identiques dans les deux cas ; cet article utilisera donc uniformément l’expression « test comparatif officiel sur des tâches en terminal ».
Q5 : Sans abonnement Antigravity, comment tester une répartition similaire entre planification et exécution ?
Vous pouvez reproduire ce fonctionnement dans votre propre Agent en suivant l’exemple de cet article. Inscrivez-vous sur APIYI apiyi.com pour obtenir des crédits d’essai gratuits, utilisez l’interface compatible OpenAI, définissez `base_url` sur `https://api.apiyi.com/v1`, puis indiquez séparément le modèle de planification et le modèle d’exécution.
Q6 : Quelles sont les limitations connues d’Orchestrator ?
Premièrement, le niveau de réflexion est figé et ne peut pas être ajusté séparément ; deuxièmement, les utilisateurs Pro ne peuvent actuellement utiliser que le mode Argon ; troisièmement, les chiffres d’efficacité proviennent des tests officiels et n’ont pas encore été reproduits de manière indépendante ; quatrièmement, au début du déploiement, certains comptes ont vu des modèles disponibles alors que les appels échouaient. Si vous voulez d’abord comparer des combinaisons de modèles dans un environnement maîtrisé, la facturation à l’usage d’APIYI apiyi.com facilite les tests à petite échelle.
Google Antigravity Orchestrator : l’essentiel à retenir
- Définition : au sein d’une même session d’agent, Carbon / Argon planifient, Hydrogen exécute, avec un passage de relais dynamique.
- Mécanisme clé : en cas de validation échouée deux fois de suite, par exemple, la main revient au modèle de planification pour un nouvel arbitrage.
- Chiffres officiels : par rapport à Carbon utilisé seul, quota -24 %, vitesse +19 %, pour des performances de réussite comparables.
- Bonne lecture : consommer du quota ne signifie pas payer une facture, et les versions de référence des tests ne sont pas marquées de la même façon dans les deux annonces.
- Conditions d’accès : les abonnés Ultra disposent des deux modes, les Pro éligibles peuvent utiliser le mode Argon.
- Pour s’y mettre : on peut reproduire cette répartition des rôles dans son propre agent via l’interface unifiée d’APIYI apiyi.com.
En résumé
Les points essentiels de Google Antigravity Orchestrator :
- Répartir les rôles plutôt que remplacer : il ne s’agit pas de substituer un modèle bon marché à un modèle coûteux, mais de confier le jugement à Carbon / Argon et l’exécution à Hydrogen.
- Passage de relais dynamique : si une anomalie survient en cours d’exécution, on revient à la phase de planification ; c’est ce qui le distingue d’un routage de modèles à sens unique.
- Gains officiels : à performances de réussite proches de Carbon, les tests officiels affichent une réduction de 24 % du quota et un gain de 19 % en vitesse.
- Choisir selon la complexité : Orchestrator pour l’ingénierie multi-étapes classique, Carbon / Argon pour l’architecture approfondie, Hydrogen pour les tâches quotidiennes bien délimitées.
Pour la plupart des tâches de développement courantes, Orchestrator est une option par défaut raisonnable, qui concilie qualité et quota. Si vous souhaitez appliquer la même approche à vos propres produits, je vous recommande de tester rapidement différentes combinaisons de modèles via APIYI apiyi.com : la plateforme offre un quota gratuit et une interface unifiée multi-modèles.
📚 Ressources
- Blog officiel de Google Antigravity : Gemini 4 Hydrogen and Orchestrator
- Lien :
antigravity.google/blog/gemini-4-hydrogen-in-google-antigravity -
Description : annonce de la sortie d’Orchestrator et données de test officielles à 24 % / 19 %, benchmark référencé sous Terminal-Bench 4.1
-
Documentation Google Antigravity : Choose a Model / Orchestrator
- Lien :
antigravity.google/docs/models -
Description : mécanisme Planner / Executor, conditions de re-planification, exemples CLI et conseils pour choisir un modèle
-
Blog officiel de Google : Introducing Gemini 4 Hydrogen
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen -
Description : vue d’ensemble de la sortie de Hydrogen ; le même résultat comparatif y est référencé sous Terminal-Bench 4.0
-
Annonce officielle de Google en chinois : Gemini 4 Hydrogen
- Lien :
china.googleblog.com/2026/11/gemini-4-hydrogen.html -
Description : informations de publication en chinois, avec la même version de benchmark indiquée comme 4.0
-
Page tarifs de Google AI Studio : tarifs des API de la gamme Gemini
- Lien :
aistudio.google.com/docs/pricing -
Description : tarifs standard des API Hydrogen, Carbon et Argon, ainsi que les dates de changement de tarification
-
Explication des forfaits Antigravity et du quota partagé
- Lien :
antigravity.google/blog/changes-to-antigravity-plans - Description : système d’abonnements et de quotas
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI ; pour plus de ressources, rendez-vous sur le centre de documentation docs.apiyi.com