Note de l’auteur : quand vous appelez l’API de génération d’images, une réponse sans image ne veut pas dire que la requête a échoué, et encore moins qu’elle n’a pas été facturée. Cet article présente une méthode en 4 étapes (regarder d’abord la réponse, puis décider de réessayer ou non), avec du code Python prêt à l’emploi.
Quand on appelle une API d’images, il arrive que la requête parte, que l’API réponde, mais qu’on ne trouve aucune image dans le résultat. Beaucoup de gens pensent d’abord à un petit souci réseau et relancent aussitôt l’appel, voire écrivent une boucle qui enchaîne plusieurs tentatives. Cet article présente un ordre de traitement : regarder d’abord la réponse, puis décider de réessayer ou non. Il vous aidera à diagnostiquer correctement une génération d’images qui ne renvoie pas d’image.
Ce n’est pas un guide générique sur les tentatives multiples. Avec un modèle de génération d’images facturé à la requête, chaque appel peut entraîner un coût. Prenons l’exemple de gpt-image-2.6-all, disponible sur APIYI depuis le 2026-11-12 : il est facturé 0,025 $ par requête. Si vous relancez sans réfléchir après une réponse vide, vous payez une seconde fois.
Ce que vous allez retenir : après cette lecture, vous saurez quels éléments vérifier en premier quand aucune image n’est renvoyée, dans quels cas réessayer est possible et dans quels cas il ne faut surtout pas le faire, et comment intégrer cette logique dans votre code pour ne pas payer deux fois la même image.
Génération d’images sans image en retour : les points essentiels
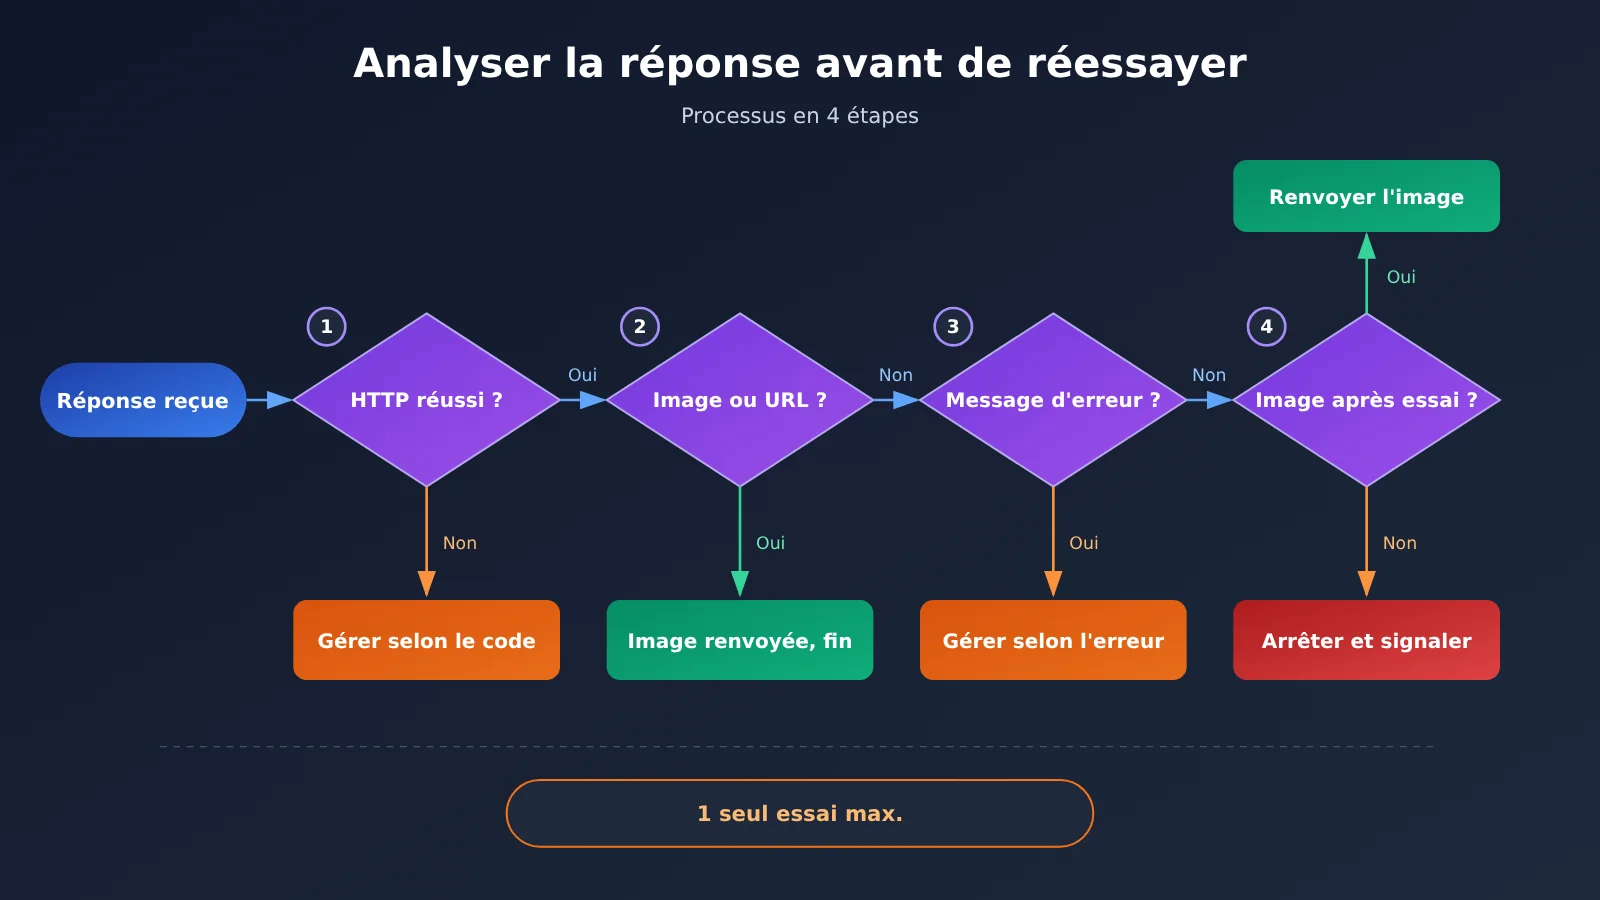
Commençons par la conclusion. Quand une requête de génération d’images ne renvoie pas d’image, il ne faut pas la classer d’office comme un problème réseau : il faut inspecter le contenu de la réponse dans un ordre précis. Le tableau ci-dessous résume les 4 étapes de la méthode.
| Étape | Ce qu’on vérifie | Si la réponse est non | Intérêt |
|---|---|---|---|
| Étape 1 | La requête HTTP a-t-elle réussi ? | Traiter selon le code d’état, sans passer aux étapes suivantes | Distinguer l’échec au niveau de la requête d’un problème de contenu |
| Étape 2 | La réponse contient-elle des données d’image ou une URL d’image ? | Passer à l’étape 3 | Si l’image est là, on s’arrête : plus de nouvelles tentatives inutiles |
| Étape 3 | La réponse contient-elle un message d’erreur ? | S’il y a une erreur, la traiter comme telle | Éviter de payer en boucle pour une requête vouée à l’échec |
| Étape 4 | Pas d’image et pas d’erreur confirmés | Réessayer une seule fois | Garder le surcoût dans une limite prévisible |
Pourquoi on ne réessaie pas tout de suite quand aucune image n’est renvoyée
Une requête de génération d’images n’est pas comparable à une simple conversation textuelle : chaque appel coûte plus cher, et le résultat n’est souvent pas « tout ou rien ». Il se peut que le serveur ait déjà terminé la génération et que votre code n’ait simplement pas lu l’image dans le bon champ. Il se peut aussi que la requête ait été rejetée, avec la raison écrite noir sur blanc dans la réponse. Dans le premier cas, réessayer tout de suite vous fait payer deux fois la même image ; dans le second, vous payez à répétition une requête qui échouera à coup sûr.
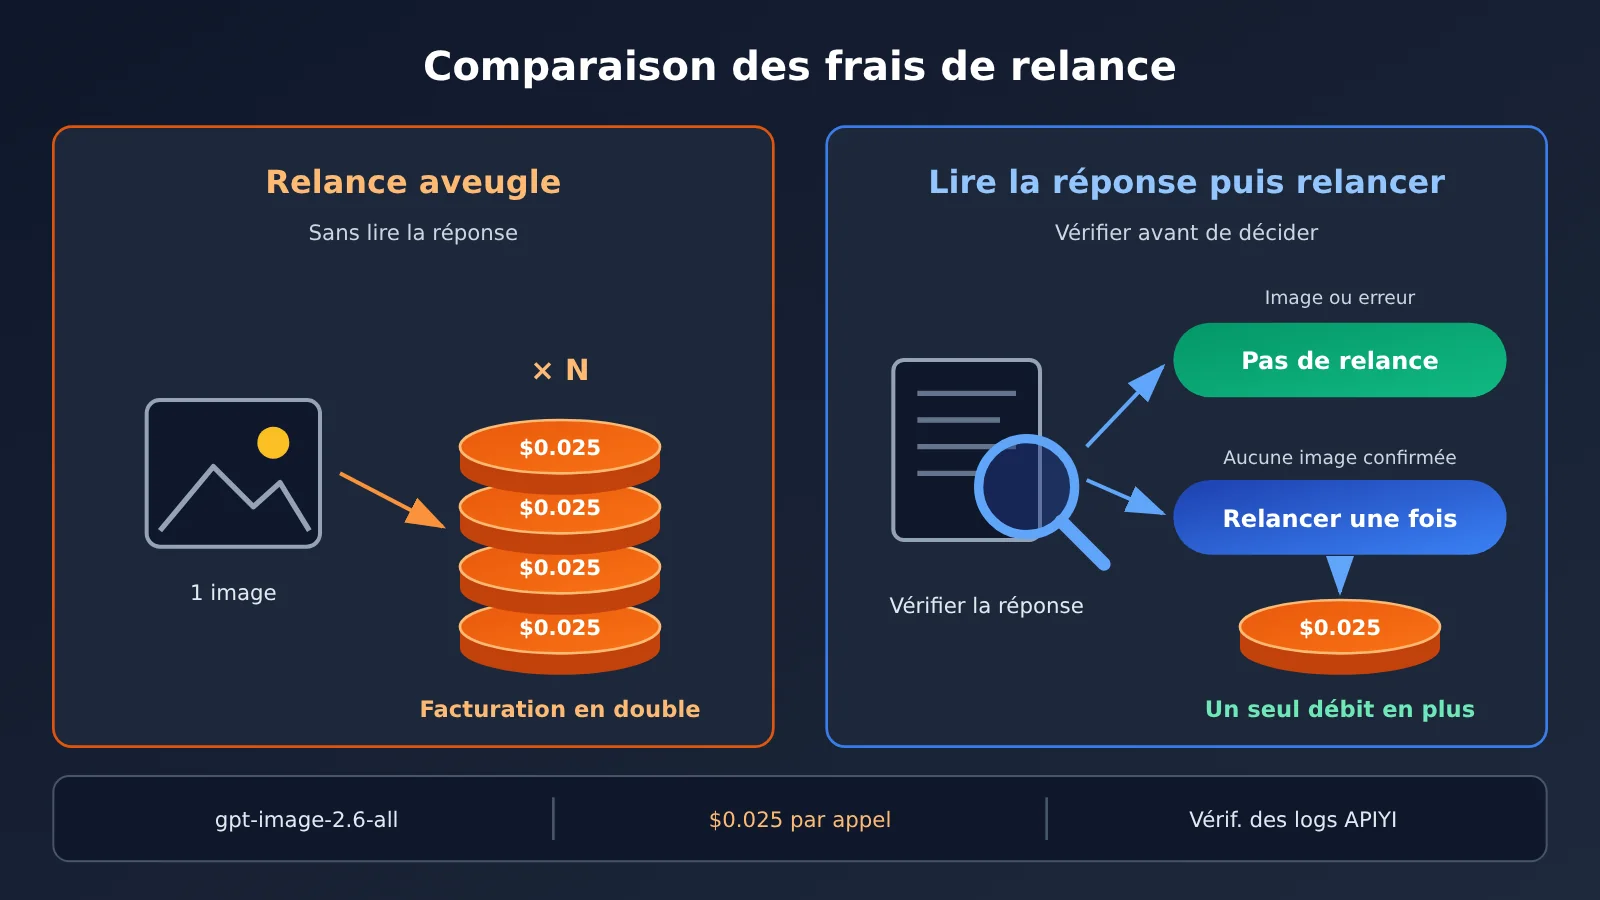
Prenons le tarif à l’appel de gpt-image-2.6-all, soit 0,025 $. Chaque nouvelle tentative à l’aveugle coûte 0,025 $ de plus. Si vous traitez une réponse vide comme une micro-coupure réseau et que vous bouclez, 3 tentatives représentent 0,075 $ de trop, sans doute pour aucune image exploitable. Lire la réponse avant de réessayer, c’est donc faire une vérification quasi gratuite avant de dépenser.
La logique de décision : lire la réponse avant de réessayer
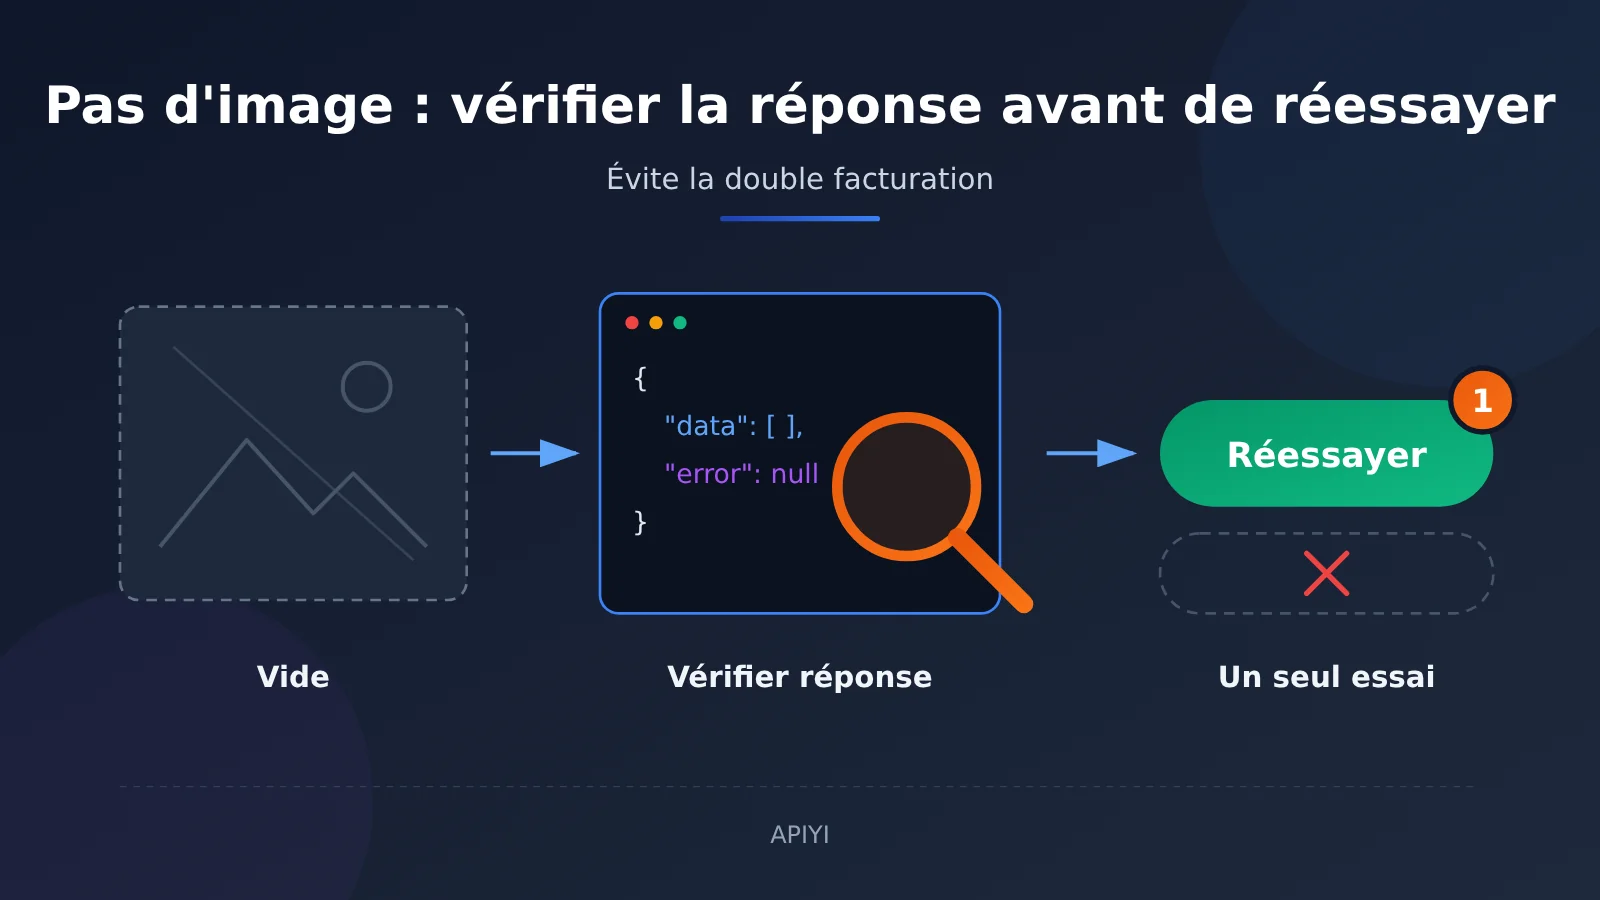
Le principe de l’ordre de vérification, c’est d’aller « de l’extérieur vers l’intérieur ». Le code d’état HTTP est le signal le plus externe : il indique si la requête a été traitée normalement. Les données d’image sont ce que vous cherchez vraiment, on les contrôle donc juste après. Le message d’erreur, c’est la raison de l’échec fournie par le serveur lui-même ; il passe avant toute nouvelle tentative. Ce n’est qu’une fois les trois premiers niveaux passés en revue, avec la certitude qu’il n’y a ni image ni explication d’erreur, que réessayer a un sens.
Un détail souvent négligé : à l’étape 2, on cherche des « données d’image ou une URL d’image ». Selon le type d’interface, l’image ne se trouve pas au même endroit. Parfois elle est dans le champ b64_json ou url du tableau data, parfois le lien de l’image est écrit dans le texte content d’un message de conversation. Si votre code d’analyse ne gère qu’un seul de ces cas, il prendra pour vides des réponses qui contiennent bien une image : c’est l’une des causes les plus fréquentes de nouvelles tentatives injustifiées.
Décortiquer les réponses quand la génération d’images ne renvoie aucune image
Pour bien faire, il faut d’abord examiner la réponse avant de réessayer, et pour cela, savoir à quoi elle peut ressembler. Le tableau ci-dessous récapitule les types de réponses les plus courants et la façon de les traiter.
| Type de réponse | Caractéristiques typiques | Image déjà générée ? | Traitement recommandé |
|---|---|---|---|
| Échec au niveau de la requête | Code d’état HTTP hors 2xx | Non | Traiter selon le code d’état ; corriger les problèmes d’authentification ou de paramètres avant de renvoyer |
| Image générée normalement (structurée) | data contient b64_json ou url |
Oui | Récupérer directement l’image, ne pas réessayer |
| Image générée normalement (intégrée au texte) | Le content du message contient un lien vers l’image |
Oui | Extraire le lien avec une expression régulière, ne pas réessayer |
| Réponse « réussie » avec message d’erreur | HTTP réussi, mais le corps contient error ou une explication de refus |
Non | Lire la cause de l’erreur, modifier l’invite ou les paramètres |
| Vraie réponse vide | HTTP réussi, ni image ni erreur | Non | Enregistrer la réponse brute, puis réessayer une seule fois |
| Délai d’attente dépassé | Le client n’a reçu aucune réponse | Impossible à confirmer | Ne pas relancer automatiquement ; vérifier d’abord les journaux et la facturation |
Pourquoi un timeout exige aussi de regarder avant de réessayer
Le timeout est le cas qu’on met le plus facilement sur le compte d’une « instabilité réseau », alors que c’est précisément celui qui demande le plus de prudence. Un timeout côté client indique seulement que vous n’avez pas attendu la réponse, pas que le serveur n’a pas terminé la génération. La génération d’images prend du temps : si le délai configuré côté client est trop court, il est tout à fait possible que le serveur ait fini de générer l’image et facturé la requête, alors que votre programme avait déjà abandonné l’attente.
Dans ce cas, la bonne démarche consiste d’abord à allonger raisonnablement le délai d’attente. Ensuite, quand un timeout survient, il faut noter l’heure et les paramètres de la requête, puis aller vérifier dans les journaux d’appels de la console l’état réel de cette requête. Ne renvoyer manuellement la requête qu’après avoir confirmé qu’aucun enregistrement de succès n’existe est bien plus sûr que de laisser le programme enchaîner les tentatives automatiquement.
Une réponse contenant un message d’erreur se traite comme une erreur
Certaines réponses ont un statut HTTP de succès, mais le corps contient un objet d’erreur, ou bien le modèle explique dans son texte pourquoi il ne peut pas générer l’image, par exemple parce que l’invite a déclenché la modération de contenu. Ces réponses ne contiennent pas d’image, mais la cause y est clairement indiquée : renvoyer la même requête à l’identique donnera presque à coup sûr le même résultat.
La bonne approche est de lire le message d’erreur pour déterminer s’il s’agit d’un problème de paramètres, de contenu ou d’un incident temporaire côté serveur. Les problèmes de paramètres et de contenu nécessitent de modifier la requête avant de la renvoyer ; ce n’est que lorsque le message pointe clairement vers une panne temporaire qu’il faut envisager de réessayer, après un certain intervalle.
Image non renvoyée : lisez la réponse avant de relancer
Voici, en Python, comment intégrer cette logique de décision dans votre code. L’exemple utilise l’interface compatible OpenAI, avec le modèle gpt-image-2.6-all. Pour le point de terminaison exact et le format de retour, reportez-vous à la description de ce modèle dans la documentation d’APIYI.
Exemple minimal : vérifier la présence d’une image dès la réponse reçue
L’approche la plus simple consiste à contrôler le champ image juste après avoir reçu la réponse. S’il y a une image, on s’arrête là. Sinon, on passe à l’analyse :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Interface compatible OpenAI d'APIYI
)

resp = client.images.generate(
    model="gpt-image-2.6-all",
    prompt="一只坐在窗台上的橘猫,水彩风格",
)

item = resp.data[0] if resp.data else None
if item and (item.b64_json or item.url):
    print("已拿到图片,不要重试")
else:
    print("响应里没有图片,先打印原始响应再决定")
    print(resp.model_dump())
Ce code ne fait qu’une dizaine de lignes, mais il évite déjà l’erreur la plus courante : relancer la requête sans avoir regardé le contenu de la réponse. Les échecs au niveau HTTP, eux, sont signalés par le SDK sous forme d’exception. Vous pouvez les intercepter avec un try dans la couche externe et les traiter selon le code de statut, plutôt que de basculer directement dans une boucle de nouvelles tentatives.
Exemple complet : 4 étapes de vérification et un seul réessai au maximum
En production, je vous conseille d’utiliser la version ci-dessous, plus complète. Elle couvre la vérification du statut HTTP, l’analyse des deux emplacements possibles de l’image dans la réponse, la détection des messages d’erreur, l’absence de nouvel appel automatique en cas de timeout, et la limite « un seul réessai une fois l’absence d’image confirmée » :
import re
import requests

API_KEY = "YOUR_API_KEY"
BASE_URL = "https://api.apiyi.com/v1"  # Adresse unifiée de l'API APIYI
MODEL = "gpt-image-2.6-all"
IMG_URL_RE = re.compile(r"https?://\S+?\.(?:png|jpe?g|webp)", re.I)


def find_images(body):
    """Vérifie à la fois le champ structuré data et les liens d'images dans le content de la conversation"""
    images = []
    for item in body.get("data") or []:
        if item.get("url"):
            images.append(item["url"])
        elif item.get("b64_json"):
            images.append("base64-image")
    for choice in body.get("choices") or []:
        content = (choice.get("message") or {}).get("content") or ""
        images += IMG_URL_RE.findall(content)
    return images


def generate_with_check(prompt, max_retry=1):
    for attempt in range(max_retry + 1):
        try:
            resp = requests.post(
                f"{BASE_URL}/images/generations",
                headers={"Authorization": f"Bearer {API_KEY}"},
                json={"model": MODEL, "prompt": prompt},
                timeout=300,
            )
        except requests.Timeout:
            # Après un timeout, impossible de savoir si le serveur a déjà généré l'image et facturé : on ne relance pas automatiquement
            return {"status": "timeout", "action": "check_logs_first"}

        # Étape 1 : la requête HTTP a-t-elle réussi ?
        if resp.status_code != 200:
            return {"status": "http_error", "code": resp.status_code,
                    "detail": resp.text[:500]}

        try:
            body = resp.json()
        except ValueError:
            return {"status": "bad_json", "detail": resp.text[:500]}

        # Étape 2 : la réponse contient-elle des données d'image ou une URL d'image ?
        images = find_images(body)
        if images:
            return {"status": "ok", "images": images}

        # Étape 3 : s'il y a un message d'erreur, on le traite comme une erreur, sans réessayer
        if body.get("error"):
            return {"status": "api_error", "error": body["error"]}

        # Étape 4 : ni image ni erreur confirmées ; on ne réessaie qu'après avoir journalisé la réponse brute
        print(f"第 {attempt + 1} 次请求无图片,原始响应:{str(body)[:300]}")

    return {"status": "empty_after_retry", "action": "stop_and_report"}


result = generate_with_check("一只坐在窗台上的橘猫,水彩风格")
print(result)
Ce code repose sur quelques choix de conception importants. max_retry vaut 1 par défaut, ce qui signifie qu’une image coûte au maximum deux requêtes : le plafond de coût reste donc prévisible. La branche du timeout retourne directement au lieu de continuer la boucle, car en cas de timeout on ne peut pas savoir si la requête a déjà été facturée. Enfin, chaque réponse jugée vide est affichée telle quelle, ce qui vous permet de déterminer a posteriori s’il s’agissait d’un problème d’analyse de votre côté ou si le serveur n’a vraiment pas produit d’image.
🚀 Démarrage rapide : si vous voulez d’abord valider cette logique de vérification dans un environnement de test, vous pouvez obtenir un crédit de test gratuit via APIYI (apiyi.com). Avec une seule clé API, vous pouvez invoquer gpt-image-2.6-all ainsi que d’autres grands modèles courants, et faire tourner le processus de vérification avant de l’intégrer à votre application en production.
Coût des réessais à l’aveugle quand la génération d’image ne renvoie pas d’image
Avant d’écrire la logique de vérification dans votre code, beaucoup de gens n’ont pas une idée concrète de ce que coûte le « on réessaie quelques fois ». Prenons le tarif de gpt-image-2.6-all, à $0.025 par requête, et comparons deux stratégies : enchaîner les appels à l’aveugle, ou examiner la réponse avant de réessayer. On regarde la dépense supplémentaire pour une seule image.
| Stratégie | Nombre max. de requêtes par image | Surcoût dans le pire des cas | Risque |
|---|---|---|---|
| Aucune vérification, 1 nouvel essai en cas d’échec | 2 | $0.025 | On peut payer deux fois pour une requête qui avait déjà produit une image |
| Aucune vérification, boucle de 3 essais | 4 | $0.075 | On paie à répétition pour une requête vouée à l’échec |
| Aucune vérification, boucle jusqu’à obtenir une image | Indéterminé | Sans plafond | Facturation continue en cas de refus lié à la modération de contenu |
| Examen de la réponse, puis 1 nouvel essai si aucune image | 2 | $0.025 | Surcoût uniquement en cas de réponse réellement vide |
À première vue, « examiner la réponse puis réessayer » et « réessayer une fois en cas d’échec » ont le même surcoût dans le pire des cas. Mais ils ne se déclenchent pas dans les mêmes conditions. Dans le premier cas, vous ne dépensez ces $0.025 que si vous avez confirmé qu’il n’y a ni image ni message d’erreur. Dans le second, vous payez aussi lorsque l’image a bien été générée mais que son analyse a échoué, ou lorsque le contenu a été refusé, et ce pour un résultat nul.
Quand on passe à de la génération d’images en lot, l’écart se multiplie. Ces $0.025 de trop par image, multipliés par le volume de requêtes quotidien, représentent une dépense tout à fait évitable.
Référence des interfaces et modèles : quand la génération d’images ne renvoie aucune image
Selon le modèle et le type d’interface, l’image ne se trouve pas toujours au même endroit dans la réponse. Cela influe directement sur la fiabilité du diagnostic de l’étape 2. Le tableau ci-dessous récapitule les formats de réponse courants et les points à vérifier, pour vous aider à confirmer que votre code d’analyse ne laisse pas passer d’image.
| Format de réponse | Emplacement de l’image | Points clés pour l’analyse | Plateformes disponibles |
|---|---|---|---|
| Interface de génération d’images (URL) | data[].url |
Le lien peut avoir une durée de validité limitée : téléchargez et enregistrez l’image dès que vous la recevez | APIYI apiyi.com, selon la documentation du modèle |
| Interface de génération d’images (Base64) | data[].b64_json |
Décodez le contenu puis écrivez-le dans un fichier, et ne le confondez pas avec une chaîne vide | Idem |
| Image intégrée dans l’interface de conversation | choices[].message.content |
Utilisez une expression régulière pour extraire l’image ou le lien au format Markdown | Idem |
| Réponse en streaming | Contenu complet obtenu après assemblage des fragments | Attendez la fin du flux et l’assemblage complet avant de vérifier la présence d’une image | Idem |
La réponse en streaming est un autre piège classique qui mène à de faux diagnostics. Si vous cherchez l’image dès le premier fragment reçu, vous ne trouverez évidemment rien. Quand la génération d’images ne renvoie aucune image, vérifiez bien que vous inspectez la réponse complète, et non un état intermédiaire.
FAQ : questions fréquentes
Q1 : Si la génération d’images ne renvoie aucune image, est-on forcément sûr de ne pas avoir été facturé ?
Non, pas forcément. La facturation dépend de la prise en charge de la requête par le serveur, pas du fait que votre code ait réussi à récupérer l’image. Un champ de réponse mal analysé, une réponse en streaming mal reconstituée ou un timeout côté client peuvent tous aboutir à une situation où vous êtes facturé sans avoir reçu d’image. Il faut donc examiner la réponse avant de relancer, plutôt que de supposer qu’il n’y a pas eu de débit et de réessayer à l’aveugle.
Q2 : Quelle différence entre « examiner la réponse avant de réessayer » et un retry classique avec backoff exponentiel ?
Le backoff exponentiel répond à la question « quand réessayer » : il convient aux limitations de débit et aux pannes temporaires côté serveur. Examiner la réponse d’abord répond à « faut-il réessayer ». Pour une requête de génération d’images facturée à l’unité, commencez par vérifier en 4 étapes qu’un nouvel essai est vraiment nécessaire, puis appliquez une stratégie de backoff pour choisir le bon moment. Les deux approches se suivent, elles ne se remplacent pas.
Q3 : Quand gpt-image-2.6-all a-t-il été mis en ligne, et à quel prix ?
gpt-image-2.6-all est disponible sur APIYI depuis le 2026-11-12, facturé 0,025 $ par requête. Avec une facturation à l’unité, chaque requête est tarifée indépendamment : relancer directement après une réponse vide, c’est payer une seconde fois. C’est précisément pour cela que cet article insiste sur l’examen de la réponse avant tout nouvel essai.
Q4 : Dans quels cas ne faut-il absolument pas réessayer quand aucune image n’est renvoyée ?
Il y a trois cas principaux :
– **La réponse contient un message d’erreur** : par exemple, l’invite a déclenché la modération de contenu ou un paramètre est invalide. Réessayer à l’identique donnera le même résultat.
– **La requête a expiré (timeout)** : impossible de savoir si le serveur a généré l’image et facturé. Vérifiez d’abord les journaux.
– **Erreur HTTP d’authentification ou de quota** : un nouvel essai ne changera rien, il faut d’abord corriger la clé API ou le quota.
Q5 : Comment vérifier rapidement que ma logique de décision est correcte ?
Je vous conseille de dérouler tout le flux dans un environnement de test :
1. Créez un compte sur APIYI (apiyi.com) pour obtenir une clé API et un quota de test gratuit.
2. Dans l’exemple complet de l’article, définissez `BASE_URL` sur `https://api.apiyi.com/v1`, puis appelez gpt-image-2.6-all.
3. Testez avec une invite normale, puis avec une invite susceptible d’être refusée, et observez le retour de chaque branche.
Une fois que chaque type de réponse arrive bien dans la bonne branche, vous pouvez l’intégrer à votre application en production.
Q6 : Après un nouvel essai, toujours pas d’image : que faire ?
Arrêtez les retries automatiques et conservez les réponses brutes des deux requêtes, leurs paramètres et leurs horodatages. Vérifiez d’abord que votre code d’analyse n’oublie pas le champ contenant l’image, puis consultez les journaux d’appels des deux requêtes dans la console. Si le serveur renvoie bien des résultats vides à la suite, contactez le support technique d’APIYI (apiyi.com) avec l’heure des requêtes et les réponses brutes : c’est plus efficace que de continuer à payer pour relancer.
Q7 : Comment maîtriser le coût des retries en génération d’images par lots ?
Donnez à chaque tâche de génération son propre compteur de tentatives et fixez la limite à 1 retry par tâche. Je recommande aussi de suivre le « taux de réponses vides » au niveau des tâches : si un lot en produit nettement trop, commencez par examiner les invites et la logique d’analyse, plutôt que d’augmenter globalement le nombre de tentatives.
Génération d’images sans image en retour : examinez la réponse avant de réessayer (points clés)
- Pas d’image ne veut pas dire pas de facturation : pour une requête de génération d’images facturée à l’unité, le serveur peut avoir déjà facturé dès lors qu’il a traité la demande.
- Un ordre de vérification fixe : statut HTTP → données d’image ou URL → message d’erreur → nouvelle tentative seulement une fois l’absence d’image confirmée.
- Une seule nouvelle tentative : si l’absence d’image est confirmée et qu’il n’y a pas d’erreur, ne réessayez qu’une fois. Le coût maximal reste prévisible.
- Pas de renvoi automatique après un timeout : un timeout ne permet pas de savoir si l’image a été générée. Vérifiez d’abord les journaux, puis décidez d’un éventuel nouvel envoi.
- Analysez tous les emplacements possibles : contrôlez à la fois le champ
dataet lecontentde la conversation, pour ne pas prendre à tort une réponse pour vide. - Le coût des nouvelles tentatives à l’aveugle est réel : avec gpt-image-2.6-all, chaque nouvelle tentative à l’aveugle coûte 0,025 $ de plus.
- Validez d’abord avec un quota de test : vous pouvez tester ce processus de vérification avec le quota de test gratuit d’APIYI (apiyi.com) avant la mise en production.
Conclusion
Quand une génération d’images ne renvoie pas d’image, voici l’essentiel à retenir avant de réessayer :
- Diagnostiquer avant de payer : examiner la réponse ne coûte presque rien, alors que chaque nouvelle tentative à l’aveugle est facturée.
- Suivre les 4 étapes dans l’ordre : la requête HTTP a-t-elle réussi ? Y a-t-il une image ? Y a-t-il une erreur ? Ce n’est qu’une fois l’absence d’image confirmée qu’on réessaie, une seule fois.
- Inscrire ces règles dans le code : limitez le nombre de tentatives, ne relancez pas automatiquement après un timeout et conservez la réponse brute. Ainsi, les coûts restent maîtrisés et les problèmes traçables.
Pour les développeurs qui utilisent des modèles d’images facturés à l’unité, cette méthode n’a rien de compliqué, mais elle évite concrètement de payer deux fois la même image. Nous vous conseillons de parcourir chaque branche dans un environnement de test, puis d’en faire l’enveloppe standard de vos appels de génération d’images.
Pour valider rapidement cette logique, passez par APIYI (apiyi.com) : la plateforme propose une interface compatible OpenAI et un quota de test gratuit. Une seule clé API suffit pour invoquer gpt-image-2.6-all et de nombreux autres modèles populaires.
📚 Références
- Centre de documentation APIYI : modes d’invocation du modèle et formats de réponse
- Lien :
docs.apiyi.com -
Description : consultez les points de terminaison d’appel et les champs de réponse de gpt-image-2.6-all ; c’est la documentation qui fait foi
-
Référence de l’API Images d’OpenAI : structure de réponse standard des interfaces de génération d’images
- Lien :
platform.openai.com/docs/api-reference/images - Description : pour comprendre le rôle des champs
urletb64_jsondans le tableaudata
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI. Vous trouverez d’autres ressources d’intégration dans le centre de documentation docs.apiyi.com