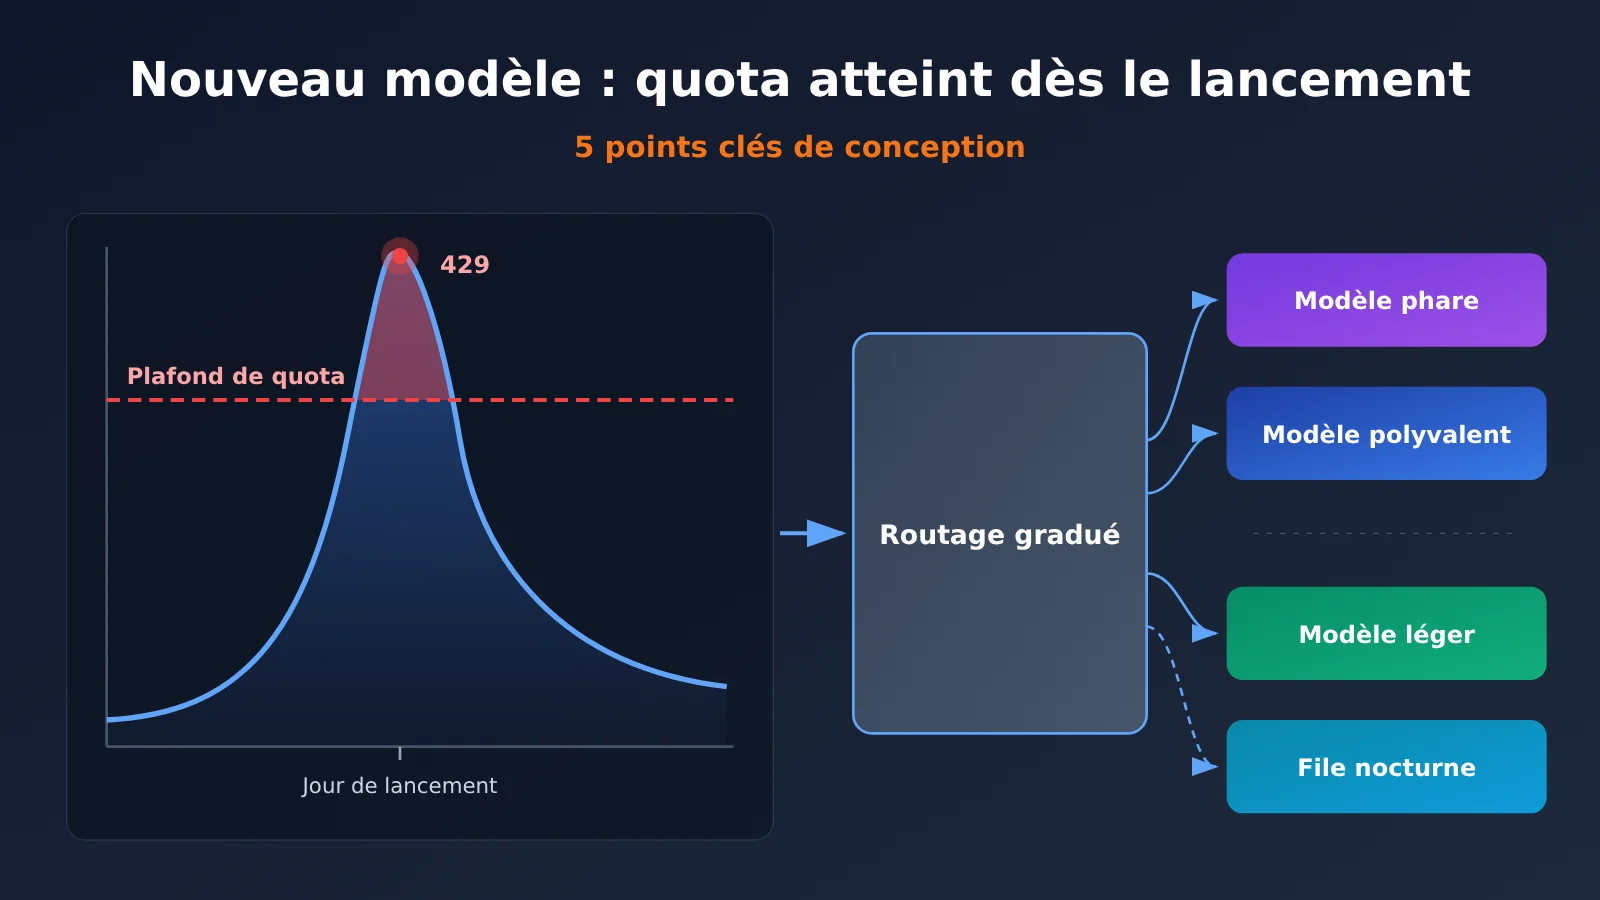
Note de l’auteur : le jour du lancement d’un nouveau modèle, il faut s’attendre à atteindre les plafonds d’utilisation, à subir des limitations de débit et à rencontrer des délais d’attente dépassés. Cet article présente 5 points de conception : la hiérarchisation des modèles, les correspondances de repli, les files d’attente prioritaires, la planification en heures creuses, ainsi que la surveillance et le budget. Vous y trouverez aussi une liste de vérification des capacités pour le jour du lancement.
En bref : atteindre les plafonds dès le lancement d’un nouveau modèle n’a rien d’un accident : c’est une conséquence prévisible du rythme des lancements. Les quotas gratuits attirent beaucoup d’essais, le trafic se concentre sur le jour du lancement et les fournisseurs ont besoin de temps pour augmenter leur capacité. Ensemble, ces facteurs rendent les tensions sur les capacités presque inévitables. Côté application, la bonne approche consiste à prévoir le basculement entre plusieurs modèles et la planification en heures creuses avant le lancement, plutôt que de multiplier les tentatives dès qu’une erreur 429 apparaît.
Cet article ne vous explique pas comment « ajouter quelques nouvelles tentatives ». Les nouvelles tentatives peuvent absorber de brèves fluctuations, mais elles ne résolvent ni l’épuisement des quotas ni la surcharge du fournisseur. Le jour du lancement, ce qui compte, ce n’est pas le nombre de tentatives, mais la hiérarchisation et la mise en file d’attente préparées en amont. À la fin de cet article, vous disposerez d’une méthode concrète pour concevoir votre capacité : hiérarchisation des modèles, correspondances de repli, files d’attente prioritaires, planification en heures creuses, surveillance et budget. Vous saurez aussi quand basculer, quand mettre en attente et quand arrêter.
Pourquoi les limites sont-elles souvent atteintes le jour du lancement d’un modèle ?
En bref : les limites sont atteintes parce que la demande explose d’un coup alors que l’augmentation de capacité prend du temps. Côté application, il faut concevoir le système en considérant cet événement comme prévisible.
Un exemple récent est celui de Hy4, de Tencent. Selon les déclarations publiques de l’entreprise, Hy4 a été lancé le 4 novembre sur WorkBuddy. Dès le premier jour, de nombreux utilisateurs ont atteint leur quota. Tencent a ensuite multiplié par dix la capacité de son cluster d’inférence et augmenté le quota gratuit. L’entreprise recommandait de passer à Hy3 en cas de limite atteinte ou de reporter les tâches non urgentes en soirée. Elle a également prolongé l’accès gratuit à Hy3 jusqu’au 15 novembre à 23:59.
Précision importante : cet incident concernait la couche produit de WorkBuddy et les quotas d’utilisation des utilisateurs finaux. Il ne peut pas être assimilé directement à une limitation de débit de l’API. Les quotas produit sont généralement calculés par compte ou par niveau d’abonnement, tandis que les limites API portent sur le débit et la concurrence par clé, organisation ou modèle. Leurs conditions de déclenchement et les façons d’y répondre sont donc différentes. Mais le phénomène observé reste général : dès qu’un nouveau modèle est lancé, la demande peut affluer massivement en très peu de temps.
La demande elle-même augmente aussi rapidement. Toujours le 4 novembre, DeepSeek indiquait que Harness comptait environ 1,54 million d’utilisateurs actifs par jour et consommait environ 92 000 milliards de tokens par jour. Ces chiffres sont déclarés par le fournisseur, et non vérifiés par un tiers : ils donnent un ordre de grandeur, mais ne constituent pas une base précise pour planifier la capacité. Ils suffisent néanmoins à montrer que les applications de type agent consomment bien plus de tokens qu’une conversation classique.
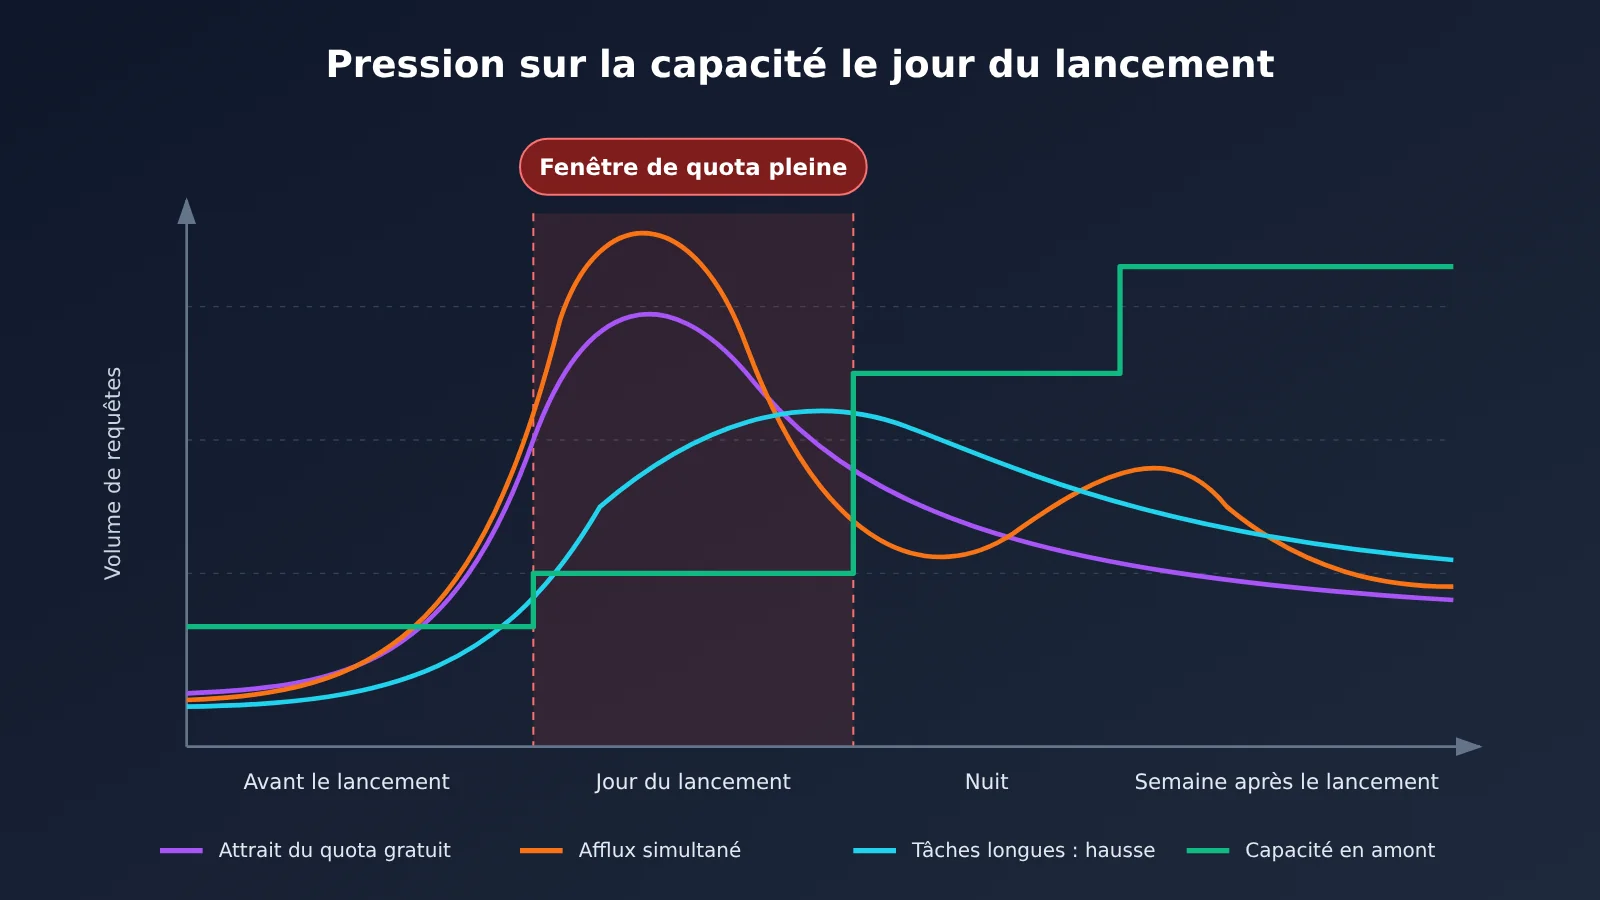
Quatre raisons pour lesquelles un nouveau modèle atteint ses limites
| Cause | Manifestation | Effet côté application |
|---|---|---|
| Quota gratuit ou d’essai | Les nouveaux modèles s’accompagnent souvent d’un quota d’essai, ce qui attire de nombreux utilisateurs en même temps | Le quota est rapidement épuisé, avec des erreurs 402 ou 429 |
| Accès simultanés | Le trafic du jour de lancement, des périodes promotionnelles et des journées de travail se cumule | Les pics peuvent atteindre 3 à 10 fois le niveau habituel |
| Occupation par les tâches longues | Agents à plusieurs tours, appels d’outils, contexte long | Chaque requête consomme beaucoup de tokens et mobilise longtemps les ressources d’inférence |
| Retard dans l’augmentation de capacité en amont | L’extension du cluster d’inférence prend du temps | Erreurs 5xx, files d’attente, délais d’expiration, voire fluctuations de la qualité des réponses |
Parmi ces quatre causes, l’application ne peut contrôler directement que la forme de ses propres requêtes et leur planification. Plutôt que d’espérer que le fournisseur en amont « tienne le coup », mieux vaut donc prévoir ses propres mécanismes de répartition du trafic et de mise en attente.
Cinq types de problèmes de capacité avec les nouveaux modèles
En bref : atteindre une limite n’est pas une erreur unique, mais cinq types de problèmes de capacité, qui demandent chacun un traitement différent.
Beaucoup d’équipes appliquent la même logique de nouvelle tentative à tous les échecs. C’est précisément ce qui peut aggraver un incident le jour d’un lancement. Si le quota est épuisé, les nouvelles tentatives continueront d’échouer. Si le fournisseur en amont est surchargé, des tentatives trop rapprochées risquent même d’accentuer la congestion. Le tableau ci-dessous distingue les cinq cas pour vous aider à concevoir une branche de traitement adaptée à chacun.
| Problème | Codes d’état typiques | Cause | Traitement |
|---|---|---|---|
| Quota épuisé | 402, 429 |
Quota gratuit ou d’essai épuisé, ou solde du compte insuffisant | Arrêter les nouvelles tentatives, basculer vers un modèle de secours ou demander un réapprovisionnement |
| Limite de débit ou de concurrence | 429, souvent accompagné de Retry-After |
Limite de RPM, de TPM ou de requêtes simultanées dépassée pour une clé ou un modèle | Attendre selon Retry-After ; si l’attente dépasse le seuil fixé, basculer ou mettre en file d’attente |
| Capacité insuffisante en amont | 500, 502, 503, 529 |
Cluster d’inférence surchargé ou panne partielle | Effectuer quelques nouvelles tentatives avec un délai exponentiel, puis basculer vers un modèle de secours après plusieurs échecs consécutifs |
| Ressources occupées par des tâches longues | Délai d’attente dépassé, connexion interrompue | Échanges à plusieurs tours avec un agent, appels d’outils ou contexte long rendant une requête trop lourde | Découper les tâches, limiter le contexte et prévoir un pool de concurrence distinct pour les tâches longues |
| Concentration des pics | Mélange de 429 et de 5xx |
Cumul du trafic en journée, les jours de lancement ou pendant les événements | Utiliser une file d’attente prioritaire et répartir les tâches dans le temps ; reporter les tâches non urgentes |
Deux détails du tableau méritent d’être soulignés. Premièrement, 429 est ambigu : il peut signaler aussi bien un dépassement de débit qu’un quota épuisé. Pour trancher, il faut examiner le message d’erreur dans le corps de la réponse et Retry-After. Deuxièmement, un code de surcharge comme 529 indique que le service en amont est temporairement indisponible. Dans ce cas, réduire la fréquence des requêtes est plus efficace qu’accélérer les nouvelles tentatives.
Une fois les codes d’erreur distingués, les cinq points de conception qui suivent ont une base solide : dans quels cas basculer, mettre en file d’attente ou arrêter immédiatement.
5 points clés pour concevoir le basculement entre modèles et la planification hors pointe
En bref, ces cinq points répondent à cinq questions : « quel modèle utiliser, par lequel le remplacer, qui l’utilise en premier, quand l’utiliser et combien cela coûte ». Si l’un d’eux manque, le problème se révélera le jour du lancement.
Point clé 1 : répartir les modèles par niveau
Comment faire : répartissez les modèles en trois niveaux selon leurs capacités et leur coût : haut de gamme, polyvalent et léger. Associez ensuite les tâches métier à ces niveaux selon leur priorité et leur difficulté. Réservez le haut de gamme au raisonnement complexe et à la génération de code critique ; utilisez le niveau polyvalent pour les questions-réponses courantes, les résumés et les reformulations ; confiez au niveau léger les tâches simples comme la classification, l’extraction et la reconnaissance d’intentions. Lorsqu’un nouveau modèle est lancé, on lui confie généralement une partie seulement du trafic haut de gamme, plutôt que de remplacer entièrement le modèle en place.
Quand l’activer : la répartition par niveau est une configuration permanente, pas une mesure réservée aux pannes. Elle détermine au quotidien le modèle vers lequel chaque catégorie de tâches est dirigée. Le jour du lancement, il suffit d’ajuster les proportions.
Comment vérifier : pour chaque niveau, utilisez un ensemble fixe de tests et consignez le taux de réussite, la latence P95 et le coût en tokens par tâche. Vérifiez que la qualité ne baisse pas sensiblement lorsque le niveau léger prend en charge les tâches simples.
En pratique, le principal obstacle est souvent que chaque nouveau fournisseur apporte son propre SDK et sa propre clé API. Avec une plateforme d’agrégation comme APIYI apiyi.com, une seule clé API permet d’invoquer les modèles de plusieurs fournisseurs, dont OpenAI, Claude et Gemini. L’interface étant compatible avec le format OpenAI, il suffit de changer le nom du modèle pour configurer les niveaux, sans avoir à gérer séparément l’authentification et le client de chacun.
Point de conception 2 : correspondance avec les modèles de secours
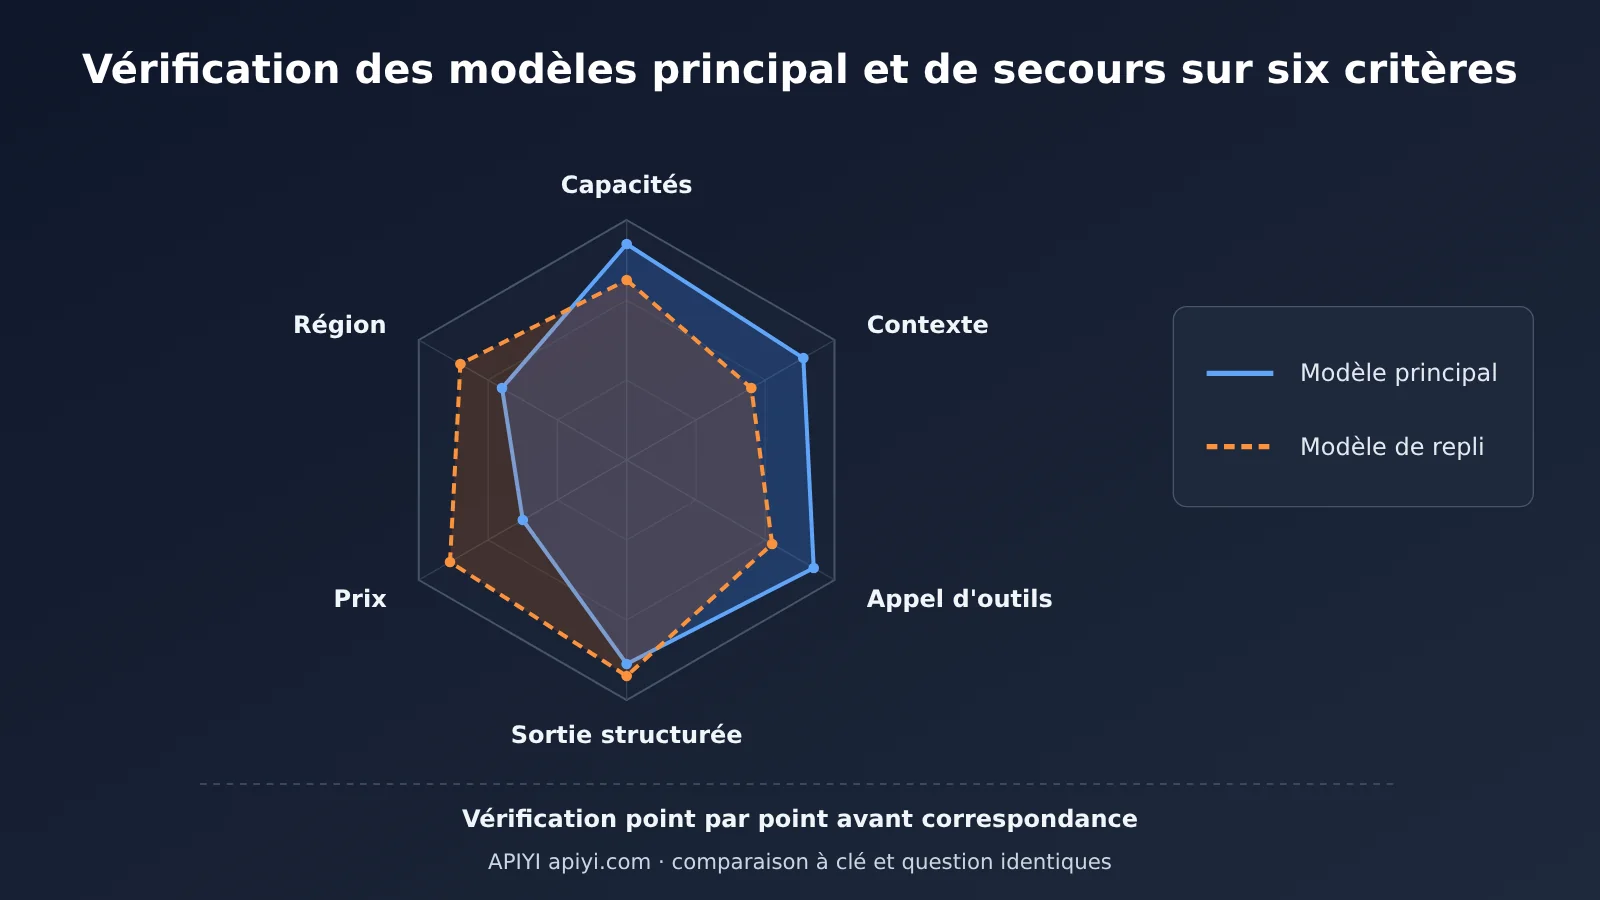
Comment procéder : désignez au moins un modèle de secours pour chaque modèle principal. Pour chaque correspondance, vérifiez six critères : le niveau de capacité, la longueur du contexte, la prise en charge des appels d’outils, la capacité à produire des sorties structurées, le prix et les régions de disponibilité. Les appels d’outils et les sorties structurées sont les critères les plus souvent oubliés : si le modèle de secours ne prend pas en charge le même format d’appel de fonctions, l’agent s’interrompra dès le basculement.
Quand déclencher le basculement : définissez des règles précises, par exemple deux erreurs 5xx consécutives, un Retry-After pour une erreur 429 supérieur au temps d’attente acceptable pour la tâche, une latence P95 durablement supérieure au double du niveau de référence ou une réponse indiquant explicitement que le quota est épuisé. Évitez de basculer à chaque échec : de simples fluctuations ponctuelles provoqueraient alors de nombreux basculements.
Comment vérifier : soumettez la même série de questions au modèle principal et au modèle de secours, puis comparez le taux de réussite, le taux de validation des sorties structurées et le taux de réussite des appels d’outils. Choisissez un autre modèle de secours si l’écart dépasse la tolérance de votre activité.
| Niveau | Tâches concernées | Modèle principal | Modèle de secours | Condition de basculement |
|---|---|---|---|---|
| Haut de gamme | Raisonnement complexe, code critique, planification d’agents | Nouveau modèle haut de gamme | Modèle haut de gamme de la génération précédente ou modèle équivalent d’un autre fournisseur | 2 erreurs 5xx consécutives ; Retry-After supérieur à 30 secondes pour une erreur 429 |
| Généraliste | Questions-réponses, résumés, reformulation, génération de rapports | Modèle généraliste principal | Modèle généraliste équivalent d’un autre fournisseur | Latence P95 supérieure au double du niveau de référence pendant 5 minutes |
| Léger | Classification, extraction, routage, reconnaissance d’intention | Modèle léger | Modèle léger d’un autre fournisseur | Taux d’erreurs 5xx supérieur à 5 % ; quota épuisé |
| Traitement par lots | Analyse hors ligne, annotation de données, évaluation | Tout modèle économique disponible | Pas de basculement, report direct | Pas de basculement immédiat, mise en file d’attente pour la nuit |
| Plateformes disponibles | Accès unifié pour tous les niveaux ci-dessus | APIYI apiyi.com, API officielles des fournisseurs | Idem | Voir la console et la documentation |
Les seuils du tableau sont donnés à titre d’exemple : adaptez-les aux niveaux de référence de votre activité.
💡 Conseil pour le repli : si vous ne souhaitez pas gérer toute la logique de basculement dans votre application, vous pouvez vous appuyer en partie sur les capacités de la plateforme. Selon sa description officielle, APIYI apiyi.com utilise un déploiement multi-nœuds, un routage intelligent, un repli automatique et un équilibrage de charge, ce qui peut réduire une partie de la pression en cas de panne partielle en amont. Consultez la documentation officielle pour connaître les conditions de déclenchement et les règles de basculement. Côté application, il reste recommandé de conserver vos propres correspondances avec des modèles de secours en dernier recours.
Point de conception 3 : files d’attente prioritaires
Comment faire : répartissez les requêtes en trois niveaux de priorité : les tâches payantes ou urgentes, les tâches internes et les traitements par lots. Les tâches urgentes passent directement par le modèle principal. Les tâches internes basculent vers un modèle de secours lorsque le modèle principal est occupé. Les traitements par lots entrent dans une file d’attente. Pour chaque file, définissez un niveau maximal de concurrence, une durée d’attente maximale et une stratégie de repli en cas de dépassement du délai. Vous éviterez ainsi qu’une tâche longue ne monopolise toute la capacité de traitement concurrent.
Quand l’activer : les files d’attente entrent en service lorsque le taux de réponses 429 du modèle principal ou la longueur de la file dépasse un seuil défini. Les requêtes de faible priorité cessent alors de monopoliser la capacité du modèle principal.
Comment le vérifier : les files d’attente doivent être observables. Vous devez au minimum suivre leur longueur, le temps d’attente moyen et le taux d’abandon. Lors des tests de charge, provoquez volontairement une limitation du débit du modèle principal, puis vérifiez que la latence des tâches urgentes reste stable et que les tâches de faible priorité sont mises en attente plutôt que de se solder par un échec.
Il y a une règle à respecter absolument : une requête non idempotente ne doit pas être réessayée automatiquement. Pour les opérations comme passer une commande, envoyer un message, écrire dans une base de données ou appeler un outil externe payant, vérifiez d’abord l’état après un échec. Assurez-vous que la tentative précédente a bien été prise en compte ou non avant de décider de la renvoyer. Vous pouvez générer une clé d’idempotence pour ces requêtes afin que le serveur élimine les doublons. Réessayer automatiquement toutes les erreurs est une cause fréquente de doubles facturations et d’écritures en double le jour de la mise en production.
Point de conception 4 : décaler les tâches hors des heures de pointe
Comment procéder : repérez les tâches qui peuvent attendre, comme les rapports hors ligne, les résumés par lot, l’annotation de données et les évaluations de régression. Exécutez-les la nuit ou pendant les heures creuses. Lorsque les limites de Hy4 sont atteintes, Tencent conseille notamment de reporter les tâches non urgentes en soirée. Cette approche s’applique aussi aux appels API.
Quand déclencher : deux méthodes peuvent être combinées. La première repose sur une plage horaire : les tâches par lot s’exécutent systématiquement pendant les heures creuses de la nuit. La seconde repose sur la charge : si le taux de 429 ou la latence P95 dépasse le seuil prévu pendant la journée, l’exécution de la file de traitement par lot est automatiquement reportée.
Comment vérifier : après le décalage, vérifiez si le volume de requêtes diminue aux heures de pointe en journée et si le taux de réussite des tâches nocturnes et le taux de nouvelles tentatives après échec restent acceptables. Une tâche décalée qui échoue peut être relancée, mais elle doit toujours respecter le principe d’idempotence.
Point de conception 5 : surveillance et budget
Comment procéder : ventilez la consommation par clé, par modèle et par type de tâche, au lieu de regarder uniquement le total. Même si celui-ci reste stable, la consommation de tokens d’une tâche d’agent peut avoir doublé ; seule une analyse par dimension permet de le voir. Prévoyez aussi un budget et des alertes temporaires pour le jour du lancement. Les seuils d’alerte peuvent être assouplis, mais le plafond budgétaire doit rester en place.
Quand déclencher : les règles d’alerte devraient couvrir quatre signaux : une hausse soudaine du taux de 429, une hausse soudaine du taux de 5xx, une consommation de tokens par tâche supérieure à la référence et un budget quotidien consommé au-delà d’un certain pourcentage.
Comment vérifier : avant le lancement, faites un essai avec un faible volume de trafic. Vérifiez que le tableau de bord ventile correctement les données et que les alertes arrivent dans les délais prévus.
| Indicateur | Dimensions à surveiller | Explication |
|---|---|---|
Taux de 429 |
Clé, modèle | Distinguer le dépassement de la limite de débit de l’épuisement du quota |
Taux de 5xx |
Modèle | Déterminer si le service en amont est surchargé et déclencher la bascule |
| Latence P95 | Modèle, type de tâche | Comptabiliser les tâches longues séparément pour éviter de fausser la référence globale |
| Longueur des files et temps d’attente | File prioritaire | Repérer une accumulation des tâches de faible priorité |
| Tokens/tâche, coût/tâche | Type de tâche | Les échanges à plusieurs tours d’un agent et les appels d’outils peuvent nettement augmenter ces valeurs |
| Nombre de bascules et taux de réussite du basculement | Correspondance principal-secours | Vérifier si le modèle de secours a réellement absorbé le trafic |
Pour suivre les coûts, vous pouvez vous appuyer sur les fonctions de la plateforme. La console APIYI apiyi.com permet de consulter la liste des modèles, la consommation, les factures et les journaux. Elle est utile pour vérifier les dépenses réelles par clé et par modèle le jour du lancement. En y ajoutant votre propre instrumentation par type de tâche, vous pouvez relier les montants dépensés à leur utilisation.
Pour estimer la capacité, partez du nombre d’utilisateurs actifs quotidiens, du volume de requêtes et du nombre moyen de tokens afin d’estimer le QPS de pointe. Appliquez ensuite un coefficient d’amplification pour les échanges à plusieurs tours des agents et les appels d’outils. Le pic du jour de lancement peut atteindre 3 à 10 fois le niveau habituel. Prévoyez donc une capacité de réserve de 30 % à 50 %, ou un modèle de secours vers lequel basculer à tout moment. Une estimation fondée uniquement sur les scénarios de conversation sous-estimerait fortement la consommation liée aux longs contextes et aux appels d’outils.
Changer rapidement de modèle : comment valider le basculement
En bref : une solution de secours qui n’a jamais été testée n’en est pas vraiment une. Validez le basculement avant la mise en production.
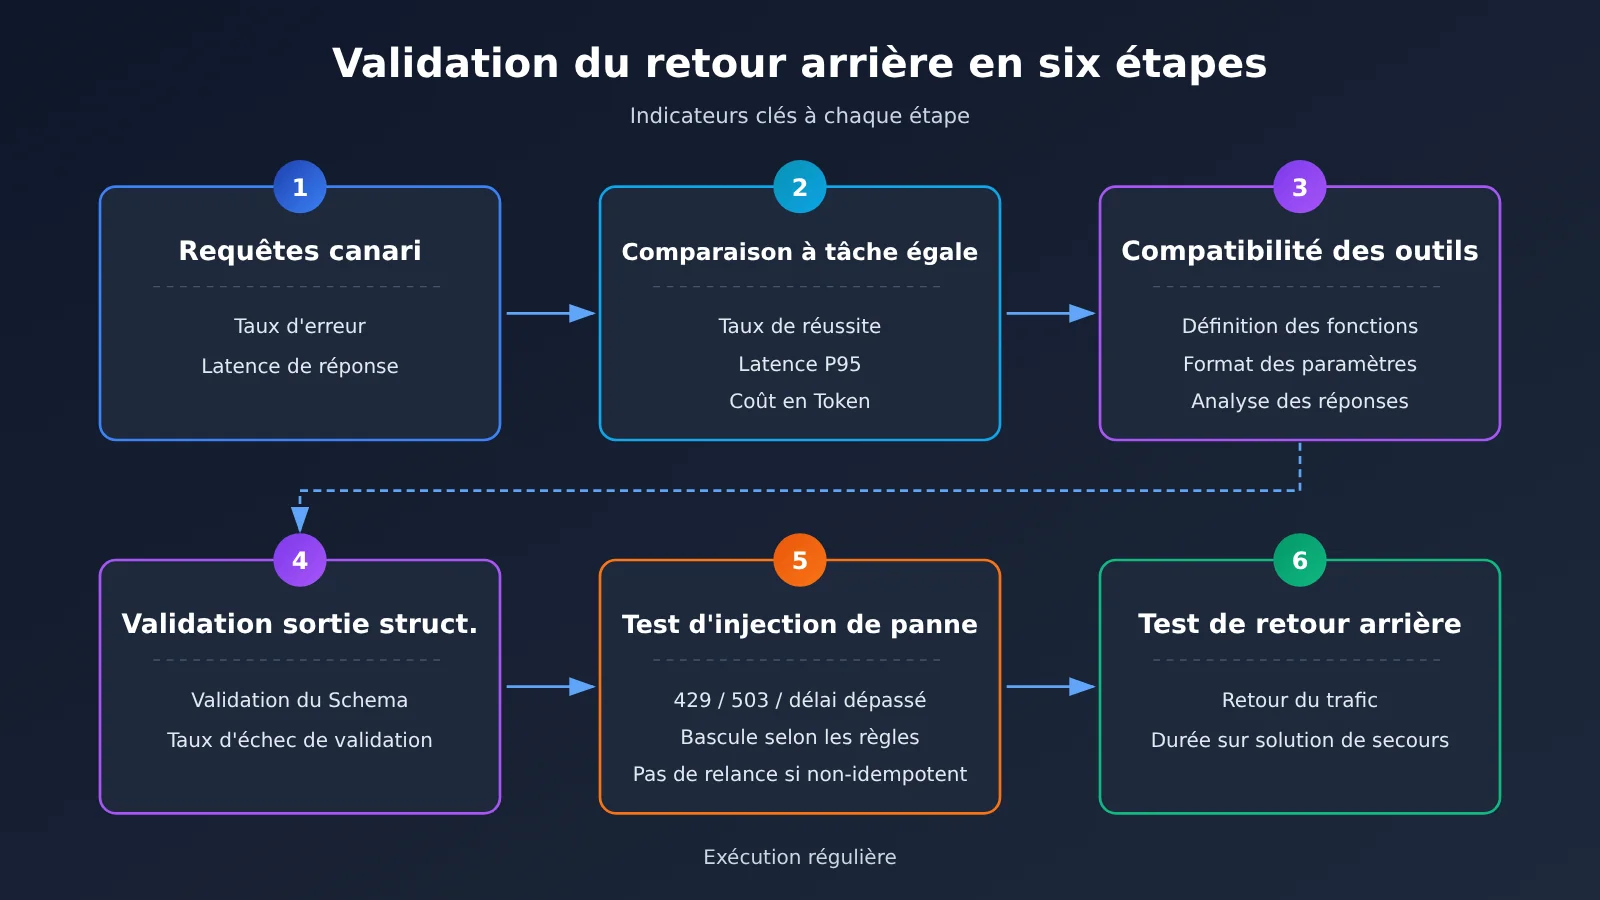
La modification côté intégration est assez simple. Si vous utilisez déjà un SDK compatible avec OpenAI, il suffit de définir base_url sur https://api.apiyi.com/v1 et de remplacer api_key par la clé fournie par la plateforme. Vous pourrez alors passer du modèle principal au modèle de secours en modifiant le paramètre model, sans ajouter de nouveau client. C’est surtout la validation qui demande du temps. Voici l’ordre recommandé :
- Requêtes canari : envoyez d’abord une petite partie du trafic réel vers le modèle de secours, puis surveillez le taux d’erreur et la latence.
- Comparaison sur les mêmes cas : exécutez un jeu d’évaluation fixe sur les deux modèles et comparez le taux de réussite, la latence P95 et le coût en tokens.
- Compatibilité des appels d’outils : vérifiez une par une les définitions de fonctions, le format des paramètres et l’analyse des réponses sur le modèle de secours.
- Validation des sorties structurées : validez les sorties JSON par rapport à un schéma et consignez le taux d’échec de validation.
- Exercice d’injection de pannes : simulez des erreurs
429,503et des délais d’attente dépassés. Vérifiez que le basculement se déclenche selon les règles et que les requêtes non idempotentes ne sont pas automatiquement réessayées. - Exercice de retour arrière : une fois le modèle principal rétabli, vérifiez que le trafic y revient comme prévu et ne reste pas trop longtemps sur le modèle de secours.
Mieux vaut répéter régulièrement ces exercices de basculement plutôt que de les effectuer une seule fois avant la mise en production. Les modèles en amont évoluent, tout comme vos invites et vos définitions d’outils : une correspondance validée il y a trois mois n’est pas forcément encore valable aujourd’hui.
🚀 Pour commencer : inscrivez-vous sur APIYI apiyi.com et récupérez vos crédits de test gratuits. Utilisez la même clé pour comparer les deux modèles sur les mêmes cas, puis décidez de la correspondance à appliquer le jour de la mise en production. Consultez la console et la documentation pour connaître les tarifs et la disponibilité des modèles.
Questions fréquentes (FAQ)
En bref : le jour du lancement, la plupart des questions se résument à ceci : « Identifier d’abord la nature de l’erreur, puis décider s’il faut changer de modèle, patienter dans une file d’attente ou arrêter les tentatives. »
Q1 : Faut-il anticiper la limitation du trafic côté application le jour du lancement d’un nouveau modèle ?
Oui, c’est conseillé. Définir à l’avance un nombre maximal de requêtes simultanées et une file d’attente prioritaire côté application offre plus de contrôle que de subir une limitation en amont avec des erreurs `429`. Vous pouvez ainsi choisir quels utilisateurs et quelles tâches sont prioritaires, alors qu’une limitation en amont ne tient pas compte de vos priorités métier. Pour fixer le seuil, vous pouvez partir de votre pic habituel et le multiplier par un facteur d’augmentation estimé.
Q2 : Faut-il changer de modèle dès qu’une erreur 429 apparaît ?
Pas forcément. Vérifiez d’abord `Retry-After` : si le délai reste acceptable pour la tâche, attendez avant de réessayer. S’il dépasse votre seuil, ou si la réponse indique clairement que le quota est épuisé, passez au modèle de secours. Avec APIYI apiyi.com, une seule clé API permet d’utiliser les modèles de plusieurs fournisseurs : il suffit de modifier le nom du modèle pour basculer. Vous pouvez donc définir des seuils plus précis, sans avoir à tout basculer dès la première erreur `429`.
Q3 : Comment mettre les tâches non urgentes en file d’attente ?
Prévoyez une file et un pool de requêtes simultanées distincts pour les tâches non urgentes, avec un temps d’attente maximal. Une fois ce délai dépassé, ne les abandonnez pas : reportez leur exécution à la nuit ou aux heures creuses. Surveillez la longueur de la file, le temps d’attente et le taux d’abandon. Les tâches en échec peuvent être relancées, mais pour les tâches non idempotentes, vérifiez d’abord leur état.
Q4 : Le basculement automatique vers un modèle de secours risque-t-il de réduire la qualité des résultats ?
C’est possible. Avant de basculer, comparez donc les modèles sur les mêmes questions pour vous assurer que l’écart de qualité reste acceptable pour votre activité. Selon la description officielle d’APIYI apiyi.com, le service prend en charge le basculement automatique et l’équilibrage de charge. Consultez toutefois la documentation officielle pour connaître les règles de basculement, et vérifiez les différences de résultats avec votre propre jeu d’évaluation. Pour les tâches sensibles à la qualité, mieux vaut attendre le modèle principal en file que basculer directement.
Q5 : Comment savoir si le quota du produit est épuisé ou si l’API limite les requêtes ?
Regardez où le message apparaît et à quel niveau la limite s’applique. Le quota d’un produit concerne une application destinée aux utilisateurs finaux, par exemple le quota de Hy4 dans WorkBuddy. Il est calculé par compte et se manifeste généralement par un message dans l’interface. La limitation de l’API apparaît dans la réponse de l’interface sous la forme d’une erreur `429`, éventuellement accompagnée de `Retry-After` ; elle s’applique par clé API, organisation ou modèle. Dans le premier cas, changez de modèle dans le produit ou attendez le renouvellement du quota. Dans le second, utilisez une stratégie d’attente progressive, une file d’attente et une correspondance vers un modèle de secours.
Points clés : bascule entre modèles et planification hors pointe
En bref : la stabilité le jour du lancement dépend de la hiérarchisation des modèles, des files d’attente et des budgets préparés à l’avance.
- La capacité risque d’être limitée : atteindre les limites de quota le jour du lancement d’un modèle est prévisible. Il faut l’anticiper dès la conception.
- Les erreurs doivent être classées :
402,429,5xxet les délais d’attente dépassés nécessitent chacun un traitement distinct. Une relance uniforme ne suffit pas. - La hiérarchisation précède la bascule : répartissez les tâches entre trois catégories de modèles : phare, généraliste et léger. Le nouveau modèle ne reçoit d’abord qu’une partie du trafic.
- Les modèles de secours doivent être vérifiés : confirmez leurs capacités, leur contexte, leurs appels d’outils, leurs sorties structurées, leur prix et leur disponibilité géographique.
- Ne relancez pas automatiquement les requêtes non idempotentes : après un échec, vérifiez d’abord leur état avant de décider de les renvoyer.
- Planifiez hors pointe : reportez les tâches qui peuvent attendre à la nuit et réservez la concurrence disponible en journée aux tâches urgentes.
- Décomposez le suivi par dimension : utilisez les journaux de consommation d’APIYI apiyi.com pour vérifier la consommation réelle par clé et par modèle.
Conclusion et liste de contrôle de capacité pour le jour du lancement
En bref : le jour du lancement, ce ne sont pas les tentatives répétées qui font la différence, mais la hiérarchisation et les files d’attente préparées en amont.
Si les limites de quota sont atteintes dès le lancement d’un nouveau modèle, c’est souvent à cause d’une combinaison de quotas gratuits, d’accès simultanés, de tâches longues et d’un retard dans l’augmentation de la capacité en amont. Côté application, vous pouvez hiérarchiser les modèles pour définir la destination par défaut des requêtes, prévoir des modèles de secours, protéger les tâches critiques avec une file d’attente prioritaire et lisser les pics grâce à la planification hors pointe. Le suivi et les budgets permettent ensuite de garder les risques et les coûts sous contrôle. La liste ci-dessous distingue les actions à mener avant et pendant le lancement ; vous pouvez l’utiliser directement pour la revue de mise en production.
| Étape | Point à vérifier | Critère de validation |
|---|---|---|
| Avant le lancement | Valider le modèle principal et le modèle de secours | Les deux modèles ont passé les tests comparatifs sur les mêmes tâches, ainsi que les vérifications des appels d’outils et des sorties structurées |
| Avant le lancement | Distinguer les codes d’erreur | 402, 429, 500, 503, 529 et les délais d’attente dépassés disposent chacun d’un traitement distinct |
| Avant le lancement | Ne pas relancer les opérations non idempotentes | Les opérations d’écriture et les appels d’outils payants ne sont pas relancés automatiquement ; leur état est vérifié après un échec |
| Avant le lancement | File d’attente prioritaire | Trois niveaux de priorité sont définis, avec une concurrence maximale, une durée d’attente maximale et une dégradation en cas de délai dépassé |
| Avant le lancement | Liste des tâches hors pointe | Les tâches par lots reportables à la nuit sont répertoriées et des règles de déclenchement selon la charge sont configurées |
| Avant le lancement | Exercices | Les exercices d’injection de pannes, de bascule et de retour arrière sont terminés et leurs résultats consignés |
| Jour du lancement | Suivi | Le taux de 429, le taux de 5xx, la latence P95 et la longueur de la file sont suivis par clé, modèle et tâche |
| Jour du lancement | Budget | Un budget temporaire et des alertes sont définis ; les seuils sont assouplis tout en conservant un plafond |
| Jour du lancement | Suivi des bascules | Le nombre de bascules et le taux de réussite du retour arrière sont suivis ; le retour au modèle principal se fait selon le plan une fois celui-ci rétabli |
| Jour du lancement | Communication avec les équipes métier | Les équipes métier sont informées à l’avance des retards et des dégradations possibles |
Si vous préparez le prochain lancement d’un modèle, vous pouvez utiliser APIYI apiyi.com pour tester le modèle principal et son modèle de secours avec une seule clé, puis définir votre budget à partir des journaux de consommation de la console et appliquer cette liste point par point.
📚 Ressources
En résumé : ces ressources permettent de vérifier les méthodes d’accès aux modèles et les capacités des plateformes. Pour les paramètres précis, consultez les dernières documentations officielles.
- Centre de documentation APIYI : liste des modèles, description des interfaces, consultation de l’utilisation et de la facturation
- Lien :
docs.apiyi.com -
À consulter : modèles disponibles, utilisation de l’interface compatible avec OpenAI et informations sur le basculement automatique
-
Codes d’erreur de l’API OpenAI : signification des erreurs de limitation du débit, comme
429, et conseils pour les traiter - Lien :
platform.openai.com/docs/guides/error-codes -
À consulter : distinction entre une limite de débit et un quota épuisé
-
Erreurs de l’API Anthropic : traitement des erreurs, notamment en cas de surcharge
- Lien :
docs.anthropic.com/en/api/errors - À consulter : signification de l’erreur de surcharge
529
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Pour plus d’informations sur l’intégration, consultez le centre de documentation docs.apiyi.com.