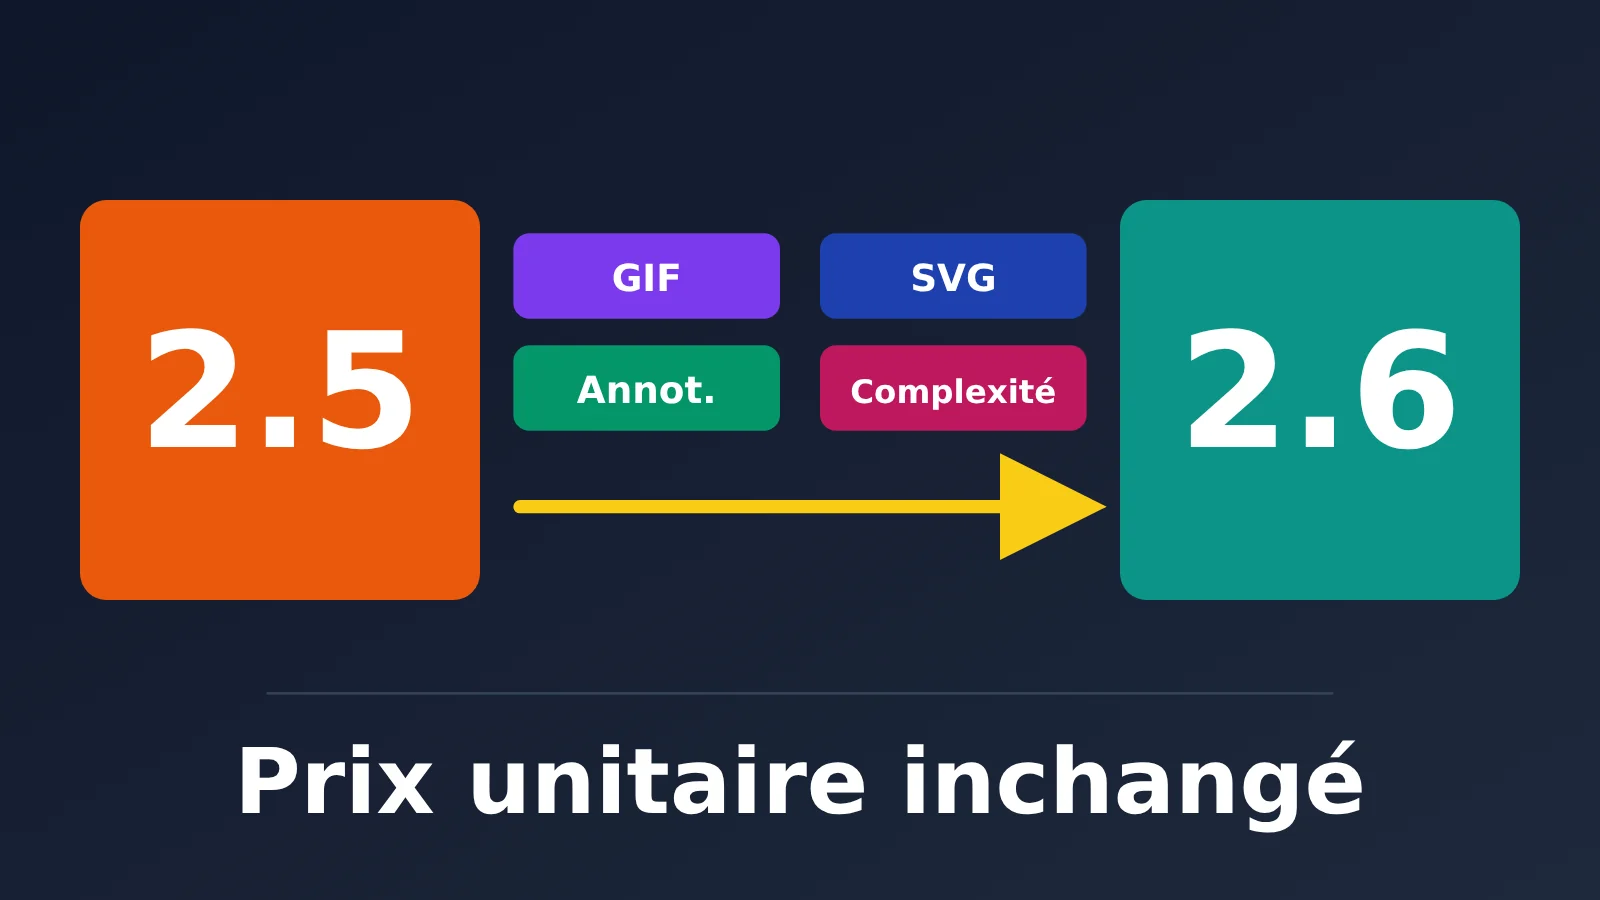
Note de l’auteur : GPT-Image-2.6 et GPT-Image-2.5 ont le même prix par token. La version 2.6 ajoute GIF, SVG, markup et complexity. Cet article distingue les déclarations officielles, les exemples tiers et les points encore inconnus pour aider les équipes qui utilisent déjà 2.5 à choisir : migrer tout de suite, faire tourner les deux versions en parallèle ou rester sur 2.5.
En bref : par rapport à GPT-Image-2.5, GPT-Image-2.6 apporte de nouvelles fonctionnalités et plus de vitesse, mais pas de saut générationnel en matière de qualité d’image. Parmi les quatre fonctionnalités ajoutées, GIF, SVG et complexity sont propres à 2.6, tandis que l’édition par annotations markup a été ajoutée aux deux versions. Les affirmations selon lesquelles le modèle serait « 50 % plus rapide » et offrirait une « meilleure cohérence des modifications » reposent uniquement sur les déclarations officielles : au 2026-11-05, aucun score indépendant vérifiable n’est disponible.
Côté coûts : les deux versions ont exactement le même prix par token. Mais cela ne signifie pas que le coût par image soit identique, ni que l’on puisse remplacer directement l’une par l’autre. Si le paramètre complexity n’est pas renseigné dans 2.6, sa valeur par défaut est high : cela augmente la latence et peut aussi modifier des éléments que vous souhaitiez conserver. Le véritable coût de la migration se situe donc dans votre propre processus de validation.
GPT-Image-2.6 face à GPT-Image-2.5 : chronologie et modèles des deux générations
GPT-Image-2.5 est sorti le 2026-09-08, date également utilisée pour son instantané par défaut. GPT-Image-2.6 a été lancé le 2026-11-04 en même temps que ChatGPT Images 2.6, soit à peine un jour avant la rédaction de cet article. Chaque génération ne compte que deux modèles, dont les identifiants ne diffèrent que par le numéro de version :
- 2.5 :
gpt-image-2.5-flare,gpt-image-2.5-sunburst - 2.6 :
gpt-image-2.6-flare,gpt-image-2.6-sunburst
Le rôle des deux modèles n’a pas changé. Flare privilégie la vitesse et la production d’images courantes, tandis que Sunburst mise sur les détails et la précision des modifications. La description officielle de la version 2.6 met toutefois l’accent sur deux points : les capacités de Flare en matière de mise en page d’affiches et d’images produit, et la cohérence de Sunburst lors de modifications successives aux niveaux de qualité medium et high. Autre détail facile à manquer : la page des modèles 2.5 indique « Highest » pour les performances et « Medium » pour la vitesse. Sur les pages des deux modèles 2.6, ces deux champs affichent « Not specified » : aucun classement officiel n’est fourni.
| Critère | GPT-Image-2.5 | GPT-Image-2.6 |
|---|---|---|
| Date de lancement | 2026-09-08 | 2026-11-04 |
| Modèles | flare / sunburst | flare / sunburst |
| Positionnement officiel | Priorité à la précision des modifications | Composition fine et workflows de retouche d’images |
| Performances et vitesse sur la page du modèle | Highest / Medium | Not specified |
| Endpoints pris en charge | v1/images/generations, v1/images/edits |
Identique |
| Niveaux de qualité | low / medium / high / xhigh / max / auto | Identique |
| Sortie GIF et SVG | Non prise en charge | Prise en charge (endpoint de génération uniquement) |
| Paramètre complexity | Aucun | low / medium / high, high par défaut |
| Modification par annotations markup | Prise en charge (ajoutée à cette occasion) | Prise en charge |
| Filigrane | C2PA | C2PA + filigrane invisible SynthID |
| Remise Batch | Oui, sortie d’image à $15/1M | Non précisée sur la page officielle du modèle |
Les deux générations ont exactement les mêmes limites côté endpoints : elles fonctionnent uniquement avec les endpoints de génération et de modification de l’Image API. Chat Completions, Responses, Realtime et Live ne sont pas pris en charge. Les règles de dimensions sont elles aussi identiques : les trois formats recommandés sont 1024×1024, 1536×1024 et 1024×1536. Pour les dimensions personnalisées, la largeur et la hauteur doivent être des multiples de 16, le rapport largeur/hauteur doit être compris entre 1:3 et 3:1, aucun côté ne doit dépasser 3840 et le nombre total de pixels doit se situer entre 655,360 et 8,294,400. Les dimensions supérieures à 2560×1440 sont considérées comme expérimentales.
Les quatre capacités réellement nouvelles de GPT-Image-2.6
En un coup d’œil, les principales différences entre 2.6 et 2.5 tiennent aux quatre capacités ci-dessous. Chacune a ses propres plages de paramètres et limites selon le point de terminaison. Vérifiez-les avant l’intégration pour éviter les erreurs dès l’envoi de la requête.
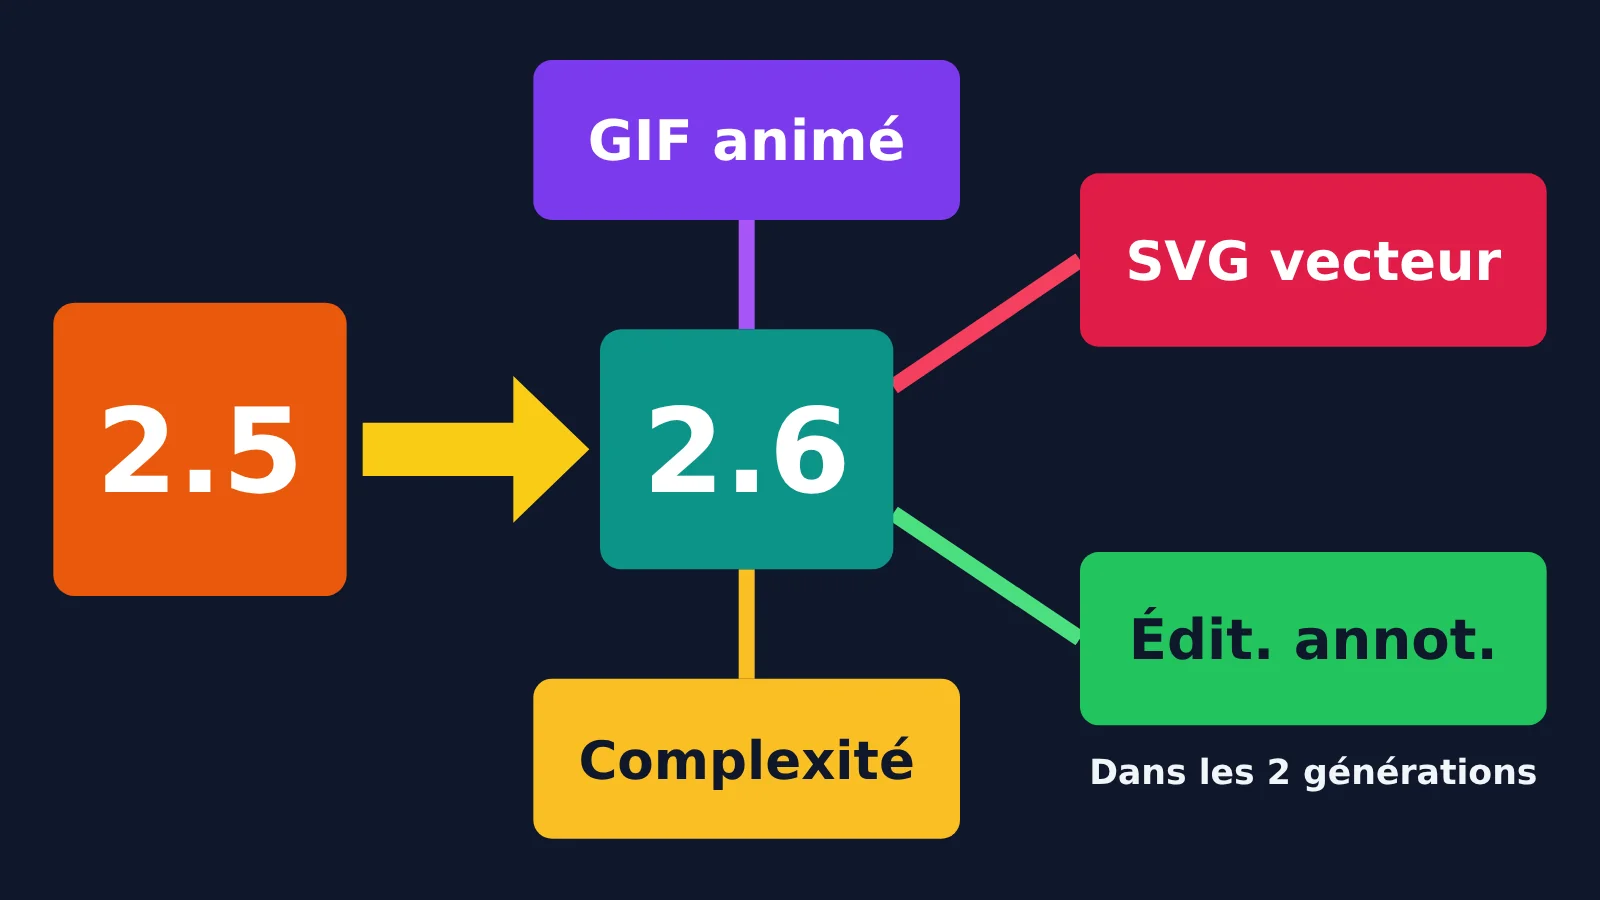
| Capacité | Paramètres clés | Points de terminaison disponibles | Principales limites | Disponible dans 2.5 |
|---|---|---|---|---|
| Sortie GIF | output_format=gif、frame_count 2–64、frame_duration_ms 20–2000 |
Génération uniquement | Ne prend pas en charge le streaming, les images partielles, la compression personnalisée ni prompt_rewriter |
Non |
| Sortie SVG | output_format=svg,n doit valoir 1 |
Génération uniquement | Ne prend pas en charge le streaming, les images partielles, output_compression ni prompt_rewriter |
Non |
| Édition par annotation markup | Calque d’annotation PNG transparent | Édition uniquement | Doit avoir les mêmes dimensions que la première image d’entrée ; ne peut pas être utilisé avec mask ou prompt_rewriter |
Oui |
| complexity | low / medium / high, par défaut high | Génération et édition | Contrôle uniquement la planification, pas les détails ; l’augmenter accroît la latence | Non |
Sortie GIF et SVG de GPT-Image-2.6
Voici les paramètres de sortie GIF. Toutes les plages de valeurs proviennent du guide OpenAI sur la génération d’images :
output_formatdéfini surgifframe_count: de 2 à 64, valeur par défaut : 9frame_duration_ms: de 20 à 2000, valeur par défaut : 200, arrondi à 10 millisecondes prèssize:auto, ou une largeur et une hauteur multiples de 16
La sortie SVG est elle aussi réservée au point de terminaison de génération. Définissez output_format sur svg ; n doit être égal à 1. Le résultat est un graphique vectoriel statique, sans script, ressource externe ni image bitmap intégrée. La facturation tient compte des tokens des images de référence et du SVG généré. Pour les équipes qui créent des icônes, des illustrations ou des éléments de marque, cela évite l’étape de conversion d’une image bitmap en vectoriel. En revanche, le point de terminaison d’édition ne prend pas en charge le SVG : impossible donc de modifier localement un SVG existant.
Les GIF sont aussi disponibles dans ChatGPT : ils peuvent être générés à partir d’une invite ou d’une photo téléversée. Selon The Verge et Android Authority, la vitesse de lecture est réglable de 0.5x à 2x et l’édition image par image est possible. Ce sont toutefois des fonctionnalités propres à ChatGPT : ne partez pas du principe que l’API permet elle aussi l’édition image par image.
markup et complexity : deux paramètres à connaître pour l’édition
L’édition par annotations markup passe par v1/images/edits : vous envoyez un PNG transparent comme calque d’annotation, sur lequel vous entourez ou coloriez les zones à modifier. Ce calque doit avoir les mêmes dimensions que la première image d’entrée. Chacun des deux fichiers est limité à 16,777,216 pixels, et le fichier d’annotation ne doit pas dépasser 50 MB. Le calque ne s’applique qu’à la première image d’entrée et ne peut pas être utilisé en même temps que mask ou prompt_rewriter. Cette fonctionnalité ayant aussi été ajoutée à la version 2.5, le seul besoin d’éditer par annotations ne justifie pas à lui seul de changer de version.
complexity est le paramètre auquel les équipes qui migrent doivent prêter le plus d’attention. Les valeurs possibles sont low, medium et high ; si le paramètre est omis, la valeur par défaut est high. Il détermine uniquement le niveau de planification du modèle : les détails du rendu et la fidélité restent contrôlés par quality. La documentation officielle précise que l’ajustement de complexity n’entraîne pas de frais supplémentaires à lui seul, mais qu’une valeur plus élevée augmente la latence et peut aussi introduire des modifications indésirables. Si vous transférez vos requêtes 2.5 vers la version 2.6 sans les modifier, vous activez automatiquement le niveau de planification le plus élevé.
GPT-Image-2.6 : vitesse et qualité, entre déclarations officielles et résultats non vérifiés
Côté vitesse, OpenAI affirme que 2.6 est 50 % plus rapide que son prédécesseur et que Flare peut générer une image en environ 6 secondes au mieux avec quality=low. Mais OpenAI ne précise pas les conditions du test derrière ces « 50 % » : dimensions, niveau de qualité ou inclusion du temps d’attente. Aucun tableau des vitesses par niveau n’est disponible non plus. Le seul test de vitesse tiers utilisable comme référence concerne 2.5 : le 25 octobre 2026, CellCog a testé 24 invites et mesuré un temps médian de 28,7 secondes par image pour GPT Image 2.5 au niveau high. Ce chiffre concerne 2.5 et ne permet pas de déduire le gain de vitesse de 2.6.
Côté qualité, seule la version 2.5 dispose encore de mesures indépendantes. Selon Artificial Analysis, consulté le 5 novembre 2026, 2.5 obtient 1 224 Elo sur AA-Image-T2I v2.1 (13 108 échantillons, première place) et 1 199 Elo sur AA-Image-Editing v2.1 (18 300 échantillons). À cette même date, 2.6 ne figure encore dans aucun des deux classements. La synthèse tierce d’OrcaRouter résume bien la situation : le modèle qu’on peut mesurer est l’ancien.
| Affirmation | Source | Niveau de preuve | Modèle concerné | Comment l’utiliser |
|---|---|---|---|---|
| 50 % plus rapide que le modèle précédent | OpenAI, source officielle | Déclaration officielle, sans conditions de test | 2.6 | Y voir une tendance et mesurer soi-même la latence |
| Environ 6 secondes pour Flare au niveau low | OpenAI, source officielle | Déclaration officielle | 2.6 Flare | Estimer la pertinence pour les usages en temps réel |
| Meilleure cohérence de Sunburst lors des retouches successives | OpenAI, source officielle | Déclaration officielle | 2.6 Sunburst | Vérifier impérativement sur ses propres cas de retouche |
| T2I : 1 224 Elo / retouche : 1 199 Elo | Artificial Analysis | Test indépendant, taille des échantillons publiée | 2.5 uniquement | Servir de référence pour la qualité de 2.5 |
| Temps médian de 28,7 secondes par image au niveau high | CellCog, 24 invites | Test indépendant, petit échantillon | 2.5 uniquement | Servir de référence pour comparer la latence |
| 2.6 Sunburst premier sur Image Arena | Publication de DesignArena sur X | Affirmation issue d’un seul classement tiers, sans score Elo vérifiable | 2.6 Sunburst | À titre indicatif seulement, pas comme base de décision |
| Score Elo indépendant et taux de réussite des GIF pour 2.6 | Pas encore disponible | Inconnu | 2.6 | Attendre la mise à jour des classements ou faire sa propre évaluation |
L’évaluation de sécurité mérite aussi une place dans la liste de vérification. La fiche système de 2.6 s’appuie sur 3 077 requêtes adversariales : pour Sunburst, le taux de sorties non conformes non bloquées est passé de 1,92 % à 1,72 % ; pour Flare, il est passé de 1,49 % à 2,14 %, une variation qui n’est pas statistiquement significative selon OpenAI. En revanche, le « taux de génération sûre » de Flare est passé de 78,36 % à 75,04 %, soit une baisse significative. OpenAI l’attribue principalement aux requêtes des catégories « Other » et « sexual ». Sa conclusion globale est que le niveau de sécurité reste comparable à celui de 2.5. Pour les activités soumises à des exigences de conformité élevées, ce point concernant Flare mérite un examen distinct.
Comparatif des prix de GPT-Image-2.6 : même tarif unitaire, coût par image potentiellement différent
Selon la grille tarifaire officielle d’OpenAI, consultée le 2026-11-05, les tarifs unitaires sont identiques pour les quatre modèles 2.5 flare, 2.5 sunburst, 2.6 flare et 2.6 sunburst :
- Entrée texte : $5/1M tokens, texte en cache : $1.25/1M tokens
- Entrée image : $8/1M tokens, image en cache : $2/1M tokens
- Sortie image : $30/1M tokens
Légende : grille tarifaire officielle d’OpenAI, source developers.openai.com/api/docs/pricing, consultée le 2026-11-05.
Le coût par image dépend du nombre de tokens de sortie, lui-même déterminé par le niveau de qualité. Le tableau ci-dessous présente les chiffres du calculateur officiel de 2.6 pour une image de 1024×1024. Ils couvrent uniquement la « sortie image », sans les tokens d’entrée ni les images partielles.
| Niveau de qualité | Tokens de sortie | Coût de sortie par image (USD) | Pour mille images (USD) | Cas d’usage |
|---|---|---|---|---|
| low | 823 | ≈ $0.02469 | ≈ $24.69 | Esquisses, aperçus en série |
| medium | 1,449 | ≈ $0.04347 | ≈ $43.47 | Images de produits courantes, visuels pour les réseaux sociaux |
| high | 1,756 | ≈ $0.05268 | ≈ $52.68 | Visuels destinés à une campagne |
| xhigh | 3,122 | ≈ $0.09366 | ≈ $93.66 | Affiches riches en détails |
| max | 7,024 | ≈ $0.21072 | ≈ $210.72 | Visuels clés, génération en très petites quantités |
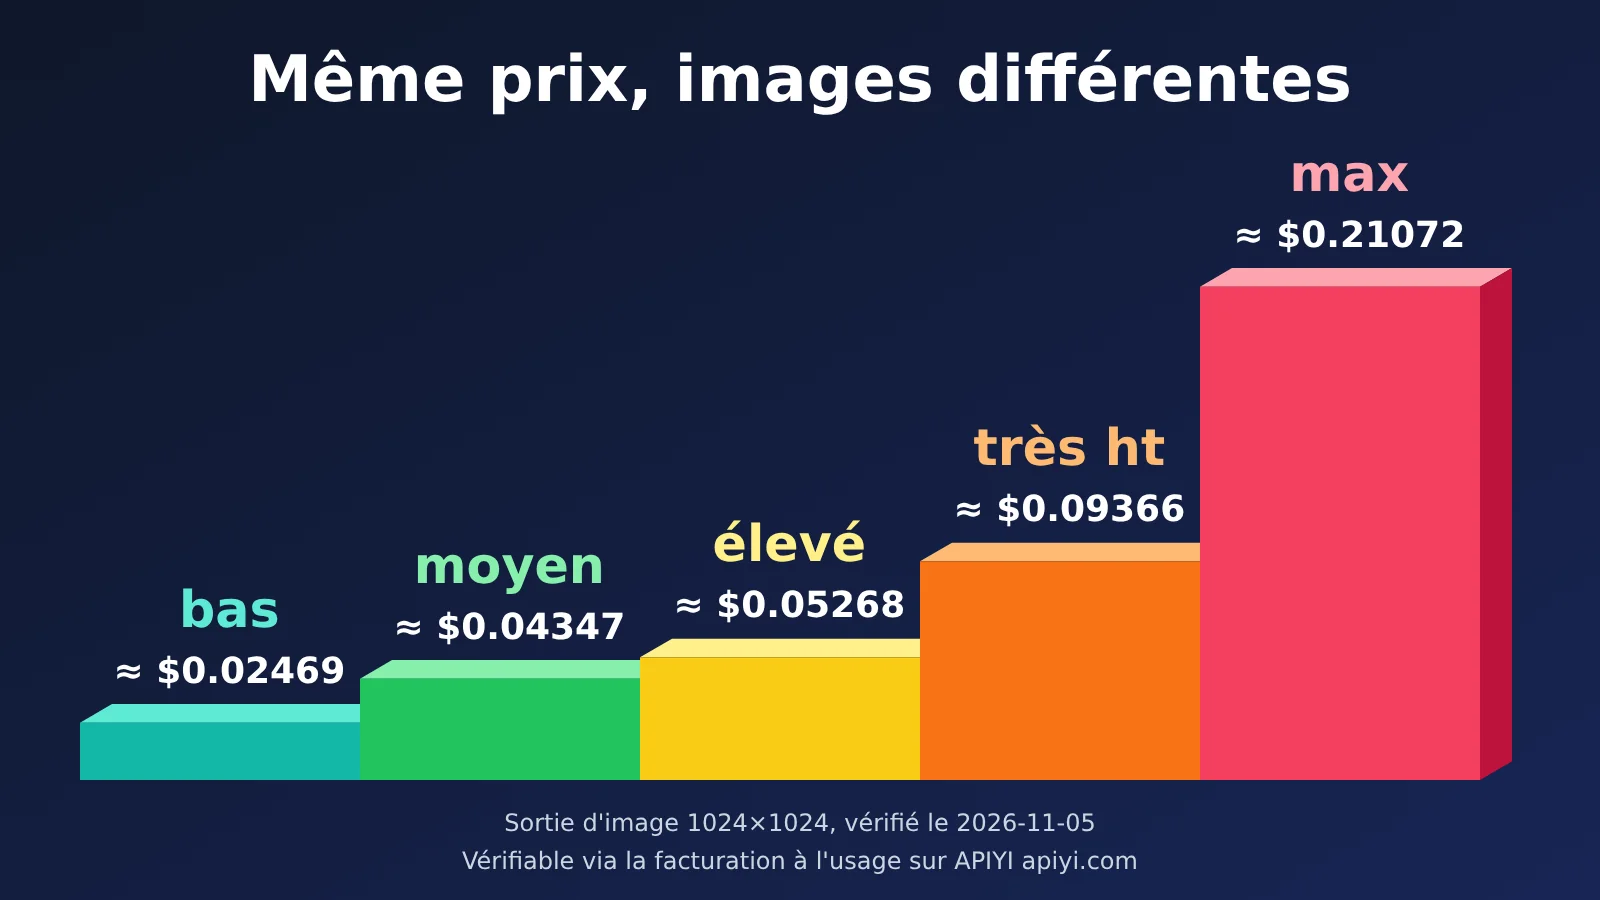
Ce tableau a trois limites à garder en tête :
- Il ne s’applique pas directement à 2.5 : la page du modèle 2.5 précise que le calculateur de GPT Image 2 n’estime pas sa consommation de tokens. Les chiffres du calculateur 2.6 ne valent donc que pour 2.6. À noter : AA indique environ $210.7 pour mille images avec 2.5 Sunburst, ce qui correspond au niveau le plus élevé.
- Pour les modifications, il faut aussi compter les entrées : OpenAI indique qu’à partir de gpt-image-2, les images d’entrée sont traitées en haute fidélité. Une demande de modification avec une image de référence consomme donc nettement plus de tokens d’entrée. Pour les deux générations, le tarif des images en entrée est de $8/1M.
- L’application du tarif Batch reste incertaine : la page tarifaire de 2.5 indique un tarif Batch de $15/1M pour les sorties image, mais la page du modèle 2.6 ne reprend pas cette précision. OpenAI n’a pas non plus communiqué le nombre de tokens de sortie de 2.6 pour les formats 1536×1024 et 4K.
Sur APIYI apiyi.com, les deux modèles 2.6 sont facturés à l’usage, selon les mêmes tarifs qu’OpenAI : entrée à $5/1M tokens, sortie à $30/1M tokens et lecture du cache à $1.25/1M tokens, selon les tarifs consultés le 2026-11-05. La liste des modèles de la plateforme fait référence pour les modèles et leurs prix ; vous pouvez la consulter sur docs.apiyi.com/models.
GPT-Image-2.6 ou GPT-Image-2.5 : trois règles pour choisir selon votre équipe
Règle n° 1 : si vous avez besoin des nouvelles fonctions ou si c’est votre première intégration, passez directement à 2.6. Si vous avez besoin de GIF animés, d’icônes ou d’illustrations SVG, ou encore de réduire la latence avec complexity, 2.5 ne propose pas d’équivalent. Les équipes qui intègrent l’API d’image d’OpenAI pour la première fois peuvent aussi commencer directement avec 2.6 : le prix unitaire est identique et elles n’ont pas à adapter de procédure de validation existante.
Règle n° 2 : si vous avez déjà une chaîne d’édition avec 2.5, testez d’abord les deux versions en parallèle. Pour les équipes qui retouchent des images de produits en plusieurs étapes ou travaillent sur la cohérence des personnages et les affiches de marque, les critères de validation de 2.5 sont déjà bien établis. Quant à la « meilleure cohérence » de 2.6, elle repose pour l’instant uniquement sur les déclarations officielles. Soumettez le même lot d’entrées aux deux générations, avec un premier essai où complexity est explicitement réglé sur low, puis un second sur high. Décidez ensuite de la part à migrer en fonction du taux de validation.
Règle n° 3 : si vous dépendez de la remise Batch ou avez des exigences de conformité élevées, restez sur 2.5. Les équipes qui génèrent de gros volumes d’images hors ligne et dont le modèle de coûts repose sur le tarif Batch de 15 $/1M devraient attendre la confirmation officielle de la politique Batch de 2.6 avant de migrer. Les activités qui exigent un taux de génération sécurisé élevé et utilisent principalement Flare devraient aussi examiner la baisse notable de performance de Flare indiquée dans la fiche de sécurité du modèle avant de décider.
Pour réaliser des tests A/B simplement, le mieux est de conserver les deux générations sur une même plateforme. APIYI, sur apiyi.com, propose à la fois les modèles 2.5 et 2.6 : utilisez la même clé API, définissez base_url sur https://api.apiyi.com/v1, puis modifiez seulement l’ID du modèle pour passer de l’un à l’autre. Pour 2.5, il existe aussi deux modèles facturés à l’appel, gpt-image-2.5-all (0,025 $/appel) et gpt-image-2.5-vip (0,03 $/appel), pratiques pour comparer les coûts à l’appel et à l’usage.
Lors de la migration, trois cas d’usage méritent d’être testés en priorité : l’édition en plusieurs étapes, les affiches contenant du texte et les images de produits sur fond transparent ou uni. Ils correspondent aux limites communes reconnues officiellement : la cohérence peut varier d’une génération à l’autre, le rendu du texte peut encore comporter des erreurs et les compositions sensibles à la mise en page peuvent manquer de précision.
| Point à vérifier | Méthode | Critère de validation / risque à surveiller |
|---|---|---|
Valeur par défaut de complexity |
Définir explicitement complexity dans toutes les requêtes 2.6 |
Éviter la latence et les modifications superflues liées à la valeur high par défaut |
| Cohérence des éditions successives | Modifier la même image de départ pendant 3 à 5 étapes et comparer les deux générations | Le sujet, les couleurs et le logo restent cohérents |
| Affiches avec texte | Tester des titres en chinois et en anglais, ainsi que des prix chiffrés | Aucun caractère ni chiffre incorrect, et mise en page stable |
| Images de produits sur fond transparent ou uni | Comparer les contours, les ombres et les reflets | Contours de détourage nets, image prête à être publiée |
| Latence et délai d’expiration | Relever les P50 / P95 selon les dimensions et le niveau de qualité réellement utilisés | Délai d’expiration d’au moins environ 2 minutes |
| Nouveaux formats de sortie | Utiliser uniquement le point de terminaison de génération pour GIF et SVG, avec n=1 |
Les requêtes au point de terminaison d’édition échouent : prévoir leur routage en amont |
| Calcul des coûts | Comptabiliser séparément les entrées et les sorties, sans utiliser le calculateur 2.6 pour estimer 2.5 | Calculer séparément le coût des entrées pour les requêtes d’édition |
| Conformité et filigrane | Réexaminer les performances de blocage de Flare et confirmer que SynthID n’a pas d’impact en aval | Respecter le seuil de sécurité de l’activité |
💡 Conseil : si vous ne savez pas quelle catégorie vous correspond, commencez par générer 20 à 50 images pour chacun des trois cas d’usage clés de la liste de vérification de migration. Avec APIYI apiyi.com, utilisez la même clé pour appeler les deux générations de modèles en parallèle et comparer les taux de réussite, la latence et les coûts. Ce sera plus pertinent pour votre activité que n’importe quel classement.
GPT-Image-2.6 et GPT-Image-2.5 : questions fréquentes et bilan
FAQ sur GPT-Image-2.6
Q1 : La version 2.5 sera-t-elle retirée après le lancement de la 2.6 ?
Au 2026-11-05, OpenAI n’a annoncé aucune date de retrait pour la 2.5 : son cycle de vie reste donc inconnu. Pour l’instant, les deux générations coexistent et sont toutes deux proposées sur APIYI apiyi.com. Pas besoin de migrer dans la précipitation par crainte d’un retrait.
Q2 : Peut-on utiliser les formats GIF et SVG avec l’interface d’édition ?
Non. Les formats GIF et SVG ne peuvent être utilisés qu’avec `v1/images/generations` ; le point de terminaison d’édition ne prend en charge ni l’un ni l’autre. Par ailleurs, OpenAI n’a pas encore publié de données sur le taux de réussite réel, la taille des fichiers et le temps de traitement des GIF via l’API. Mieux vaut donc faire un test sur un petit échantillon avant de les utiliser à grande échelle.
Q3 : Faut-il réécrire les invites existantes de la 2.5 ?
Pas besoin de tout réécrire d’emblée, mais il faut d’abord régler complexity. Lors d’une migration à l’identique, sa valeur par défaut est high, ce qui peut entraîner des modifications indésirables. Commencez par la définir explicitement sur low ou medium, puis comparez les résultats des deux générations sur le même jeu d’invites. Ajustez ensuite uniquement celles qui présentent des écarts. Vous pouvez effectuer cette comparaison avec une seule clé API sur APIYI apiyi.com.
Q4 : Le niveau max vaut-il encore le coût avec la 2.6 ?
En 1024×1024, la génération d’images au niveau max coûte environ 0,21072 $ par image, soit près de 4 fois le prix du niveau high. Ce niveau convient à un petit nombre de visuels importants, mais pas à la production en masse. Comme complexity n’est pas facturé séparément, essayez d’abord le niveau high avec une valeur complexity plus élevée pour voir s’il répond à vos besoins. Si ce n’est pas suffisant, passez à max.
Q5 : L’édition par annotations markup est-elle réservée à la 2.6 ?
Non. La 2.5 et la 2.6 prennent toutes deux en charge markup, avec les mêmes restrictions : le calque d’annotation doit être un PNG transparent de même largeur et de même hauteur que la première image d’entrée, et ne peut pas être utilisé en même temps que mask ou prompt_rewriter. Inutile de changer de génération uniquement pour profiter de l’édition par annotations.
GPT-Image-2.6 : points clés
- Nature de la mise à niveau : plus de fonctionnalités et de rapidité, sans saut générationnel dans la qualité des images.
- Même tarif unitaire : pour les deux générations, 5 $/1M de tokens en entrée et 30 $/1M en sortie, vérifié le 2026-11-05.
- Exclusif à 2.6 : GIF, SVG et complexity ; markup est disponible dans les deux générations.
- Limites des données : les scores Elo de 1,224 / 1,199 concernent 2.5 ; 2.6 n’a pas encore de score indépendant.
- Risques de migration : complexity vaut high par défaut ; la prise en charge de Batch par 2.6 reste inconnue.
- Validation : commencez par tester trois cas d’usage : édition en plusieurs étapes, affiches avec texte et images de produits.
GPT-Image-2.6 face à GPT-Image-2.5 : en résumé
En bref : si vous avez besoin de GIF ou de SVG, choisissez 2.6. Si vous disposez déjà d’un processus d’édition bien établi, faites d’abord tourner les deux versions en parallèle. Si vous dépendez de Batch ou avez des exigences de conformité élevées, restez pour l’instant sur 2.5. Voici les trois actions à mener :
- Définir explicitement complexity : transmettez ce paramètre dans toutes les requêtes 2.6, sans dépendre de la valeur par défaut high.
- Tester les trois cas d’usage : édition en plusieurs étapes, affiches avec texte et images de produits. Consignez le taux de réussite et la latence P95.
- Comptabiliser les coûts séparément : suivez les tokens d’entrée et de sortie séparément, et n’utilisez pas le calculateur 2.6 pour estimer le coût de 2.5.
Nous recommandons de passer par APIYI apiyi.com pour comparer les deux générations en A/B avec une même clé API. Appuyez-vous sur vos propres échantillons pour décider, plutôt que sur des classements qui ne sont pas encore disponibles.
Références
- Page des modèles OpenAI – GPT-Image-2.6 Flare : présentation du modèle 2.6
- Lien :
developers.openai.com/api/docs/models/gpt-image-2.6-flare - Page des modèles OpenAI – GPT-Image-2.5 Sunburst : positionnement du modèle 2.5, informations sur Batch et le calculateur
- Lien :
developers.openai.com/api/docs/models/gpt-image-2.5-sunburst - Tarifs OpenAI : prix unitaire des tokens pour les quatre modèles
- Lien :
developers.openai.com/api/docs/pricing - Fiche système ChatGPT Images 2.6 : données d’évaluation de sécurité
- Lien :
deploymentsafety.openai.com/chatgpt-images-2-6 - Liste des modèles APIYI : modèles et tarifs de la plateforme
- Lien :
docs.apiyi.com/models
Auteur : équipe technique APIYI
Échanges techniques : si vous avez des questions lors de l’évaluation d’une migration, contactez-nous depuis la page d’accueil APIYI sur apiyi.com. Pour en savoir plus, consultez la documentation sur docs.apiyi.com.