Note de l’auteur : si vous utilisez déjà, dans APIYI, l’image_generation de Responses pour générer des images au fil de la conversation, vous pouvez conserver la modification d’image continue en suivant la méthode décrite ici après être passé à l’API Images autonome.
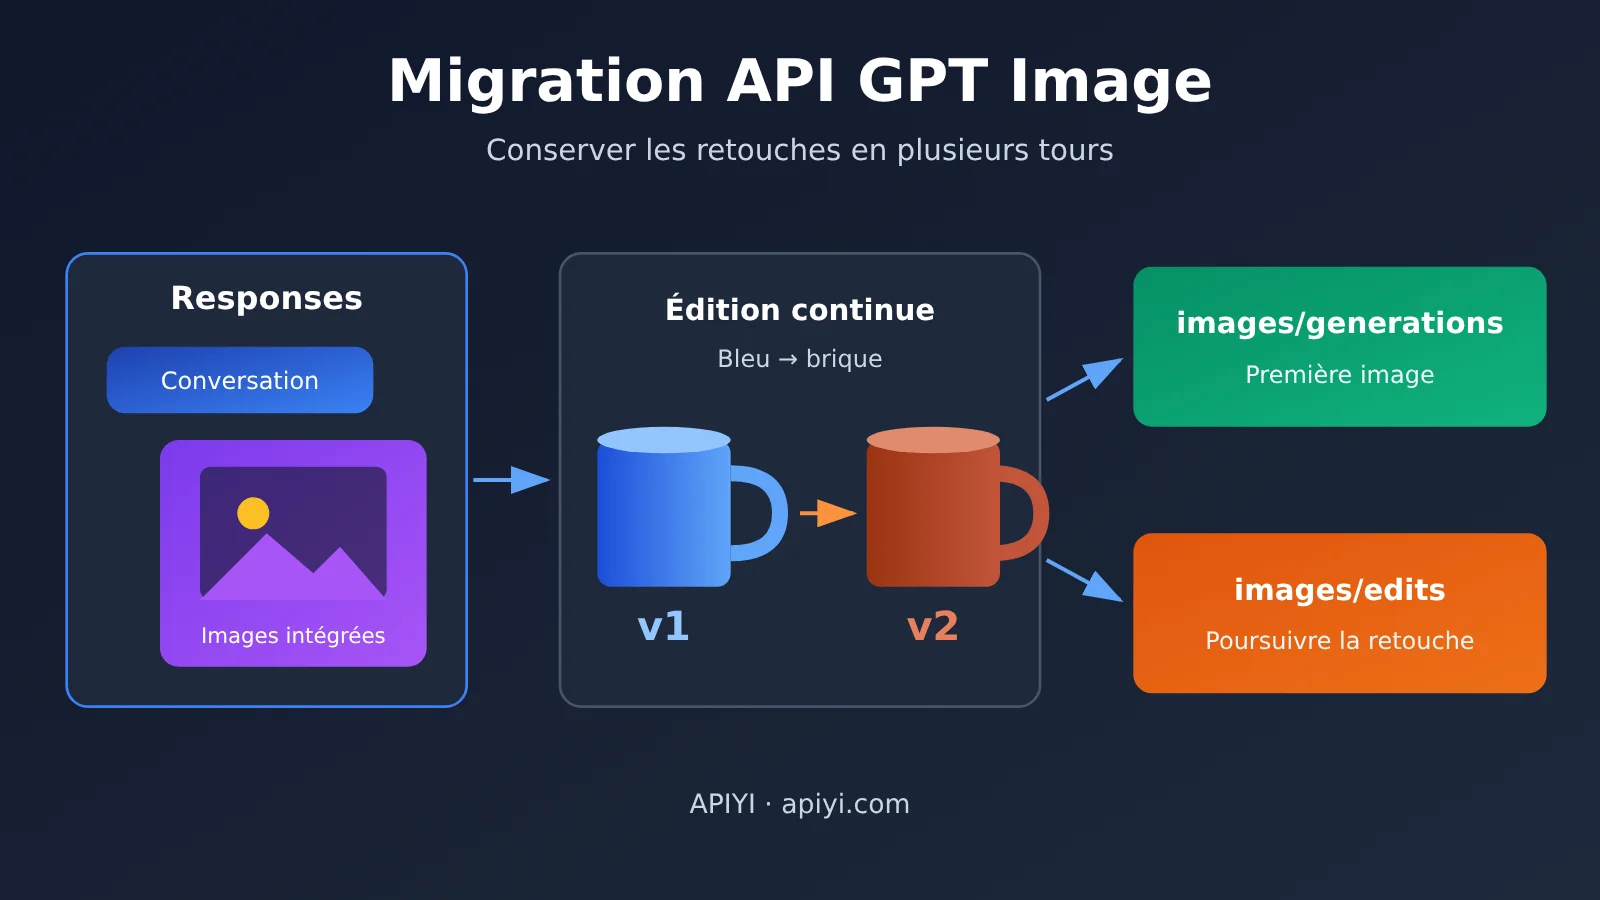
Conclusion en premier : ne migrez que la partie génération d’images, le dialogue texte existant reste inchangé. L’« image précédente », qui était auparavant rattachée implicitement via previous_response_id, est désormais enregistrée par votre application, et vous la sélectionnez explicitement à chaque modification d’image pour l’envoyer comme image d’origine à POST /v1/images/edits. Une fois cela fait, l’effet de la modification d’image sur plusieurs tours ne change pas ; ce qui change, c’est simplement qui se souvient de l’« image précédente ».
Cette conclusion repose sur la mise à jour de la documentation publiée par APIYI le 2026-11-21 à 22:30 (heure de Pékin). Cinq modèles d’image officiels convertis sont désormais recommandés via deux points de terminaison d’image indépendants. OpenAI n’a pas désactivé Responses, et le dialogue texte sur le site reste disponible comme d’habitude. Toutes les interfaces, champs et règles de facturation ci-dessous proviennent de la documentation APIYI apiyi.com et du guide officiel de génération d’images d’OpenAI. Le code relève d’exemples de documentation et ne représente pas des résultats de tests réels.
Carte des connaissances et index pour la migration vers GPT Image API
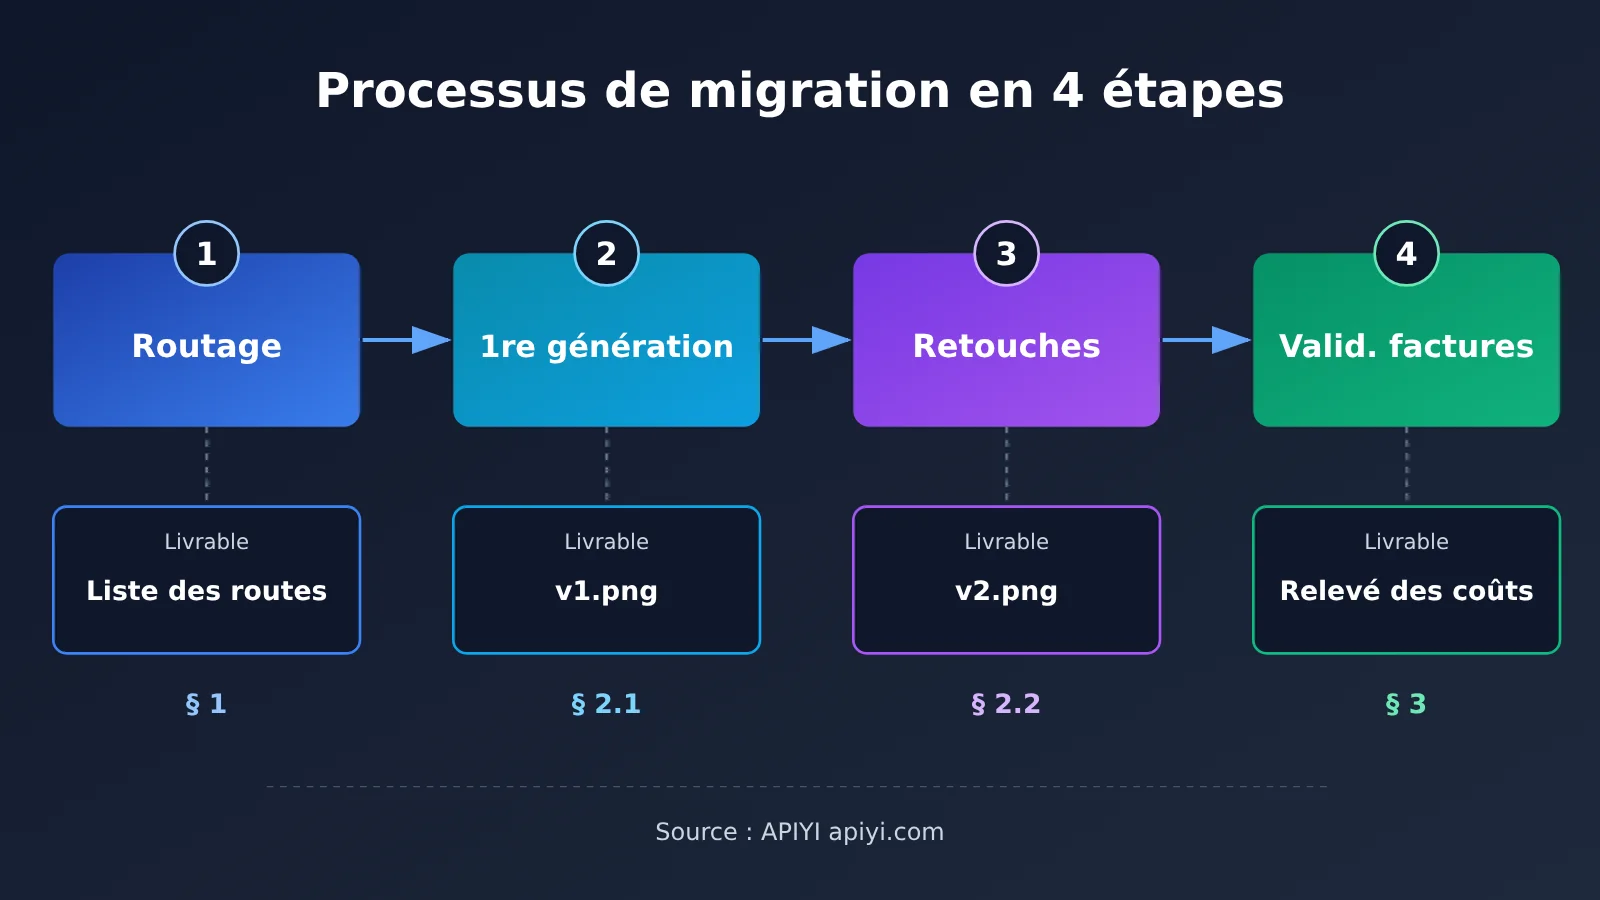
Toute la migration se déroule en quatre étapes, et la sortie de chaque étape devient l’entrée de la suivante :
Identifier les anciens appels et répartir les routes (section 1)
   └─> Sortie : pour chaque requête, choisir entre dialogue, generations ou edits
Générer et conserver la première image (section 2.1)
   └─> Sortie : v1.png validé + fiche d'actif
Transmettre l'image originale choisie à l'interface d'édition (section 2.2)
   └─> Sortie : v2.png + association parent_asset_id
Validation et rapprochement comptable (section 3)
   └─> Sortie : liste des images utilisables + coût de chaque image validée
| Étape | De quoi elle dépend | Pourquoi elle est placée ici | Objectif |
|---|---|---|---|
| 1 Répartition des routes | La liste des appels présents dans le code existant | Déterminer d’abord où intervenir, pour ne pas modifier par erreur le dialogue texte | Basculer uniquement les requêtes de génération d’images vers Images API |
| 2.1 Première génération d’image | La route generations définie à l’étape 1 | Les éditions ultérieures ont besoin d’une image originale réellement sauvegardée | Obtenir un v1 validé et l’enregistrer |
| 2.2 Poursuite des éditions | Le fichier v1 sauvegardé à l’étape 2.1 | Le point de terminaison autonome ne reconnaît pas previous_response_id, seulement l’image que vous téléversez |
Obtenir un v2 et noter la relation parent-enfant |
| 3 Validation et rapprochement | Les images de l’étape 2 et les journaux de la console | Seules les images validées entrent dans le dénominateur du coût | Images livrables + facturation explicable |
Ordre de lecture conseillé : la section 1 est incontournable ; suivez la section 2 dans l’ordre du code ; consultez la section 3 avant la mise en production, ou en cas de déconnexion ou de doute sur la facturation.
À savoir : terminologie de la migration vers GPT Image API
| Terme | Explication concise |
|---|---|
| 官转 (transfert officiel) | Modèle du canal de transfert officiel fourni par APIYI ; dans cet article, désigne les cinq ID de modèles d’image |
| image_generation | Outil de génération d’images de la Responses API ; l’ancien flux passait par lui pour générer des images au fil de la conversation |
| previous_response_id | Paramètre utilisé par Responses pour prolonger le contexte du tour précédent ; une requête Images autonome ne l’accepte pas |
| multipart | Format d’envoi de formulaire ; /images/edits l’utilise pour transmettre les données binaires d’une vraie image |
| b64_json | Champ dans lequel le point de terminaison d’image autonome renvoie l’image, dont le contenu est une image encodée en base64 |
| parent_asset_id | Champ de liaison que l’application enregistre elle-même pour savoir « de quelle image celle-ci a été modifiée » |
1 Quels appels à l’API GPT Image doivent être migrés depuis Responses
1.1 Périmètre de la mise à jour GPT Image API du 11/21 et des cinq modèles officiels relayés
Cette mise à jour de la documentation concerne les cinq ID de modèles officiels relayés suivants :
gpt-image-2.6-sunburstgpt-image-2.6-flaregpt-image-2.5-sunburstgpt-image-2.5-flaregpt-image-2
Les deux points de terminaison image indépendants correspondants sont POST /v1/images/generations (corps JSON) et POST /v1/images/edits (formulaire multipart). APIYI ne recommande plus de générer des images via la chaîne image_generation de Responses, pour deux raisons : d’une part la disponibilité est instable, d’autre part cela génère des frais d’outil supplémentaires. Par ailleurs, Chat Completions ne permet pas de générer des images avec ces cinq modèles image officiels relayés ; si votre ancien code utilise ce mode, il faut aussi l’ajouter à la liste de migration.
Précision importante : cette modification ne concerne que la génération d’images. OpenAI n’a pas désactivé Responses, et le dialogue textuel sur APIYI n’a pas été désactivé non plus. Le périmètre de migration se limite donc au code qui « appelle l’outil image ou le modèle image dans la requête ». Le choix entre les cinq modèles est un autre sujet ; voir l’article sur le choix des modèles dans le centre d’aide d’APIYI apiyi.com, nous ne le détaillons pas ici.
1.2 Routage de GPT Image API pour le dialogue textuel, la première génération d’image et la retouche continue
La FAQ d’APIYI propose la combinaison suivante : le modèle de dialogue détermine l’intention de l’utilisateur, puis l’application appelle séparément l’API Images et gère elle-même les images. Dans cette logique, les trois tâches que gérait auparavant une seule requête Responses peuvent être réparties en trois routes :
| Intention de l’utilisateur | Nouvelle route | Format de requête | Source de l’image |
|---|---|---|---|
| Chat purement textuel, questions-réponses | Conserver l’interface de dialogue textuel existante | Inchangé | Aucune |
| Première génération d’image | POST /v1/images/generations |
JSON | prompt uniquement |
| Retouche continue sur une image donnée | POST /v1/images/edits |
multipart | L’application téléverse l’image originale sélectionnée |
Dans Responses natif, la retouche successive peut se faire via previous_response_id, ou en passant directement l’image. Une requête Images indépendante n’accepte pas previous_response_id ; c’est la raison fondamentale pour laquelle la « retouche multi-tour » doit être prise en charge par l’application. Le modèle ne garde plus en mémoire l’image précédente à votre place ; c’est à vous de lui transmettre le fichier de cette image.
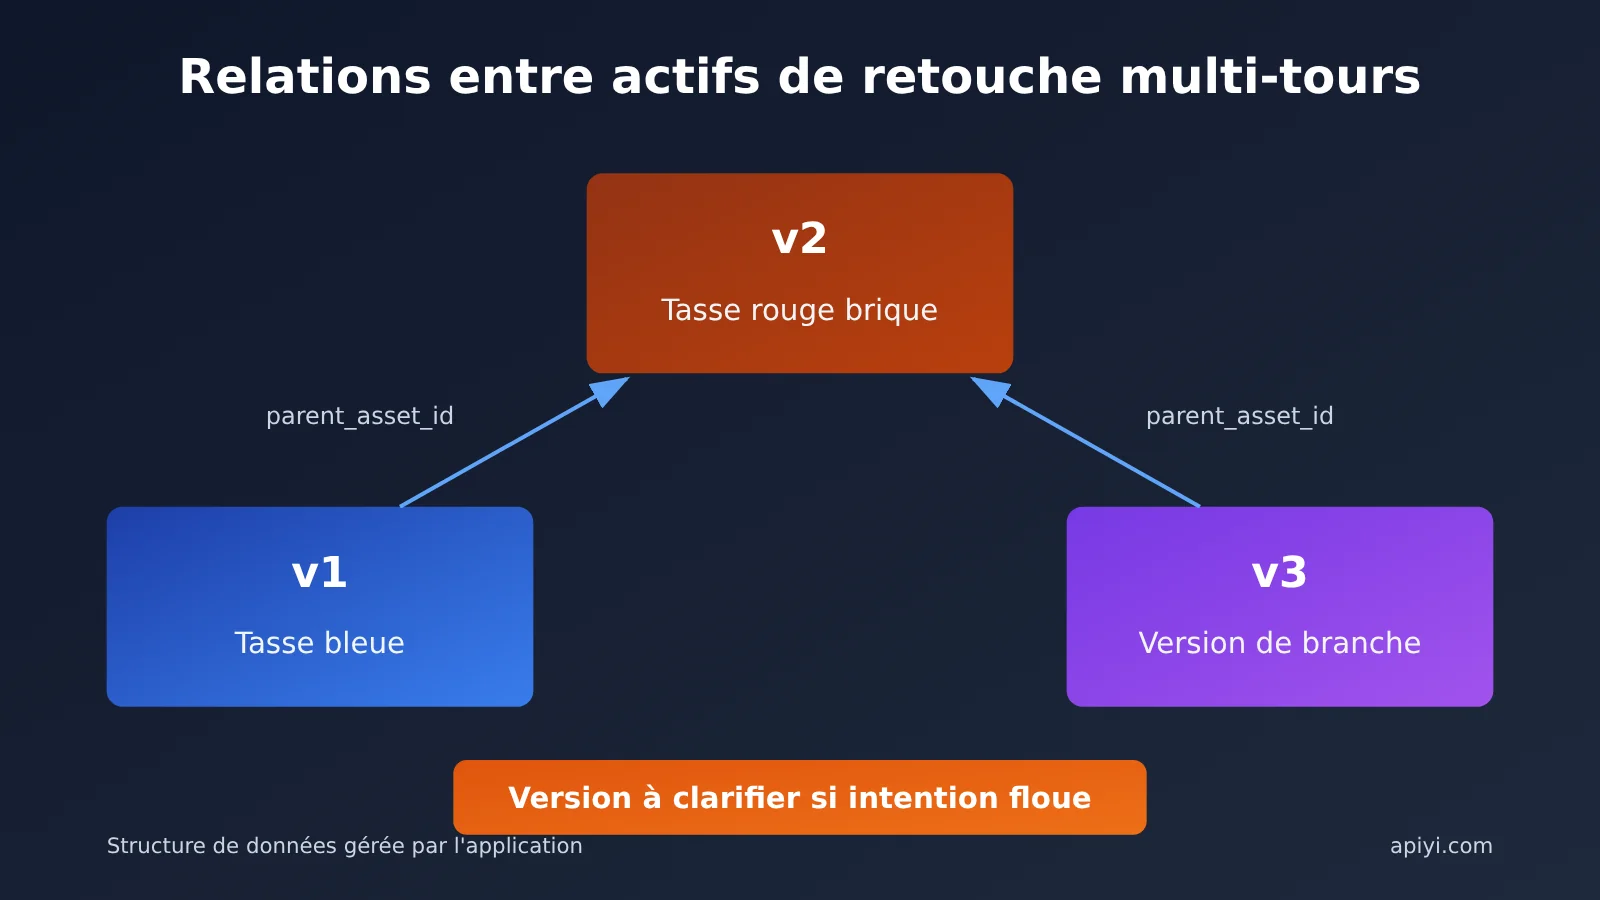
Si l’utilisateur dit « un peu plus rouge », mais que la conversation contient déjà plusieurs versions v1, v2, v3, l’application ne peut pas savoir de quelle version il parle. Dans ce cas, demandez confirmation à l’utilisateur au lieu de deviner. Utiliser la dernière version par défaut paraît plus simple, mais si l’utilisateur veut en réalité revenir à la v2 pour la retoucher, vous déclenchez un débit supplémentaire pour rien et vous embrouillez l’utilisateur.
L’analyse des réponses doit aussi être adaptée :
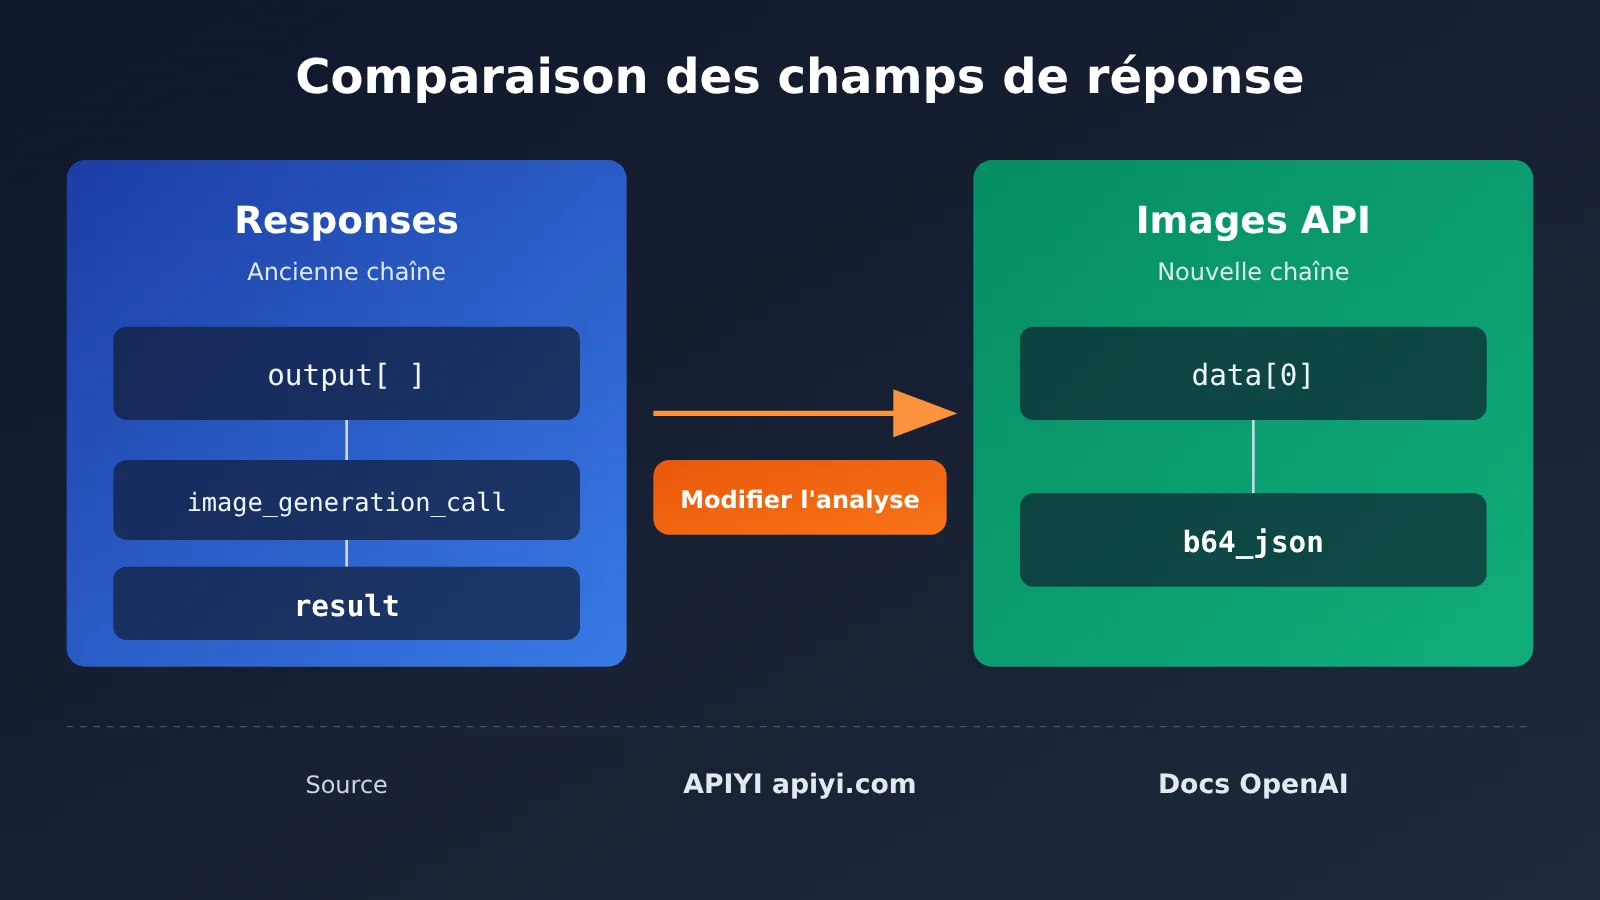
| Chaîne | Emplacement de l’image dans la réponse | Mode de continuité du contexte |
|---|---|---|
| Responses + image_generation | result de l’élément type=image_generation_call dans output |
previous_response_id ou envoi d’image |
| API Images indépendante | data[0].b64_json |
L’application envoie l’image originale sélectionnée |
2 Comment continuer à modifier l’image précédente avec GPT Image API
Voici un exemple en deux tours qui illustre le déroulé complet. Le premier tour génère une tasse bleue, le second se contente de passer la tasse en rouge brique. Les paramètres reprennent l’exemple de la documentation APIYI : modèle gpt-image-2.5-sunburst, taille 1024x1024, quality=medium, output_format=png. Le jeton est lu depuis la variable d’environnement APIYI_KEY et transmis en tant que Bearer.
2.1 GPT Image API génère et valide le PNG de la tasse bleue
Le premier tour appelle le point de terminaison generations, avec une invite qui décrit : fond gris clair, tasse en céramique bleue centrée, anse vers la droite, éclairage latéral doux, aucun texte dans l’image. Une fois la réponse reçue, procédez dans cet ordre :
- Appelez
raise_for_status()pour écarter d’abord les échecs au niveau HTTP. - Effectuez un décodage base64 strict sur
b64_json; si le décodage échoue, considérez que c’est un échec. - Ouvrez avec Pillow et appelez
load()pour confirmer que le fichier se décode bel et bien en image. - Vérifiez que le format est PNG et que la taille est bien 1024×1024, puis enregistrez sous
v1.png. - Enregistrez cette ressource dans l’application ; les retouches suivantes partiront de cette image d’origine.
L’étape 3 n’est pas facultative. open() ne lit que l’en-tête du fichier ; si les données d’image sont tronquées, cela ne se verra qu’au moment du load().
2.2 GPT Image API : téléverser l’image originale sélectionnée et ne modifier que le corps de la tasse en rouge brique
Deuxième appel sur l’endpoint edits. Dans data, on passe model, prompt, size, quality et output_format ; dans files, on envoie les vrais octets binaires de v1.png via le champ image[]. Le sens de l’instruction : ne changer que le corps de la tasse en rouge brique, en gardant identiques la forme de la tasse, l’anse, la composition, la lumière et l’arrière-plan.
Quelques pièges classiques à ce stade :
- Ne pas passer
response_format. - Ne pas écrire
Content-Typeà la main. requests génère automatiquement l’en-tête multipart avec son boundary ; le préciser soi-même revient à le perdre. - Ne pas envoyer une chaîne base64 comme fichier : ce sont les octets bruts de l’image qui doivent être téléversés.
Une fois la réponse obtenue, on décode et on valide de la même façon, puis on enregistre en v2.png. On conserve v1 et on note parent_asset_id = v1 dans l’enregistrement de l’asset. Cette relation parent-enfant, c’est justement le « contexte multi-tours » de la nouvelle architecture. À noter aussi : il s’agit d’une édition générative — le modèle s’efforce de préserver le reste de l’image, mais rien ne garantit que les pixels hors du corps de la tasse soient identiques un par un.
Voici un exemple minimal complet (exemple de documentation, non testé dans le cadre de cet article) :
import base64
import io
import os
import uuid

import requests
from PIL import Image

BASE_URL = "https://api.apiyi.com/v1"  # point d'accès unifié APIYI
API_KEY = os.environ["APIYI_KEY"]
HEADERS = {"Authorization": f"Bearer {API_KEY}"}
MODEL = "gpt-image-2.5-sunburst"
SIZE = "1024x1024"
# Timeout intermédiaire donné à titre d'exemple ; à ajuster selon votre réseau et le niveau de qualité. Pas de nouvelle tentative automatique.
TIMEOUT = (10, 360)

assets = {}  # asset_id -> {"path": ..., "parent_asset_id": ...}


def decode_and_check(resp, path):
    resp.raise_for_status()
    item = resp.json()["data"][0]
    b64 = item.get("b64_json")
    if not b64:
        raise ValueError("no b64_json in response, check body before any resend")
    raw = base64.b64decode(b64, validate=True)
    img = Image.open(io.BytesIO(raw))
    img.load()
    if img.format != "PNG" or img.size != (1024, 1024):
        raise ValueError(f"unexpected image: {img.format} {img.size}")
    with open(path, "wb") as f:
        f.write(raw)
    return path


def save_asset(path, parent_asset_id=None):
    asset_id = str(uuid.uuid4())
    assets[asset_id] = {"path": path, "parent_asset_id": parent_asset_id}
    return asset_id


# Tour 1 : texte vers image via JSON
gen_resp = requests.post(
    f"{BASE_URL}/images/generations",
    headers=HEADERS,
    json={
        "model": MODEL,
        "prompt": (
            "Light gray background, a blue ceramic mug centered, "
            "handle facing right, soft side lighting, no text."
        ),
        "size": SIZE,
        "quality": "medium",
        "output_format": "png",
    },
    timeout=TIMEOUT,
)
v1_id = save_asset(decode_and_check(gen_resp, "v1.png"))

# Tour 2 : éditer l'original explicitement sélectionné via multipart
selected_id = v1_id  # si la version cible de l'utilisateur n'est pas claire, demandez d'abord
with open(assets[selected_id]["path"], "rb") as f:
    edit_resp = requests.post(
        f"{BASE_URL}/images/edits",
        headers=HEADERS,  # pas de Content-Type manuel ; requests définit le boundary
        data={
            "model": MODEL,
            "prompt": (
                "Change only the mug body to brick red. Keep the mug shape, "
                "handle, composition, lighting and background unchanged."
            ),
            "size": SIZE,
            "quality": "medium",
            "output_format": "png",
        },
        files={"image[]": ("v1.png", f, "image/png")},
        timeout=TIMEOUT,
    )
v2_id = save_asset(decode_and_check(edit_resp, "v2.png"), parent_asset_id=selected_id)
print(assets)
Dans l’exemple, timeout=(10, 360) n’est qu’un réglage intermédiaire à titre documentaire : la valeur réelle doit être choisie en fonction de votre liaison réseau et du niveau de qualité visé. L’exemple omet volontairement toute nouvelle tentative automatique — la raison est expliquée à la section 3.2.
🚀 Vérification rapide : définissez APIYI_KEY avec le jeton que vous avez créé dans la console d’APIYI apiyi.com, et le script ci-dessus exécutera le flux complet en deux tours. Les nouveaux utilisateurs peuvent d’abord confirmer la logique de routage et d’analyse (parsing) avec le quota de test gratuit, puis basculer sur le trafic de production.
3 Après la migration de l’API GPT Image : comment valider et rapprocher la facturation
3.1 Les quatre contrôles de validation des images avec l’API GPT Image
Ce n’est que lorsque ces quatre contrôles sont tous passés qu’une image peut être marquée comme « utilisable » dans l’application :
- Succès HTTP :
raise_for_status()n’a levé aucune exception. - Décodable : le décodage base64 strict a réussi et l’appel
load()de Pillow a fonctionné. - Spécifications correctes : le format et les dimensions correspondent à la demande ; ici, PNG et 1024×1024.
- La modification visuelle a bien eu lieu : sur la v2, le corps de la tasse est effectivement devenu rouge brique, tandis que la forme de la tasse, l’anse, la composition et l’arrière-plan restent globalement inchangés.
Le quatrième contrôle nécessite une inspection humaine ou une étape de révision distincte, car un code de statut HTTP ne permet pas de savoir si le modèle a fait la bonne modification. Une image qui ne passe que les trois premiers contrôles est tout au plus « techniquement valide » et ne peut pas encore être livrée. Si la réponse ne contient aucune image, il faut d’abord examiner son contenu avant de décider s’il y a lieu de réessayer. Un article dédié du centre d’aide traite de ce point ; nous ne le répétons pas ici.
3.2 Frais de l’ancien outil de l’API GPT Image et coût par image validée
Avant et après la migration, la base de facturation n’est pas la même :
| Élément | Ancienne chaîne Responses image_generation | API Images autonome |
|---|---|---|
| Frais supplémentaires | Environ 0,20 $ de frais d’appel supplémentaire pour l’outil d’image d’APIYI | Aucun frais d’outil de ce type |
| Signification de ce chiffre | Ce chiffre ne désigne que ces frais d’outil supplémentaires ; il ne s’agit ni du prix total de la commande, ni d’un tarif générique d’OpenAI | Facturation à l’usage |
| Mode de comparaison approprié | Comparer selon le « coût par image validée » | Comparer selon le « coût par image validée » |
Ne comparez pas seulement le prix unitaire ; utilisez plutôt systématiquement la formule suivante :
Coût par image validée = frais réellement débités pertinents (y compris les appels texte nécessaires, les requêtes échouées déjà facturées et les nouvelles tentatives) ÷ nombre d’images ayant passé la validation
Le numérateur doit inclure tous les frais pertinents, y compris les appels de conversation servant à déterminer l’intention, les requêtes échouées déjà facturées et les tentatives répétées. Le dénominateur ne compte que les images ayant franchi les quatre contrôles de la section 3.1. S’il n’y a aucune image validée, ne calculez pas de coût unitaire : la conclusion devrait alors être « le processus a un problème » et non « le prix unitaire est élevé ». Les économies réalisées par la migration dépendent de votre taux de nouvelle tentative et de votre taux de validation ; cet article ne fournit aucun pourcentage précis.
Les données de rapprochement comptable proviennent des journaux de consommation de la console, où les enregistrements de consommation portent type=2. Si vous lisez le champ quota, convertissez-le en montant avec quota ÷ 500000, conformément à la documentation de la plateforme.
La gestion des déconnexions mérite une attention particulière. Le point de terminaison d’images autonome répond de manière synchrone ; si la connexion est interrompue en cours de route, la requête peut déjà avoir été facturée, et il n’est pas possible de récupérer l’image via le request ID. L’ordre correct est le suivant : commencez par vérifier dans les journaux de consommation de la console APIYI apiyi.com si cette requête a été facturée, puis décidez s’il faut la renvoyer. C’est aussi la raison pour laquelle l’exemple de code n’implémente pas de nouvelle tentative automatique : une telle tentative risque facilement de provoquer une double facturation en cas de déconnexion. Si vous rencontrez une limitation de débit ou si vous devez changer de canal, consultez l’article du centre d’aide sur le choix des canaux et la rétrogradation en cas de 429.
Les critères permettant de vérifier que la migration est terminée sont simples : les conversations textuelles fonctionnent comme d’habitude ; la première génération d’images renvoie de manière stable un v1 capable de passer les quatre contrôles ; chaque modification d’image permet de retrouver un parent_asset_id explicite dans l’historique des ressources ; et chaque débit lié à une image dans les journaux de la console correspond à une image validée, à un échec connu, ou à un nouvel envoi documenté. Une fois tous ces points satisfaits, vous pouvez basculer le trafic de génération d’images restant sur Responses vers l’API Images. Si vous avez besoin de tests comparatifs entre plusieurs modèles, APIYI apiyi.com propose une interface compatible OpenAI unifiée ; pour changer de modèle, il suffit de modifier le seul paramètre MODEL.
Références
-
Mise à jour de la doc APIYI : les modèles d’image relais officiels passent par l’API Images
- Lien :
docs.apiyi.com/live/2026-11/gpt-image-official-relay-images-api - Description : les cinq ID relais officiels, les deux endpoints indépendants et les raisons pour lesquelles l’ancienne route n’est pas recommandée
- Lien :
-
FAQ APIYI : traiter du texte et des images dans une seule API
- Lien :
docs.apiyi.com/faq/text-and-image-in-one-api - Description : le modèle de dialogue détermine l’intention, puis l’application appelle séparément l’API Images — la combinaison à mettre en place
- Lien :
-
Guide de génération d’images d’OpenAI
- Lien :
developers.openai.com/api/docs/guides/image-generation - Description : le mode d’édition continue de Responses et la structure de réponse
- Lien :
-
APIYI GPT Image 2 : texte vers image / édition d’image
- Lien :
docs.apiyi.com/api-capabilities/gpt-image-2/text-to-image - Lien :
docs.apiyi.com/api-capabilities/gpt-image-2/image-edit - Description : paramètres de requête, upload multipart et exemples de validation du décodage
- Lien :
-
APIYI : outil image de Responses / bonnes pratiques de l’API Images / consultation des logs
- Lien :
docs.apiyi.com/api-capabilities/gpt-image-2/responses-image-tool - Lien :
docs.apiyi.com/api-capabilities/image-api-best-practices - Lien :
docs.apiyi.com/api-capabilities/log-query - Description : base de facturation des outils, gestion des déconnexions et conversion des journaux de consommation
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : si vous rencontrez des problèmes de routage ou de facturation pendant la migration, contactez-nous via la page d’accueil d’APIYI apiyi.com ; pour plus de détails sur les interfaces, consultez le centre de documentation docs.apiyi.com