Note de l’auteur : comment les équipes qui utilisent déjà Gemini 4 Carbon considèrent Gemini 4 Neon. Cet article aligne les scores d’intelligence selon le niveau de réflexion, vérifie séparément les trois comptabilités de coût par tâche, et indique les modèles et tarifs disponibles sur APIYI.
Google a publié Gemini 4 Neon le 18 novembre 2026. Sundar Pichai a expliqué dans un post publié le jour même qu’il cible l’ingénierie logicielle complexe, le travail intellectuel et les processus scientifiques, et qu’il est lancé simultanément dans le Gemini API de Google AI Studio, Gemini for business, Google Antigravity et Gemini App. Le même jour, la fiche modèle de DeepMind, le guide développeur Google Cloud et l’article d’évaluation d’Artificial Analysis étaient déjà en ligne, ce qui permet de recouper les informations.
Si vous faites déjà tourner Gemini 4 Carbon en production, la question qui se pose est très concrète : Gemini 4 Neon sert-il à remplacer Carbon, ou à être placé à côté pour prendre en charge une partie des tâches ? Cet article décompose le problème en deux volets : quel est l’écart de profondeur, et combien de comptabilités distinctes faut-il établir pour le coût par tâche.
L’essentiel : à la fin de cet article, vous disposerez de scores d’intelligence alignés par niveau, de trois comptabilités de coûts établies selon des méthodologies différentes, ainsi que des modèles et tarifs directement appelables sur APIYI. Changer ou non dépendra finalement des données de vos propres tâches.
Gemini 4 Neon et Gemini 4 Carbon : points clés
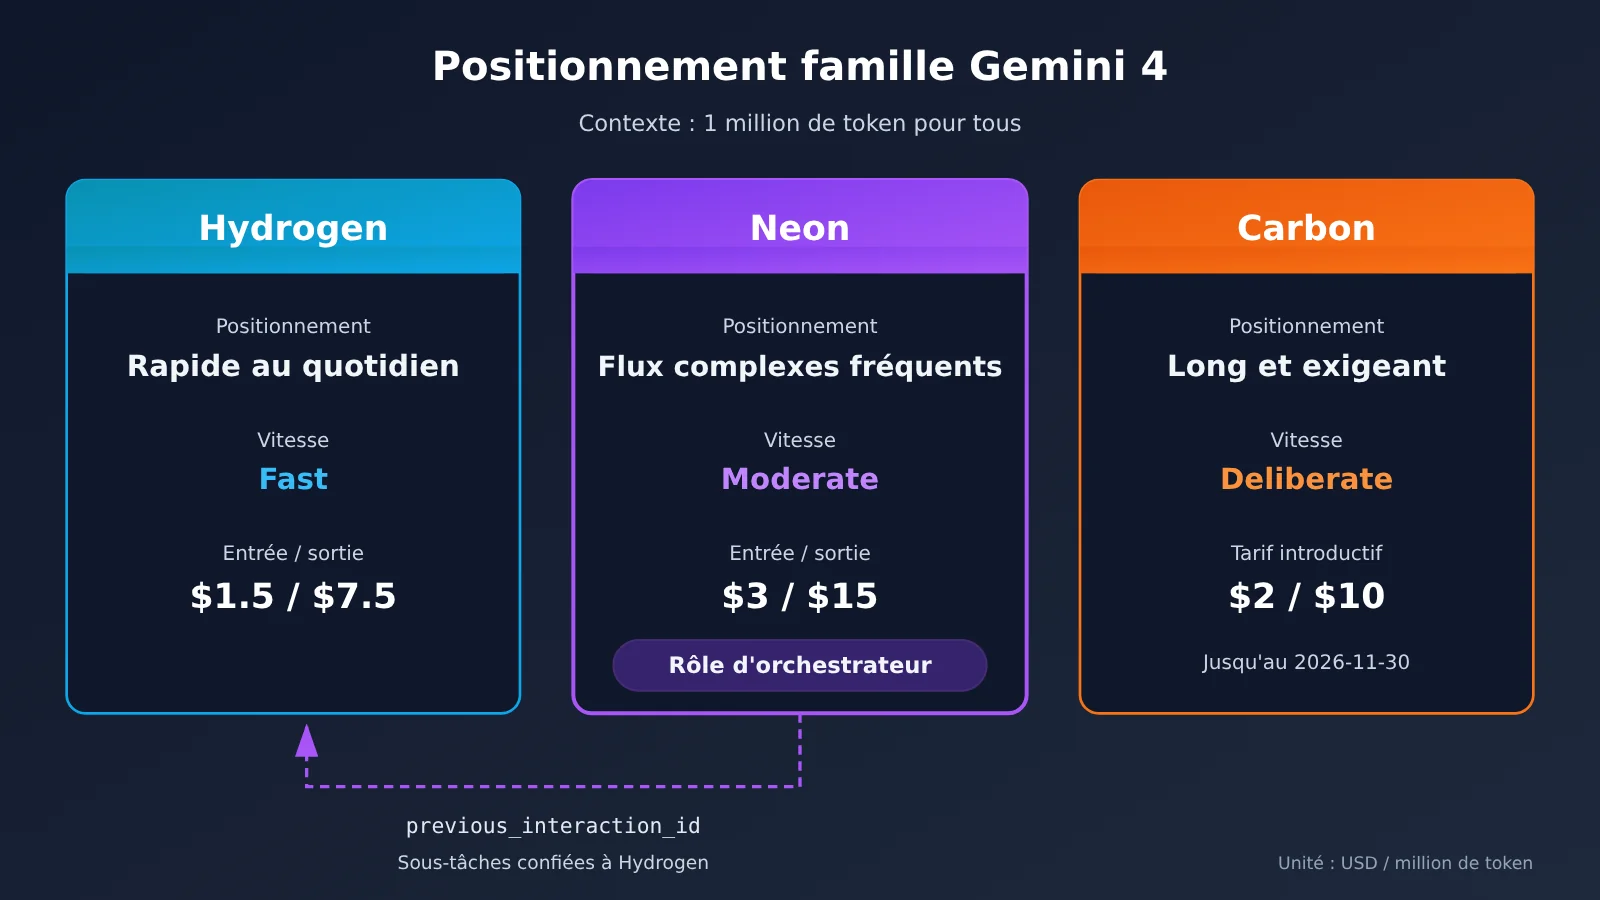
La famille Gemini 4 compte actuellement trois modèles : Carbon, Neon et Hydrogen. Les positionnements donnés par le blog Google et le guide développeur Google Cloud sont cohérents : Neon se situe entre Hydrogen et Carbon.
| Modèle | Positionnement officiel (blog Google, guide développeur) | Qualificatif de vitesse (page des derniers modèles d’AI Studio) | Niveaux de réflexion | Niveau par défaut |
|---|---|---|---|---|
| Gemini 4 Carbon | Tâches longues les plus difficiles | Deliberate | low / medium / high, pas de xhigh | medium |
| Gemini 4 Neon | Compromis, pour les processus complexes à haute fréquence | Moderate | low / medium / high / xhigh | high |
| Gemini 4 Hydrogen | Exécution rapide au quotidien | Fast | Non indiqué dans les sources | Non indiqué dans les sources |
Relation de famille entre Gemini 4 Neon et Carbon
D’après la fiche modèle, Gemini 4 Neon est une adaptation de Gemini 4 Carbon ; ses connaissances s’arrêtent en mars 2026 et l’entrée prend en charge le texte, les images, l’audio et la vidéo. La fenêtre unifiée peut atteindre 1 million de tokens, la sortie synchrone par défaut jusqu’à 64 000 tokens, et le décodage long en arrière-plan jusqu’à 1 million. La page des derniers modèles d’AI Studio indique que les trois modèles disposent d’un contexte unifié de 1 million de tokens et d’une sortie synchrone par défaut de 64K.
Les spécifications de contexte sont identiques ; les trois modèles se distinguent surtout par la profondeur de réflexion, le qualificatif de vitesse et le prix unitaire. Le guide développeur Google Cloud propose une utilisation combinée : utiliser gemini-4-neon pour l’orchestration, puis confier previous_interaction_id à gemini-4-hydrogen pour exécuter des sous-tâches plus rapidement. Dans cette logique, Neon n’a pas forcément vocation à remplacer qui que ce soit ; il peut aussi servir de couche intermédiaire dans la famille.
À noter : le tableau comparatif de la fiche modèle ne comporte que trois colonnes : Gemini 4 Neon, Claude Opus 5.5 et GPT-6.2 Sol, sans colonne Gemini 4 Carbon. Le PDF explicatif de l’évaluation précise aussi que les résultats non-Gemini proviennent par défaut des auto-déclarations de chaque éditeur. Pour comparer Neon et Carbon, on s’appuie donc principalement sur les rares auto-déclarations officielles disséminées dans le blog Google, ainsi que sur les mesures tierces d’Artificial Analysis.
Gemini 4 Neon vs Carbon : quelle différence de profondeur
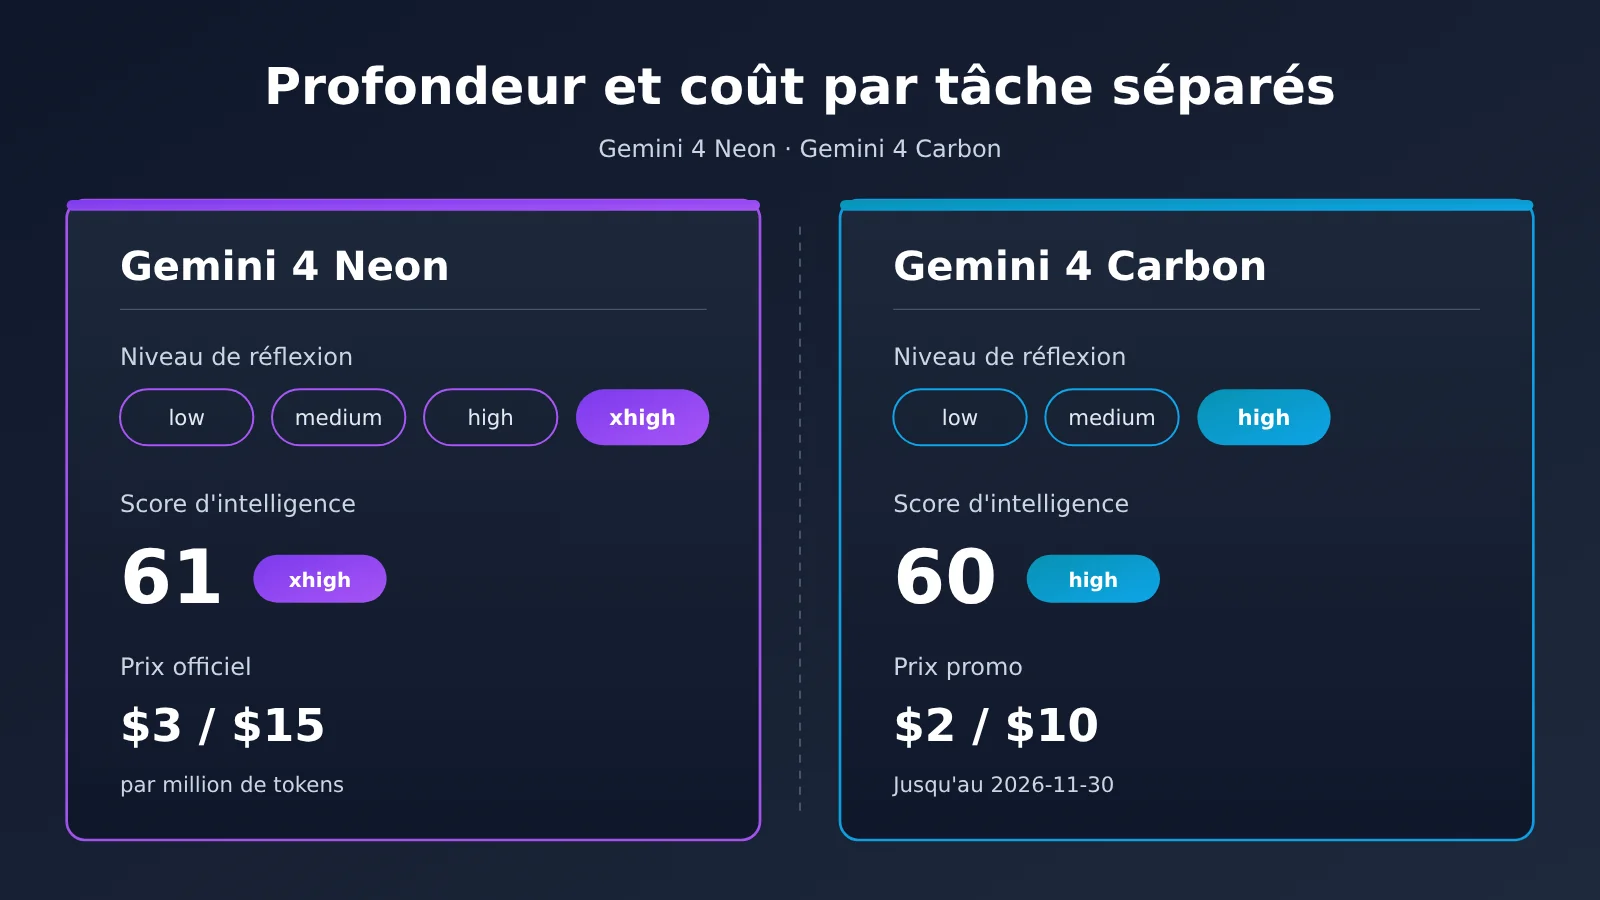
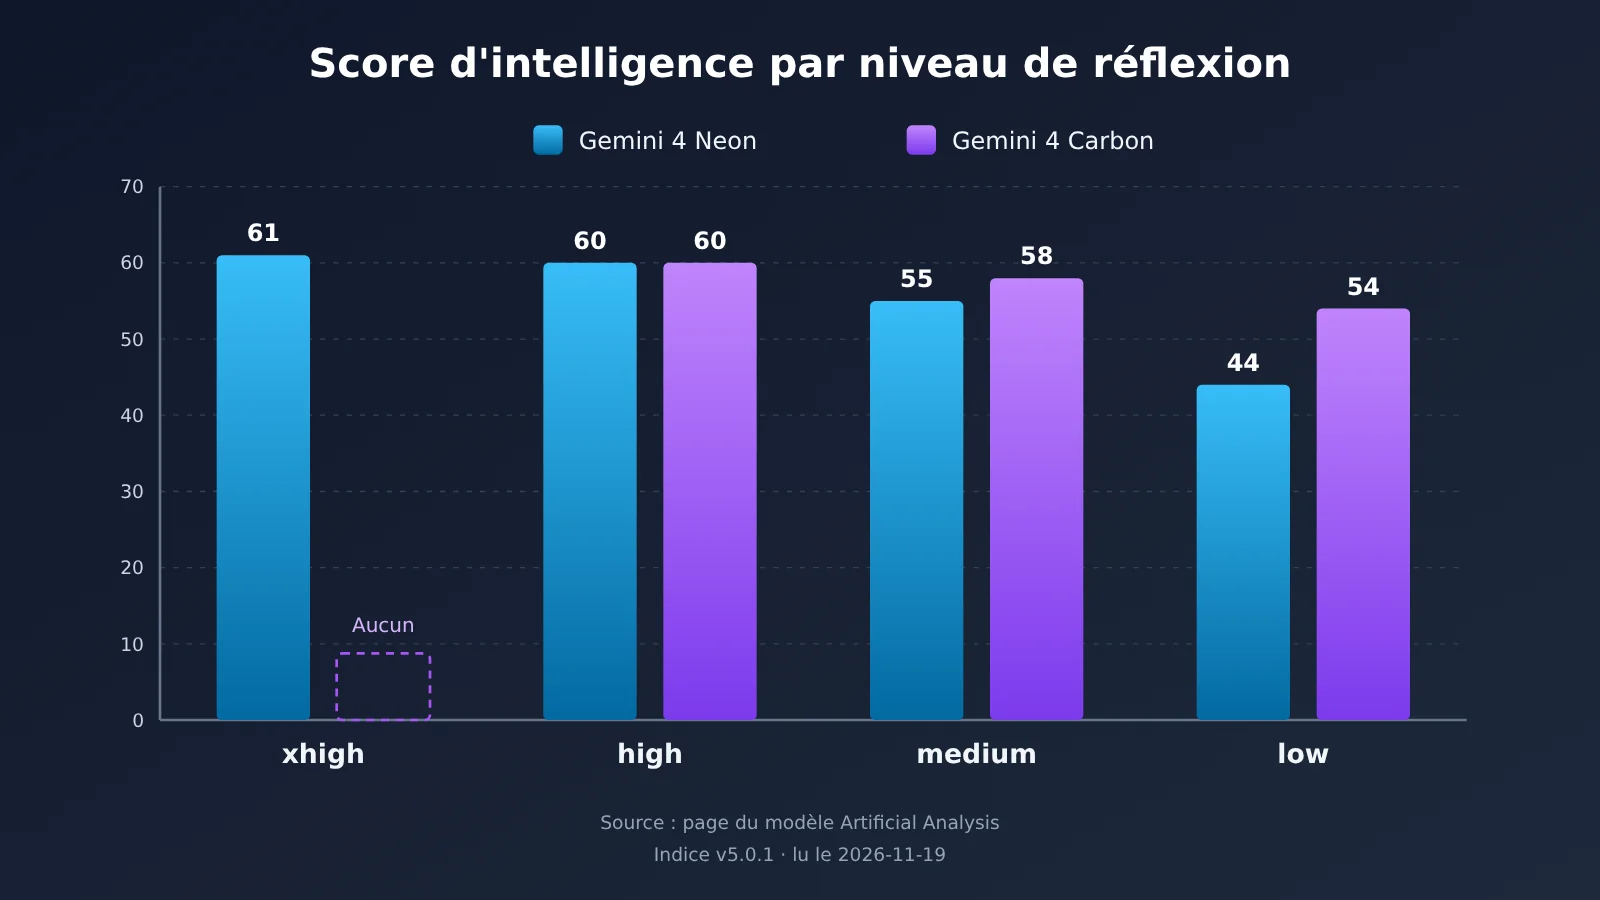
Avant de comparer la profondeur, alignons d’abord les niveaux. D’après la dernière page des modèles d’AI Studio, les niveaux de réflexion de Carbon sont low, medium (par défaut) et high ; il n’y a pas de xhigh. La page du modèle Carbon sur Artificial Analysis n’indique pas non plus de xhigh. Par conséquent, lorsque Artificial Analysis compare Neon xhigh, c’est à Carbon high qu’il le compare.
| Niveau de réflexion | Score d’intelligence de Gemini 4 Neon | Score d’intelligence de Gemini 4 Carbon | Remarque |
|---|---|---|---|
| xhigh | 61 | Niveau absent de la page | Niveau exclusif à Neon |
| high | 60 | 60 | Même score, niveau par défaut de Neon |
| medium | 55 | 58 | Niveau par défaut de Carbon |
| low | 44 | 54 | Carbon est meilleur au niveau low |
Ce tableau provient de la page des modèles d’Artificial Analysis, version de l’indice v5.0.1, consultée le 2026-11-19. D’après l’article d’Artificial Analysis, les 61 points de Neon xhigh dépassent Carbon high de 1 point, et Neon xhigh se classe 3e au classement général ; devant lui, on trouve GPT-6.2 Astra (max) et Claude Fable 5.2 (max). Le blog officiel de Google indique aussi, en auto-déclaration, 61 points avec le niveau xhigh et une 3e place au classement général ; la colonne AA Index v5.0.1 de la fiche modèle affiche également 61. Pour le score d’intelligence, les trois sources concordent.
Le tableau met aussi en évidence un point souvent négligé : au niveau high, les deux sont à égalité. Sur medium et low, la page des modèles d’Artificial Analysis donne Carbon avec un meilleur score. Donc l’affirmation « Neon est plus profond » ne vaut que lorsque xhigh est comparé à Carbon high, et l’écart est de 1 point.
Les indicateurs détaillés de Gemini 4 Neon et Carbon
S’en tenir au score total fait facilement passer des détails à la trappe. Les critères suivants permettent de trouver à la fois des chiffres pour Neon et pour Carbon, mais les sources diffèrent ; il faut donc aussi noter les méthodologies séparément :
- GDP.pdf (article d’Artificial Analysis) : Neon high 33.4 %, Carbon high 28.4 %, Neon xhigh 28.0 %. Sur ce critère, xhigh est inférieur à high, ce qui montre qu’un niveau de réflexion plus élevé ne garantit pas un meilleur score.
- Coding Agent Index : dans l’article d’Artificial Analysis, on lit Neon xhigh 59 et Carbon high 55 sur Antigravity CLI ; le blog de Google indique 58.6 et une 1re place au classement général. Ces deux chiffres ne concordent pas ; je conserve les deux ici, sans les fusionner.
- MKA : dans l’article d’Artificial Analysis, on lit Neon 56 %, soit 2 points de plus que Carbon ; la fiche modèle indique MKA Climb WSR 56.5 %. Là encore, les deux chiffres sont notés séparément.
- CWE-bench v2 (auto-déclaration officielle) : Neon 70.7 %, soit 3.4 points de pourcentage de plus que Carbon. Il s’agit d’un résultat en cybersécurité ; la version réseau ne sera disponible que dans quelques jours, uniquement pour les défenseurs de confiance du Fairwind Program, sans identifiant de modèle public.
- Comportement de sécurité (auto-déclaration officielle) : taux de sous-service inférieur de 43 % à 56 % par rapport à Carbon, et franchissements de limites inférieurs de 15 % à 35 %.
Un mot sur la vitesse : d’après la page des modèles d’Artificial Analysis, Carbon high affiche un débit de sortie de 55 tokens/seconde et 37.2 minutes par tâche, tandis que Neon xhigh affiche 110 tokens/seconde et 21.5 minutes par tâche ; davantage de détails dans l’article consacré à la vitesse.
Coût par tâche de Gemini 4 Neon et Carbon : trois bilans
Commençons par les prix unitaires. D’après la page de tarification d’AI Studio, gemini-4-neon n’a pas d’offre gratuite : le tarif payant est de 3,00 $ par million de tokens en entrée et 15,00 $ en sortie (tokens de réflexion inclus), 0,15 $ pour le cache, et seul le cache implicite est pris en charge. Le cas de Carbon est un peu plus compliqué : la page des derniers modèles d’AI Studio affiche un prix de lancement valable jusqu’au 2026-11-30, à 2,00 en entrée et 10,00 en sortie ; le prix standard cité dans l’article d’Artificial Analysis est de 4/20.
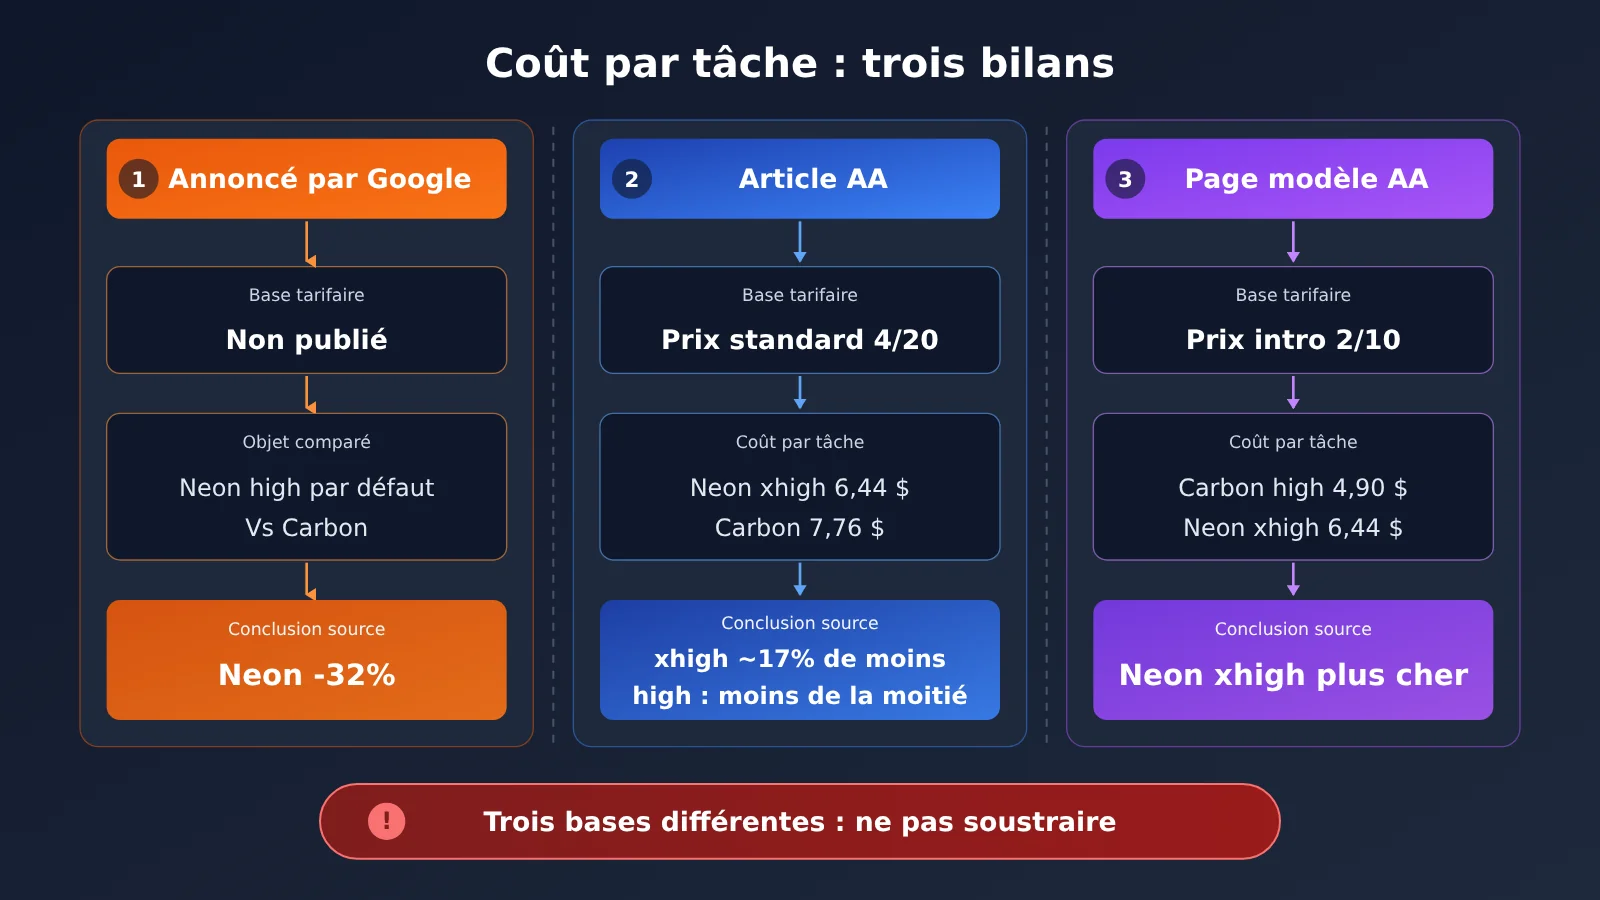
Le prix retenu pour Carbon change directement la conclusion. Les trois comptes ci-dessous tiennent chacun debout, mais on ne peut pas les additionner ni les soustraire entre eux.
Premier bilan : l’auto-déclaration de Google, Neon 32 % moins cher par tâche
Le blog de Google indique : en mode high par défaut, Neon coûte 32 % de moins par tâche que Carbon. C’est le calcul de coût propre à Google, et le blog ne précise pas si Carbon est facturé au prix de lancement ou au prix standard — impossible à reproduire de l’extérieur.
Le blog mentionne aussi que sur Vals et Agent Arena, le coût par tâche de Neon en mode high est inférieur d’environ 50 % à 80 % à celui des principaux concurrents ; en xhigh, il reste plus de 36 % moins cher que l’offre haut de gamme des concurrents. Là encore, ce sont des chiffres auto-déclarés par l’éditeur. Notre avis : à prendre comme un signal directionnel, pas comme un chiffre à inscrire directement dans un budget.
Deuxième bilan : l’article d’Artificial Analysis, calculé au prix standard de Carbon
L’article d’Artificial Analysis donne : Neon xhigh à 6,44 dollars par tâche, contre 7,76 dollars pour Carbon hors remise, soit environ 17 % de moins pour Neon. L’article détaille aussi la raison : Neon produit environ 15 % de tokens de sortie en plus par tâche, et si le coût baisse, c’est parce que son prix unitaire de 3/15 est 25 % inférieur au prix standard de Carbon, à 4/20.
Le même article décrit aussi la situation inverse : en appliquant le prix remisé actuel de Carbon, 2/10 (jusqu’au 30 novembre), le prix unitaire de Neon devient au contraire 50 % plus élevé. En mode high, Neon et Carbon high obtiennent le même score, et au prix standard de Carbon, le coût par tâche de Neon représente moins de la moitié de celui de Carbon.
Troisième registre : la page modèle d’Artificial Analysis, calculée au prix d’introduction
Les frais Carbon affichés sur la page modèle d’Artificial Analysis sont calculés d’après le prix actuellement affiché sur la page, à savoir le prix d’introduction 2.00/10.00, avec une remise de cache de 90 %. Dans ce référentiel, Carbon high revient à 4.90 dollars par tâche, pour un prix mixte de 1.54, et génère 205 millions de tokens en sortie sur l’indice. Sur la page modèle de Neon, xhigh revient à 6.44 dollars par tâche, pour un prix mixte de 2.21, avec 283 millions de tokens en sortie et une remise de cache de 95 %.
Selon ce registre, les 6.44 dollars de Neon xhigh dépassent les 4.90 dollars de Carbon high. Le récapitulatif de la page modèle de Neon ne mentionne pas le coût par tâche du niveau high, impossible donc de comparer directement, dans ce registre, les dépenses du niveau high des deux modèles.
| Registre | Étiquette de source | Base tarifaire Carbon | Objet de la comparaison | Conclusion de l’article original |
|---|---|---|---|---|
| Premier | Déclaration officielle (blog Google) | Non publiée | Neon high par défaut vs Carbon | Neon inférieur de 32 % par tâche |
| Deuxième | Article d’Artificial Analysis | Prix standard 4/20 | Neon xhigh vs Carbon high ; Neon high vs Carbon high | xhigh environ 17 % de moins ; high moins de la moitié |
| Troisième | Page modèle d’Artificial Analysis | Prix d’introduction 2/10 | Neon xhigh vs Carbon high | Carbon high 4.90 dollars, Neon xhigh 6.44 dollars |
Les 32 %, 17 % et 4.90 dollars des trois registres relèvent chacun d’un référentiel différent : on ne peut pas les mettre dans la même soustraction. Notre conclusion : le registre qui vous concerne dépend du prix unitaire Carbon que vous payez réellement. Le prix d’introduction expire le 2026-11-30 ; une fois cette échéance passée, les hypothèses du troisième registre changeront.
Comment appeler Gemini 4 Carbon et ses modèles de comparaison sur APIYI
Dans le tableau récapitulatif d’APIYI (docs.apiyi.com/models.md, page mise à jour le 2026-11-16 09:39, UTC+8) et dans l’interface de tarification (consultée le 2026-11-19, version shell-api-modelmak-v1, 285 modèles au total), voici les modèles de la famille Gemini 4 actuellement appelables :
| ID du modèle | Prix officiel Google (USD/million de tokens) | Prix APIYI : entrée / lecture du cache / sortie | Endpoint | Statut |
|---|---|---|---|---|
gemini-4-carbon |
Prix de lancement 2 / 10 (jusqu’au 2026-11-30) ; prix standard 4 / 20 (article Artificial Analysis) | 2 / 0.1 / 10 | chat, gemini | Disponible |
gemini-4-hydrogen |
1.5 / 7.5 (AI Studio) | 1.5 / 0.075 / 7.5 | chat, gemini | Disponible |
gemini-4-neon |
3 / 15, cache 0.15 (AI Studio) | Absent du tableau récapitulatif et de l’interface de tarification | — | Pas encore disponible |
gemini-4-neon n’est pas encore disponible ; nous l’ajouterons dès que possible. Les modèles et les prix font foi selon la liste des modèles de la plateforme.
Sur APIYI, le prix de gemini-4-carbon est de 2 pour l’entrée, 0.1 pour la lecture du cache et 10 pour la sortie : cela correspond au prix de lancement de Google jusqu’au 2026-11-30, et non au prix standard 4/20 qui s’applique ensuite. Dans l’interface de tarification, model_ratio vaut 1, ce qui correspond à 2 USD par million de tokens en entrée ; completion_ratio vaut 5, ce qui signifie que le prix de sortie est 5 fois celui de l’entrée, en cohérence avec le tableau récapitulatif. Les groupes sont notés Default et SVIP dans la documentation, et default / svip dans l’interface de tarification. La page du modèle Carbon indique par ailleurs : contexte 1048576, sortie maximale 65536, connaissances à jour jusqu’à 2026-03, publié le 2026-11-10, mis en ligne le 2026-11-11. gemini-4-hydrogen figure sur la même page et peut servir de référence pour le niveau des tâches quotidiennes.
Étapes d’appel ultra-simples
- Créez un compte sur apiyi.com et générez une clé API, puis enregistrez-la dans la variable d’environnement
APIYI_API_KEY— n’écrivez jamais la clé en clair dans votre code. - Méthode compatible OpenAI :
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"). - Envoyez la requête :
client.chat.completions.create(model="gemini-4-carbon", messages=[{"role": "user", "content": "..."}]), le contenu renvoyé se trouve dansresponse.choices[0].message.content. - Méthode native Gemini : URL de base
https://api.apiyi.com, version d’APIv1beta, adaptée aux projets qui utilisent déjà le SDK Google GenAI. - Pour les sous-tâches du quotidien : avec la même clé, il suffit de remplacer
modelpargemini-4-hydrogen.
Ce qu’on peut préparer avant la sortie de Gemini 4 Neon
D’après le guide développeur de Google Cloud, l’intégration de Neon diffère de Carbon sur quelques points, qu’on peut corriger dès maintenant dans le code :
- Niveaux de réflexion : uniquement
low,medium,highetxhigh, avechighpar défaut. Passerthinking_budgetouMINIMALrenvoie une erreur HTTP400. - Cache : pas de cache de contexte explicite ; les préfixes partagés de plus de 4096 tokens passent automatiquement par le cache implicite, et le cache persistant est activé par défaut.
- Limite de sortie : plafond unifié à 1048576 tokens, entrée et sortie confondues ; la sortie inclut la réflexion, les appels de fonction et la réponse finale. Un segment unique est limité par défaut à 65536, et un décodage long peut monter jusqu’à 1048576 moins la longueur de l’entrée.
- Fichiers : lecture directe des formats Office et OpenDocument.
🎯 Conseil technique : vous pouvez dès maintenant exécuter votre propre jeu de tâches avec
gemini-4-carbonetgemini-4-hydrogensur APIYI apiyi.com, en notant pour chaque tâche le nombre de tokens de sortie et le coût. Une fois Neon disponible, relancez le même lot de tâches : c’est cette conversion qui vous donnera le compte réel de votre activité.
Scénarios recommandés pour Gemini 4 Neon et Carbon
Le tableau ci-dessous rassemble le positionnement officiel et les données tierces, en indiquant la source de chaque justification. La colonne « niveau à examiner en premier » reflète notre jugement, à titre indicatif seulement ; elle ne constitue pas une conclusion déf initive.
| Scénario | Niveau à examiner en premier | Justification (source) | Statut APIYI |
|---|---|---|---|
| Tâches longues les plus difficiles | Carbon high | Positionnement officiel ; Carbon n’a pas de niveau xhigh (AI Studio) | Déjà disponible, utilisable sur apiyi.com |
| Flux complexes à haute fréquence | Neon high | Positionnement officiel ; même score de 60 que Carbon high (page du modèle sur Artificial Analysis) | Pas encore disponible |
| Besoin d’un point de profondeur supplémentaire | Neon xhigh | 61 points (page du modèle et article d’Artificial Analysis) | Pas encore disponible |
| Budget calculé au tarif de lancement | Carbon high | 4.90 $ par tâche (page du modèle sur Artificial Analysis) | Déjà disponible |
| Boucles quotidiennes rapides, orchestration de sous-tâches | Hydrogen | Positionnement officiel ; usage d’orchestration décrit dans le guide développeur | Déjà disponible |
Cas où continuer principalement avec Carbon
- Les tâches longues sont déjà bien réglées : les invites et la chaîne d’outils ont été ajustées autour de Carbon high, et Neon high affiche simplement le même score sur la page du modèle d’Artificial Analysis.
- La facture est réglée au tarif de lancement : selon le troisième scénario de calcul, le coût par tâche de Carbon high est inférieur à celui de Neon xhigh.
- Vous utilisez surtout les niveaux medium ou low : pour ces deux niveaux, Carbon obtient un meilleur score sur la page du modèle d’Artificial Analysis.
Cas où placer Neon à côté de Carbon
- Nombre d’appels élevé, exigence moyenne à plutôt difficile par appel : cela correspond au positionnement officiel de Neon pour les « flux complexes à haute fréquence ».
- Vous voulez une couche d’orchestration : comme le recommande le guide développeur, Neon orchestre et Hydrogen exécute les sous-tâches.
- Vous vous intéressez au travail intellectuel sur des documents comme GDP.pdf : dans l’article d’Artificial Analysis, Neon high obtient 33.4 %, contre 28.4 % pour Carbon high.
Recommandations de décision pour Gemini 4 Neon et Carbon
Notre verdict : mieux vaut répartir Neon et Carbon selon les tâches que choisir l’un ou l’autre de façon globale. Sur la profondeur, xhigh ne devance high que d’un point, et high face à high donne un match nul ; côté coûts, les trois méthodes de calcul aboutissent à des conclusions de sens différent, car le prix de Carbon n’est pas exprimé dans le même référentiel. Avec les seules données publiques, impossible de calculer une réponse unique pour votre activité.
L’approche la plus sûre : sélectionner un lot de tâches réelles représentatives, noter pour chacune le nombre de tokens de sortie et la qualité du résultat, puis appliquer votre prix unitaire réel. L’article d’Artificial Analysis indique déjà que Neon produit environ 15 % de tokens de sortie en plus par tâche, ce qui pèse directement sur le résultat d’une facturation à l’usage.
💡 Conseil de choix : garder Carbon ou ajouter Neon dépend surtout de la répartition des tâches et du prix unitaire réel. Vous pouvez d’abord établir une base de référence pour Carbon et Hydrogen via l’interface unifiée d’APIYI apiyi.com, puis, une fois Neon disponible, remplacer directement l’ID du modèle pour comparer — sans toucher au code d’appel.
FAQ — Questions fréquentes
Q1 : Qu’est-ce que Gemini 4 Neon ?
Gemini 4 Neon est un modèle publié par Google le 2026-11-18, adapté de Gemini 4 Carbon d’après sa fiche modèle. Son positionnement officiel le place entre Hydrogen et Carbon : il vise les workflows complexes à haute fréquence et propose quatre niveaux de réflexion — low, medium, high et xhigh — avec high par défaut.
Q2 : Quel écart de profondeur entre Gemini 4 Neon et Carbon ?
D’après la page modèle d’Artificial Analysis, Neon xhigh obtient 61 points, Carbon high 60 points, et Neon high également 60 points. Carbon n’a pas de niveau xhigh : l’écart d’un point vient donc de la comparaison Neon xhigh contre Carbon high. Sur les niveaux medium et low, c’est Carbon qui obtient les meilleurs scores.
Q3 : Pourquoi les trois bilans de coûts aboutissent-ils à des conclusions différentes ?
Parce que le référentiel de prix de Carbon n’est pas le même. Les 32 % de moins annoncés par Google ne précisent pas sur quel référentiel de prix Carbon est mesuré ; l’article d’Artificial Analysis (environ 17 % de moins, et moins de la moitié) se base sur le prix standard 4/20 ; la page modèle d’Artificial Analysis, avec 4.90 dollars, se base sur le prix de lancement 2/10. Ces trois chiffres ne peuvent être comparés qu’un à un, ils ne se soustraient pas les uns des autres.
Q4 : Quand se termine le prix de lancement de Gemini 4 Carbon ?
La page des derniers modèles d’AI Studio indique que le prix de lancement court jusqu’au 2026-11-30, avec 2.00 en entrée et 10.00 en sortie. Le prix actuel de `gemini-4-carbon` sur APIYI est aligné sur ce prix de lancement ; en cas d’ajustement par la suite, c’est la liste des modèles de la plateforme qui fait foi.
Q5 : Comment appeler rapidement Gemini 4 Carbon via l’API ?
Inscrivez-vous sur APIYI apiyi.com, récupérez une clé API et un quota de test gratuit, puis appelez `gemini-4-carbon` en mode compatible OpenAI tout simplement ; l’endpoint natif Gemini, lui, utilise `v1beta`. `gemini-4-neon` n’est pas encore disponible ; une fois publié, vous pourrez basculer avec la même clé.
Q6 : Quelles sont les limitations connues de Gemini 4 Neon ?
– D’après la page tarifaire d’AI Studio, pas d’offre gratuite, et le prix de sortie inclut les tokens de réflexion.
– D’après le guide développeur, la mise en cache explicite du contexte n’est pas prise en charge : passer `thinking_budget` ou `MINIMAL` renvoie `400`.
– La version web n’est fournie qu’aux défenseurs de confiance du Fairwind Program, sans ID de modèle public.
Q7 : Les 12.8 % et 39.0 % de SWE-sweep sont-ils directement comparables ?
Non, pas directement. Les deux chiffres viennent de harness différents : 12.8 % avec mini-SWE harness, 39.0 % dans Google Antigravity. Le blog de Google attribue cet écart au harness, il reflète donc une différence d’environnement de test.
Gemini 4 Neon et Carbon : points clés (Key Takeaways)
- Positionnement dans la gamme : Carbon prend en charge les tâches longues les plus difficiles, Neon les flux complexes à haute fréquence, Hydrogen l’exécution quotidienne rapide.
- Alignement des niveaux : Carbon n’a pas de xhigh ; le xhigh de Neon se compare au high de Carbon.
- Écart de profondeur : Neon xhigh 61 points, Carbon high 60 points, Neon high également 60 points.
- Trois comptabilités à lire séparément : 32 % selon les chiffres officiels, 17 % dans l’article d’Artificial Analysis, 4,90 $ sur la page du modèle — les référentiels ne sont pas les mêmes.
- Fin du tarif de lancement : le tarif de lancement de Carbon à 2/10 court jusqu’au 2026-11-30 ; passé cette date, les hypothèses de la troisième comptabilité changeront.
- Comment démarrer : APIYI propose déjà
gemini-4-carbonetgemini-4-hydrogen;gemini-4-neonn’est pas encore disponible.
En résumé
Les points essentiels de la comparaison entre Gemini 4 Neon et Gemini 4 Carbon :
- Profondeur : une fois les niveaux alignés, l’écart se réduit à 1 point entre Neon xhigh et Carbon high ; sur le niveau high, les deux modèles sont à égalité.
- Coût : les trois comptabilités tiennent chacune de leur côté parce que le référentiel de prix de Carbon diffère ; on ne peut pas fusionner les conclusions.
- Positionnement : l’éditeur place Neon à côté de Carbon, pour absorber les flux complexes à haute fréquence.
Cet article ne tranche pas sur ce qu’il faudrait remplacer. Je conseille de refaire le calcul avec vos propres données de tâches et votre prix unitaire réel avant de décider comment répartir les flux. Le mieux est de passer par APIYI (apiyi.com) pour établir d’abord une base de référence avec Carbon et Hydrogen, puis d’ajouter le troisième groupe de comparaison une fois Neon disponible.
📚 Références
-
Publication de Sundar Pichai : lancement de Gemini 4 Neon et canaux de disponibilité
- Lien :
x.com/sundarpichai/status/2123167780988125621 - Description : la formulation officielle employée le jour du lancement
- Lien :
-
Blog Google « Introducing Gemini 4 Neon » : benchmarks et coûts annoncés par l’éditeur lui-même
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Description : source du « 32 % moins cher par tâche » et du positionnement dans la gamme
- Lien :
-
Fiche modèle DeepMind : spécifications et tableau comparatif
- Lien :
deepmind.google/models/model-cards/gemini-4-neon/ - Description : le tableau comparatif ne comporte pas de colonne Carbon ; les résultats des modèles non-Gemini sont auto-déclarés par chaque éditeur
- Lien :
-
Guide développeur Google Cloud : ID de modèle, niveaux de réflexion et règles de cache
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Description : les paramètres à modifier avant de brancher Neon
- Lien :
-
Pages tarifs et derniers modèles de Google AI Studio : prix unitaires, tarif de lancement et niveaux
- Lien :
aistudio.google.com/docs/pricing,aistudio.google.com/docs/latest-model - Description : source de la date limite du 2026-11-30 pour le tarif de lancement de Carbon
- Lien :
-
Article d’Artificial Analysis : mesures tierces et base de référence des prix standard
- Lien :
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Description : source du « environ 17 % de moins » et du « moins de la moitié »
- Lien :
-
Pages modèles d’Artificial Analysis : score d’intelligence par niveau et coût calculé sur la base du tarif de lancement
- Lien :
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/gemini-4-carbon - Description : source du 4,90 $ pour Carbon high
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; vous trouverez davantage de modèles et de tarifs dans le centre de documentation docs.apiyi.com