Choisir entre transfert officiel et inversé sur APIYI : conclusion directe
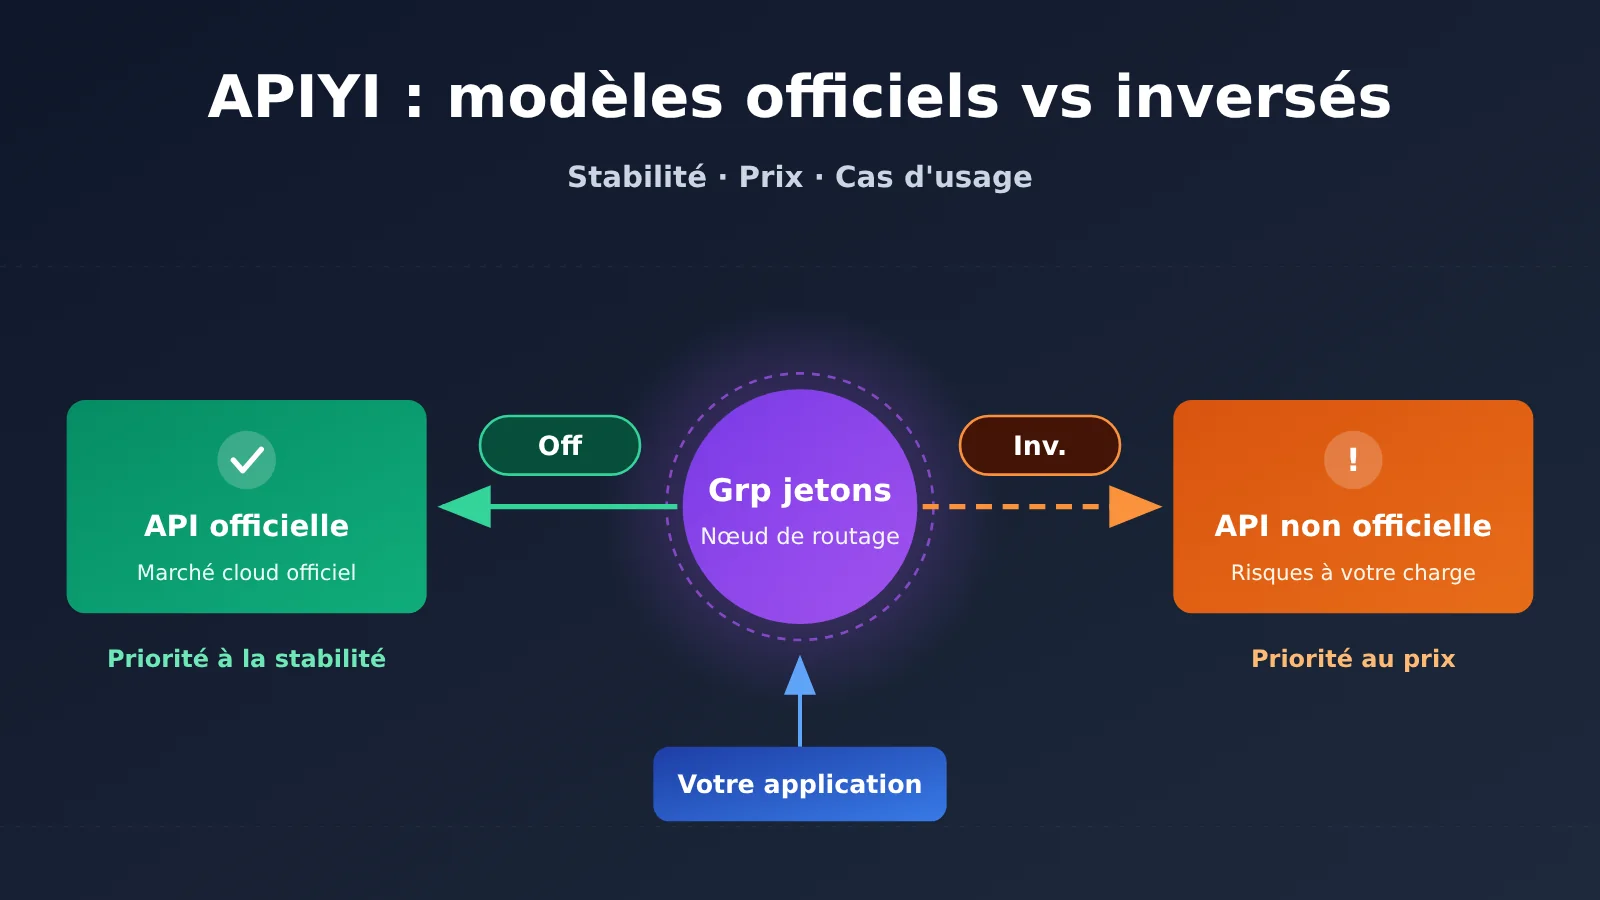
En production et pour les tâches Agent complexes, privilégiez le transfert officiel (官转) ; l’inversé (逆向) convient aux tâches non critiques et sensibles au coût. Le transfert officiel utilise directement l’API du fournisseur ou les ressources du marché cloud officiel ; l’inversé obtient la capacité d’appel via des interfaces non officielles. Les deux ne présentent pas les mêmes sources de risque.
Le choix ne doit pas se faire sur le simple label « officiel » ou « inversé », ni sur le nom d’un groupe. Ce qu’il faut comparer au final, c’est : un même modèle précis, un même groupe, un même lot de tâches réelles — en incluant les nouvelles tentatives — combien coûte réellement chaque production valide et combien de temps elle prend.
Ce que vous allez apprendre en lisant cet article
- Distinguer « groupe » et « modèle » : pourquoi un même groupe peut contenir à la fois des modèles officiels et inversés.
- Comprendre les dimensions de différence entre officiel et inversé publiées dans la documentation publique d’APIYI, et ce que le SLA public couvre réellement.
- À travers deux incidents réels survenus les 12 et 13 novembre 2026, comprendre les formes de panne propres à chaque type de canal.
- Récupérer une fiche de recette, pour comparer des canaux candidats sur de vraies tâches, sans trancher sur le seul prix affiché.
Index de sélection entre transfert officiel et reverse engineering
La partie « faits objectifs » présente successivement : la classification des canaux et des groupes, les dimensions publiques des différences fonctionnelles, la chronologie de deux incidents réels d’exploitation, ainsi que les conditions d’application des mécanismes de compensation publiés. La partie « analyse et jugement » examine comment arbitrer entre trois usages — agents en production, chat ordinaire et achat en entreprise —, explique pourquoi un tarif affiché bas ne signifie pas un coût faible, puis propose une méthode de consignation des tests d’acceptation et un script d’enregistrement directement exécutable.
À savoir : concepts liés au transfert officiel et au reverse engineering
| Concept | Explication succincte |
|---|---|
| Transfert officiel | Canal qui relaie les requêtes vers l’API officielle du fournisseur ou vers sa place de marché cloud officielle |
| Reverse engineering | Canal qui donne accès aux capacités d’invocation du modèle via une interface non officielle |
| Groupe | Canal de routage et de facturation utilisé par le jeton ; les modèles réellement accessibles dépendent aussi du model renseigné dans la requête |
| Tool Calling | Capacité du modèle à demander à un outil externe d’exécuter une action au moyen de paramètres structurés ; c’est une brique de base des tâches d’agent |
| Cache de préfixe | Réutilisation du début identique d’une requête pour réduire les calculs répétés et la facturation |
| SLA | Périmètre de garantie, responsabilités et conditions de compensation prévus dans le contrat ou la description du service |
| Latence P95 | Durée de réponse que 95 % des échantillons ne dépassent pas ; sert à observer les requêtes lentes |
Aperçu rapide des impacts du relais officiel et du reverse engineering
- Développeurs en environnement de production : avant de comparer les prix, vérifiez d’abord si l’appel d’outils, les sorties structurées, le cache et le repli en cas de panne répondent aux exigences de la tâche.
- Acheteurs en entreprise et responsables techniques : les pages publiques ne donnent aucun engagement de taux de disponibilité uniforme couvrant tous les modèles ; il faut obtenir les clauses contractuelles applicables à ce projet.
- Tâches personnelles ou internes non critiques : le reverse engineering peut être une option de réduction des coûts, mais la comparaison doit se faire sur le coût de production utile, réessais inclus.
Faits objectifs : les informations publiques sur le relais officiel et le reverse engineering d’APIYI
Les faits de cette section proviennent des pages publiques du centre de documentation d’APIYI, vérifiées le 17 novembre 2026 (heure de Pékin). La comparaison des fonctionnalités qui y figure relève de la description fournie par la plateforme en tant que fournisseur, et non d’un comparatif tiers. D’après les archives, la « page de présentation des groupes et la FAQ relais officiel vs reverse engineering » a été publiée le 14 novembre 2026 à 23 h 38.
Différences entre relais officiel, reverse, groupes et modèles
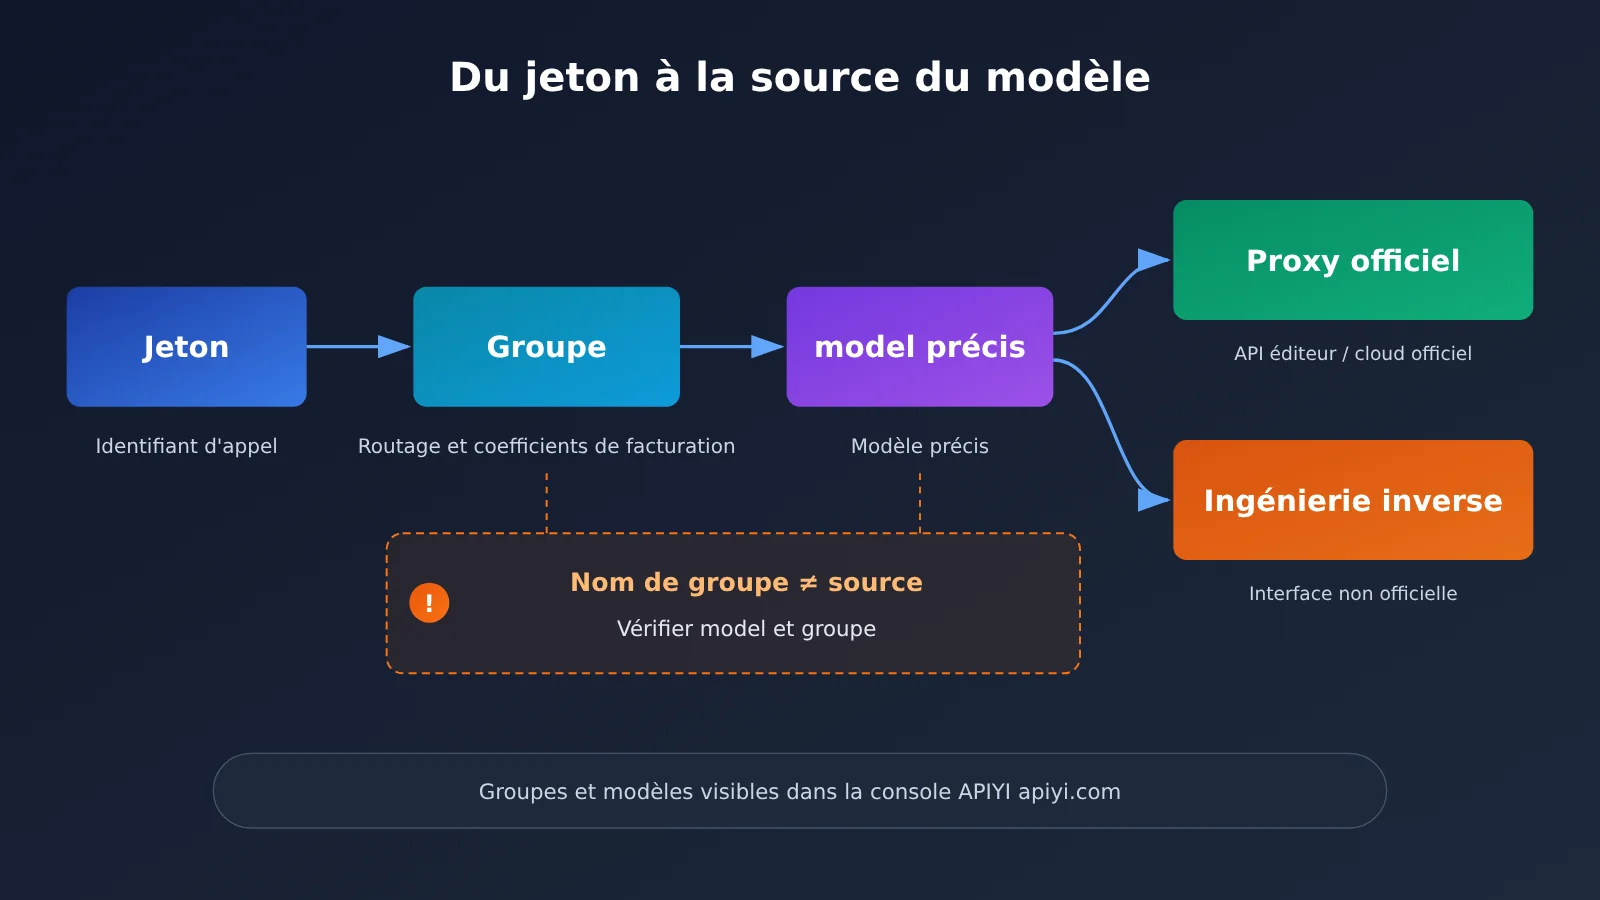
D’après la FAQ publique, le « 官转 » (relais officiel) s’appuie sur l’API du fournisseur ou sur les ressources du marketplace cloud officiel, tandis que le « 逆向 » (reverse) passe par des interfaces non officielles. Un point prête facilement à confusion : l’attribut de canal est attaché au modèle précis, pas au groupe. La documentation l’indique clairement : les groupes Default et SVIP contiennent eux aussi des modèles image en relais officiel ou en reverse. On ne peut donc pas déduire la provenance d’une image en regardant uniquement le nom du groupe.
Le groupe est le canal d’appel du jeton (token). Il joue sur trois choses : quels modèles sont accessibles, comment les requêtes sont routées, et quel coefficient de facturation s’applique. L’ordre recommandé dans la doc pour choisir un groupe est le suivant : vérifier d’abord quels groupes prennent en charge le modèle visé, puis faire correspondre avec l’usage, comparer les prix, et enfin configurer un canal de secours. Un même compte peut être découpé en plusieurs jetons selon les usages ; le prix final est celui affiché dans la console.
| Positionnement du groupe (description publique) | Usage principal | Points à vérifier au moment du choix |
|---|---|---|
| Default | Appels courants | Le groupe peut contenir à la fois des modèles en relais officiel et en reverse ; il faut vérifier chaque model un par un |
| ClaudeCode | Appels de programmation au format Anthropic | Pensé pour les outils de programmation, format différent de l’interface compatible OpenAI |
| Groupe entreprise / groupe dédié aux images | Positionnement de ressources à part | Les archives contiennent des groupes entreprise avec multiplicateur ; le prix affiché dans la console fait foi |
| Groupes dont le nom contient Reverse | Groupes de ressources reverse déjà vus dans les archives | Les remises correspondent aux annonces de l’époque et peuvent évoluer ensuite ; à confirmer dans la console APIYI apiyi.com |
La description de la couverture reverse de la série Fable dans la FAQ publique ne correspond pas au registre actuel. Cet article ne garantit pas que cette série soit réellement appelable dans les groupes reverse : fiez-vous aux modèles réellement sélectionnables dans la console.
Dimensions des différences fonctionnelles entre relais officiel et ingénierie inverse
La comparaison publique énumère les dimensions d’acceptation suivantes et souligne que les conclusions doivent toujours être rattachées à des modèles et à des groupes précis. La position de la plateforme est claire : pour les environnements de production et les agents complexes, privilégiez le relais officiel ; l’ingénierie inverse sert aux tâches non critiques et sensibles au coût. L’expérience réelle doit de toute façon être vérifiée séparément selon le canal, la plage horaire et la tâche.
| Dimension | Ce qu’on vérifie lors de l’acceptation |
|---|---|
| Transmission des paramètres | Les paramètres comme temperature, max_tokens prennent-ils effet tels quels |
| Retour en streaming | La sortie par blocs est-elle stable, la latence du premier token est-elle acceptable |
| Structure des appels d’outils | Le champ tool_calls est-il complet, les appels multi-tours renvoient-ils des erreurs |
| Contraintes JSON | La sortie structurée passe-t-elle la validation du schéma |
| Limite de contexte et contrôle du raisonnement | Les entrées longues sont-elles tronquées, les niveaux de raisonnement prennent-ils effet |
| Multimodal | Les entrées image et vidéo sont-elles correctement reconnues |
| usage / codes d’erreur | Les statistiques de tokens sont-elles exploitables pour la réconciliation, les codes d’erreur permettent-ils de distinguer ce qui est réessayable de ce qui ne l’est pas |
| Préfixe de cache | Les préfixes répétés touchent-ils le cache, sont-ils facturés au tarif du cache |
| Capacité et continuité des ressources | Aux heures de pointe, les erreurs 429 ou les files d’attente sont-elles fréquentes |
Chronologie de deux incidents réels (novembre 2026)
Les deux incidents ci-dessous sont de véritables relevés d’exploitation, et non des expériences comparatives. Ils ne décrivent l’état d’une voie donnée qu’à un instant précis et ne permettent pas d’en déduire un taux de disponibilité sur la durée.
| Heure (UTC+8) | Voie / Modèle | Incident | Explication fournie par la plateforme |
|---|---|---|---|
| 2026-11-12 17:15 | GPT Image 2.6 – relais officiel | Taux d’erreur en hausse, ralentissements | Cause : panne de l’upstream OpenAI ; certaines autres voies listées à ce moment-là restaient disponibles |
| 2026-11-12 17:48 | GPT Image 2.6 – relais officiel | Rétabli | Incident d’environ 33 minutes |
| 2026-11-13 13:16 | Trois lignes GPT Image -vip en relais inversé officiel | Saturation, erreurs 429 et files d’attente fréquentes | Réapprovisionnement du pool de comptes perturbé ; il est conseillé d’utiliser le relais officiel ou 2.6-all comme solution de secours |
En rapprochant ces deux incidents, la conclusion est claire : le relais officiel subit lui aussi les fluctuations de l’upstream, tandis que le goulot d’étranglement des lignes inversées tient davantage à la capacité du pool de comptes. Les archives contiennent des cas similaires. Par exemple, le 15 octobre 2026, le dépassement de délai du relais officiel DeepSeek provenait d’une panne du fournisseur d’origine ; le même jour, lorsque la charge des lignes -vip était trop élevée, la plateforme recommandait de basculer d’abord sur le relais officiel en secours.
Mécanisme de compensation public et conditions d’application
La page SLA publique l’indique clairement : pour les problèmes imputables à la plateforme, celle-ci vérifie les journaux et réémet des crédits ; les clients image à gros volume désignés dont la consommation mensuelle dépasse 10 000 USD peuvent demander une vérification et une compensation lorsqu’ils constatent une facturation manifestement anormale. Les contrats d’entreprise peuvent préciser la portée de la garantie, la disponibilité, les délais de réponse et le plafond d’indemnisation.
La page ne fournit pas de tableau contractuel unifié du taux de disponibilité mensuel, du P95 ou du MTTR couvrant l’ensemble des modèles des canaux officiels relayés et des canaux rétro-ingénierés. Les 300 secondes mentionnées sur la page ne sont qu’un exemple de facturation anormale : il ne s’agit en aucun cas d’un engagement d’indemnisation pour une génération d’image dans un délai imparti.
Analyse et arbitrage : comment choisir entre relais officiel et rétro-ingénierie chez APIYI
Cette section reflète le jugement de l’auteur, fondé sur les faits exposés plus haut ; elle n’engage pas la plateforme.
Choisir entre relais officiel et canal inversé selon trois cas d’usage
Agents en production : les tâches d’agent multi-tours reposent sur la structure des appels d’outils, les contraintes JSON et le préfixe de cache. Si un seul de ces éléments vacille, toute la chaîne de tâches est réexécutée. La documentation publique cite ces dimensions comme critères pour privilégier le relais officiel ; pour un agent en production, on recommandera donc le relais officiel comme canal principal. Il faut également prévoir un groupe de secours — mais attention : le groupe de secours ne fait que garantir « qu’un canal est disponible ». Le format et les sorties du modèle de secours doivent quand même être validés séparément.
Chat ordinaire et tâches non critiques : pour une conversation à un seul tour, un brouillon interne ou une réécriture en masse, le coût d’un nouvel essai après échec est très faible. Le canal inversé est donc adapté à une réduction des coûts. L’incident de saturation du canal -vip du 13 novembre nous rappelle que les lignes inversées peuvent concentrer des erreurs 429 à certaines heures : mieux vaut leur adjoindre un relais officiel ou un autre modèle comme filet de sécurité.
Achats en entreprise : les mécanismes de compensation décrits sur les pages publiques ne couvrent que les problèmes « attribuables à la plateforme » et certains gros clients image désignés ; il ne faut pas les considérer comme un SLA général. Pour les projets exigeant une disponibilité et des pénalités claires, il convient de négocier des clauses contractuelles portant sur les modèles précis concernés par le projet.
Pourquoi un prix d’affichage bas ne signifie pas un coût faible
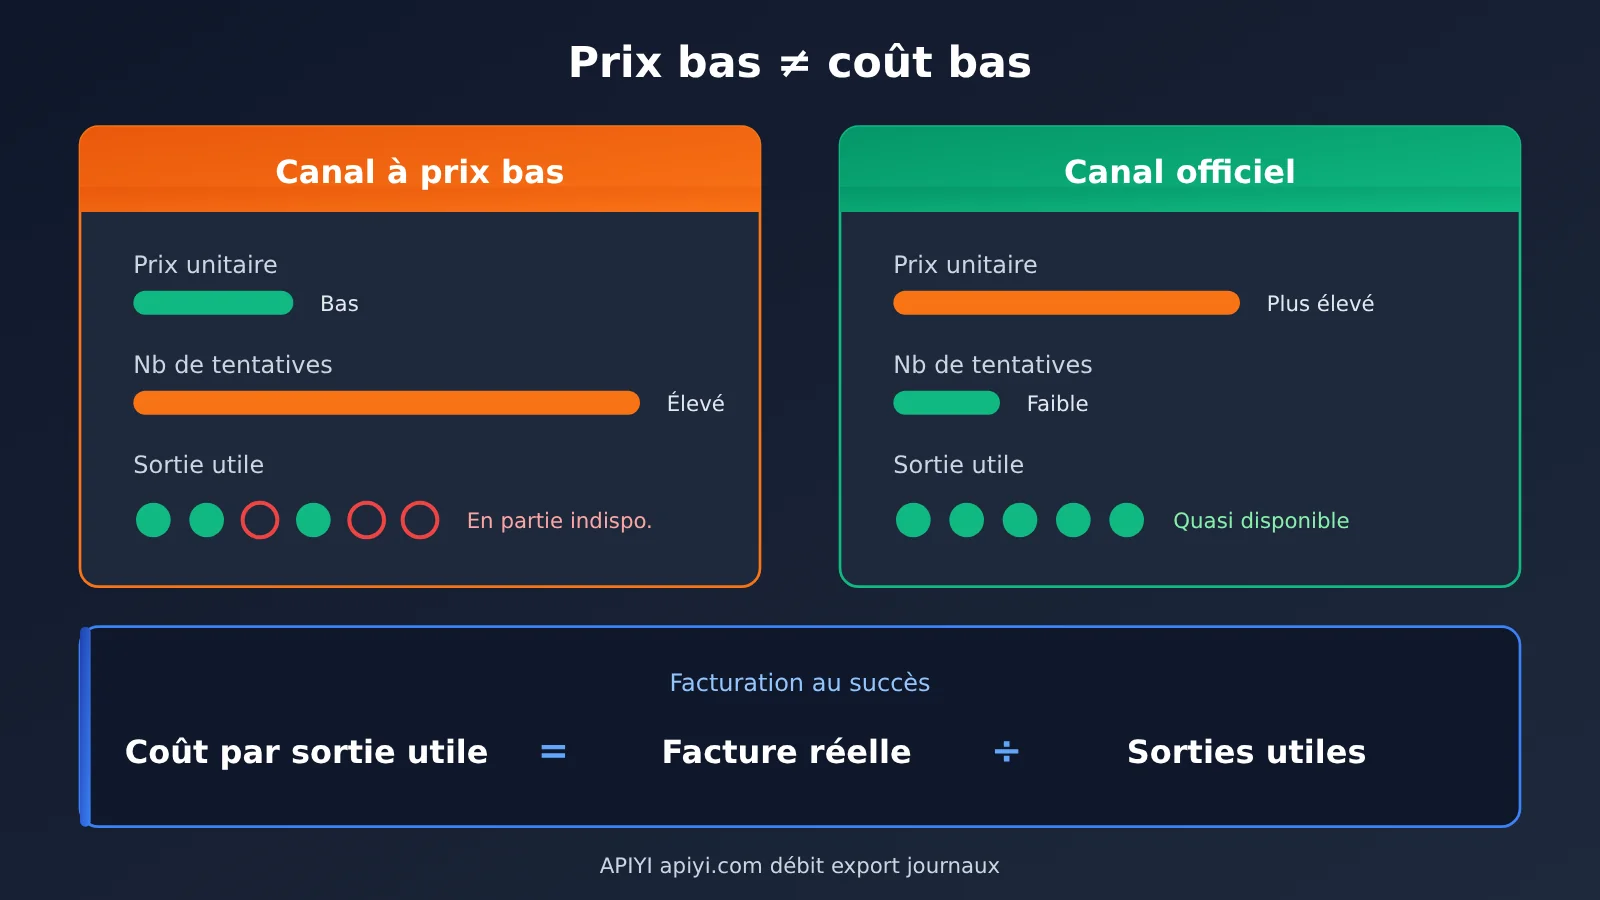
Le prix affiché se calcule par requête, mais ce qui intéresse vraiment une activité, c’est combien coûte chaque tâche menée à bien. Prenez une voie (un canal) dont le prix unitaire est bas, mais qui demande de nombreuses tentatives, ou dont les champs d’appel d’outil incomplets obligent à relancer tout un tour d’Agent : son coût de production effectif peut au contraire être plus élevé. Même chose pour les tâches d’images : la file d’attente et les erreurs 429 allongent la durée totale, et dans les scénarios avec une échéance de livraison, ce temps compte lui aussi comme un coût.
À l’inverse, pour des tâches par lots hors ligne qui tolèrent les échecs et n’ont pas de contrainte de temps, la remise du groupe « inversé » (reverse) est une économie bien réelle. La bonne approche n’est donc pas de dire en gros « l’officiel coûte cher, le reverse est bon marché », mais de faire les comptes séparément selon le type de tâche.
Valider les canaux candidats avec de vraies tâches
Voici le tableau de validation proposé dans cet article : ce ne sont pas des données mesurées, et aucune disponibilité n’y est renseignée. Le chat, l’appel d’outils, la sortie structurée et les tâches d’image doivent être comptés séparément. Si l’échantillon est trop petit, ou s’il ne couvre pas les périodes de panne, contentez-vous de noter les événements et la méthode, sans écrire des conclusions du type « stabilité supérieure de X % ».
| Champ enregistré | Comment le remplir |
|---|---|
| Tâche fixe | Le même jeu d’invites et d’entrées, par exemple 50 cas d’appel d’outils |
| Date et plage horaire | Couvrez les heures de pointe et les heures creuses, en précisant UTC+8 |
| Modèle / groupe | Indiquez le modèle précis et le groupe de jetons, par exemple un jeton de test créé séparément dans la console APIYI apiyi.com |
| Nombre total de tentatives / sorties exploitables | Les nouvelles tentatives comptent aussi dans le dénominateur ; exploitable = validé par le format ou par une vérification humaine |
| Latence du premier token / latence totale / P95 | Pour les tâches en streaming, notez la latence du premier token ; pour les tâches d’image, la durée totale |
| Coût réel | Basez-vous sur la facturation ou sur les débits des journaux, puis divisez par le nombre de sorties exploitables pour obtenir le coût d’un succès |
L’enregistrement peut se faire automatiquement avec un petit script. Comme le groupe est lié au jeton, vous pouvez créer un jeton par groupe candidat et faire tourner la même série de tâches sur chacun :
import time, openai

# Un jeton par groupe candidat, à créer dans la console APIYI
CANDIDATES = {"official": "KEY_OFFICIAL_GROUP", "reverse": "KEY_REVERSE_GROUP"}
MODEL = "your-model-name"  # indiquez le modèle réellement disponible pour ce groupe dans la console

def run(group, key, prompt, max_retry=3):
    client = openai.OpenAI(api_key=key, base_url="https://api.apiyi.com/v1")
    for attempt in range(1, max_retry + 1):
        t0 = time.time()
        try:
            r = client.chat.completions.create(model=MODEL,
                messages=[{"role": "user", "content": prompt}])
            return {"group": group, "attempts": attempt,
                    "latency": round(time.time() - t0, 2),
                    "usage": r.usage.model_dump() if r.usage else None,
                    "ok": bool(r.choices[0].message.content)}
        except Exception as e:
            last = str(e)
    return {"group": group, "attempts": max_retry, "ok": False, "error": last}

for g, k in CANDIDATES.items():
    print(run(g, k, "用 JSON 返回北京今天的三条出行建议"))
Voir la version avec vérification de l’appel d’outils
import json, time, openai

client = openai.OpenAI(api_key="YOUR_API_KEY",
                       base_url="https://api.apiyi.com/v1")  # interface unifiée APIYI

tools = [{"type": "function", "function": {
    "name": "get_weather",
    "parameters": {"type": "object",
                   "properties": {"city": {"type": "string"}},
                   "required": ["city"]}}}]

def check_tool_call(model):
    t0 = time.time()
    r = client.chat.completions.create(
        model=model, tools=tools,
        messages=[{"role": "user", "content": "查一下上海天气"}])
    calls = r.choices[0].message.tool_calls or []
    valid = False
    if calls:
        try:
            valid = "city" in json.loads(calls[0].function.arguments)
        except json.JSONDecodeError:
            valid = False
    return {"model": model, "tool_call_valid": valid,
            "latency": round(time.time() - t0, 2)}

print(check_tool_call("your-model-name"))
🚀 Conseil de validation : commencez par créer sur APIYI apiyi.com un jeton de test pour le groupe officiel et un pour le groupe reverse, puis faites tourner la même série de tâches avant d’aller consulter les débits réels dans les journaux de la console : c’est bien plus fiable que de se fier aux tarifs affichés. Les nouveaux utilisateurs peuvent déjà faire cette étape avec le quota d’essai gratuit.
Une fois l’exécution terminée, il suffit de fusionner les frais déduits relevés dans le journal avec le nombre de tentatives enregistré par le script pour obtenir le coût par succès de chaque groupe. Si une panne upstream survient par la suite, la rubrique « actualités en temps réel » du centre de documentation APIYI apiyi.com publiera l’état du canal correspondant : vous pourrez alors décider si l’échantillon anormal doit être exclu, ou simplement annoté séparément.
Ce qui suit est une prédiction, non encore vérifiée : à mesure que les fournisseurs ajustent leurs contrôles de risque et leurs ressources, la capacité des lignes inversées continuera probablement de fluctuer par phases, et les canaux officiels continueront eux aussi de subir l’impact des incidents upstream. Il n’est donc pas judicieux d’archiver définitivement un enregistrement de validation après une seule passe : mieux vaut le relancer à chaque mise à niveau de modèle ou ajustement de groupe.
💡 Conseil de choix : un même compte peut contenir à la fois des jetons officiels et des jetons inversés, à répartir selon la criticité des tâches. Pour la couverture des modèles spécifiques et les multiplicateurs actuels, référez-vous au tableau de bord APIYI apiyi.com.
Les documents de sélection nous indiquent quelles dimensions valent la peine d’être examinées, mais la seule réponse à la question « quel canal convient réellement à votre activité » viendra de vos propres tâches, factures et relevés de latence. Comme l’écrivait Lu You dans Enseigner à son fils Zhu sur une nuit d’hiver : « Ce qu’on apprend sur le papier reste superficiel ; pour maîtriser vraiment la chose, il faut passer à la pratique. »
Auteur : équipe technique APIYI
Échanges techniques : pour les questions de configuration des groupes et des modèles, contactez-nous via la page d’accueil APIYI apiyi.com ; vous trouverez davantage de documentation dans le centre de documentation docs.apiyi.com