Note de l’auteur : tous ont « Flash » dans le nom, mais les modalités d’entrée, les endpoints et les multiplicateurs de groupe diffèrent. Cet article suit l’ordre « d’abord la page du modèle, puis les prix, enfin la tâche » pour expliquer clairement comment choisir un modèle Flash.
Beaucoup de gens choisissent un modèle de la gamme Flash de la façon suivante : dès que « Flash » apparaît dans le nom, ils le considèrent comme « rapide et pas cher », puis lui confient le codage, la lecture d’images et le calcul de formules. Le problème, c’est que les modèles dont le nom contient Flash n’ont pas les mêmes modalités d’entrée ni les mêmes endpoints disponibles. Certains ne prennent que du texte, d’autres savent lire des images et des vidéos, et certains ne passent même pas par /v1/messages.
Ce n’est pas un classement de « qui est le plus fort ». Cet article ne déclare pas qu’un modèle est globalement plus fort ou moins cher ; il donne seulement une procédure concrète pour choisir un modèle Flash : regarder d’abord les types d’entrée et les usages indiqués sur la page du modèle, comparer ensuite le prix d’entrée, le prix de sortie et la lecture du cache, puis choisir un modèle précis selon la tâche.
L’essentiel : après la lecture, vous pourrez choisir un modèle Flash dont les modalités correspondent à votre type d’entrée (texte pur, captures d’écran de graphiques, longues vidéos). Vous saurez aussi quelles tâches à forte déduction ne devraient pas être confiées par défaut à Flash.
Les points clés pour choisir un modèle Flash
| Point clé | Explication | Intérêt |
|---|---|---|
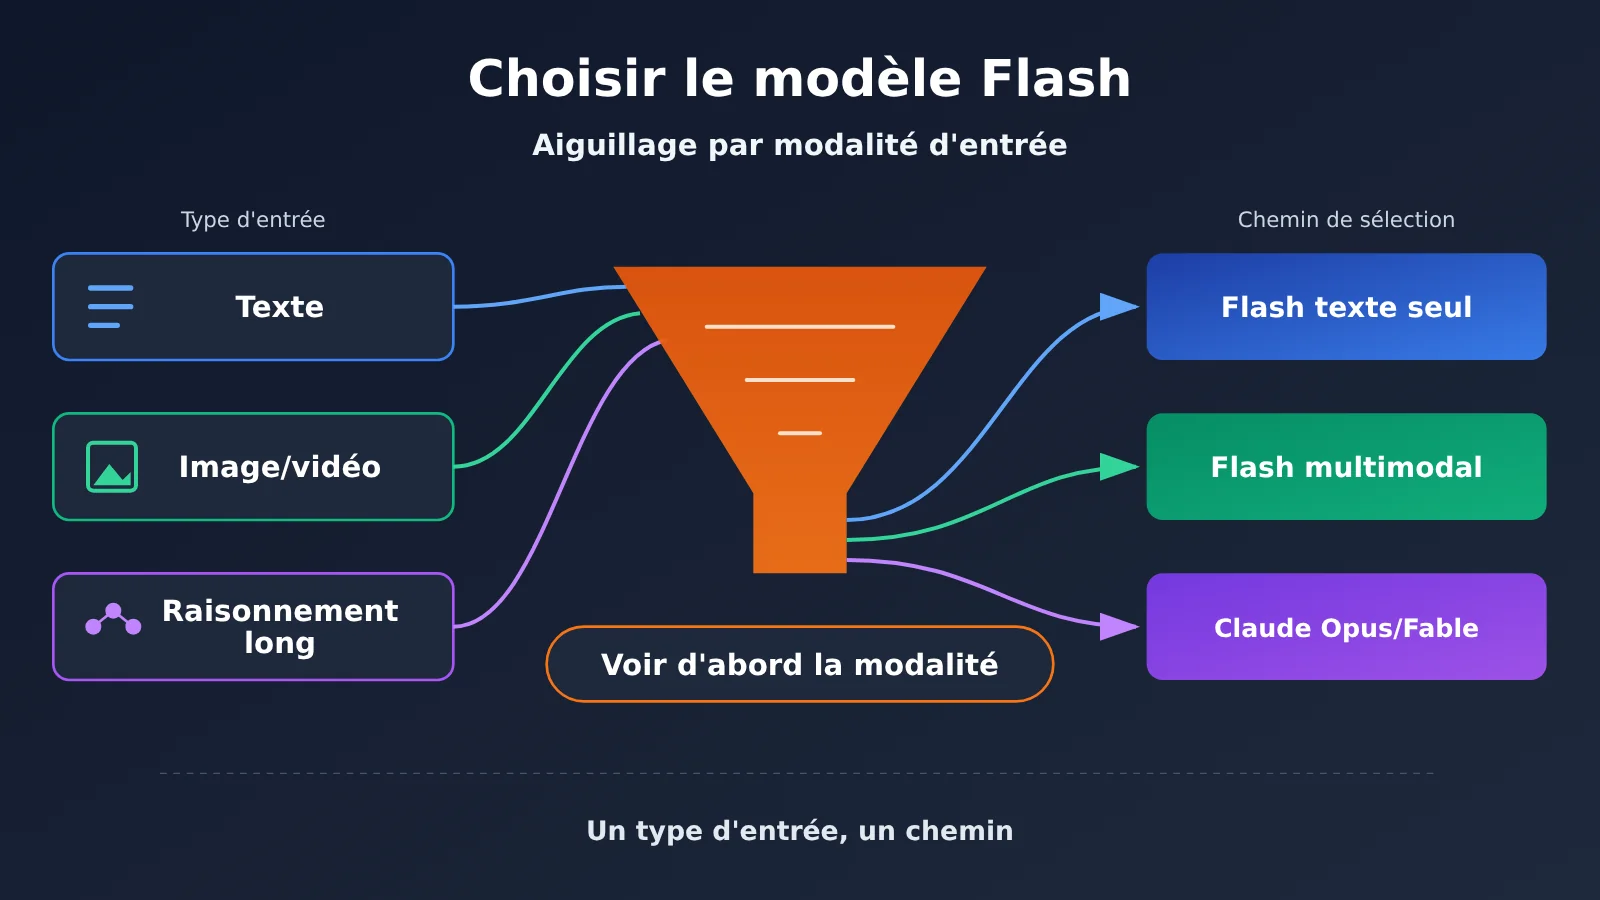
| D’abord, la modalité d’entrée | Le type d’entrée indiqué sur la page du modèle (texte/image/vidéo/audio) détermine s’il peut recevoir vos données | Éviter d’envoyer une capture d’écran à un modèle qui ne prend que du texte |
| Ensuite, l’endpoint | Les endpoints chat, messages et gemini ne sont pas pris en charge de la même façon selon les modèles | Éviter une erreur d’interface après avoir changé de modèle |
| Comparer les trois prix | Il faut regarder ensemble le prix d’entrée, le prix de sortie et la lecture du cache, puis multiplier par le coefficient du groupe | Obtenir une estimation de facture plus proche de la réalité |
| Répartir selon la tâche | Lire des graphiques ou modifier un court morceau de code avec un Flash dont les modalités correspondent | Garder les coûts des tâches à volume sous contrôle |
| Choisir un autre modèle pour les raisonnements lourds | Formules, démonstrations, travaux techniques à longue chaîne : ne pas prendre Flash par défaut | Confier les problèmes difficiles à un modèle plus haut de gamme |
Pourquoi on ne peut pas traiter tous les modèles Flash de la même façon selon leur nom
« Flash » est seulement le nom qu’un fabricant donne à une catégorie de modèles, et chaque éditeur en a sa propre définition. Sur la page des modèles APIYI (docs.apiyi.com/models.md), on voit que plusieurs modèles également appelés Flash vont d’une modalité d’entrée « texte uniquement » à « texte, image, vidéo, audio ». Les endpoints vont aussi de « chat et messages » à « chat seulement ».
Ainsi, pour choisir un modèle Flash, le nom sert uniquement à identifier une catégorie de modèles plutôt orientés volume et faible latence. Ce qui détermine réellement si le modèle peut convenir, ce sont les trois colonnes d’informations de sa page : le type d’entrée, les endpoints pris en charge et le coefficient du groupe. Toutes les données ci-dessous proviennent de la page du modèle et du tableau récapitulatif des modèles. Date de vérification : 2026-11-17 ; données du tableau récapitulatif mises à jour le 2026-11-16 à 09:39 (UTC+8) ; les prix sont les tarifs catalogue par défaut par million de tokens.
Modes d’entrée des modèles Flash et correspondance des endpoints
Le tableau ci-dessous réunit les modalités d’entrée et les endpoints de plusieurs modèles Flash. La première étape pour choisir un modèle consiste justement à écarter ici ceux dont les modalités ou l’endpoint ne correspondent pas à votre usage.
| ID du modèle | Modalités d’entrée | Sortie | Endpoint | Autres précisions sur la page du modèle |
|---|---|---|---|---|
deepseek-v4-flash |
Texte uniquement | Texte | chat, messages | Sorties structurées non prises en charge ; appel d’outils, réflexion approfondie facultative et cache d’invites disponibles |
deepseek-v4.1-flash |
Aucune page dédiée | — | chat, messages | Seulement une ligne dans le tableau récapitulatif ; les capacités seront à confirmer selon les précisions officielles à venir |
gemini-3.8-flash |
Texte, image, vidéo, audio | Texte | chat, gemini (pas de messages) | Réflexion approfondie activée par défaut, niveaux low/medium/high ; spécifications officielles pas encore publiées |
qwen3.8-flash |
Texte, image, vidéo | Texte | chat uniquement | Fenêtre de contexte 1 000 000, sortie max 131 072 |
glm-5.3-flash |
Texte, image, vidéo | Texte | chat uniquement | Fenêtre de contexte 1 000 000, sortie max 128 000 ; réflexion approfondie activée par défaut |
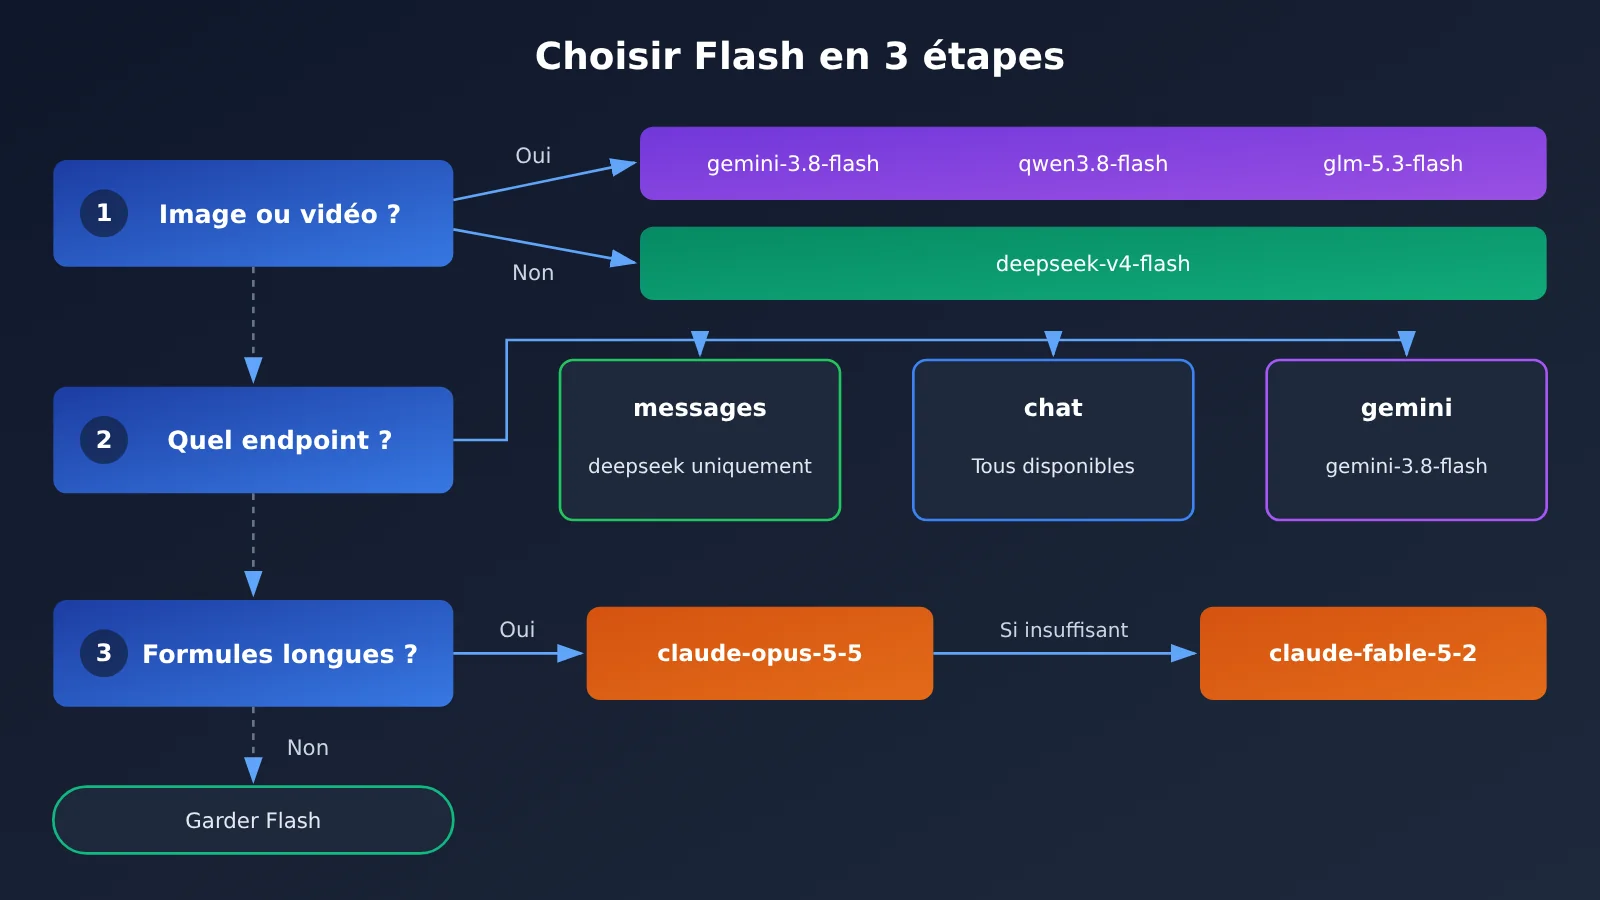
Deux points méritent une attention particulière. Premièrement, pour deepseek-v4-flash, les mentions « texte uniquement », la fenêtre de contexte de 1 048 576 et la sortie max de 393 216 proviennent toutes de la page du modèle v4 : elles ne doivent pas être transposées à deepseek-v4.1-flash. Pour v4.1, il n’existe pour l’instant qu’une ligne dans le tableau récapitulatif ; si les capacités ne sont pas clairement documentées, mieux vaut ne pas faire d’hypothèses. Deuxièmement, si votre projet utilise l’interface /v1/messages de style Anthropic, aucun des modèles Flash multimodaux ne fonctionnera : il faudra passer à l’endpoint chat.
Comment rapprocher les prix et les groupes des modèles Flash
Une fois les modalités et les endpoints validés, on passe aux prix. Changer de modèle modifie directement la facture, et le prix affiché ne correspond pas à la facturation réelle, car les groupes de jetons d’APIYI apiyi.com appliquent un multiplicateur. Le tableau ci-dessous indique les prix affichés par défaut et les groupes mentionnés sur la page du modèle.
| ID du modèle | Prix d’entrée | Prix de sortie | Lecture du cache | Groupe et multiplicateur |
|---|---|---|---|---|
deepseek-v4-flash |
$0.44 | $1.32 | $0.01408 | ClaudeCode 0.95× ; CodexResponses, Default, SVIP 1× |
deepseek-v4.1-flash |
$0.3 | $1.2 | $0.006 | ClaudeCode, CodexResponses, Default, SVIP |
gemini-3.8-flash |
$0.75 | $3.75 | $0.075 | Gemini_Reverse 0.5× ; Default, SVIP 1× |
qwen3.8-flash |
$0.114 | $0.3876 | $0.01425 | Default, SVIP 1× |
glm-5.3-flash |
$0.15 | $0.5 | $0.03 | CodexResponses, Default, SVIP |
claude-opus-5-5 |
$4 | $20 | $0.2 | voir le tableau récapitulatif des modèles |
claude-fable-5-2 |
$8 | $40 | $0.2 | aucun groupe Claude_Reverse |
Trois points à vérifier sur la facture des modèles Flash
Cet article ne tire pas de conclusion à votre place sur « qui est le moins cher », car le coût réel dépend de votre ratio entrée/sortie et de votre taux de succès du cache. Je vous propose de faire le rapprochement vous-même en trois étapes :
- Regardez le ratio entrée/sortie : pour les tâches d’analyse d’image ou de lecture de documents, l’entrée est volumineuse et la sortie faible, donc le prix d’entrée pèse davantage ; pour la génération de longs extraits de code ou de longs rapports, c’est le prix de sortie qui pèse le plus.
- Regardez la lecture du cache : dans les scénarios où l’invite système est fixe et où les appels sont répétés, le prix de lecture du cache influence nettement la facture totale.
- Multipliez par le multiplicateur du groupe : pour le même
gemini-3.8-flash, le groupe Gemini_Reverse facture à 0.5×, tandis que Default facture à 1× : le montant de la facture n’est pas le même.
💰 Conseil coût : le groupe auquel un jeton est rattaché change directement le résultat de la facturation. Avant de changer de modèle, vérifiez d’abord dans la console APIYI apiyi.com le groupe du jeton actuel, puis estimez le coût en multipliant le prix affiché du tableau ci-dessus par le multiplicateur, afin d’éviter de découvrir un changement de facture après la mise en production.
Choisir un modèle Flash selon la tâche
Une fois les modalités, les endpoints et les prix passés en revue, il reste à concrétiser tout ça tâche par tâche. Le tableau ci-dessous présente une approche de sélection par type de tâche. La répartition proposée s’appuie sur les informations des pages de modèles ; les capacités précises sont à vérifier sur ces pages.
| Type de tâche | Caractéristiques d’entrée | Modèles candidats | Critère de choix |
|---|---|---|---|
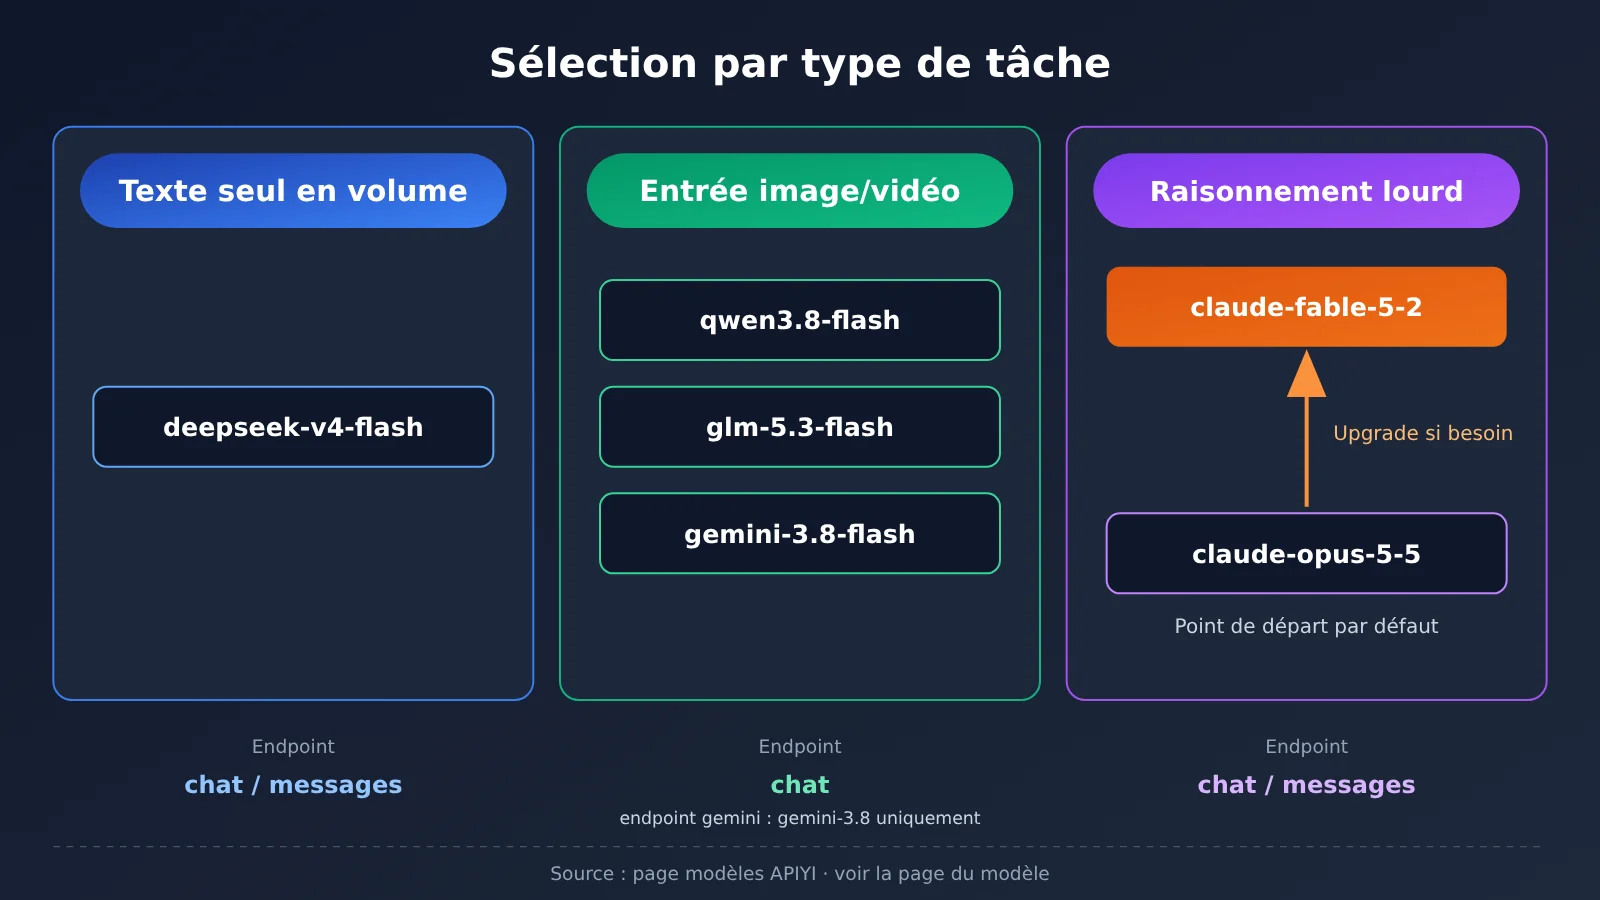
| Modifier du code court, traitement de texte à forte concurrence | Texte pur | deepseek-v4-flash |
La page du modèle met en avant une priorité aux hautes concurrences et à la faible latence ; prise en charge de l’endpoint messages |
| Modifier du code à partir de captures d’écran, lire des graphiques | Texte + image | qwen3.8-flash, glm-5.3-flash, gemini-3.8-flash |
La modalité d’entrée inclut l’image, avec prise en charge de la compréhension visuelle |
| Analyse de documents et de longues vidéos | Texte + vidéo | qwen3.8-flash, glm-5.3-flash, gemini-3.8-flash |
La modalité d’entrée inclut la vidéo ; la page du modèle qwen cite explicitement ce type de scénario à fort volume |
| Entrées contenant de l’audio | Texte + audio | gemini-3.8-flash |
Parmi les différents modèles, seul sa page mentionne une entrée audio |
| Formules, démonstrations, tâches techniques à longue chaîne | Forte déduction | claude-opus-5-5 → claude-fable-5-2 |
Aucune des quatre pages de modèles Flash ne désigne le calcul scientifique comme une spécialité |
Choix du modèle Flash pour les tâches de codage
Si l’entrée ne contient que du code et des explications textuelles, le modèle dont la modalité correspond est deepseek-v4-flash. La fiche de ce modèle indique mot pour mot : « MoE de 284B de paramètres totaux avec 13B activés, pensé pour la haute concurrence et la faible latence ». Il s’agit du texte de la fiche modèle, et non de mesures réalisées dans cet article. Il prend en charge à la fois les endpoints chat et messages, ce qui limite au minimum les modifications nécessaires lors du raccordement à un client de style Anthropic. Attention toutefois : la colonne « sortie structurée » est marquée comme non prise en charge. Si vous comptez sur JSON Schema pour contraindre la sortie, il faudra trouver une autre solution.
Si la tâche de codage s’accompagne de captures d’écran — par exemple « modifie le front-end en suivant cette maquette » — il faut passer à un Flash multimodal. La fiche de qwen3.8-flash indique mot pour mot qu’il est « adapté aux scénarios à fort volume comme le codage visuel, les documents et l’analyse de vidéos longues ». La fiche de glm-5.3-flash indique mot pour mot 320B de paramètres totaux, 18B activés, ainsi qu’un score de 84,3 sur Terminal-Bench 2.1. Ces deux séries de chiffres proviennent du texte des fiches modèles, pas de mesures effectuées dans cet article, et elles ne signifient pas non plus qu’il surpasse systématiquement les autres modèles.
Choix du modèle Flash pour la lecture d’images et de vidéos longues
Pour lire des graphiques, analyser des captures d’écran PDF ou décortiquer des vidéos longues, les modalités des trois Flash multimodaux correspondent toutes. La différence se joue surtout sur les endpoints et la colonne des fonctionnalités : gemini-3.8-flash prend en charge en plus l’entrée audio et l’exécution de code, et peut passer par l’endpoint gemini ; qwen3.8-flash et glm-5.3-flash n’ont que l’endpoint chat. La réflexion approfondie de gemini-3.8-flash et de glm-5.3-flash est activée par défaut : à garder en tête pour les tâches à fort volume sensibles à la latence.
Les tâches de déduction lourde ne passent pas par Flash par défaut
Il faut ici poser clairement la limite : Flash n’est pas totalement incapable de calculer, mais aucune des quatre pages de modèles ne présente le calcul scientifique, la démonstration ou la physique comme une spécialité ; il ne faut donc pas confier ce type de tâche par défaut à ce modèle. Dans son annonce du 2026-11-09, Anthropic positionne Claude Fable 5.2 sur les travaux techniques les plus difficiles, et recommande de démarrer la plupart des tâches de code et de connaissance avec Opus 5.5, puis de passer à Fable si cela ne suffit pas.
Les deux modèles sont déjà disponibles sur APIYI, avec les ID claude-opus-5-5 et claude-fable-5-2. Leur tarif est nettement supérieur à celui de la gamme Flash, d’où une répartition plus logique : les tâches à fort volume passent par Flash, et seules les dérivations de formules, les démonstrations et les analyses techniques à longue chaîne justifient une montée en gamme.
Prise en main rapide des modèles Flash
Une fois le modèle choisi, l’intégration est très simple. APIYI propose une interface compatible OpenAI : une seule clé API suffit pour appeler tous les modèles présentés ci-dessus. Voici les points de configuration essentiels, présentés comme dans la documentation d’aide.
Étape 1 : configurer le base_url et le point de terminaison du modèle Flash
- Dans votre client, définissez le base_url sur
https://api.apiyi.com/v1et renseignez comme clé API le jeton que vous avez créé dans la console. - Choisissez le chemin selon le modèle : tous les modèles peuvent passer par
/v1/chat/completions; seuldeepseek-v4-flash(ainsi quedeepseek-v4.1-flash, indiqué dans le tableau récapitulatif) peut passer par/v1/messages;gemini-3.8-flashpeut en plus passer par le point de terminaison Gemini. - Renseignez l’ID du modèle dans le champ
modeldu corps de la requête, par exempleqwen3.8-flash.
Étape 2 : organiser les requêtes du modèle Flash selon la modalité d’entrée
- Texte seul : placez simplement
roleet lecontenttextuel dansmessages. Cela convient àdeepseek-v4-flash. - Avec image : au format chat, écrivez
contentsous forme de tableau, avectypeàtextpour l’élément texte ettypeàimage_urlpour l’élément image. N’envoyez ce type de requête qu’aux modèles qui acceptent les images en entrée. - Activer le streaming : définissez
streamsurtrue. C’est idéal pour les scénarios à forte concurrence où vous avez besoin d’un retour rapide du premier token.
Étape 3 : checklist avant de changer de modèle Flash
- Le nouveau modèle prend-il en charge le point de terminaison que vous utilisez actuellement ? Les utilisateurs de messages qui passent à un Flash multimodal doivent impérativement basculer sur chat.
- Le nouveau modèle prend-il en charge les fonctionnalités dont vous dépendez ? Par exemple, la sortie structurée est indiquée comme non prise en charge sur
deepseek-v4-flash. - Quel est le ratio du nouveau modèle dans le groupe de votre jeton actuel ?
🚀 Démarrage rapide : nous vous conseillons de commencer par utiliser le crédit de test gratuit réservé aux nouveaux utilisateurs sur APIYI apiyi.com, d’envoyer le même lot d’entrées réelles à deux ou trois modèles Flash candidats, de comparer la qualité des sorties et la consommation de tokens, puis de décider du passage officiel. Il suffit de modifier le champ
modelpour basculer d’un modèle à l’autre.
FAQ — questions fréquentes
Q1 : Que signifie « Flash » dans le nom d’un modèle ?
Flash est un nom que les éditeurs donnent à une gamme de modèles orientée volume et latence réduite — ce n’est pas une norme unifiée. Selon l’éditeur, un modèle Flash peut différer fortement en modalités d’entrée, en endpoints et en fonctionnalités prises en charge. Pour choisir, fiez-vous à la page du modèle, pas seulement au nom.
Q2 : deepseek-v4-flash et deepseek-v4.1-flash sont-ils interchangeables ?
Il ne faut pas le supposer. Pour v4.1, on ne dispose pour l’instant que d’une ligne dans le tableau récapitulatif : entrée $0.3, sortie $1.2, lecture de cache $0.006, endpoints chat et messages. Le nombre de paramètres, la fenêtre de contexte et le caractère « texte uniquement » de v4 ne s’appliquent pas à v4.1 : avant de remplacer l’un par l’autre, référez-vous au tableau récapitulatif et aux futures fiches du modèle.
Q3 : Pourquoi mon client de style Claude n’arrive-t-il pas à appeler gemini-3.8-flash ?
Parce que `gemini-3.8-flash` expose les endpoints chat et gemini, mais pas messages. `qwen3.8-flash` et `glm-5.3-flash` n’ont eux aussi que chat. Si vous avez besoin de l’endpoint messages, il ne reste que les modèles Flash de la famille deepseek.
Q4 : Pourquoi le même modèle me coûte-t-il différemment selon le jeton ?
À cause du multiplicateur de groupe, qui varie. Par exemple, `gemini-3.8-flash` est à 0,5× dans le groupe Gemini_Reverse et à 1× dans Default. Pour la relation entre jetons et groupes, voir la documentation APIYI : docs.apiyi.com/faq/token-and-groups.md.
Q5 : Comment appeler rapidement ces modèles Flash via l’API ?
Inscrivez-vous sur APIYI (apiyi.com), créez un jeton, définissez `base_url` sur `https://api.apiyi.com/v1`, choisissez le chemin chat ou messages selon le modèle, et renseignez l’ID correspondant dans `model`. Les nouveaux utilisateurs disposent d’un quota de test gratuit : commencez par une petite série de vérifications.
Q6 : Les modèles Flash peuvent-ils faire des démonstrations mathématiques ou du calcul scientifique ?
Ils gèrent les calculs courants, mais aucune des fiches modèle ne mentionne les calculs scientifiques, les preuves ou la physique comme usage spécialisé. Pour les formules, les démonstrations et les tâches techniques à long enchaînement, mieux vaut partir de `claude-opus-5-5`, puis monter vers `claude-fable-5-2` si ce n’est pas suffisant.
Q7 : Peut-on se baser directement sur le score Terminal-Bench de la fiche modèle pour choisir ?
La fiche de `glm-5.3-flash` indique textuellement un score Terminal-Bench 2.1 de 84,3 — c’est ce que dit la fiche, pas une mesure réalisée dans cet article. Cela peut servir de signal de référence, mais ne signifie pas que le modèle est meilleur sur toutes les tâches ; en dernier ressort, validez avec vos propres données.
Points clés pour choisir un modèle Flash
- Le nom ne dit pas tout : les modèles qui portent Flash dans leur nom ont des modalités d’entrée et des endpoints qui diffèrent.
- Première étape : la modalité : pour du texte pur, prenez
deepseek-v4-flash; pour image et vidéo, prenez un Flash multimodal. - Deuxième étape : l’endpoint : l’endpoint messages n’est pris en charge que par la gamme deepseek ; la plupart des Flash multimodaux ne passent que par chat.
- Troisième étape : la facture : prix d’entrée, prix de sortie et lecture du cache s’examinent ensemble, puis se multiplient par le coefficient de groupe.
- Les chiffres de la fiche modèle sont à sourcer : nombre de paramètres, Terminal-Bench, « adapté au codage visuel » sont tous des citations de la fiche modèle.
- Pour le raisonnement lourd, pas de Flash par défaut : les preuves de formules démarrent avec
claude-opus-5-5, et l’on monte àclaude-fable-5-2si ce n’est pas suffisant. - Valider sur un petit lot avant de basculer : sur APIYI, faites tourner des entrées réelles avec le quota gratuit, puis décidez du passage effectif.
En résumé
Choisir un modèle Flash se résume en une phrase : on choisit en fonction de la modalité d’entrée, pas en fonction du nom.
- D’abord, la fiche modèle : vérifiez les types d’entrée, l’endpoint et les fonctionnalités prises en charge, et écartez les modèles qui ne correspondent pas.
- Ensuite, le prix : prix d’entrée, prix de sortie et lecture du cache s’analysent ensemble selon votre ratio d’appels, en les multipliant par le coefficient de groupe de jetons.
- Puis, la répartition par tâche : les tâches à fort volume comme lire des graphiques ou retoucher de courts extraits de code reviennent au Flash dont la modalité correspond ; les tâches de raisonnement lourd reviennent à Claude Opus 5.5 ou Fable 5.2.
Les prix et les capacités évoluent ; au moment du choix, fiez-vous à la fiche modèle du jour. Je conseille, sur APIYI apiyi.com, de comparer en petit lot plusieurs modèles candidats avec la même clé API, puis de trancher selon votre facture et la qualité de sortie.
📚 Références
-
Annonce d’Anthropic – Claude Fable et Mythos 5.2 : positionnement de Fable 5.2 et conseils d’usage à partir d’Opus 5.5
- Lien :
anthropic.com/claude-fable-and-mythos-5-2 - Description : comprendre la répartition des modèles pour les tâches de raisonnement intensif
- Lien :
-
Vue d’ensemble des modèles Claude : liste officielle des modèles Anthropic et indications d’utilisation
- Lien :
platform.claude.com/docs/en/about-claude/models/overview - Description : recommandations d’usage d’Opus et de Fable, cohérentes avec l’annonce
- Lien :
-
Tableau récapitulatif des modèles et pages par modèle sur APIYI : prix, groupes, endpoints et modalités d’entrée
- Lien : centre de documentation models.md et pages de chaque modèle (deepseek-v4-flash, gemini-3-8-flash, qwen3-8-flash, glm-5-3-flash)
- Description : source de toutes les données de prix et de capacités de cet article ; avant de choisir, référez-vous à la dernière version en date
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil du site APIYI ; pour plus de détails sur les modèles et les groupes, consultez le centre de documentation docs.apiyi.com