Nota del autor: Este artículo analiza la declaración de Alphabet en sus resultados del tercer trimestre de 2026 según la cual «las API de modelos propios procesan cerca de 32.000 millones de tokens por minuto», y distingue entre las conclusiones respaldadas por datos y lo que todavía se desconoce.
El 28 de octubre de 2026 (hora de Estados Unidos), Alphabet publicó sus resultados del tercer trimestre. En su intervención, el CEO Sundar Pichai compartió una cifra: las API de modelos propios de Google procesan cerca de 32.000 millones de tokens por minuto, aproximadamente un 40 % más que la cifra anunciada el trimestre anterior y más de cuatro veces la de un año antes.
No se trata de una estimación extraoficial: las palabras aparecen en la intervención del CEO sobre los resultados, publicada en el blog oficial de Google: «Our first-party model APIs are now processing nearly 32 billion tokens per minute». Sin embargo, es fácil malinterpretar esta cifra: no equivale a 32.000 millones de invocaciones ni al uso de la aplicación Gemini.
La idea central: entiende en 3 minutos qué mide la cifra de 32.000 millones de tokens de la API de Google, cómo ha evolucionado y en qué consumen esa capacidad de cómputo los desarrolladores, los clientes empresariales y los agentes de IA.
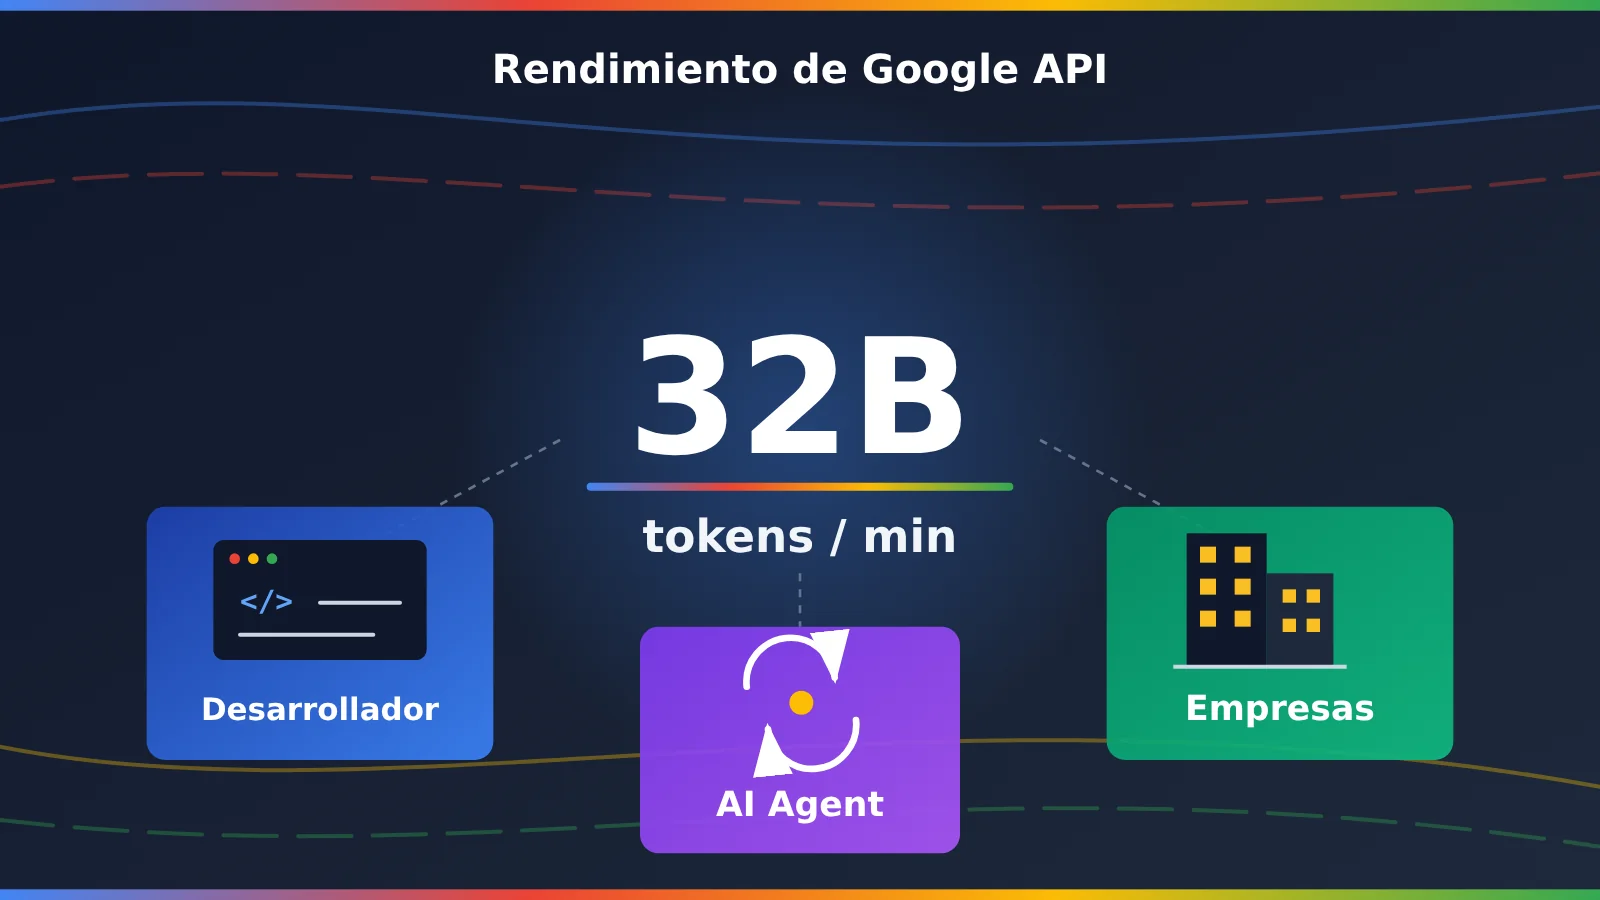
Datos clave sobre los 32.000 millones de tokens de la API de Google
Empecemos por reunir los datos de la noticia en una tabla. El análisis posterior parte de esta información divulgada.
| Dato | Detalle |
|---|---|
| Fecha de divulgación | 28 de octubre de 2026, durante la llamada de resultados del tercer trimestre de Alphabet |
| Quién lo divulgó | Sundar Pichai, CEO de Alphabet |
| Cifra principal | Las API de modelos propios procesan cerca de 32.000 millones de tokens por minuto |
| Variación trimestral | Un aumento aproximado del 40 % respecto a la cifra divulgada el trimestre anterior, según datos oficiales |
| Variación interanual | Más de cuatro veces la cifra de un año antes |
| Alcance de la medición | El conjunto de las API de modelos propios de Google, no un modelo Gemini en particular |
| Datos no divulgados | Desglose por modelo, cliente, sector o producto de API |
Qué mide la cifra de 32.000 millones de tokens de la API de Google
Para entender la noticia, primero hay que distinguir varios indicadores que suelen confundirse. Los 32.000 millones son tokens, no solicitudes a la API: una sola solicitud para analizar un documento extenso puede contener cientos de miles de tokens. Además, la cifra describe la tasa de procesamiento actual comunicada el 28 de octubre, no el promedio de todo el tercer trimestre.
En los resultados y la llamada también se mencionaron cifras sobre desarrolladores, licencias empresariales y uso de Gemini Enterprise, entre otras. Como cada indicador mide algo distinto, no se pueden sumar ni deducir unos a partir de otros.
| Indicador | Cifra y fecha | Alcance de la medición | ¿Se puede sumar a los 32.000 millones de tokens por minuto? |
|---|---|---|---|
| Capacidad de procesamiento de las API de modelos propios | Cerca de 32.000 millones de tokens por minuto (28-10-2026) | Tasa de procesamiento actual | Es el indicador principal |
| Desarrolladores activos mensuales | Más de 9 millones al mes (dato divulgado en el segundo trimestre) | Desarrolladores que usan las API de modelos y los principales productos para desarrolladores | No, es una cifra de personas, no de clientes de pago |
| Tokens de herramientas para desarrolladores | Más de 3 billones al día (material de junio de 2026) | Uso relacionado con herramientas para desarrolladores | No, el alcance de la medición es distinto |
| Clientes de Gemini Enterprise con alto uso | Más de 2.600 con un uso ≥100.000 millones de tokens (en los últimos 12 meses) | Uso de clientes del producto empresarial | No |
| Licencias para trabajadores del conocimiento | Más de 100 millones vendidas en total | Todos los servicios de IA de Google | No, son licencias, no clientes de API |
Hay otro punto importante: esta cifra no permite afirmar que Gemini App consuma 32.000 millones de tokens por minuto. App, Search, las licencias empresariales y los tokens de API corresponden a distintas líneas de negocio e indicadores.
Evolución del volumen de tokens procesados por la API de Google
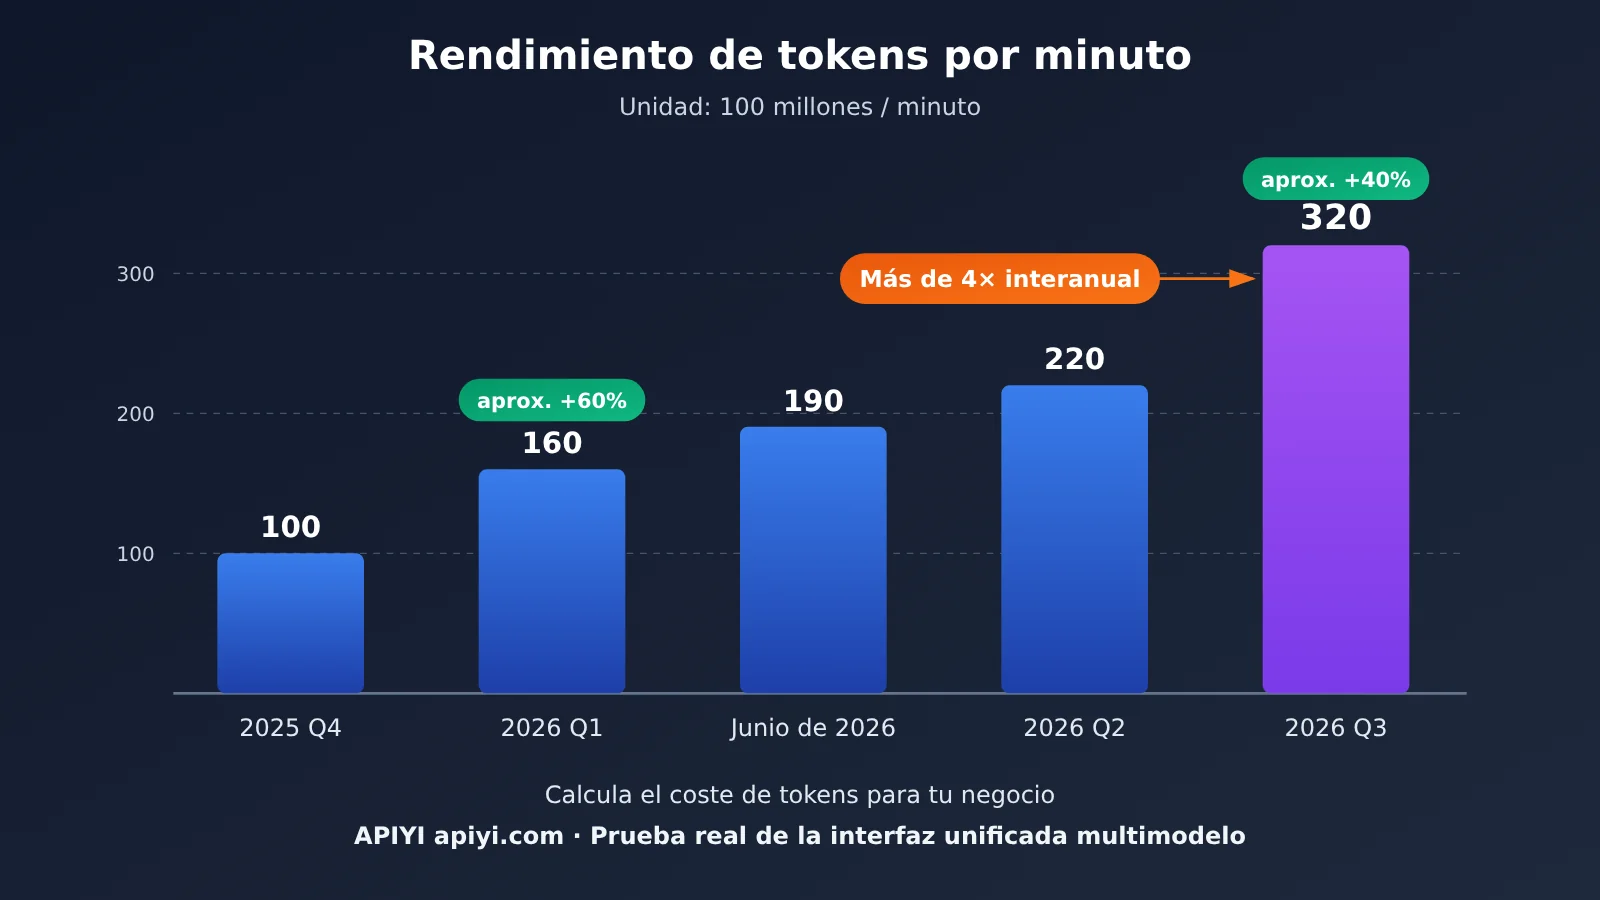
Si reunimos las últimas cifras publicadas, la pendiente de la curva dice más que cualquier dato aislado.
| Fecha de publicación | Contexto | Tokens/minuto | Nota |
|---|---|---|---|
| Cuarto trimestre de 2025 | Informe trimestral | Unos 10.000 millones | Punto de partida |
| 2026-04-29 | Resultados del primer trimestre | Más de 16.000 millones | Crecimiento de alrededor del 60 % respecto al trimestre anterior |
| Junio de 2026 | Presentación para inversores | Unos 19.000 millones | Dato de mediados de trimestre |
| 2026-07-22 | Resultados del segundo trimestre | Unos 22.000 millones | — |
| 2026-10-28 | Conferencia de resultados del tercer trimestre | Casi 32.000 millones | Según Google, alrededor de un 40 % más que el trimestre anterior y más de 4 veces la cifra interanual |
Si calculamos directamente el incremento entre 22.000 y 32.000 millones, obtenemos alrededor de un 45,5 %. Pero ambas cifras son aproximadas («unos» y «casi»), así que conviene tomar como referencia el «alrededor del 40 %» comunicado por Google. Esto no significa que la empresa haya calculado mal el porcentaje.
¿A cuánto equivalen 32.000 millones de tokens por minuto?
Para hacernos una idea de la escala, hagamos una conversión matemática suponiendo que el ritmo se mantiene constante. Las cifras diarias y mensuales son solo resultados de ese cálculo hipotético, no datos de uso real publicados por Google.
- Por segundo: unos 533 millones de tokens
- Por hora: unos 1,92 billones de tokens
- Si se mantiene durante 24 horas: unos 46,08 billones de tokens
- Si se mantiene durante 30 días: unos 1.382,4 billones de tokens
Quién está consumiendo los 32.000 millones de tokens de la API de Google
Esa es precisamente la pregunta que plantea el título. Según la información publicada por Google, se pueden identificar tres categorías importantes de usuarios, pero no se ha hecho pública la proporción exacta que corresponde a cada una.
Primera categoría: el ecosistema de desarrolladores de la API de Google
El informe financiero del segundo trimestre indica que más de 9 millones de desarrolladores crean aplicaciones cada mes con las API de modelos de Google y sus principales productos para desarrolladores. Esta cifra muestra que la comunidad potencial de desarrolladores es enorme, pero no equivale a 9 millones de clientes de pago ni significa que todos invoquen directamente la API de Gemini.
Durante el mismo periodo, la plataforma de desarrollo de agentes Antigravity superaba los 2,4 millones de usuarios activos semanales. Algunos de los principales usos que consumen tokens entre los desarrolladores son:
- Programación y desarrollo de software: lectura de repositorios de código, refactorización, generación de pruebas, detección de errores y llamadas repetidas de agentes de programación
- Desarrollo de aplicaciones de IA: chatbots en sitios web y aplicaciones, automatización de la atención al cliente, búsquedas internas en empresas y análisis de PDF y documentos extensos
- Flujos de trabajo con agentes: planificación de tareas, invocación de herramientas externas, lectura de resultados, corrección de errores y ejecución de los siguientes pasos
Segunda categoría: clientes empresariales de Gemini Enterprise
Thomas Kurian, CEO de Google Cloud, compartió datos sobre el segmento empresarial durante la conferencia de resultados del tercer trimestre. En los últimos 12 meses, más de 2600 clientes usaron al menos 100 000 millones de tokens en Gemini Enterprise, y unos 75 usaron al menos 10 billones de tokens. Además, cerca del 90 % de las empresas de Fortune 100 utilizan Gemini Enterprise.
Otra señal destacable es el aumento del gasto: los clientes que ya usaban Gemini Enterprise en el tercer trimestre de 2025 gastaron más de cuatro veces más en el tercer trimestre de 2026, en comparación interanual. Esto indica que la IA empresarial está pasando de las pruebas a pequeña escala a despliegues a gran escala. Sin embargo, el uso de Gemini Enterprise y los 32 000 millones de tokens de la API de modelos propios son métricas distintas; no se puede suponer que esos 2600 clientes aportaron la mayor parte de ese volumen.
Tercera categoría: agentes especializados y procesos empresariales complejos
Google presentó varios casos de despliegue en distintos sectores durante la conferencia de resultados y en el blog de Cloud. Todos los resultados que aparecen a continuación provienen de información oficial de Google y no han sido verificados por terceros independientes. Google tampoco ha publicado cuántos tokens consumió cada una de estas empresas.
| Empresa | Sector | Despliegue descrito por Google | Resultados comunicados por Google |
|---|---|---|---|
| BNP Paribas | Servicios financieros | Despliegue de Gemini Enterprise para más de 65 000 empleados | Simplificación de los flujos de trabajo, manteniendo la seguridad y la gobernanza de datos |
| Tata Steel | Industria manufacturera | Despliegue de más de 300 agentes especializados en 9 meses, para seguridad, cadena de suministro y reclamaciones de clientes | Reducción de aproximadamente un 50 % en el tiempo de resolución de reclamaciones |
| Ulta Beauty | Comercio minorista | Asistente de compras con IA | Tasa de conversión aproximadamente 3 veces mayor que la de la navegación tradicional por el sitio web |
| Hitachi HMAX | Operaciones industriales | Los técnicos de primera línea crearon más de 200 casos de uso para agentes, como la comparación de imágenes tomadas antes y después de una tarea | Aumento de la productividad de hasta un 30 % aproximadamente en los casos correspondientes |
| NTT DOCOMO | Análisis de datos | Agente de análisis de datos | Obtención de algunos hallazgos en tiempo casi inmediato, frente a las dos semanas anteriores; ahorro estimado de unas 450 000 horas al año |
Estos casos tienen algo en común: los modelos ya no se usan solo para conversar, sino que se integran en procesos reales, como la seguridad operativa, la cadena de suministro, las decisiones de compra y el análisis de datos. En el caso de Ulta Beauty, la cifra de 3 veces se refiere a la tasa de conversión del asistente de compras; no significa que las ventas totales se hayan triplicado.
Multimodalidad: otro factor que multiplica el consumo de tokens de la API de Google
Las preguntas y respuestas sobre texto, la revisión de contratos, el análisis de repositorios de código completos, la comprensión de imágenes y videos y la transcripción de voz consumen tokens de formas muy distintas. La cantidad de imágenes, la duración de los videos y el tamaño de los archivos no se pueden convertir directamente en tokens como si fueran palabras de texto normal.
Google no ha hecho público cómo se distribuyen los 32.000 millones de tokens entre texto, imágenes, video y audio. Tampoco ha indicado cuántos corresponden a la entrada, cuántos a la salida y cuántos provienen del proceso de razonamiento interno del modelo.
Por qué los agentes pueden aumentar el consumo de tokens de Google API
Una conversación normal puede tener solo una ronda de entrada y salida. En cambio, para completar una tarea, un agente de programación puede pasar por varias etapas: leer archivos, analizar el problema, modificar el código, ejecutar pruebas, leer los errores, volver a modificar y repetir las pruebas. Cada paso puede requerir una invocación del modelo y, por lo general, también hay que volver a incluir el contexto acumulado.
Por eso, afirmar que «los agentes son una fuente potencial importante de demanda» es una conclusión razonable basada en cómo funcionan. Pero no hay datos públicos que respalden la afirmación de que «los agentes consumieron la mayor parte de los 32.000 millones de tokens». Es importante distinguir entre ambas al escribir o tomar decisiones.
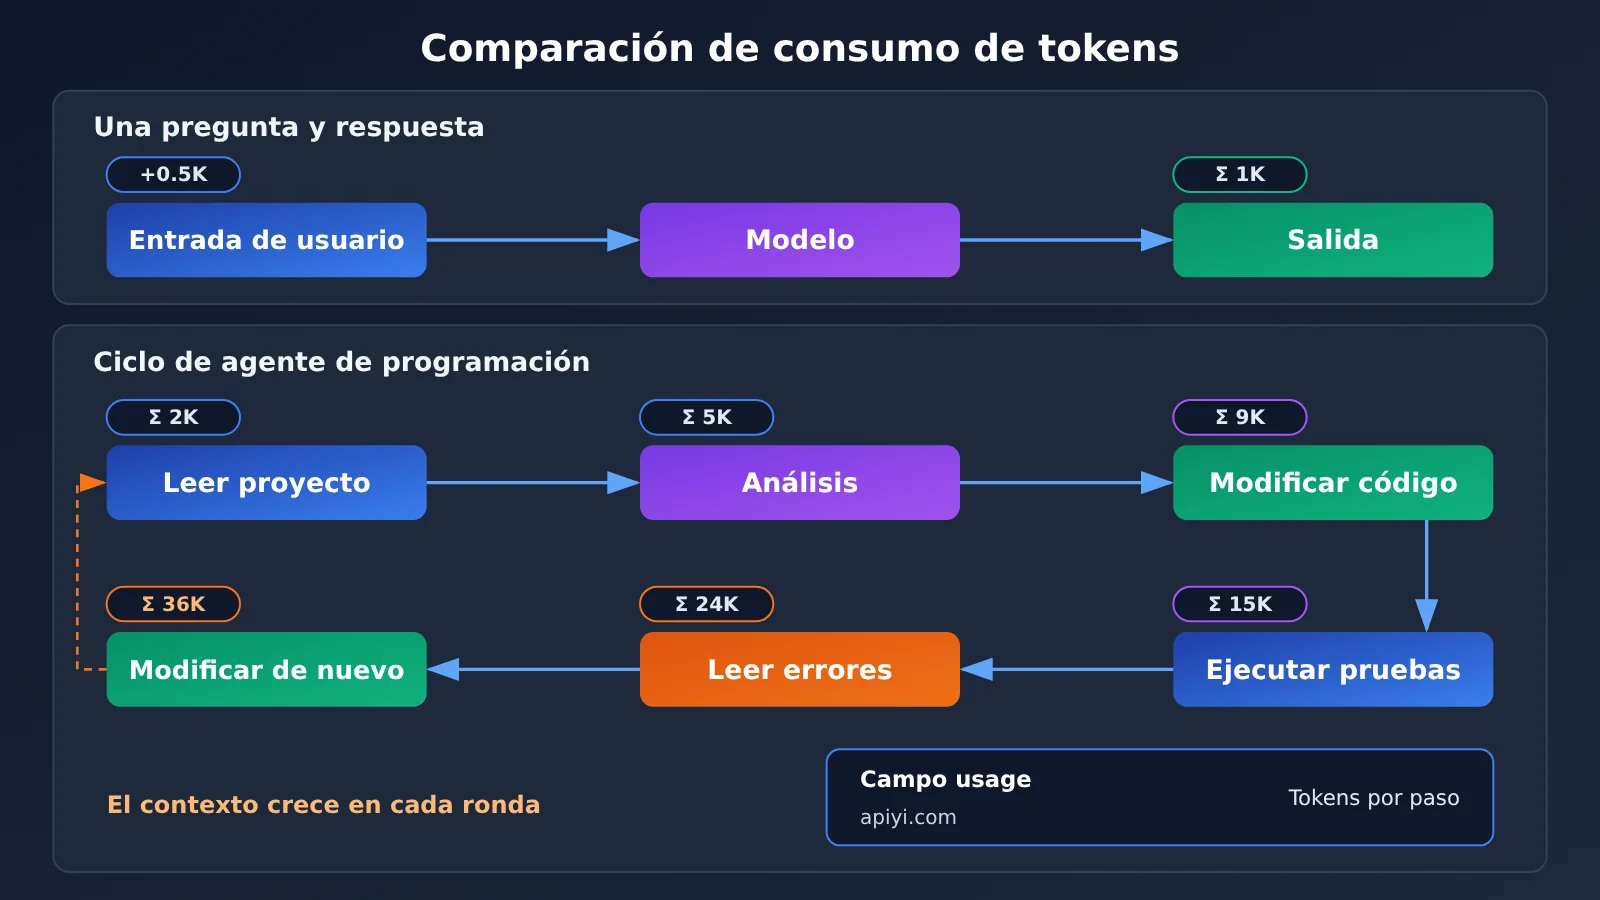
Observa la acumulación de tokens de un agente con código
La forma más sencilla de entenderlo es registrar el campo usage que devuelve cada llamada. El siguiente ejemplo simula un proceso de corrección de varias rondas e imprime los tokens de entrada y salida de cada paso:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "user", "content": "写一个计算斐波那契数列的 Python 函数"}]
resp = client.chat.completions.create(model="YOUR_GEMINI_MODEL", messages=messages)
print(resp.usage.prompt_tokens, resp.usage.completion_tokens)
Ver el código para contar los tokens de un ciclo de agente con varias rondas
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "YOUR_GEMINI_MODEL"  # 替换为平台模型列表中的 Gemini 模型名称

steps = [
    "写一个计算斐波那契数列的 Python 函数",
    "为这个函数补充单元测试",
    "测试报错:输入负数时没有处理,请修复",
    "再检查一遍边界条件并给出最终版本",
]

messages = [{"role": "system", "content": "你是一个严谨的编程助手"}]
total_in, total_out = 0, 0

for i, step in enumerate(steps, 1):
    messages.append({"role": "user", "content": step})
    resp = client.chat.completions.create(model=MODEL, messages=messages)
    reply = resp.choices[0].message.content
    messages.append({"role": "assistant", "content": reply})

    usage = resp.usage
    total_in += usage.prompt_tokens
    total_out += usage.completion_tokens
    print(f"第 {i} 步:输入 {usage.prompt_tokens},输出 {usage.completion_tokens}")

print(f"累计输入 {total_in},累计输出 {total_out}")
Al ejecutarlo, verás que los tokens de entrada aumentan en cada ronda debido al historial de contexto. Por eso, la estructura de consumo de tokens de un flujo de trabajo con agentes es mucho más compleja que la de una sola pregunta y respuesta.
🚀 Para empezar rápido: si quieres medir cómo evoluciona el consumo de tokens de distintos modelos en un ciclo de agente, puedes registrarte en APIYI apiyi.com para obtener crédito gratuito de prueba. Con la misma clave API puedes alternar entre modelos como Gemini, Claude y GPT y comparar su consumo de tokens para una misma tarea.
Análisis del impacto de los 32.000 millones de tokens de la API de Google
Impacto para los desarrolladores
- La estructura de costos pasa de depender de cada llamada a depender de todo el flujo: el costo de una tarea de un agente depende del número de ciclos y de la longitud del contexto. Por eso, conviene presupuestar los tokens desde la fase de diseño, por ejemplo, recortando el historial de contexto y almacenando en caché el contenido que no cambia.
- Elegir el modelo adecuado para cada tarea cobra más importancia: conviven modelos de alto rendimiento y modelos económicos. Una forma habitual de controlar los costos es dejar la planificación compleja a los modelos más potentes y la clasificación por lotes a los económicos.
- La facturación multimodal requiere una evaluación independiente: los tokens de imágenes, video y audio se calculan de forma distinta a los de texto. Antes de pasar a producción, conviene medir el consumo con muestras reales.
💡 Recomendación: el consumo de tokens y los resultados de una misma tarea pueden variar mucho entre modelos. Prueba muestras reales con una interfaz unificada a través de APIYI apiyi.com antes de decidir qué combinación de modelos usar en producción.
Impacto en el sector y en Google Cloud
Kurian explicó durante la llamada que, al crear agentes, las empresas suelen necesitar, además de invocar modelos, recursos de cómputo, servicios para almacenar la memoria de los agentes y bases de datos que les proporcionen contexto. Por eso, la adopción de modelos también podría impulsar el crecimiento de otros productos de la nube.
| Indicador financiero (tercer trimestre finalizado el 30 de septiembre de 2026) | Valor | Descripción |
|---|---|---|
| Ingresos totales de Alphabet | 127.577 millones de dólares, un 25 % más interanual | Total del grupo |
| Ingresos de Google Cloud | 30.709 millones de dólares, un 103 % más interanual | Incluye infraestructura de IA empresarial, soluciones de IA, servicios principales de GCP y venta de sistemas TPU |
| Beneficio operativo de Google Cloud | 11.121 millones de dólares | Margen operativo trimestral de aproximadamente el 36,2 % |
| Ingresos de Gemini API por separado | No divulgados | No pueden sustituirse por los ingresos de Cloud |
Hay que subrayar dos puntos. Los 30.700 millones de dólares corresponden a los ingresos de todo Google Cloud, no a los de Gemini API. Tampoco se pueden estimar los ingresos de Google por la API multiplicando los 32.000 millones de tokens por los precios públicos: no se ha divulgado cómo se distribuyen entre modelos, cada modelo tiene un precio distinto y los clientes empresariales pueden beneficiarse de procesamiento por lotes, caché, contratos específicos y descuentos.
Una trampa cronológica fácil de pasar por alto
El período financiero del tercer trimestre de Alphabet va del 1 de julio al 30 de septiembre de 2026; Gemini 4 Argon se lanzó oficialmente el 13 de octubre de 2026; y la cifra de 32.000 millones de tokens por minuto se divulgó el 28 de octubre. Por lo tanto, no se pueden considerar esos 32.000 millones como el ritmo medio del tercer trimestre, y mucho menos afirmar que el crecimiento de la API durante todo ese trimestre se debió principalmente a Argon, que no se lanzó hasta octubre. Una forma más prudente de expresarlo es que el lanzamiento de Argon y el hito de los 32.000 millones de tokens reflejan, en conjunto, los avances de Google en modelos y negocio durante octubre de 2026.
Preguntas frecuentes (FAQ)
Q1: ¿Qué significa que la API de Google procese 32.000 millones de tokens por minuto?
Es la tasa de procesamiento global que Google comunicó el 28 de octubre de 2026 para sus propias API de modelos. Se mide en tokens, no en número de solicitudes, y no representa el uso de un modelo Gemini concreto ni de la aplicación Gemini.
Q2: ¿Quiénes aportan principalmente esos 32.000 millones de tokens?
Entre los usuarios confirmados se encuentran más de 9 millones de desarrolladores al mes, más de 2.600 clientes de Gemini Enterprise con un uso elevado y despliegues de agentes en sectores como finanzas, manufactura, comercio minorista y operaciones industriales. Sin embargo, Google no ha detallado la proporción correspondiente a cada grupo, sector o modelo, por lo que no hay datos públicos que respalden afirmaciones como «un tipo de usuario aporta la mayor parte».
Q3: ¿Tienen relación los 32.000 millones de tokens con Gemini 4 Argon?
Argon se lanzó el 13 de octubre de 2026 y los 32.000 millones corresponden a la tasa vigente el 28 de octubre. Ambos forman parte de los avances de Google en octubre. Sin embargo, el período de Q3 terminó el 30 de septiembre, por lo que no se puede atribuir a Argon el crecimiento de todo ese trimestre.
Q4: ¿Cómo pueden los desarrolladores estimar el consumo de tokens de su negocio?
El método más fiable es hacer pruebas con muestras reales y registrar el campo `usage` que devuelve cada invocación. Puedes obtener créditos de prueba gratuitos en APIYI apiyi.com, configurar `base_url` como `https://api.apiyi.com/v1` en el código de este artículo y probar por separado casos de texto, documentos extensos y agentes con múltiples turnos. Después, puedes estimar los costos según el volumen de uso.
Q5: ¿Se pueden estimar los ingresos de Google por sus API a partir de los 32.000 millones de tokens?
No. No se han hecho públicos la distribución por modelo, los precios reales por unidad, los descuentos por procesamiento por lotes y caché ni los contratos específicos para empresas. Google tampoco ha comunicado por separado los ingresos y beneficios de la API de Gemini.
Q6: ¿Qué limitaciones conocidas tienen actualmente los datos de esta noticia?
Hay tres principales: no hay un desglose por cliente, sector o modelo; tampoco se conoce la distribución entre texto, imagen, video y audio; y no hay una separación entre tokens de entrada, salida y razonamiento interno. Además, los resultados de los casos empresariales proceden de información publicada por Google y no han sido verificados de forma independiente por terceros.
Google API y los 32.000 millones de tokens: puntos clave
- Cifra principal: la API de modelos propios procesa casi 32.000 millones de tokens por minuto, más de cuatro veces la cifra del año anterior.
- Curva de crecimiento: pasó de unos 10.000 millones a casi 32.000 millones en aproximadamente un año.
- Tres tipos de usuarios: el ecosistema de desarrolladores, los clientes empresariales de Gemini Enterprise y los agentes implementados en distintas industrias.
- Cómo funcionan los agentes: los ciclos de varias rondas y la acumulación de contexto multiplican el consumo de tokens de una sola tarea.
- Límites de las métricas: los tokens, las solicitudes, los puestos, el número de desarrolladores y los ingresos de Cloud no se pueden confundir ni sumar entre sí.
- La gran incógnita: Google aún no ha revelado qué proporción de esos 32.000 millones de tokens corresponde a cada tipo de cliente o caso de uso.
- Recomendación práctica: usa la interfaz unificada de APIYI apiyi.com para medir la curva real de consumo de tokens de tu negocio.
Resumen
Estos son los puntos principales de la noticia sobre los 32.000 millones de tokens por minuto de Google API:
- La escala crece rápidamente: un crecimiento de más de cuatro veces en un año indica que la invocación de modelos está pasando de la fase de pruebas a un uso a gran escala.
- Las fuentes de demanda son identificables: los desarrolladores, los clientes empresariales y los agentes de distintas industrias son grupos reales de alto consumo.
- Las proporciones siguen siendo desconocidas: Google no ha publicado datos desglosados; reconocerlo es precisar los límites de la información disponible, no señalar un dato omitido.
- El valor comercial aún está por verse: lo que merece un seguimiento continuo es cuántas de estas invocaciones pueden convertirse en aplicaciones empresariales sostenibles y rentables.
Para los desarrolladores, la conclusión más directa es que los agentes y la tecnología multimodal harán que el presupuesto de tokens sea aún más importante. Conviene incorporar la elección de modelos y la gestión del contexto al diseño de la arquitectura desde el principio. Una opción es usar APIYI apiyi.com para comparar el rendimiento y el consumo de varios modelos populares con una sola clave API, y después elegir la solución que mejor se adapte a tus necesidades.
📚 Referencias
- Resultados financieros de Alphabet del tercer trimestre de 2026 (SEC): fuente original de los datos financieros
- Enlace:
sec.gov/Archives/edgar/data/1652044/000165204426000080/googexhibit991q32026.htm -
Detalles: ingresos, ingresos de Google Cloud y beneficio operativo
-
Mensaje del CEO de Google sobre los resultados del tercer trimestre de 2026: fuente original de la cifra de 32.000 millones de tokens por minuto
- Enlace:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q3-2026/ -
Detalles: cifras clave y datos oficiales de crecimiento
-
Transcripción de la conferencia de resultados de Alphabet del tercer trimestre de 2026: datos y casos de clientes empresariales
- Enlace:
fool.com/earnings/call-transcripts/2026/10/29/alphabet-googl-q3-2026-earnings-call-transcript/ -
Detalles: datos de Gemini Enterprise compartidos por Thomas Kurian
-
Mensaje del CEO de Google sobre los resultados del segundo trimestre de 2026: datos sobre desarrolladores y 22.000 millones de tokens
- Enlace:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q2-2026/ -
Detalles: 9 millones de desarrolladores activos al mes y datos de usuarios activos semanales de Antigravity
-
Mensaje del CEO de Google sobre los resultados del primer trimestre de 2026: dato de 16.000 millones de tokens
- Enlace:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q1-2026/ -
Detalles: punto de referencia en la cronología de crecimiento
-
Presentación de Google para inversores de junio de 2026: 19.000 millones de tokens y uso de herramientas para desarrolladores
- Enlace:
blog.google/alphabet/investor-presentation-june-2026/ -
Detalles: más de 3 billones de tokens diarios en herramientas para desarrolladores
-
Google Cloud: Gemini at Work 2026: casos de clientes empresariales que usan agentes
- Enlace:
cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026 - Detalles: casos de implementación en empresas como Hitachi
Autor: Equipo técnico de APIYI
Contacto técnico: Contáctanos desde la página principal del sitio oficial de APIYI. Encontrarás más información sobre la integración en el centro de documentación docs.apiyi.com