Nota del autor: repaso sistemático de 5 causas habituales de las interrupciones en las conexiones con API de imágenes. Abarca la configuración de tiempos de espera, las pasarelas proxy, las conexiones transfronterizas, las estrategias de reintento y el entorno de ejecución, para ayudarte a recibir los resultados de forma fiable al generar imágenes desde otros países.
Envías una solicitud de generación de imágenes, esperas decenas de segundos y, al final, solo recibes un Connection reset o un Read timed out. Es un problema frecuente para quienes desarrollan aplicaciones de generación de imágenes transfronteriza. Y hay algo aún más frustrante: puede que el modelo ya haya generado la imagen, pero el resultado no haya llegado a tu programa. En este artículo presentamos 5 causas habituales de las interrupciones en las conexiones con API de imágenes y cómo solucionarlas, para que puedas generar imágenes de forma estable tanto si despliegas tu aplicación en el extranjero como en el país.
No se trata de un artículo genérico sobre redes: su contenido se basa en problemas reales que hemos encontrado repetidamente al ayudar a desarrolladores con sus integraciones. Por ejemplo, a un desarrollador con servicios desplegados en servidores de Estados Unidos le interesa sobre todo saber qué dirección de acceso debe configurar, si las llamadas transfronterizas serán lentas y cómo garantizar que las respuestas de gran tamaño, como las imágenes, se reciban completas.
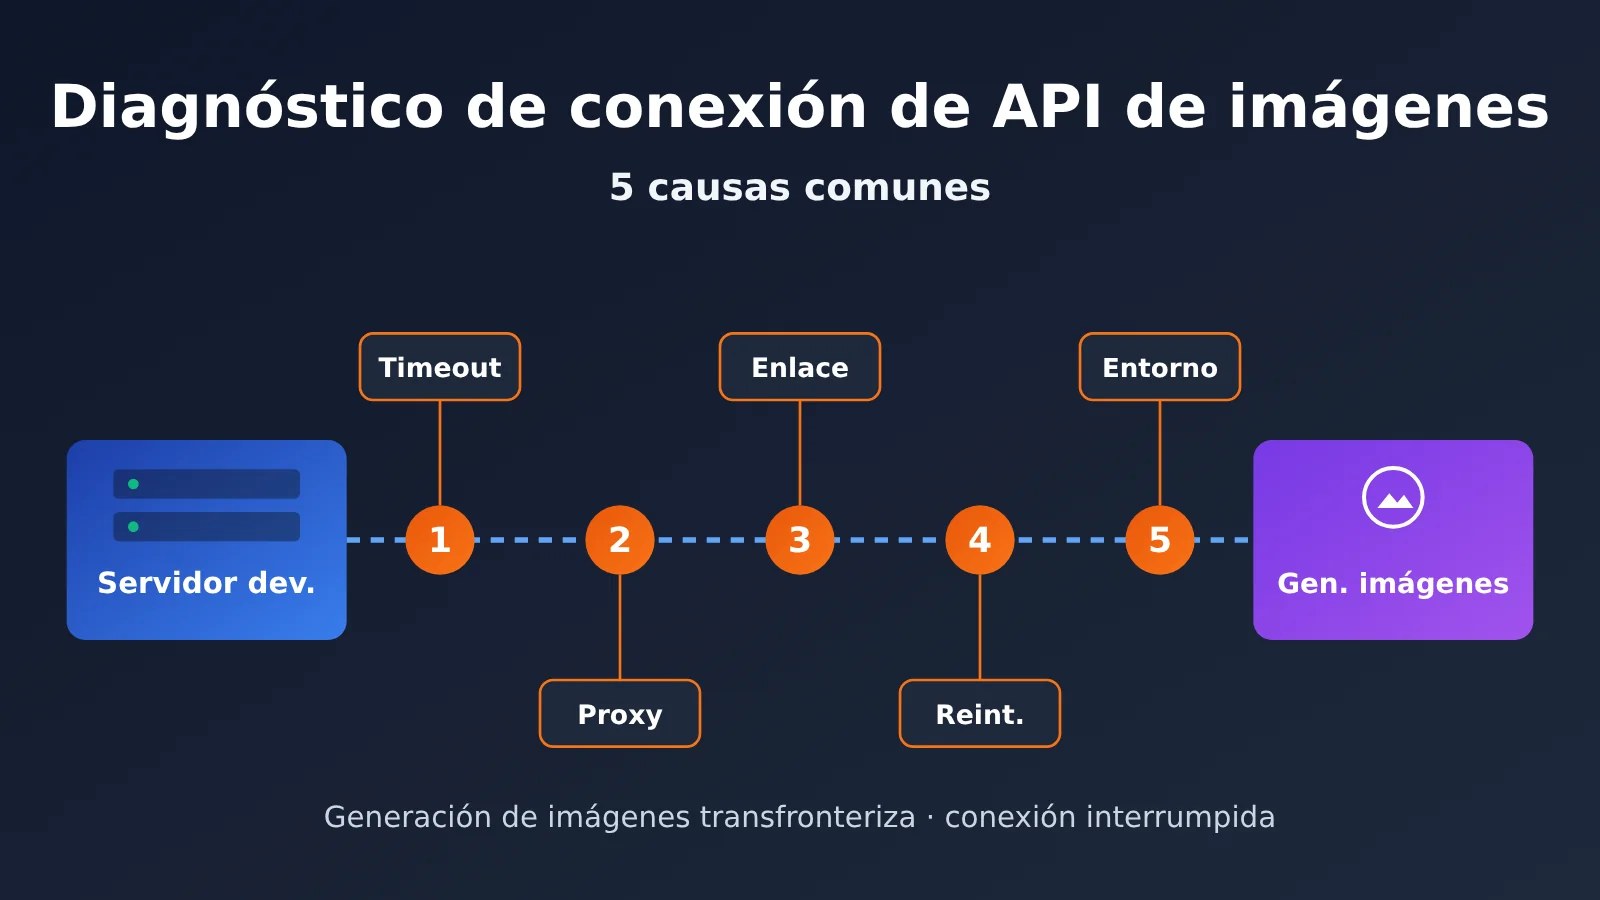
Qué aprenderás: al terminar, sabrás localizar los problemas de conexión con la API de imágenes en cinco capas —cliente, pasarela, conexión, reintentos y entorno de ejecución— y tendrás una plantilla de código reutilizable para configurar los tiempos de espera y los reintentos.
Puntos clave para diagnosticar interrupciones en la conexión con la API de imágenes
Empecemos por la conclusión: las interrupciones en la conexión con la API de imágenes casi siempre se producen en uno de estos cinco puntos, ordenados por prioridad de diagnóstico:
| N.º | Causa común | Síntomas habituales | Cómo solucionarlo |
|---|---|---|---|
| 1 | El tiempo de espera del cliente es demasiado corto | Aparece timeout siempre después del mismo número de segundos |
Aumenta específicamente el tiempo de espera de lectura |
| 2 | Tiempo de espera por inactividad del proxy o la puerta de enlace | La conexión se interrumpe de forma constante alrededor de los 60 segundos y devuelve un error 502/504 | Ajusta los tiempos de espera de Nginx y del balanceador de carga |
| 3 | Calidad de la conexión internacional y respuestas grandes | Interrupciones ocasionales; cuanto más grande es el resultado, más probable es que falle | Elige el punto de acceso adecuado y reduce el tamaño de los datos devueltos |
| 4 | Estrategia de reintentos inadecuada | Se cobra más de una vez o, durante las horas de mayor tráfico, cada reintento empeora la situación | Desactiva los reintentos automáticos indiscriminados e incorpora esperas progresivas |
| 5 | Limitaciones del propio entorno de ejecución | La interrupción se produce siempre al usar Serverless o conectar directamente desde el navegador | Cambia a un proceso persistente en el backend o a tareas asíncronas |
Por qué la API de imágenes se interrumpe con más facilidad que la de chat
Las interfaces de generación de imágenes suelen funcionar mediante invocaciones síncronas: una vez enviada la solicitud, la conexión debe mantenerse abierta hasta que el modelo termine de generar la imagen y devuelva el resultado. Las interfaces de chat pueden transmitir la respuesta en streaming y empezar a devolver datos en unos cientos de milisegundos. En cambio, durante la generación de imágenes no suele transmitirse ningún byte, y ese periodo de «silencio» puede durar decenas de segundos o más. Por eso, es fácil que se alcance el tiempo de espera por inactividad en alguna de las capas de la conexión.
Otro factor clave es el tamaño de la respuesta. Una imagen de alta resolución devuelta en formato base64 puede ocupar varios MB, y los archivos de vídeo suelen ser aún más grandes. En una conexión internacional, basta con que se produzca una sola fluctuación para que una respuesta grande tenga más probabilidades de transmitirse de forma incompleta.
Lo más importante que hay que tener en cuenta es que si la conexión se interrumpe, el resultado se pierde, aunque es posible que la generación ya haya terminado y se haya cobrado. El servidor no puede «reenviar» el resultado a una conexión que ya se ha cerrado. Por eso, diagnosticar estas interrupciones no es solo una cuestión de estabilidad: también afecta directamente a los costos.
Cómo elegir la URL de acceso para generar imágenes desde distintos países
Los servidores de APIYI están alojados en la costa oeste de Estados Unidos. Para operaciones en el extranjero, basta con usar https://api.apiyi.com/v1: la distancia física es corta y la latencia, baja. Muchos desarrolladores se preguntan por qué el acceso desde China también es fluido. La razón es que la plataforma acelera la conexión hacia China, especialmente para garantizar un buen rendimiento con imágenes y vídeos, que generan respuestas de gran tamaño.
| Región de despliegue | URL de acceso recomendada | Características de la conexión | Consideraciones |
|---|---|---|---|
| Servidores en Estados Unidos o Norteamérica | URL de acceso predeterminada | Está en la misma región que el servidor, por lo que ofrece la latencia más baja | Revisa especialmente los tiempos de espera de la puerta de enlace local |
| Servidores en Europa o Asia-Pacífico | URL de acceso predeterminada | Usa la red pública para la conexión entre regiones; en general, es estable | Aumenta un poco el tiempo de espera de lectura |
| Servidores en China continental | URL de acceso predeterminada | Usa una ruta acelerada hacia China | Evita añadir otra capa de proxy inestable |
| Equipo de desarrollo local | URL de acceso predeterminada | Depende mucho de la red local | No uses los resultados locales para evaluar el rendimiento en producción |
Como puedes ver, con el modo compatible con OpenAI, solo hace falta cambiar base_url para conectarse, independientemente de dónde esté el despliegue. No es necesario mantener distintas versiones del código para cada región. Lo que sí debes ajustar según la región son los tiempos de espera y la configuración de los intermediarios de red.
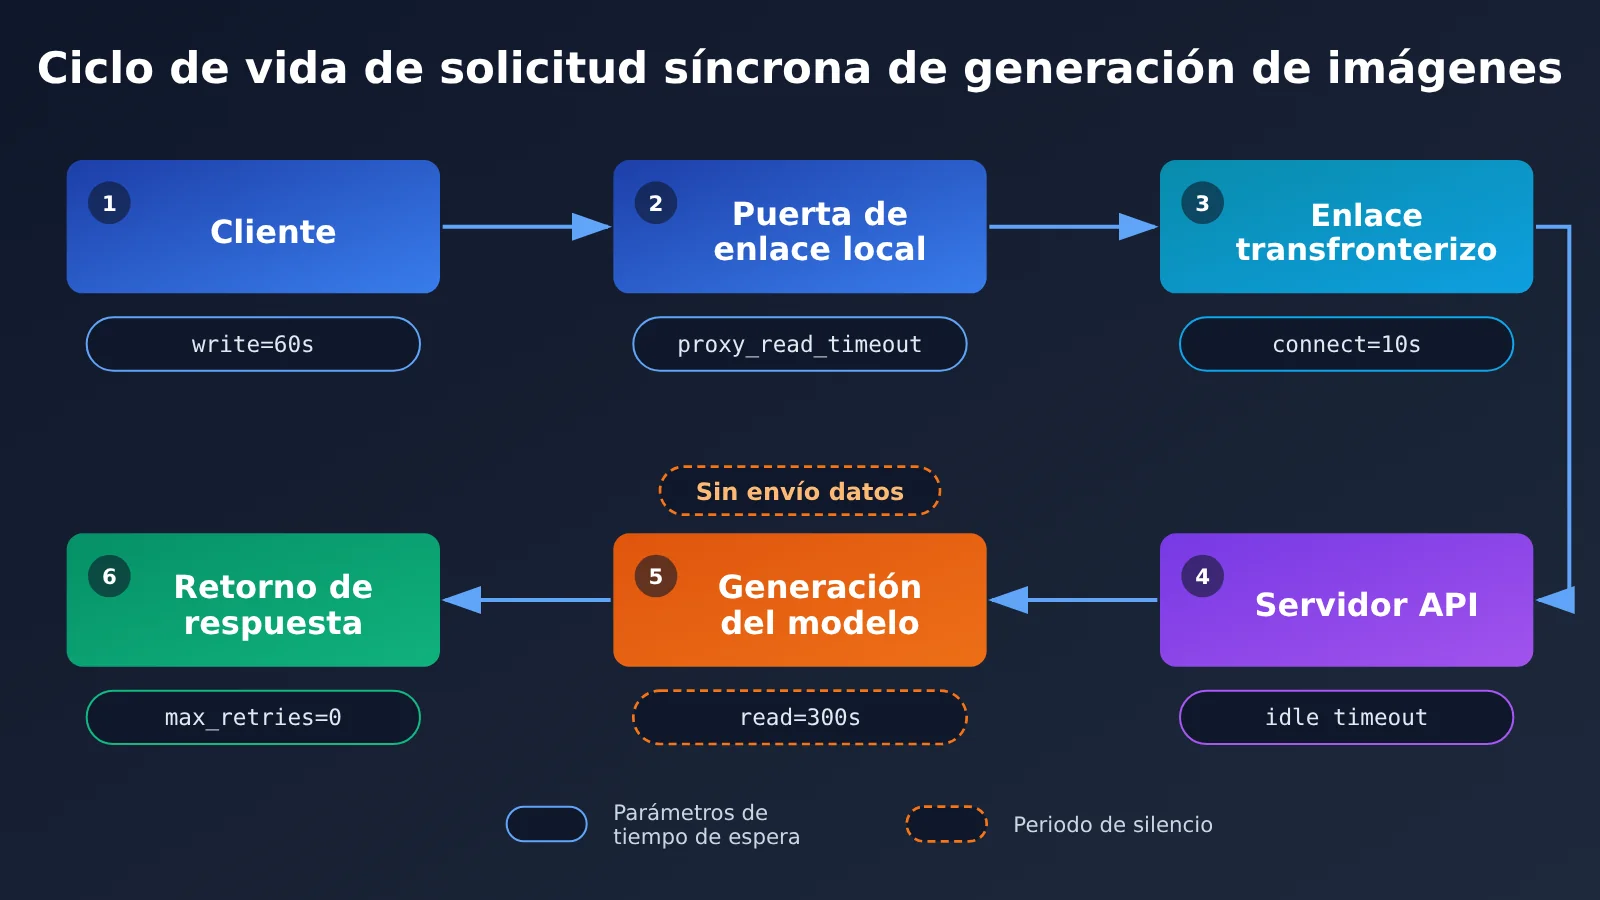
Guía rápida para diagnosticar interrupciones de conexión en la API de imágenes
Ejemplo mínimo: configura correctamente el tiempo de espera y los reintentos automáticos
Muchos problemas de interrupción de conexión se resuelven ajustando correctamente el tiempo de espera y los reintentos del SDK. En el siguiente ejemplo se usa el SDK oficial de Python de OpenAI:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Punto de acceso unificado de APIYI, compatible con despliegues dentro y fuera del país
    timeout=300,      # La generación de imágenes es una invocación síncrona; asigna tiempo suficiente
    max_retries=0,    # Desactiva los reintentos automáticos del SDK para evitar generar y cobrar de nuevo tras una desconexión
)

result = client.images.generate(
    model="gpt-image-1",  # Sustitúyelo según la lista de modelos de la consola
    prompt="Un Shiba Inu corriendo frente a una montaña nevada, con iluminación cinematográfica",
    size="1024x1024",
)
print("Resultado recibido. Longitud de los datos:", len(result.data[0].b64_json or ""))
Hay dos detalles que suelen pasarse por alto. Primero, el SDK de Python de OpenAI reintenta automáticamente por defecto cuando se producen errores de conexión o tiempos de espera agotados. Esto no suele ser un problema en las interfaces de conversación, pero cada reintento en una API de imágenes podría iniciar una generación nueva. Segundo, si timeout se configura con un único número, se aplica tanto a la conexión como a la lectura. En producción, es preferible configurarlos por separado; consulta el código completo a continuación.
Ver la implementación completa (tiempos de espera por separado + reintentos limitados + guardado del resultado)
import base64
import time
import uuid
import httpx
import openai

# Tiempo de espera por etapas: la conexión debe fallar rápido y la lectura debe tener margen suficiente
TIMEOUT = httpx.Timeout(
    connect=10.0,   # Establecimiento de TCP/TLS; si tarda más de 10 segundos, probablemente hay un problema de red
    read=300.0,     # Espera de la generación y la recepción de una respuesta grande
    write=60.0,     # Se necesita más tiempo al subir una imagen de referencia (imagen a imagen o edición)
    pool=10.0,
)

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Interfaz compatible con OpenAI de APIYI
    timeout=TIMEOUT,
    max_retries=0,
)

# Reintentar solo errores en los que es muy probable que la solicitud no haya llegado al servidor
RETRYABLE_BEFORE_SEND = (openai.APIConnectionError,)

def generate_image(prompt: str, out_dir: str = ".", max_attempts: int = 2) -> str:
    task_id = uuid.uuid4().hex[:8]
    for attempt in range(1, max_attempts + 1):
        start = time.time()
        try:
            resp = client.images.generate(
                model="gpt-image-1",
                prompt=prompt,
                size="1024x1024",
            )
            # Guardar el resultado en disco de inmediato para evitar perderlo si falla la lógica posterior
            path = f"{out_dir}/img_{task_id}.png"
            with open(path, "wb") as f:
                f.write(base64.b64decode(resp.data[0].b64_json))
            print(f"[{task_id}] 成功,耗时 {time.time() - start:.1f}s")
            return path

        except openai.APITimeoutError:
            # Tiempo de espera agotado durante la lectura: es muy probable que el servidor ya esté generando la imagen, así que no conviene reintentar de inmediato
            print(f"[{task_id}] 读取超时 {time.time() - start:.1f}s,请检查超时与链路")
            raise

        except RETRYABLE_BEFORE_SEND as e:
            elapsed = time.time() - start
            # Si la conexión falla rápido durante el establecimiento, se puede asumir que la solicitud no llegó y reintentar con espera progresiva
            if elapsed < 15 and attempt < max_attempts:
                wait = 2 ** attempt
                print(f"[{task_id}] 建连失败,{wait}s 后重试:{e}")
                time.sleep(wait)
                continue
            print(f"[{task_id}] 连接中断({elapsed:.1f}s),不再重试:{e}")
            raise

        except openai.APIStatusError as e:
            # Deja que la capa superior gestione los errores 429 y 5xx según la lógica del servicio para evitar una avalancha durante las horas punta
            print(f"[{task_id}] 状态码 {e.status_code}:{e.message}")
            raise

if __name__ == "__main__":
    generate_image("赛博朋克风格的城市夜景,霓虹灯倒映在雨后街道")
🚀 Recomendación para empezar: ejecuta primero el ejemplo mínimo de arriba en tu entorno real de despliegue y registra el tiempo total. Después, ajusta el tiempo de espera de lectura en función de ese dato. Al registrarte en APIYI apiyi.com, obtendrás crédito gratuito para pruebas, ideal para ajustar los tiempos de espera, la puerta de enlace y los parámetros de reintento antes de poner el sistema en producción.
5 causas habituales de las interrupciones en la conexión con la API de imágenes
Causa 1: el tiempo de espera del cliente es demasiado corto
Es la causa más habitual y también una de las más fáciles de solucionar. Muchos clientes HTTP y frameworks de desarrollo tienen un tiempo de espera predeterminado de solo 30 o 60 segundos. Suele ser suficiente para las API de conversación, pero la generación de imágenes puede tardar más, sobre todo con alta resolución, indicaciones complejas o durante las horas de mayor demanda.
La forma de detectarlo es sencilla: si cada intento fallido se interrumpe prácticamente en el mismo segundo, es muy probable que se haya alcanzado el tiempo de espera de alguna capa. En ese caso, hay que distinguir entre el tiempo de espera de conexión y el de lectura. Conviene mantener corto el de conexión para detectar rápidamente los problemas de red, mientras que el de lectura debe cubrir el peor caso de «tiempo de generación + tiempo de transferencia».
Causa 2: tiempo de espera por inactividad del proxy o la puerta de enlace
Aunque el tiempo de espera del cliente esté bien configurado, Nginx, el balanceador de carga en la nube y la puerta de enlace de la API que intervienen en la ruta de la solicitud también tienen sus propios límites. El valor predeterminado de proxy_read_timeout de Nginx es de 60 segundos, y el tiempo de espera por inactividad de muchos balanceadores de carga en la nube suele ser similar. Si el periodo de silencio durante la generación de imágenes supera ese límite, la puerta de enlace cerrará la conexión y el cliente recibirá un error 502 o 504, o verá cómo se restablece la conexión.
Si tu servicio tiene una estructura de reenvío del tipo «frontend → backend → API de imágenes», revisa tanto la puerta de enlace de entrada de tu backend como el proxy de salida:
location /api/image/ {
    proxy_pass http://backend;
    proxy_connect_timeout 10s;
    proxy_send_timeout    120s;
    proxy_read_timeout    300s;   # 覆盖图片生成的静默期
    client_max_body_size  20m;    # 图生图、图片编辑需要上传参考图
    proxy_buffering       on;
}
| Capa | Parámetro clave | Valores predeterminados habituales | Recomendación |
|---|---|---|---|
| SDK / cliente HTTP | read timeout | Varía mucho según el framework | Cubre el peor tiempo de generación y deja un margen |
| Nginx propio | proxy_read_timeout | 60 segundos por defecto | Alinearlo con el tiempo de espera de lectura del cliente |
| Balanceador de carga en la nube | idle timeout | Por lo general, menos de unos minutos | Aumentarlo explícitamente desde la consola |
| Navegador / frontend | fetch no tiene un tiempo de espera integrado, pero está sujeto a los límites de las capas anteriores | Depende de la puerta de enlace | Cambiar a un sistema de sondeo del estado de las tareas del backend |
| Plataforma serverless | Tiempo máximo de ejecución | Varía según la plataforma | Elegir un plan que admita ejecuciones largas o cambiar la arquitectura |
Una regla práctica: cuanto más externa sea la capa, mayor o igual debe ser su tiempo de espera respecto al de las capas internas. Si el tiempo de espera de la puerta de enlace es menor que el del cliente, la configuración de tiempo de espera del cliente no servirá de nada.
Causa 3: calidad de la conexión internacional y transferencia de respuestas de gran tamaño
Las conexiones internacionales suelen tener una latencia media aceptable, pero las fluctuaciones y la pérdida de paquetes son impredecibles. Si una solicitud pequeña a una interfaz de chat sufre fluctuaciones, basta con retransmitir algunos paquetes. En cambio, cuando una interfaz de imágenes devuelve varios MB de resultados, la transferencia dura más y aumenta la probabilidad de que se produzcan fluctuaciones.
Hay tres formas de optimizar esta capa:
- Elegir la dirección de acceso adecuada: si el servicio está desplegado en el extranjero, usa la dirección predeterminada para comunicarte con el servidor de la costa oeste de EE. UU. Si está desplegado en China, usa también la dirección predeterminada y deja que la ruta acelerada hacia China de la plataforma gestione el tramo internacional. Evita añadir un proxy propio cuya estabilidad no esté clara.
- Controlar el tamaño de la respuesta: elige dimensiones y cantidades adecuadas según las necesidades del negocio. Generar varias imágenes en una sola solicitud aumenta proporcionalmente el volumen de datos que hay que transferir.
- Guardar los resultados en cuanto lleguen: escríbelos de inmediato en el almacenamiento local o en el almacenamiento de objetos. No esperes a terminar una cadena de operaciones posteriores en memoria para guardarlos.
💡 Recomendación sobre la conexión: Si quieres comparar el rendimiento de generación de imágenes de un mismo servicio desde servidores en el extranjero y en China, despliega el script de prueba anterior en ambas ubicaciones y conéctalos a APIYI apiyi.com. Compara el tiempo de respuesta y la tasa de éxito. Al cambiar solo la ubicación del despliegue y mantener el código igual, obtendrás una comparación más fiable.
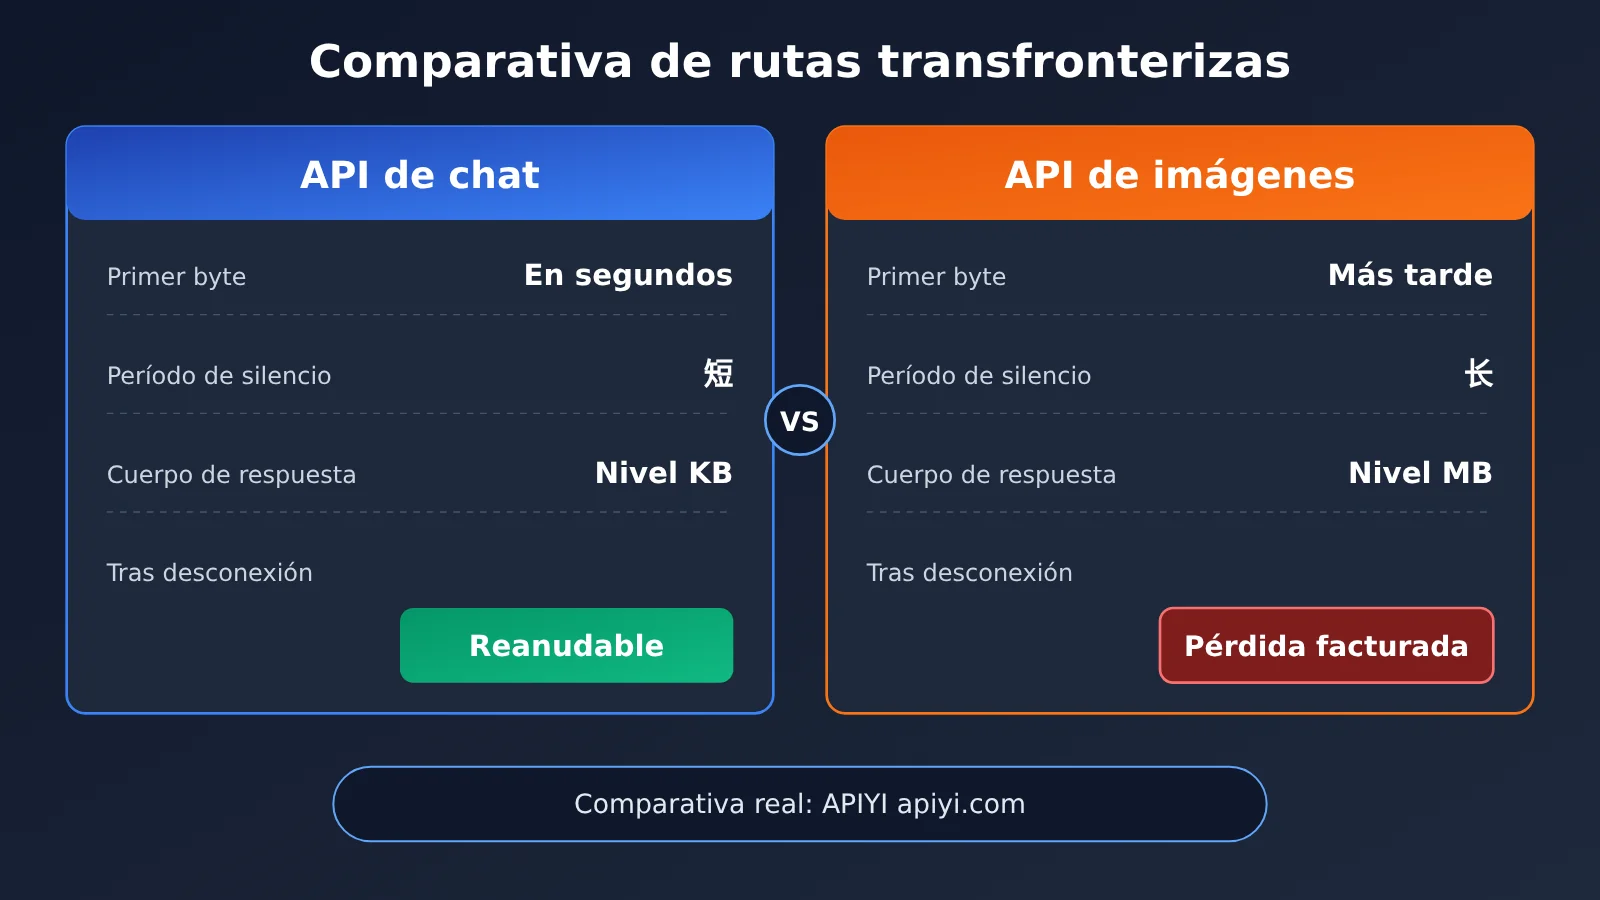
Causa cuatro: estrategia de reintentos inadecuada
El problema no son los reintentos en sí, sino «reintentar todos los errores por igual». Si la conexión se interrumpe mientras se lee la respuesta de la API de imágenes, es muy probable que el servidor ya haya iniciado o incluso completado la generación. En ese caso, reintentar de inmediato equivale a hacer otro pedido. Peor aún: en horas pico, si muchos clientes reintentan rápidamente al mismo tiempo, las colas se alargan y aumentan los tiempos de espera, lo que genera un círculo vicioso.
| Escenario de fallo | ¿Se envió la solicitud? | ¿Se recomienda reintentar? | Cómo actuar |
|---|---|---|---|
| Fallo de resolución DNS o tiempo de espera al establecer la conexión | Probablemente no | Sí | Aplicar retroceso exponencial y limitar el número de intentos |
| Fallo durante el protocolo de enlace TLS | Probablemente no | Sí | Revisar primero el proxy local y los certificados |
| Tiempo de espera de lectura | Probablemente sí | Con cautela | Aumentar primero el tiempo de espera y después confirmar manualmente |
| Conexión restablecida durante la respuesta | Sí, y es posible que la solicitud ya se haya completado | No se recomienda reintentar automáticamente | Registrar el error y revisar la conexión |
| Límite de solicitudes 429 | Sí, pero la solicitud fue rechazada | Sí | Aumentar el intervalo entre reintentos y limitar la concurrencia |
| Error 5xx del servidor | Sí | Depende del caso | Reintentar unas pocas veces con retroceso y generar una alerta |
La idea clave es la lógica que aparece en el código completo: reintentar automáticamente solo cuando sea muy probable que la solicitud no haya llegado al servidor. En los demás casos, debe decidirlo la capa de negocio. Si el usuario solicita generar una imagen, es mejor mostrarle claramente «La generación falló; puedes volver a intentarlo» que reintentar en segundo plano sin avisarle.
Causa 5: Limitaciones del entorno de ejecución
Algunos cortes de conexión no están relacionados con la red, sino con que el entorno de ejecución «no espera lo suficiente». Hay tres casos habituales: las funciones serverless tienen un tiempo máximo de ejecución y la plataforma las detiene al alcanzarlo; las llamadas directas a la API de imágenes desde el navegador se interrumpen al cambiar de página o de red móvil; y algunas plataformas de contenedores liberan las instancias cuando están inactivas.
Para evitar estos problemas, recomendamos ejecutar la generación de imágenes en un proceso de backend permanente o en una cola de tareas. El frontend envía la tarea y recibe un ID; después, obtiene el resultado mediante consultas periódicas o notificaciones push. Así, el proceso de generación queda desacoplado de la conexión del usuario y el resultado no se pierde aunque este actualice la página. Como los archivos de vídeo ocupan más espacio, es aún más recomendable usar este enfoque desacoplado para devolverlos.
Lista práctica para diagnosticar cortes de conexión en la API de imágenes
Cuando se produzca un corte de conexión en producción, puedes seguir estos pasos para identificar la capa afectada, normalmente en menos de media hora:
- Revisa la distribución de los tiempos: registra cuánto tardan las solicitudes fallidas. Si los tiempos se concentran en un valor fijo, probablemente se trate de una configuración de tiempo de espera; si varían al azar, es más probable que sea un problema de conexión.
- Revisa el tipo de error: distingue entre errores al establecer la conexión, tiempos de espera de lectura, conexiones restablecidas y códigos de estado HTTP. Cada tipo apunta a una capa diferente.
- Prueba la conexión directa, sin intermediarios: desde el mismo servidor, usa un script para llamar directamente a la API. Si funciona, el problema está en tu propia puerta de enlace o proxy.
- Vuelve a probar en otro horario: si la tasa de errores aumenta claramente en las horas de mayor actividad, revisa primero la concurrencia y la estrategia de reintentos.
- Comprueba la facturación y los registros: verifica si se cobraron las solicitudes cuya conexión se interrumpió durante la lectura. Esto te ayudará a evaluar las pérdidas y optimizar la estrategia.
🎯 Recomendación técnica: durante el diagnóstico, registra la hora de inicio y finalización de cada solicitud, el tipo de error y el identificador de la solicitud. Si en el historial de llamadas de la consola de APIYI apiyi.com la solicitud aparece como exitosa, pero tu programa devuelve un error, es muy probable que el problema esté en la conexión o el tiempo de espera durante la devolución de la respuesta.
Preguntas frecuentes
P1: ¿Qué significa que se interrumpa la conexión con una API de imágenes?
Significa que la conexión entre el cliente y el servidor se corta antes de que finalice una solicitud de generación de imágenes. Entre los errores más habituales están el tiempo de espera de lectura, la conexión restablecida y los errores 502 y 504. Como la API de imágenes funciona de forma síncrona, una vez interrumpida la conexión, ya no se puede enviar el resultado al cliente.
P2: ¿Tengo que configurar un `base_url` distinto para las llamadas desde servidores nacionales y del extranjero?
No. El servidor está alojado en la costa oeste de EE. UU., así que las operaciones desde el extranjero pueden usar la dirección de acceso predeterminada. Para las conexiones desde China, la plataforma ofrece aceleración mediante rutas de retorno al país. Ambas configuraciones usan el mismo `base_url`; lo único que cambia son los parámetros de tiempo de espera y la configuración de la puerta de enlace intermedia.
P3: Si se interrumpe la conexión, ¿se cobra esta solicitud?
Es posible. Si la conexión se interrumpe cuando el modelo ya ha generado el resultado y este se está enviando al cliente, la generación ya se ha completado y, por lo general, se cobra, aunque el resultado no llegue a su destino. Por eso es importante configurar bien los tiempos de espera y definir con cuidado los reintentos.
P4: ¿Qué tiempo de espera de lectura debería configurar?
No hay un valor estándar para todos los casos. Te recomendamos hacer pruebas en tu entorno real de despliegue: envía varias solicitudes con el tamaño de imagen deseado y las indicaciones habituales, y añade un margen suficiente a las que más tardan. Asegúrate también de que los tiempos de espera de la puerta de enlace y del balanceador de carga no sean inferiores a ese valor.
P5: ¿Cómo puedo comprobar rápidamente si mi configuración de tiempos de espera y reintentos es adecuada?
Sigue estos pasos:
1. Regístrate en APIYI, en apiyi.com, y obtén una clave API y una cuota de prueba gratuita.
2. Mantén `base_url` como `https://api.apiyi.com/v1` en el código completo de este artículo y despliégalo en un servidor de producción de la misma región que tu servicio.
3. Ejecuta varias solicitudes seguidas y registra la distribución de los tiempos de respuesta y los tipos de error. Después, ajusta los parámetros según los resultados.
P6: ¿Puede ocurrir lo mismo con las API de generación de videos?
Sí, y los archivos de video suelen ocupar más espacio, por lo que son más sensibles a la estabilidad de las conexiones internacionales. La solución es similar: ampliar el tiempo de espera de lectura, guardar el resultado en cuanto se reciba, desacoplar el proceso de generación de la conexión con el usuario y evitar reintentos a ciegas si falla el envío del resultado.
P7: ¿Estos métodos pueden eliminar por completo las interrupciones de conexión?
No. No es posible evitar por completo las fluctuaciones ocasionales de las redes internacionales. El objetivo de estos métodos es reducir la tasa de fallos a un nivel aceptable y garantizar que cada fallo se pueda localizar y rastrear. Para operaciones críticas, recomendamos añadir alertas y un proceso de revisión manual.
Puntos clave para diagnosticar interrupciones de conexión en la API de imágenes
- La causa raíz es la llamada síncrona: durante la generación de imágenes, no se transmiten datos, por lo que es fácil que se agote el tiempo de espera por inactividad en alguna de las capas.
- Si se interrumpe la conexión, se pierde el resultado: cuando la conexión se corta durante el envío de la respuesta, es posible que la generación ya se haya completado y cobrado. La estabilidad afecta directamente a los costos.
- Ajusta los tiempos de espera por capas: el tiempo de espera para establecer la conexión debe ser corto y el de lectura, largo. El tiempo de espera de la puerta de enlace externa no debe ser menor que el de la capa interna.
- Decide cuándo reintentar según la etapa: reintenta automáticamente solo ante errores de establecimiento de conexión en los que la solicitud no haya llegado, y aplica retroceso exponencial.
- Unifica las direcciones de acceso: tanto en despliegues nacionales como internacionales, usa el mismo
base_urly centraliza el acceso mediante APIYI en apiyi.com. - Desacopla las tareas largas: en entornos Serverless y en conexiones directas desde el navegador, usa tareas en el backend y consultas periódicas de estado.
Resumen
Puntos clave para diagnosticar interrupciones de conexión en la API de imágenes:
- Localiza primero la capa: revisa una por una las cinco capas —cliente, puerta de enlace, red, reintentos y entorno de ejecución— y analiza la distribución de los tiempos y los tipos de error.
- Ajusta después los parámetros: configura los tiempos de espera por capas, desactiva los reintentos automáticos indiscriminados del SDK y alinea el tiempo de espera de la puerta de enlace con el del cliente.
- Por último, cambia la arquitectura: guarda en disco las respuestas grandes en cuanto las recibas y desacopla las tareas de larga duración de la conexión del usuario.
La generación de imágenes entre países no es inestable por naturaleza. La mayoría de las interrupciones se deben a la configuración y a la arquitectura, y pueden resolverse de forma sistemática. Antes de poner el sistema en producción, te recomendamos desplegar los scripts de prueba de este artículo en un entorno real y ejecutarlos. Puedes validar rápidamente los resultados a través de APIYI en apiyi.com: con una sola clave API, podrás comparar el tiempo y la estabilidad de generación de imágenes de varios modelos.
📚 Recursos de referencia
- Guía de inicio rápido y manual de API de APIYI: información sobre la URL de acceso y el proceso de integración en tres pasos
- Enlace:
docs.apiyi.com -
Descripción: incluye la configuración de
base_urlpara el modo compatible con OpenAI y las indicaciones para invocar los endpoints de imágenes -
OpenAI Python SDK: biblioteca oficial para clientes
- Enlace:
github.com/openai/openai-python -
Descripción: consulta la documentación completa de parámetros como
timeoutymax_retries -
Documentación del módulo proxy de Nginx: información sobre parámetros como
proxy_read_timeout - Enlace:
nginx.org/en/docs/http/ngx_http_proxy_module.html - Descripción: sirve como referencia al ajustar la configuración de timeout en una puerta de enlace propia
Autor: Equipo técnico de APIYI
Intercambio técnico: Puedes ponerte en contacto con nosotros desde la página de inicio del sitio web de APIYI. Encontrarás más información sobre la integración en el centro de documentación.